

Kurs
Python ile Kümeleme Analizi
4 sa
66.1K
Alıştırma and program your progress.
Google Ile Devam EdinMakine öğreniminde, nesneleri farklı gruplara ayırma hedefini gerçekleştirmek için iki teknik vardır: sınıflandırma ve kümeleme. Bu durum, özellikle başlangıç seviyesindeki uygulayıcılar arasında sıkça kafa karışıklığına yol açar.
Yüzeyde bakıldığında, sınıflandırma ve kümeleme benzer görünür. Her ikisi de, bir veri kümesinin özelliklerinden yararlanarak kalıpları ortaya çıkarmak ve örnekleri ayrı gruplara ayırmak için algoritmalar kullanır. Ancak pratik açıdan bakıldığında, aralarında belirgin farklar vardır.
Bu yazıda, her bir tekniği, onlarla ilişkili farklı algoritmaları, uygulama alanlarını ve en önemlisi aralarındaki farkları ele alacağız.
Sınıflandırma görevleri, “denetimli öğrenme” olarak adlandırılan problem kategorisine girer. Bu tür problemler, geçmiş verilerden öğrenerek yeni örnekler üzerinde tahminler yapan modeller geliştirmeyi içerir.
Daha resmi olarak, denetimli öğrenme görevleri, örnek girdi-çıktı çiftlerine dayanarak girdiden çıktıya eşleyen bir fonksiyonun öğrenildiği problemlerdir. Dolayısıyla amaç, girdilerden (X) çıktıya (y) eşlemeyi sağlayan fonksiyonu (f) yaklaşıklamak — matematik geçmişiniz varsa bunu fonksiyon yaklaşımı problemi olarak biliyor olabilirsiniz.
Denetimli öğrenmenin iki farklı biçimi olduğunu not etmek önemlidir: regresyon ve sınıflandırma.
Sınıflandırma problemlerinde, öğrenme algoritmasının amacı, bir özellikler kümesinden ayrık bir çıktıyı tahmin etmek için eşleme fonksiyonunu yaklaşıklamaktır (ör. bir görselin kedi mi köpek mi olduğunu tahmin etmek) — uygulamalı bir gösterim için Python ile metin sınıflandırmayı anlama eğitimimize bakın.
Sınıflandırma algoritmalarının uygulandığı çeşitli problemler vardır, örneğin:
Bazı sınıflandırma algoritmalarına göz atalım.
Çoğu zaman lojistik regresyonun bir regresyon algoritması olduğu düşünülür; bu anlaşılabilir bir yanılgıdır. Teknik olarak haksız da değillerdir. Lojistik regresyon istatistiksel sınıflandırma yapmaz; yalnızca bir lojistik modelin parametrelerini tahmin eder.
Lojistik regresyonu sınıflandırma için kullanabilmemizin nedeni, sınıfları ayırmak üzere eklenen bir karar sınırıdır. Dolayısıyla en basit hâliyle lojistik regresyon, ikili bağımlı değişkenleri modellemek için bir lojistik fonksiyon kullanır.
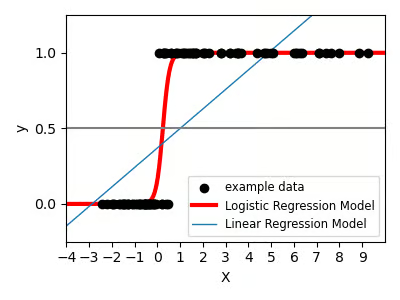
Kaynak: Scikit-Learn ile Lojistik Fonksiyon
KNN, en basit makine öğrenimi algoritmalarından biridir ve lojistik regresyondan farklı olarak hem sınıflandırma hem de regresyon görevleri için kullanılabilir.
Kısacası, parametrik olmayan, tembel bir öğrenme algoritmasıdır. Bu, KNN’nin örneklerin özellikleri veya verinin nicel mi nitel mi olduğu hakkında varsayımda bulunmadığı (parametrik olmayan) ve tüm hesaplamayı fonksiyon değerlendirmesine kadar ertelediği (tembel öğrenici) anlamına gelir.
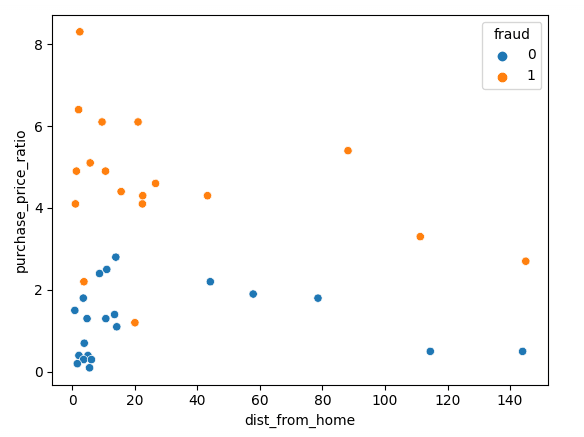
Kaynak: Scikit-learn ile En Yakın Komşular
Karar ağacı algoritması, regresyon ve sınıflandırma yapabilen popüler bir parametrik olmayan algoritmadır. Popülerliğinin büyük kısmı, görselleştirmenin ve yorumlamanın görece kolay olması sayesinde anlaşılabilirlik ve sadeliğinden gelir.
Kavramsal olarak, bir karar ağacını kökten yapraklara akan bir yapı gibi düşünebilirsiniz. Kökten bir yaprağa giden yol, özellikler üzerinde verilen bir karar kuralını tanımlar.
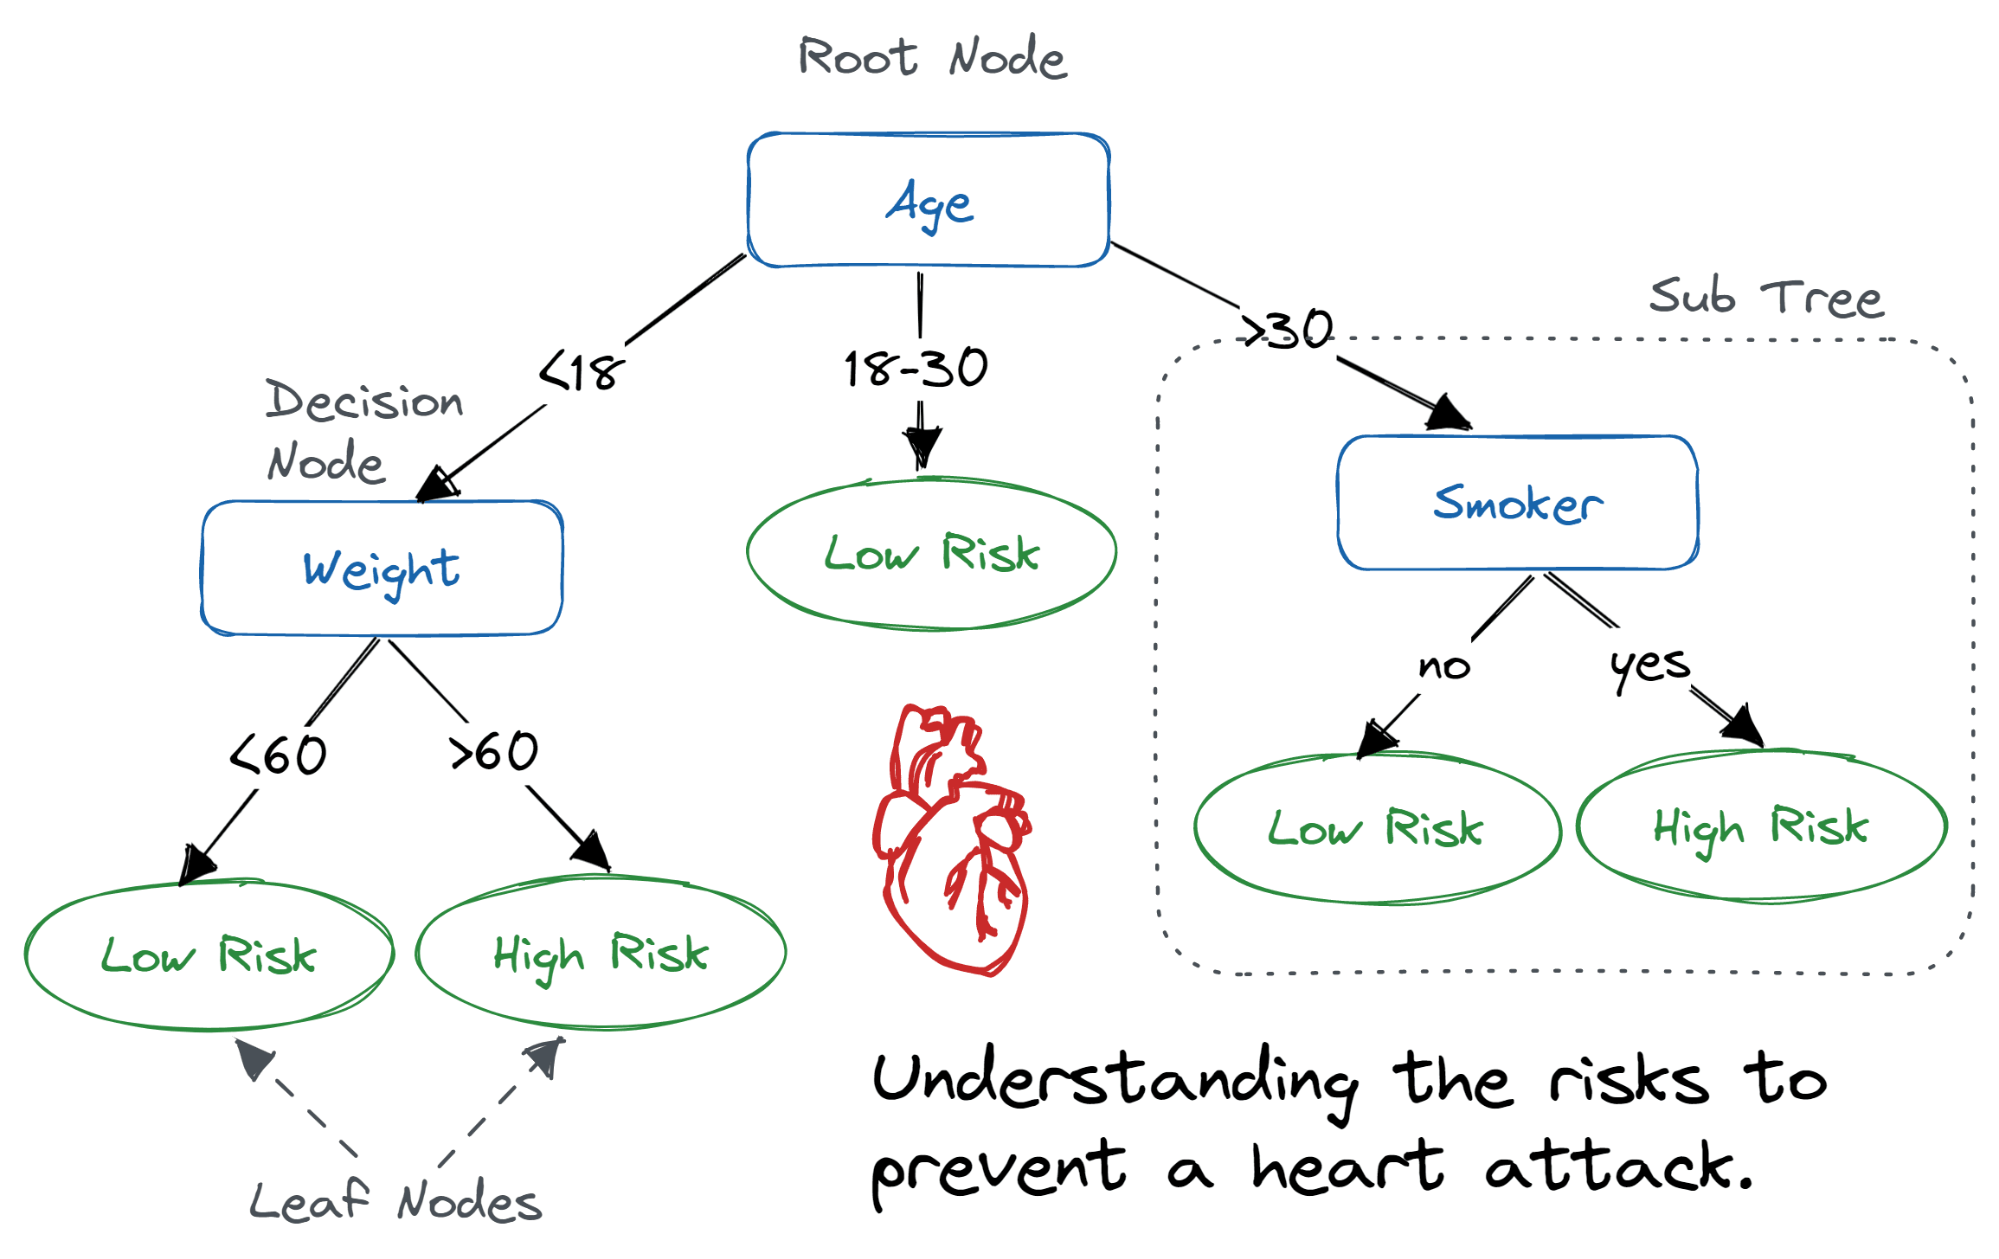
Kaynak: Python'da Karar Ağacı Sınıflandırması Eğitimi
Rastgele orman, iki veya daha fazla karar ağacından oluşan bir ansambl modelidir. Bu teknik, bireysel ağaçları büyütmek için önyükleme toplamayı ve rastgele alt uzay yöntemini kullanarak, hem sınıflandırma hem de regresyon yapabilen güçlü bir birleştirilmiş kestirici elde eder.
Önyükleme toplama veya bagging, birleştirilmiş bir kestirici oluşturmak için yararlanılabilecek birden çok kestirici sürümü üretmekte kullanılan bir tekniktir. Amaç, daha iyi genelleşen birleştirilmiş model için kestiriciler arasındaki korelasyonu azaltmaktır.
Her kestiriciye rastgelelik, eğitim kümesinden yerine koymalı örnekleme yapılarak ve önyüklenen veriler eğitimde kullanılarak katılır.
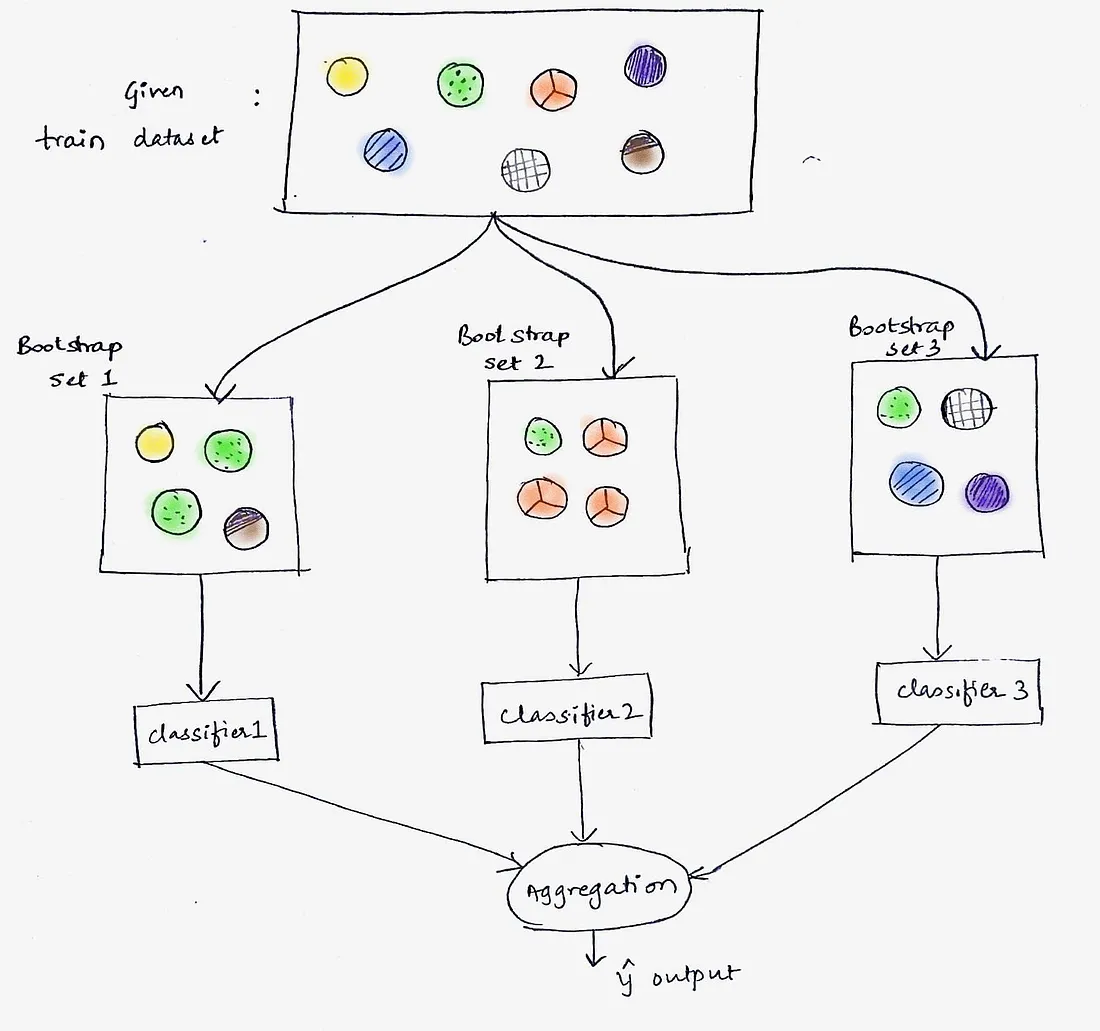
Kaynak: Bagging: Görsellerle Makine Öğrenimi. #1: “Bagging” ansambl öğrenmesi nedir?
Ansambl içindeki kestiriciler arasındaki korelasyonu azaltmak için rastgele alt uzay yöntemi de kullanılır. Sıklıkla “özellik bagging’i” olarak anılır; çünkü özelliklerde bagging ile aynı yaklaşımı uygular. Yani, rastgele alt uzay yöntemi, ansambl içindeki her kestiriciyi, yerine koymalı rastgele seçilmiş bir özellik örneği üzerinde inşa ederek korelasyonu azaltır.
Naive Bayes sınıflandırıcısı, yeni verilere göre olasılıkları güncellemek için kullanılan matematiksel bir kural olan Bayes teoremine dayalı olasılıksal bir algoritmadır.
Naive Bayes bağlamında “naif” varsayım, sonucun tahmininde veri kümesindeki tüm özelliklerin (veya değişkenlerin) birbirinden bağımsız olduğudur. Bu bir basitleştirmedir; çünkü gerçekte özellikler bağımlı olabilir. Ancak bu naif varsayıma rağmen, algoritma birçok sınıflandırma görevinde şaşırtıcı derecede iyi performans gösterebilir.
Dolayısıyla Bayes teoreminin kendisi değişkenlerin bağımsızlığına dair bir varsayımda bulunmaz. Basitlik ve hesaplama verimliliği adına bu varsayımı yapan, Naive Bayes sınıflandırıcısıdır.
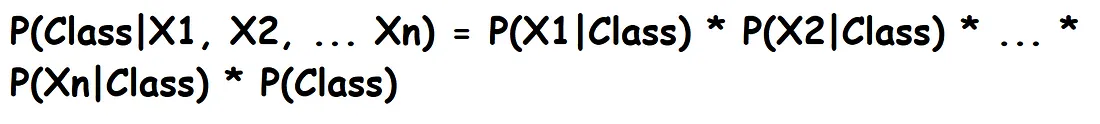
Kümeyi anlamak için denetimsiz öğrenme tanımından başlamalıyız. Denetimsiz öğrenme, verinin altında yatan yapıyı keşfetmek için kullanılan bir yaklaşımdır; ancak denetimsiz öğrenme algoritmaları bunu başarmak için girdi-çıktı eşlemelerine ihtiyaç duymaz.
Denetimsiz öğrenme, genellikle verideki mevcut kalıpları ortaya çıkarmak ve örnekleri etiketlere ihtiyaç duymadan gruplamak için kullanılır. Aynı gruba düşen örneklerin benzer özelliklere sahip olduğu varsayılır. Bu nedenle, kümeleme, etiketlenmemiş verileri benzerlik veya farklılıklarına göre gruplamak için kullanılan bir denetimsiz öğrenme tekniğidir.
Kümeleme kullanım alanlarına örnekler:
İşte birkaç farklı kümeleme algoritması türü:
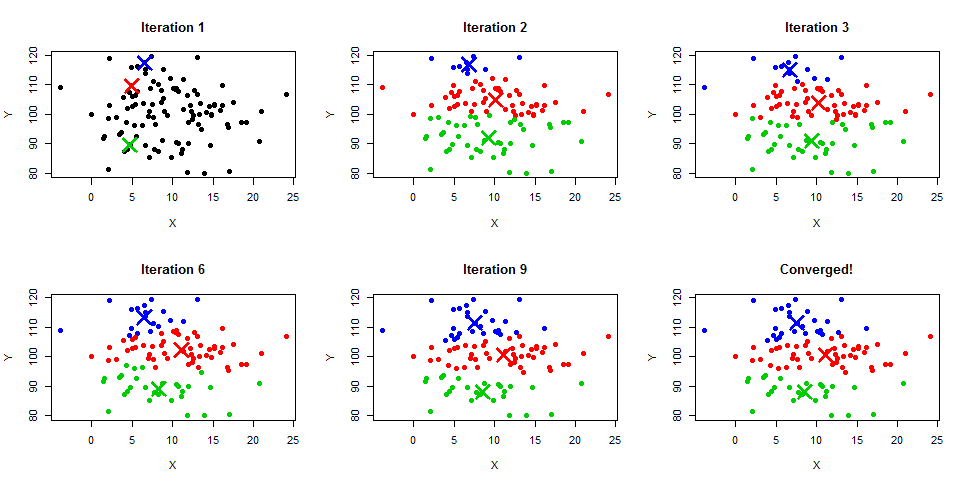
En popüler ve en yaygın kullanılan kümeleme algoritmalarından biri k-means’tir. Merkezî noktaya dayalı, yinelemeli bir algoritmadır ve örtüşmeyen kümeler oluşturur.
Kümeleri oluşturmanın bir başka yolu da kümelerin bir hiyerarşisini inşa etmektir; bu nedenle adına “hiyerarşik kümeleme” denir. Kümelerin bir hiyerarşisini inşa etmenin iki yolu vardır: .
Birleştirici (Agglomerative)
Bu, her bir gözlemin başlangıçta kendi başına bir küme olarak kabul edildiği alttan üste bir yaklaşımdır. Hiyerarşi tabandan yukarı doğru inşa edilirken, her gözlem önce ikili olarak birleştirilir, ardından bu ikililer kümelere birleştirilir.
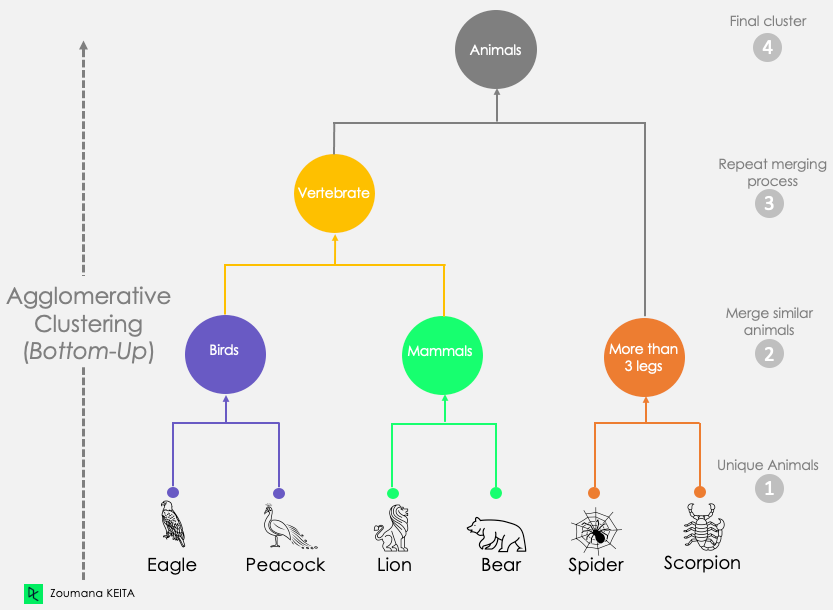
Kaynak: Python'da Hiyerarşik Kümelemede giriş
Bölücü (Divisive)
Bölücü kümeleme, tüm gözlemlerin tek bir kümede başladığı ve bölünmelerin tekrarlı olarak uygulanarak hiyerarşinin yukarıdan aşağıya kurulduğu üstten alta bir yaklaşımdır.
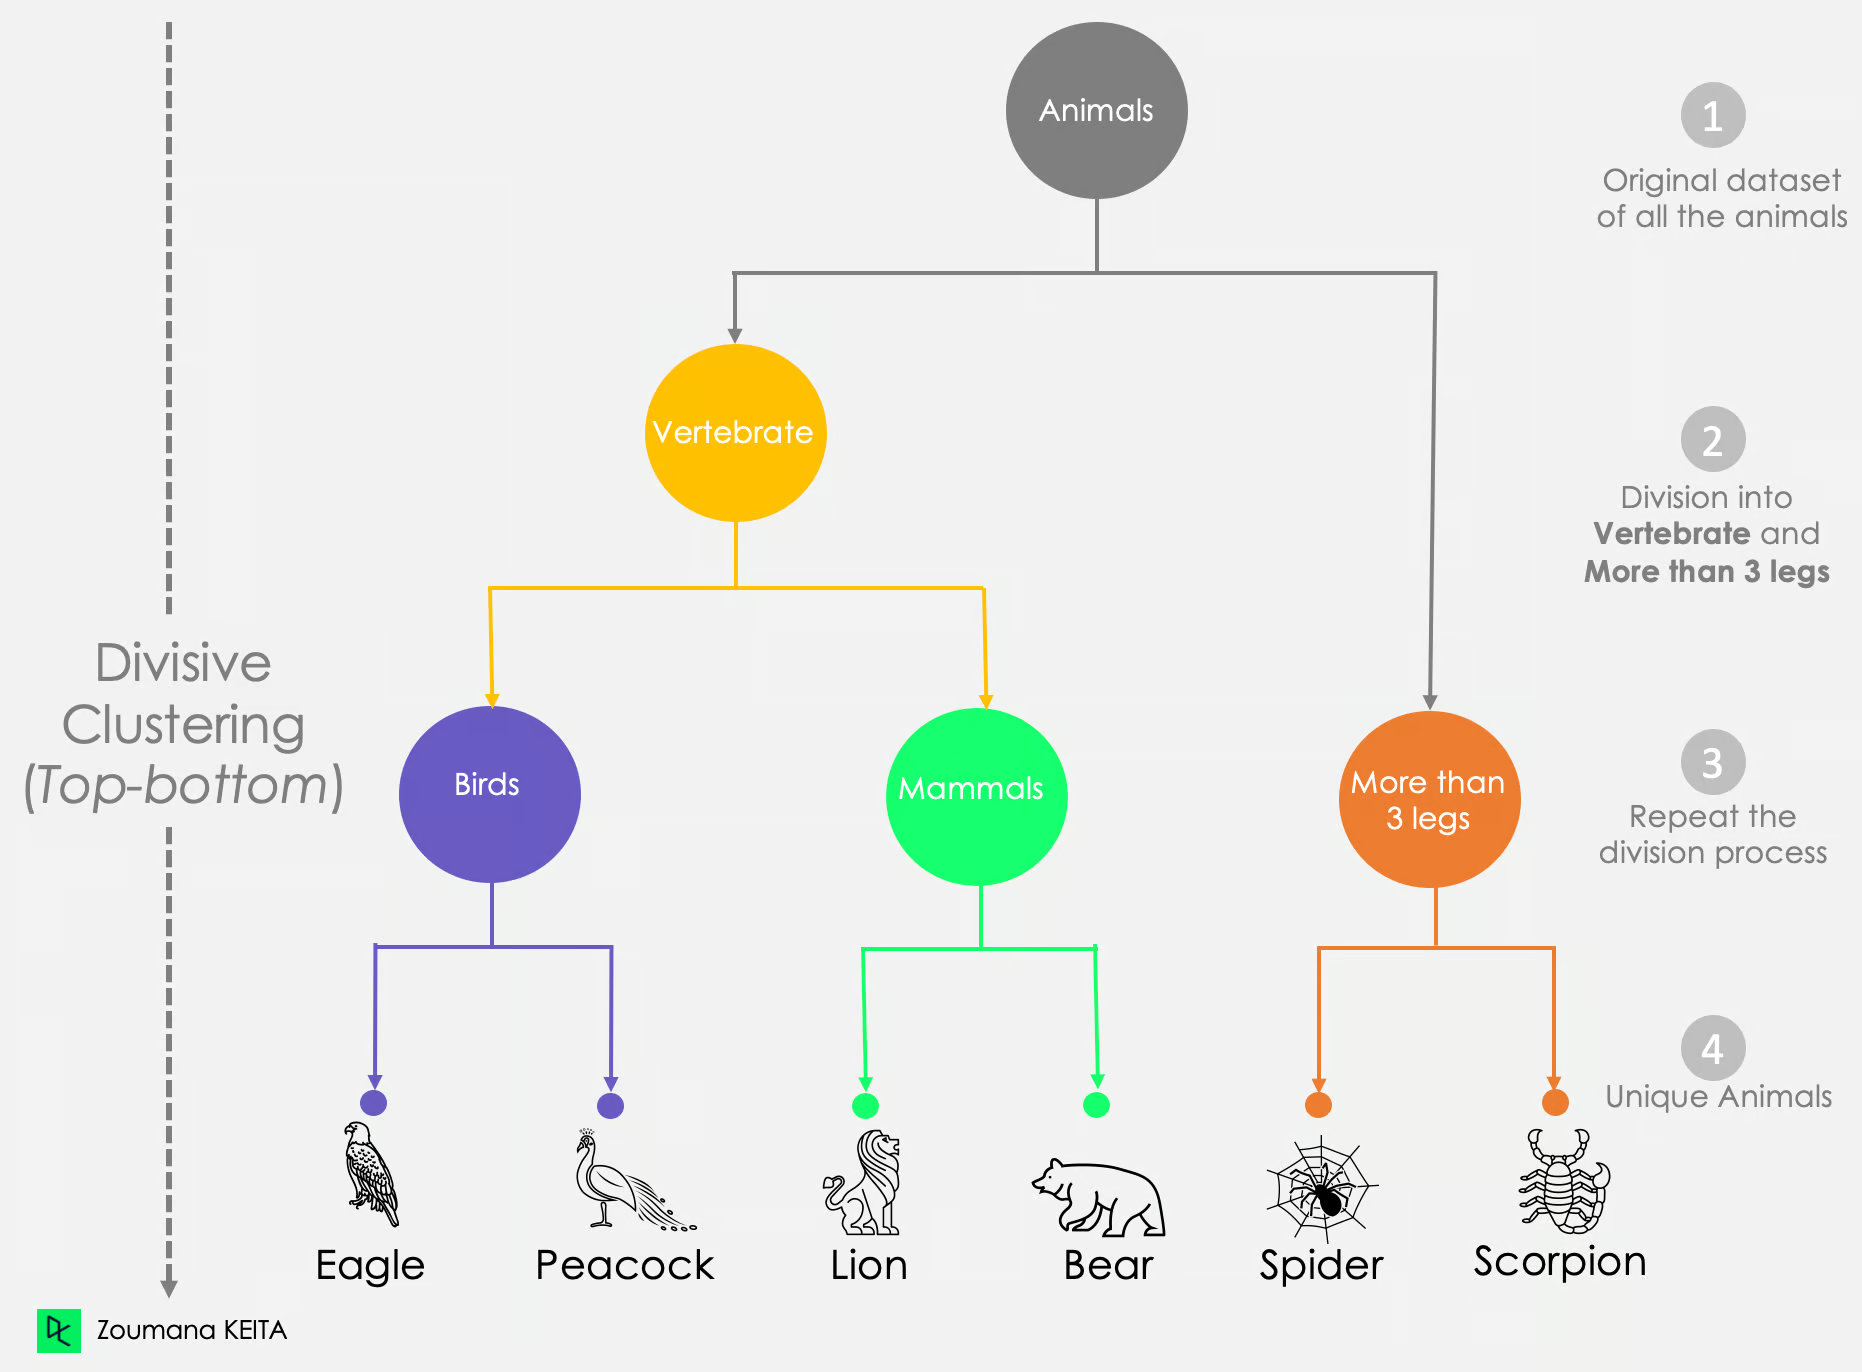
Kaynak: Python'da Hiyerarşik Kümelemede giriş
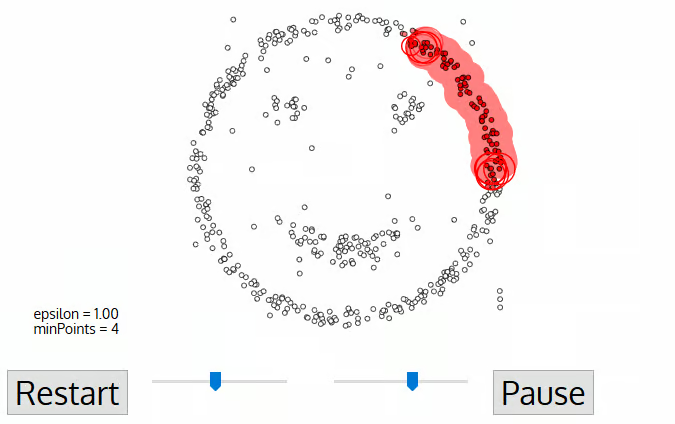
Gürültü ile Uygulamaların Yoğunluk Tabanlı Uzamsal Kümelemesi (DBSCAN) yönteminin en büyük çekiciliklerinden biri aykırı değerlere karşı sağlam olmasıdır — ayrıca en bilinen yoğunluk tabanlı kümeleme algoritmasıdır.
DBSCAN, kümelerin, daha düşük yoğunluklu bölgelerle ayrılan uzaydaki yoğun bölgeler olduğunu varsayar. K-Ortalamalar’ın aksine, DBSCAN küme sayısını veriye göre çıkarır ve rastgele şekilli kümeleri keşfedebilir; bu nedenle küme sayısının bir parametre olarak verilmesine gerek yoktur.
OPTICS kısaltması, Kümeleme Yapısını Belirlemek için Noktaların Sıralanması (Ordering Points to Identify the Clustering Structure) ifadesinin baş harflerinden oluşur. DBSCAN gibi, aynı araştırma grubu tarafından geliştirilen yoğunluk tabanlı bir algoritmadır. Ancak OPTICS, veri yoğunluğunun tutarlı olduğu varsayımını göz ardı ederek, DBSCAN’in önemli bir açmazını — değişen yoğunluktaki verilerde kümeleri belirleme — aşmayı amaçlar.
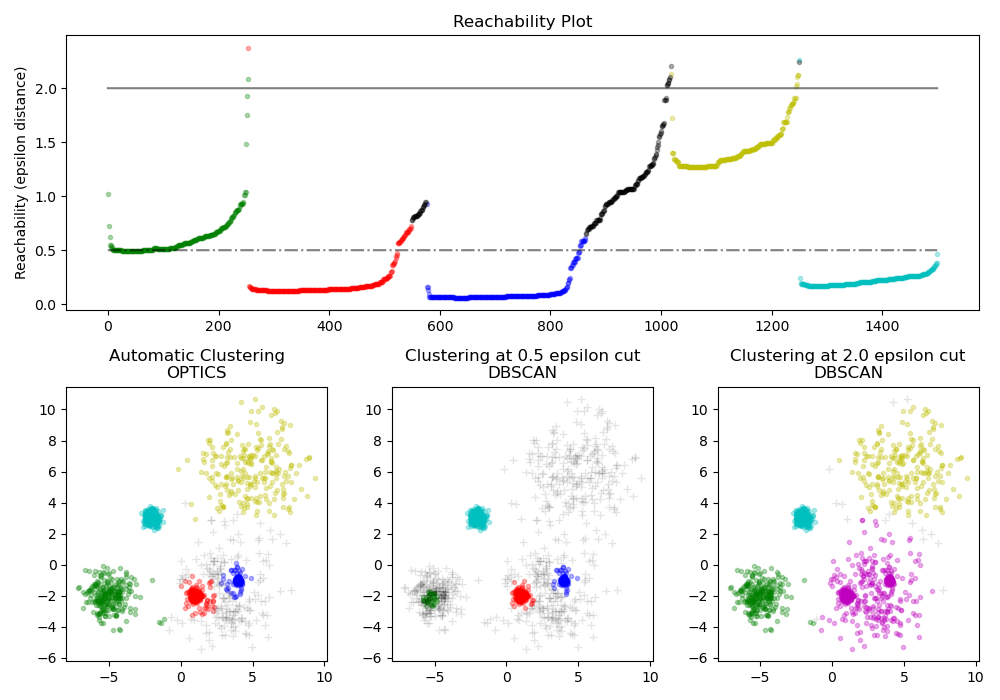
Kaynak: OPTICS kümeleme algoritmasının Scikit-learn demosu
Sınıflandırma, bir denetimli öğrenme biçimidir. Denetimli öğrenme problemleri, girdi-çıktı çiftlerine dayanarak girdiyi çıktıya eşleyen bir fonksiyon öğrenmeyi içerir. Buna karşılık, denetimsiz öğrenme görevleri, etiketlenmemiş verilerdeki gizli kalıpları keşfetmek için kümeleme gibi yöntemleri kullanır.
Hem sınıflandırma hem de kümeleme görevlerinin kalıpları öğrenmek için eğitim verisine ihtiyacı vardır. Ancak sınıflandırma görevlerinde, makine öğrenimi modelinin tahmin performansını değerlendirmek için test verisine sahip olmak iyi bir uygulamadır.
Kümeleme algoritmaları, içgörüler keşfetmek için verinin altında yatan yapıyı modellemek üzere girdi verisine dayanır. Başka bir deyişle, algoritmaya doğru cevapları bildiren bir öğretmen yoktur — algoritmanın öğrendiği kadardır. Buna karşılık, sınıflandırma algoritmaları eşleme fonksiyonunu öğrenmek için girdi ve çıktı verilerine ihtiyaç duyar; böylece yeni girdi verilerinin çıktısını tahmin etmekte kullanılabilir.
|
Sınıflandırma |
Kümeleme |
|
|
Denetimli |
Evet |
Hayır |
|
Etiketli |
Evet |
Hayır |
|
Amaç |
Yeni girdilerin çıktısını tahmin etmekte kullanılabilmesi için, bir girdi kümesinden (X) ayrık bir çıktıya (y) eşleyen eşleme fonksiyonunu (f) yaklaşıklamak. |
Girdiler (X) içindeki temel kalıpları öğrenerek örneklerin ayrılabileceği grupları önermek. |
|
Algoritmalar |
Lojistik regresyon, K-en yakın komşu, Karar Ağacı, Rastgele Orman, Naive Bayes |
K-ortalamalar, birleştirici kümeleme, bölücü kümeleme, DBSCAN, OPTICS |
|
Kullanım alanları |
Müşteri kaybı, kredi onayı, spam filtreleme, yüz tanıma |
Pazar bölümlendirme, görüntü bölütleme, sosyal ağ analizi, öneri motorları. |
Sınıflandırma da kümeleme de örnekleri ayrık gruplara ayırmayı hedeflese de yaklaşımları temelde farklıdır. Sınıflandırma, önceden tanımlanmış etiketlere ve öğrenme sürecini yönlendiren bir denetleyiciye dayanır; bu da onu müşteri kaybı tahmini veya spam filtreleme gibi görevler için ideal kılar. Öte yandan, kümeleme bir denetleyici olmadan çalışır ve daha keşif odaklıdır; pazar bölümlendirme veya öneri sistemleri gibi alanlarda kullanılır. Bu nüansları anlamak, makine öğrenimi projenizin etkinliğini önemli ölçüde etkileyebilir.
Daha derine inmek ister misiniz? Anlayışınızı ve becerilerinizi geliştirmek için şu DataCamp kurslarına göz atın:
Sınıflandırma ve Kümelemeye Daha Derin Bir Giriş
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




