

Corso
Analisi di cluster in Python
4 ore
66.1K
Pratica and corso your progress.
Continua Con GoogleNel machine learning, esistono due tecniche per separare gli oggetti in gruppi distinti: classificazione e clustering. Questo spesso genera parecchia confusione tra chi è alle prime armi.
In superficie, classificazione e clustering sembrano simili. Entrambe utilizzano algoritmi che sfruttano le caratteristiche di un dataset per scoprire pattern e separare le istanze in gruppi distinti. Ma, dal punto di vista pratico, sono piuttosto diverse.
In questo articolo analizzeremo ciascuna tecnica, i diversi algoritmi associati, le loro applicazioni e, soprattutto, in cosa differiscono.
I compiti di classificazione rientrano in una categoria di problemi chiamata “apprendimento supervisionato”. Questi problemi implicano lo sviluppo di modelli che apprendono dai dati storici per fare previsioni su nuove istanze.
Più formalmente, i compiti di apprendimento supervisionato sono problemi in cui si apprende una funzione che mappa un input a un output sulla base di coppie input–output di esempio. L’obiettivo è quindi approssimare la funzione di mappatura (f) dagli input (X) all’output (y) — se hai un background matematico, potresti conoscerlo come problema di approssimazione di funzioni.
È importante notare che l’apprendimento supervisionato si presenta in due forme diverse: regressione e classificazione.
Nei problemi di classificazione, l’obiettivo dell’algoritmo di apprendimento è approssimare la funzione di mappatura da un insieme di feature per predire un output discreto (cioè, prevedere se l’immagine è un gatto o un cane) — nel nostro tutorial Capire la classificazione del testo in Python trovi una dimostrazione pratica.
Esistono diversi problemi che implicano l’applicazione di algoritmi di classificazione, come ad esempio:
Vediamo alcuni algoritmi di classificazione.
Spesso, comprensibilmente, si scambia la regressione logistica per un algoritmo di regressione. Tecnicamente, non è sbagliato. La regressione logistica non esegue la classificazione statistica. Si limita a stimare i parametri di un modello logistico.
Il motivo per cui possiamo usare la regressione logistica per la classificazione è dovuto a una frontiera di decisione inserita per separare le classi. Dunque, nella sua forma più semplice, la regressione logistica utilizza una funzione logistica per modellare variabili dipendenti binarie.
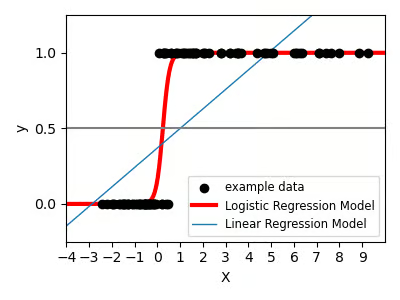
Fonte: Funzione logistica di Scikit-Learn
KNN è uno degli algoritmi di machine learning meno complessi e si differenzia dalla regressione logistica perché può essere usato sia per compiti di classificazione sia di regressione.
In particolare, è un algoritmo non parametrico e “pigro”. Ciò significa che KNN non fa assunzioni sulle caratteristiche del campione o sul fatto che i dati osservati siano quantitativi o qualitativi (non parametrico), e tutta la computazione è rimandata alla fase di valutazione della funzione (lazy learner).
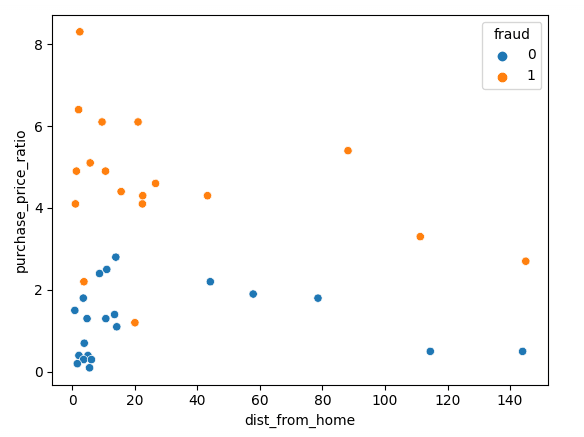
Fonte: Nearest Neighbors con Scikit-learn
L’algoritmo dell’albero decisionale è un popolare algoritmo non parametrico capace di eseguire sia regressione sia classificazione. Gran parte della sua popolarità deriva dall’intelligibilità e semplicità — è uno degli algoritmi più facili da visualizzare e interpretare.
Concettualmente, puoi considerare un albero decisionale come un flusso che va dalla radice alle foglie. Il percorso dalla radice a una foglia definisce una regola decisionale basata sulle feature.
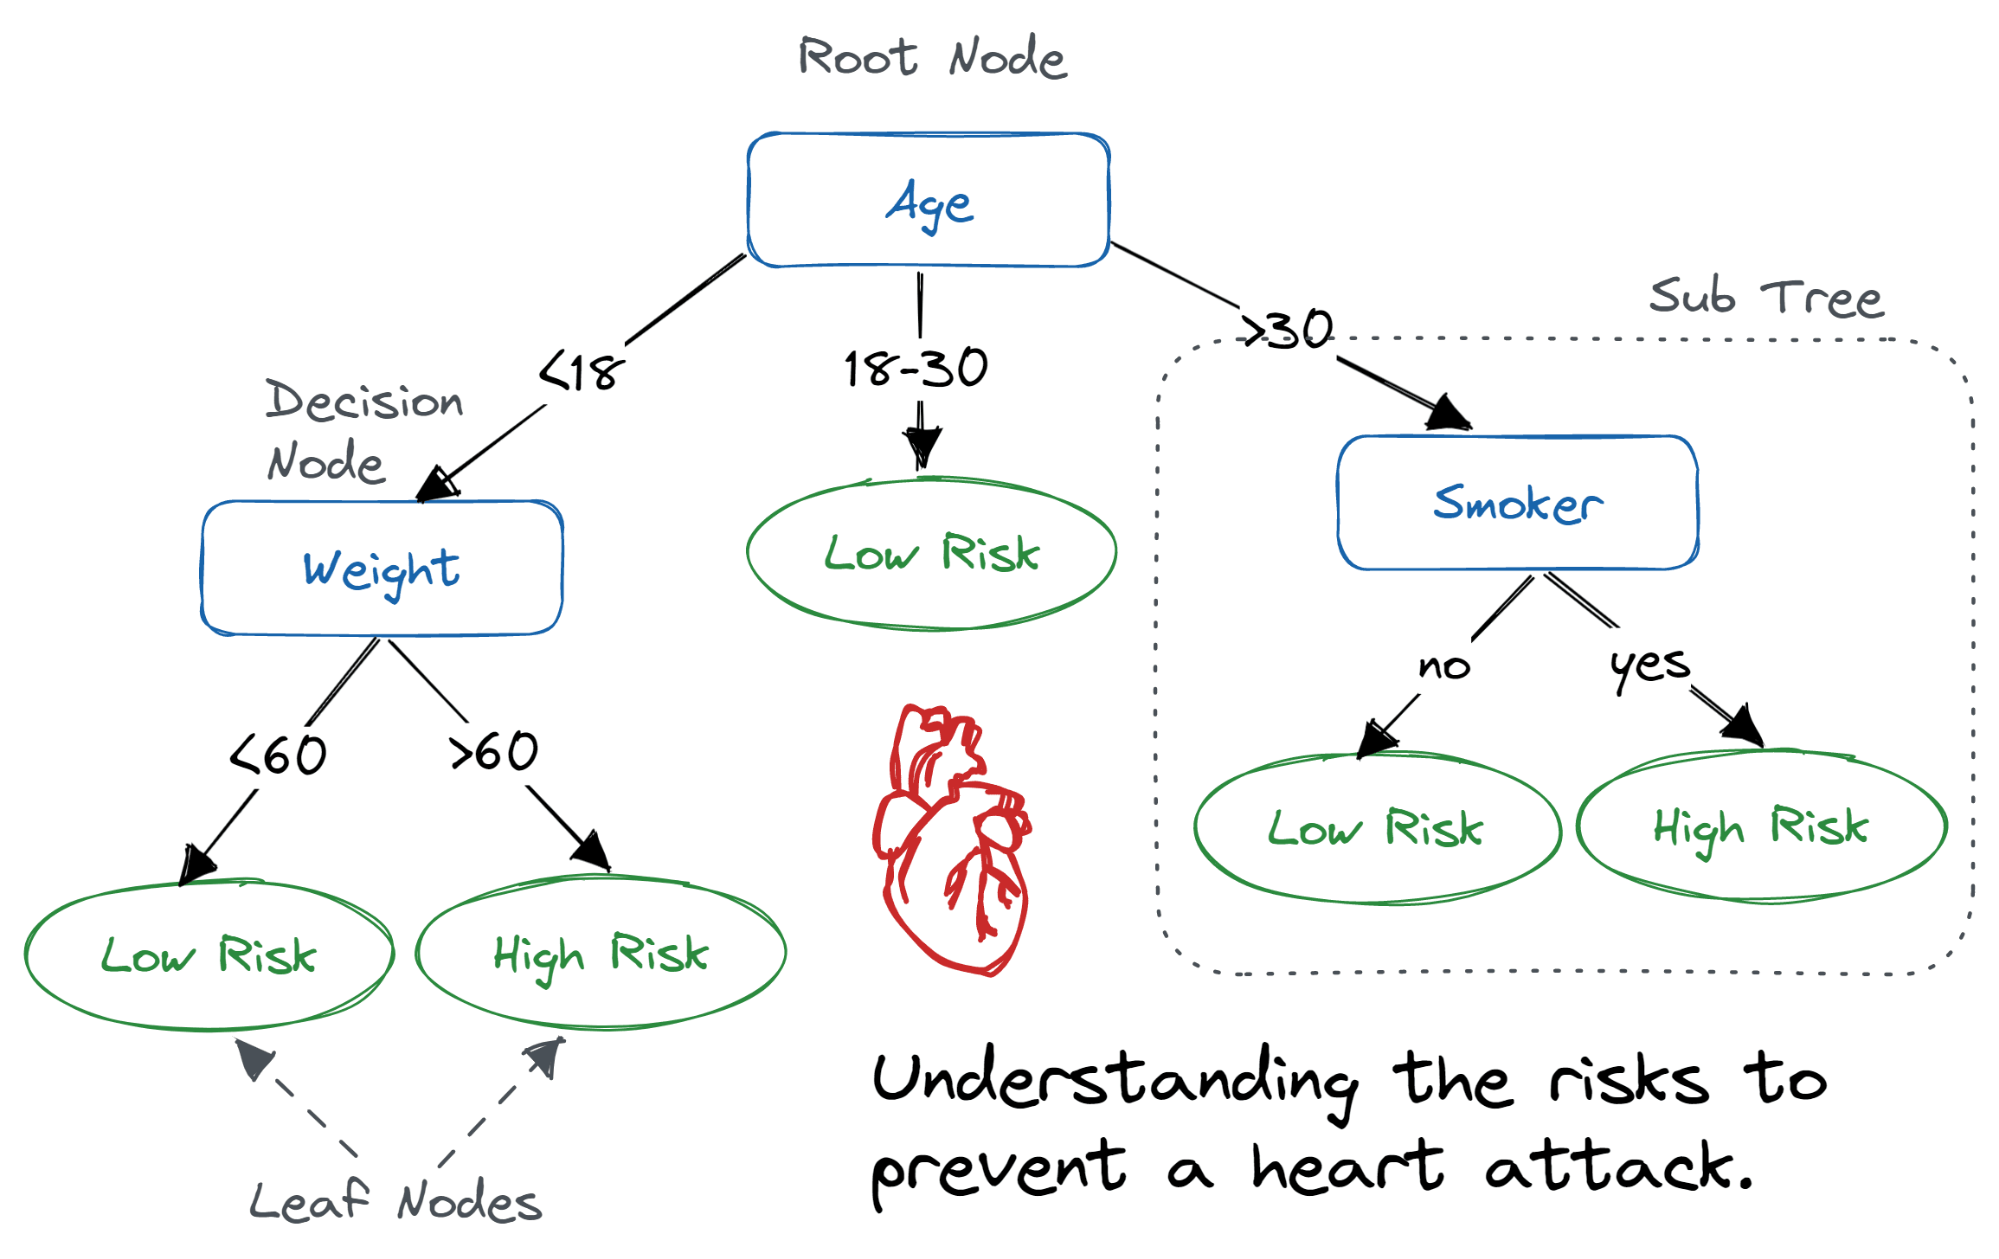
Fonte: Tutorial sulla classificazione con alberi decisionali in Python
La random forest è un modello ensemble composto da due o più alberi decisionali. La tecnica sfrutta il bootstrap aggregation e il metodo della sotto-spazio casuale per far crescere i singoli alberi, al fine di ottenere un potente predittore aggregato capace sia di classificazione sia di regressione.
Nota: il bootstrap aggregation, o bagging, è semplicemente una tecnica usata per generare più versioni di un predittore che possono essere sfruttate per costruire un predittore aggregato. L’obiettivo è ridurre la correlazione tra i predittori per ottenere un modello aggregato che generalizzi meglio.
La casualità viene introdotta in ciascun predittore campionando casualmente istanze dal set di training con reinserimento e utilizzando i dati bootstrap per l’addestramento.
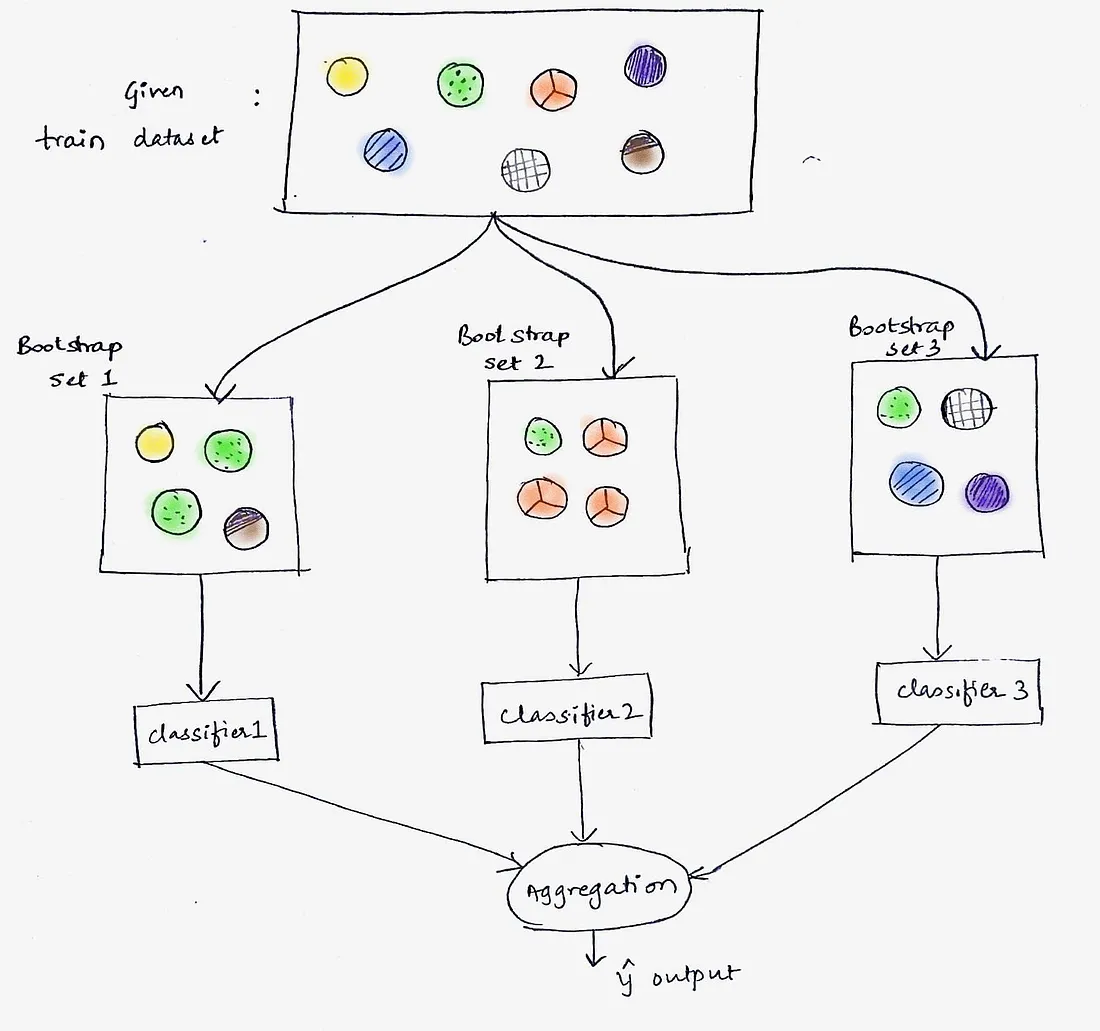
Fonte: Bagging: Machine Learning through visuals. #1: What is “Bagging” ensemble learning?
Il metodo del sotto-spazio casuale è usato anch’esso per ridurre la correlazione tra i predittori all’interno dell’ensemble. Spesso è chiamato “feature bagging” perché adotta lo stesso approccio del bagging, ma con le feature. In altre parole: il metodo del sotto-spazio casuale riduce la correlazione costruendo ciascun predittore dell’ensemble su un campione casuale delle feature con reinserimento.
Il classificatore Naive Bayes è un algoritmo probabilistico basato sul teorema di Bayes, una regola matematica per aggiornare le probabilità alla luce di nuovi dati.
Nel contesto di Naive Bayes, l’assunzione “ingenua” è che tutte le feature (o variabili) nel dataset siano indipendenti tra loro quando si predice l’esito. Si tratta di una semplificazione perché, in realtà, le feature possono essere dipendenti. Tuttavia, nonostante questa assunzione, l’algoritmo spesso offre prestazioni sorprendentemente buone in molti compiti di classificazione.
Dunque, il teorema di Bayes in sé non fa alcuna assunzione sull’indipendenza delle variabili. È il classificatore Naive Bayes a fare questa assunzione per semplicità ed efficienza computazionale.
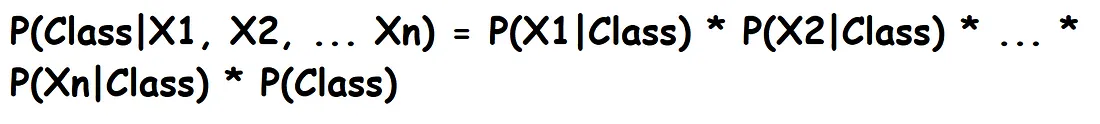
Per capire il clustering, bisogna partire dalla definizione di apprendimento non supervisionato. L’apprendimento non supervisionato è un approccio usato per scoprire la struttura sottostante dei dati, ma gli algoritmi non supervisionati non richiedono mappature input–output per riuscirci.
L’apprendimento non supervisionato è tipicamente sfruttato per scoprire pattern esistenti nei dati in modo che le istanze siano raggruppate senza bisogno di etichette. Si assume che le istanze che ricadono nello stesso gruppo abbiano feature simili. Così, il clustering è una tecnica di apprendimento non supervisionato usata per raggruppare dati non etichettati in base alle loro somiglianze o differenze.
Alcuni casi d’uso del clustering includono:
Ecco alcuni diversi tipi di algoritmi di clustering:
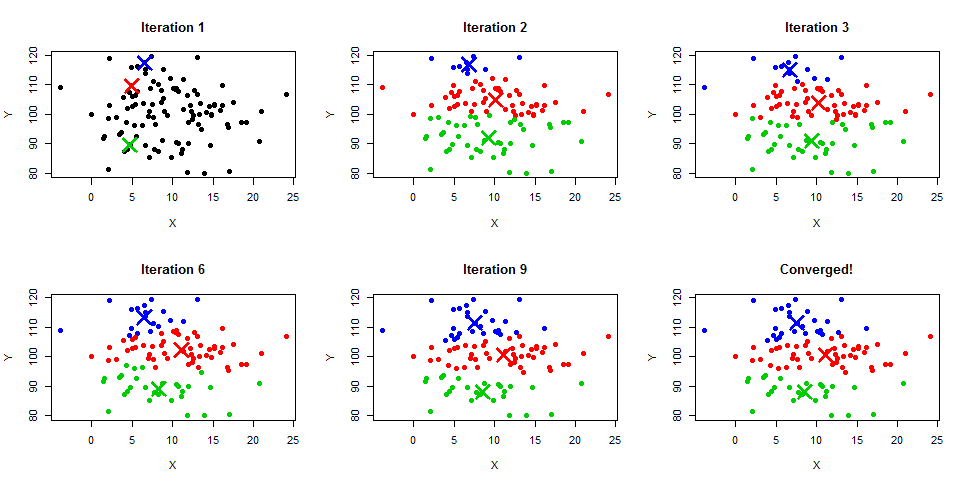
Uno degli algoritmi più popolari e ampiamente utilizzati per compiti di clustering è il k-means. È un algoritmo basato sui centroidi, iterativo, che crea cluster non sovrapposti.
Un altro modo per costruire cluster è creare una gerarchia di cluster, da cui il nome “clustering gerarchico”. Ci sono due modi per costruire una gerarchia di cluster: .
Agglomerativo
È un approccio bottom-up in cui, nelle fasi iniziali, ogni osservazione è trattata come un proprio cluster. Man mano che la gerarchia viene costruita dal basso verso l’alto, ogni osservazione viene unita a coppie e le coppie vengono fuse in cluster.
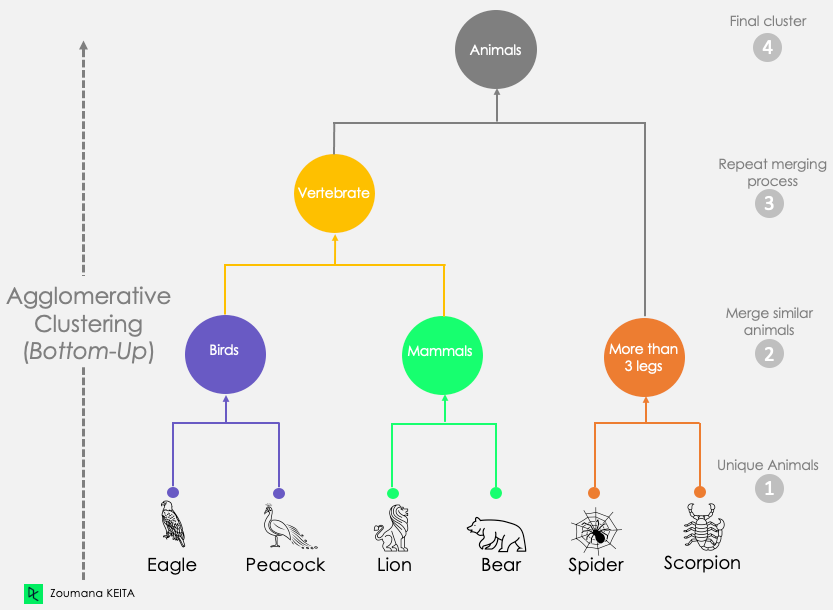
Fonte: Un’introduzione al clustering gerarchico in Python
Divisivo
Il clustering divisivo è un approccio top-down in cui tutte le osservazioni partono in un unico cluster e si eseguono suddivisioni ricorsive per costruire la gerarchia dall’alto verso il basso.
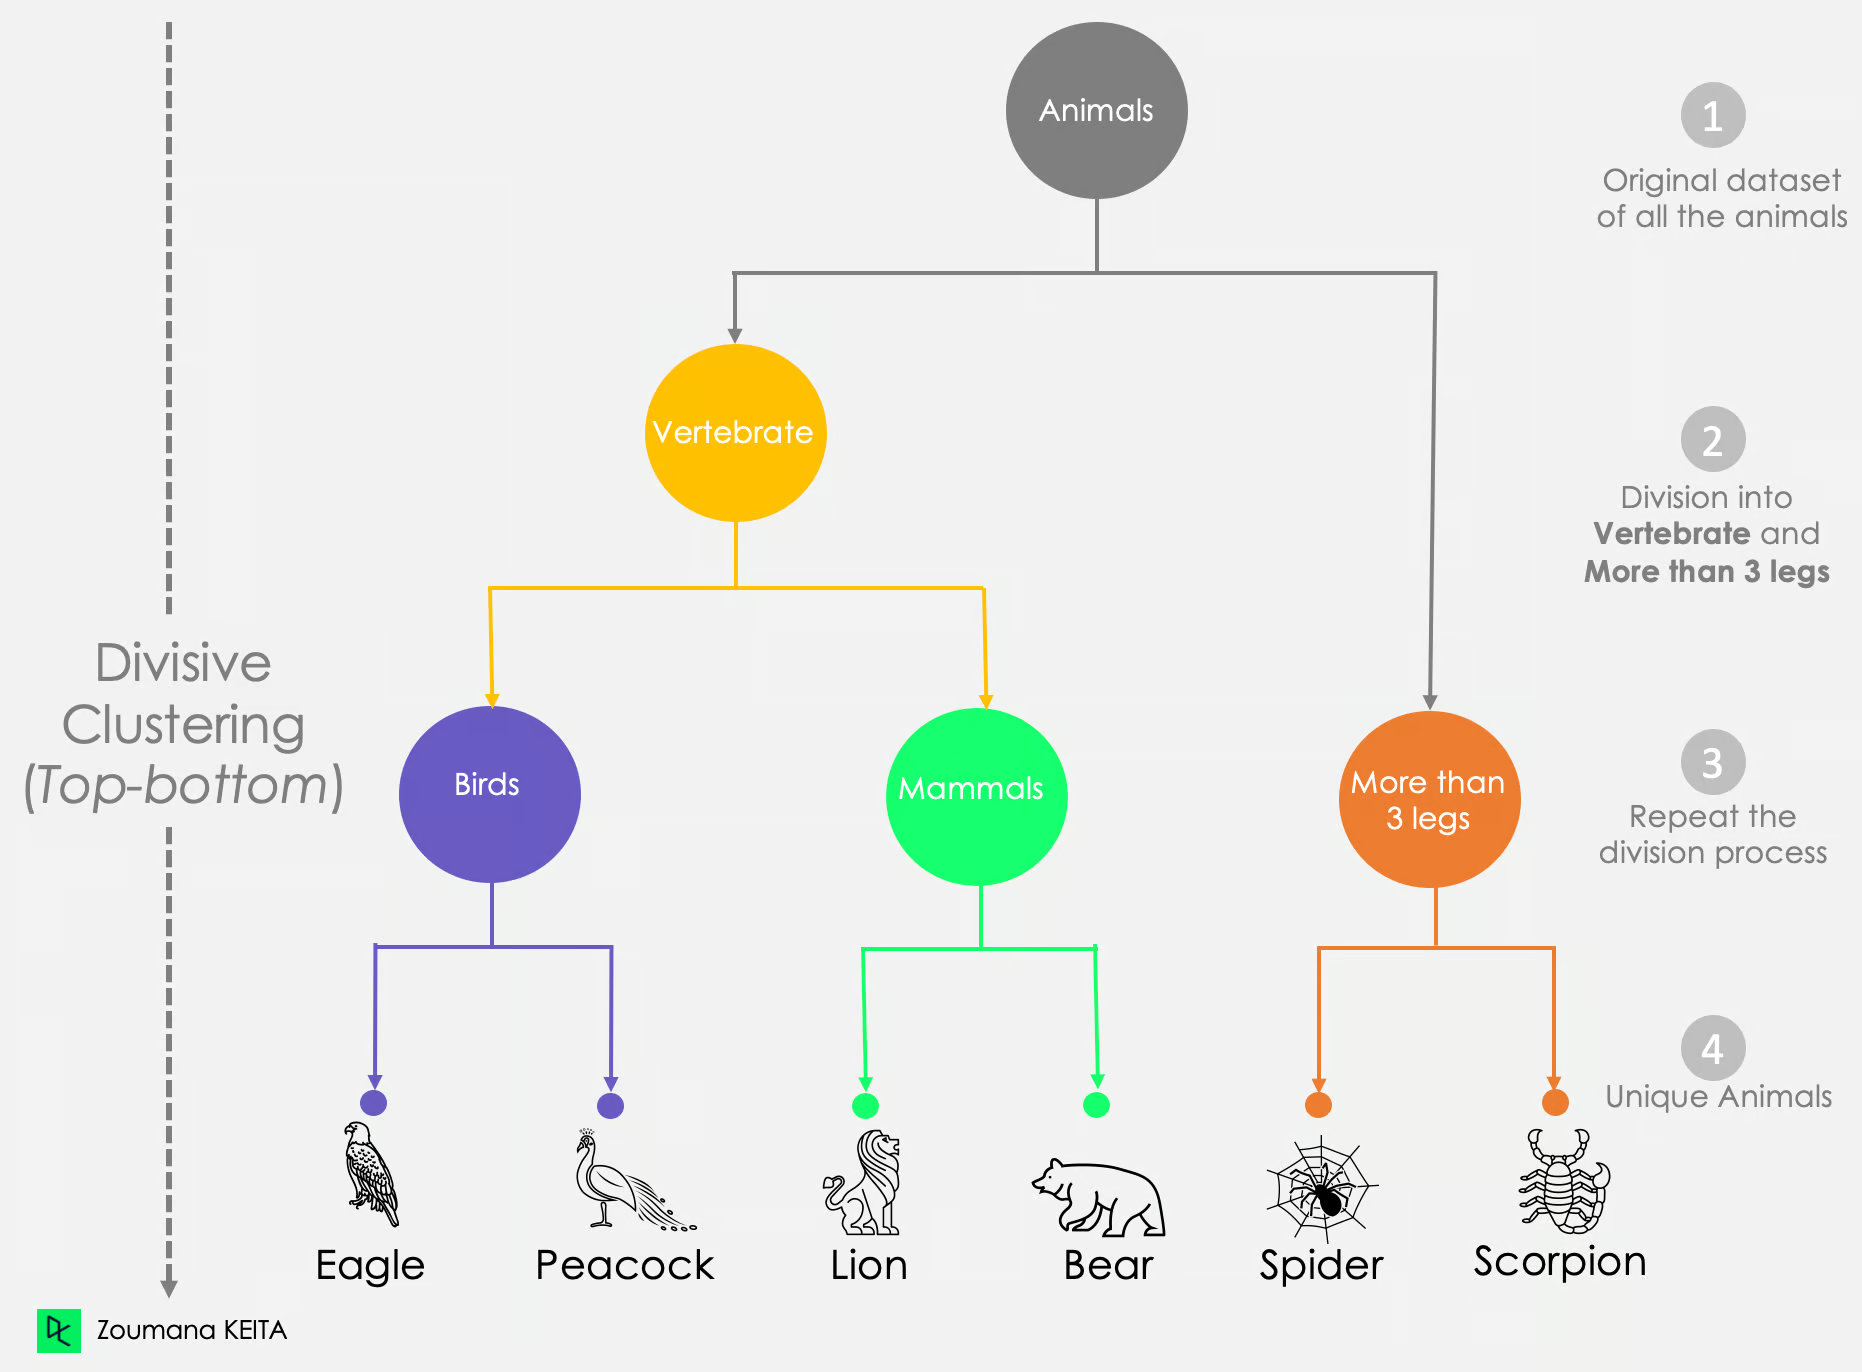
Fonte: Un’introduzione al clustering gerarchico in Python
Uno dei grandi punti di forza di Density-Based Spatial Clustering of Applications with Noise, o DBSCAN, è la robustezza agli outlier — è anche l’algoritmo di clustering basato sulla densità più noto.
DBSCAN assume che i cluster siano regioni dense nello spazio separate da regioni a densità più bassa. A differenza di K-Means, DBSCAN deduce il numero di cluster dai dati e può scoprire cluster di forma arbitraria, quindi il numero di cluster non deve essere passato come parametro.
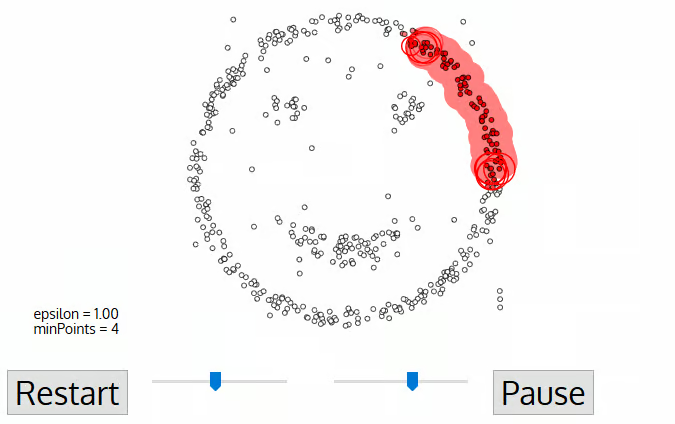
OPTICS è l’acronimo di Ordering Points to Identify the Clustering Structure. Come DBSCAN, è un algoritmo basato sulla densità sviluppato dallo stesso gruppo di ricerca. Tuttavia, OPTICS cerca di superare una delle principali criticità di DBSCAN — identificare cluster in dati con densità variabile — abbandonando l’assunzione che la densità dei dati sia uniforme.
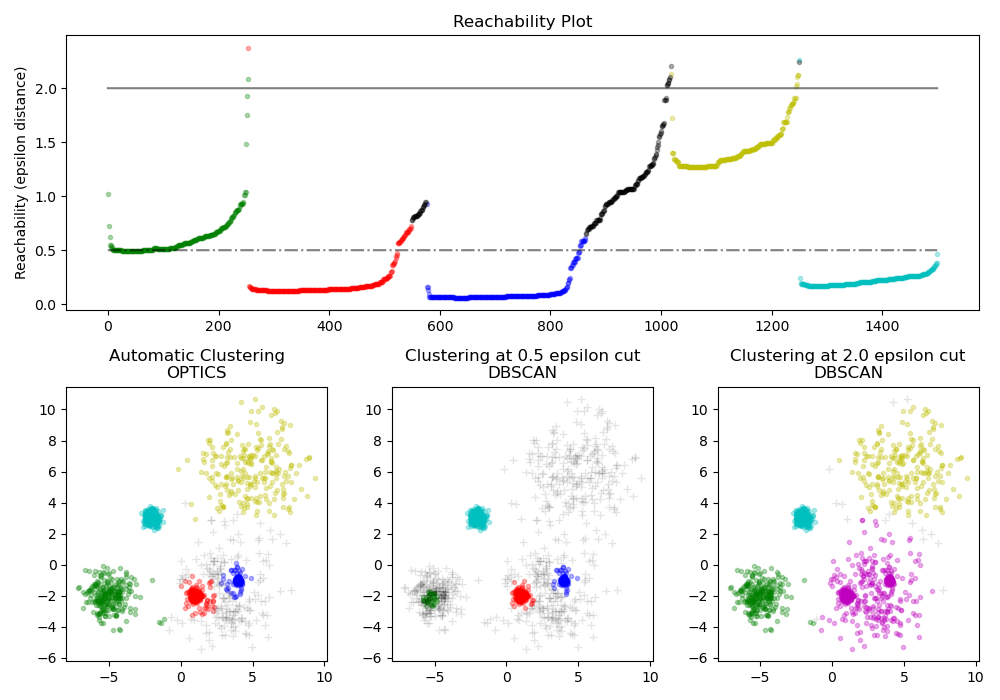
Fonte: Demo Scikit-learn dell’algoritmo di clustering OPTICS
La classificazione è una forma di apprendimento supervisionato. I problemi di apprendimento supervisionato implicano l’apprendimento di una funzione che mappa un input a un output sulla base di coppie input–output. Al contrario, i compiti di apprendimento non supervisionato impiegano metodi, come il clustering, per scoprire pattern nascosti in dati non etichettati.
Sia i compiti di classificazione sia quelli di clustering richiedono dati di training per apprendere i pattern. Tuttavia, è buona pratica disporre di dati di test per i compiti di classificazione per valutare le prestazioni delle previsioni del modello di machine learning.
Gli algoritmi di clustering dipendono dai dati in input per modellare la struttura sottostante e scoprire insight. In altre parole, non c’è un “insegnante” che informi l’algoritmo delle risposte corrette — conta solo ciò che l’algoritmo apprende. Al contrario, gli algoritmi di classificazione richiedono dati di input e output per apprendere la funzione di mappatura, in modo da poter predire l’output di nuovi dati in input.
|
Classificazione |
Clustering |
|
|
Supervisionato |
Sì |
No |
|
Etichettato |
Sì |
No |
|
Scopo |
Approssimare la funzione di mappatura (f) da un insieme di input (X) a un output discreto (y) in modo che possa essere usata per prevedere l’output di nuovi input. |
Apprendere i pattern sottostanti negli input (X) per suggerire i gruppi in cui le istanze possono essere suddivise. |
|
Algoritmi |
Regressione logistica, K-nearest neighbors, Alberi decisionali, Random forest, Naive Bayes |
K-means, clustering agglomerativo, clustering divisivo, DBSCAN, OPTICS |
|
Casi d’uso |
Churn dei clienti, approvazione dei prestiti, filtraggio dello spam, riconoscimento facciale |
Segmentazione del mercato, segmentazione delle immagini, analisi dei social network, motori di raccomandazione. |
Sebbene sia la classificazione sia il clustering mirino a suddividere le istanze in gruppi discreti, i loro approcci sono profondamente diversi. La classificazione si basa su etichette predefinite e su un supervisore che guida il processo di apprendimento, rendendola ideale per compiti come la previsione del churn dei clienti o il filtraggio dello spam. Il clustering, invece, opera senza supervisore ed è più esplorativo, trovando applicazione nella segmentazione del mercato o nei sistemi di raccomandazione. Comprendere queste sfumature può incidere in modo significativo sull’efficacia del tuo progetto di machine learning.
Vuoi approfondire? Dai un’occhiata a questi corsi DataCamp per migliorare comprensione e competenze:
Approfondisci: introduzione a classificazione e clustering
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



