
Cours
Analyse de clusters en Python
4 h
65.8K
En apprentissage automatique, deux approches permettent de regrouper des objets en ensembles distincts : la classification et le clustering. De quoi semer la confusion chez nombre de débutants.
À première vue, classification et clustering semblent proches. Dans les deux cas, des algorithmes exploitent les caractéristiques d’un jeu de données pour déceler des motifs et séparer les observations en groupes distincts. Dans la pratique, toutefois, ces méthodes diffèrent sensiblement.
Dans cet article, nous passons en revue chaque technique, les algorithmes associés, leurs applications et, surtout, ce qui les distingue.
Les problèmes de classification relèvent de l’apprentissage supervisé. L’objectif est de concevoir des modèles qui apprennent à partir de données historiques pour prédire de nouveaux cas.
Plus formellement, en apprentissage supervisé, on apprend une fonction qui associe une entrée à une sortie à partir d’exemples d’entrées-sorties. L’objectif est donc d’approximer la fonction d’application (f) des entrées (X) vers la sortie (y) — si vous avez un bagage en mathématiques, vous reconnaîtrez là un problème d’approximation de fonction.
L’apprentissage supervisé se décline en deux grandes familles : la régression et la classification.
En classification, l’algorithme apprend une fonction de projection depuis un ensemble de caractéristiques afin de prédire une sortie discrète (par exemple, déterminer si une image montre un chat ou un chien) — consultez notre tutoriel Understanding text classification in Python pour une mise en pratique.
Voici quelques exemples d’applications de la classification :
Voyons quelques algorithmes de classification.
On confond souvent, à juste titre, la régression logistique avec un algorithme de régression. Techniquement, ce n’est pas faux : la régression logistique n’effectue pas la classification statistique à proprement parler, elle estime les paramètres d’un modèle logistique.
Si l’on peut l’employer en classification, c’est grâce à une frontière de décision qui sépare les classes. Dans sa forme la plus simple, la régression logistique utilise une fonction logistique pour modéliser des variables dépendantes binaires.
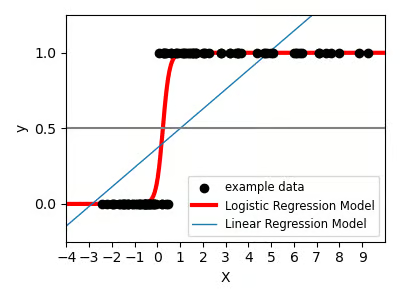
Source : Logistic Function by Scikit-Learn
KNN est l’un des algorithmes d’apprentissage automatique les plus simples et, contrairement à la régression logistique, il s’applique aussi bien à la classification qu’à la régression.
C’est un algorithme non paramétrique et à apprentissage paresseux (lazy learning). Autrement dit, KNN ne fait pas d’hypothèses sur la distribution des données ni sur la nature quantitative/qualitative des variables (non paramétrique), et reporte les calculs au moment de l’évaluation (apprentissage paresseux).
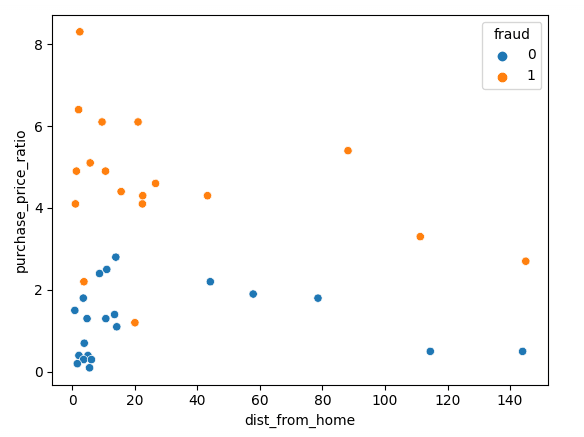
Source : Nearest Neighbors with Scikit-learn
L’algorithme d’arbre de décision est un algorithme non paramétrique très populaire, capable de faire à la fois de la régression et de la classification. Sa popularité tient à sa lisibilité et à sa simplicité — c’est l’un des modèles les plus faciles à visualiser et interpréter.
Conceptuellement, on peut voir un arbre de décision comme un flux allant de la racine vers les feuilles. Le chemin de la racine à une feuille définit une règle de décision sur les caractéristiques.
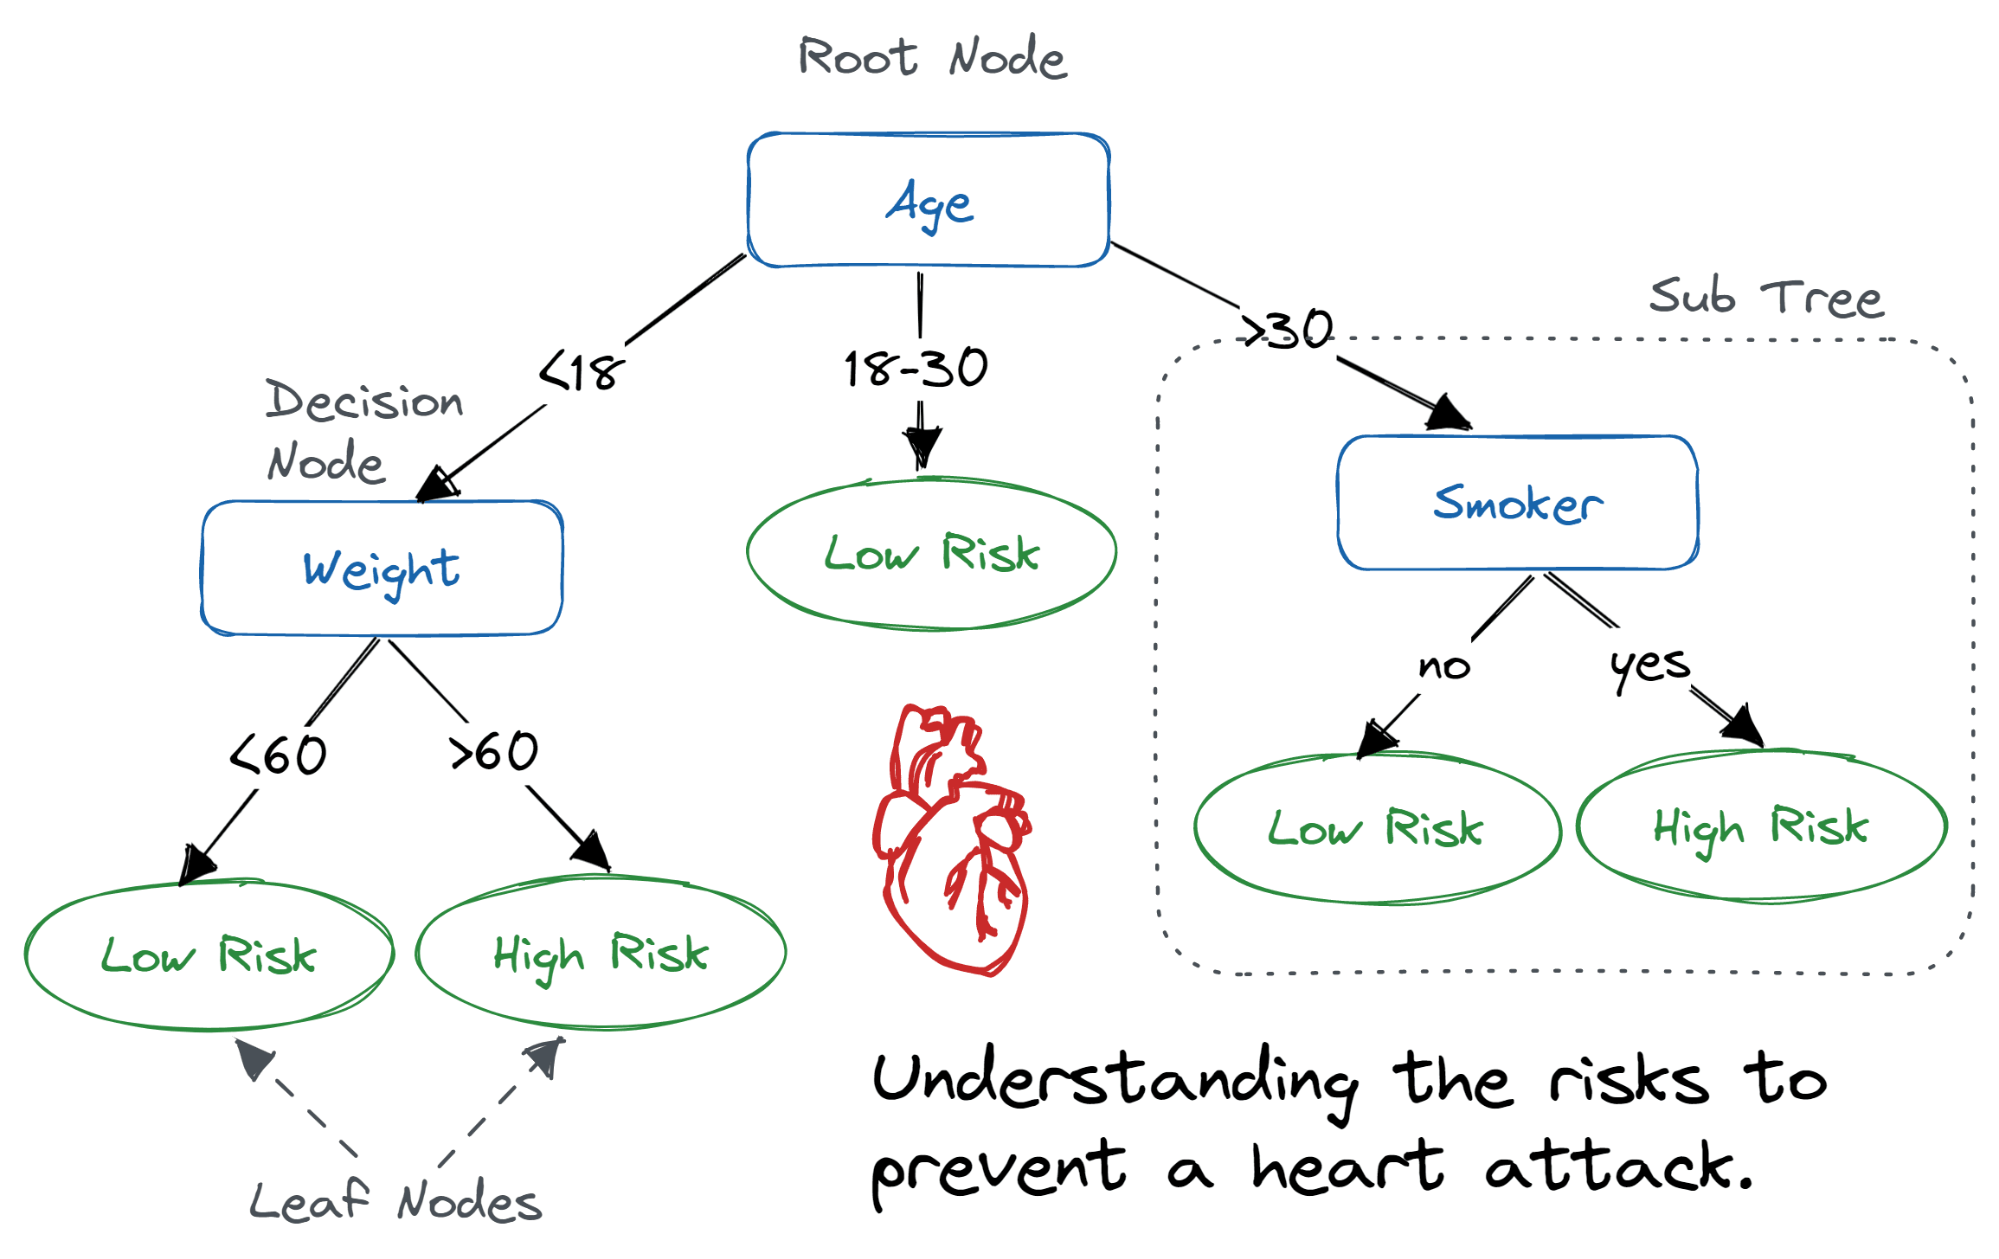
Source : Decision Tree Classification in Python Tutorial
La forêt aléatoire est un modèle d’assemblage composé de deux arbres de décision ou plus. Elle combine le bootstrap aggregation (bagging) et la méthode des sous-espaces aléatoires pour faire croître des arbres individuels et obtenir un prédicteur agrégé performant, utilisable en classification comme en régression.
Le bagging consiste à générer plusieurs versions d’un même prédicteur pour construire un modèle agrégé. L’objectif est de réduire la corrélation entre prédicteurs afin d’améliorer la généralisation.
On introduit de l’aléa en échantillonnant avec remise des observations du jeu d’apprentissage, puis en entraînant chaque prédicteur sur ces échantillons bootstrappés.
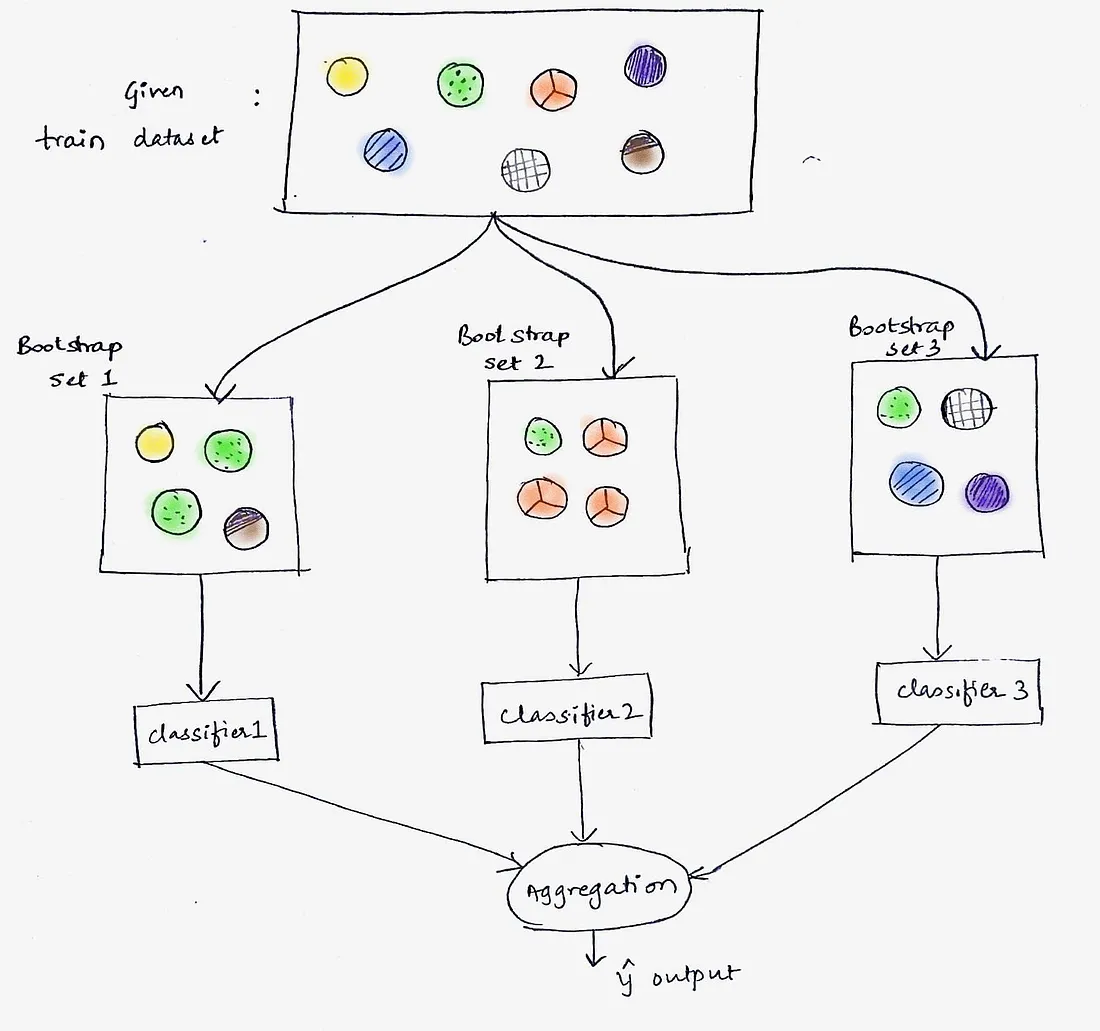
Source : Bagging: Machine Learning through visuals. #1: What is “Bagging” ensemble learning?
La méthode des sous-espaces aléatoires contribue également à réduire la corrélation au sein de l’ensemble. Par analogie, on parle de « feature bagging » : chaque prédicteur de l’ensemble est construit sur un échantillon aléatoire de caractéristiques, avec remise.
Le classifieur Naive Bayes est un algorithme probabiliste fondé sur le théorème de Bayes, une règle mathématique qui met à jour des probabilités à la lumière de nouvelles données.
Dans Naive Bayes, l’hypothèse « naïve » suppose l’indépendance des caractéristiques entre elles pour prédire l’issue. C’est une simplification — en réalité, des dépendances existent —, mais malgré cela, l’algorithme obtient souvent d’excellents résultats en classification.
À noter : le théorème de Bayes ne suppose pas l’indépendance des variables. C’est le classifieur Naive Bayes qui fait cette hypothèse pour des raisons de simplicité et d’efficacité de calcul.
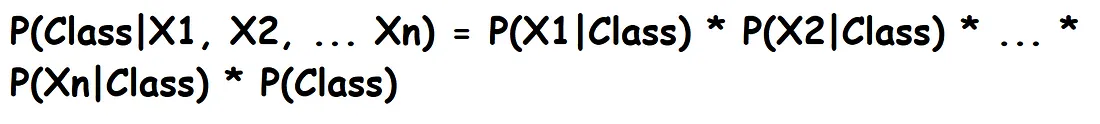
Pour comprendre le clustering, partons de la définition de l’apprentissage non supervisé. C’est une approche qui vise à découvrir la structure sous-jacente des données, sans exiger de correspondances entrée‑sortie.
On l’utilise pour mettre au jour des motifs existants et regrouper des observations sans étiquettes. L’hypothèse est que des observations d’un même groupe partagent des caractéristiques similaires. Ainsi, le clustering est une technique non supervisée qui regroupe des données non étiquetées selon leurs similarités ou leurs différences.
Exemples d’usage du clustering :
Voici quelques algorithmes de clustering :
Parmi les plus populaires pour le clustering, k-means est un algorithme itératif, centré sur des centroïdes, qui produit des clusters non chevauchants.
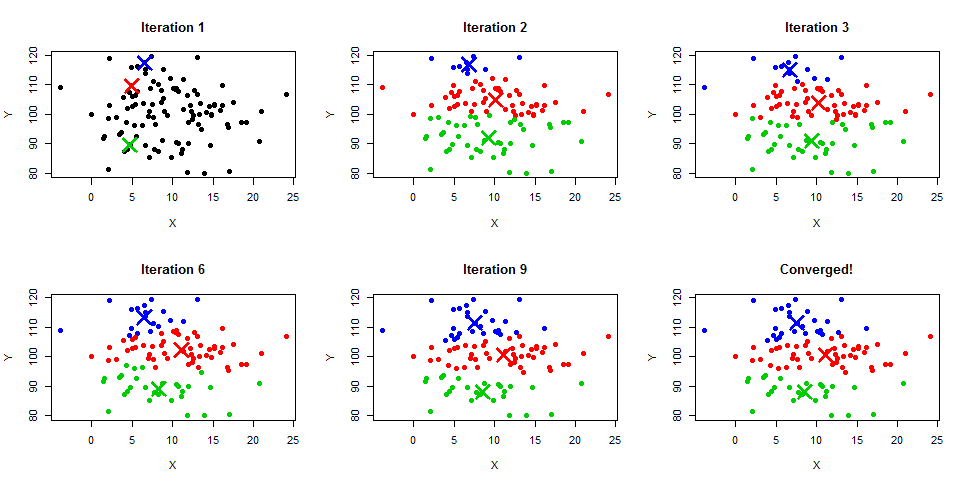
Autre voie : construire une hiérarchie de groupes, d’où le nom « clustering hiérarchique ». Deux approches existent :
Agglomératif
Approche ascendante : chaque observation forme d’abord son propre cluster. En remontant la hiérarchie, on fusionne d’abord les observations par paires, puis les paires en clusters.
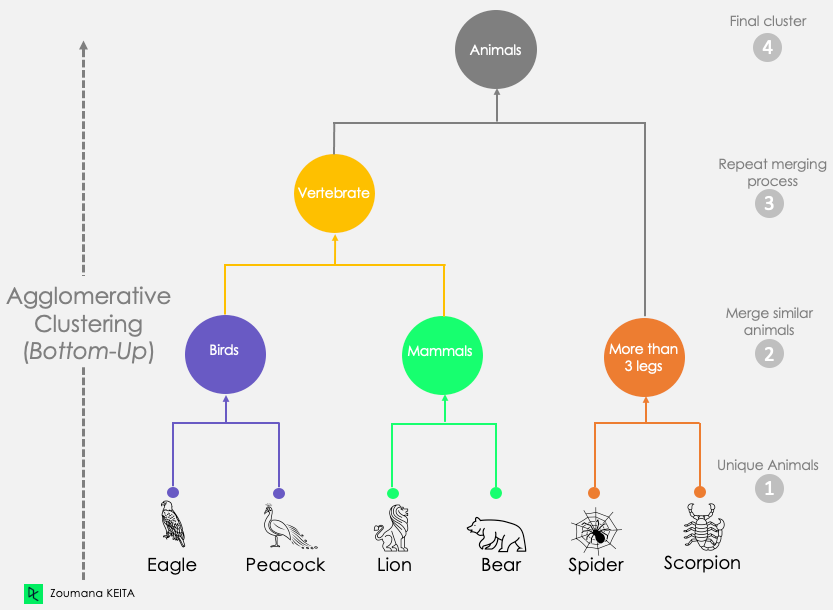
Source : An introduction to Hierarchical clustering in Python
Divisif
Approche descendante : toutes les observations commencent dans un seul cluster, puis on effectue des divisions récursives pour construire la hiérarchie du haut vers le bas.
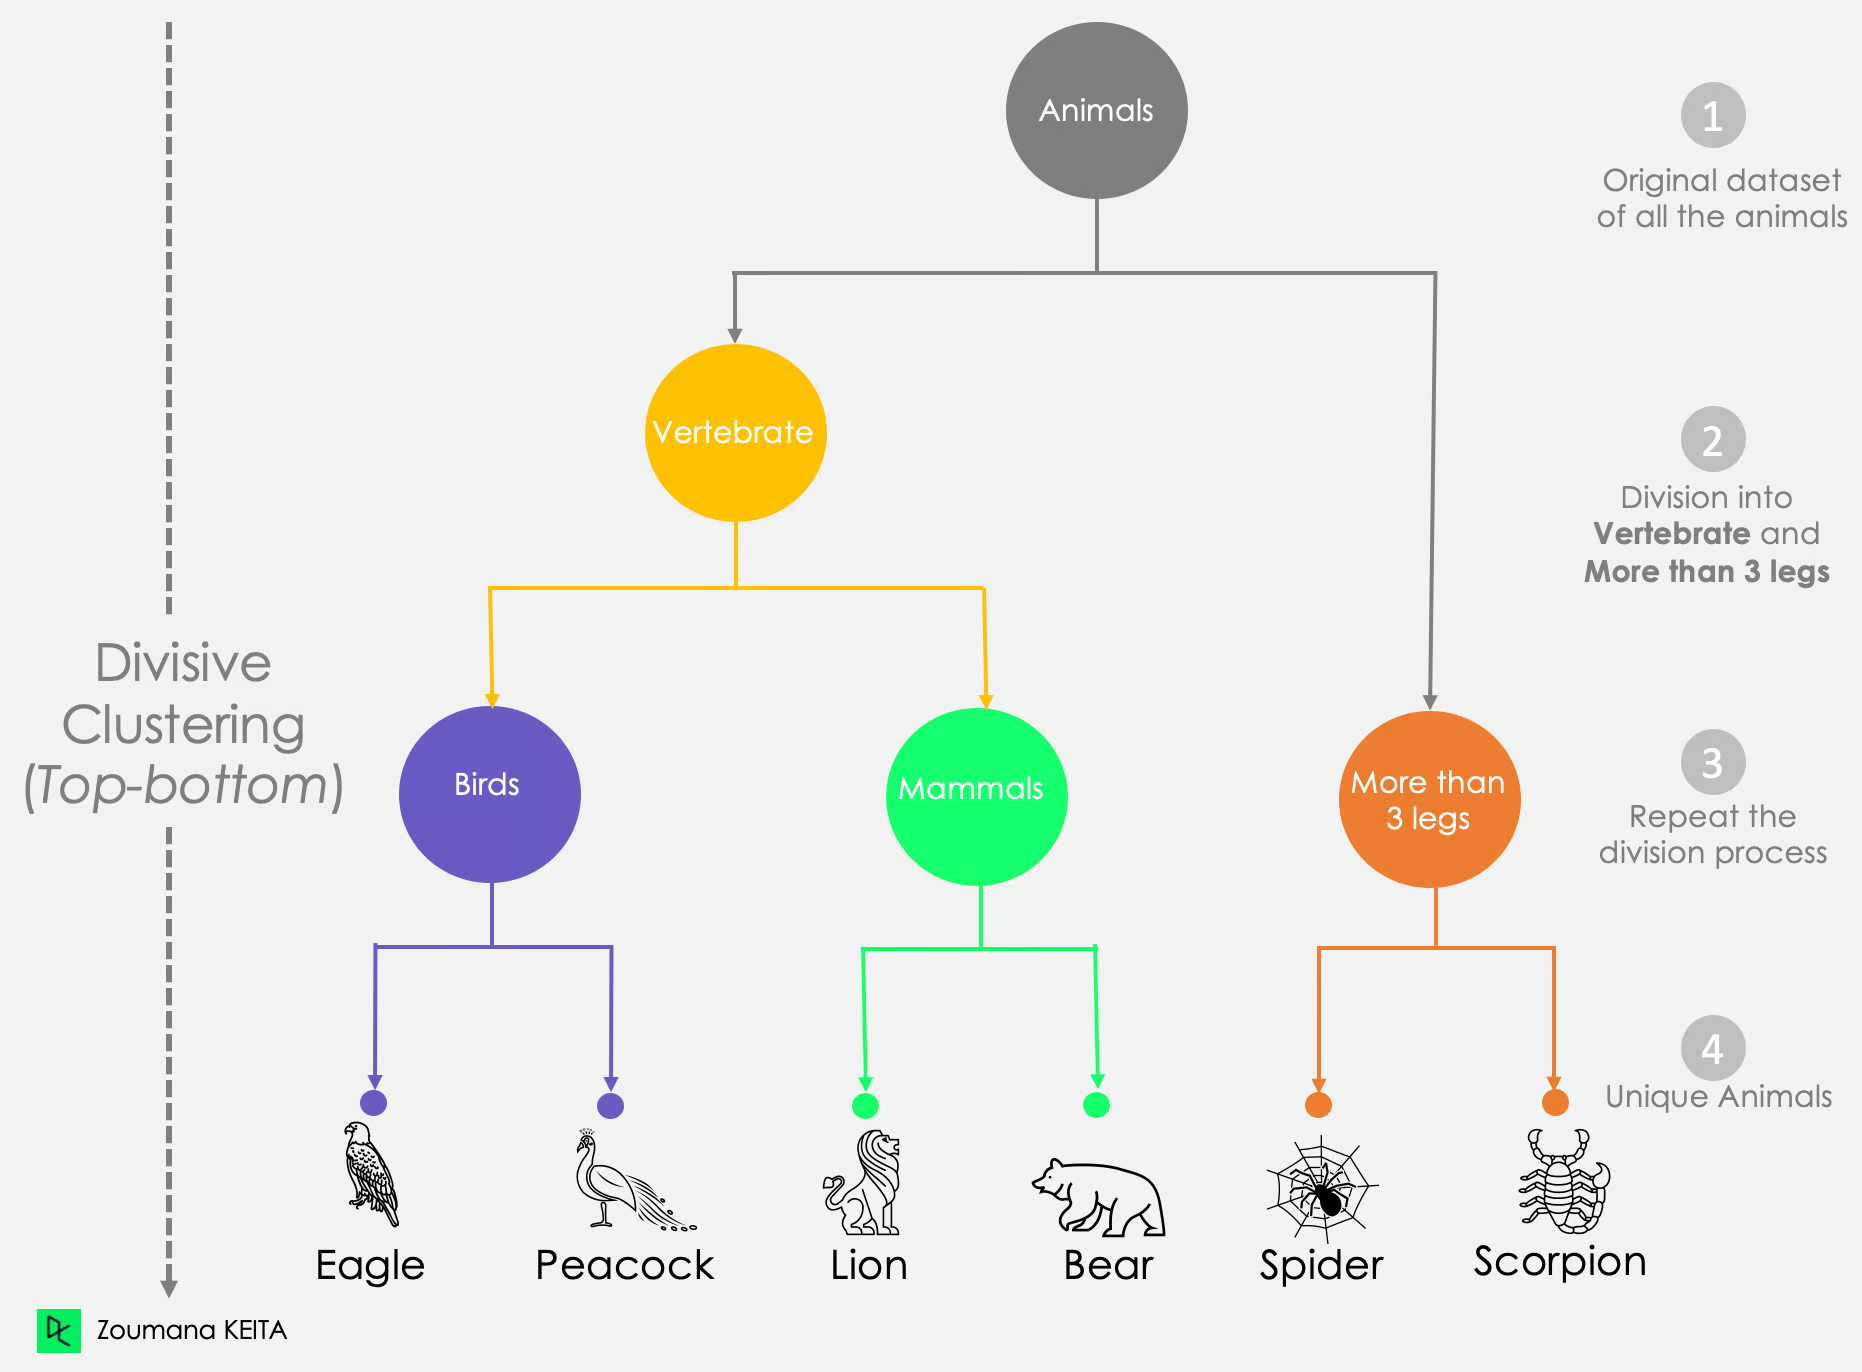
Source : An introduction to Hierarchical clustering in Python
L’un des grands atouts de Density-Based Spatial Clustering of Applications with Noise (DBSCAN) est sa robustesse aux valeurs aberrantes — c’est aussi l’algorithme de clustering par densité le plus connu.
DBSCAN suppose que les clusters sont des régions denses séparées par des zones moins denses. Contrairement à k-means, DBSCAN déduit le nombre de clusters des données et peut découvrir des formes arbitraires ; il n’est donc pas nécessaire de renseigner le nombre de clusters en paramètre.
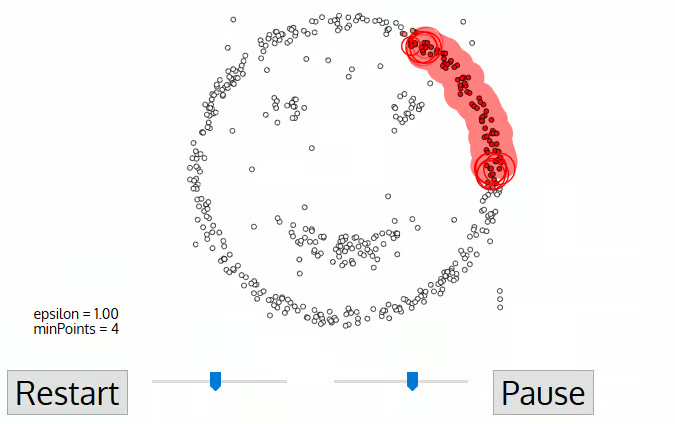
OPTICS signifie « Ordering Points To Identify the Clustering Structure ». Comme DBSCAN, c’est un algorithme par densité, conçu par le même groupe de recherche. Il corrige toutefois un écueil majeur de DBSCAN — l’identification de clusters dans des données de densité variable — en levant l’hypothèse de densité uniforme.
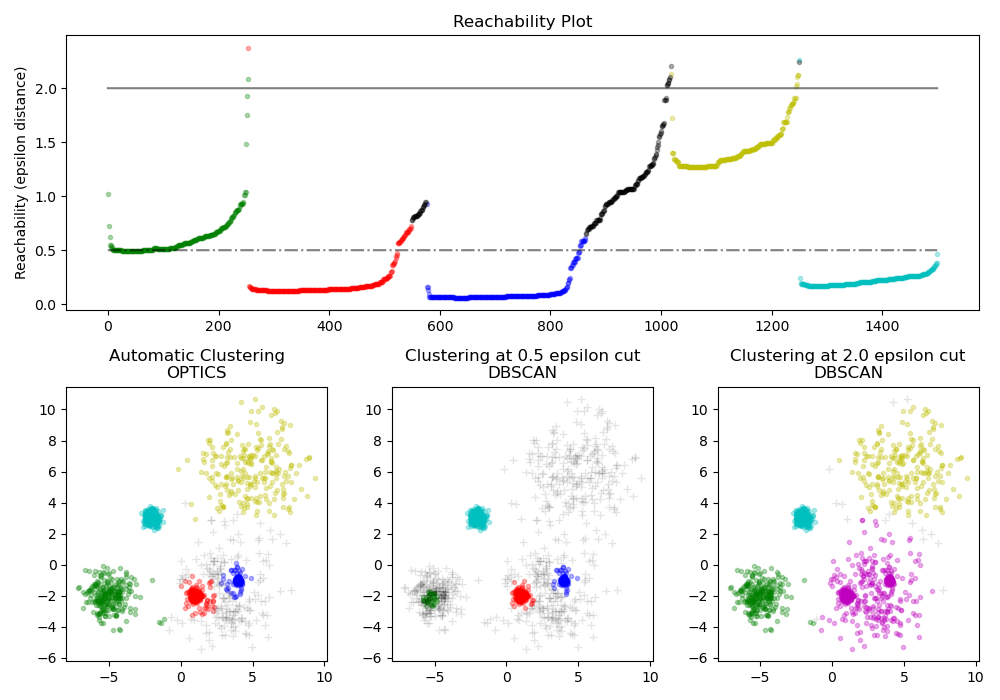
Source : Scikit-learn Demo of OPTICS clustering algorithm
La classification relève de l’apprentissage supervisé : on apprend une fonction qui associe des entrées à des sorties à partir de paires entrée‑sortie. À l’inverse, les tâches non supervisées, comme le clustering, cherchent des motifs cachés dans des données non étiquetées.
Classification et clustering s’appuient tous deux sur des données d’entraînement pour apprendre des schémas. Toutefois, pour la classification, il est recommandé de disposer d’un jeu de test afin d’évaluer les performances prédictives du modèle.
Les algorithmes de clustering utilisent les données en entrée pour modéliser leur structure sous-jacente et en tirer des insights — sans « enseignant » pour fournir les bonnes réponses : seul l’apprentissage de l’algorithme compte. À l’inverse, les algorithmes de classification exigent données d’entrée et de sortie pour apprendre la fonction d’application, afin de prédire la sortie de nouvelles entrées.
|
Classification |
Clustering |
|
|
Supervisé |
Oui |
Non |
|
Étiqueté |
Oui |
Non |
|
But |
Approcher la fonction d’application (f) d’un ensemble d’entrées (X) vers une sortie discrète (y) afin de prédire la sortie de nouvelles entrées. |
Apprendre les motifs sous-jacents des entrées (X) pour suggérer les groupes dans lesquels les observations peuvent être séparées. |
|
Algorithmes |
Régression logistique, k-plus proches voisins, arbre de décision, forêt aléatoire, Naive Bayes |
K-means, clustering agglomératif, clustering divisif, DBSCAN, OPTICS |
|
Cas d’usage |
Churn client, octroi de prêt, filtrage des spams, reconnaissance faciale |
Segmentation marketing, segmentation d’images, analyse de réseaux sociaux, moteurs de recommandation |
Si classification et clustering visent tous deux à regrouper des observations, leurs approches diffèrent fondamentalement. La classification s’appuie sur des étiquettes prédéfinies et un « superviseur » pour guider l’apprentissage, ce qui la rend idéale pour des tâches comme la prédiction de churn ou le filtrage des spams. Le clustering, lui, opère sans superviseur et explore la structure des données, avec des applications comme la segmentation marketing ou les systèmes de recommandation. Maîtriser ces nuances peut avoir un impact décisif sur la réussite de votre projet de machine learning.
Envie d’aller plus loin ? Découvrez ces cours DataCamp pour renforcer votre compréhension et vos compétences :
Approfondissez : introduction à la classification et au clustering
Cours
Cours
Cours