
Curso
Análise de cluster em Python
4 h
65.8K
Em machine learning, existem duas técnicas para separar objetos em grupos distintos: classificação e clusterização. Isso costuma gerar bastante confusão entre quem está começando.
À primeira vista, classificação e clusterização parecem semelhantes. Ambas usam algoritmos que aproveitam os recursos de um conjunto de dados para encontrar padrões e separar instâncias em grupos distintos. Mas, na prática, elas são bem diferentes.
Neste artigo, vamos abordar cada técnica, os diferentes algoritmos associados a elas, suas aplicações e, principalmente, como elas se diferenciam.
Tarefas de classificação fazem parte de um conjunto de problemas chamado "aprendizado supervisionado". Esses problemas envolvem desenvolver modelos que aprendem com dados históricos para fazer previsões sobre novas instâncias.
De forma mais formal, tarefas de aprendizado supervisionado são problemas em que se aprende uma função que mapeia entradas em saídas com base em pares de exemplo entrada-saída. Assim, o objetivo é aproximar a função de mapeamento (f) das entradas (X) para a saída (y) — se você vem da matemática, talvez conheça isso como o problema de aproximação de funções.
Vale notar que o aprendizado supervisionado aparece em duas formas: regressão e classificação.
Em problemas de classificação, o objetivo do algoritmo de aprendizado é aproximar a função de mapeamento a partir de um conjunto de features para prever uma saída discreta (por exemplo, dizer se a imagem é de um gato ou de um cachorro) — confira nosso tutorial entendendo a classificação de texto em Python para ver na prática.
Há vários problemas que envolvem a aplicação de algoritmos de classificação, como:
Vamos ver alguns algoritmos de classificação.
Muita gente, com razão, confunde regressão logística com um algoritmo de regressão. Tecnicamente, não estão errados. A regressão logística não realiza classificação estatística por si só. O que ela faz é estimar os parâmetros de um modelo logístico.
Conseguimos usar regressão logística para classificar graças a uma fronteira de decisão inserida para separar as classes. Assim, em sua forma mais simples, a regressão logística usa uma função logística para modelar variáveis dependentes binárias.
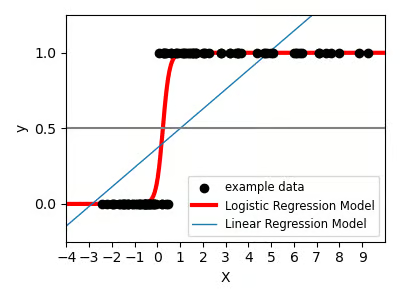
Fonte: Função logística pelo Scikit-Learn
KNN é um dos algoritmos de machine learning mais simples e difere da regressão logística porque pode ser usado tanto para classificação quanto para regressão.
Ele é um algoritmo não paramétrico e de aprendizado preguiçoso (lazy learning). Isso significa que o KNN não faz suposições sobre as características da amostra ou sobre o tipo de dado observado ser quantitativo ou qualitativo (não paramétrico), e adia os cálculos até a avaliação da função (lazy learner).
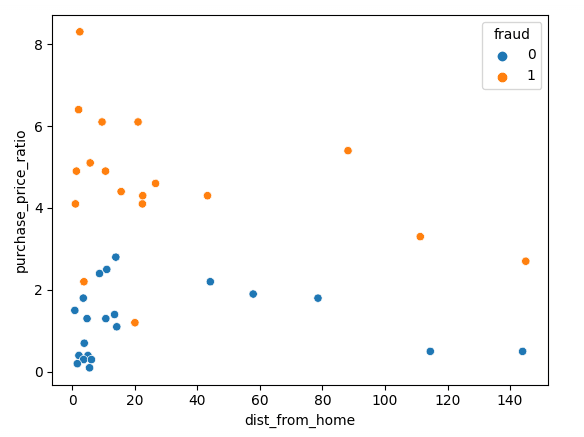
Fonte: Vizinhos mais próximos com Scikit-learn
O algoritmo de árvore de decisão é um algoritmo não paramétrico popular, também capaz de realizar regressão e classificação. Boa parte de sua popularidade vem da interpretabilidade e simplicidade — é um dos algoritmos mais fáceis de visualizar e entender.
Conceitualmente, você pode imaginar uma árvore de decisão em um fluxo que vai da raiz às folhas. O caminho da raiz até uma folha define uma regra de decisão feita sobre as features.
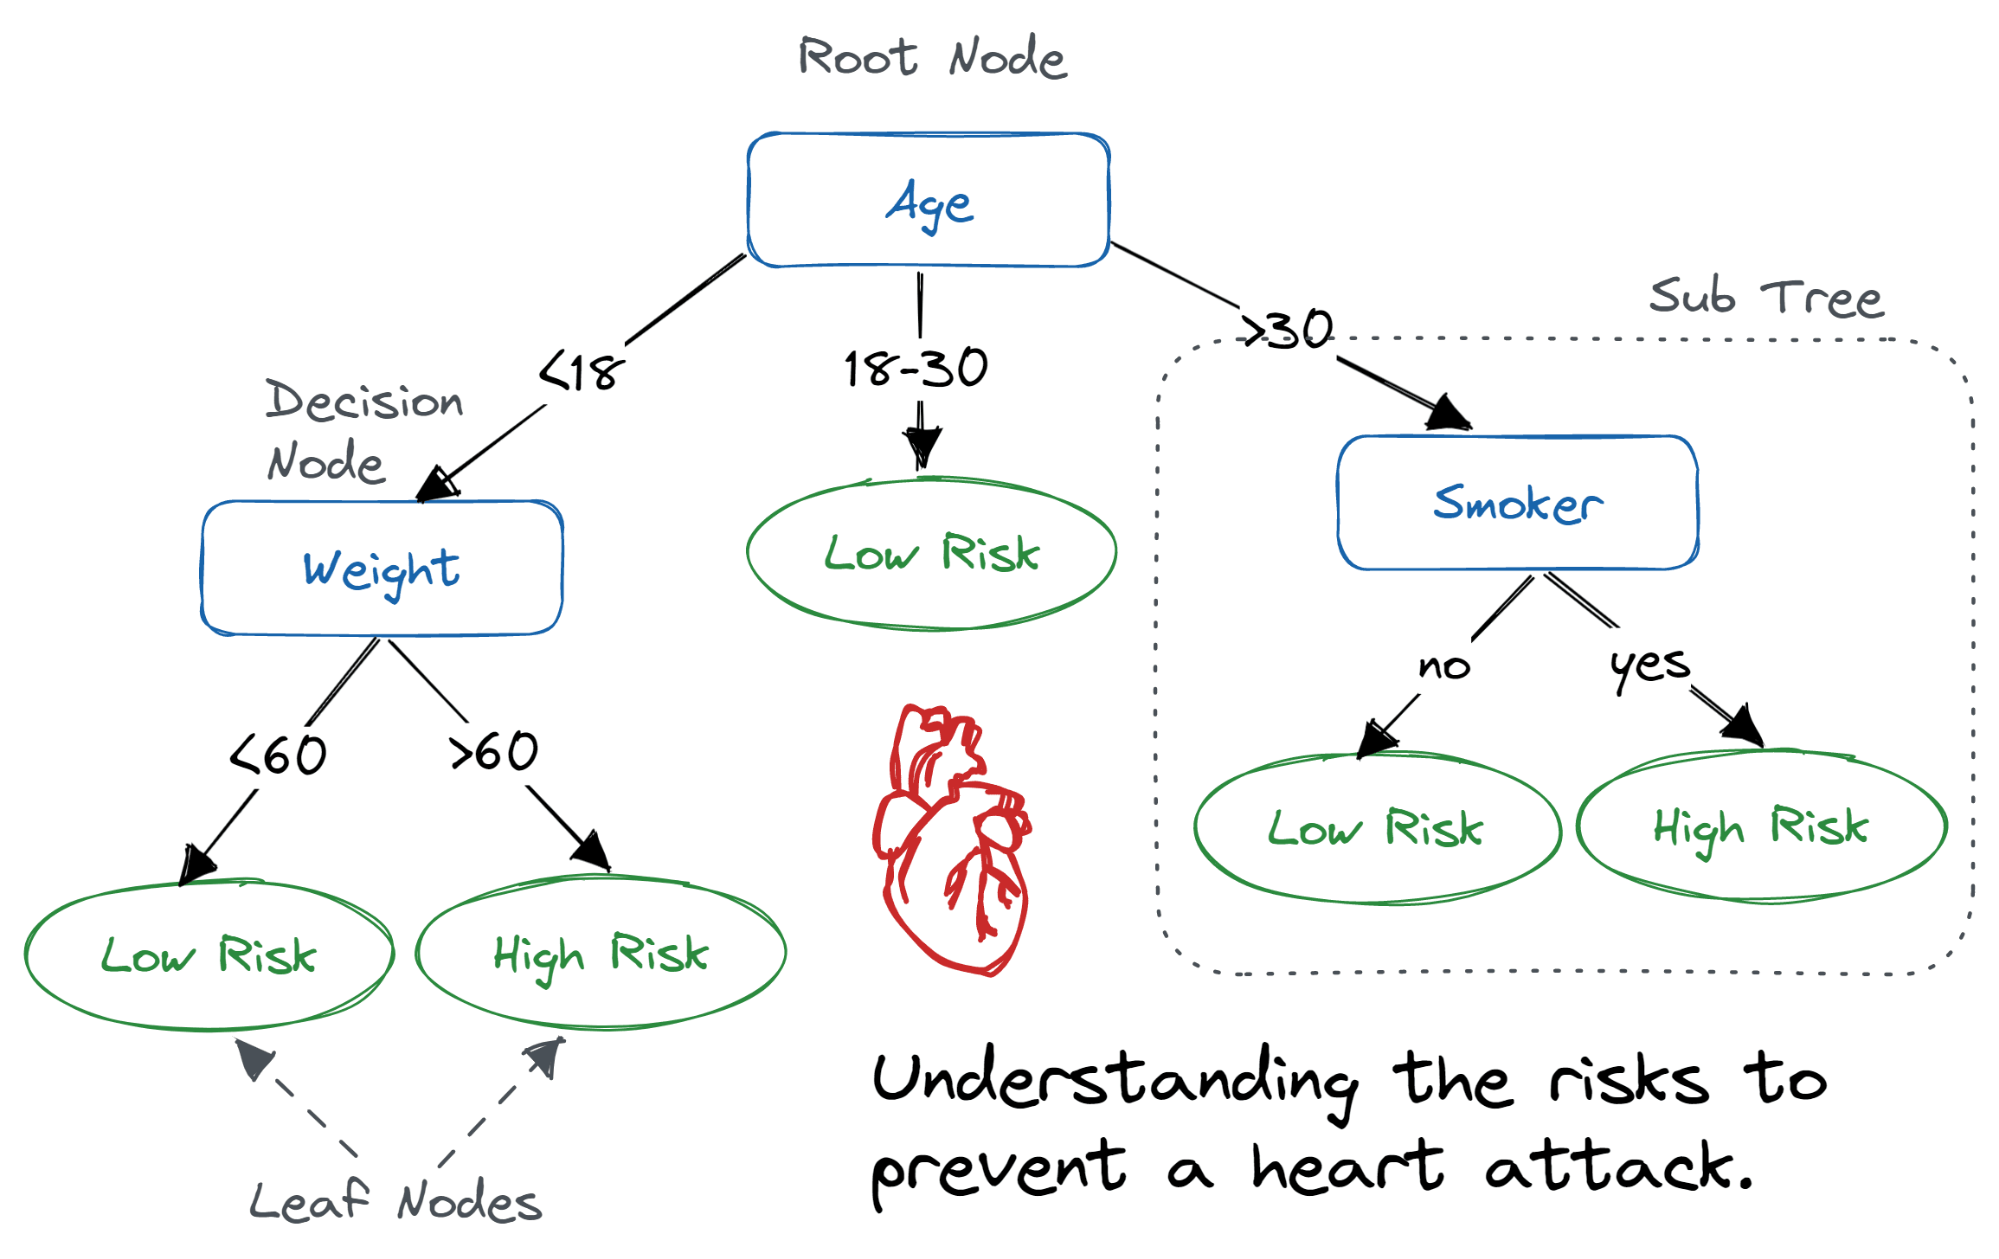
Fonte: Tutorial de classificação com árvore de decisão em Python
A random forest é um modelo de comitê (ensemble) composto por duas ou mais árvores de decisão. A técnica usa bootstrap aggregation e o método de subespaço aleatório para crescer árvores individuais e chegar a um preditor agregado poderoso, capaz de fazer tanto classificação quanto regressão.
Vale lembrar: bootstrap aggregation, ou bagging, é apenas uma técnica para gerar várias versões de um preditor, que depois são combinadas para formar um preditor agregado. O objetivo é reduzir a correlação entre os preditores, resultando em um modelo agregado que generaliza melhor.
A aleatoriedade é introduzida em cada preditor ao amostrar instâncias do conjunto de treino com reposição e usar os dados bootstrapados no treinamento.
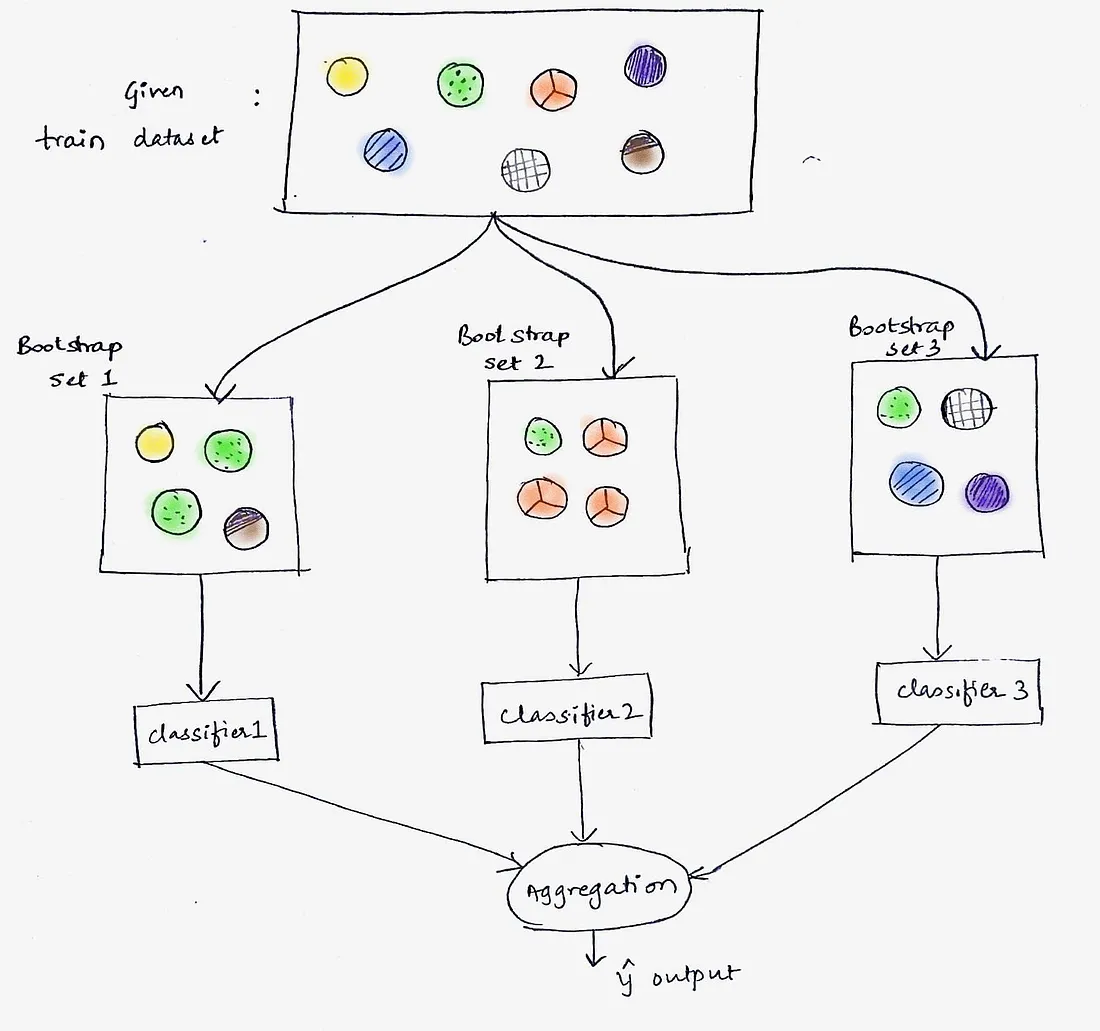
Fonte: Bagging: machine learning através de visuais. #1: o que é o ensemble “Bagging”?
O método de subespaço aleatório também é usado para reduzir a correlação entre os preditores dentro do ensemble. Ele é frequentemente chamado de "feature bagging", pois adota a mesma abordagem do bagging, porém nas features. Ou seja: o método de subespaço aleatório reduz a correlação ao construir cada preditor do ensemble em uma amostra aleatória das features, com reposição.
O classificador Naive Bayes é um algoritmo probabilístico baseado no teorema de Bayes, que é uma regra matemática para atualizar probabilidades com base em novos dados.
No contexto do Naive Bayes, a suposição "ingênua" é que todas as features (ou variáveis) do conjunto de dados são independentes entre si ao prever o resultado. Isso é uma simplificação, pois, na prática, as features podem ser dependentes. Mesmo assim, apesar dessa suposição ingênua, o algoritmo costuma ter um desempenho surpreendentemente bom em muitas tarefas de classificação.
Ou seja, o próprio teorema de Bayes não faz suposições sobre independência de variáveis. É o classificador Naive Bayes que adota essa suposição por simplicidade e eficiência computacional.
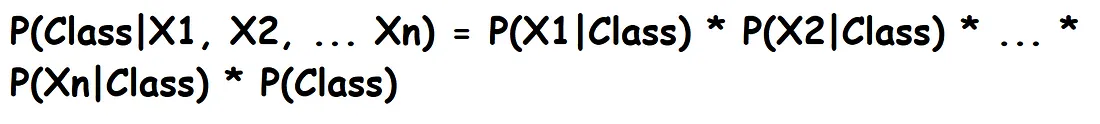
Para entender clusterização, precisamos começar pela definição de aprendizado não supervisionado. Aprendizado não supervisionado é uma abordagem usada para descobrir a estrutura subjacente dos dados — e, para isso, os algoritmos não precisam de mapeamentos de entrada para saída.
Geralmente, o aprendizado não supervisionado é usado para revelar padrões existentes nos dados, de modo que as instâncias sejam agrupadas sem necessidade de rótulos. Parte-se do princípio de que instâncias no mesmo grupo têm características semelhantes. Assim, a clusterização é uma técnica não supervisionada usada para agrupar dados não rotulados com base em suas semelhanças ou diferenças.
Alguns casos de uso de clusterização:
Veja a seguir alguns tipos de algoritmos de clusterização:
Um dos algoritmos mais populares e amplamente usados para tarefas de clusterização é o k-means. Ele é um algoritmo baseado em centróides, iterativo, que cria clusters não sobrepostos.
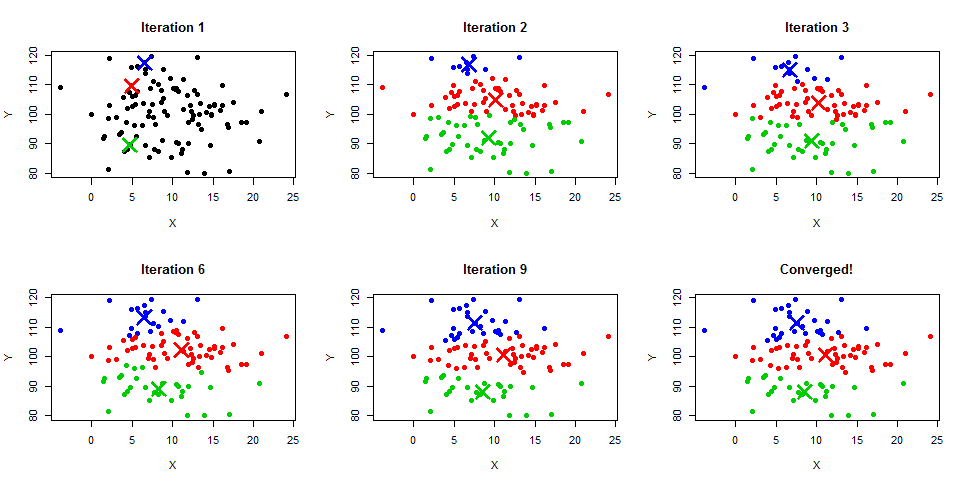
Outra forma de construir clusters é criando uma hierarquia de agrupamentos — daí o nome "clusterização hierárquica". Existem duas maneiras de construir essa hierarquia:
Aglomerativa
É uma abordagem bottom-up em que cada observação começa como seu próprio cluster. À medida que a hierarquia vai sendo construída de baixo para cima, observações são unidas em pares e os pares são mesclados em clusters.
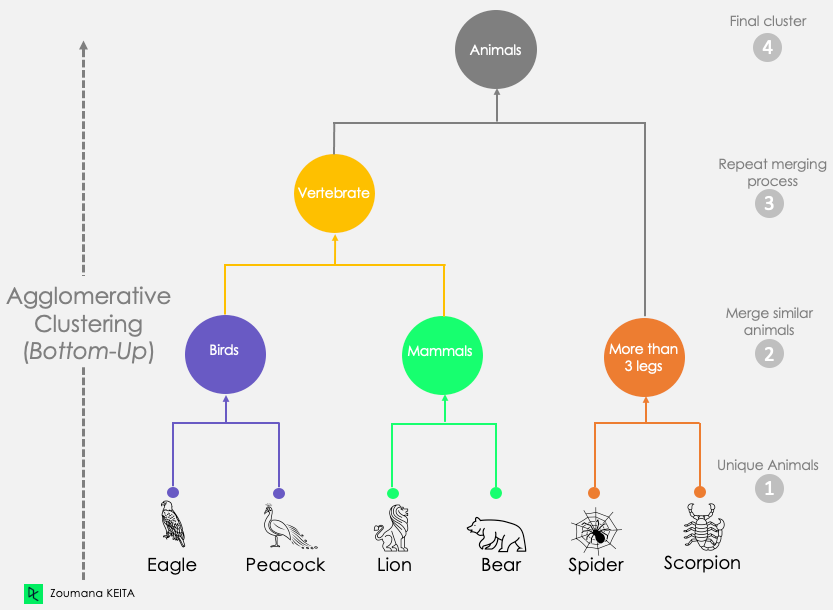
Fonte: Uma introdução à clusterização hierárquica em Python
Divisiva
A clusterização divisiva é uma abordagem top-down, em que todas as observações começam em um único cluster e divisões são feitas recursivamente para construir a hierarquia de cima para baixo.
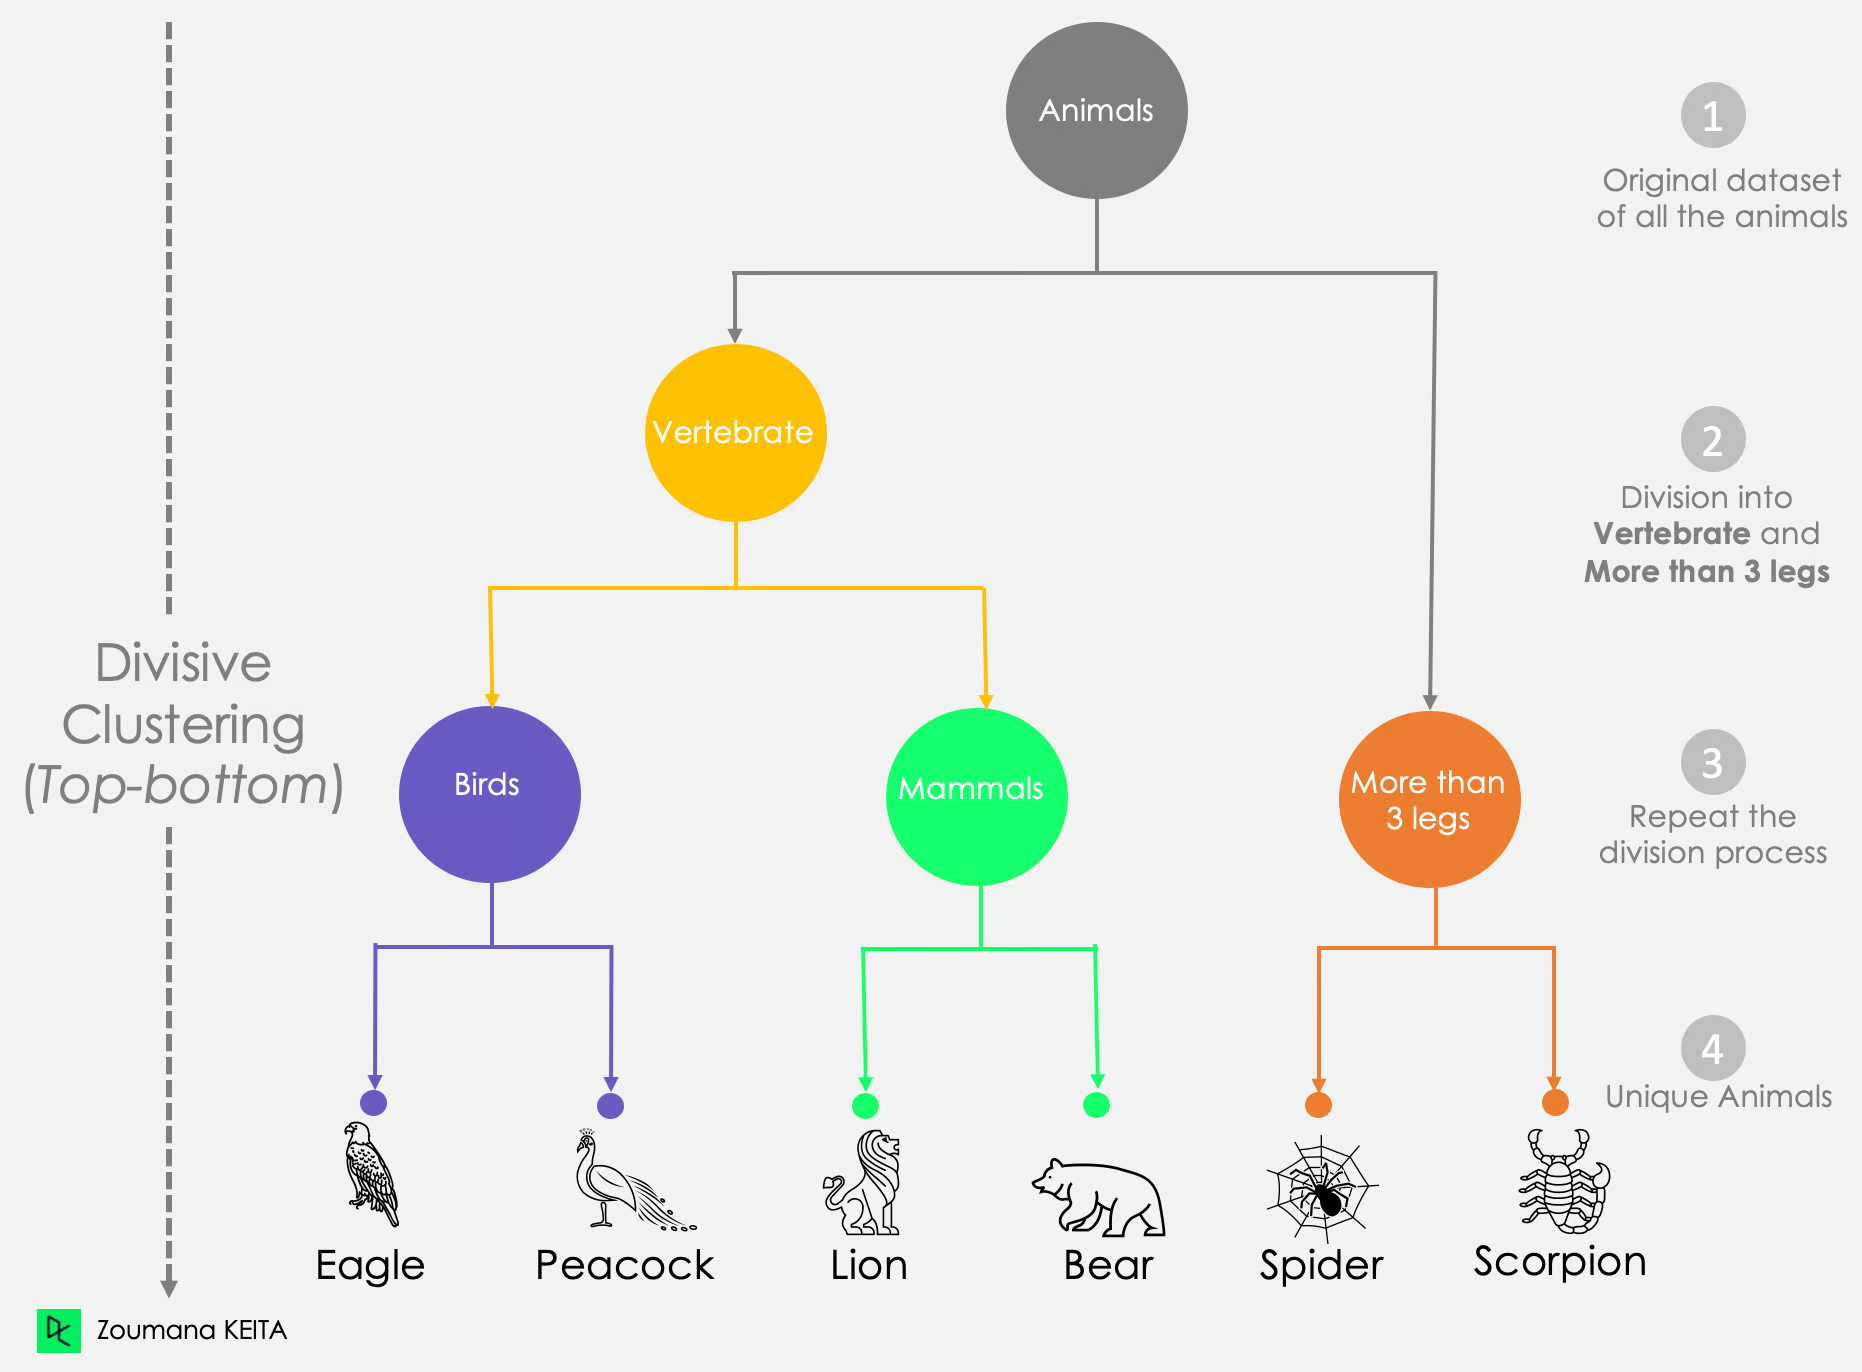
Fonte: Uma introdução à clusterização hierárquica em Python
Um dos grandes atrativos do Density-Based Spatial Clustering of Applications with Noise, ou DBSCAN, é sua robustez a outliers — além de ser o algoritmo de clusterização baseado em densidade mais conhecido.
O DBSCAN assume que clusters são regiões densas no espaço separadas por regiões de menor densidade. Diferente do K-means, o DBSCAN infere o número de clusters a partir dos dados e pode descobrir clusters de formato arbitrário, então não é necessário passar o número de clusters como parâmetro.
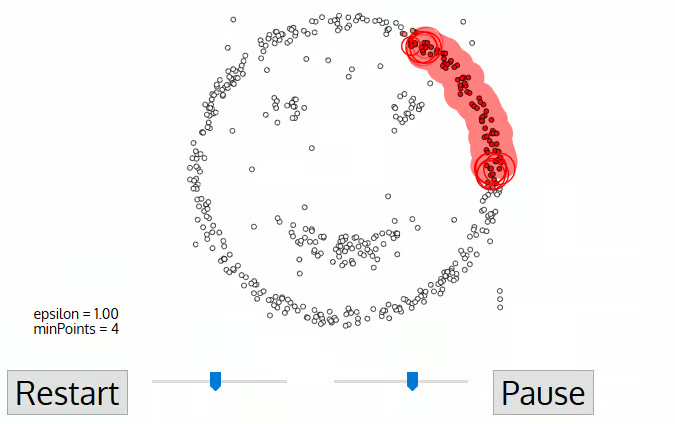
OPTICS é o acrônimo de Ordering Points to Identify the Clustering Structure. Assim como o DBSCAN, é um algoritmo baseado em densidade desenvolvido pelo mesmo grupo de pesquisa. No entanto, o OPTICS busca superar uma das grandes limitações do DBSCAN — identificar clusters em dados com densidades variadas — abrindo mão da suposição de densidade consistente nos dados.
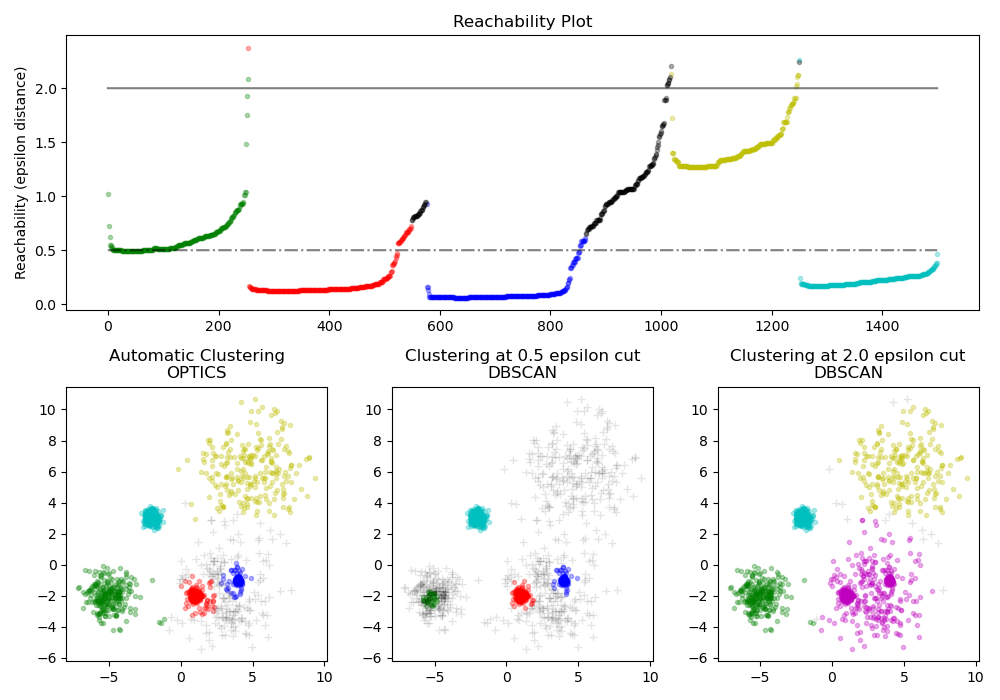
Fonte: Demonstração do algoritmo de clusterização OPTICS no Scikit-learn
Classificação é uma forma de aprendizado supervisionado. Problemas supervisionados envolvem aprender uma função que mapeia uma entrada para uma saída com base em pares entrada-saída. Já as tarefas não supervisionadas empregam métodos, como a clusterização, para descobrir padrões ocultos em dados não rotulados.
Tanto tarefas de classificação quanto de clusterização precisam de dados de treino para aprender padrões. No entanto, é boa prática ter dados de teste em tarefas de classificação para avaliar o desempenho das previsões do modelo de machine learning.
Algoritmos de clusterização dependem dos dados de entrada para modelar a estrutura subjacente e extrair insights. Em outras palavras, não há um "professor" informando as respostas corretas — o algoritmo aprende sozinho. Já os algoritmos de classificação exigem dados de entrada e saída para aprender a função de mapeamento, de modo que possam prever a saída de novos dados de entrada.
|
Classificação |
Clusterização |
|
|
Supervisionado |
Sim |
Não |
|
Rotulado |
Sim |
Não |
|
Propósito |
Aproximar a função de mapeamento (f) de um conjunto de entradas (X) para uma saída discreta (y), de modo que possa ser usada para prever a saída de novas entradas. |
Aprender os padrões subjacentes nas entradas (X) para sugerir grupos nos quais as instâncias podem ser separadas. |
|
Algoritmos |
Regressão logística, K-nearest neighbors, árvore de decisão, random forest, Naive Bayes |
K-means, clusterização aglomerativa, clusterização divisiva, DBSCAN, OPTICS |
|
Casos de uso |
Churn de clientes, aprovação de crédito, filtro de spam, reconhecimento facial |
Segmentação de mercado, segmentação de imagens, análise de redes sociais, motores de recomendação. |
Embora classificação e clusterização tenham o mesmo objetivo de separar instâncias em grupos distintos, suas abordagens são fundamentalmente diferentes. A classificação se baseia em rótulos predefinidos e em um "supervisor" para guiar o aprendizado, sendo ideal para tarefas como previsão de churn ou filtro de spam. Já a clusterização opera sem supervisor e é mais exploratória, com aplicações em segmentação de mercado ou sistemas de recomendação. Entender essas nuances pode impactar diretamente a eficácia do seu projeto de machine learning.
Quer ir além? Confira estes cursos da DataCamp para aprofundar seu entendimento e desenvolver suas habilidades:
Aprofunde-se: introdução a classificação e clusterização
Curso
Curso
Curso
blog
Moez Ali
15 min
blog
Arun Nanda
15 min
blog
Matt Crabtree
14 min
Tutorial
Eugenia Anello
8 min
Tutorial
Kevin Babitz
8 min
Tutorial
Moez Ali
12 min





