
Kurs
Cluster Analysis in Python
4 Std.
65.8K
Im Machine Learning gibt es zwei grundlegende Techniken, um Objekte in klar getrennte Gruppen einzuordnen: Klassifikation und Clustering. Gerade am Anfang sorgt das oft für Verwirrung.
Auf den ersten Blick wirken Klassifikation und Clustering ähnlich. In beiden Fällen nutzen Algorithmen die Merkmale eines Datensatzes, um Muster zu finden und Instanzen in Gruppen zu trennen. In der Praxis unterscheiden sie sich jedoch deutlich.
In diesem Artikel schauen wir uns beide Techniken an – ihre Algorithmen, Anwendungsfälle und vor allem die Unterschiede.
Klassifikationsaufgaben gehören zur Kategorie des „Supervised Learning“. Dabei werden Modelle entwickelt, die aus historischen Daten lernen, um Vorhersagen für neue Fälle zu treffen.
Formal betrachtet wird beim Supervised Learning eine Funktion gelernt, die Eingaben auf Ausgaben abbildet – anhand von Beispielpaaren aus Input und Output. Ziel ist es also, die Abbildungsfunktion f von den Eingaben (X) zur Ausgabe (y) zu approximieren. Mit mathematischem Hintergrund kennst du das als Funktionsapproximation.
Supervised Learning gibt es in zwei Varianten: Regression und Klassifikation.
Bei Klassifikationsproblemen approximiert der Algorithmus die Abbildungsfunktion von einem Merkmalsvektor zu einer diskreten Ausgabe (z. B. Katze oder Hund). Eine praxisnahe Einführung findest du in unserem Tutorial Understanding text classification in Python.
Typische Anwendungsfälle für Klassifikation sind:
Schauen wir uns einige Klassifikationsalgorithmen an.
Die logistische Regression wird häufig mit einem Regressionsalgorithmus verwechselt – was technisch nicht falsch ist. Sie führt keine statistische Klassifikation durch, sondern schätzt die Parameter eines logistischen Modells.
Für die Klassifikation nutzen wir die logistische Regression dank einer Entscheidungsgrenze, die Klassen trennt. In der einfachsten Form modelliert sie mit der logistischen Funktion binäre Zielvariablen.
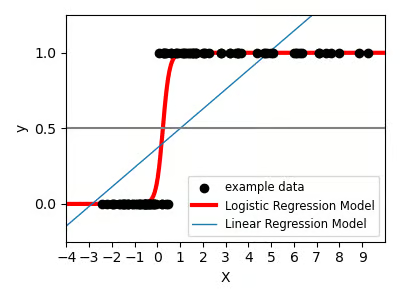
Quelle: Logistic Function by Scikit-Learn
KNN zählt zu den einfachsten Algorithmen im Machine Learning und unterscheidet sich von der logistischen Regression dadurch, dass er für Klassifikation und Regression eingesetzt werden kann.
Konkret ist KNN ein nichtparametrischer, „fauler“ Lernalgorithmus. Nichtparametrisch bedeutet, er macht keine Annahmen über die Verteilung oder den Typ der Daten. Als Lazy Learner verschiebt er die Berechnung bis zur Auswertung der Zielfunktion.
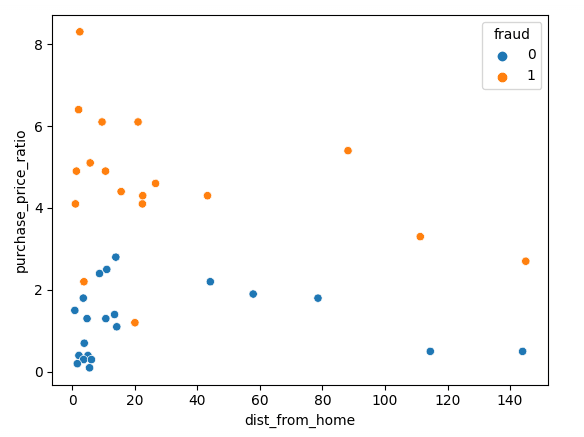
Quelle: Nearest Neighbors with Scikit-learn
Der Entscheidungsbaum ist ein populärer nichtparametrischer Algorithmus für Regression und Klassifikation. Er ist so verbreitet, weil er einfach zu visualisieren und zu interpretieren ist.
Konzeptionell verläuft ein Entscheidungsbaum wie ein Fluss vom Wurzelknoten zu den Blättern. Der Pfad von der Wurzel zu einem Blatt definiert eine Entscheidungsregel über die Merkmale.
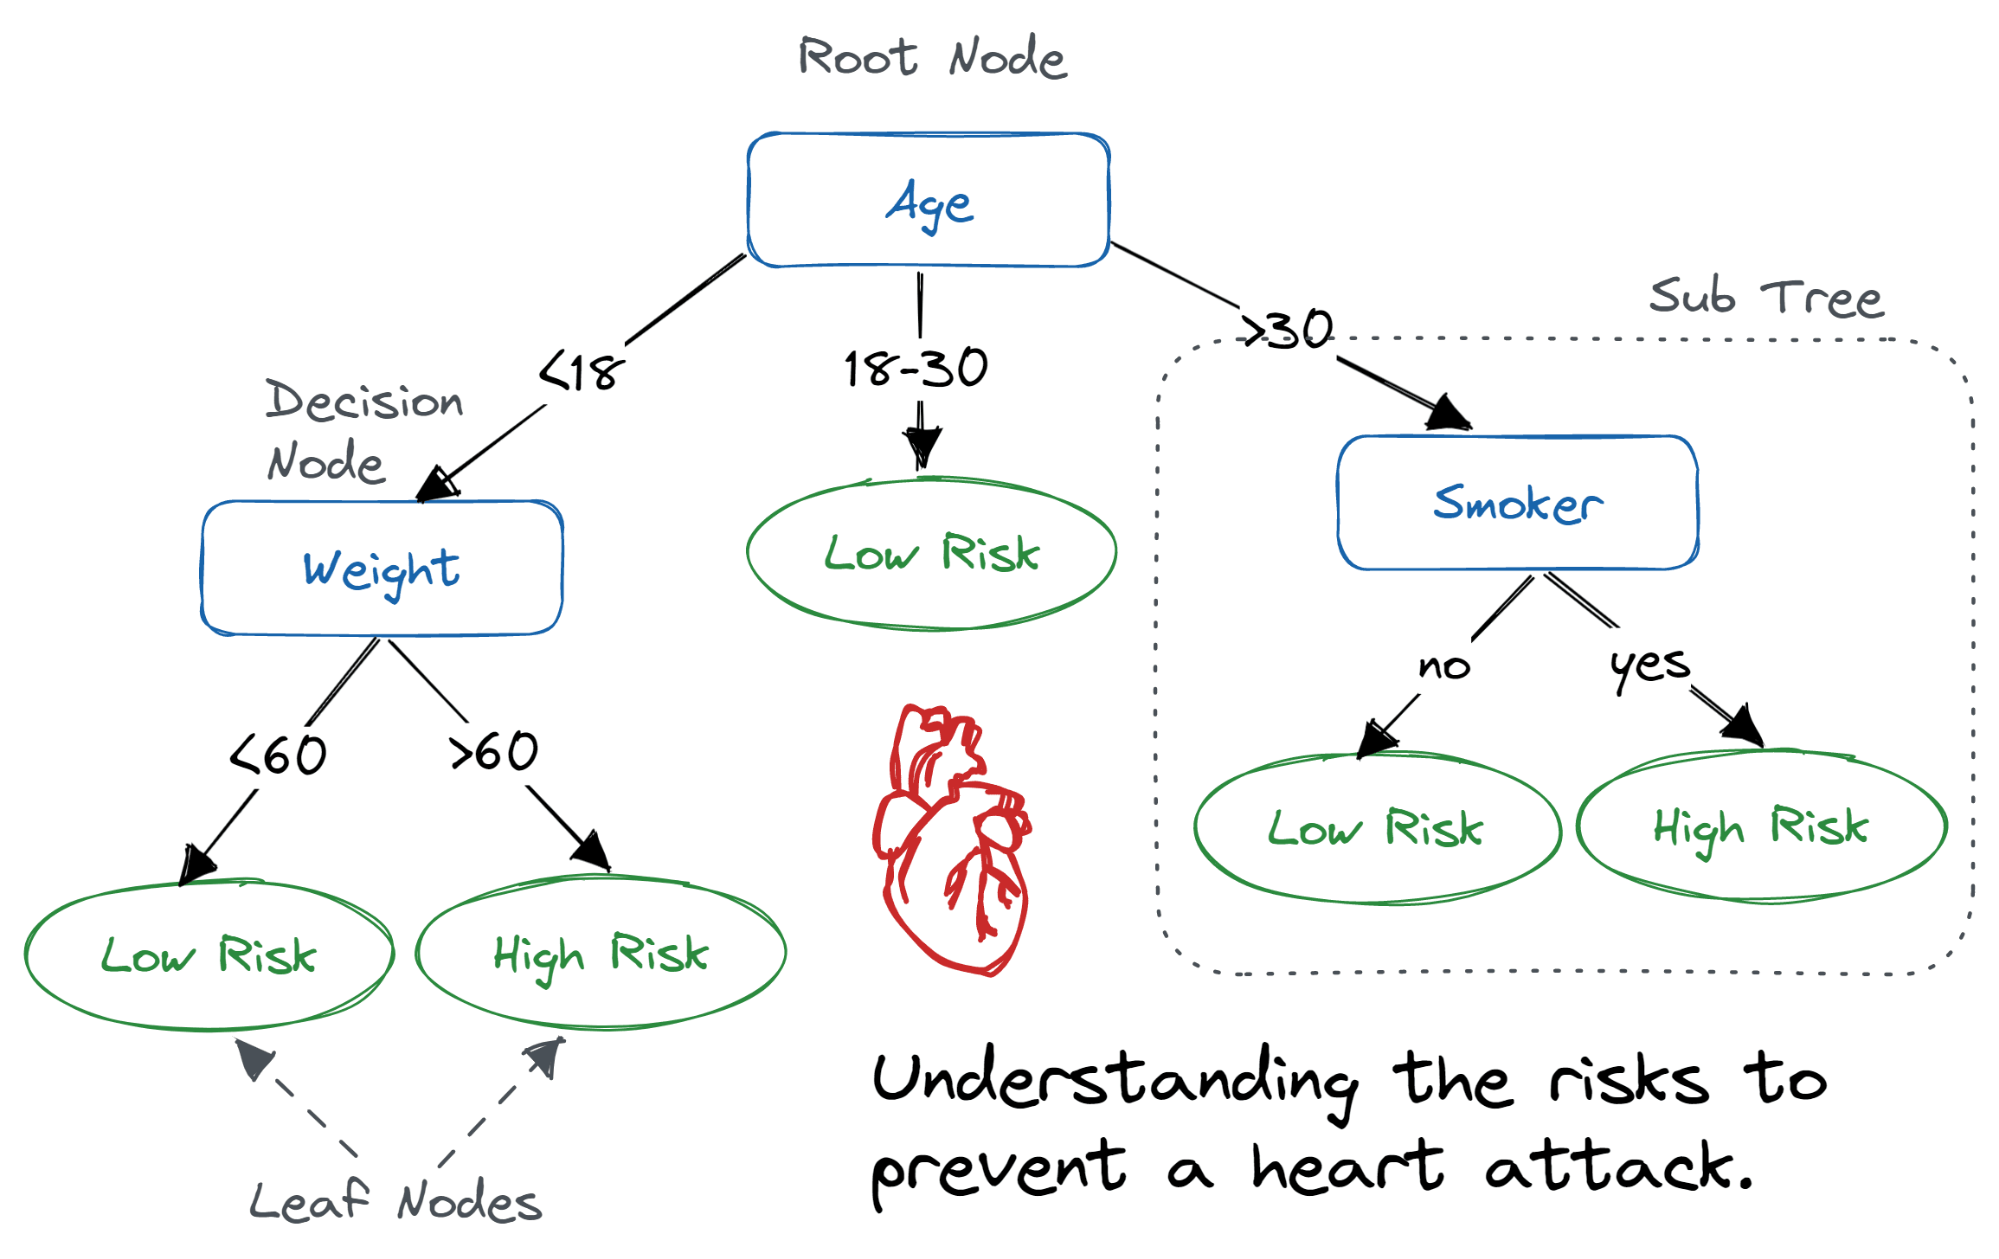
Quelle: Decision Tree Classification in Python Tutorial
Der Random Forest ist ein Ensemblemodell aus mehreren Entscheidungsbäumen. Mithilfe von Bootstrap-Aggregation und dem Random-Subspace-Verfahren entstehen einzelne Bäume, deren Aggregation starke Vorhersagen für Klassifikation und Regression liefert.
Bootstrap-Aggregation („Bagging“) erzeugt mehrere Varianten eines Prädiktors, die zu einem Gesamtmodell gebündelt werden. Ziel ist es, die Korrelation zwischen den Einzelprädiktoren zu reduzieren, damit das Ensemble besser generalisiert.
Zufall fließt ein, indem beim Training mit Zurücklegen aus dem Datensatz Stichproben gezogen werden (Bootstrapping).
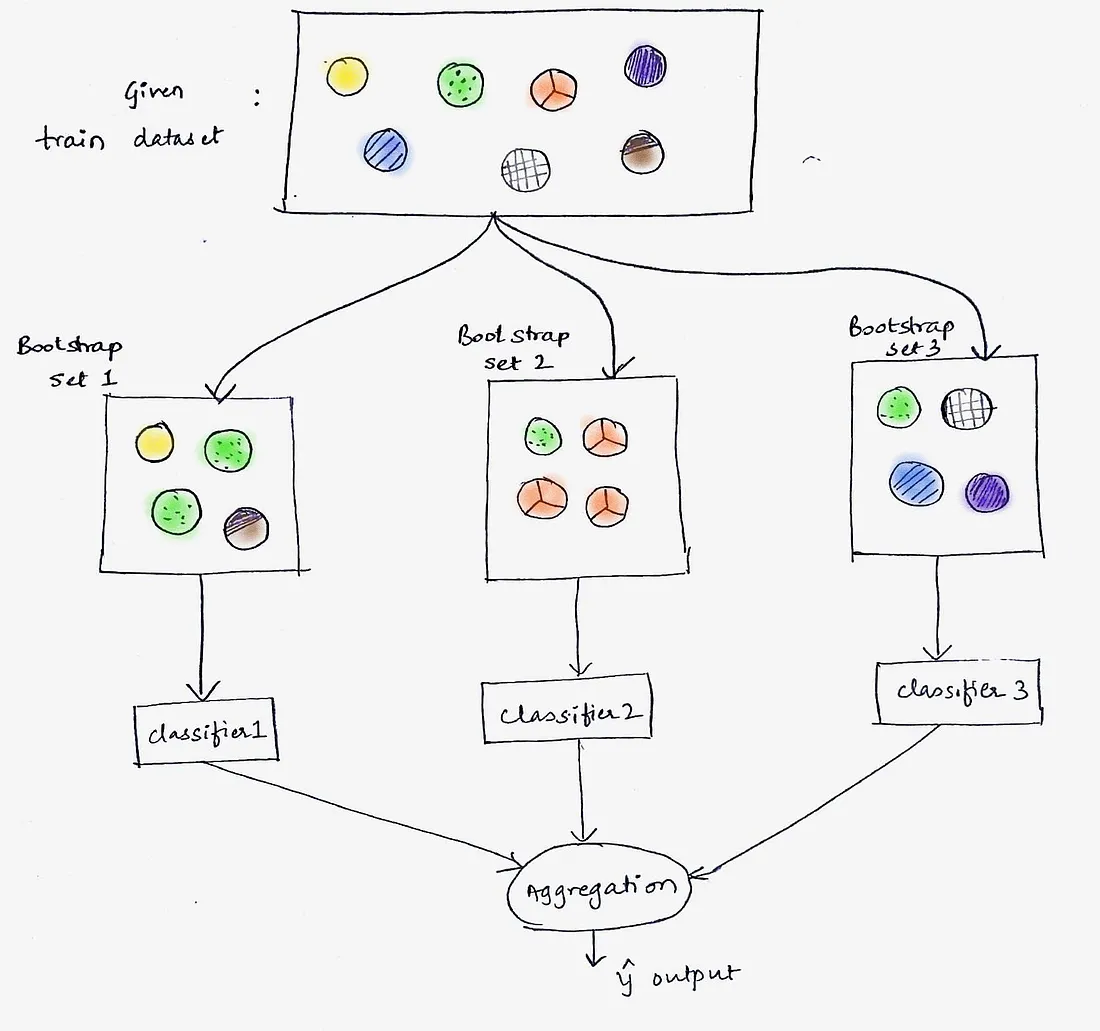
Quelle: Bagging: Machine Learning through visuals. #1: What is “Bagging” ensemble learning?
Das Random-Subspace-Verfahren verringert ebenfalls die Korrelation innerhalb des Ensembles. Es wird oft „Feature Bagging“ genannt, da analog zum Bagging mit Merkmalen statt mit Instanzen gearbeitet wird: Jeder Baum nutzt eine zufällige Merkmalsstichprobe (mit Zurücklegen).
Der Naive-Bayes-Klassifikator ist ein probabilistischer Ansatz auf Basis des Satzes von Bayes – einer Regel, um Wahrscheinlichkeiten mithilfe neuer Daten zu aktualisieren.
„Naiv“ ist hier die Annahme, dass alle Merkmale im Datensatz bei der Vorhersage voneinander unabhängig sind. Das ist eine Vereinfachung, denn in der Realität gibt es Abhängigkeiten. Trotzdem liefert der Algorithmus in vielen Klassifikationsaufgaben bemerkenswert gute Ergebnisse.
Der Satz von Bayes selbst macht keine Unabhängigkeitsannahmen. Diese Annahme trifft allein der Naive-Bayes-Klassifikator – zugunsten von Einfachheit und Rechenaufwand.
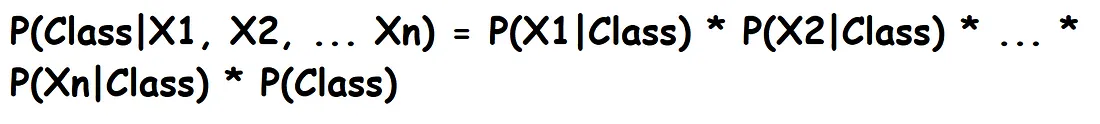
Um Clustering zu verstehen, starten wir mit Unsupervised Learning. Dabei wird die zugrunde liegende Struktur von Daten aufgedeckt – ohne dass Eingaben explizit Ausgaben zugeordnet sind.
Unsupervised Learning dient dazu, Muster in Daten zu entdecken und Instanzen ohne Labels zu gruppieren. Die Annahme: Instanzen derselben Gruppe teilen ähnliche Merkmale. Clustering ist somit eine Unsupervised-Technik, die nicht gelabelte Daten anhand von Ähnlichkeiten bzw. Unterschieden gruppiert.
Beispiele für Clustering:
Hier sind einige Clustering-Algorithmen:
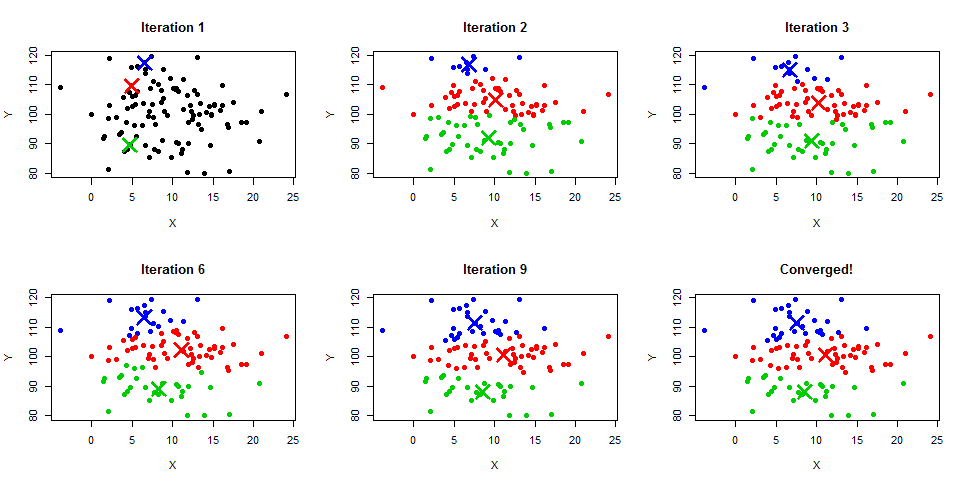
Einer der bekanntesten und am weitesten verbreiteten Algorithmen ist K-Means. Er ist zentroidbasiert, iterativ und erzeugt nicht überlappende Cluster.
Eine weitere Möglichkeit ist der Aufbau einer Clusterhierarchie, daher der Name hierarchisches Clustering. Es gibt zwei Vorgehensweisen:
Agglomerativ
Bottom-up: Zunächst ist jede Beobachtung ihr eigenes Cluster. Schritt für Schritt werden Paare zusammengeführt, dann Paare zu Clustern vereint.
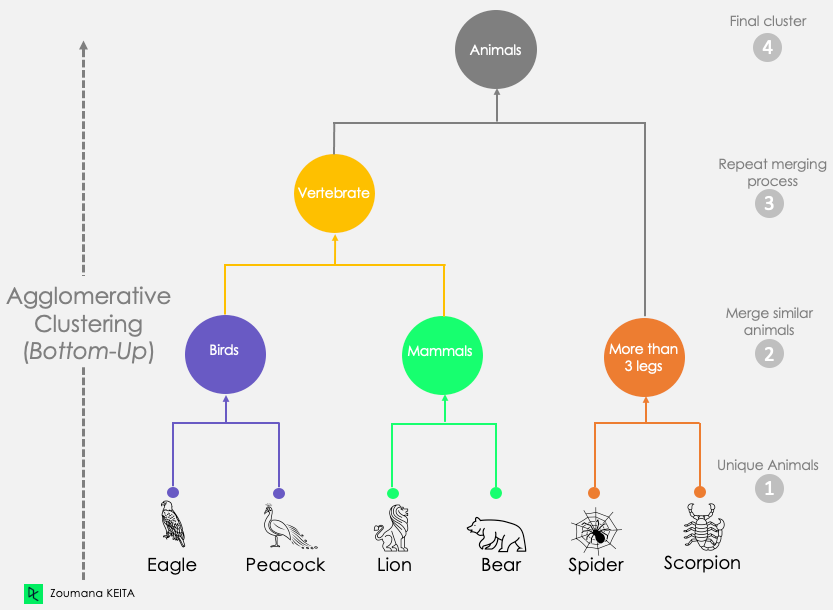
Quelle: An introduction to Hierarchical clustering in Python
Divisiv
Top-down: Alle Beobachtungen starten in einem Cluster. Durch rekursive Aufteilung entsteht die Hierarchie von oben nach unten.
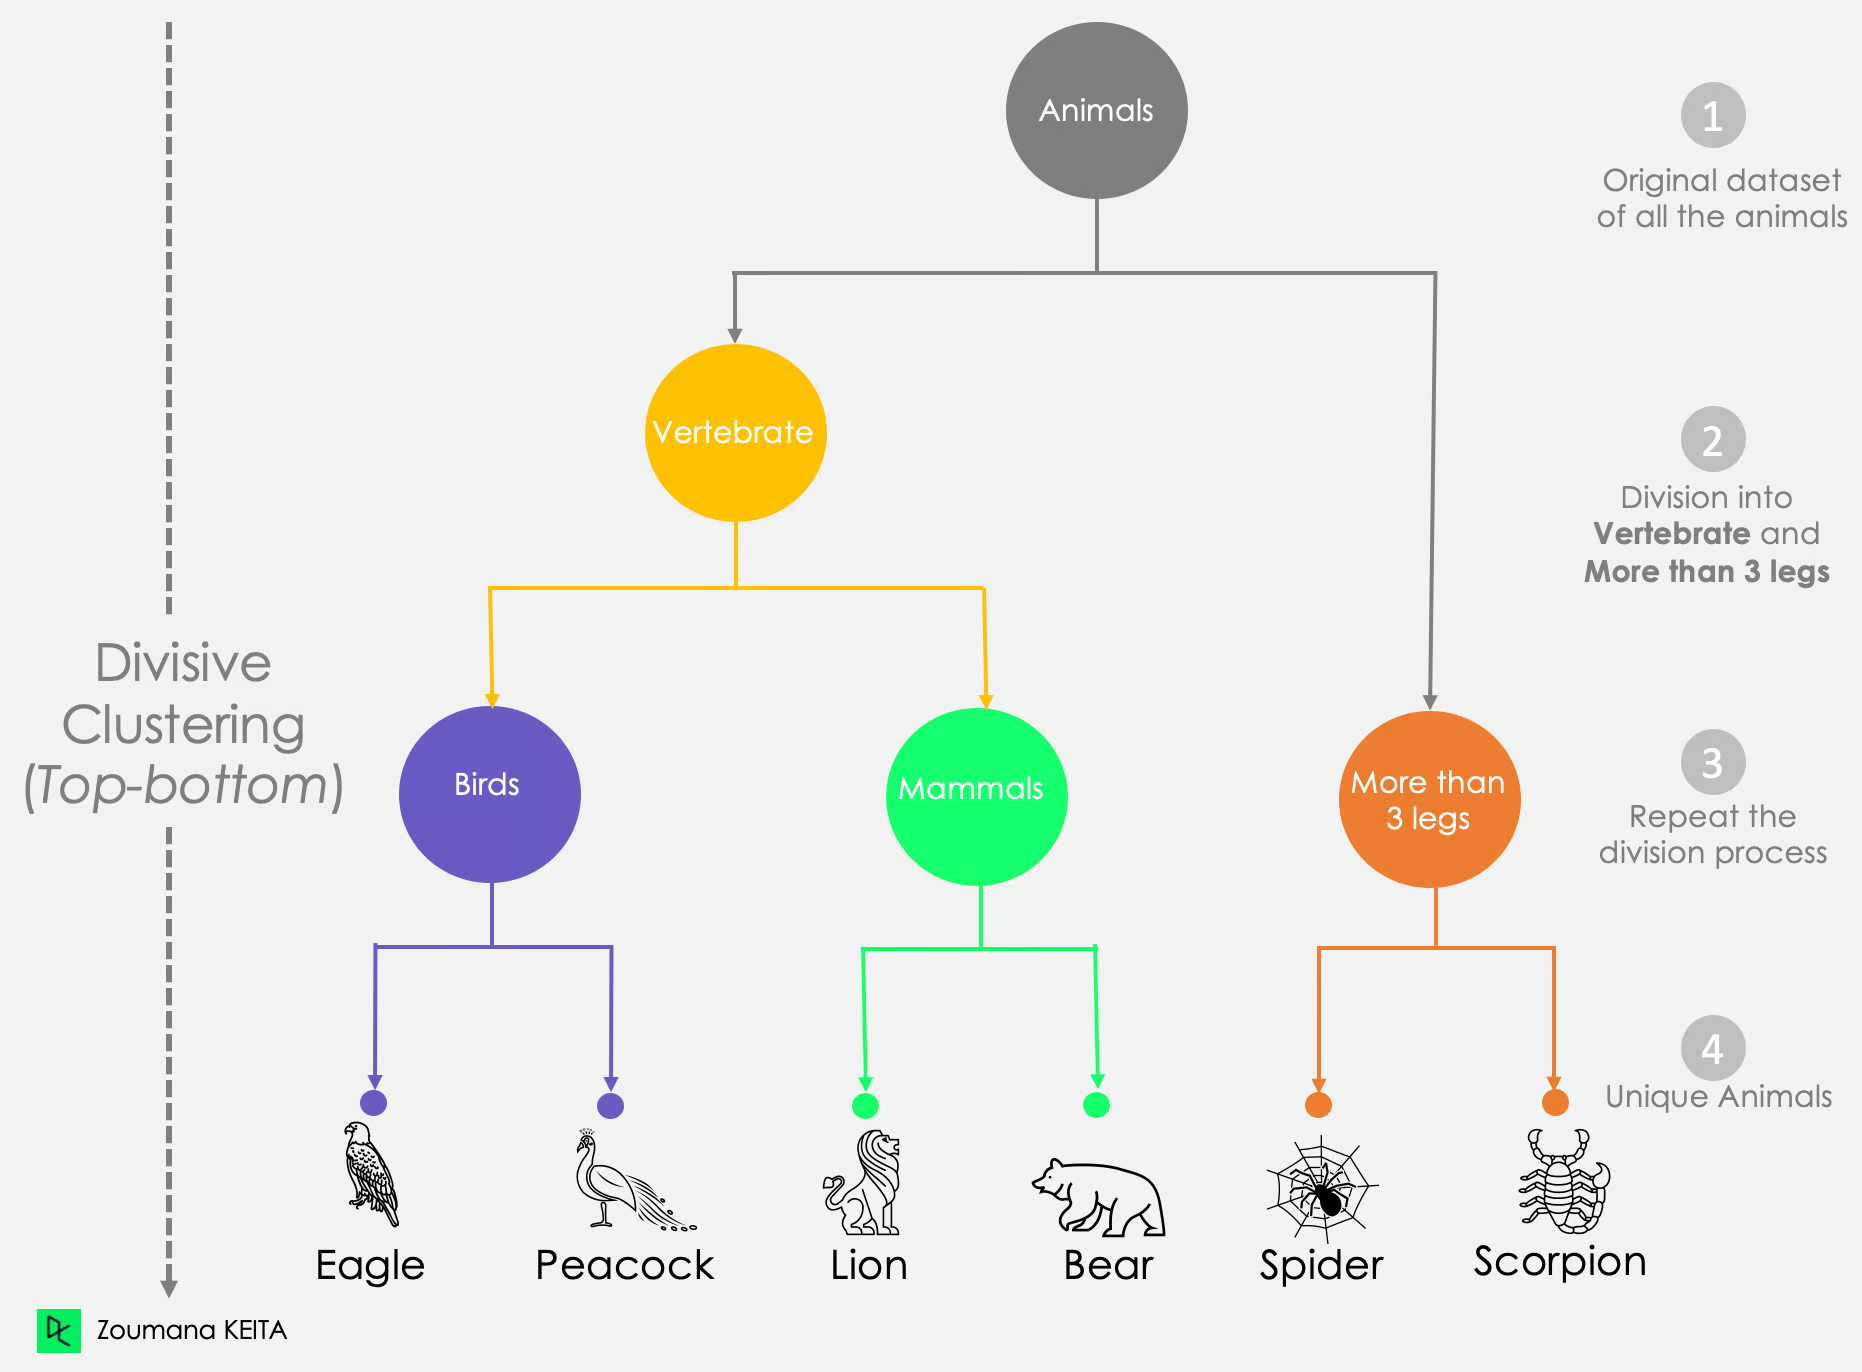
Quelle: An introduction to Hierarchical clustering in Python
Ein großer Pluspunkt von Density-Based Spatial Clustering of Applications with Noise (DBSCAN) ist die Robustheit gegenüber Ausreißern. Es ist der bekannteste dichtebasierte Algorithmus.
DBSCAN nimmt an, dass Cluster dichte Regionen sind, getrennt durch bereiche geringerer Dichte. Anders als K-Means leitet DBSCAN die Anzahl der Cluster aus den Daten ab und findet Cluster beliebiger Form – die Clusteranzahl muss nicht als Parameter vorgegeben werden.
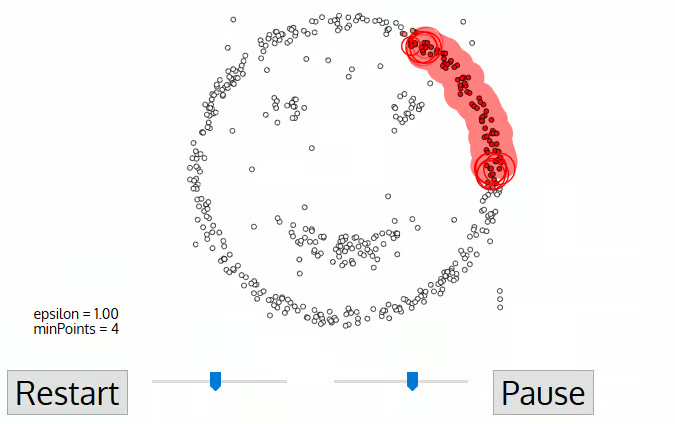
OPTICS steht für Ordering Points to Identify the Clustering Structure. Wie DBSCAN ist es dichtebasiert und stammt aus derselben Forschungsgruppe. OPTICS überwindet jedoch eine Schwäche von DBSCAN – Cluster bei variierender Dichte zu erkennen –, indem es die Annahme konstanter Dichte aufgibt.
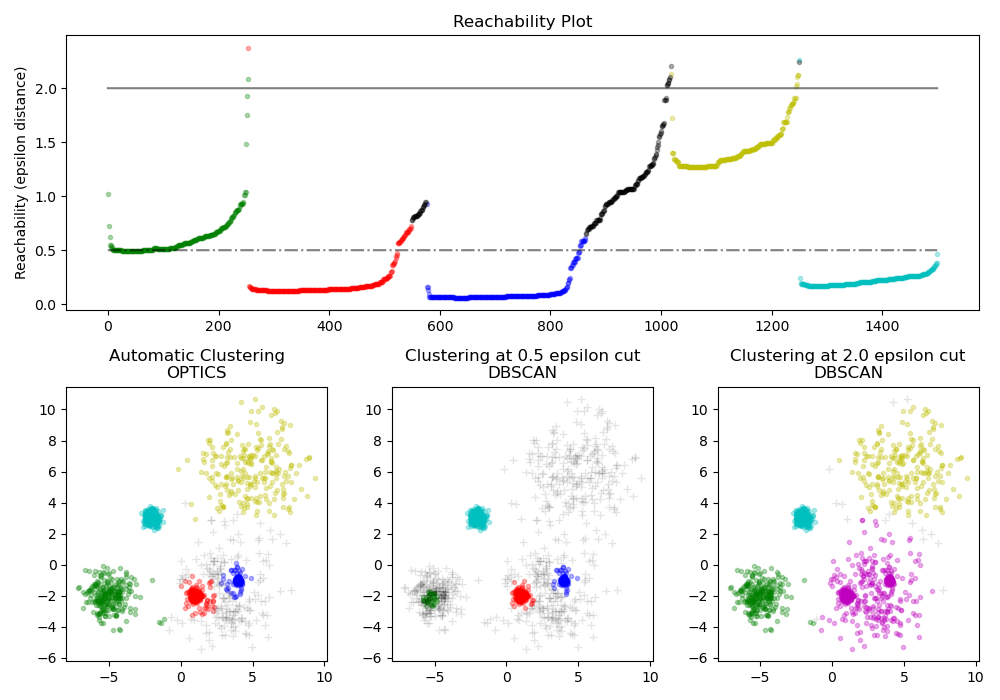
Quelle: Scikit-learn Demo of OPTICS clustering algorithm
Klassifikation ist Supervised Learning. Dabei wird eine Funktion gelernt, die Eingaben anhand gelabelter Beispiele auf Ausgaben abbildet. Im Gegensatz dazu nutzt Unsupervised Learning – etwa Clustering – Methoden, um verborgene Muster in ungelabelten Daten zu entdecken.
Sowohl Klassifikation als auch Clustering benötigen Trainingsdaten, um Muster zu lernen. Für Klassifikation ist es jedoch Best Practice, zusätzliche Testdaten zu verwenden, um die Vorhersagegüte des Modells zu bewerten.
Clustering-Algorithmen modellieren die Struktur der Eingabedaten, um Erkenntnisse zu gewinnen – ohne „Lehrer“ mit korrekten Antworten. Klassifikationsalgorithmen hingegen benötigen Eingabe- und Ausgabedaten, um die Abbildungsfunktion zu lernen und damit für neue Eingaben Vorhersagen zu treffen.
|
Klassifikation |
Clustering |
|
|
Supervised |
Ja |
Nein |
|
Gelabelt |
Ja |
Nein |
|
Zweck |
Die Abbildungsfunktion f von Eingaben (X) zu einer diskreten Ausgabe (y) approximieren, um die Ausgabe für neue Eingaben vorhersagen zu können. |
Muster in den Eingaben (X) lernen, um sinnvolle Gruppen vorzuschlagen, in die Instanzen aufgeteilt werden können. |
|
Algorithmen |
Logistische Regression, K-Nearest Neighbors, Entscheidungsbaum, Random Forest, Naive Bayes |
K-Means, agglomeratives Clustering, divisives Clustering, DBSCAN, OPTICS |
|
Use Cases |
Churn-Vorhersage, Kreditzusage, Spam-Filter, Gesichtserkennung |
Marktsegmentierung, Bildsegmentierung, Analyse sozialer Netzwerke, Empfehlungssysteme |
Beide Verfahren teilen das Ziel, Instanzen in klar abgegrenzte Gruppen einzuordnen, verfolgen dabei aber grundverschiedene Ansätze. Klassifikation nutzt vordefinierte Labels und einen „Lehrer“ und eignet sich für Aufgaben wie Churn-Prognosen oder Spam-Erkennung. Clustering arbeitet ohne Aufsicht, ist explorativ und findet Anwendungen etwa in der Marktsegmentierung oder in Empfehlungssystemen. Diese Unterschiede zu verstehen, kann den Erfolg deines Machine-Learning-Projekts entscheidend beeinflussen.
Du willst tiefer einsteigen? Diese DataCamp-Kurse bringen dich weiter:
Tiefer eintauchen: Intro zu Klassifikation & Clustering
Kurs
Kurs
Kurs