

Khóa học
Phân cụm trong Python
4 giờ
66.1K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleTrong học máy, có hai kỹ thuật để tách các đối tượng thành các nhóm riêng biệt: phân loại và phân cụm. Điều này thường gây nhiều nhầm lẫn cho những người mới bắt đầu.
Bề ngoài, phân loại và phân cụm trông có vẻ giống nhau. Cả hai đều dùng các thuật toán khai thác đặc trưng của tập dữ liệu để phát hiện mẫu và tách các quan sát thành những nhóm khác nhau. Nhưng trên thực tế, chúng khá khác biệt.
Bài viết này sẽ trình bày từng kỹ thuật, các thuật toán liên quan, ứng dụng của chúng và quan trọng nhất là điểm khác nhau giữa chúng.
Các bài toán phân loại thuộc nhóm vấn đề gọi là “học có giám sát.” Những bài toán này xây dựng mô hình học từ dữ liệu lịch sử để dự đoán cho các quan sát mới.
Về hình thức, các bài toán học có giám sát là những vấn đề trong đó một hàm được học để ánh xạ đầu vào sang đầu ra dựa trên các cặp ví dụ đầu vào–đầu ra. Mục tiêu là xấp xỉ hàm ánh xạ (f) từ đầu vào (X) đến đầu ra (y) — nếu bạn có nền tảng toán học, bạn có thể biết đây là bài toán xấp xỉ hàm.
Lưu ý rằng học có giám sát có hai dạng: hồi quy và phân loại.
Trong bài toán phân loại, mục tiêu của thuật toán học là xấp xỉ hàm ánh xạ từ một tập đặc trưng để dự đoán đầu ra rời rạc (ví dụ: dự đoán ảnh là mèo hay chó) — hãy xem hướng dẫn Tìm hiểu phân loại văn bản trong Python để thực hành.
Có nhiều vấn đề áp dụng thuật toán phân loại, chẳng hạn như:
Hãy điểm qua một số thuật toán phân loại.
Nhiều người, có thể hiểu được, nhầm hồi quy logistic là một thuật toán hồi quy. Về kỹ thuật, điều đó không sai. Hồi quy logistic không thực hiện phân loại thống kê; nó ước lượng các tham số của một mô hình logistic.
Lý do ta có thể dùng hồi quy logistic cho phân loại là nhờ ranh giới quyết định được chèn vào để tách các lớp. Do đó, ở dạng đơn giản nhất, hồi quy logistic dùng hàm logistic để mô hình hóa biến phụ thuộc nhị phân.
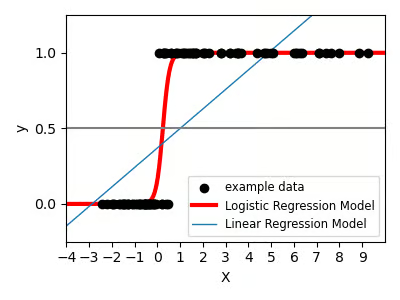
Nguồn: Hàm Logistic bởi Scikit-Learn
KNN là một trong những thuật toán học máy ít phức tạp nhất và khác với hồi quy logistic ở chỗ có thể dùng cho cả bài toán phân loại và hồi quy.
Cụ thể, đây là một thuật toán phi tham số và “học lười biếng”. Nghĩa là KNN không đưa ra giả định về đặc tính của mẫu hay dữ liệu quan sát là định lượng hay định tính (phi tham số), và mọi tính toán được hoãn lại đến lúc đánh giá hàm (học lười).
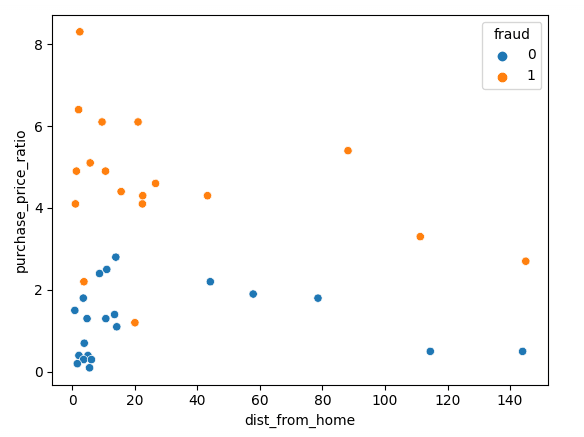
Nguồn: Lân cận gần nhất với Scikit-learn
Thuật toán cây quyết định là một thuật toán phi tham số phổ biến, cũng có thể thực hiện hồi quy và phân loại. Phần lớn mức độ phổ biến đến từ tính dễ hiểu và đơn giản — vì đây là một trong những thuật toán dễ hình dung và diễn giải.
Về mặt khái niệm, bạn có thể hình dung cây quyết định như một luồng từ gốc đến lá. Đường đi từ gốc đến một lá xác định một quy tắc quyết định dựa trên các đặc trưng.
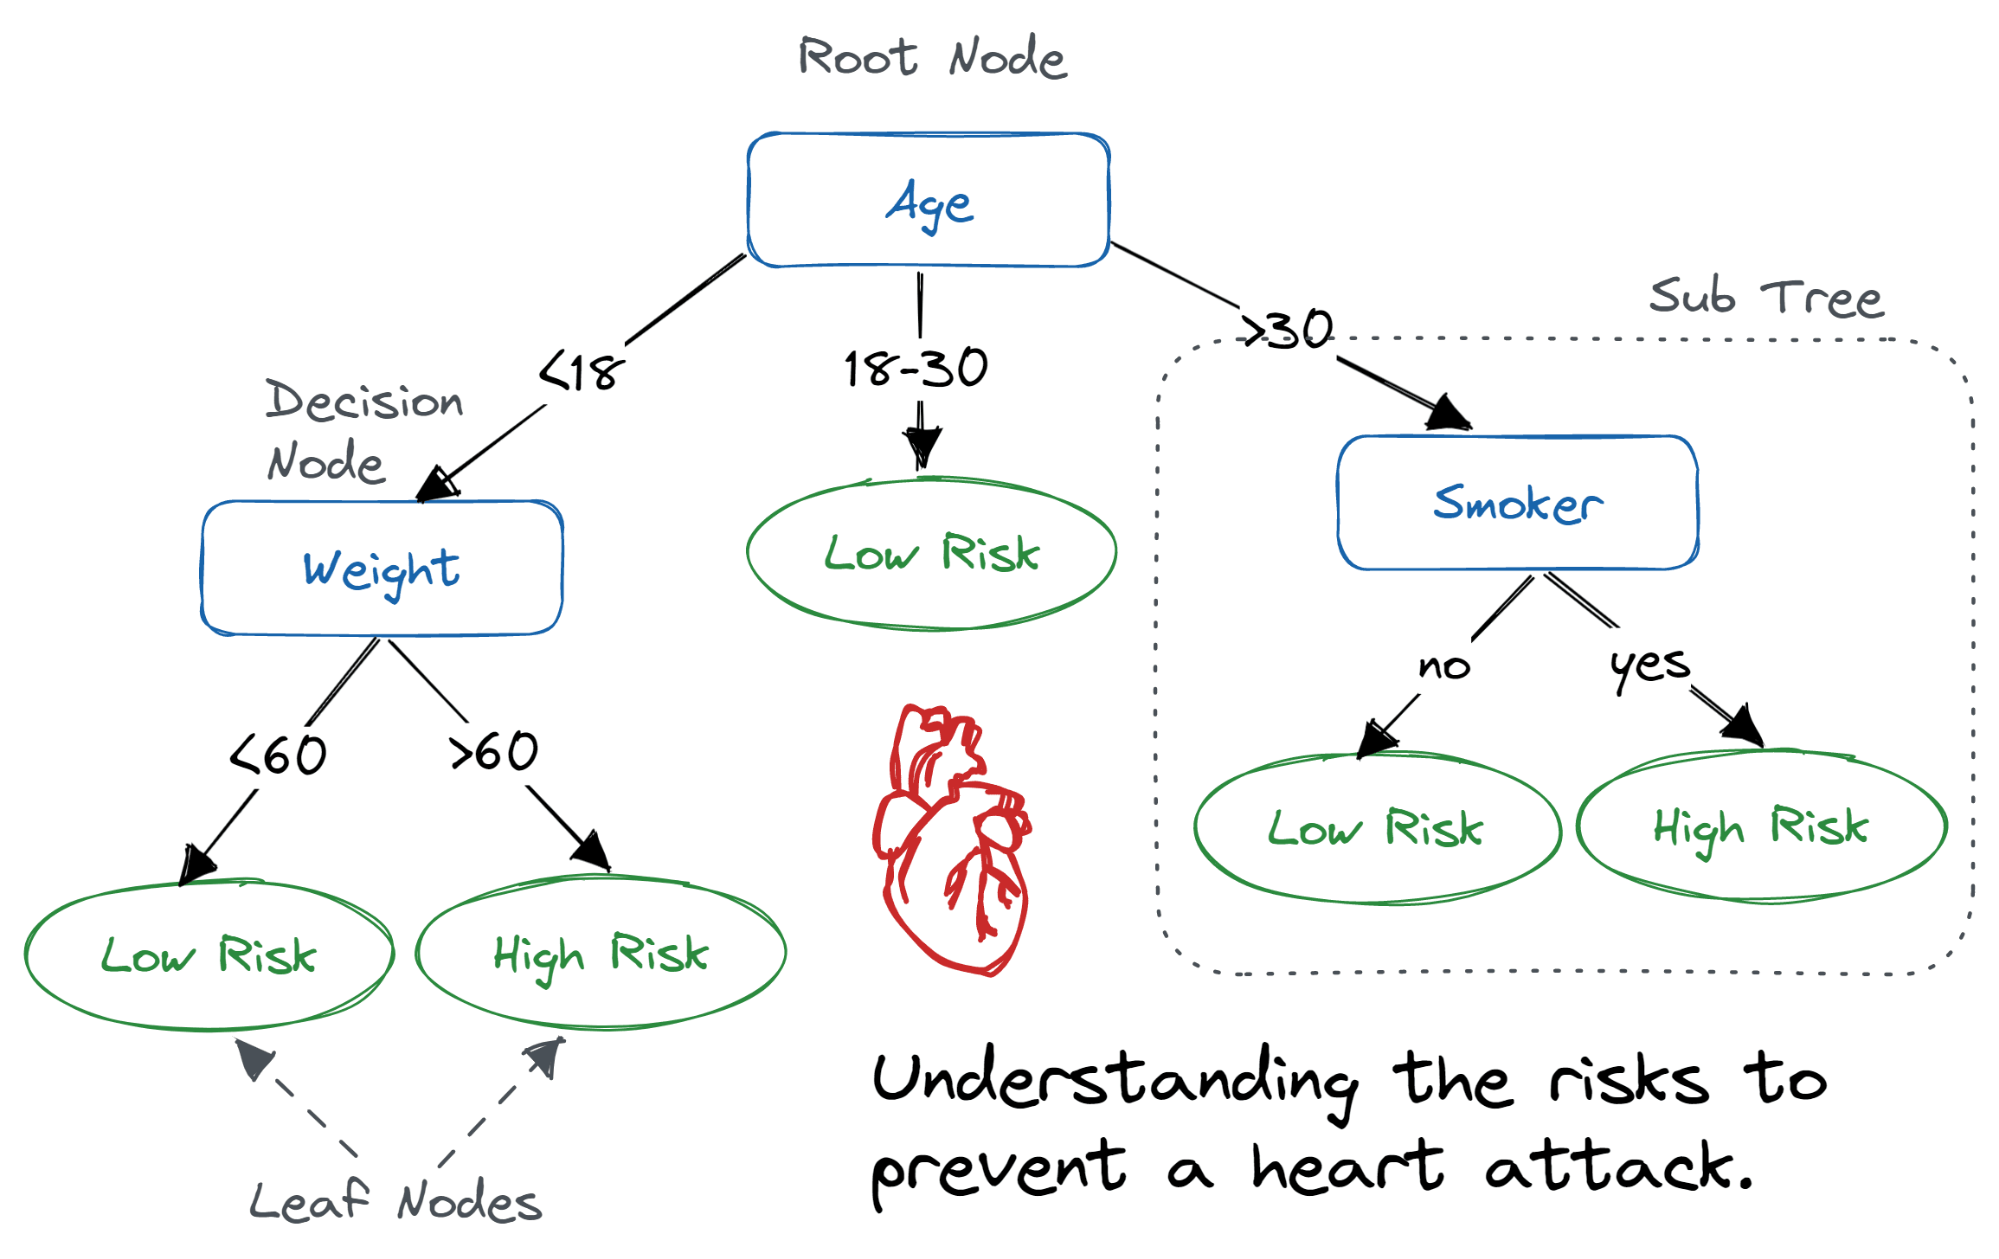
Nguồn: Hướng dẫn Phân loại bằng Cây quyết định trong Python
Rừng ngẫu nhiên là một mô hình tổ hợp gồm từ hai cây quyết định trở lên. Kỹ thuật này tận dụng bootstrap aggregation và phương pháp không gian con ngẫu nhiên để phát triển các cây riêng lẻ, nhằm đạt được bộ dự đoán tổng hợp mạnh mẽ cho cả phân loại và hồi quy.
Lưu ý, bootstrap aggregation, hay bagging, chỉ là một kỹ thuật tạo ra nhiều phiên bản của bộ dự đoán để xây dựng một bộ dự đoán tổng hợp. Mục tiêu là giảm tương quan giữa các bộ dự đoán để mô hình tổng hợp khái quát hóa tốt hơn.
Tính ngẫu nhiên được đưa vào mỗi bộ dự đoán bằng cách lấy mẫu ngẫu nhiên các quan sát từ tập huấn luyện có hoàn lại và dùng dữ liệu bootstrap để huấn luyện.
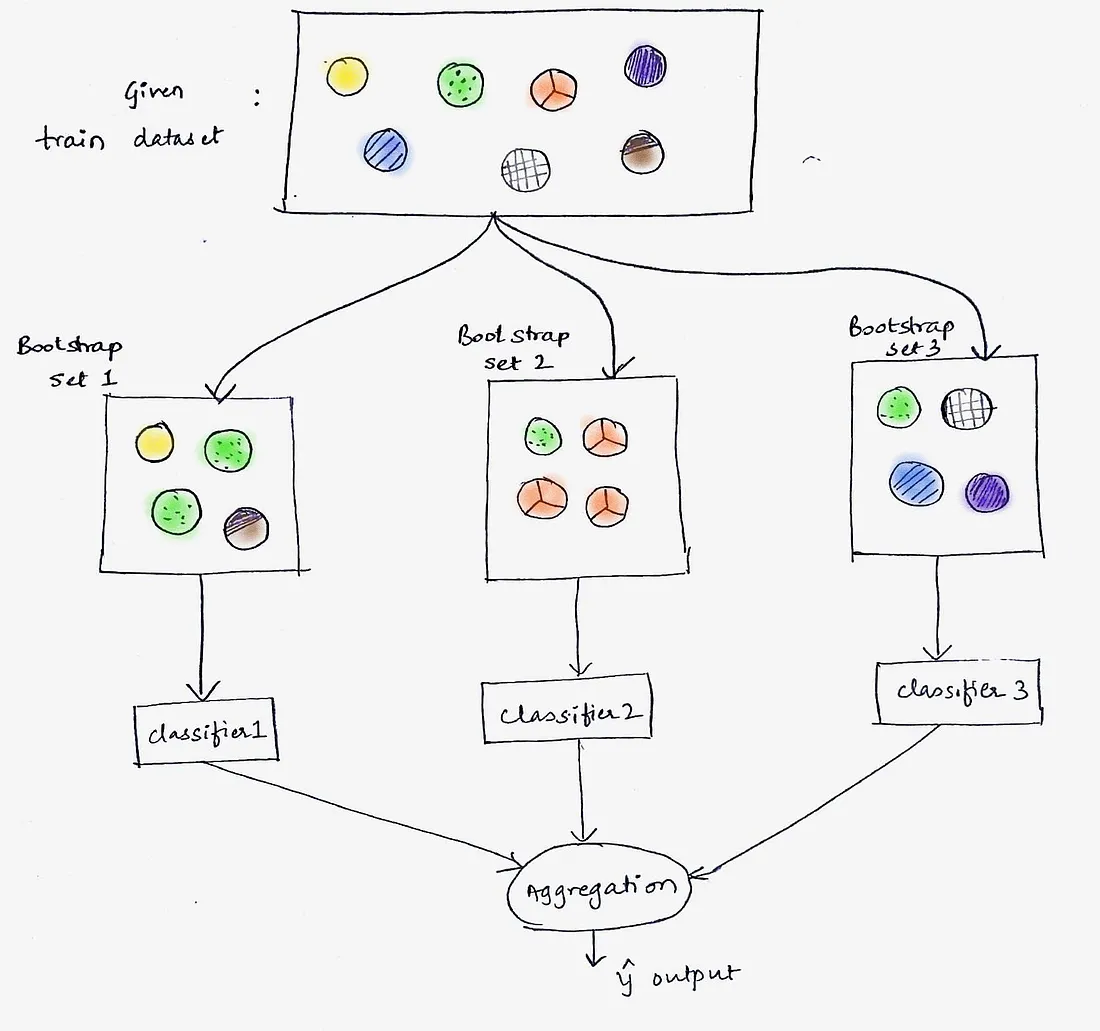
Nguồn: Bagging: Học máy qua trực quan. #1: “Bagging” là gì trong học tổ hợp?
Phương pháp không gian con ngẫu nhiên cũng được dùng để giảm tương quan giữa các bộ dự đoán trong tập hợp. Nó thường được gọi là “bagging đặc trưng” vì áp dụng cách tiếp cận tương tự bagging nhưng với các đặc trưng. Tức là: phương pháp không gian con ngẫu nhiên giảm tương quan bằng cách xây dựng mỗi bộ dự đoán trong tập hợp trên một mẫu ngẫu nhiên các đặc trưng có hoàn lại.
Bộ phân loại Naive Bayes là một thuật toán xác suất dựa trên định lý Bayes, một quy tắc toán học để cập nhật xác suất dựa trên dữ liệu mới.
Trong bối cảnh Naive Bayes, giả định “ngây thơ” là tất cả các đặc trưng (hoặc biến) trong tập dữ liệu độc lập với nhau khi dự đoán kết quả. Đây là sự đơn giản hóa vì thực tế các đặc trưng có thể phụ thuộc. Tuy vậy, dù giả định đơn giản như vậy, thuật toán thường cho hiệu quả đáng ngạc nhiên trong nhiều bài toán phân loại.
Vì vậy, bản thân định lý Bayes không giả định tính độc lập của các biến. Chính bộ phân loại Naive Bayes đưa ra giả định này để đơn giản và hiệu quả tính toán.
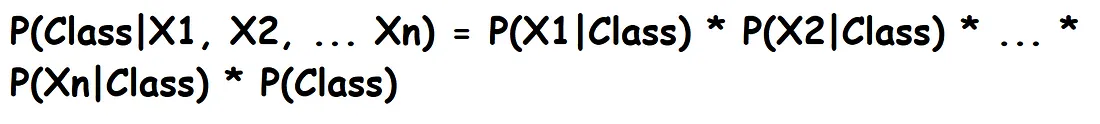
Để hiểu phân cụm, ta phải bắt đầu từ định nghĩa học không giám sát. Học không giám sát là cách tiếp cận dùng để khám phá cấu trúc tiềm ẩn của dữ liệu, ngoại trừ việc các thuật toán học không giám sát không cần ánh xạ đầu vào–đầu ra để làm được điều đó.
Học không giám sát thường được dùng để phát hiện các mẫu hiện hữu trong dữ liệu sao cho các quan sát được nhóm lại mà không cần nhãn. Nó giả định các quan sát cùng nhóm có đặc trưng tương tự. Do đó, phân cụm là một kỹ thuật học không giám sát dùng để nhóm dữ liệu không gán nhãn dựa trên sự tương đồng hoặc khác biệt của chúng.
Một số trường hợp sử dụng phân cụm gồm:
Dưới đây là một vài loại thuật toán phân cụm:
Một trong những thuật toán phổ biến và được dùng rộng rãi nhất cho bài toán phân cụm là k-means. Đây là một thuật toán dựa trên trọng tâm, lặp, tạo ra các cụm không chồng lấn.
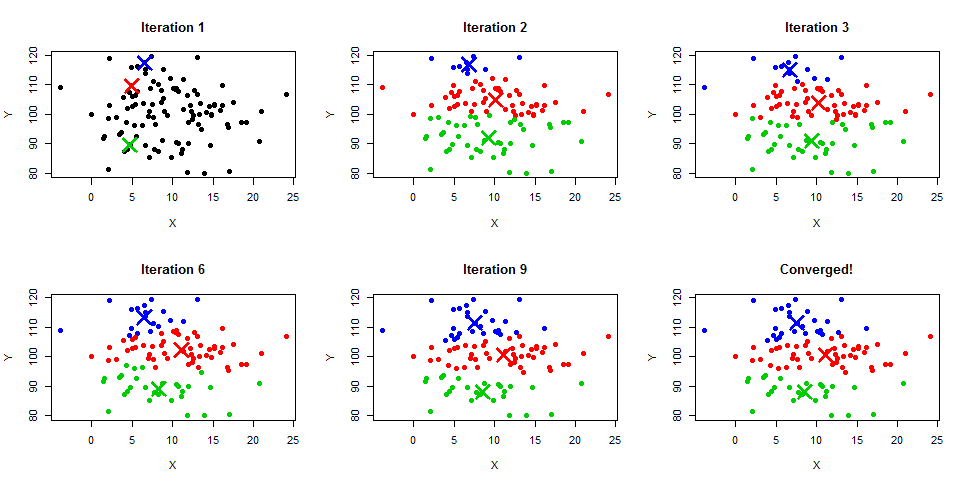
Một cách khác để xây dựng các cụm là tạo ra một hệ phân cấp các cụm, do đó có tên “phân cụm phân cấp.” Có hai cách để xây dựng hệ phân cấp cụm: .
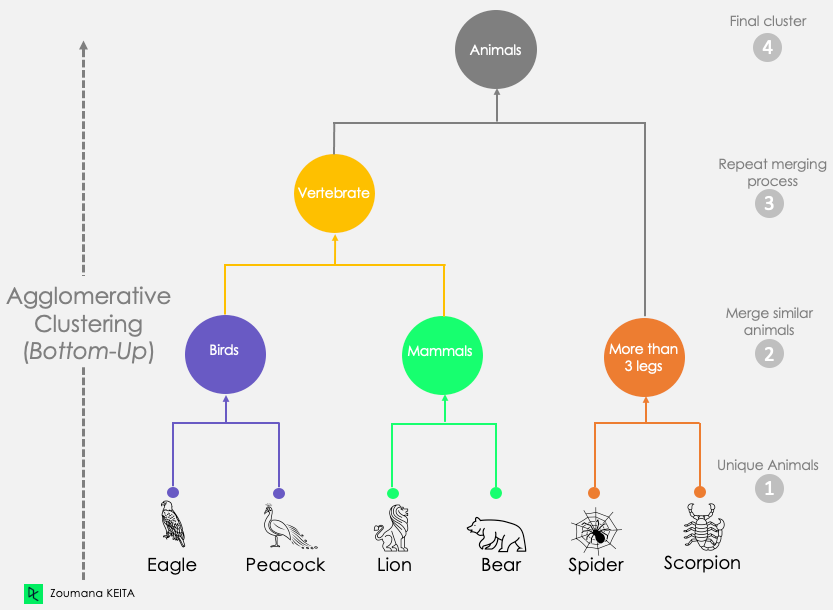
Gom nhóm (Agglomerative)
Đây là cách tiếp cận từ dưới lên, trong đó mỗi quan sát ban đầu được coi là một cụm riêng. Khi cấu trúc phân cấp được xây từ dưới lên, các quan sát được ghép thành cặp, và các cặp được hợp nhất thành các cụm.
Nguồn: Giới thiệu về phân cụm phân cấp trong Python
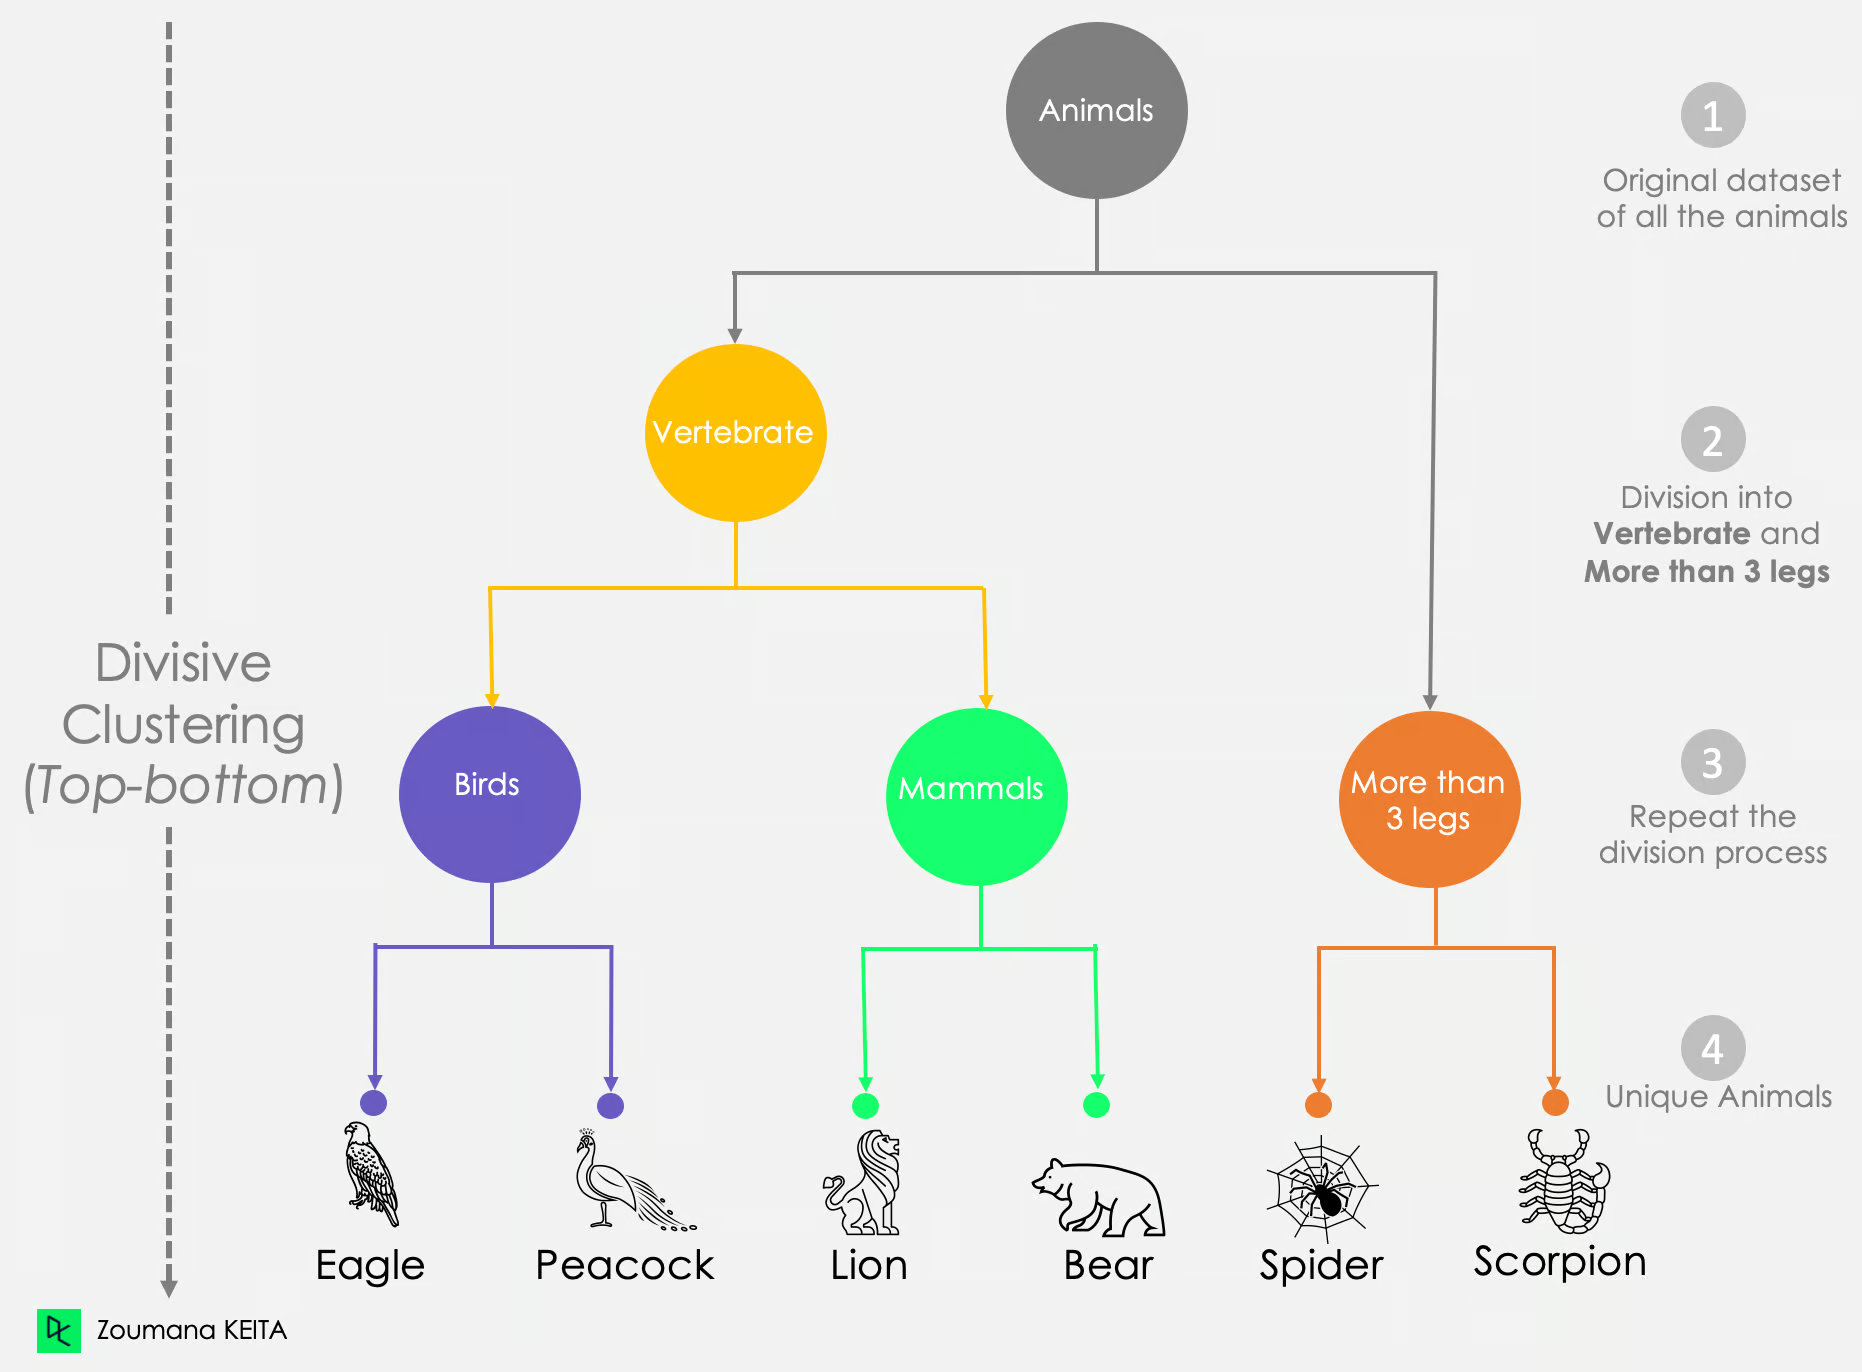
Phân chia (Divisive)
Phân cụm phân chia là cách tiếp cận từ trên xuống, nơi tất cả các quan sát bắt đầu trong một cụm, và các phép tách được thực hiện đệ quy để xây dựng hệ phân cấp từ trên xuống.
Nguồn: Giới thiệu về phân cụm phân cấp trong Python
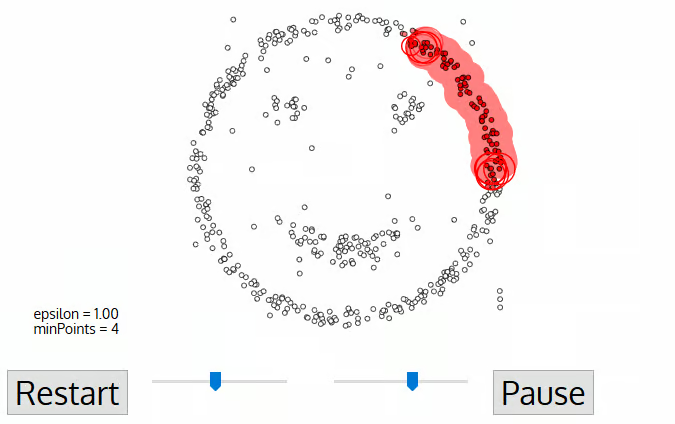
Một trong những điểm hấp dẫn lớn của Density-Based Spatial Clustering of Applications with Noise, hay viết tắt là DBSCAN, là khả năng chống chịu với ngoại lệ — đây cũng là thuật toán phân cụm dựa trên mật độ nổi tiếng nhất.
DBSCAN giả định các cụm là những vùng có mật độ dày trong không gian, được ngăn cách bởi các vùng thưa hơn. Không giống K-Means, DBSCAN suy ra số cụm dựa trên dữ liệu và có thể phát hiện các cụm có hình dạng bất kỳ, nên không cần truyền số cụm làm tham số.
OPTICS là viết tắt của Ordering Points to Identify the Clustering Structure. Giống DBSCAN, đây là một thuật toán dựa trên mật độ do cùng một nhóm nghiên cứu phát triển. Tuy nhiên, OPTICS tìm cách khắc phục một nhược điểm lớn của DBSCAN — nhận diện cụm trong dữ liệu có mật độ thay đổi — bằng cách loại bỏ giả định rằng mật độ dữ liệu đồng nhất.
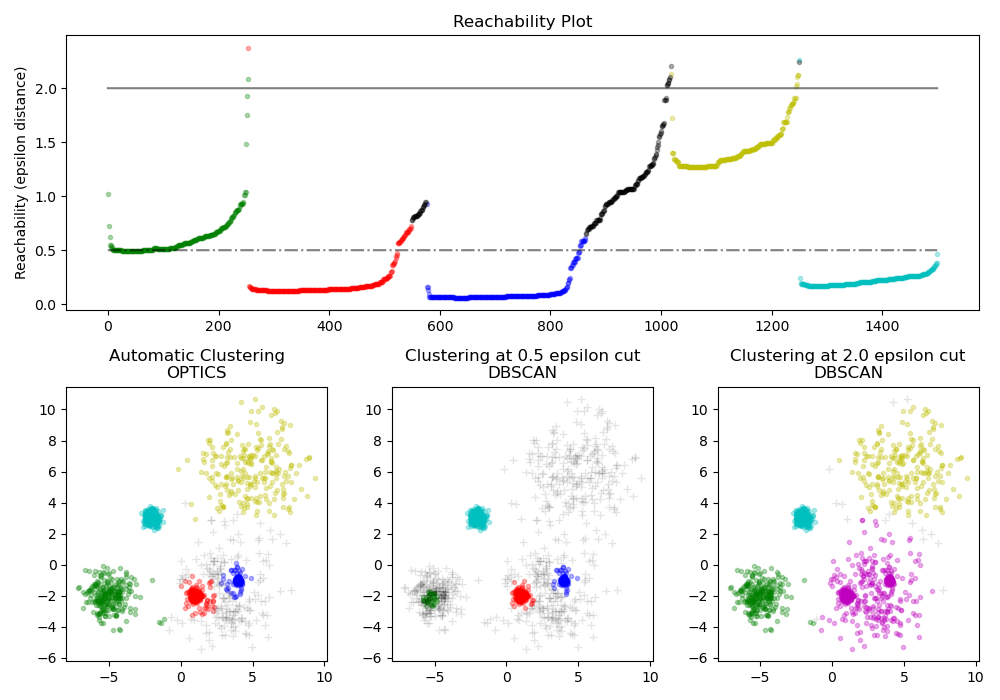
Nguồn: Bản trình diễn thuật toán phân cụm OPTICS của Scikit-learn
Phân loại là một dạng học có giám sát. Bài toán học có giám sát liên quan đến việc học một hàm ánh xạ đầu vào sang đầu ra dựa trên các cặp đầu vào–đầu ra. Ngược lại, các tác vụ học không giám sát sử dụng những phương pháp như phân cụm để khám phá mẫu ẩn trong dữ liệu không gán nhãn.
Cả phân loại và phân cụm đều cần dữ liệu huấn luyện để học mẫu. Tuy nhiên, thông lệ tốt là có dữ liệu kiểm tra cho các tác vụ phân loại để đánh giá hiệu năng dự đoán của mô hình học máy.
Thuật toán phân cụm dựa vào dữ liệu đầu vào để mô hình hóa cấu trúc tiềm ẩn nhằm khám phá hiểu biết. Nói cách khác, không có “giáo viên” cung cấp đáp án đúng — thuật toán tự học những gì có thể. Ngược lại, thuật toán phân loại cần cả dữ liệu đầu vào và đầu ra để học hàm ánh xạ, từ đó dự đoán đầu ra cho dữ liệu đầu vào mới.
|
Phân loại |
Phân cụm |
|
|
Có giám sát |
Có |
Không |
|
Có nhãn |
Có |
Không |
|
Mục đích |
Xấp xỉ hàm ánh xạ (f) từ tập đầu vào (X) sang đầu ra rời rạc (y) để có thể dùng dự đoán đầu ra cho đầu vào mới. |
Học các mẫu tiềm ẩn trong đầu vào (X) để gợi ý những nhóm mà các quan sát có thể được tách vào. |
|
Thuật toán |
Hồi quy logistic, K-lân cận gần nhất, Cây quyết định, Rừng ngẫu nhiên, Naive Bayes |
K-means, phân cụm gom nhóm, phân cụm phân chia, DBSCAN, OPTICS |
|
Trường hợp sử dụng |
Khách hàng rời bỏ, phê duyệt khoản vay, lọc thư rác, nhận diện khuôn mặt |
Phân khúc thị trường, phân đoạn ảnh, phân tích mạng xã hội, hệ thống gợi ý. |
Mặc dù cả phân loại và phân cụm đều nhằm tách các quan sát thành những nhóm rời rạc, cách tiếp cận của chúng khác nhau căn bản. Phân loại dựa vào nhãn được xác định sẵn và có “người hướng dẫn” để dẫn dắt quá trình học, phù hợp cho các tác vụ như dự đoán khách hàng rời bỏ hay lọc thư rác. Ngược lại, phân cụm vận hành không có giám sát và mang tính khám phá, thường được áp dụng trong phân khúc thị trường hay hệ thống gợi ý. Hiểu những khác biệt này có thể ảnh hưởng đáng kể đến hiệu quả dự án học máy của bạn.
Muốn tìm hiểu sâu hơn? Hãy xem các khóa học DataCamp sau để nâng cao hiểu biết và kỹ năng của bạn:
Đào sâu Giới thiệu về Phân loại & Phân cụm
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Google