
कोर्स
Python में क्लस्टर विश्लेषण
4 घंटा
65.9K
मशीन लर्निंग में वस्तुओं को अलग-अलग समूहों में बाँटने के लिए दो तकनीकें उपलब्ध हैं: classification और clustering। यह बात शुरुआती प्रैक्टिशनर्स में अक्सर भ्रम पैदा करती है।
ऊपरी तौर पर classification और clustering समान दिखते हैं। दोनों ही ऐसे एल्गोरिद्म का उपयोग करते हैं जो किसी दिए गए डेटासेट की विशेषताओं का लाभ उठाकर पैटर्न खोजते हैं और उदाहरणों को अलग-अलग समूहों में बाँटते हैं। लेकिन व्यावहारिक दृष्टि से, वे काफी अलग हैं।
इस लेख में, हम प्रत्येक तकनीक, उनसे जुड़े विभिन्न एल्गोरिद्म, उनके अनुप्रयोग, और सबसे महत्वपूर्ण, उनके बीच के अंतर को कवर करेंगे।
Classification कार्य उन समस्याओं की श्रेणी में आते हैं जिन्हें “supervised learning” कहा जाता है। ऐसी समस्याओं में ऐसे मॉडल विकसित करना शामिल है जो ऐतिहासिक डेटा से सीखकर नए उदाहरणों पर भविष्यवाणियाँ करते हैं।
औपचारिक रूप से, supervised learning वे कार्य हैं जिनमें उदाहरण स्वरूप इनपुट-आउटपुट युग्मों के आधार पर किसी इनपुट को आउटपुट से मैप करने वाला एक फंक्शन सीखा जाता है। अतः उद्देश्य इनपुट (X) से आउटपुट (y) तक मैपिंग फंक्शन (f) का अनुमान लगाना होता है — यदि आपका गणितीय पृष्ठभूमि है, तो आप इसे function approximation की समस्या के रूप में जानते होंगे।
यह ध्यान रखने योग्य है कि supervised learning दो रूपों में आता है: regression और classification।
Classification समस्याओं में, सीखने वाले एल्गोरिद्म का उद्देश्य विशेषताओं के सेट से मैपिंग फंक्शन का अनुमान लगाकर एक discrete आउटपुट की भविष्यवाणी करना होता है (जैसे, यह भविष्यवाणी करना कि छवि बिल्ली है या कुत्ता) — हमारे Python में टेक्स्ट क्लासिफिकेशन समझें ट्यूटोरियल में इसका व्यावहारिक प्रदर्शन देखें।
कई समस्याएँ हैं जिनमें classification एल्गोरिद्म का उपयोग होता है, जैसे:
आइए कुछ classification एल्गोरिद्म पर नज़र डालें।
अक्सर लोग स्वाभाविक रूप से logistic regression को regression एल्गोरिद्म समझ लेते हैं। तकनीकी रूप से, वे पूरी तरह गलत नहीं हैं। Logistic regression सांख्यिकीय classification नहीं करती; यह एक logistic मॉडल के पैरामीटर का अनुमान लगाती है।
हम logistic regression को classification के लिए इसलिए उपयोग कर पाते हैं क्योंकि कक्षाओं को अलग करने के लिए एक decision boundary डाली जाती है। अतः, अपने सबसे सरल रूप में, logistic regression बाइनरी अवलंबी चरों को मॉडल करने के लिए logistic फंक्शन का उपयोग करती है।
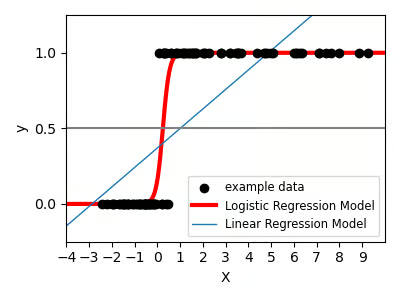
स्रोत: Scikit-Learn द्वारा Logistic Function
KNN सबसे कम जटिल मशीन लर्निंग एल्गोरिद्म में से एक है और logistic regression से भिन्न है क्योंकि इसे classification और regression दोनों कार्यों के लिए इस्तेमाल किया जा सकता है।
यह एक non-parametric, lazy learning एल्गोरिद्म है। इसका मतलब है कि KNN नमूने की विशेषताओं या डेटा के गुणात्मक/मात्रात्मक होने के बारे में कोई मान्यताएँ नहीं बनाता (non-parametric), और सभी गणना फंक्शन मूल्यांकन तक स्थगित रहती है (lazy learner)।
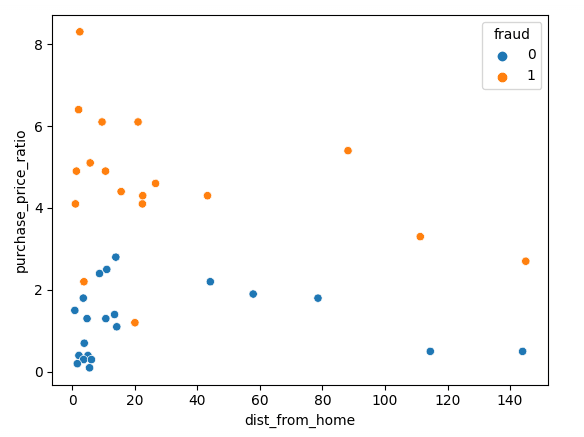
स्रोत: Scikit-learn के साथ Nearest Neighbors
Decision tree एल्गोरिद्म एक लोकप्रिय non-parametric एल्गोरिद्म है जो regression और classification दोनों करने में सक्षम है। इसकी लोकप्रियता का एक बड़ा कारण इसकी समझनीयता और सादगी है — क्योंकि इसे visualize और interpret करना सबसे आसान एल्गोरिद्म में से एक है।
संकल्पनात्मक रूप से, आप decision tree को एक flow की तरह सोच सकते हैं, जो root से leaves तक बहता है। root से किसी leaf तक का मार्ग, विशेषताओं पर आधारित एक निर्णय नियम को परिभाषित करता है।
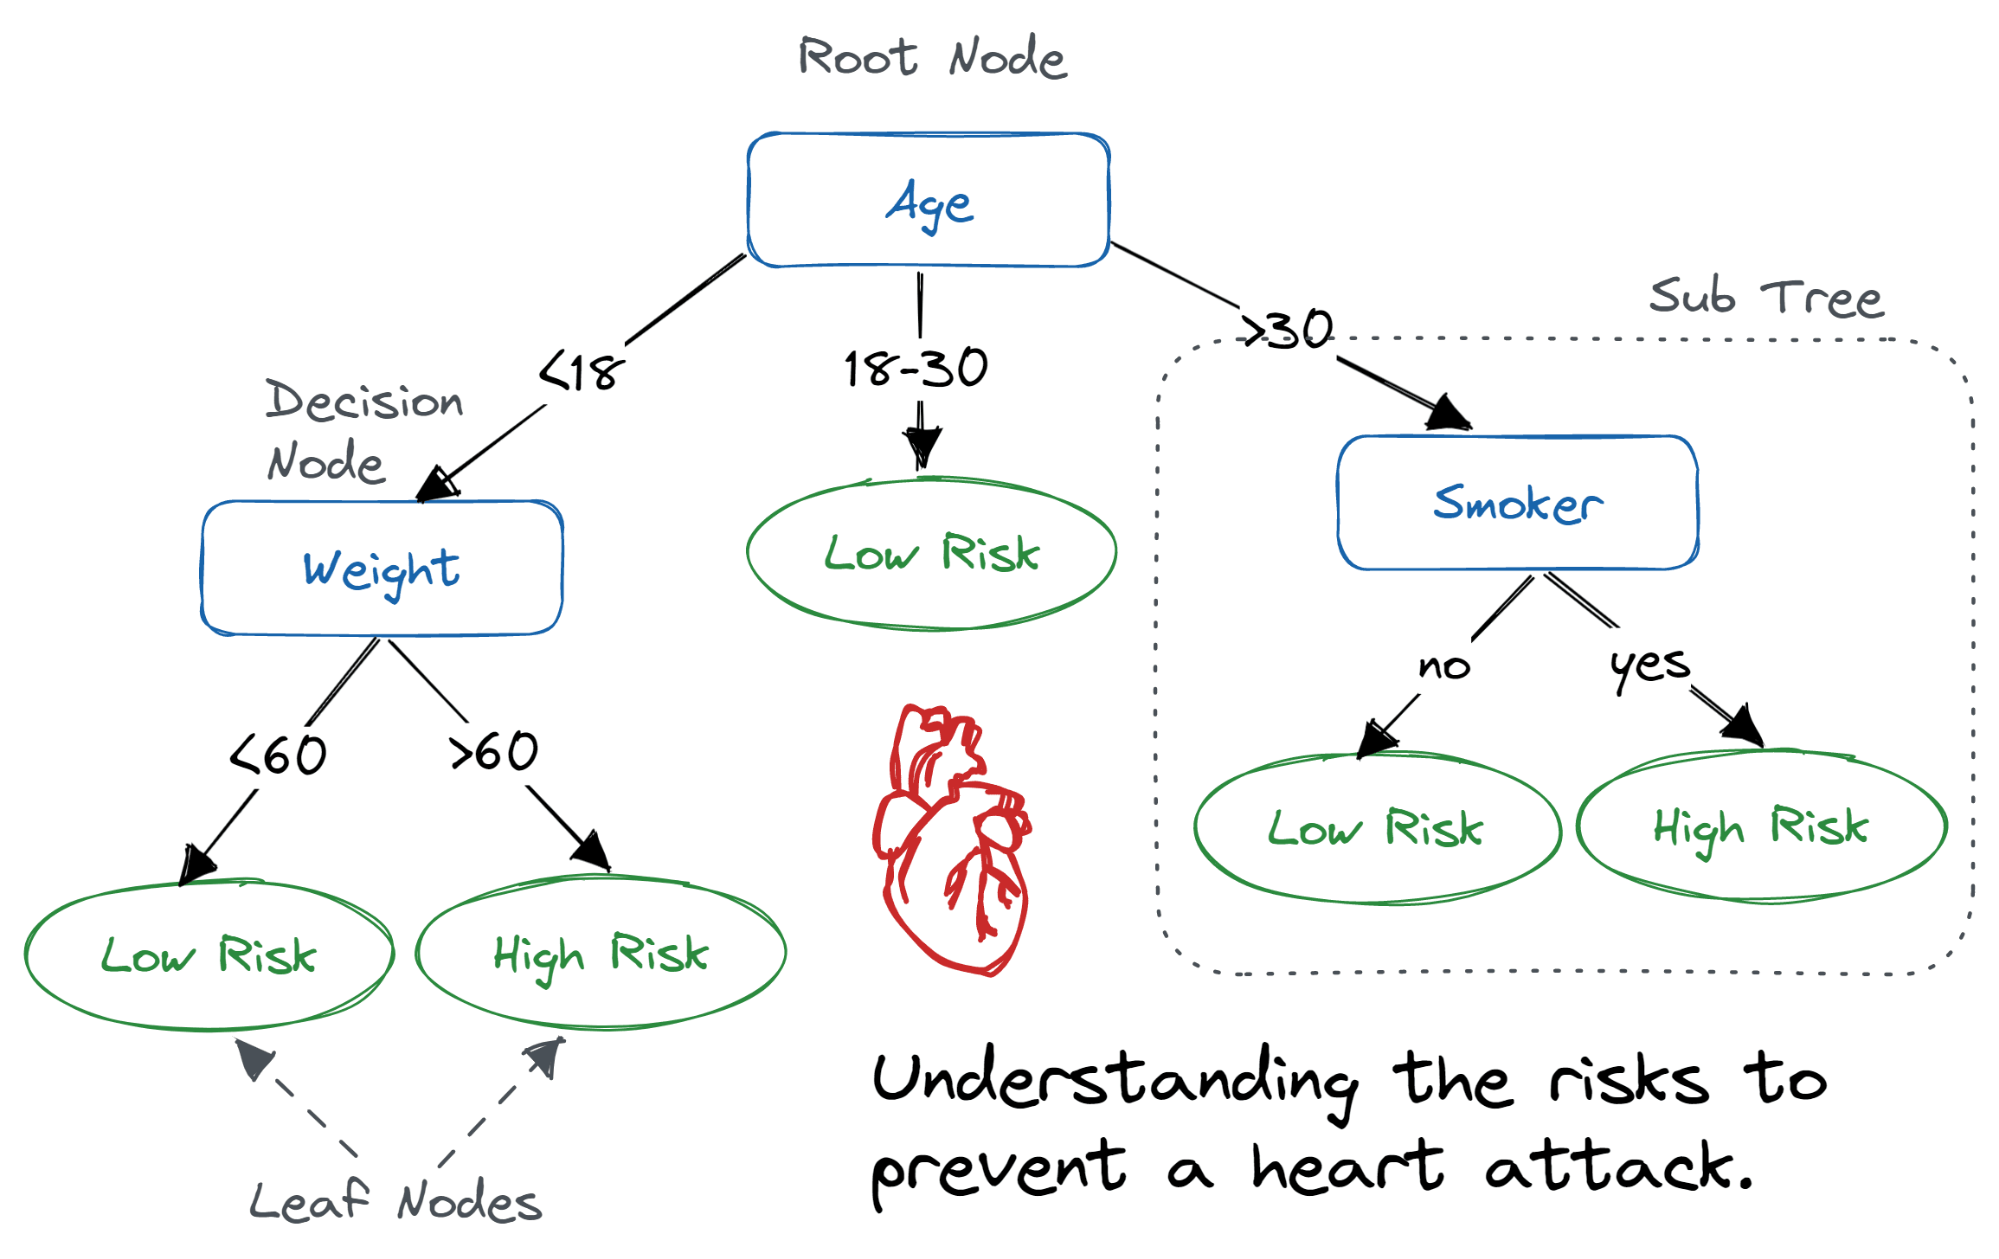
स्रोत: Python ट्यूटोरियल में Decision Tree Classification
Random forest एक ensemble मॉडल है जो दो या अधिक decision trees से मिलकर बना होता है। यह तकनीक bootstrap aggregation और random subspace विधि का उपयोग करके व्यक्तिगत पेड़ों को उगाती है ताकि एक शक्तिशाली समेकित predictor तैयार किया जा सके जो classification और regression दोनों करने में सक्षम हो।
ध्यान दें, bootstrap aggregation, या bagging, केवल एक तकनीक है जिसका उपयोग किसी predictor के कई संस्करण उत्पन्न करने के लिए किया जाता है, जिन्हें मिलाकर एक aggregated predictor बनाया जा सके। लक्ष्य यह है कि aggregated मॉडल के बेहतर generalize करने के लिए predictors के बीच सहसंबंध घटाया जाए।
प्रत्येक predictor में यादृच्छिकता इस तरह डाली जाती है कि training सेट से replacement के साथ उदाहरणों का यादृच्छिक सैंपलिंग किया जाता है और bootstrapped डेटा पर प्रशिक्षण होता है।
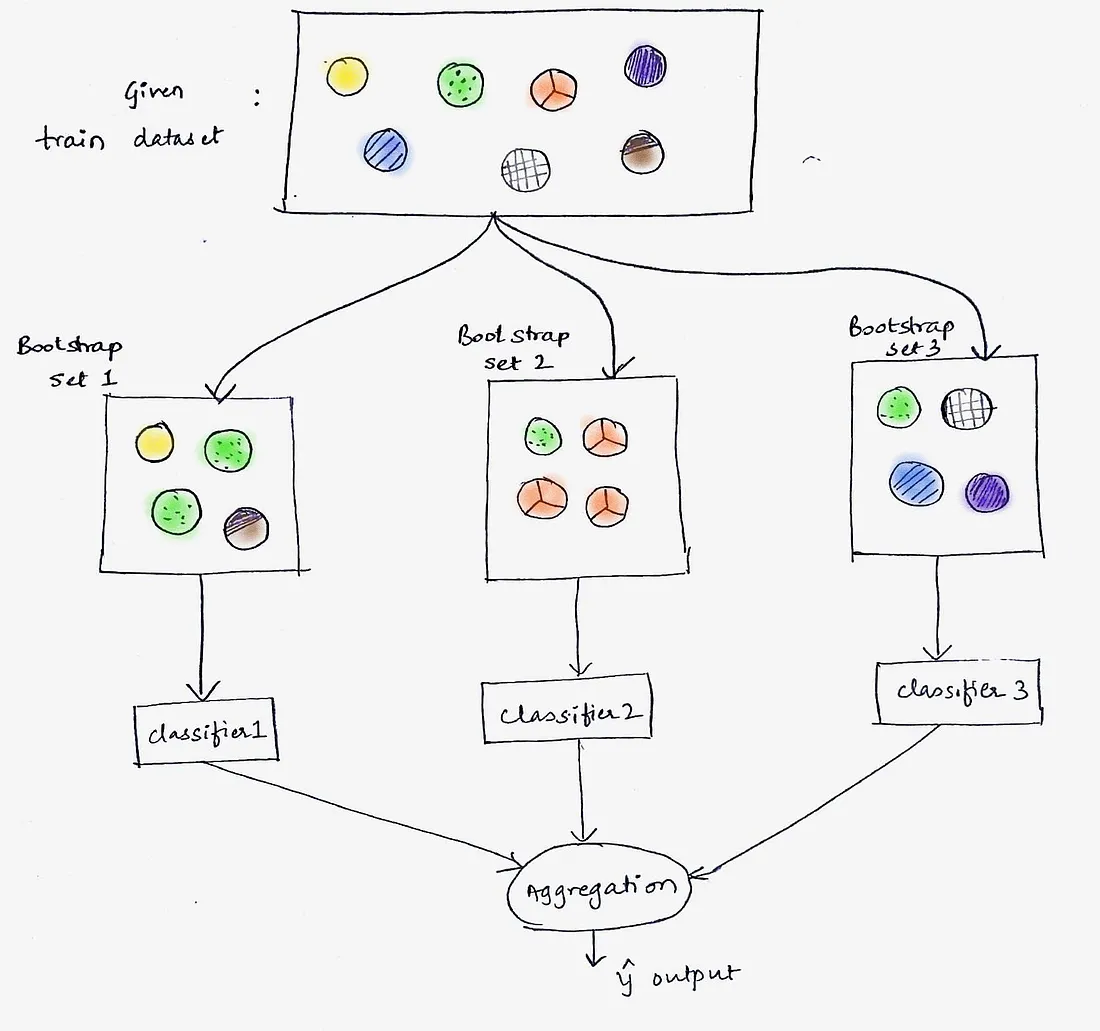
स्रोत: बैगिंग: दृश्य माध्यम से मशीन लर्निंग। #1: “Bagging” ensemble learning क्या है?
Ensemble के भीतर predictors के बीच सहसंबंध कम करने के लिए random subspace विधि का भी उपयोग किया जाता है। इसे अक्सर “feature bagging” कहा जाता है क्योंकि यह bagging जैसा ही दृष्टिकोण अपनाती है, बस विशेषताओं पर। यानी: random subspace विधि प्रत्येक predictor को features के एक यादृच्छिक सैंपल (replacement के साथ) पर बनाकर सहसंबंध घटाती है।
Naive Bayes classifier Bayes के प्रमेय पर आधारित एक प्रायिकतामूलक एल्गोरिद्म है, जो नई जानकारी के आधार पर प्रायिकताओं को अद्यतन करने का एक गणितीय नियम है।
Naive Bayes के संदर्भ में, "naive" मान्यता यह है कि परिणाम की भविष्यवाणी करते समय डेटासेट की सभी विशेषताएँ (या चर) एक-दूसरे से स्वतंत्र हैं। यह एक सरलीकरण है क्योंकि वास्तविकता में विशेषताएँ परस्पर निर्भर हो सकती हैं। फिर भी, इस naive मान्यता के बावजूद, यह एल्गोरिद्म कई classification कार्यों में आश्चर्यजनक रूप से अच्छा प्रदर्शन करता है।
तो, Bayes का प्रमेय स्वयं चरों की स्वतंत्रता के बारे में कोई मान्यता नहीं बनाता। सरलता और संगणनात्मक दक्षता के लिए यह मान्यता Naive Bayes classifier बनाता है।
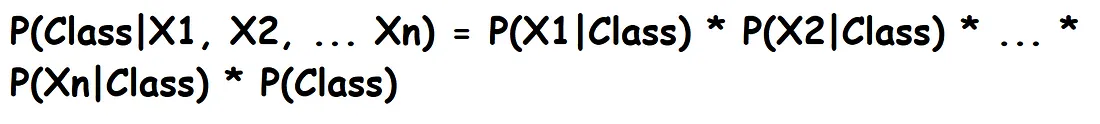
Clustering को समझने के लिए, हमें unsupervised learning की परिभाषा से शुरू करना होगा। Unsupervised learning डेटा की अंतर्निहित संरचना खोजने का एक तरीका है, सिवाय इसके कि unsupervised एल्गोरिद्म को यह उपलब्धि हासिल करने के लिए input-to-output मैपिंग की ज़रूरत नहीं होती।
Unsupervised learning का उपयोग आमतौर पर डेटा में मौजूदा पैटर्न खोजने के लिए किया जाता है ताकि उदाहरणों को बिना लेबल के समूहित किया जा सके। यह मानता है कि एक ही समूह में आने वाले उदाहरणों की विशेषताएँ समान हैं। इस प्रकार, clustering एक unsupervised learning तकनीक है जो समानताओं या भिन्नताओं के आधार पर बिना लेबल वाले डेटा को समूहित करती है।
Clustering के उपयोग मामलों में शामिल हैं:
यहाँ clustering एल्गोरिद्म के कुछ प्रकार दिए गए हैं:
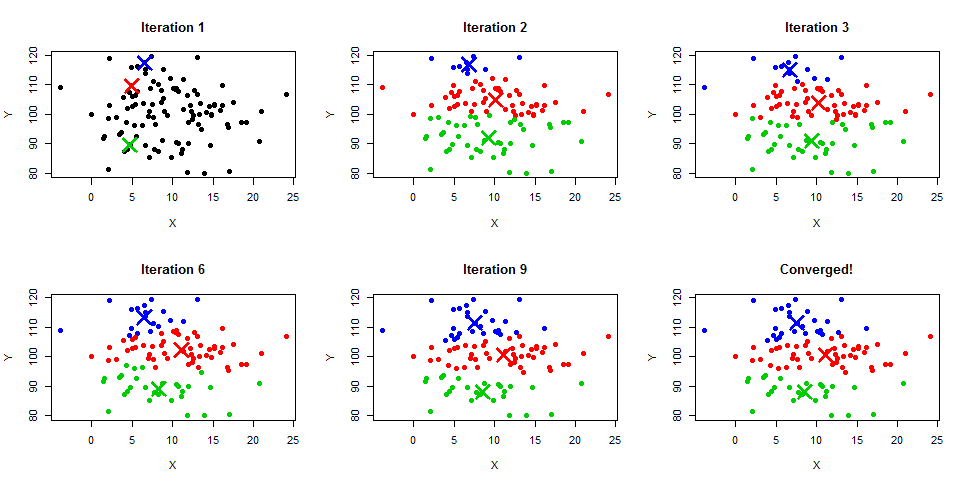
Clustering कार्यों के लिए सबसे लोकप्रिय और व्यापक रूप से उपयोग किए जाने वाले एल्गोरिद्म में से एक k-means है। यह एक centroid-आधारित, iterative एल्गोरिद्म है जो non-overlapping क्लस्टर्स बनाता है।
क्लस्टर बनाने का एक और तरीका यह है कि क्लस्टर्स का एक पदानुक्रम बनाया जाए, इसलिए नाम “hierarchical clustering।” क्लस्टर्स का पदानुक्रम बनाने के दो तरीके हैं:
Agglomerative
यह एक bottom-up दृष्टिकोण है जिसमें प्रारंभिक चरणों में प्रत्येक observation को अपने आप में एक क्लस्टर माना जाता है। जैसे-जैसे पदानुक्रम नीचे से ऊपर बनता है, प्रत्येक observation जोड़ों में मिलती है, और जोड़े क्लस्टर्स में मिलते जाते हैं।
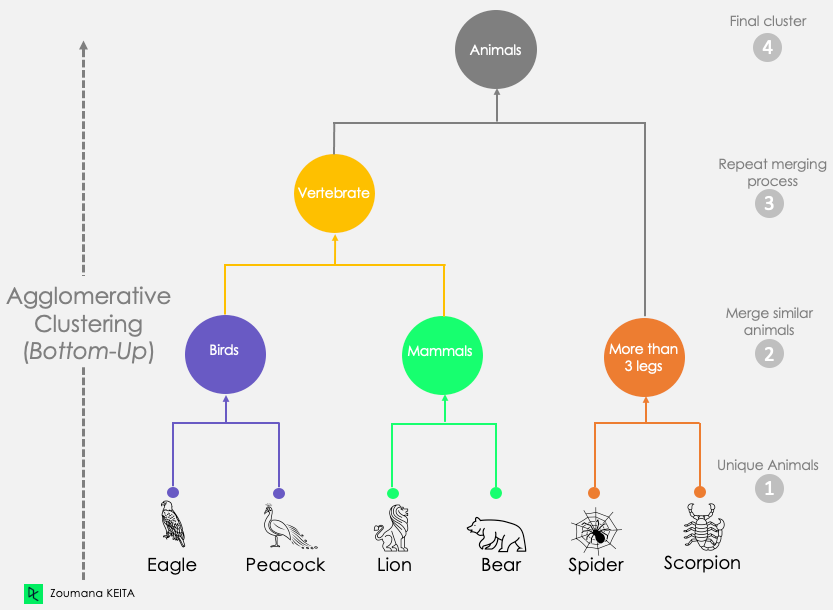
स्रोत: Python में Hierarchical clustering का परिचय
Divisive
Divisive clustering एक top-down दृष्टिकोण है जिसमें सभी observations एक ही क्लस्टर में शुरू होती हैं, और ऊपर से नीचे तक पदानुक्रम बनाने के लिए पुनरावर्ती रूप से विभाजन किए जाते हैं।
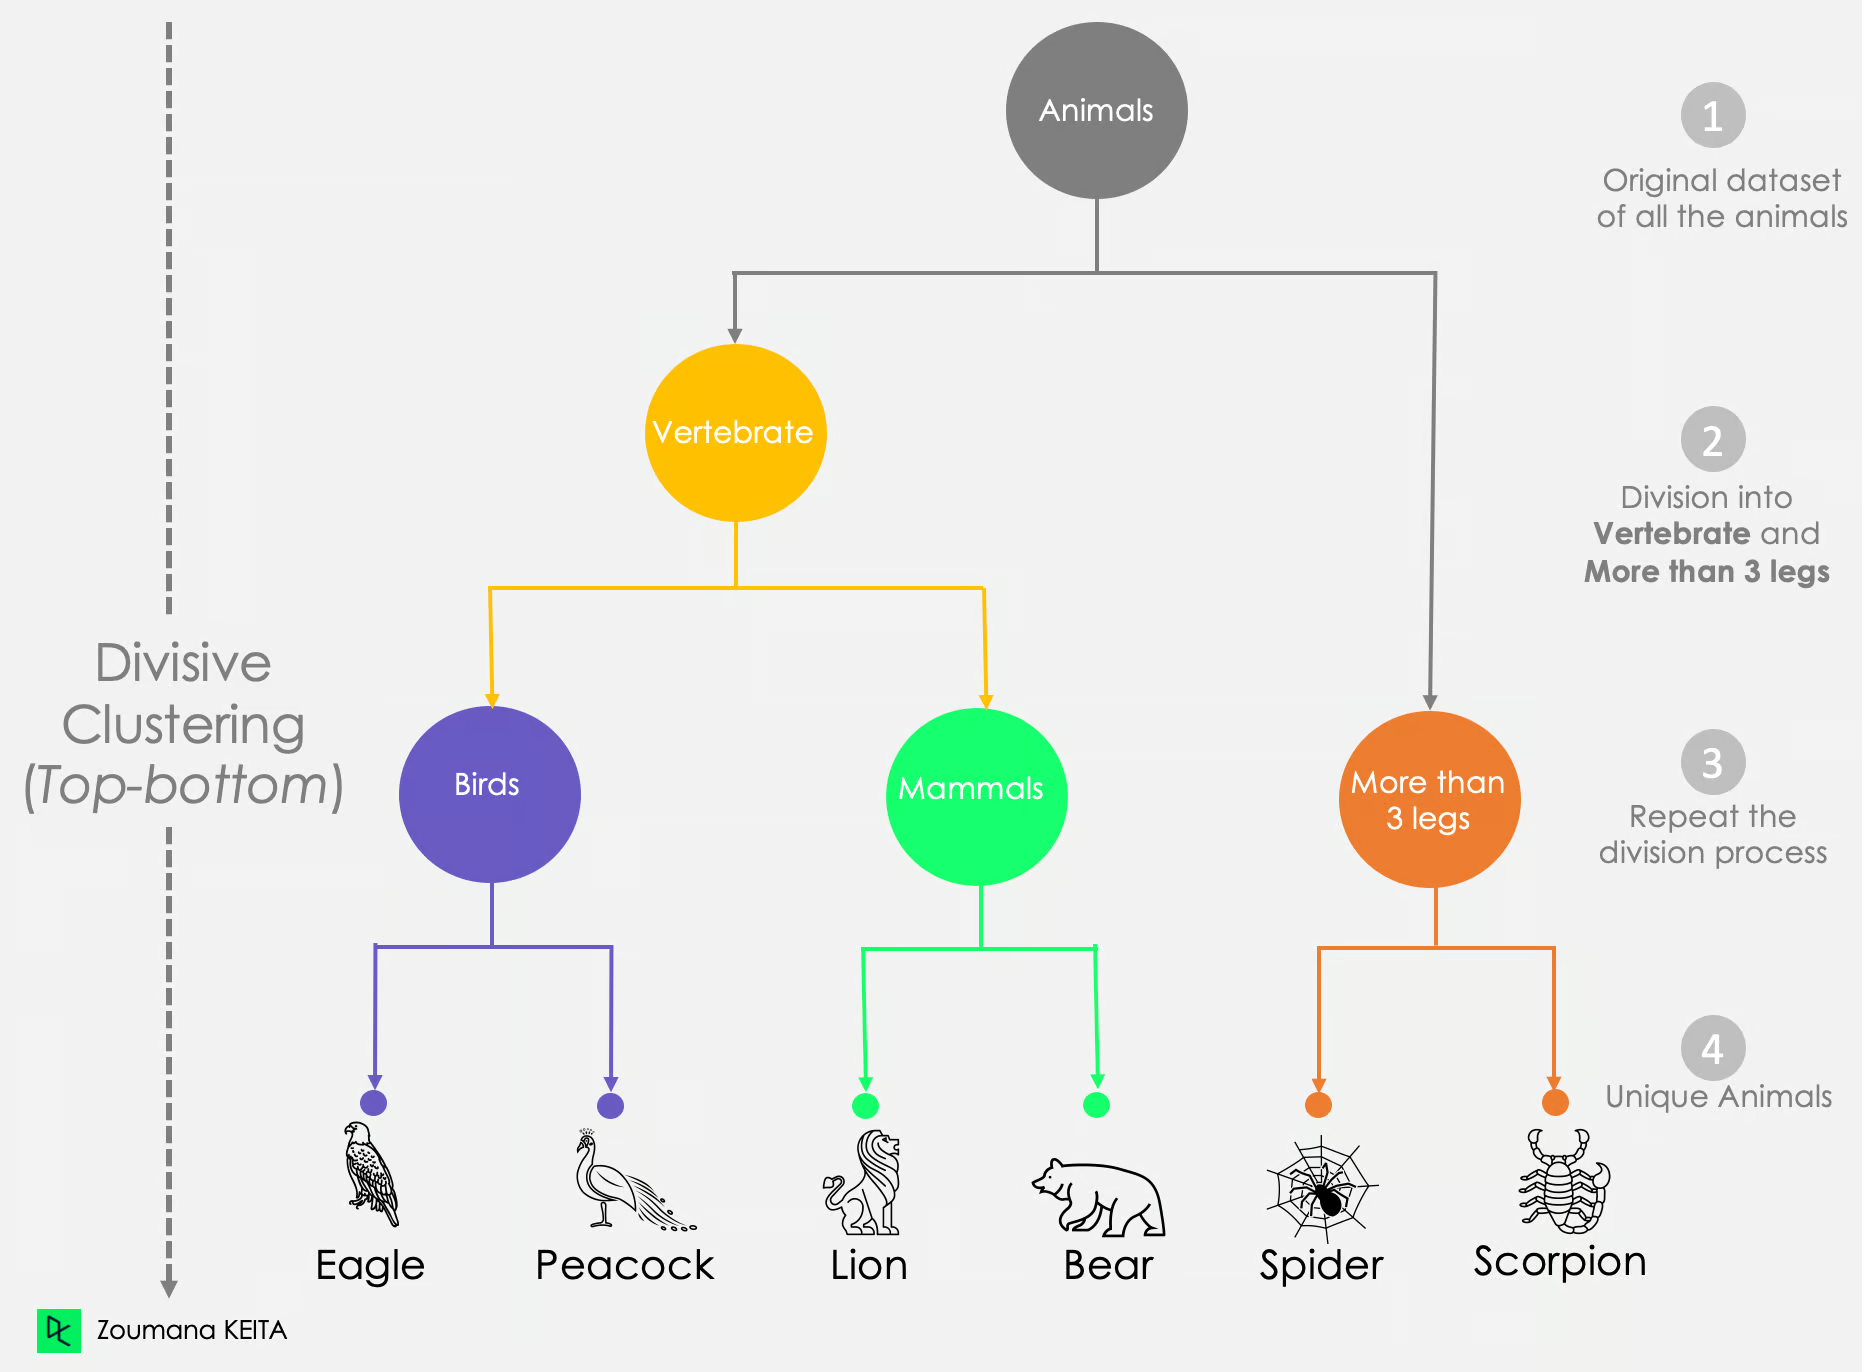
स्रोत: Python में Hierarchical clustering का परिचय
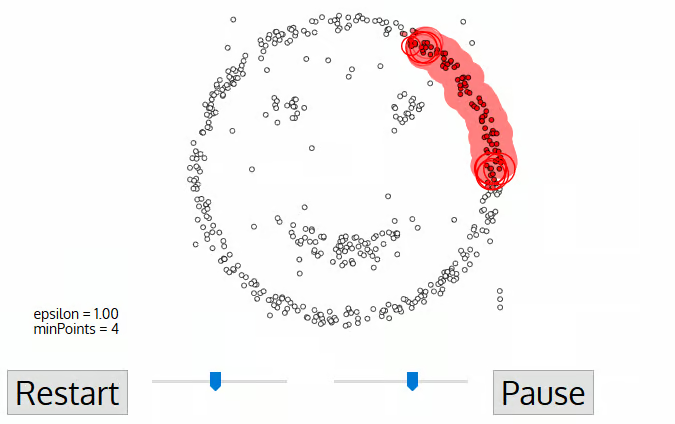
Density-Based Spatial Clustering of Applications with Noise, संक्षेप में DBSCAN, की एक बड़ी विशेषता outliers के प्रति इसकी मजबूती है — यह सबसे प्रसिद्ध density-आधारित clustering एल्गोरिद्म भी है।
DBSCAN मानता है कि क्लस्टर्स स्थान में घनी क्षेत्रों के रूप में होते हैं जो कम-घनत्व वाले क्षेत्रों से अलग होते हैं। K-Means के विपरीत, DBSCAN डेटा के आधार पर क्लस्टर्स की संख्या का अनुमान लगाता है, और यह मनमाने आकार के क्लस्टर्स खोज सकता है, इसलिए क्लस्टर्स की संख्या को पैरामीटर के रूप में पास करने की ज़रूरत नहीं पड़ती।
OPTICS का संक्षिप्तीकरण है Ordering Points to Identify the Clustering Structure। DBSCAN की तरह, यह भी उसी शोध समूह द्वारा विकसित एक density-आधारित एल्गोरिद्म है। हालाँकि, OPTICS DBSCAN की एक बड़ी कमी — विभिन्न घनत्व वाले डेटा में क्लस्टर्स की पहचान — को दूर करने का प्रयास करता है, और यह मान्यता छोड़ देता है कि डेटा का घनत्व एकसमान है।
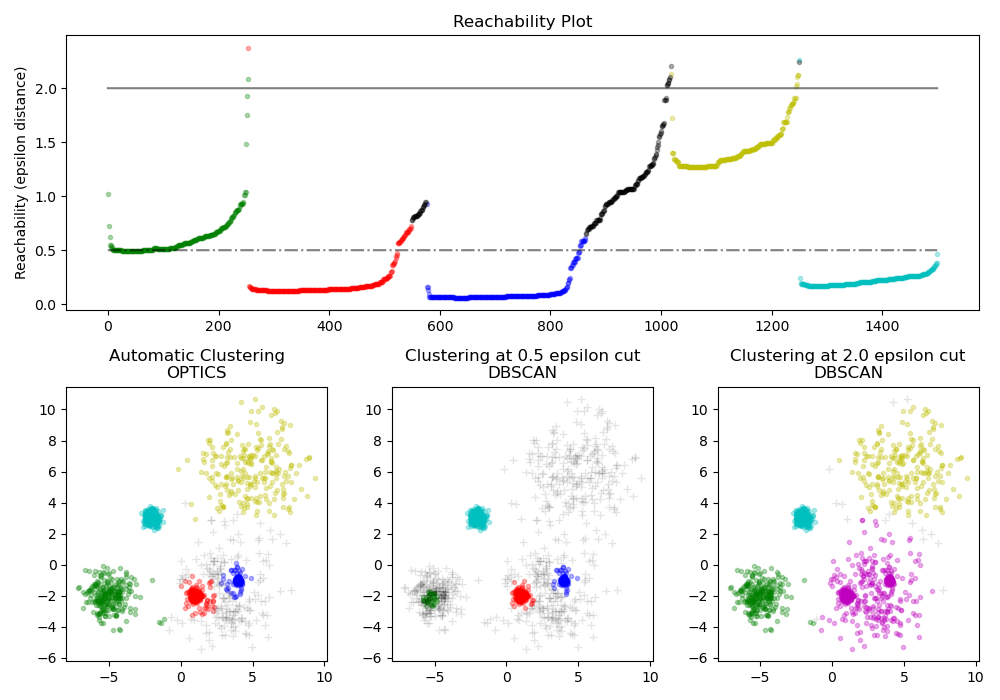
स्रोत: OPTICS क्लस्टरिंग एल्गोरिद्म का Scikit-learn डेमो
Classification supervised learning का एक रूप है। Supervised learning समस्याओं में इनपुट-आउटपुट युग्मों के आधार पर इनपुट को आउटपुट से मैप करने वाला फंक्शन सीखना शामिल है। इसके विपरीत, unsupervised learning कार्य बिना लेबल वाले डेटा में छिपे पैटर्न खोजने के लिए clustering जैसी विधियाँ अपनाते हैं।
Classification और clustering दोनों कार्यों को पैटर्न सीखने के लिए training डेटा की आवश्यकता होती है। हालाँकि, classification कार्यों के लिए मॉडल की भविष्यवाणियों के प्रदर्शन का आकलन करने हेतु testing डेटा रखना अच्छा अभ्यास है।
Clustering एल्गोरिद्म अंतर्निहित संरचना को मॉडल करने के लिए इनपुट डेटा पर निर्भर करते हैं ताकि अंतर्दृष्टि खोजी जा सके। दूसरे शब्दों में, सही उत्तर बताने वाला कोई शिक्षक नहीं होता — एल्गोरिद्म जो सीखता है, वही है। इसके विपरीत, classification एल्गोरिद्म को मैपिंग फंक्शन सीखने के लिए इनपुट और आउटपुट दोनों डेटा की आवश्यकता होती है, ताकि नए इनपुट डेटा का आउटपुट भविष्यवाणी किया जा सके।
|
Classification |
Clustering |
|
|
Supervised |
हाँ |
नहीं |
|
Labeled |
हाँ |
नहीं |
|
उद्देश्य |
इनपुट (X) के एक सेट से discrete आउटपुट (y) तक मैपिंग फंक्शन (f) का अनुमान लगाना, ताकि इसे नए इनपुट्स के आउटपुट की भविष्यवाणी के लिए उपयोग किया जा सके। |
इनपुट (X) के भीतर के अंतर्निहित पैटर्न सीखना ताकि सुझाव दिया जा सके कि उदाहरणों को किन समूहों में विभाजित किया जा सकता है। |
|
एल्गोरिद्म |
Logistic regression, K-nearest neighbors, Decision Tree, Random Forest, Naive Bayes |
K-means, agglomerative clustering, divisive clustering, DBSCAN, OPTICS |
|
उपयोग के मामले |
कस्टमर चर्न, लोन स्वीकृति, स्पैम फ़िल्टरिंग, चेहरे की पहचान |
मार्केट सेगमेंटेशन, इमेज सेगमेंटेशन, सोशल नेटवर्क विश्लेषण, रिकमेंडेशन इंजन |
यद्यपि classification और clustering दोनों का उद्देश्य उदाहरणों को अलग-अलग समूहों में बाँटना है, उनके तरीके मूल रूप से भिन्न हैं। Classification पूर्वनिर्धारित लेबल और एक सुपरवाइज़र पर निर्भर करता है जो सीखने की प्रक्रिया का मार्गदर्शन करता है, जिससे यह कस्टमर चर्न भविष्यवाणी या स्पैम फ़िल्टरिंग जैसे कार्यों के लिए उपयुक्त बनता है। दूसरी ओर, clustering बिना सुपरवाइज़र के काम करता है और अधिक खोज-उन्मुख होता है, जिसका उपयोग मार्केट सेगमेंटेशन या रिकमेंडेशन सिस्टम में होता है। इन बारीकियों को समझना आपकी मशीन लर्निंग परियोजना की प्रभावशीलता पर महत्वपूर्ण प्रभाव डाल सकता है।
और गहराई में जाना चाहते हैं? अपनी समझ और कौशल बढ़ाने के लिए ये DataCamp कोर्स देखें:
और गहराई में जाएँ: Classification और Clustering का परिचय
कोर्स
कोर्स
कोर्स