
{count, plural, one {Cursus} other {Cursussen}}
Clusteranalyse in Python
{hours} uur
65.9K
In machine learning zijn er twee technieken om objecten in afzonderlijke groepen te verdelen: classificatie en clustering. Dat zorgt vaak voor verwarring bij beginnende gebruikers.
Op het eerste gezicht lijken classificatie en clustering op elkaar. Beide gebruiken algoritmen die de kenmerken van een dataset benutten om patronen te vinden en instanties in duidelijke groepen te scheiden. Maar in de praktijk verschillen ze behoorlijk.
In dit artikel bespreken we elke techniek, de bijbehorende algoritmen, hun toepassingen en vooral: hoe ze van elkaar verschillen.
Classificatietaken vallen onder een categorie problemen die "supervised learning" heet. Dergelijke problemen draaien om het ontwikkelen van modellen die leren van historische data om voorspellingen te doen voor nieuwe gevallen.
Formeler gezegd: supervised learning-taken zijn problemen waarbij een functie wordt geleerd die een input naar een output afbeeldt op basis van voorbeeldparen van input en output. Het doel is dus om de afbeeldingsfunctie (f) van de inputs (X) naar de output (y) te benaderen — als je een wiskundige achtergrond hebt, ken je dit als het probleem van functiebenadering.
Belangrijk om te weten: supervised learning kent twee vormen: regressie en classificatie.
Bij classificatieproblemen is het doel van het leeralgoritme om de afbeeldingsfunctie van een set kenmerken te benaderen om een discrete output te voorspellen (bijv. voorspellen of een afbeelding een kat of een hond is) – bekijk onze tutorial Understanding text classification in Python voor een praktische demo.
Er zijn verschillende problemen waarbij classificatie-algoritmen worden toegepast, zoals:
Laten we enkele classificatie-algoritmen bekijken.
Logistische regressie wordt vaak, begrijpelijk, aangezien voor een regressie-algoritme. Technisch gezien is dat niet onjuist. Logistische regressie voert geen statistische classificatie uit; het schat de parameters van een logistiek model.
De reden dat we logistische regressie kunnen gebruiken voor classificatie is de beslissingsgrens die wordt aangebracht om klassen te scheiden. In de eenvoudigste vorm gebruikt logistische regressie een logistische functie om binaire afhankelijke variabelen te modelleren.
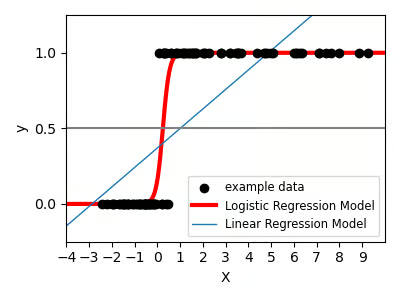
Bron: Logistic Function by Scikit-Learn
KNN is een van de minst complexe machinelearning-algoritmen en verschilt van logistische regressie omdat je het kunt inzetten voor zowel classificatie- als regressietaken.
Het is namelijk een niet-parametrisch, lui leeralgoritme. Dat betekent dat KNN geen aannames maakt over de eigenschappen van de steekproef of of de geobserveerde data kwantitatief of kwalitatief is (niet-parametrisch), en dat alle berekeningen worden uitgesteld tot de functiewaardering (lui leren).
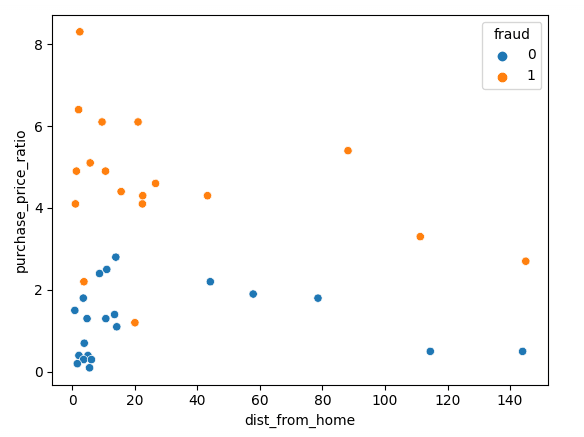
Bron: Nearest Neighbors with Scikit-learn
Het beslisboom-algoritme is een populair niet-parametrisch algoritme dat ook regressie en classificatie aankan. De populariteit komt vooral door de begrijpelijkheid en eenvoud — het is een van de makkelijkst te visualiseren en te interpreteren algoritmen.
Conceptueel kun je een beslisboom zien als een stroom van wortel naar bladeren. Het pad van de wortel naar een blad definieert een beslisregel op de kenmerken.
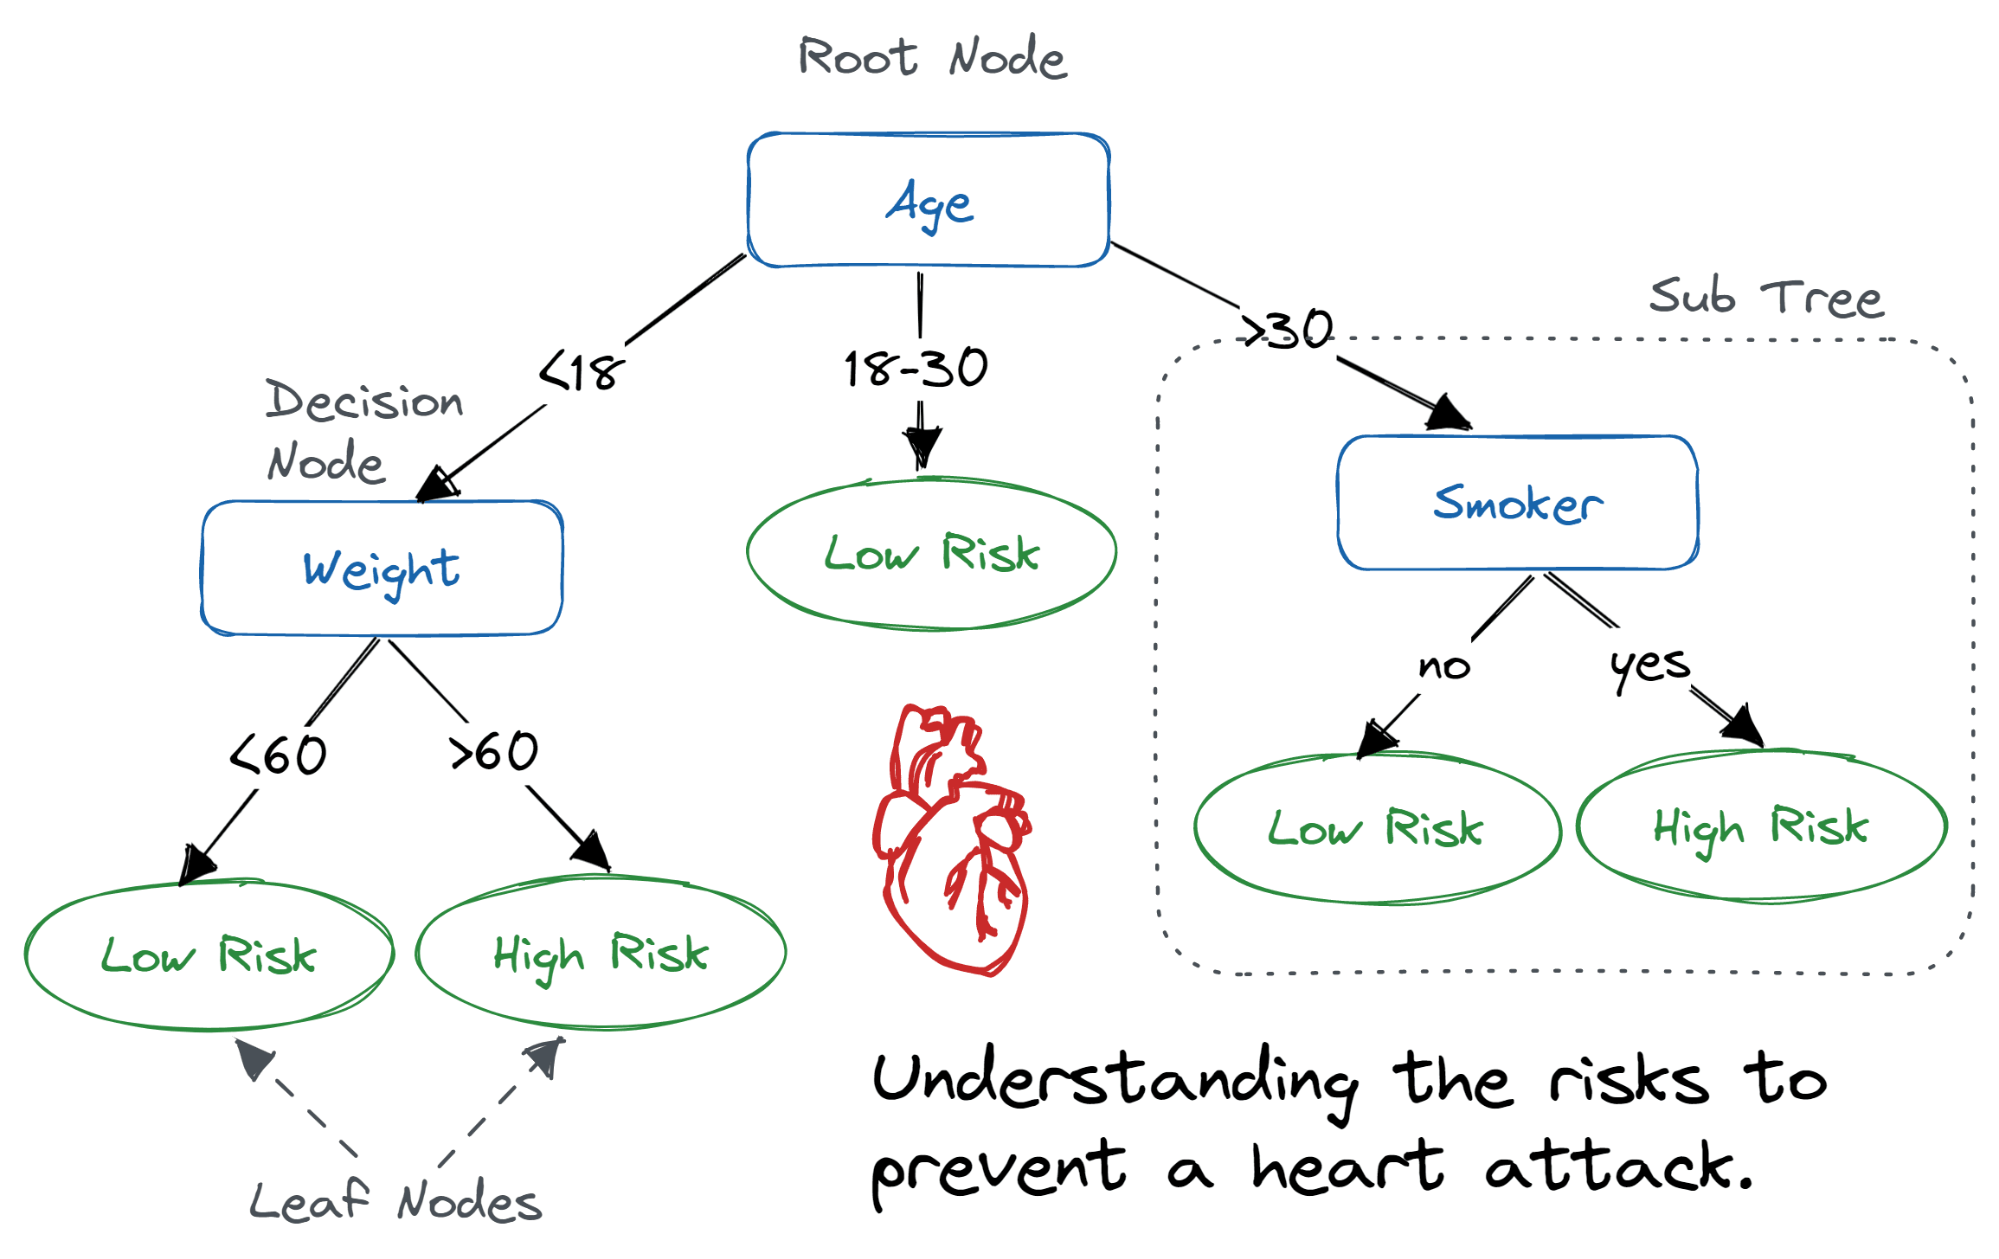
Bron: Decision Tree Classification in Python Tutorial
De random forest is een ensemblemodel dat bestaat uit twee of meer beslisbomen. De techniek maakt gebruik van bootstrap-aggregatie en de random-subspace-methode om individuele bomen te laten groeien en zo te komen tot een krachtige, geaggregeerde voorspeller voor zowel classificatie als regressie.
Let op: bootstrap-aggregatie, of bagging, is simpelweg een techniek om meerdere versies van een voorspeller te genereren die samen een geaggregeerde voorspeller vormen. Het doel is om de correlatie tussen voorspellers te verlagen, zodat het geaggregeerde model beter generaliseert.
Willekeur wordt in elke voorspeller geïntroduceerd door willekeurig instanties uit de trainingsset te trekken met teruglegging en de gebootstrapte data te gebruiken voor training.
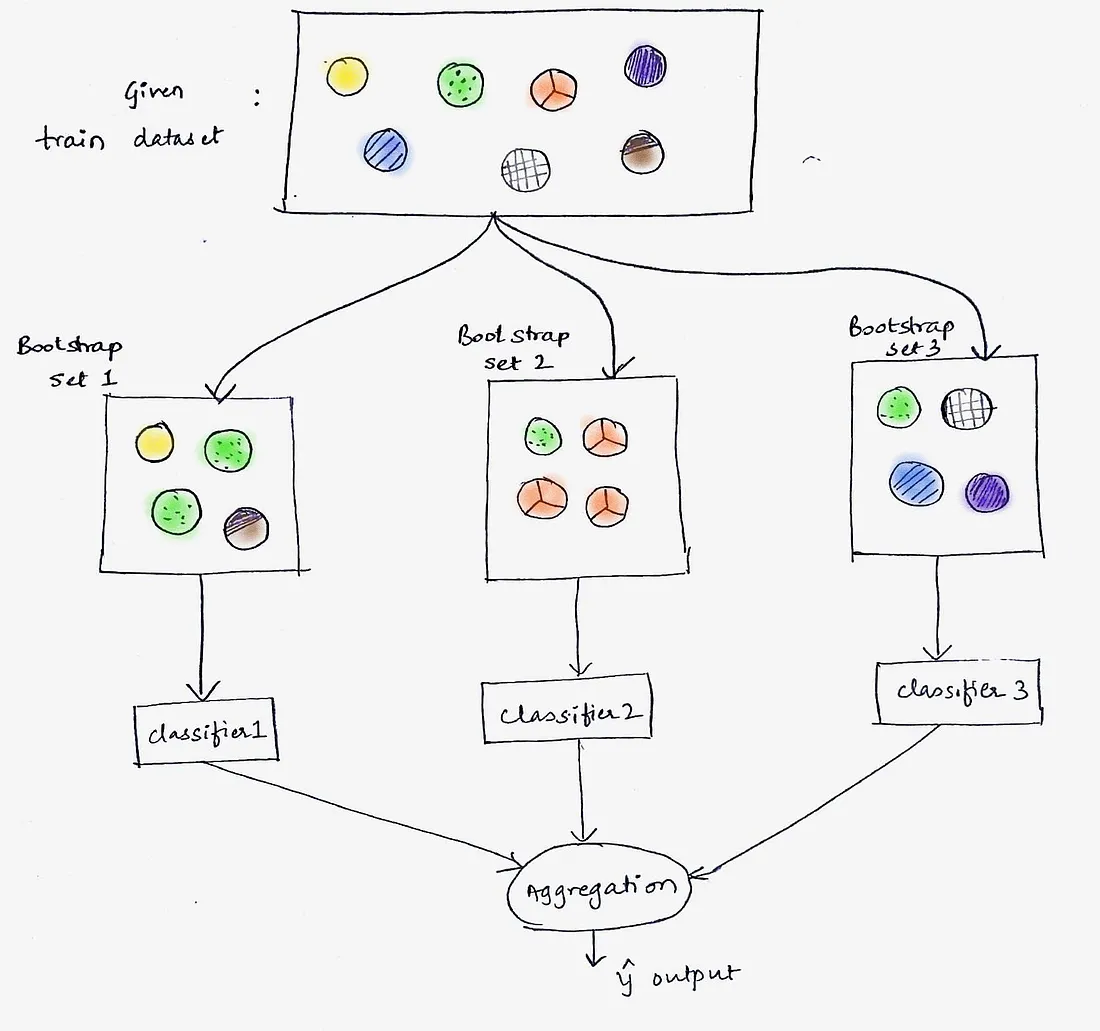
Bron: Bagging: Machine Learning through visuals. #1: What is “Bagging” ensemble learning?
De random-subspace-methode wordt ook gebruikt om de correlatie tussen de voorspellers binnen het ensemble te verminderen. Dit heet vaak "feature bagging", omdat het hetzelfde doet als bagging maar dan met de kenmerken. Dus: de random-subspace-methode verlaagt de correlatie door elke voorspeller in het ensemble te bouwen op een willekeurige steekproef van de kenmerken met teruglegging.
De Naive Bayes-classifier is een probabilistisch algoritme gebaseerd op de stelling van Bayes, een wiskundige regel om kansen bij te werken op basis van nieuwe data.
In de context van Naive Bayes is de "naïeve" aanname dat alle kenmerken (of variabelen) in de dataset onafhankelijk van elkaar zijn bij het voorspellen van de uitkomst. Dat is een vereenvoudiging, want in werkelijkheid kunnen kenmerken afhankelijk zijn. Toch presteert het algoritme ondanks deze aanname vaak verrassend goed bij veel classificatietaken.
De stelling van Bayes zelf doet dus geen aannames over onafhankelijkheid van variabelen. Het is de Naive Bayes-classifier die deze aanname maakt, omwille van eenvoud en rekenefficiëntie.
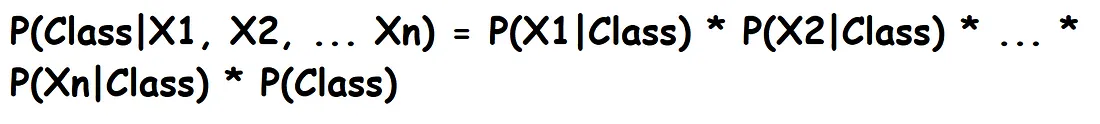
Om clustering te begrijpen, moeten we beginnen bij de definitie van unsupervised learning. Unsupervised learning is een aanpak om de onderliggende structuur van data te ontdekken, maar dan zonder dat algoritmen input-naar-output-koppelingen nodig hebben om dit te bereiken.
Unsupervised learning wordt doorgaans gebruikt om bestaande patronen in data te ontdekken, zodat instanties worden gegroepeerd zonder labels. Het gaat ervan uit dat instanties binnen dezelfde groep vergelijkbare kenmerken hebben. Clustering is dus een unsupervised learning-techniek om ongelabelde data te groeperen op basis van overeenkomsten of verschillen.
Use-cases voor clustering zijn onder meer:
Hier zijn enkele soorten clustering-algoritmen:
Een van de populairste en meest gebruikte algoritmen voor clustering is k-means. Het is een centroid-gebaseerd, iteratief algoritme dat niet-overlappende clusters maakt.
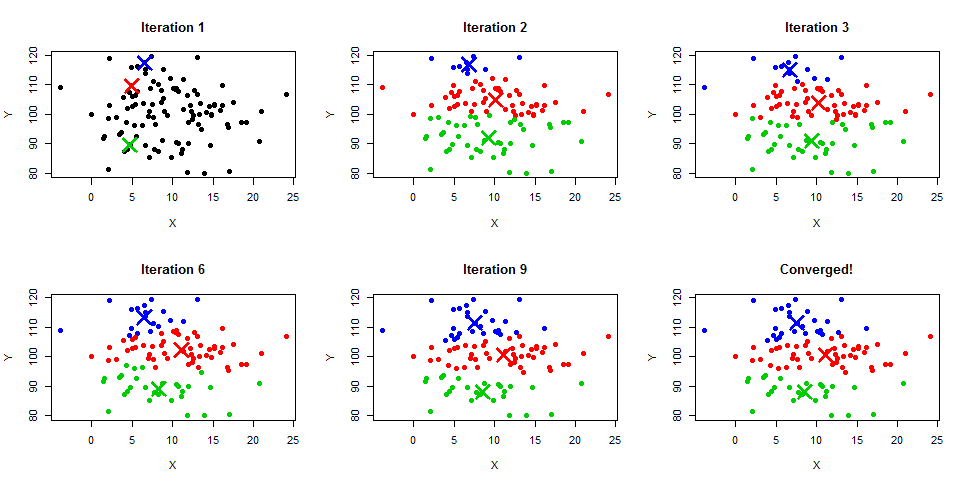
Een andere manier om clusters te vormen is door een hiërarchie van clusters op te bouwen, vandaar de naam "hiërarchische clustering". Er zijn twee manieren om een hiërarchie van clusters op te bouwen: .
Agglomeratief
Dit is een bottom-upbenadering waarbij elke observatie in eerste instantie zijn eigen cluster vormt. Terwijl de hiërarchie van onder naar boven wordt opgebouwd, worden observaties per paar samengevoegd en paren weer tot clusters.
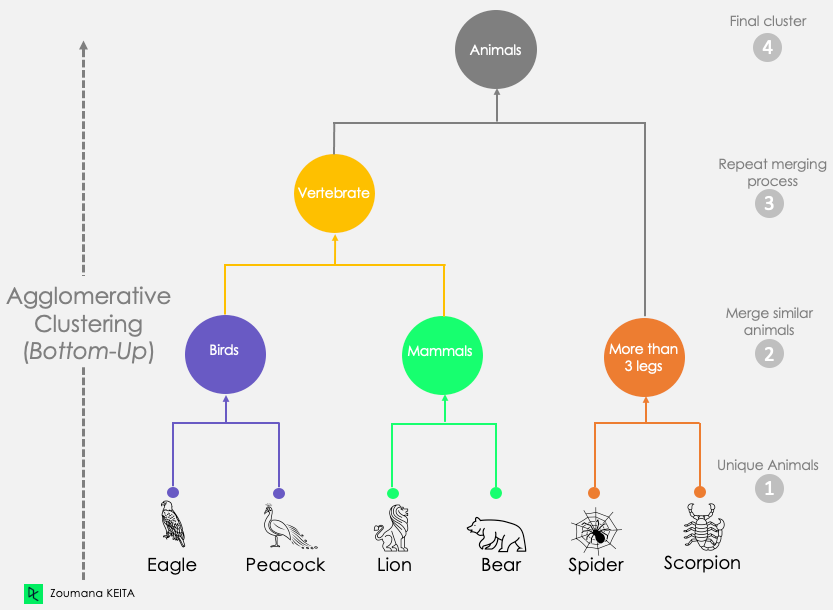
Bron: An introduction to Hierarchical clustering in Python
Divisief
Divisieve clustering is een top-downbenadering waarbij alle observaties in één cluster beginnen en er recursief splitsingen worden uitgevoerd om de hiërarchie van boven naar beneden op te bouwen.
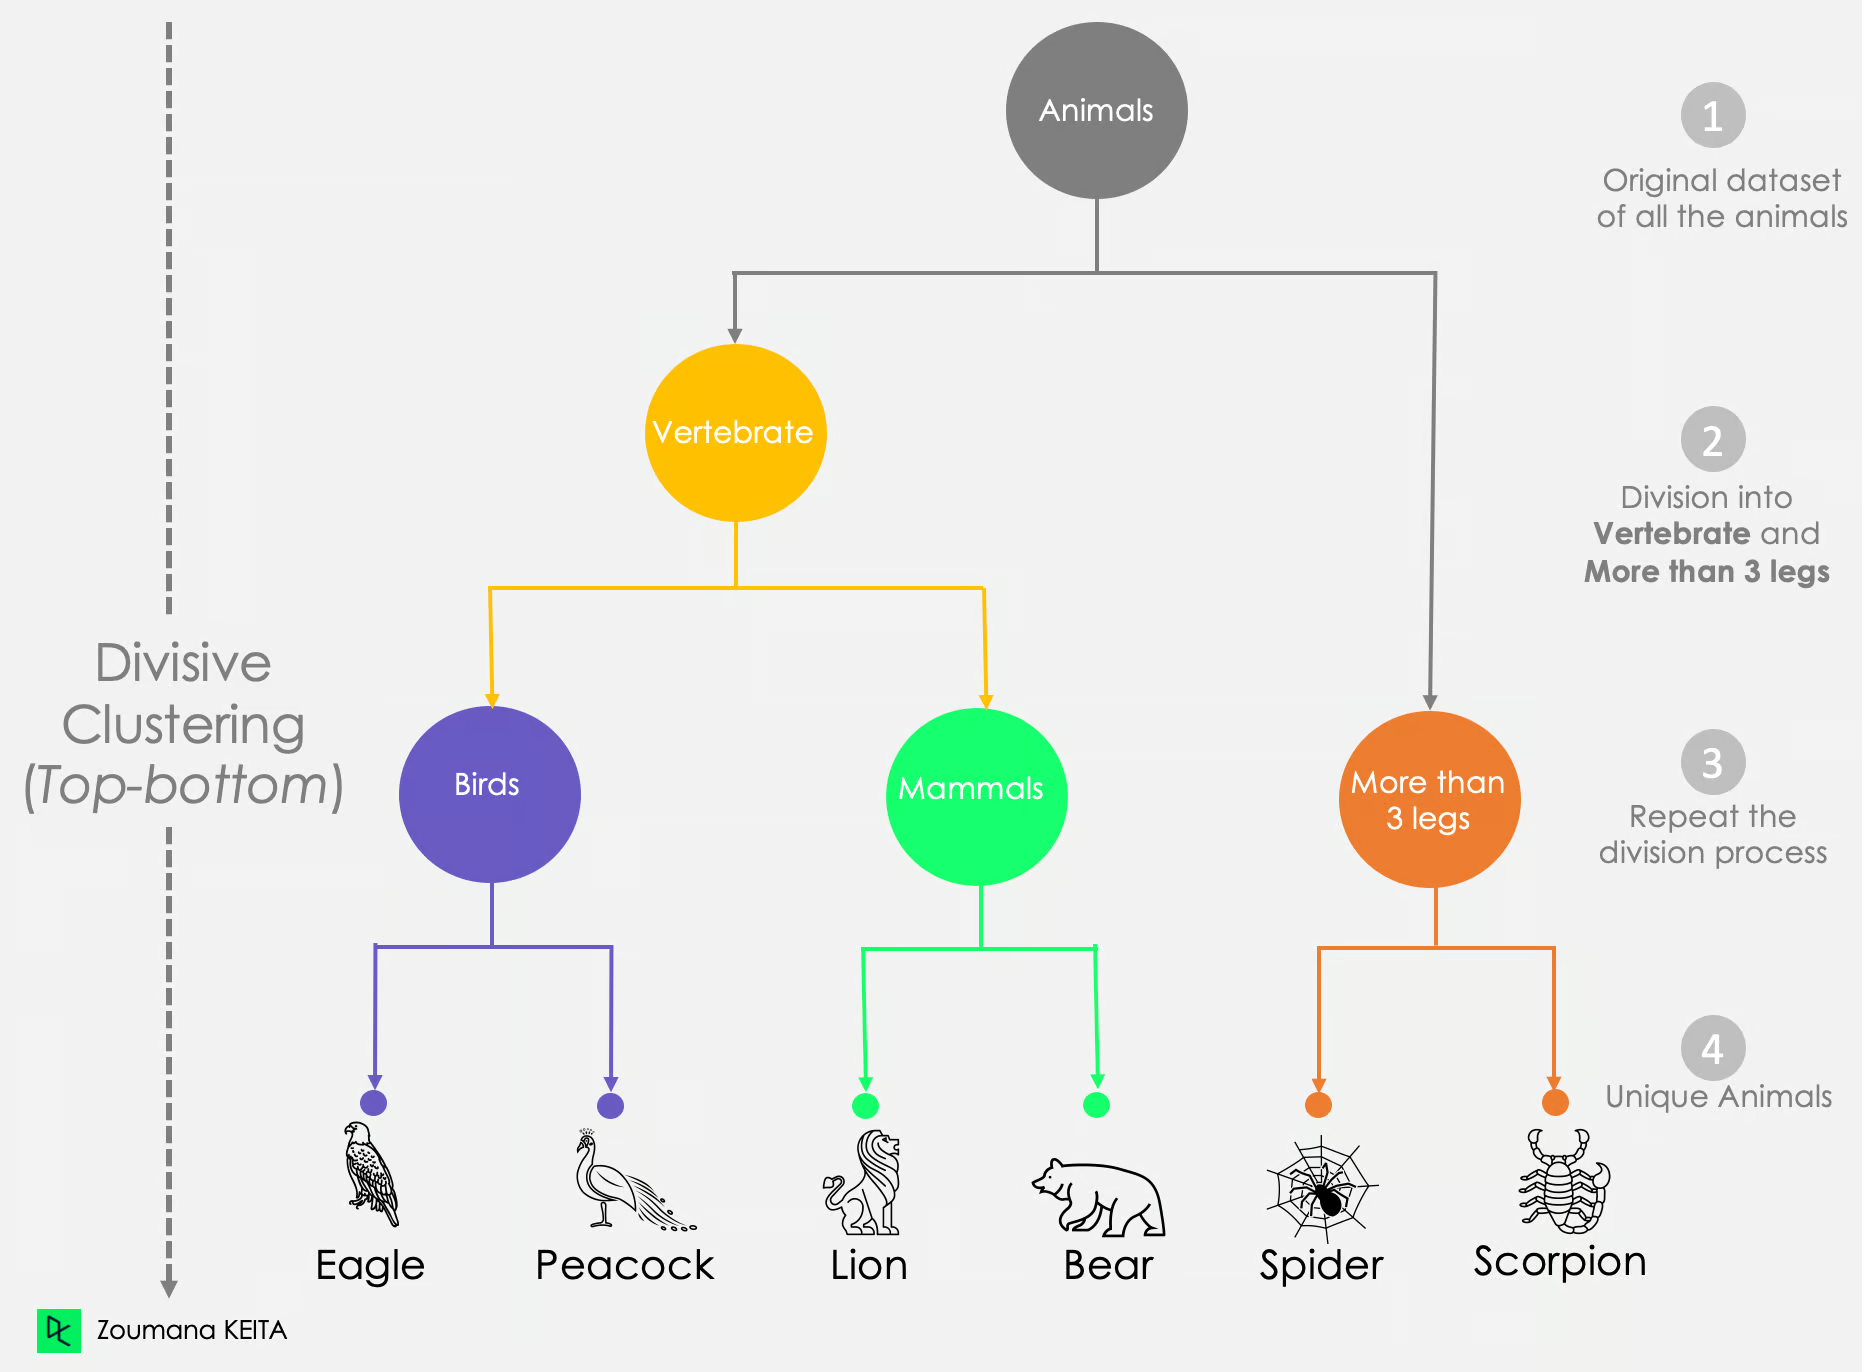
Bron: An introduction to Hierarchical clustering in Python
Een groot pluspunt van Density-Based Spatial Clustering of Applications with Noise, of kortweg DBSCAN, is de robuustheid tegen uitschieters – het is ook het bekendste dichtheidsgebaseerde clustering-algoritme.
DBSCAN gaat ervan uit dat clusters dichte gebieden in de ruimte zijn, gescheiden door gebieden met lagere dichtheid. In tegenstelling tot K-means leidt DBSCAN het aantal clusters af uit de data, en het kan clusters van willekeurige vorm vinden, zodat je het aantal clusters niet als parameter hoeft mee te geven.
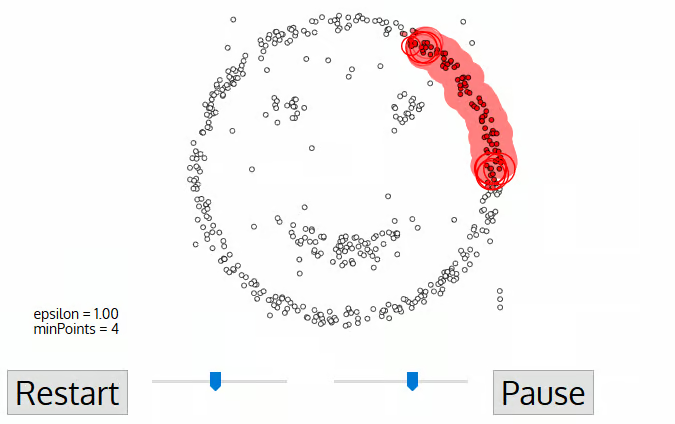
OPTICS staat voor Ordering Points to Identify the Clustering Structure. Net als DBSCAN is het een dichtheidsgebaseerd algoritme, ontwikkeld door dezelfde onderzoeksgroep. OPTICS wil echter een belangrijke valkuil van DBSCAN omzeilen – clusters identificeren in data met variërende dichtheid – door de aanname los te laten dat de dichtheid van de data consistent is.
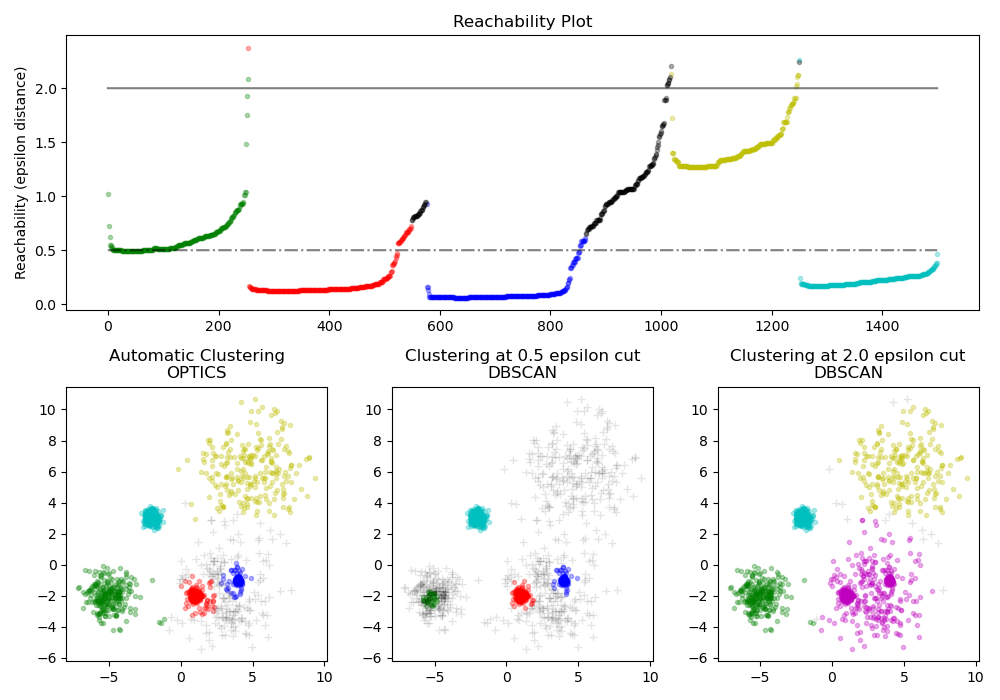
Bron: Scikit-learn Demo of OPTICS clustering algorithm
Classificatie is een vorm van supervised learning. Supervised learning-problemen draaien om het leren van een functie die een input naar een output afbeeldt op basis van input-outputparen. Daarentegen gebruiken unsupervised learning-taken methoden zoals clustering om verborgen patronen te ontdekken in ongelabelde data.
Zowel classificatie- als clusteringtaken hebben trainingsdata nodig om patronen te leren. Voor classificatie is het echter goed gebruik om ook testdata te hebben om de prestaties van de voorspellingen van het model te evalueren.
Clustering-algoritmen zijn afhankelijk van inputdata om de onderliggende structuur te modelleren en zo inzichten te ontdekken. Met andere woorden: er is geen leraar die het algoritme de juiste antwoorden geeft – het komt puur voort uit wat het algoritme leert. Classificatie-algoritmen hebben daarentegen input- én outputdata nodig om de afbeeldingsfunctie te leren, zodat ze de output van nieuwe inputdata kunnen voorspellen.
|
Classificatie |
Clustering |
|
|
Supervised |
Ja |
Nee |
|
Gelabeld |
Ja |
Nee |
|
Doel |
De afbeeldingsfunctie (f) van een set inputs (X) naar een discrete output (y) benaderen, zodat die kan worden gebruikt om de output van nieuwe inputs te voorspellen. |
De onderliggende patronen in de inputs (X) leren om groepen te suggereren waarin instanties kunnen worden ingedeeld. |
|
Algoritmen |
Logistische regressie, k-nearest neighbors, beslisboom, random forest, Naive Bayes |
K-means, agglomeratieve clustering, divisieve clustering, DBSCAN, OPTICS |
|
Use-cases |
Klantverloop, leningsgoedkeuring, spamfiltering, gezichtsherkenning |
Marktsegmentatie, beeldsegmentatie, analyse van sociale netwerken, aanbevelingssystemen. |
Hoewel zowel classificatie als clustering erop gericht zijn instanties in afzonderlijke groepen in te delen, verschillen hun aanpakken fundamenteel. Classificatie steunt op vooraf gedefinieerde labels en een begeleider die het leerproces stuurt, wat het ideaal maakt voor taken zoals klantverloop voorspellen of spamfiltering. Clustering werkt daarentegen zonder begeleider en is meer verkennend, met toepassingen in bijvoorbeeld marktsegmentatie of aanbevelingssystemen. Als je deze nuances begrijpt, kan dat de effectiviteit van je machinelearningproject aanzienlijk vergroten.
Meer de diepte in? Bekijk deze DataCamp-cursussen om je begrip en vaardigheden te vergroten:
Duik dieper in classificatie & clustering
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

