Banyak pengembang membangun chatbot dan asisten AI yang dapat menjawab pertanyaan dengan cemerlang secara terpisah, tetapi kesulitan mempertahankan percakapan yang koheren. Penyebab utamanya? Kurangnya memori. Saat pengguna mengajukan pertanyaan lanjutan yang merujuk konteks sebelumnya, model bahasa tanpa status memperlakukannya sebagai hal yang benar-benar baru, sehingga menimbulkan interaksi yang membuat frustrasi dan berulang.
Memahami dan mengimplementasikan memori dalam model bahasa besar sangat penting untuk menciptakan aplikasi AI yang terasa alami dan cerdas. Memori memungkinkan LLM mempertahankan konteks lintas percakapan, belajar dari interaksi sebelumnya, dan memberikan respons yang dipersonalisasi. Dalam tutorial ini, saya akan memandu Anda melalui dasar-dasar memori LLM, dari jendela konteks dasar hingga arsitektur tingkat lanjut.
Jika Anda baru mengenal LLM, saya sarankan mengambil salah satu kursus kami, seperti Developing LLM Applications with LangChain, Developing Large Language Models, atau LLMOps Concepts.
Apa itu Memori LLM?
Model bahasa besar memproses informasi secara berbeda dari perangkat lunak tradisional. Sementara basis data menyimpan dan mengambil data secara eksplisit, LLM harus mengelola memori dalam batasan arsitektural seperti jendela konteks dan batas token. Tantangannya adalah membuat model mengingat informasi yang relevan sambil melupakan detail yang tidak perlu, mempertahankan koherensi tanpa membebani sumber daya komputasi.
Sebelum membahas detail implementasi, mari kita tetapkan apa arti memori dalam konteks model bahasa besar dan mengapa hal ini penting untuk membangun aplikasi AI yang efektif.
Dasar-dasar memori dalam model bahasa besar
Memori pada LLM mengacu pada kemampuan sistem untuk menyimpan dan memanfaatkan informasi dari interaksi sebelumnya atau data pelatihan. Ini bukan memori dalam arti komputasi tradisional. Ini adalah kapasitas model untuk mempertahankan konteks, merujuk pertukaran sebelumnya, dan menerapkan pola yang dipelajari ke situasi baru.
Memori sangat penting karena mengubah pasangan tanya jawab yang terisolasi menjadi percakapan yang koheren. Tanpa memori, LLM tidak dapat memahami saat Anda berkata "ceritakan lebih lanjut tentang itu." Model memerlukan konteks untuk menafsirkan rujukan dan membangun di atas pertukaran sebelumnya.
Saya sering memandang memori LLM sejajar dengan memori manusia. Manusia memiliki memori sensorik (persepsi langsung), memori jangka pendek (informasi aktif), dan memori jangka panjang (pengetahuan tersimpan). LLM menerapkan sistem analog: jendela konteks bertindak seperti memori jangka pendek, informasi yang diambil berfungsi sebagai memori jangka panjang yang dipanggil kembali, dan parameter yang dilatih mewakili pengetahuan permanen.
Sekarang setelah saya membahas konsep dasar memori dalam LLM, mari kita tinjau bagaimana sistem memori diklasifikasikan untuk membantu Anda memilih pendekatan yang tepat bagi aplikasi spesifik Anda.
Tiga dimensi klasifikasi memori LLM
Memahami bagaimana memori diklasifikasikan membantu dalam memilih pendekatan yang tepat untuk aplikasi Anda. Memori LLM dapat dikategorikan sepanjang tiga dimensi kunci: objek, bentuk, dan waktu.
Dimensi objek
Dimensi objek membedakan antara memori personal dan memori sistem. Memori personal menyimpan informasi spesifik pengguna seperti preferensi dan riwayat percakapan.
Memori sistem berisi pengetahuan umum dan kapabilitas yang tersedia untuk semua pengguna. Bot layanan pelanggan mungkin menggunakan memori sistem untuk informasi produk sekaligus mempertahankan memori personal tiap pelanggan atas riwayat pesanannya.
Dimensi bentuk
Beralih ke dimensi kedua, dimensi bentuk memisahkan memori parametrik dari non-parametrik. Memori parametrik dikodekan dalam bobot model selama pelatihan. Memori non-parametrik berada di luar model, disimpan di basis data atau penyimpanan vektor. Memori parametrik bersifat tetap setelah pelatihan, sementara memori non-parametrik dapat diperbarui secara dinamis.
Dimensi waktu
Terakhir, dimensi waktu mengategorikan memori berdasarkan durasi: jangka pendek versus jangka panjang. Memori jangka pendek mencakup percakapan saat ini, disimpan di jendela konteks. Memori jangka panjang bertahan lintas sesi, disimpan secara eksternal dan diambil saat diperlukan.
Dengan kerangka klasifikasi ini, mari kita kaji jenis-jenis memori spesifik yang diimplementasikan LLM dalam praktik.
Jenis-Jenis Memori pada LLM
Jenis memori yang berbeda melayani tujuan yang berbeda dalam aplikasi LLM. Memahami jenis-jenis ini membantu Anda merancang arsitektur memori yang efektif untuk kasus penggunaan spesifik Anda.
Memori semantik
Memori semantik menyimpan fakta dan pengetahuan umum yang dapat diakses dan dirujuk oleh sistem. Meskipun model memiliki pengetahuan dasar dari pelatihan, memori semantik dalam praktik sering merujuk ke basis pengetahuan eksternal, basis data, atau penyimpanan dokumen yang berisi informasi faktual.
Sebagai contoh, bot layanan pelanggan mungkin memiliki memori semantik yang menyimpan spesifikasi produk, informasi harga, dan kebijakan perusahaan dalam basis data vektor. Ini memungkinkan sistem mengambil dan merujuk fakta yang akurat dan terbaru tanpa hanya bergantung pada data pelatihan yang mungkin sudah usang. Memori semantik biasanya disimpan secara eksternal dan diambil saat dibutuhkan, sehingga mudah diperbarui dan dikelola.
Memori episodik
Sementara memori semantik berkaitan dengan fakta dan pengetahuan, memori episodik berfokus pada pengalaman spesifik. Memori episodik menangkap interaksi masa lalu, pertanyaan yang diajukan, bagaimana model merespons, dan konteks yang mengiringi pertukaran tersebut.
Memori episodik memungkinkan model merujuk bagian awal percakapan secara alami, mengatakan hal-hal seperti "seperti yang kita bahas sebelumnya" atau "berdasarkan apa yang Anda ceritakan tentang proyek Anda." Jenis memori ini biasanya non-parametrik, disimpan dalam buffer percakapan atau basis data.
Memori prosedural
Memori prosedural mencakup instruksi sistem dan prosedur yang dipelajari. Ini termasuk prompt sistem yang mendefinisikan perilaku AI, pedoman cara merespons, dan instruksi khusus tugas.
Saat Anda mengonfigurasi model untuk "selalu menjawab dalam bentuk poin" atau "mengutamakan akurasi dibanding kreativitas," Anda sedang menyetel memori prosedural. Ini membentuk bagaimana model memproses dan merespons informasi alih-alih apa yang model ketahui.
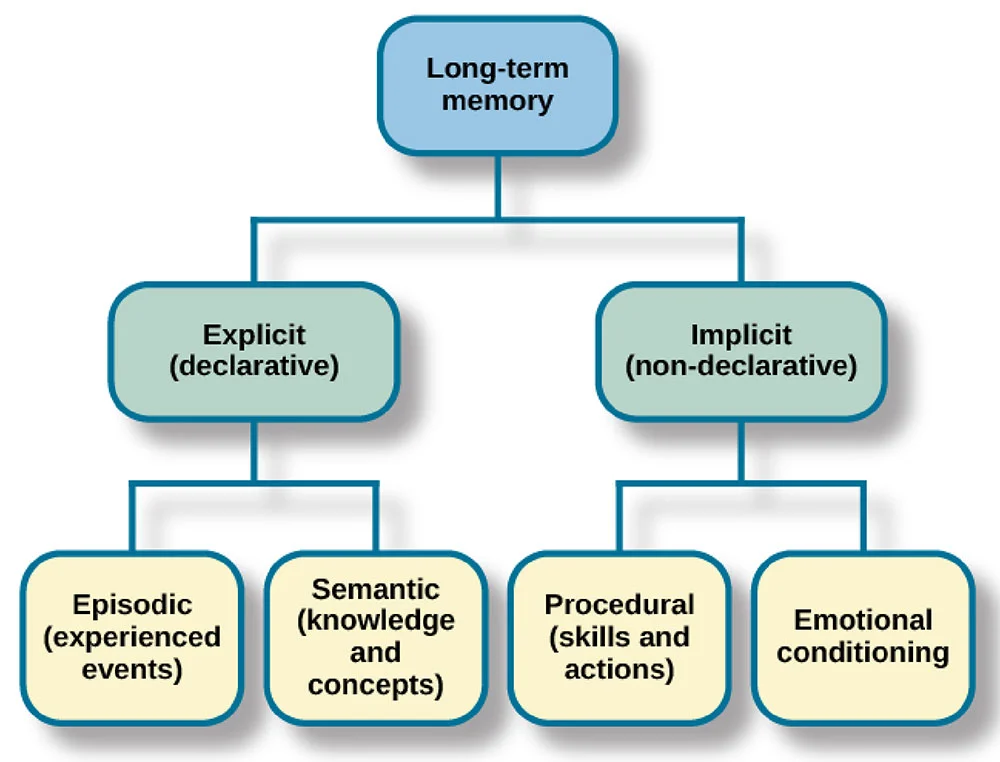
Jenis-Jenis Memori
Di luar jenis memori fundamental ini, implementasi praktis, khususnya dalam kerangka kerja seperti LangChain, menawarkan berbagai bentuk memori percakapan.
ConversationBufferMemory menyimpan semua pesan secara utuh, mempertahankan riwayat percakapan lengkap, ideal untuk percakapan singkat saat Anda memerlukan konteks penuh. ConversationSummaryMemory memampatkan interaksi masa lalu menjadi ringkasan, mengurangi penggunaan token sambil menjaga informasi kunci untuk percakapan yang lebih panjang. ConversationBufferWindowMemory hanya menyimpan N pesan terbaru, menciptakan jendela konteks geser yang efektif saat hanya pertukaran terbaru yang penting. ConversationSummaryBufferMemory menggabungkan pendekatan, mempertahankan pesan terbaru apa adanya sambil merangkum pertukaran yang lebih lama, menawarkan keseimbangan antara detail dan efisiensi. Setiap bentuk menukar kelengkapan dengan efisiensi, memungkinkan Anda memilih berdasarkan kebutuhan spesifik aplikasi Anda.
Memahami jenis-jenis memori ini penting, tetapi semuanya beroperasi dalam batasan mendasar: jendela konteks. Mari jelajahi bagaimana batasan arsitektural ini membentuk implementasi memori.
Jendela Konteks LLM: Fondasi dan Batasan
Menurut saya, salah satu aspek kunci memori LLM yang perlu dipahami adalah konsep jendela konteks. Mari kita lihat sekilas bagaimana cara kerjanya.
Apa itu jendela konteks?
Jendela konteks adalah jumlah maksimum teks, diukur dalam token, yang dapat diproses LLM dalam satu permintaan. Token adalah potongan teks, kira-kira setara dengan kata atau sub-kata.
Jendela konteks berfungsi sebagai memori kerja langsung model. Segala sesuatu yang dipertimbangkan model harus muat dalam jendela ini: prompt sistem, riwayat percakapan, dokumen yang diambil, dan ruang respons. Seiring percakapan bertambah, pesan yang lebih lama harus dihapus untuk yang baru.
Ukuran jendela konteks sangat bervariasi. Misalnya, GPT-5 mendukung 400.000 token, Claude 4.5 Sonnet menangani 200.000 token, dan Gemini 3 Pro mencapai 1,5 juta token. Jendela yang lebih besar memungkinkan konteks yang lebih kaya tetapi meningkatkan biaya komputasi secara kuadratik.
Meskipun memiliki jendela konteks besar terdengar ideal, itu menimbulkan tantangan praktis yang signifikan yang memengaruhi penerapan di dunia nyata.
Tantangan dan keterbatasan jendela konteks
Menurut pengalaman saya, masalah terbesar dengan jendela konteks adalah masalah "hilang di tengah". Riset menunjukkan LLM lebih memperhatikan informasi di awal dan akhir jendela konteks, sementara konten di tengah mendapat perhatian lebih sedikit. Sekadar menjejalkan konteks dengan informasi tidak menjamin pemanfaatan yang efektif.
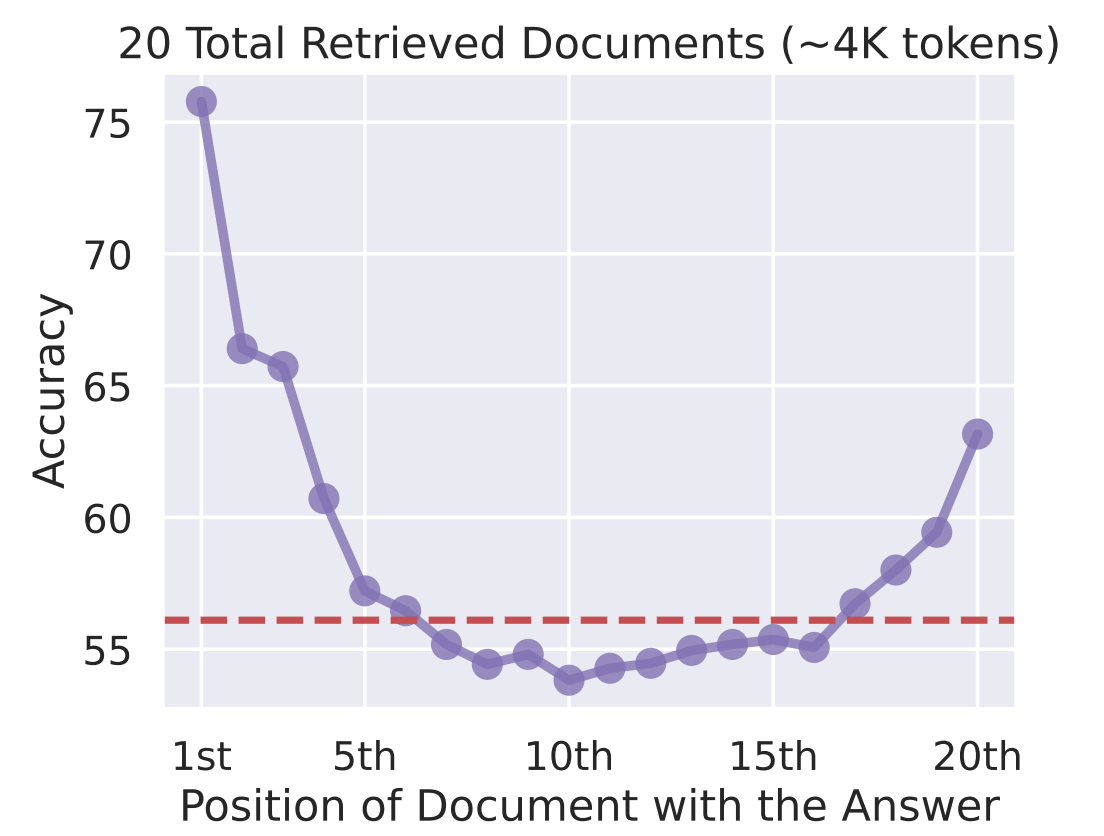
Akurasi vs. Posisi Dokumen dengan Jawaban
Keterbatasan komputasi membuat perluasan jendela konteks menjadi mahal. Memproses konteks 100.000 token memerlukan memori GPU dan waktu yang jauh lebih banyak daripada konteks 10.000 token.
Untuk aplikasi produksi, biaya ini cepat terakumulasi, mendorong kebutuhan sistem memori cerdas yang hanya menyertakan informasi relevan secara selektif.
Mengingat batasan ini, solusinya bukan sekadar memperluas jendela konteks, melainkan membangun sistem yang lebih cerdas yang menggunakannya secara efisien.
Memadukan jendela konteks dengan sistem memori
Aplikasi LLM yang efektif mengombinasikan jendela konteks dengan sistem memori yang melampaui konteks langsung. Polanya melibatkan penggunaan jendela konteks untuk informasi jangka pendek berprioritas tinggi sambil menyimpan memori jangka panjang secara eksternal dan mengambilnya secara selektif.
Arsitektur khas mempertahankan giliran percakapan terbaru dalam jendela konteks, menyimpan percakapan yang lebih lama di basis data, dan menggunakan mekanisme pengambilan untuk membawa kembali informasi masa lalu yang relevan saat diperlukan. Ini menyeimbangkan kelengkapan dengan efisiensi dan kinerja.
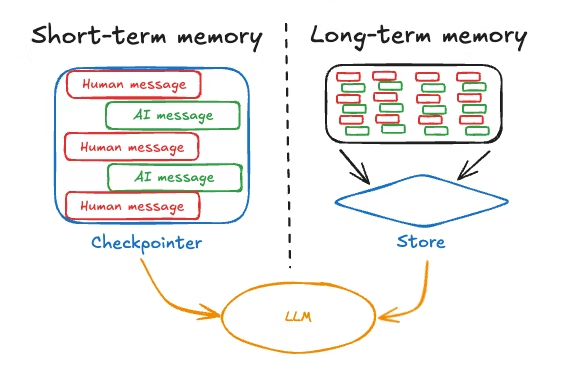
Memori Jangka Pendek/Panjang
Dengan pemahaman arsitektural ini, mari kita jelajahi cara mengimplementasikan sistem memori jangka pendek yang efektif yang bekerja dalam batasan ini
Mengimplementasikan Sistem Memori Jangka Pendek pada LLM
Sistem memori jangka pendek mengelola informasi dalam sesi saat ini, terutama memanfaatkan jendela konteks. Saya suka menganggap ini sebagai memori kerja model; informasi yang secara aktif dipegangnya saat memproses percakapan saat ini.
Mari kita lihat cara memaksimalkan ruang memori yang terbatas namun krusial ini.
Pembelajaran dalam konteks
Pembelajaran dalam konteks mengacu pada kemampuan model untuk menyesuaikan perilaku berdasarkan contoh atau instruksi dalam prompt. Anda mengajari model dengan menunjukkan apa yang harus dilakukan di dalam jendela konteks alih-alih melakukan fine-tuning.
Mekanismenya sederhana:
- Sertakan contoh perilaku yang diinginkan, dan model mempelajari polanya.
- Untuk klasifikasi sentimen, berikan beberapa pasangan teks-sentimen sebagai contoh, lalu sajikan teks baru. Model menyimpulkan pola dan menerapkannya.
Manfaat pendekatan ini meliputi:
- Adaptasi tugas yang cepat tanpa pelatihan ulang
- Fleksibilitas untuk mengubah perilaku dengan memodifikasi prompt
- Mengajarkan tugas spesifik domain dengan beberapa contoh.
Keterbatasannya termasuk efektivitas yang menurun dengan banyak contoh karena "hilang di tengah", biaya token meningkat, dan kinerja jarang menyamai model yang di-fine-tune.
Pembelajaran dalam konteks menunjukkan apa yang mungkin dilakukan dengan memori jangka pendek, tetapi bagaimana informasi sebenarnya disimpan untuk digunakan model? Mari jelajahi mekanisme di balik pembentukan memori.
Pembentukan memori dalam sistem LLM dapat berlangsung secara sadar (eksplisit) atau bawah sadar (implisit).
- Pembentukan sadar melibatkan instruksi eksplisit kepada sistem untuk mengingat informasi atau menerapkan mekanisme yang mengekstrak fakta kunci dari percakapan dan menyimpannya.
- Pembentukan bawah sadar terjadi secara otomatis melalui alur percakapan. Saat pesan menumpuk dalam jendela konteks, pesan-pesan tersebut secara implisit menyediakan memori.
Banyak kerangka kerja secara otomatis memelihara buffer percakapan, menciptakan memori implisit tanpa operasi eksplisit. Tantangannya adalah mengelola akumulasi ini, memastikan informasi yang relevan tetap ada sementara detail yang kurang penting dipangkas.
Memori jangka pendek menangani kebutuhan percakapan langsung, tetapi apa yang terjadi saat Anda memerlukan informasi bertahan melampaui sesi saat ini? Di sinilah solusi memori jangka panjang menjadi penting.
Solusi Memori Jangka Panjang LLM
Memori jangka panjang memungkinkan LLM mempertahankan informasi lintas sesi.
Sementara memori jangka pendek bersifat sementara dan menghilang saat percakapan berakhir, memori jangka panjang tetap ada, memungkinkan AI Anda mengingat preferensi pengguna, interaksi sebelumnya, dan pengetahuan yang terakumulasi seiring waktu.
Saya akan menyoroti dua pendekatan utama: sistem memori berbasis teks yang menyimpan informasi secara eksternal dan key-value caching yang mengoptimalkan cara model mengakses informasi yang sebelumnya dihitung.
Sistem memori berbasis teks
Memori berbasis teks menyimpan riwayat percakapan dan informasi pengguna dalam basis data atau penyimpanan vektor. Akuisisi melibatkan penangkapan informasi yang relevan, preferensi, keputusan, fakta, atau detail kontekstual.
Manajemen memori memerlukan kompresi dan pengorganisasian. Teknik peringkasan memampatkan percakapan menjadi poin-poin kunci. Organisasi hierarkis menyusun memori berdasarkan topik, periode waktu, atau relevansi.
Pemanfaatan berfokus pada pengambilan. Pencarian kemiripan vektor menemukan memori yang relevan berdasarkan makna semantik. Pengambilan berbasis waktu memprioritaskan informasi terbaru. Penilaian relevansi memberi peringkat memori berdasarkan kepentingannya.
Sistem berbasis teks menangani apa yang harus disimpan, tetapi ada juga pertanyaan tentang bagaimana membuat pengambilan lebih efisien. Di sinilah key-value caching berperan.
Key-value caching dan optimisasi atensi
Key-value (KV) caching meningkatkan efisiensi pembuatan token. Selama pembuatan teks, model menghitung atensi atas semua token sebelumnya. KV caching menyimpan perhitungan antara ini, memungkinkan penggunaan ulang saat menghasilkan token berikutnya tanpa perhitungan ulang.
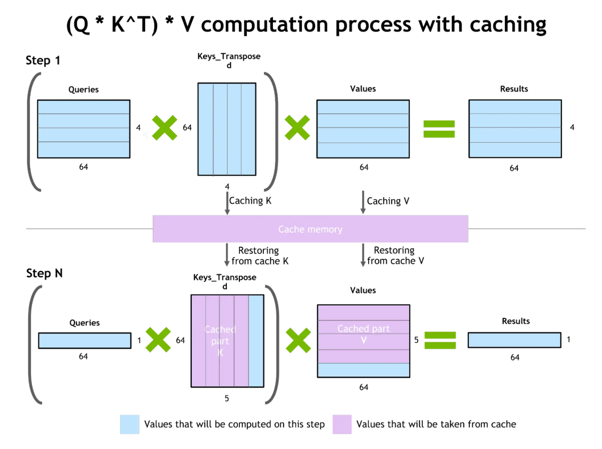
Key-value Caching dan Optimisasi Atensi
Manfaatnya besar: biaya komputasi berkurang, memungkinkan respons lebih cepat dan penggunaan sumber daya lebih rendah. Namun, pasangan key-value yang di-cache mengonsumsi VRAM GPU. Untuk konteks yang sangat panjang, ukuran KV cache menjadi kendala.
Walaupun KV caching mengoptimalkan cara model menggunakan jendela konteksnya, ini tidak menyelesaikan masalah mendasar kapasitas memori yang terbatas. Di sinilah retrieval-augmented generation menawarkan pendekatan komplementer.
Retrieval-Augmented Generation (RAG)
Salah satu kemajuan terbaru yang menurut saya paling menarik adalah Retrieval-Augmented Generation atau RAG. RAG menjembatani memori internal dan eksternal, memperluas memori LLM melampaui batasan jendela konteks.
Alih-alih hanya mengandalkan apa yang dipelajari model selama pelatihan atau apa yang muat di konteks saat ini, RAG secara dinamis menarik informasi relevan dari sumber eksternal tepat saat dibutuhkan. Mari kita jelajahi RAG lebih rinci.
Menjembatani memori internal dan eksternal
Arsitektur RAG terdiri dari dua komponen utama: retriever yang mencari informasi relevan di basis pengetahuan eksternal dan generator (LLM) yang menghasilkan respons berdasarkan kueri dan konteks yang diambil.
Saat kueri datang, retriever menemukan dokumen yang relevan dari basis data vektor atau basis pengetahuan. Dokumen yang diambil disuntikkan ke jendela konteks, menyediakan informasi spesifik untuk membumikan respons.
Manfaat RAG termasuk berkurangnya halusinasi dengan merujuk dokumen aktual, peningkatan akurasi dengan mengakses informasi terbaru di luar data pelatihan, dan penggabungan pengetahuan proprietari tanpa pelatihan ulang.
Namun, tantangannya meliputi potensi halusinasi ketika dokumen yang diambil mengandung kesalahan, masalah relevansi jika hasil pengambilan tidak membantu, dan kompleksitas dalam mengelola basis data vektor.
Kekuatan sejati RAG tampak saat kita mempertimbangkan bagaimana ia mengatasi salah satu keterbatasan paling mendasar yang kita bahas sebelumnya: batasan jendela konteks.
Bagaimana RAG membantu jendela konteks
RAG memperluas konteks melampaui ukuran jendela dengan secara selektif mengambil hanya informasi yang relevan. Alih-alih mempertahankan riwayat percakapan lengkap, Anda menyimpannya secara eksternal dan mengambil bagian yang relevan sesuai kebutuhan, mendukung panjang percakapan yang praktis tak terbatas dalam batasan jendela konteks.
Strategi untuk meningkatkan jendela konteks dengan RAG mencakup pengambilan hibrida yang mengombinasikan pencarian semantik dengan penyaringan metadata, penyusunan ulang peringkat hasil pengambilan untuk memprioritaskan dokumen yang relevan, dan pengambilan rekursif di mana respons awal model memandu pengambilan tambahan.
RAG mewakili pendekatan yang praktis dan siap produksi untuk ekstensi memori, tetapi komunitas riset terus mendorong batas dengan arsitektur baru yang membayangkan ulang bagaimana model menangani memori pada tingkat fundamental.
Arsitektur Memori LLM Lanjutan
Arsitektur baru dan sistem yang terinspirasi ilmu saraf memajukan kapabilitas memori LLM. Pendekatan mutakhir ini membayangkan ulang bagaimana model menangani informasi konteks panjang, melampaui keterbatasan transformer tradisional untuk menciptakan sistem memori yang lebih efisien dan mirip manusia.
Arsitektur neural baru
Arsitektur seperti Mamba dan recurrent memory transformer mengoptimalkan efisiensi memori. Mamba menggunakan state space models alih-alih mekanisme atensi, mencapai skala linear, bukan kuadratik, terhadap panjang urutan, sehingga memungkinkan pemrosesan urutan yang jauh lebih panjang dengan sumber daya sebanding.
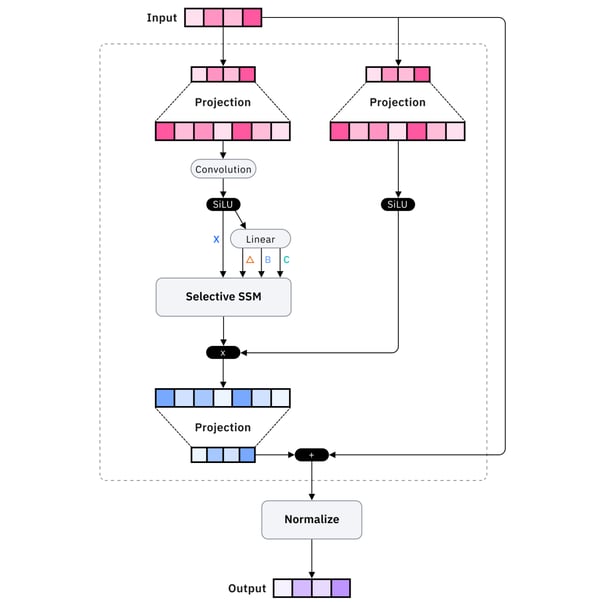
Blok Mamba
Recurrent memory transformer menambah transformer standar dengan koneksi rekuren yang mempertahankan keadaan jangka panjang, memungkinkan informasi bertahan melampaui jendela konteks langsung melalui mekanisme memori yang dipelajari.
Inovasi arsitektural ini menarik dari perspektif riset, tetapi bagaimana dengan solusi yang siap produksi? Di sinilah platform memori eksternal berperan.
Sistem memori eksternal
Platform seperti Mem0 dan Zep menyediakan solusi memori eksternal yang siap produksi. Mem0 menawarkan lapisan memori terkelola yang secara otomatis mengekstrak, menyimpan, dan mengambil informasi relevan. Zep berfokus pada memori percakapan dengan peringkasan bawaan, ekstraksi fakta, dan pencarian vektor.
Walau platform ini menawarkan solusi praktis, sebagian peneliti mengambil inspirasi dari sumber yang tak terduga: bagaimana otak manusia sebenarnya membentuk dan mengelola memori.
Augmentasi memori terinspirasi ilmu saraf
CAMELoT (Consolidated Associative Memory Enhanced Long Transformer) menerapkan prinsip ilmu saraf ke memori LLM, mengimplementasikan konsolidasi, deteksi kebaruan, dan pembobotan kebaruan waktu. Prinsip-prinsip ini mencerminkan sistem memori manusia, menciptakan perilaku memori yang lebih alami.
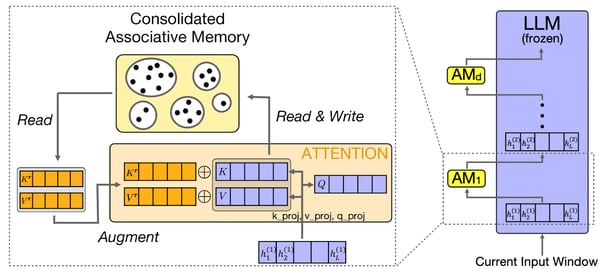
Pipeline CAMELoT
Bertumpu pada prinsip ilmu saraf tersebut, pendekatan lain, seperti Laminar, berfokus khusus pada bagaimana manusia mengingat pengalaman dan peristiwa yang berbeda.
Memori episodik untuk LLM
Larimar memungkinkan LLM mempertahankan episode memori yang berbeda. Alih-alih memperlakukan semua informasi masa lalu secara seragam, memori episodik menyusun informasi menjadi peristiwa-peristiwa terpisah. Ini memungkinkan generalisasi panjang konteks. Model merujuk episode masa lalu tertentu tanpa memuat riwayat lengkap.
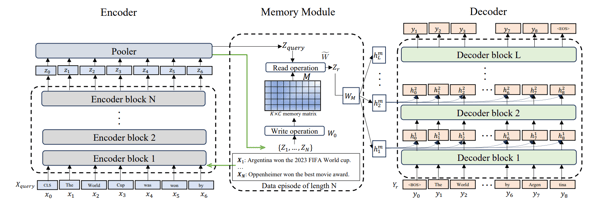
Arsitektur Larimar
Arsitektur maju ini menunjukkan potensi besar, tetapi juga memperkenalkan kompleksitas baru. Mari kita tinjau tantangan praktis yang muncul saat mengimplementasikan sistem memori dan strategi untuk mengatasinya.
Mengatasi Keterbatasan Memori LLM
Bahkan dengan arsitektur canggih, saya menemukan bahwa sistem memori menghadapi tantangan yang sering kali memerlukan mitigasi cermat. Memahami hambatan ini dan solusinya sangat penting untuk membangun sistem produksi yang tangguh dan dapat dipercaya pengguna.
Tantangan umum
Catastrophic forgetting terjadi saat model kehilangan informasi yang sebelumnya dipelajari. Solusinya meliputi konsolidasi memori, memperkuat memori penting, hierarki memori, mempertahankan informasi kritis, dan penyegaran memori berkala.
Di luar pelupaan, tantangan kritis lainnya adalah saat sistem memori secara aktif menyesatkan model. Halusinasi (menghasilkan informasi yang masuk akal namun salah) diperburuk oleh memori yang cacat. Mitigasinya melibatkan atribusi sumber, penilaian keyakinan untuk memori yang diambil, dan langkah verifikasi.
Terakhir, menyimpan percakapan dan preferensi pengguna menimbulkan pertanyaan privasi yang penting. Pertimbangan privasi dan keamanan sangat krusial saat menyimpan data pengguna. Terapkan enkripsi data, kebijakan retensi yang secara otomatis menghapus data lama, dan kontrol akses yang memastikan pengguna hanya mengakses memori mereka sendiri.
Integrasi
Mengintegrasikan memori memerlukan desain API yang matang. Pola inti mencakup integrasi stateful, di mana sistem memori mempertahankan status lintas permintaan, dan integrasi stateless, di mana setiap permintaan menyertakan pengenal yang diperlukan.
Manajemen memori yang efisien menggunakan trimming (menghapus pesan tertua atau paling tidak relevan), deletion (menghapus item tertentu), dan summarization (memampatkan pesan). Pola-pola ini menjaga memori tetap dalam anggaran sambil mempertahankan konteks esensial.
Memahami pola dan tantangan teoretis ini bernilai, tetapi ujian sesungguhnya ada pada implementasi. Mari terjemahkan konsep-konsep ini menjadi panduan praktis yang dapat Anda terapkan pada proyek Anda sendiri.
Praktik Terbaik untuk Sistem Memori LLM
Berikut beberapa cara yang saya lihat digunakan pengembang untuk memaksimalkan sistem memori LLM.
Anggaran token
Manajemen konteks yang efektif dimulai dengan memahami anggaran token Anda. Hitung berapa banyak token yang diperlukan untuk prompt sistem, memori, dan respons Anda, pastikan totalnya tetap dalam batas. Strukturkan data secara hierarkis, menempatkan informasi penting di tempat yang paling diperhatikan model—di awal atau akhir.
Siapkan data
Sama pentingnya adalah bagaimana Anda menyiapkan data sebelum masuk ke sistem memori Anda. Persiapan data sangat berpengaruh. Pecah dokumen besar menjadi potongan semantik alih-alih batas token sewenang-wenang. Tumpangtindihkan potongan sedikit untuk kesinambungan konteks. Sertakan metadata pada setiap potongan untuk memungkinkan pengambilan terfilter.
Uji dan ukur
Setelah sistem Anda berjalan, Anda memerlukan cara untuk mengukur apakah sistem benar-benar bekerja. Evaluasi memori memerlukan pelacakan metrik seperti akurasi recall, tingkat halusinasi, dan kepuasan pengguna. Pantau latensi sistem memori, penggunaan token, dan relevansi pengambilan.
Miliki strategi pengambilan
Terakhir, strategi pengambilan Anda harus beradaptasi dengan kompleksitas permintaan pengguna. Strategi pengambilan yang fleksibel beradaptasi dengan kompleksitas kueri. Kueri sederhana menggunakan pencarian kata kunci, sementara pertanyaan kompleks mendapat manfaat dari pencarian kemiripan semantik. Terapkan namespace memori untuk mengatur informasi berdasarkan pengguna, topik, atau periode waktu.
Kesimpulan
Memori model bahasa besar mentransformasikan model ini dari generator teks tanpa status menjadi asisten AI yang peka konteks dan mampu berinteraksi secara koheren dan personal. Sepanjang tutorial ini, saya telah mengeksplorasi dasar-dasar memori LLM, dari jendela konteks hingga arsitektur canggih.
Menurut saya, poin-poin pentingnya adalah mulai dengan jendela konteks dan buffer percakapan yang terkelola baik untuk kebutuhan langsung, menerapkan RAG untuk akses pengetahuan berskala di luar memori parametrik, memanfaatkan platform memori eksternal untuk aplikasi produksi, dan terus mengevaluasi efektivitas memori melalui metrik dan umpan balik pengguna.
Seiring kapabilitas LLM berkembang, sistem memori akan menjadi semakin canggih. Bagi para praktisi, fokuslah membangun sistem memori yang melayani kebutuhan pengguna: mempertahankan konteks yang relevan, melupakan secara tepat, dan memungkinkan interaksi alami yang membuat aplikasi AI benar-benar bermanfaat.
Untuk terus belajar, saya sarankan melihat sumber daya berikut:





Banyak pengembang membangun chatbot dan asisten AI yang dapat menjawab pertanyaan dengan cemerlang secara terpisah, tetapi kesulitan mempertahankan percakapan yang koheren. Penyebab utamanya? Kurangnya memori. Saat pengguna mengajukan pertanyaan lanjutan yang merujuk konteks sebelumnya, model bahasa tanpa status memperlakukannya sebagai hal yang benar-benar baru, sehingga menimbulkan interaksi yang membuat frustrasi dan berulang.
Memahami dan mengimplementasikan memori dalam model bahasa besar sangat penting untuk menciptakan aplikasi AI yang terasa alami dan cerdas. Memori memungkinkan LLM mempertahankan konteks lintas percakapan, belajar dari interaksi sebelumnya, dan memberikan respons yang dipersonalisasi. Dalam tutorial ini, saya akan memandu Anda melalui dasar-dasar memori LLM, dari jendela konteks dasar hingga arsitektur tingkat lanjut.
Jika Anda baru mengenal LLM, saya sarankan mengambil salah satu kursus kami, seperti Developing LLM Applications with LangChain, Developing Large Language Models, atau LLMOps Concepts.
Apa itu Memori LLM?
Model bahasa besar memproses informasi secara berbeda dari perangkat lunak tradisional. Sementara basis data menyimpan dan mengambil data secara eksplisit, LLM harus mengelola memori dalam batasan arsitektural seperti jendela konteks dan batas token. Tantangannya adalah membuat model mengingat informasi yang relevan sambil melupakan detail yang tidak perlu, mempertahankan koherensi tanpa membebani sumber daya komputasi.
Sebelum membahas detail implementasi, mari kita tetapkan apa arti memori dalam konteks model bahasa besar dan mengapa hal ini penting untuk membangun aplikasi AI yang efektif.
Dasar-dasar memori dalam model bahasa besar
Memori pada LLM mengacu pada kemampuan sistem untuk menyimpan dan memanfaatkan informasi dari interaksi sebelumnya atau data pelatihan. Ini bukan memori dalam arti komputasi tradisional. Ini adalah kapasitas model untuk mempertahankan konteks, merujuk pertukaran sebelumnya, dan menerapkan pola yang dipelajari ke situasi baru.
Memori sangat penting karena mengubah pasangan tanya jawab yang terisolasi menjadi percakapan yang koheren. Tanpa memori, LLM tidak dapat memahami saat Anda berkata "ceritakan lebih lanjut tentang itu." Model memerlukan konteks untuk menafsirkan rujukan dan membangun di atas pertukaran sebelumnya.
Saya sering memandang memori LLM sejajar dengan memori manusia. Manusia memiliki memori sensorik (persepsi langsung), memori jangka pendek (informasi aktif), dan memori jangka panjang (pengetahuan tersimpan). LLM menerapkan sistem analog: jendela konteks bertindak seperti memori jangka pendek, informasi yang diambil berfungsi sebagai memori jangka panjang yang dipanggil kembali, dan parameter yang dilatih mewakili pengetahuan permanen.
Sekarang setelah saya membahas konsep dasar memori dalam LLM, mari kita tinjau bagaimana sistem memori diklasifikasikan untuk membantu Anda memilih pendekatan yang tepat bagi aplikasi spesifik Anda.
Tiga dimensi klasifikasi memori LLM
Memahami bagaimana memori diklasifikasikan membantu dalam memilih pendekatan yang tepat untuk aplikasi Anda. Memori LLM dapat dikategorikan sepanjang tiga dimensi kunci: objek, bentuk, dan waktu.
Dimensi objek
Dimensi objek membedakan antara memori personal dan memori sistem. Memori personal menyimpan informasi spesifik pengguna seperti preferensi dan riwayat percakapan.
Memori sistem berisi pengetahuan umum dan kapabilitas yang tersedia untuk semua pengguna. Bot layanan pelanggan mungkin menggunakan memori sistem untuk informasi produk sekaligus mempertahankan memori personal tiap pelanggan atas riwayat pesanannya.
Dimensi bentuk
Beralih ke dimensi kedua, dimensi bentuk memisahkan memori parametrik dari non-parametrik. Memori parametrik dikodekan dalam bobot model selama pelatihan. Memori non-parametrik berada di luar model, disimpan di basis data atau penyimpanan vektor. Memori parametrik bersifat tetap setelah pelatihan, sementara memori non-parametrik dapat diperbarui secara dinamis.
Dimensi waktu
Terakhir, dimensi waktu mengategorikan memori berdasarkan durasi: jangka pendek versus jangka panjang. Memori jangka pendek mencakup percakapan saat ini, disimpan di jendela konteks. Memori jangka panjang bertahan lintas sesi, disimpan secara eksternal dan diambil saat diperlukan.
Dengan kerangka klasifikasi ini, mari kita kaji jenis-jenis memori spesifik yang diimplementasikan LLM dalam praktik.
Jenis-Jenis Memori pada LLM
Jenis memori yang berbeda melayani tujuan yang berbeda dalam aplikasi LLM. Memahami jenis-jenis ini membantu Anda merancang arsitektur memori yang efektif untuk kasus penggunaan spesifik Anda.
Memori semantik
Memori semantik menyimpan fakta dan pengetahuan umum yang dapat diakses dan dirujuk oleh sistem. Meskipun model memiliki pengetahuan dasar dari pelatihan, memori semantik dalam praktik sering merujuk ke basis pengetahuan eksternal, basis data, atau penyimpanan dokumen yang berisi informasi faktual.
Sebagai contoh, bot layanan pelanggan mungkin memiliki memori semantik yang menyimpan spesifikasi produk, informasi harga, dan kebijakan perusahaan dalam basis data vektor. Ini memungkinkan sistem mengambil dan merujuk fakta yang akurat dan terbaru tanpa hanya bergantung pada data pelatihan yang mungkin sudah usang. Memori semantik biasanya disimpan secara eksternal dan diambil saat dibutuhkan, sehingga mudah diperbarui dan dikelola.
Memori episodik
Sementara memori semantik berkaitan dengan fakta dan pengetahuan, memori episodik berfokus pada pengalaman spesifik. Memori episodik menangkap interaksi masa lalu, pertanyaan yang diajukan, bagaimana model merespons, dan konteks yang mengiringi pertukaran tersebut.
Memori episodik memungkinkan model merujuk bagian awal percakapan secara alami, mengatakan hal-hal seperti "seperti yang kita bahas sebelumnya" atau "berdasarkan apa yang Anda ceritakan tentang proyek Anda." Jenis memori ini biasanya non-parametrik, disimpan dalam buffer percakapan atau basis data.
Memori prosedural
Memori prosedural mencakup instruksi sistem dan prosedur yang dipelajari. Ini termasuk prompt sistem yang mendefinisikan perilaku AI, pedoman cara merespons, dan instruksi khusus tugas.
Saat Anda mengonfigurasi model untuk "selalu menjawab dalam bentuk poin" atau "mengutamakan akurasi dibanding kreativitas," Anda sedang menyetel memori prosedural. Ini membentuk bagaimana model memproses dan merespons informasi alih-alih apa yang model ketahui.
Jenis-Jenis Memori
Di luar jenis memori fundamental ini, implementasi praktis, khususnya dalam kerangka kerja seperti LangChain, menawarkan berbagai bentuk memori percakapan.
ConversationBufferMemorymenyimpan semua pesan secara utuh, mempertahankan riwayat percakapan lengkap, ideal untuk percakapan singkat saat Anda memerlukan konteks penuh.ConversationSummaryMemorymemampatkan interaksi masa lalu menjadi ringkasan, mengurangi penggunaan token sambil menjaga informasi kunci untuk percakapan yang lebih panjang.ConversationBufferWindowMemoryhanya menyimpan N pesan terbaru, menciptakan jendela konteks geser yang efektif saat hanya pertukaran terbaru yang penting.ConversationSummaryBufferMemorymenggabungkan pendekatan, mempertahankan pesan terbaru apa adanya sambil merangkum pertukaran yang lebih lama, menawarkan keseimbangan antara detail dan efisiensi. Setiap bentuk menukar kelengkapan dengan efisiensi, memungkinkan Anda memilih berdasarkan kebutuhan spesifik aplikasi Anda.Memahami jenis-jenis memori ini penting, tetapi semuanya beroperasi dalam batasan mendasar: jendela konteks. Mari jelajahi bagaimana batasan arsitektural ini membentuk implementasi memori.
Jendela Konteks LLM: Fondasi dan Batasan
Menurut saya, salah satu aspek kunci memori LLM yang perlu dipahami adalah konsep jendela konteks. Mari kita lihat sekilas bagaimana cara kerjanya.
Apa itu jendela konteks?
Jendela konteks adalah jumlah maksimum teks, diukur dalam token, yang dapat diproses LLM dalam satu permintaan. Token adalah potongan teks, kira-kira setara dengan kata atau sub-kata.
Jendela konteks berfungsi sebagai memori kerja langsung model. Segala sesuatu yang dipertimbangkan model harus muat dalam jendela ini: prompt sistem, riwayat percakapan, dokumen yang diambil, dan ruang respons. Seiring percakapan bertambah, pesan yang lebih lama harus dihapus untuk yang baru.
Ukuran jendela konteks sangat bervariasi. Misalnya, GPT-5 mendukung 400.000 token, Claude 4.5 Sonnet menangani 200.000 token, dan Gemini 3 Pro mencapai 1,5 juta token. Jendela yang lebih besar memungkinkan konteks yang lebih kaya tetapi meningkatkan biaya komputasi secara kuadratik.
Meskipun memiliki jendela konteks besar terdengar ideal, itu menimbulkan tantangan praktis yang signifikan yang memengaruhi penerapan di dunia nyata.
Tantangan dan keterbatasan jendela konteks
Menurut pengalaman saya, masalah terbesar dengan jendela konteks adalah masalah "hilang di tengah". Riset menunjukkan LLM lebih memperhatikan informasi di awal dan akhir jendela konteks, sementara konten di tengah mendapat perhatian lebih sedikit. Sekadar menjejalkan konteks dengan informasi tidak menjamin pemanfaatan yang efektif.
Akurasi vs. Posisi Dokumen dengan Jawaban
Keterbatasan komputasi membuat perluasan jendela konteks menjadi mahal. Memproses konteks 100.000 token memerlukan memori GPU dan waktu yang jauh lebih banyak daripada konteks 10.000 token.
Untuk aplikasi produksi, biaya ini cepat terakumulasi, mendorong kebutuhan sistem memori cerdas yang hanya menyertakan informasi relevan secara selektif.
Mengingat batasan ini, solusinya bukan sekadar memperluas jendela konteks, melainkan membangun sistem yang lebih cerdas yang menggunakannya secara efisien.
Memadukan jendela konteks dengan sistem memori
Aplikasi LLM yang efektif mengombinasikan jendela konteks dengan sistem memori yang melampaui konteks langsung. Polanya melibatkan penggunaan jendela konteks untuk informasi jangka pendek berprioritas tinggi sambil menyimpan memori jangka panjang secara eksternal dan mengambilnya secara selektif.
Arsitektur khas mempertahankan giliran percakapan terbaru dalam jendela konteks, menyimpan percakapan yang lebih lama di basis data, dan menggunakan mekanisme pengambilan untuk membawa kembali informasi masa lalu yang relevan saat diperlukan. Ini menyeimbangkan kelengkapan dengan efisiensi dan kinerja.
Memori Jangka Pendek/Panjang
Dengan pemahaman arsitektural ini, mari kita jelajahi cara mengimplementasikan sistem memori jangka pendek yang efektif yang bekerja dalam batasan ini
Mengimplementasikan Sistem Memori Jangka Pendek pada LLM
Sistem memori jangka pendek mengelola informasi dalam sesi saat ini, terutama memanfaatkan jendela konteks. Saya suka menganggap ini sebagai memori kerja model; informasi yang secara aktif dipegangnya saat memproses percakapan saat ini.
Mari kita lihat cara memaksimalkan ruang memori yang terbatas namun krusial ini.
Pembelajaran dalam konteks
Pembelajaran dalam konteks mengacu pada kemampuan model untuk menyesuaikan perilaku berdasarkan contoh atau instruksi dalam prompt. Anda mengajari model dengan menunjukkan apa yang harus dilakukan di dalam jendela konteks alih-alih melakukan fine-tuning.
Mekanismenya sederhana:
Manfaat pendekatan ini meliputi:
Keterbatasannya termasuk efektivitas yang menurun dengan banyak contoh karena "hilang di tengah", biaya token meningkat, dan kinerja jarang menyamai model yang di-fine-tune.
Pembelajaran dalam konteks menunjukkan apa yang mungkin dilakukan dengan memori jangka pendek, tetapi bagaimana informasi sebenarnya disimpan untuk digunakan model? Mari jelajahi mekanisme di balik pembentukan memori.
Menulis dan menyimpan memori
Pembentukan memori dalam sistem LLM dapat berlangsung secara sadar (eksplisit) atau bawah sadar (implisit).
Banyak kerangka kerja secara otomatis memelihara buffer percakapan, menciptakan memori implisit tanpa operasi eksplisit. Tantangannya adalah mengelola akumulasi ini, memastikan informasi yang relevan tetap ada sementara detail yang kurang penting dipangkas.
Memori jangka pendek menangani kebutuhan percakapan langsung, tetapi apa yang terjadi saat Anda memerlukan informasi bertahan melampaui sesi saat ini? Di sinilah solusi memori jangka panjang menjadi penting.
Solusi Memori Jangka Panjang LLM
Memori jangka panjang memungkinkan LLM mempertahankan informasi lintas sesi.
Sementara memori jangka pendek bersifat sementara dan menghilang saat percakapan berakhir, memori jangka panjang tetap ada, memungkinkan AI Anda mengingat preferensi pengguna, interaksi sebelumnya, dan pengetahuan yang terakumulasi seiring waktu.
Saya akan menyoroti dua pendekatan utama: sistem memori berbasis teks yang menyimpan informasi secara eksternal dan key-value caching yang mengoptimalkan cara model mengakses informasi yang sebelumnya dihitung.
Sistem memori berbasis teks
Memori berbasis teks menyimpan riwayat percakapan dan informasi pengguna dalam basis data atau penyimpanan vektor. Akuisisi melibatkan penangkapan informasi yang relevan, preferensi, keputusan, fakta, atau detail kontekstual.
Manajemen memori memerlukan kompresi dan pengorganisasian. Teknik peringkasan memampatkan percakapan menjadi poin-poin kunci. Organisasi hierarkis menyusun memori berdasarkan topik, periode waktu, atau relevansi.
Pemanfaatan berfokus pada pengambilan. Pencarian kemiripan vektor menemukan memori yang relevan berdasarkan makna semantik. Pengambilan berbasis waktu memprioritaskan informasi terbaru. Penilaian relevansi memberi peringkat memori berdasarkan kepentingannya.
Sistem berbasis teks menangani apa yang harus disimpan, tetapi ada juga pertanyaan tentang bagaimana membuat pengambilan lebih efisien. Di sinilah key-value caching berperan.
Key-value caching dan optimisasi atensi
Key-value (KV) caching meningkatkan efisiensi pembuatan token. Selama pembuatan teks, model menghitung atensi atas semua token sebelumnya. KV caching menyimpan perhitungan antara ini, memungkinkan penggunaan ulang saat menghasilkan token berikutnya tanpa perhitungan ulang.
Key-value Caching dan Optimisasi Atensi
Manfaatnya besar: biaya komputasi berkurang, memungkinkan respons lebih cepat dan penggunaan sumber daya lebih rendah. Namun, pasangan key-value yang di-cache mengonsumsi VRAM GPU. Untuk konteks yang sangat panjang, ukuran KV cache menjadi kendala.
Walaupun KV caching mengoptimalkan cara model menggunakan jendela konteksnya, ini tidak menyelesaikan masalah mendasar kapasitas memori yang terbatas. Di sinilah retrieval-augmented generation menawarkan pendekatan komplementer.
Retrieval-Augmented Generation (RAG)
Salah satu kemajuan terbaru yang menurut saya paling menarik adalah Retrieval-Augmented Generation atau RAG. RAG menjembatani memori internal dan eksternal, memperluas memori LLM melampaui batasan jendela konteks.
Alih-alih hanya mengandalkan apa yang dipelajari model selama pelatihan atau apa yang muat di konteks saat ini, RAG secara dinamis menarik informasi relevan dari sumber eksternal tepat saat dibutuhkan. Mari kita jelajahi RAG lebih rinci.
Menjembatani memori internal dan eksternal
Arsitektur RAG terdiri dari dua komponen utama: retriever yang mencari informasi relevan di basis pengetahuan eksternal dan generator (LLM) yang menghasilkan respons berdasarkan kueri dan konteks yang diambil.
Saat kueri datang, retriever menemukan dokumen yang relevan dari basis data vektor atau basis pengetahuan. Dokumen yang diambil disuntikkan ke jendela konteks, menyediakan informasi spesifik untuk membumikan respons.
Manfaat RAG termasuk berkurangnya halusinasi dengan merujuk dokumen aktual, peningkatan akurasi dengan mengakses informasi terbaru di luar data pelatihan, dan penggabungan pengetahuan proprietari tanpa pelatihan ulang.
Namun, tantangannya meliputi potensi halusinasi ketika dokumen yang diambil mengandung kesalahan, masalah relevansi jika hasil pengambilan tidak membantu, dan kompleksitas dalam mengelola basis data vektor.
Kekuatan sejati RAG tampak saat kita mempertimbangkan bagaimana ia mengatasi salah satu keterbatasan paling mendasar yang kita bahas sebelumnya: batasan jendela konteks.
Bagaimana RAG membantu jendela konteks
RAG memperluas konteks melampaui ukuran jendela dengan secara selektif mengambil hanya informasi yang relevan. Alih-alih mempertahankan riwayat percakapan lengkap, Anda menyimpannya secara eksternal dan mengambil bagian yang relevan sesuai kebutuhan, mendukung panjang percakapan yang praktis tak terbatas dalam batasan jendela konteks.
Strategi untuk meningkatkan jendela konteks dengan RAG mencakup pengambilan hibrida yang mengombinasikan pencarian semantik dengan penyaringan metadata, penyusunan ulang peringkat hasil pengambilan untuk memprioritaskan dokumen yang relevan, dan pengambilan rekursif di mana respons awal model memandu pengambilan tambahan.
RAG mewakili pendekatan yang praktis dan siap produksi untuk ekstensi memori, tetapi komunitas riset terus mendorong batas dengan arsitektur baru yang membayangkan ulang bagaimana model menangani memori pada tingkat fundamental.
Arsitektur Memori LLM Lanjutan
Arsitektur baru dan sistem yang terinspirasi ilmu saraf memajukan kapabilitas memori LLM. Pendekatan mutakhir ini membayangkan ulang bagaimana model menangani informasi konteks panjang, melampaui keterbatasan transformer tradisional untuk menciptakan sistem memori yang lebih efisien dan mirip manusia.
Arsitektur neural baru
Arsitektur seperti Mamba dan recurrent memory transformer mengoptimalkan efisiensi memori. Mamba menggunakan state space models alih-alih mekanisme atensi, mencapai skala linear, bukan kuadratik, terhadap panjang urutan, sehingga memungkinkan pemrosesan urutan yang jauh lebih panjang dengan sumber daya sebanding.
Blok Mamba
Recurrent memory transformer menambah transformer standar dengan koneksi rekuren yang mempertahankan keadaan jangka panjang, memungkinkan informasi bertahan melampaui jendela konteks langsung melalui mekanisme memori yang dipelajari.
Inovasi arsitektural ini menarik dari perspektif riset, tetapi bagaimana dengan solusi yang siap produksi? Di sinilah platform memori eksternal berperan.
Sistem memori eksternal
Platform seperti Mem0 dan Zep menyediakan solusi memori eksternal yang siap produksi. Mem0 menawarkan lapisan memori terkelola yang secara otomatis mengekstrak, menyimpan, dan mengambil informasi relevan. Zep berfokus pada memori percakapan dengan peringkasan bawaan, ekstraksi fakta, dan pencarian vektor.
Walau platform ini menawarkan solusi praktis, sebagian peneliti mengambil inspirasi dari sumber yang tak terduga: bagaimana otak manusia sebenarnya membentuk dan mengelola memori.
Augmentasi memori terinspirasi ilmu saraf
CAMELoT (Consolidated Associative Memory Enhanced Long Transformer) menerapkan prinsip ilmu saraf ke memori LLM, mengimplementasikan konsolidasi, deteksi kebaruan, dan pembobotan kebaruan waktu. Prinsip-prinsip ini mencerminkan sistem memori manusia, menciptakan perilaku memori yang lebih alami.
Pipeline CAMELoT
Bertumpu pada prinsip ilmu saraf tersebut, pendekatan lain, seperti Laminar, berfokus khusus pada bagaimana manusia mengingat pengalaman dan peristiwa yang berbeda.
Memori episodik untuk LLM
Larimar memungkinkan LLM mempertahankan episode memori yang berbeda. Alih-alih memperlakukan semua informasi masa lalu secara seragam, memori episodik menyusun informasi menjadi peristiwa-peristiwa terpisah. Ini memungkinkan generalisasi panjang konteks. Model merujuk episode masa lalu tertentu tanpa memuat riwayat lengkap.
Arsitektur Larimar
Arsitektur maju ini menunjukkan potensi besar, tetapi juga memperkenalkan kompleksitas baru. Mari kita tinjau tantangan praktis yang muncul saat mengimplementasikan sistem memori dan strategi untuk mengatasinya.
Mengatasi Keterbatasan Memori LLM
Bahkan dengan arsitektur canggih, saya menemukan bahwa sistem memori menghadapi tantangan yang sering kali memerlukan mitigasi cermat. Memahami hambatan ini dan solusinya sangat penting untuk membangun sistem produksi yang tangguh dan dapat dipercaya pengguna.
Tantangan umum
Catastrophic forgetting terjadi saat model kehilangan informasi yang sebelumnya dipelajari. Solusinya meliputi konsolidasi memori, memperkuat memori penting, hierarki memori, mempertahankan informasi kritis, dan penyegaran memori berkala.
Di luar pelupaan, tantangan kritis lainnya adalah saat sistem memori secara aktif menyesatkan model. Halusinasi (menghasilkan informasi yang masuk akal namun salah) diperburuk oleh memori yang cacat. Mitigasinya melibatkan atribusi sumber, penilaian keyakinan untuk memori yang diambil, dan langkah verifikasi.
Terakhir, menyimpan percakapan dan preferensi pengguna menimbulkan pertanyaan privasi yang penting. Pertimbangan privasi dan keamanan sangat krusial saat menyimpan data pengguna. Terapkan enkripsi data, kebijakan retensi yang secara otomatis menghapus data lama, dan kontrol akses yang memastikan pengguna hanya mengakses memori mereka sendiri.
Integrasi
Mengintegrasikan memori memerlukan desain API yang matang. Pola inti mencakup integrasi stateful, di mana sistem memori mempertahankan status lintas permintaan, dan integrasi stateless, di mana setiap permintaan menyertakan pengenal yang diperlukan.
Manajemen memori yang efisien menggunakan trimming (menghapus pesan tertua atau paling tidak relevan), deletion (menghapus item tertentu), dan summarization (memampatkan pesan). Pola-pola ini menjaga memori tetap dalam anggaran sambil mempertahankan konteks esensial.
Memahami pola dan tantangan teoretis ini bernilai, tetapi ujian sesungguhnya ada pada implementasi. Mari terjemahkan konsep-konsep ini menjadi panduan praktis yang dapat Anda terapkan pada proyek Anda sendiri.
Praktik Terbaik untuk Sistem Memori LLM
Berikut beberapa cara yang saya lihat digunakan pengembang untuk memaksimalkan sistem memori LLM.
Anggaran token
Manajemen konteks yang efektif dimulai dengan memahami anggaran token Anda. Hitung berapa banyak token yang diperlukan untuk prompt sistem, memori, dan respons Anda, pastikan totalnya tetap dalam batas. Strukturkan data secara hierarkis, menempatkan informasi penting di tempat yang paling diperhatikan model—di awal atau akhir.
Siapkan data
Sama pentingnya adalah bagaimana Anda menyiapkan data sebelum masuk ke sistem memori Anda. Persiapan data sangat berpengaruh. Pecah dokumen besar menjadi potongan semantik alih-alih batas token sewenang-wenang. Tumpangtindihkan potongan sedikit untuk kesinambungan konteks. Sertakan metadata pada setiap potongan untuk memungkinkan pengambilan terfilter.
Uji dan ukur
Setelah sistem Anda berjalan, Anda memerlukan cara untuk mengukur apakah sistem benar-benar bekerja. Evaluasi memori memerlukan pelacakan metrik seperti akurasi recall, tingkat halusinasi, dan kepuasan pengguna. Pantau latensi sistem memori, penggunaan token, dan relevansi pengambilan.
Miliki strategi pengambilan
Terakhir, strategi pengambilan Anda harus beradaptasi dengan kompleksitas permintaan pengguna. Strategi pengambilan yang fleksibel beradaptasi dengan kompleksitas kueri. Kueri sederhana menggunakan pencarian kata kunci, sementara pertanyaan kompleks mendapat manfaat dari pencarian kemiripan semantik. Terapkan namespace memori untuk mengatur informasi berdasarkan pengguna, topik, atau periode waktu.
Kesimpulan
Memori model bahasa besar mentransformasikan model ini dari generator teks tanpa status menjadi asisten AI yang peka konteks dan mampu berinteraksi secara koheren dan personal. Sepanjang tutorial ini, saya telah mengeksplorasi dasar-dasar memori LLM, dari jendela konteks hingga arsitektur canggih.
Menurut saya, poin-poin pentingnya adalah mulai dengan jendela konteks dan buffer percakapan yang terkelola baik untuk kebutuhan langsung, menerapkan RAG untuk akses pengetahuan berskala di luar memori parametrik, memanfaatkan platform memori eksternal untuk aplikasi produksi, dan terus mengevaluasi efektivitas memori melalui metrik dan umpan balik pengguna.
Seiring kapabilitas LLM berkembang, sistem memori akan menjadi semakin canggih. Bagi para praktisi, fokuslah membangun sistem memori yang melayani kebutuhan pengguna: mempertahankan konteks yang relevan, melupakan secara tepat, dan memungkinkan interaksi alami yang membuat aplikasi AI benar-benar bermanfaat.
Untuk terus belajar, saya sarankan melihat sumber daya berikut: