
{count, plural, one {Corso} other {Corsi}}
Introduzione agli LLM in Python
{hours} ore
36.7K
Molti sviluppatori creano chatbot e assistenti IA capaci di rispondere in modo brillante a singole domande, ma che faticano a mantenere conversazioni coerenti. La causa principale? La mancanza di memoria. Quando un utente fa una domanda di follow-up che fa riferimento a un contesto precedente, i modelli linguistici senza stato la trattano come del tutto nuova, portando a interazioni frustranti e ripetitive.
Capire e implementare la memoria nei large language model è fondamentale per creare applicazioni di IA che sembrino naturali e intelligenti. La memoria permette agli LLM di mantenere il contesto nelle conversazioni, imparare dalle interazioni passate e fornire risposte personalizzate. In questo tutorial, ti guiderò attraverso le basi della memoria negli LLM, dalle semplici finestre di contesto alle architetture avanzate.
Se sei alle prime armi con gli LLM, ti consiglio di seguire uno dei nostri corsi, come Developing LLM Applications with LangChain, Developing Large Language Models o LLMOps Concepts.
I large language model elaborano le informazioni in modo diverso dal software tradizionale. Mentre i database archiviano e recuperano i dati in modo esplicito, gli LLM devono gestire la memoria entro vincoli architetturali come finestre di contesto e limiti di token. La sfida consiste nel far sì che i modelli ricordino le informazioni rilevanti dimenticando i dettagli non necessari, mantenendo coerenza senza sovraccaricare le risorse computazionali.
Prima di entrare nei dettagli di implementazione, chiariamo cosa significa memoria nel contesto dei large language model e perché è importante per costruire applicazioni di IA efficaci.
La memoria negli LLM si riferisce alla capacità del sistema di trattenere e utilizzare informazioni da interazioni precedenti o dai dati di addestramento. Non è memoria nel senso informatico tradizionale. È la capacità del modello di mantenere il contesto, fare riferimento agli scambi passati e applicare schemi appresi a nuove situazioni.
La memoria è cruciale perché trasforma coppie isolate di domanda e risposta in conversazioni coerenti. Senza memoria, un LLM non può capire quando dici "dimmi di più su quello". Il modello ha bisogno di contesto per interpretare i riferimenti e costruire sulle interazioni precedenti.
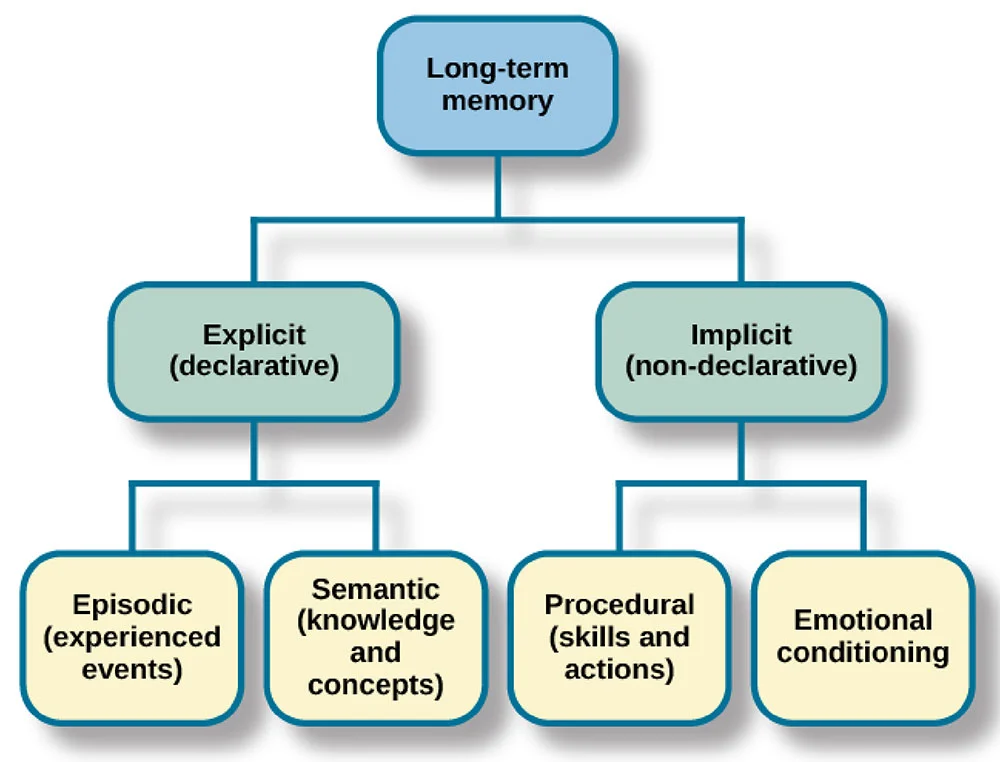
Penso spesso alla memoria degli LLM in parallelo con quella umana. Gli esseri umani hanno memoria sensoriale (percezione immediata), memoria a breve termine (informazioni attive) e memoria a lungo termine (conoscenza conservata). Gli LLM implementano sistemi analoghi: le finestre di contesto funzionano come memoria a breve termine, le informazioni recuperate come memoria a lungo termine richiamata e i parametri addestrati rappresentano la conoscenza permanente.
Ora che ho trattato il concetto fondamentale di memoria negli LLM, vediamo come vengono classificate le memorie per aiutarti a scegliere l'approccio giusto per la tua applicazione specifica.
Capire come viene classificata la memoria aiuta a scegliere l'approccio giusto per la tua applicazione. La memoria negli LLM può essere categorizzata lungo tre dimensioni chiave: oggetto, forma e tempo.
La dimensione oggetto distingue tra memoria personale e memoria di sistema. La memoria personale conserva informazioni specifiche dell'utente come preferenze e cronologia delle conversazioni.
La memoria di sistema contiene conoscenze generali e funzionalità disponibili per tutti gli utenti. Un bot di assistenza clienti potrebbe usare la memoria di sistema per le informazioni sui prodotti, mantenendo al contempo la memoria personale della cronologia ordini di ciascun cliente.
Passando alla seconda dimensione, la dimensione forma separa la memoria parametrica da quella non parametrica. La memoria parametrica è codificata nei pesi del modello durante l'addestramento. La memoria non parametrica esiste al di fuori del modello, archiviata in database o archivi vettoriali. La memoria parametrica è fissa dopo l'addestramento, mentre quella non parametrica può essere aggiornata dinamicamente.
Infine, la dimensione tempo classifica la memoria in base alla durata: a breve termine e a lungo termine. La memoria a breve termine copre la conversazione corrente, archiviata nella finestra di contesto. La memoria a lungo termine persiste tra le sessioni, archiviata esternamente e recuperata quando necessario.
Stabilito questo quadro di classificazione, esaminiamo i tipi specifici di memoria che gli LLM implementano nella pratica.
Tipi di memoria diversi servono a scopi distinti nelle applicazioni LLM. Capirli ti aiuta a progettare architetture di memoria efficaci per il tuo caso d'uso.
La memoria semantica conserva fatti e conoscenze generali a cui il sistema può accedere e fare riferimento. Sebbene i modelli possano disporre di conoscenze di base dall'addestramento, nella pratica la memoria semantica spesso si riferisce a basi di conoscenza esterne, database o archivi di documenti contenenti informazioni fattuali.
Per esempio, un bot di assistenza clienti potrebbe avere una memoria semantica che archivia specifiche dei prodotti, informazioni sui prezzi e policy aziendali in un database vettoriale. Questo consente al sistema di recuperare e citare fatti accurati e aggiornati senza fare affidamento esclusivamente su dati di addestramento potenzialmente obsoleti. La memoria semantica è in genere archiviata esternamente e recuperata quando serve, risultando facile da aggiornare e manutenere.
Mentre la memoria semantica riguarda fatti e conoscenze, la memoria episodica si concentra su esperienze specifiche. La memoria episodica cattura interazioni passate, quali domande sono state poste, come il modello ha risposto e il contesto che circondava quegli scambi.
La memoria episodica permette al modello di fare riferimento in modo naturale alle parti precedenti della conversazione, dicendo cose come "come abbiamo discusso prima" o "in base a quanto mi hai detto sul tuo progetto". Questo tipo di memoria è tipicamente non parametrica, archiviata in buffer di conversazione o database.
La memoria procedurale comprende istruzioni di sistema e procedure apprese. Include il prompt di sistema che definisce il comportamento dell'IA, le linee guida su come rispondere e le istruzioni specifiche per il compito.
Quando configuri un modello perché "risponda sempre per punti" o "dia priorità all'accuratezza rispetto alla creatività", stai impostando la memoria procedurale. Questa influenza il modo in cui il modello elabora e risponde alle informazioni, più che quali informazioni conosce.
Oltre a questi tipi fondamentali, implementazioni pratiche, in particolare in framework come LangChain, offrono varie forme di memoria conversazionale.
ConversationBufferMemory archivia tutti i messaggi per intero, mantenendo la cronologia completa della conversazione, ideale per conversazioni brevi in cui serve il contesto completo. ConversationSummaryMemory comprime le interazioni passate in riepiloghi, riducendo l'uso di token pur preservando le informazioni chiave per conversazioni più lunghe. ConversationBufferWindowMemory mantiene solo gli ultimi N messaggi, creando una finestra di contesto scorrevole che funziona bene quando contano solo gli scambi recenti. ConversationSummaryBufferMemory combina gli approcci, mantenendo i messaggi recenti alla lettera mentre riassume gli scambi più vecchi, offrendo un equilibrio tra dettaglio ed efficienza. Ogni forma bilancia completezza ed efficienza, permettendoti di scegliere in base alle esigenze specifiche della tua applicazione.Capire questi tipi di memoria è essenziale, ma tutti operano entro un vincolo fondamentale: la finestra di contesto. Vediamo come questo limite architetturale plasma l'implementazione della memoria.
Uno degli aspetti chiave della memoria negli LLM, a mio avviso, è il concetto di finestre di contesto. Diamo un'occhiata rapida a come funzionano.
Una finestra di contesto è la quantità massima di testo, misurata in token, che un LLM può elaborare in una singola richiesta. I token sono frammenti di testo, corrispondenti approssimativamente a parole o sottoparole.
La finestra di contesto funziona come la memoria di lavoro immediata del modello. Tutto ciò che il modello considera deve rientrare in questa finestra: prompt di sistema, cronologia della conversazione, documenti recuperati e spazio per la risposta. Man mano che le conversazioni crescono, i messaggi più vecchi devono essere rimossi per fare spazio ai nuovi.
La dimensione della finestra di contesto varia notevolmente. Per esempio, GPT-5 supporta 400.000 token, Claude 4.5 Sonnet gestisce 200.000 token e Gemini 3 Pro arriva a 1,5 milioni di token. Finestre più ampie consentono un contesto più ricco ma aumentano i costi computazionali in modo quadratico.
Sebbene avere grandi finestre di contesto sembri ideale, introducono notevoli sfide pratiche che incidono sulla messa in produzione.
Per esperienza, il problema più grande con le finestre di contesto è il fenomeno "lost in the middle". La ricerca mostra che gli LLM prestano più attenzione alle informazioni all'inizio e alla fine della finestra, mentre il contenuto intermedio riceve meno attenzione. Semplicemente riempire il contesto di informazioni non ne garantisce l'uso efficace.
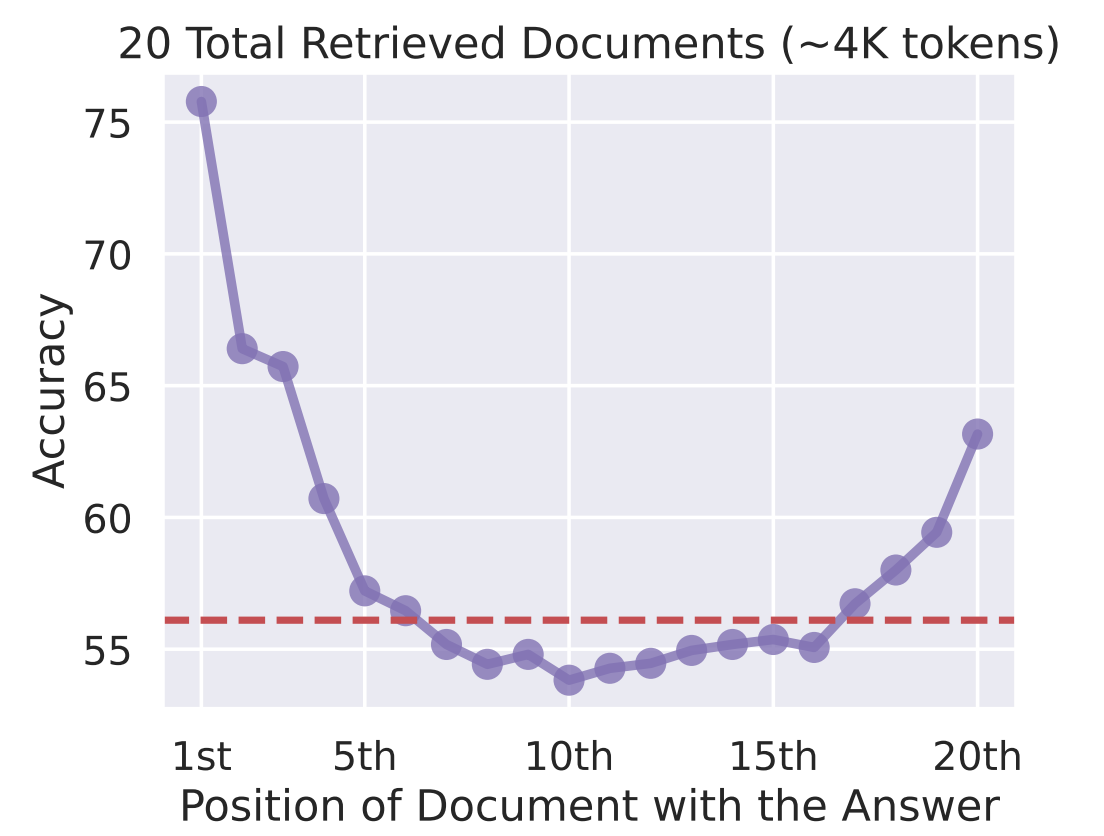
Accuratezza vs. posizione del documento con la risposta
I vincoli computazionali rendono costoso espandere le finestre di contesto. Elaborare un contesto da 100.000 token richiede molta più memoria GPU e tempo rispetto a un contesto da 10.000 token.
Per applicazioni in produzione, questi costi si sommano rapidamente, creando l'esigenza di sistemi di memoria intelligenti che includano selettivamente solo le informazioni rilevanti.
Dato questi vincoli, la soluzione non è semplicemente ampliare le finestre di contesto, ma costruire sistemi più intelligenti che le usino in modo efficiente.
Applicazioni LLM efficaci combinano le finestre di contesto con sistemi di memoria che si estendono oltre il contesto immediato. Il modello prevede di usare la finestra di contesto per informazioni a breve termine e ad alta priorità, mentre la memoria a lungo termine viene archiviata esternamente e recuperata in modo selettivo.
Un'architettura tipica mantiene gli scambi recenti nella finestra di contesto, archivia le conversazioni più vecchie in un database e usa meccanismi di retrieval per riportare quando serve le informazioni passate pertinenti. Questo bilancia completezza, efficienza e prestazioni.
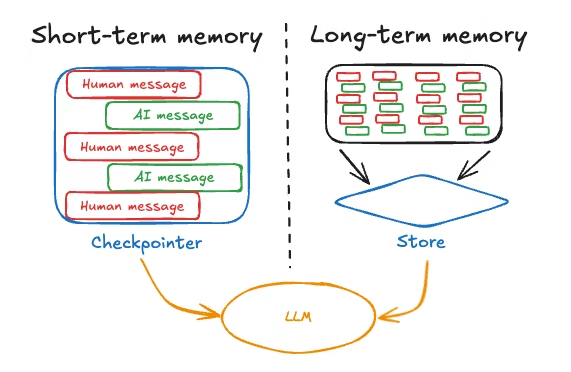
Con questa comprensione architetturale, vediamo come implementare sistemi di memoria a breve termine efficaci che funzionino entro questi vincoli
I sistemi di memoria a breve termine gestiscono le informazioni all'interno della sessione corrente, sfruttando principalmente la finestra di contesto. Mi piace pensarla come la memoria di lavoro del modello: le informazioni che tiene attivamente mentre elabora la conversazione in corso.
Vediamo come massimizzare questo spazio di memoria limitato ma cruciale.
L'apprendimento in contesto si riferisce alla capacità del modello di adattare il comportamento in base a esempi o istruzioni presenti nel prompt. Insegni al modello mostrandogli cosa fare all'interno della finestra di contesto, invece di eseguire il fine-tuning.
Il meccanismo è semplice:
I vantaggi di questo approccio includono:
Le limitazioni includono efficacia ridotta con molti esempi a causa del "lost in the middle", costi di token più alti e prestazioni raramente pari a quelle dei modelli sottoposti a fine-tuning.
L'apprendimento in contesto mostra cosa è possibile con la memoria a breve termine, ma come vengono effettivamente memorizzate le informazioni per l'uso del modello? Vediamo i meccanismi alla base della formazione della memoria.
La formazione della memoria nei sistemi LLM può essere conscia (esplicita) o inconscia (implicita).
Molti framework mantengono automaticamente buffer di conversazione, creando memoria implicita senza operazioni esplicite. La sfida è gestire questo accumulo, garantendo che le informazioni rilevanti persistano mentre i dettagli meno importanti vengono potati.
La memoria a breve termine gestisce le esigenze conversazionali immediate, ma cosa succede quando serve che le informazioni persistano oltre la sessione corrente? Qui diventano essenziali le soluzioni di memoria a lungo termine.
La memoria a lungo termine permette agli LLM di mantenere informazioni tra sessioni.
Mentre la memoria a breve termine è effimera e scompare quando la conversazione finisce, la memoria a lungo termine persiste, consentendo alla tua IA di ricordare preferenze dell'utente, interazioni passate e conoscenza accumulata nel tempo.
Metterò in evidenza due approcci chiave: sistemi di memoria basati su testo che archiviano informazioni esternamente e caching chiave-valore che ottimizza il modo in cui il modello accede a informazioni precedentemente calcolate.
La memoria basata su testo archivia cronologie di conversazione e informazioni sugli utenti in database o archivi vettoriali. L'acquisizione comporta la cattura di informazioni rilevanti, preferenze, decisioni, fatti o dettagli contestuali.
La gestione della memoria richiede compressione e organizzazione. Tecniche di sintesi comprimono le conversazioni in punti chiave. Un'organizzazione gerarchica struttura le memorie per argomenti, periodi di tempo o rilevanza.
L'utilizzo si concentra sul recupero. La ricerca per similarità vettoriale trova memorie rilevanti per significato semantico. Il recupero basato sul tempo dà priorità alle informazioni recenti. Il punteggio di rilevanza classifica le memorie per importanza.
I sistemi basati su testo gestiscono cosa archiviare, ma resta la domanda su come rendere il recupero più efficiente. Qui entra in gioco il caching chiave-valore.
Il caching key-value (KV) migliora l'efficienza nella generazione di token. Durante la generazione del testo, il modello calcola l'attenzione su tutti i token precedenti. Il KV caching archivia questi calcoli intermedi, permettendone il riutilizzo nella generazione dei token successivi senza ricalcolarli.
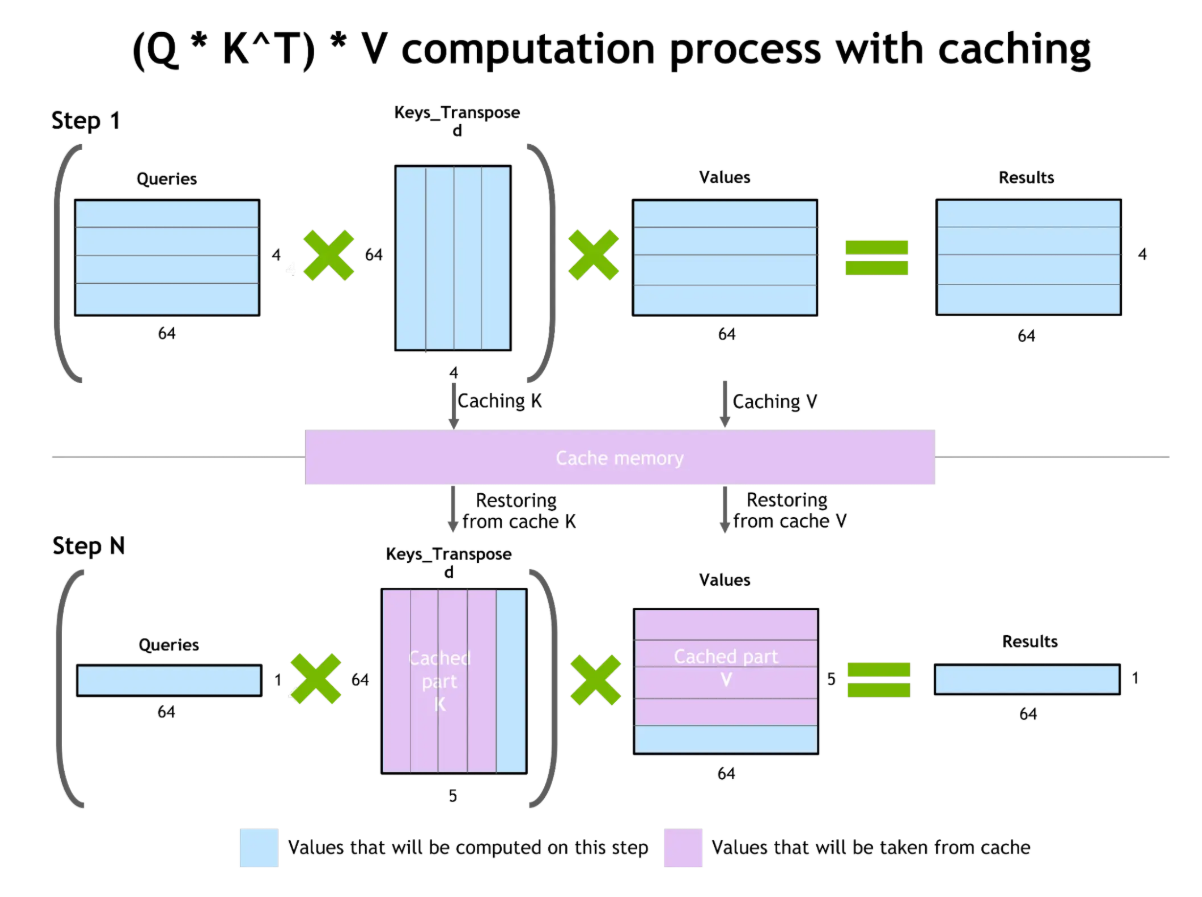
Caching key-value e ottimizzazione dell'attenzione
Il vantaggio è notevole: costi computazionali ridotti, con risposte più rapide e minore consumo di risorse. Tuttavia, le coppie chiave-valore in cache consumano VRAM della GPU. Per contesti molto lunghi, la dimensione della cache KV diventa un vincolo.
Sebbene il KV caching ottimizzi come i modelli usano le finestre di contesto, non risolve il problema fondamentale della capacità di memoria limitata. È qui che la generazione aumentata dal recupero offre un approccio complementare.
Una delle innovazioni recenti che trovo più interessanti è la Retrieval-Augmented Generation o RAG. RAG fa da ponte tra memoria interna ed esterna, estendendo la memoria di un LLM oltre i vincoli della finestra di contesto.
Invece di affidarsi solo a ciò che il modello ha imparato durante l'addestramento o a ciò che entra nel contesto corrente, RAG recupera dinamicamente informazioni rilevanti da fonti esterne esattamente quando servono. Esploriamo RAG più nel dettaglio.
L'architettura RAG consiste in due componenti principali: un retriever che cerca informazioni rilevanti in basi di conoscenza esterne e un generatore (l'LLM) che produce risposte basate sia sulla query sia sul contesto recuperato.
Quando arriva una query, il retriever trova documenti pertinenti da database vettoriali o basi di conoscenza. I documenti recuperati vengono inseriti nella finestra di contesto, fornendo informazioni specifiche su cui ancorare la risposta.
I vantaggi di RAG includono la riduzione delle allucinazioni facendo riferimento a documenti reali, una migliore accuratezza accedendo a informazioni aggiornate oltre i dati di addestramento e l'integrazione di conoscenze proprietarie senza riaddestramento.
Le sfide includono possibili allucinazioni quando i documenti recuperati contengono errori, problemi di rilevanza se il retrieval restituisce informazioni poco utili e la complessità nella gestione di database vettoriali.
La vera potenza di RAG emerge quando consideriamo come affronta uno dei limiti più fondamentali discussi prima: i vincoli della finestra di contesto.
RAG estende il contesto oltre la dimensione della finestra recuperando selettivamente solo le informazioni rilevanti. Invece di mantenere l'intera cronologia della conversazione, la archivi esternamente e recuperi le parti pertinenti al bisogno, supportando una lunghezza di conversazione praticamente illimitata entro i vincoli della finestra di contesto.
Strategie per migliorare le finestre di contesto con RAG includono il retrieval ibrido che combina ricerca semantica e filtraggio per metadati, il reranking dei risultati recuperati per dare priorità ai documenti più rilevanti e il recupero ricorsivo in cui la risposta iniziale del modello guida ulteriori recuperi.
RAG rappresenta un approccio pratico e pronto per la produzione all'estensione della memoria, ma la comunità di ricerca continua a spingersi oltre con architetture innovative che ripensano alla radice la gestione della memoria da parte dei modelli.
Architetture innovative e sistemi ispirati alle neuroscienze stanno avanzando le capacità di memoria degli LLM. Questi approcci all'avanguardia ripensano la gestione delle informazioni a lungo contesto, andando oltre i limiti dei transformer tradizionali per creare sistemi di memoria più efficienti e simili a quelli umani.
Architetture come Mamba e i transformer con memoria ricorrente ottimizzano l'efficienza della memoria. Mamba utilizza modelli a spazio di stato invece dei meccanismi di attenzione, ottenendo una scalabilità lineare anziché quadratica con la lunghezza della sequenza, consentendo l'elaborazione di sequenze molto più lunghe con risorse comparabili.
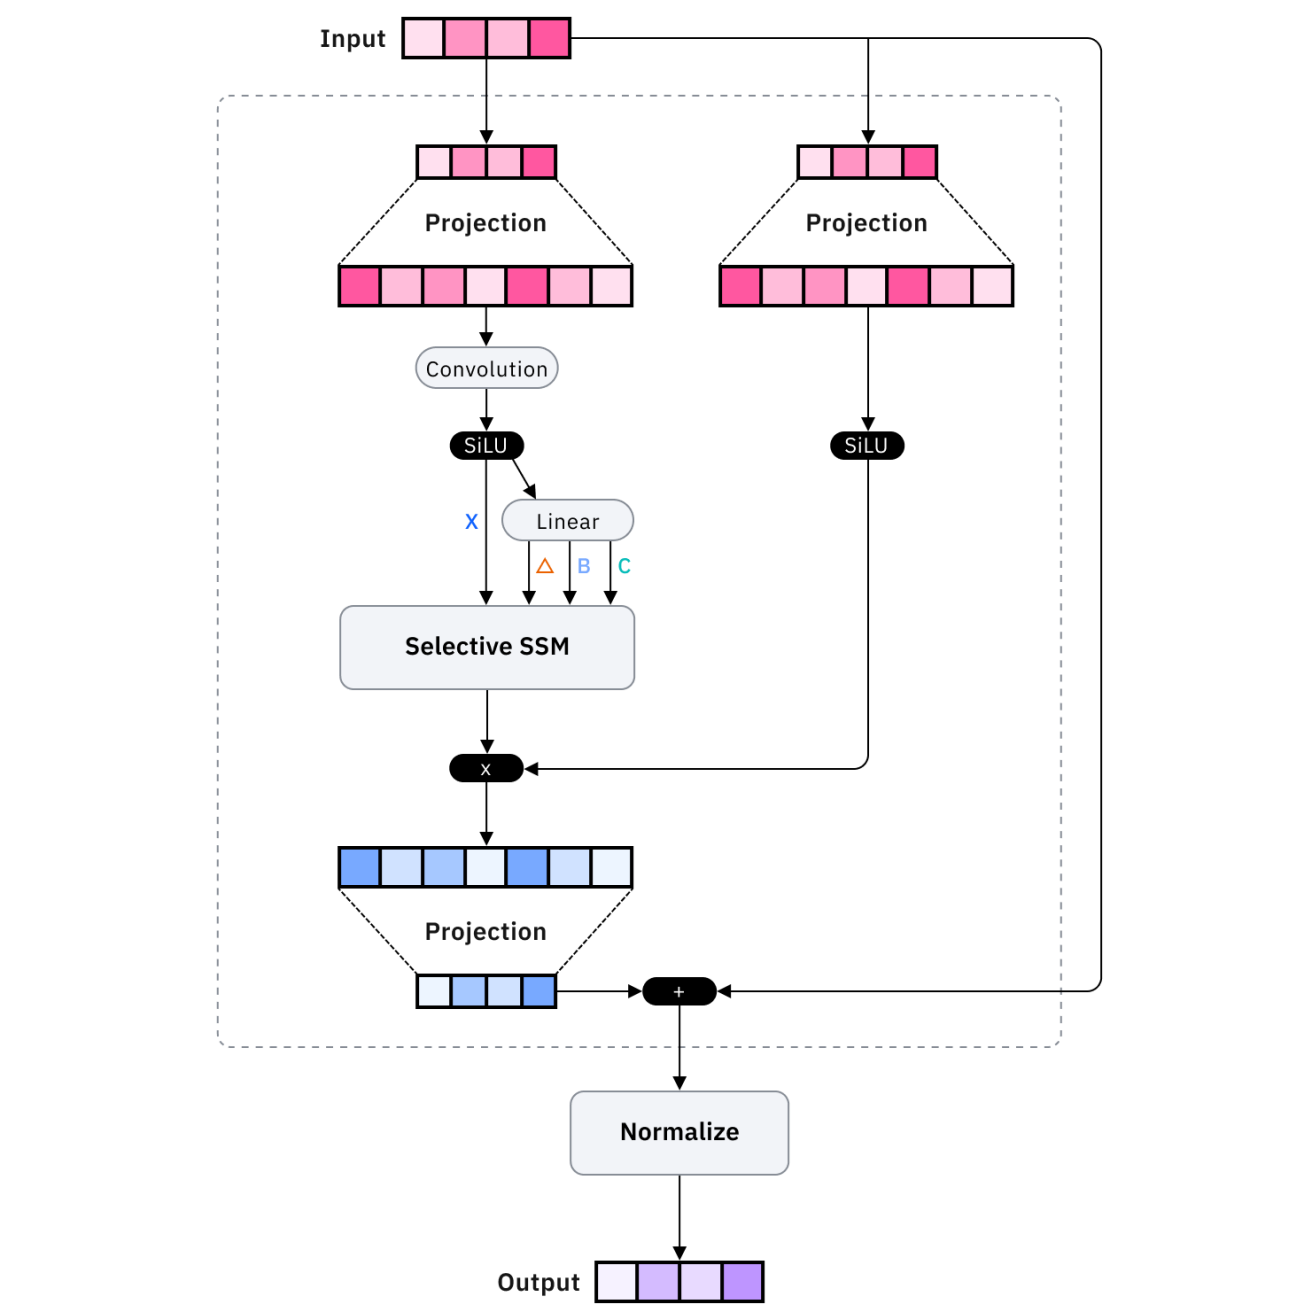
I transformer con memoria ricorrente potenziano i transformer standard con connessioni ricorrenti che mantengono uno stato a lungo termine, consentendo alle informazioni di persistere oltre la finestra di contesto immediata tramite meccanismi di memoria appresi.
Queste innovazioni architetturali sono affascinanti dal punto di vista della ricerca, ma per le soluzioni pronte alla produzione? Qui entrano in gioco le piattaforme di memoria esterna.
Piattaforme come Mem0 e Zep offrono soluzioni di memoria esterna pronte per la produzione. Mem0 fornisce un livello di memoria gestito che estrae, archivia e recupera automaticamente le informazioni rilevanti. Zep è incentrato sulla memoria conversazionale con sintesi integrate, estrazione di fatti e ricerca vettoriale.
Mentre queste piattaforme offrono soluzioni pratiche, alcuni ricercatori traggono ispirazione da una fonte inaspettata: come il cervello umano forma e gestisce i ricordi.
CAMELoT (Consolidated Associative Memory Enhanced Long Transformer) applica principi neuroscientifici alla memoria degli LLM, implementando consolidamento, rilevazione della novità e ponderazione della recenza. Questi principi rispecchiano i sistemi di memoria umani, creando un comportamento della memoria più naturale.
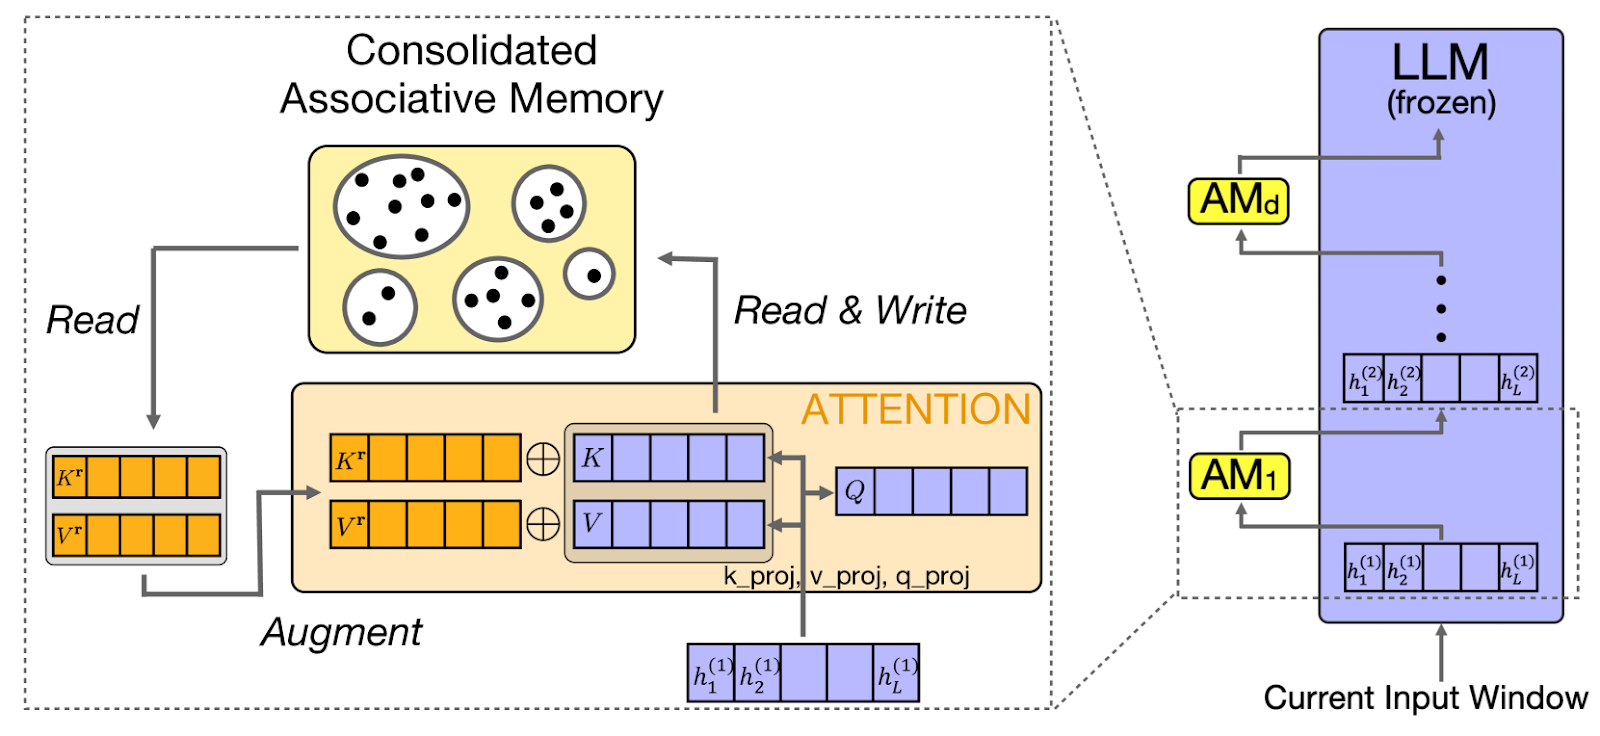
Basandosi su questi principi neuroscientifici, un altro approccio, come Laminar, si concentra specificamente su come gli esseri umani ricordano esperienze ed eventi distinti.
Larimar permette agli LLM di mantenere episodi di memoria distinti. Invece di trattare uniformemente tutte le informazioni passate, la memoria episodica struttura le informazioni in eventi discreti. Questo abilita la generalizzazione rispetto alla lunghezza del contesto. Il modello fa riferimento a episodi passati specifici senza caricare l'intera cronologia.
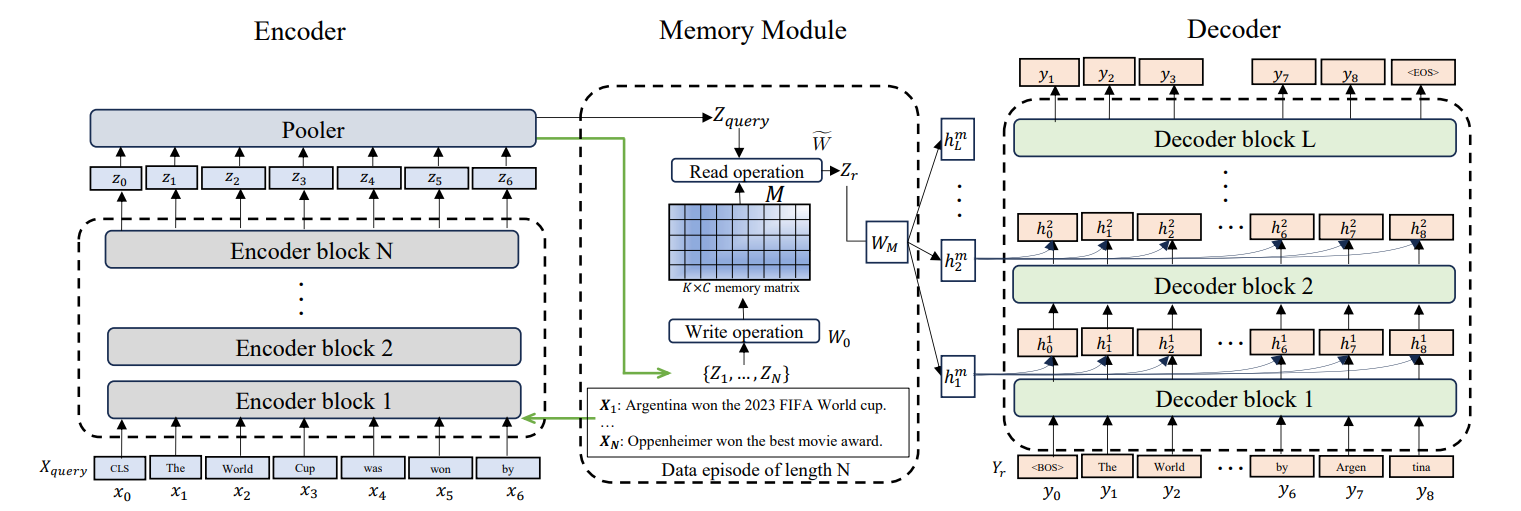
Queste architetture avanzate mostrano un enorme potenziale, ma introducono anche nuove complessità. Esaminiamo le sfide pratiche che sorgono nell'implementare sistemi di memoria e le strategie per superarle.
Anche con architetture sofisticate, ho riscontrato che i sistemi di memoria affrontano sfide che spesso richiedono una mitigazione attenta. Comprendere questi ostacoli e le relative soluzioni è fondamentale per costruire sistemi di produzione robusti e affidabili per gli utenti.
Il forgetting catastrofico si verifica quando i modelli perdono informazioni precedentemente apprese. Le soluzioni includono il consolidamento della memoria, il rafforzamento delle memorie importanti, gerarchie di memoria che preservano le informazioni critiche e un refresh periodico della memoria.
Oltre alla dimenticanza, un'altra sfida critica è quando i sistemi di memoria fuorviano attivamente il modello. Le allucinazioni (generare informazioni plausibili ma errate) sono aggravate da una memoria difettosa. La mitigazione prevede attribuzione delle fonti, punteggio di confidenza per le memorie recuperate e passaggi di verifica.
Infine, archiviare conversazioni e preferenze degli utenti solleva importanti questioni di privacy. Privacy e sicurezza sono cruciali quando si memorizzano dati degli utenti. Implementa crittografia dei dati, policy di conservazione che eliminino automaticamente i dati vecchi e controlli di accesso che garantiscano che gli utenti accedano solo alle proprie memorie.
Integrare la memoria richiede un'attenta progettazione delle API. I pattern principali includono l'integrazione stateful, in cui il sistema di memoria mantiene lo stato tra le richieste, e l'integrazione stateless, in cui ogni richiesta include gli identificatori necessari.
Una gestione efficiente della memoria impiega trimming (rimozione dei messaggi più vecchi o meno rilevanti), cancellazione (rimozione di elementi specifici) e sintesi (compressione dei messaggi). Questi pattern mantengono la memoria entro il budget preservando il contesto essenziale.
Capire questi pattern e sfide teoriche è utile, ma la vera prova è l'implementazione. Traduciamo questi concetti in linee guida pratiche che puoi applicare ai tuoi progetti.
Ecco alcuni dei modi in cui ho visto gli sviluppatori ottenere il massimo dai sistemi di memoria degli LLM.
Una gestione efficace del contesto inizia con la comprensione del tuo budget di token. Calcola quanti token richiedono il prompt di sistema, la memoria e la risposta, assicurandoti che la somma rientri nei limiti. Struttura i dati in modo gerarchico, posizionando le informazioni importanti dove il modello presta più attenzione— all'inizio o alla fine.
È altrettanto importante come prepari i dati prima che entrino nel tuo sistema di memoria. La preparazione dei dati conta molto. Suddividi i documenti grandi in blocchi semantici anziché secondo limiti arbitrari di token. Sovrapponi leggermente i blocchi per la continuità del contesto. Includi metadati con ogni blocco per abilitare il recupero filtrato.
Una volta che il sistema è in funzione, servono metodi per misurare se sta davvero funzionando. La valutazione della memoria richiede il tracciamento di metriche come accuratezza di richiamo, tasso di allucinazioni e soddisfazione degli utenti. Monitora la latenza del sistema di memoria, l'uso di token e la rilevanza del retrieval.
Infine, la tua strategia di retrieval dovrebbe adattarsi alla complessità delle richieste degli utenti. Strategie di recupero flessibili si adattano alla complessità delle query. Le query semplici usano la ricerca per keyword, mentre le domande complesse beneficiano della ricerca per similarità semantica. Implementa namespace di memoria per organizzare le informazioni per utente, argomento o periodo di tempo.
La memoria dei large language model trasforma questi modelli da generatori di testo senza stato in assistenti IA consapevoli del contesto, capaci di interazioni coerenti e personalizzate. In questo tutorial, ho esplorato i fondamenti della memoria negli LLM, dalle finestre di contesto alle architetture avanzate.
Penso che i punti chiave siano: iniziare con finestre di contesto e buffer di conversazione ben gestiti per le esigenze immediate, implementare RAG per un accesso scalabile alla conoscenza oltre la memoria parametrica, sfruttare piattaforme di memoria esterna per applicazioni in produzione e valutare continuamente l'efficacia della memoria tramite metriche e feedback degli utenti.
Man mano che le capacità degli LLM avanzano, i sistemi di memoria diventeranno sempre più sofisticati. Per chi li utilizza, concentrati sulla costruzione di sistemi di memoria che servano i bisogni degli utenti: mantenere il contesto rilevante, dimenticare quando opportuno e abilitare interazioni naturali che rendano davvero utili le applicazioni di IA.
Per continuare a imparare, ti consiglio di consultare le seguenti risorse:
I migliori corsi DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



