
कोर्स
Python में LLMs का परिचय
3 घंटा
36.5K
कई डेवलपर्स ऐसे चैटबॉट्स और AI असिस्टेंट बनाते हैं जो अकेले में प्रश्नों के शानदार उत्तर देते हैं, लेकिन सुसंगत बातचीत बनाए रखने में संघर्ष करते हैं। जड़ कारण? मेमोरी की कमी। जब कोई उपयोगकर्ता पहले के संदर्भ का हवाला देते हुए फॉलो-अप प्रश्न पूछता है, तो स्टेटलेस लैंग्वेज मॉडल उसे बिल्कुल नया मानते हैं, जिससे निराशाजनक, दोहरावदार इंटरैक्शन होते हैं।
प्राकृतिक और बुद्धिमान महसूस होने वाले AI एप्लिकेशन बनाने के लिए बड़े भाषा मॉडलों में मेमोरी को समझना और लागू करना महत्वपूर्ण है। मेमोरी LLMs को बातचीत के दौरान संदर्भ बनाए रखने, पिछली इंटरैक्शन से सीखने और वैयक्तिकृत उत्तर देने में सक्षम बनाती है। इस ट्यूटोरियल में, मैं आपको LLM मेमोरी की बुनियाद से लेकर उन्नत आर्किटेक्चर तक ले जाऊंगा—बेसिक संदर्भ विंडो से शुरुआत करते हुए।
यदि आप LLMs में नए हैं, तो मैं हमारे किसी कोर्स को लेने की सलाह देता/देती हूँ, जैसे Developing LLM Applications with LangChain, Developing Large Language Models, या LLMOps Concepts.
बड़े भाषा मॉडल पारंपरिक सॉफ्टवेयर से अलग ढंग से जानकारी प्रोसेस करते हैं। जहाँ डेटाबेस डेटा को स्पष्ट रूप से स्टोर और रिट्रीव करते हैं, वहीं LLMs को संदर्भ विंडो और टोकन सीमाओं जैसी आर्किटेक्चरल बाधाओं के भीतर मेमोरी मैनेज करनी होती है। चुनौती यह है कि मॉडल प्रासंगिक जानकारी को याद रखें और अनावश्यक विवरणों को भूलें, ताकि संगति बनी रहे और कंप्यूटेशनल संसाधनों पर बोझ न बढ़े।
इम्प्लीमेंटेशन विवरणों में जाने से पहले, आइए समझें कि बड़े भाषा मॉडलों के संदर्भ में मेमोरी का क्या अर्थ है और प्रभावी AI एप्लिकेशन बनाने में यह क्यों मायने रखती है।
LLMs में मेमोरी का मतलब सिस्टम की वह क्षमता है जिससे वह पिछली इंटरैक्शन या प्रशिक्षण डेटा से जानकारी को बनाए रखे और उपयोग करे। यह पारंपरिक कंप्यूटिंग वाली मेमोरी नहीं है। यह मॉडल की क्षमता है कि वह संदर्भ बनाए रखे, पिछले संवादों का संदर्भ दे, और सीखे हुए पैटर्न को नई स्थितियों पर लागू करे।
मेमोरी इसलिए महत्वपूर्ण है क्योंकि यह अलग-थलग प्रश्न-उत्तर जोड़ों को सुसंगत बातचीत में बदल देती है। बिना मेमोरी के, जब आप कहते हैं "उस बारे में और बताइए," तो LLM समझ ही नहीं सकता। संदर्भ की ज़रूरत होती है ताकि मॉडल रेफरेंस समझे और पिछली बातों पर आगे बढ़े।
मैं अक्सर LLM मेमोरी को मानव मेमोरी के समानांतर सोचता/सोचती हूँ। मनुष्यों में सेंसरी मेमोरी (तत्काल संवेदना), शॉर्ट-टर्म मेमोरी (सक्रिय जानकारी), और लॉन्ग-टर्म मेमोरी (संग्रहीत ज्ञान) होती है। LLMs में भी समान प्रणालियाँ हैं: संदर्भ विंडो शॉर्ट-टर्म मेमोरी की तरह काम करती है, रिट्रीव की गई जानकारी याद की गई लॉन्ग-टर्म मेमोरी की तरह, और प्रशिक्षित पैरामीटर स्थायी ज्ञान का प्रतिनिधित्व करते हैं।
अब जब मैंने LLMs में मेमोरी की मूल अवधारणा समझा दी है, तो आइए देखें कि आपकी विशिष्ट एप्लिकेशन के लिए सही दृष्टिकोण चुनने में मदद करने हेतु मेमोरी प्रणालियों का वर्गीकरण कैसे किया जाता है।
यह समझना कि मेमोरी का वर्गीकरण कैसे होता है, आपकी एप्लिकेशन के लिए सही दृष्टिकोण चुनने में मदद करता है। LLM मेमोरी को तीन प्रमुख आयामों—ऑब्जेक्ट, फॉर्म, और टाइम—के अनुसार वर्गीकृत किया जा सकता है।
ऑब्जेक्ट आयाम व्यक्तिगत मेमोरी और सिस्टम मेमोरी में अंतर करता है। व्यक्तिगत मेमोरी उपयोगकर्ता-विशिष्ट जानकारी जैसे प्राथमिकताएँ और बातचीत का इतिहास स्टोर करती है।
सिस्टम मेमोरी में सभी उपयोगकर्ताओं के लिए उपलब्ध सामान्य ज्ञान और क्षमताएँ होती हैं। उदाहरण के लिए, एक कस्टमर सर्विस बॉट उत्पाद जानकारी के लिए सिस्टम मेमोरी का उपयोग कर सकता है, जबकि प्रत्येक ग्राहक के ऑर्डर इतिहास के लिए व्यक्तिगत मेमोरी बनाए रख सकता है।
दूसरे आयाम की ओर बढ़ते हुए, फॉर्म आयाम पैरामीट्रिक और नॉन-पैरामीट्रिक मेमोरी को अलग करता है। पैरामीट्रिक मेमोरी मॉडल के वेट्स में प्रशिक्षण के दौरान एन्कोड होती है। नॉन-पैरामीट्रिक मेमोरी मॉडल के बाहर, डेटाबेस या वेक्टर स्टोर्स में स्टोर होती है। पैरामीट्रिक मेमोरी प्रशिक्षण के बाद स्थिर होती है, जबकि नॉन-पैरामीट्रिक मेमोरी को डायनेमिक रूप से अपडेट किया जा सकता है।
अंत में, टाइम आयाम अवधि के आधार पर मेमोरी को वर्गीकृत करता है: शॉर्ट-टर्म बनाम लॉन्ग-टर्म। शॉर्ट-टर्म मेमोरी मौजूदा बातचीत तक सीमित रहती है और संदर्भ विंडो में स्टोर होती है। लॉन्ग-टर्म मेमोरी सत्रों के बीच बनी रहती है, बाहरी रूप से स्टोर होती है और ज़रूरत पड़ने पर रिट्रीव की जाती है।
इस वर्गीकरण ढांचे को स्थापित करने के बाद, आइए देखें कि व्यवहार में LLMs किस प्रकार की मेमोरी लागू करते हैं।
विभिन्न मेमोरी प्रकार LLM एप्लिकेशन में अलग-अलग उद्देश्यों की पूर्ति करते हैं। इन प्रकारों को समझना आपकी विशिष्ट आवश्यकता के लिए प्रभावी मेमोरी आर्किटेक्चर डिजाइन करने में मदद करता है।
सेमांटिक मेमोरी तथ्यों और सामान्य ज्ञान को स्टोर करती है, जिसे सिस्टम एक्सेस और संदर्भित कर सकता है। जबकि मॉडलों के पास प्रशिक्षण से बुनियादी ज्ञान होता है, व्यवहार में सेमांटिक मेमोरी अक्सर बाहरी नॉलेज बेस, डेटाबेस, या दस्तावेज़ स्टोर्स को संदर्भित करती है जिनमें तथ्यात्मक जानकारी होती है।
उदाहरण के लिए, एक कस्टमर सर्विस बॉट वेक्टर डेटाबेस में उत्पाद विशिष्टताओं, मूल्य निर्धारण जानकारी, और कंपनी नीतियों को सेमांटिक मेमोरी के रूप में स्टोर कर सकता है। इससे सिस्टम संभावित रूप से पुराने प्रशिक्षण डेटा पर निर्भर रहने के बजाय सटीक, अप-टू-डेट तथ्यों को रिट्रीव और संदर्भित कर सकता है। सेमांटिक मेमोरी आमतौर पर बाहरी रूप से स्टोर होती है और ज़रूरत पड़ने पर रिट्रीव की जाती है, जिससे इसे अपडेट और मेंटेन करना आसान होता है।
जहाँ सेमांटिक मेमोरी तथ्यों और ज्ञान से संबंधित है, वहीं एपिसोडिक मेमोरी विशिष्ट अनुभवों पर केंद्रित होती है। एपिसोडिक मेमोरी पिछली इंटरैक्शन, कौन से प्रश्न पूछे गए, मॉडल ने कैसे उत्तर दिया, और उन आदान-प्रदानों के संदर्भ को कैप्चर करती है।
एपिसोडिक मेमोरी मॉडल को बातचीत के पहले के हिस्सों का स्वाभाविक रूप से संदर्भ देने में सक्षम बनाती है, जैसे "जैसा कि हमने पहले चर्चा की थी" या "आपके प्रोजेक्ट के बारे में जो आपने बताया उसके आधार पर"। इस प्रकार की मेमोरी आमतौर पर नॉन-पैरामीट्रिक होती है, जिसे बातचीत के बफर्स या डेटाबेस में स्टोर किया जाता है।
प्रोसीजरल मेमोरी सिस्टम निर्देशों और सीखी गई प्रक्रियाओं को समाहित करती है। इसमें सिस्टम प्रॉम्प्ट शामिल है जो AI के व्यवहार को परिभाषित करता है, प्रतिक्रिया देने के दिशा-निर्देश, और कार्य-विशिष्ट निर्देश।
जब आप किसी मॉडल को "हमेशा बुलेट पॉइंट्स में जवाब दें" या "रचनात्मकता से अधिक सटीकता को प्राथमिकता दें" के लिए कॉन्फ़िगर करते हैं, तो आप प्रोसीजरल मेमोरी सेट कर रहे होते हैं। यह इस बात को आकार देती है कि मॉडल जानकारी को कैसे प्रोसेस और जवाब देता है, न कि वह क्या जानता है।
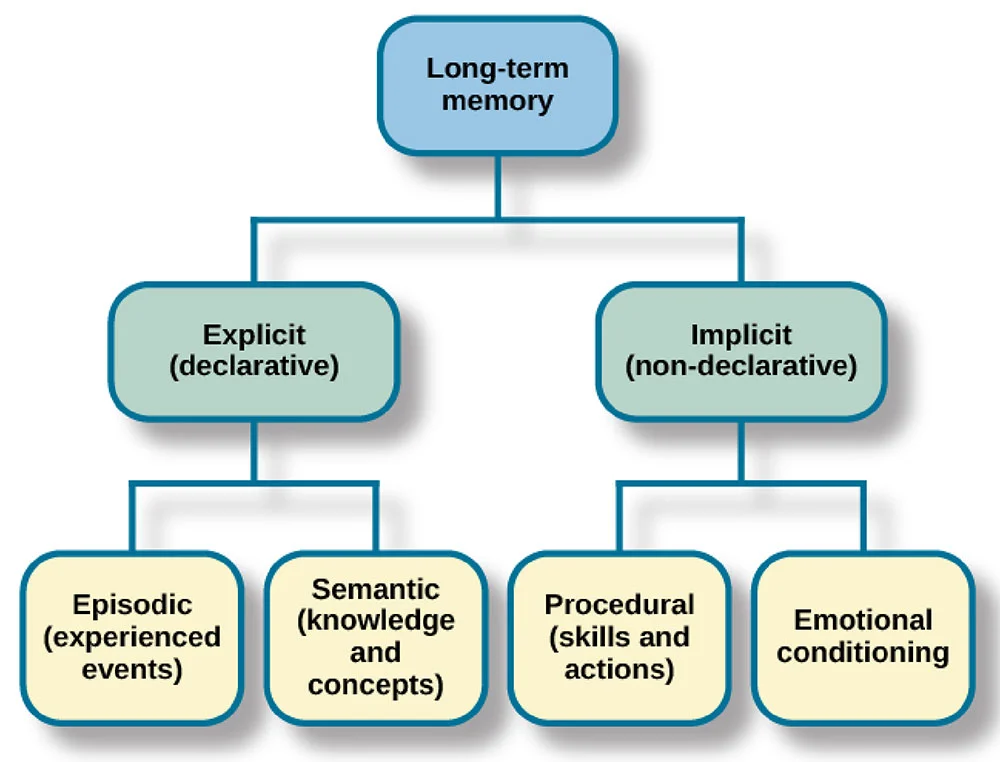
इन बुनियादी मेमोरी प्रकारों से परे, व्यावहारिक इम्प्लीमेंटेशन—खासतौर पर LangChain जैसे फ्रेमवर्क्स में—बातचीत संबंधी मेमोरी के कई रूप प्रदान करते हैं।
ConversationBufferMemory सभी संदेशों को पूर्ण रूप में स्टोर करती है, संपूर्ण बातचीत इतिहास बनाए रखती है—उन छोटी बातचीतों के लिए आदर्श जहाँ आपको पूरा संदर्भ चाहिए। ConversationSummaryMemory पिछली इंटरैक्शन को सारांशों में संपीड़ित करती है, जिससे लंबे संवादों के लिए प्रमुख जानकारी बनाए रखते हुए टोकन उपयोग कम होता है। ConversationBufferWindowMemory केवल सबसे हाल के N संदेश रखती है, एक स्लाइडिंग विंडो संदर्भ बनाते हुए—जब केवल ताज़ा आदान-प्रदान महत्वपूर्ण हो। ConversationSummaryBufferMemory दृष्टिकोणों को मिलाती है—हालिया संदेशों को यथावत रखकर और पुराने आदान-प्रदान का सारांश बनाकर—विवरण और दक्षता के बीच संतुलन प्रदान करती है। हर रूप पूर्णता और दक्षता के बीच समझौता करता है, जिससे आप अपनी एप्लिकेशन की आवश्यकताओं के अनुसार चुन सकें।इन मेमोरी प्रकारों को समझना आवश्यक है, पर वे सभी एक बुनियादी बाधा—संदर्भ विंडो—के भीतर काम करते हैं। आइए देखें कि यह आर्किटेक्चरल सीमा मेमोरी इम्प्लीमेंटेशन को कैसे आकार देती है।
मेरे विचार में LLM मेमोरी के प्रमुख पहलुओं में से एक संदर्भ विंडो की अवधारणा है। आइए संक्षेप में देखें कि वे कैसे काम करती हैं।
संदर्भ विंडो वह अधिकतम टेक्स्ट मात्रा है, जिसे टोकन में मापा जाता है, जिसे कोई LLM एक ही अनुरोध में प्रोसेस कर सकता है। टोकन टेक्स्ट के टुकड़े होते हैं, जो मोटे तौर पर शब्दों या सबवर्ड्स के अनुरूप होते हैं।
संदर्भ विंडो मॉडल की तात्कालिक कार्यशील मेमोरी की तरह काम करती है। जो कुछ भी मॉडल विचार करता है, वह इसी विंडो में फिट होना चाहिए: सिस्टम प्रॉम्प्ट, बातचीत का इतिहास, रिट्रीव किए गए दस्तावेज़, और उत्तर के लिए स्थान। जैसे-जैसे बातचीत बढ़ती है, पुराने संदेशों को नए के लिए हटाना पड़ता है।
संदर्भ विंडो का आकार काफी भिन्न होता है। उदाहरण के लिए, GPT-5 400,000 टोकन सपोर्ट करता है, Claude 4.5 Sonnet 200,000 टोकन संभालता है, और Gemini 3 Pro 1.5 मिलियन टोकन तक विस्तारित है। बड़ी विंडो समृद्ध संदर्भ सक्षम करती हैं, लेकिन कंप्यूटेशनल लागत को वर्गानुपाती रूप से बढ़ाती हैं।
हालाँकि बड़ी संदर्भ विंडो सुनने में आदर्श लगती हैं, वे वास्तविक दुनिया में डिप्लॉयमेंट को प्रभावित करने वाली महत्वपूर्ण व्यावहारिक चुनौतियाँ लाती हैं।
मेरे अनुभव में, संदर्भ विंडो की सबसे बड़ी समस्या "बीच में खो जाना" है। शोध से पता चलता है कि LLMs संदर्भ विंडो की शुरुआत और अंत की जानकारी पर बेहतर ध्यान देते हैं, जबकि बीच की सामग्री को कम ध्यान मिलता है। केवल संदर्भ में जानकारी ठूँस देने से प्रभावी उपयोग की गारंटी नहीं मिलती।
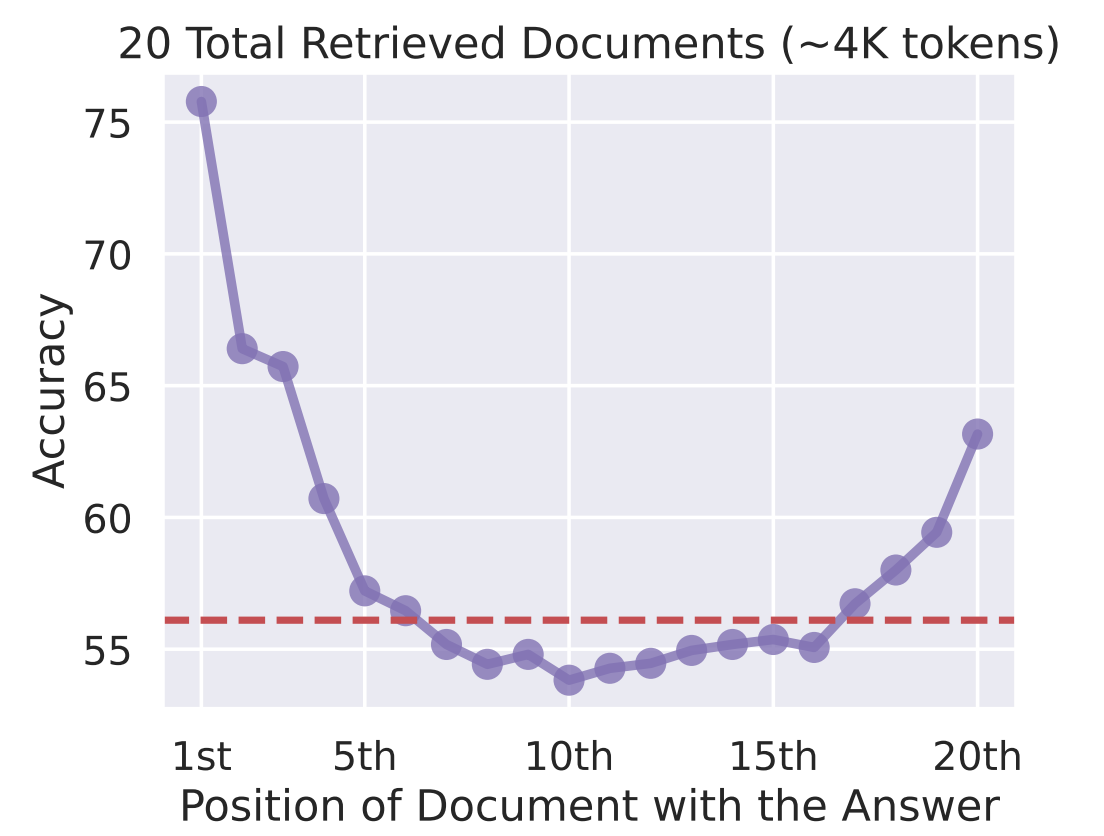
उत्तर वाले दस्तावेज़ की स्थिति बनाम सटीकता
कंप्यूटेशनल बाधाओं के कारण संदर्भ विंडो का विस्तार महंगा हो जाता है। 100,000-टोकन संदर्भ को प्रोसेस करना 10,000-टोकन संदर्भ की तुलना में कहीं अधिक GPU मेमोरी और समय मांगता है।
प्रोडक्शन एप्लिकेशंस के लिए ये लागतें तेजी से जुड़ती हैं, जिससे केवल प्रासंगिक जानकारी शामिल करने वाली बुद्धिमान मेमोरी प्रणालियों की आवश्यकता बढ़ती है।
इन बाधाओं को देखते हुए, समाधान केवल संदर्भ विंडो बढ़ाना नहीं है, बल्कि ऐसे स्मार्ट सिस्टम बनाना है जो उनका कुशलतापूर्वक उपयोग करें।
प्रभावी LLM एप्लिकेशन संदर्भ विंडो को ऐसी मेमोरी प्रणालियों के साथ जोड़ते हैं जो तात्कालिक संदर्भ से परे तक फैली हों। पैटर्न में शॉर्ट-टर्म, उच्च-प्राथमिकता जानकारी के लिए संदर्भ विंडो का उपयोग करना शामिल होता है, जबकि लॉन्ग-टर्म मेमोरी बाहरी रूप से स्टोर करके ज़रूरत पर चुनिंदा रूप से रिट्रीव की जाती है।
एक सामान्य आर्किटेक्चर संदर्भ विंडो में हालिया बातचीत टर्न्स को बनाए रखता है, पुरानी बातचीत को डेटाबेस में स्टोर करता है, और आवश्यकता पड़ने पर प्रासंगिक पुरानी जानकारी वापस लाने के लिए रिट्रीवल तंत्र का उपयोग करता है। यह पूर्णता, दक्षता, और प्रदर्शन के बीच संतुलन बनाता है।
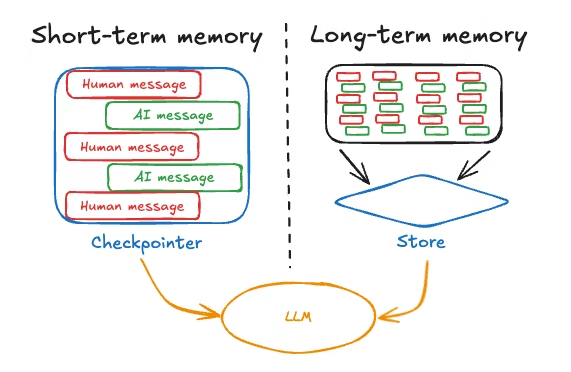
इस आर्किटेक्चरल समझ के साथ, आइए देखें कि इन बाधाओं के भीतर काम करने वाली प्रभावी शॉर्ट-टर्म मेमोरी प्रणालियाँ कैसे लागू करें।
शॉर्ट-टर्म मेमोरी सिस्टम मौजूदा सत्र के भीतर जानकारी को मैनेज करते हैं, मुख्यतः संदर्भ विंडो का लाभ उठाते हुए। मैं इसे मॉडल की कार्यशील मेमोरी मानता/मानती हूँ—वह जानकारी जिसे वह वर्तमान बातचीत को प्रोसेस करते समय सक्रिय रूप से थामे रहता है।
आइए देखें कि इस सीमित लेकिन अहम मेमोरी स्पेस का अधिकतम उपयोग कैसे करें।
इन-कॉन्टेक्स्ट लर्निंग का मतलब है कि मॉडल प्रॉम्प्ट में दिए गए उदाहरणों या निर्देशों के आधार पर व्यवहार को अपनाता है। आप मॉडल को फाइन-ट्यूनिंग के बजाय संदर्भ विंडो के भीतर उदाहरण दिखाकर सिखाते हैं कि क्या करना है।
तरीका सीधा है:
इस दृष्टिकोण के लाभों में शामिल हैं:
सीमाएँ: बहुत अधिक उदाहरण होने पर "बीच में खो जाना" समस्या के कारण असर घटता है, टोकन लागत बढ़ती है, और प्रदर्शन शायद ही फाइन-ट्यून मॉडल्स की बराबरी करता है।
इन-कॉन्टेक्स्ट लर्निंग दिखाती है कि शॉर्ट-टर्म मेमोरी से क्या संभव है, पर जानकारी वास्तव में मॉडल के उपयोग के लिए स्टोर कैसे होती है? आइए मेमोरी निर्माण के पीछे के तंत्र को देखें।
LLM सिस्टम में मेमोरी का निर्माण सचेत (एक्सप्लिसिट) या अवचेतन (इम्प्लिसिट) हो सकता है।
कई फ्रेमवर्क स्वतः बातचीत बफर्स बनाए रखते हैं, बिना स्पष्ट ऑपरेशंस के इम्प्लिसिट मेमोरी बना देते हैं। चुनौती इस संचय का प्रबंधन करना है—यह सुनिश्चित करना कि प्रासंगिक जानकारी बनी रहे जबकि कम महत्वपूर्ण विवरणों को छाँटा जाए।
शॉर्ट-टर्म मेमोरी तात्कालिक बातचीत की जरूरतें संभालती है, लेकिन जब आपको जानकारी मौजूदा सत्र से परे बनाए रखनी हो तो क्या करें? यहीं लॉन्ग-टर्म मेमोरी समाधान आवश्यक हो जाते हैं।
लॉन्ग-टर्म मेमोरी LLMs को सत्रों के बीच जानकारी बनाए रखने में सक्षम बनाती है।
जहाँ शॉर्ट-टर्म मेमोरी क्षणभंगुर होती है और बातचीत खत्म होते ही गायब हो जाती है, वहीं लॉन्ग-टर्म मेमोरी बनी रहती है—आपके AI को समय के साथ उपयोगकर्ता प्राथमिकताएँ, पिछली इंटरैक्शन, और संचित ज्ञान याद रखने देती है।
मैं दो प्रमुख दृष्टिकोणों पर प्रकाश डालूँगा/डालूँगी: टेक्स्ट-आधारित मेमोरी सिस्टम जो जानकारी को बाहरी रूप से स्टोर करते हैं, और की-वैल्यू कैशिंग जो मॉडल द्वारा पहले से कंप्यूट की गई जानकारी तक पहुँच को अनुकूलित करती है।
टेक्स्ट-आधारित मेमोरी बातचीत का इतिहास और उपयोगकर्ता जानकारी को डेटाबेस या वेक्टर स्टोर्स में स्टोर करती है। अधिग्रहण में प्रासंगिक जानकारी, प्राथमिकताएँ, निर्णय, तथ्य, या संदर्भ विवरण कैप्चर करना शामिल है।
मेमोरी प्रबंधन के लिए संपीड़न और संगठन आवश्यक हैं। सारांशण तकनीकें बातचीत को मुख्य बिंदुओं में संपीड़ित करती हैं। पदानुक्रमित संगठन यादों को विषय, समय अवधि, या प्रासंगिकता के अनुसार संरचित करता है।
उपयोग का केंद्र बिंदु रिट्रीवल है। वेक्टर समानता खोज सेमांटिक अर्थ द्वारा प्रासंगिक यादें ढूँढती है। समय-आधारित रिट्रीवल हाल की जानकारी को प्राथमिकता देती है। प्रासंगिकता स्कोरिंग यादों को महत्ता के आधार पर रैंक करती है।
टेक्स्ट-आधारित सिस्टम यह संभालते हैं कि क्या स्टोर करना है, लेकिन रिट्रीवल को अधिक कुशल कैसे बनाया जाए—यह प्रश्न भी है। यहीं की-वैल्यू कैशिंग काम आती है।
की-वैल्यू (KV) कैशिंग टोकन जेनरेशन की दक्षता बढ़ाती है। टेक्स्ट जेनरेशन के दौरान, मॉडल सभी पिछले टोकनों पर अटेंशन कंप्यूट करता है। KV कैशिंग इन मध्यवर्ती गणनाओं को स्टोर करती है, जिससे बाद के टोकन जेनरेट करते समय बिना पुनर्गणना के उनका पुन: उपयोग हो सके।
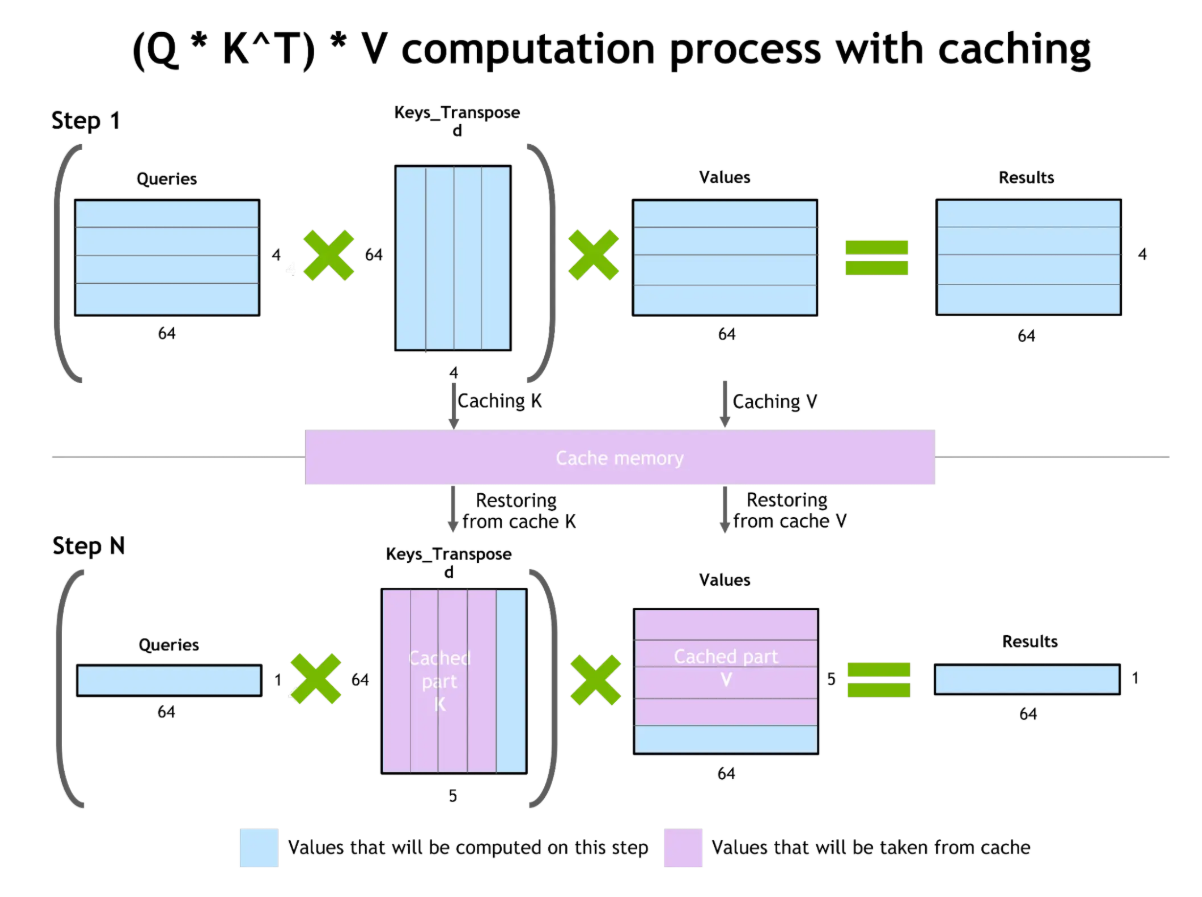
की-वैल्यू कैशिंग और अटेंशन ऑप्टिमाइज़ेशन
लाभ महत्वपूर्ण है: कम कंप्यूटेशनल लागत, तेज़ प्रतिक्रियाएँ, और कम संसाधन उपयोग। हालाँकि, कैश्ड की-वैल्यू पेयर्स GPU VRAM का उपभोग करते हैं। बहुत लंबे संदर्भों के लिए, KV कैश का आकार एक बाधा बन जाता है।
KV कैशिंग संदर्भ विंडो के उपयोग को अनुकूलित करती है, लेकिन सीमित मेमोरी क्षमता की बुनियादी समस्या का समाधान नहीं करती। यहीं रिट्रीवल-ऑगमेंटेड जेनरेशन एक पूरक दृष्टिकोण प्रदान करती है।
हाल के जिन विकासों को मैं सबसे रोचक पाता/पाती हूँ, उनमें से एक है रिट्रीवल-ऑगमेंटेड जेनरेशन या RAG। RAG आंतरिक और बाहरी मेमोरी के बीच पुल बनाता है, किसी LLM की मेमोरी को संदर्भ विंडो की सीमाओं से आगे बढ़ाते हुए।
प्रशिक्षण में सीखी बातों या मौजूदा संदर्भ में फिट होने वाली जानकारी पर ही निर्भर रहने के बजाय, RAG ज़रूरत पड़ने पर बाहरी स्रोतों से प्रासंगिक जानकारी डायनेमिक रूप से खींचता है। आइए RAG को विस्तार से समझें।
RAG आर्किटेक्चर दो मुख्य घटकों से बना होता है: एक रिट्रीवर जो बाहरी नॉलेज बेस से प्रासंगिक जानकारी खोजता है और एक जेनरेटर (LLM) जो क्वेरी और रिट्रीव्ड संदर्भ दोनों के आधार पर उत्तर उत्पन्न करता है।
जब कोई क्वेरी आती है, तो रिट्रीवर वेक्टर डेटाबेस या नॉलेज बेस से प्रासंगिक दस्तावेज़ ढूँढता है। रिट्रीव्ड दस्तावेज़ों को संदर्भ विंडो में इंजेक्ट किया जाता है, जिससे उत्तर को ग्राउंड करने के लिए विशिष्ट जानकारी मिलती है।
RAG के लाभों में हेलुसिनेशन्स में कमी (क्योंकि वास्तविक दस्तावेज़ों का संदर्भ होता है), सटीकता में सुधार (प्रशिक्षण डेटा से परे अप-टू-डेट जानकारी तक पहुँच), और बिना पुनःप्रशिक्षण के स्वामित्व-ज्ञान का समावेश शामिल हैं।
हालाँकि, चुनौतियों में यह संभावना शामिल है कि यदि रिट्रीव्ड दस्तावेज़ों में त्रुटियाँ हों तो हेलुसिनेशन बढ़ सकते हैं, यदि रिट्रीवल अनुपयोगी जानकारी लौटाए तो प्रासंगिकता समस्याएँ, और वेक्टर डेटाबेस का प्रबंधन जटिल होना।
RAG की वास्तविक शक्ति तब स्पष्ट होती है जब हम देखते हैं कि यह पहले बताई गई एक बुनियादी सीमा—संदर्भ विंडो बाधाओं—को कैसे संबोधित करता है।
RAG केवल प्रासंगिक जानकारी को चुनिंदा रूप से रिट्रीव करके संदर्भ को विंडो आकार से आगे तक बढ़ाता है। पूरी बातचीत का इतिहास बनाए रखने के बजाय, आप उसे बाहरी रूप से स्टोर करते हैं और ज़रूरत पड़ने पर प्रासंगिक हिस्सों को रिट्रीव करते हैं—इस तरह संदर्भ विंडो की सीमाओं के भीतर प्रभावी रूप से असीमित बातचीत लंबाई समर्थित होती है।
संदर्भ विंडो को बेहतर करने की रणनीतियों में हाइब्रिड रिट्रीवल (सेमांटिक सर्च के साथ मेटाडेटा फ़िल्टरिंग), रीरैंकिंग (प्रासंगिक दस्तावेज़ों को प्राथमिकता देना), और रिकर्सिव रिट्रीवल (जहाँ मॉडल की प्रारंभिक प्रतिक्रिया आगे की रिट्रीवल का मार्गदर्शन करती है) शामिल हैं।
RAG मेमोरी एक्सटेंशन के लिए एक व्यावहारिक, प्रोडक्शन-रेडी दृष्टिकोण प्रस्तुत करता है, पर शोध समुदाय नई आर्किटेक्चर्स के साथ सीमाएँ आगे बढ़ा रहा है जो बुनियादी स्तर पर मॉडल की मेमोरी हैंडलिंग को फिर से परिभाषित करते हैं।
नई आर्किटेक्चर और न्यूरोसाइंस-प्रेरित सिस्टम LLM मेमोरी क्षमताओं को आगे बढ़ा रहे हैं। ये अत्याधुनिक दृष्टिकोण पारंपरिक ट्रांसफॉर्मर सीमाओं से आगे बढ़कर लंबे संदर्भ की जानकारी को संभालने के अधिक कुशल और मानव-सदृश मेमोरी सिस्टम की कल्पना करते हैं।
Mamba और recurrent memory transformers जैसे आर्किटेक्चर मेमोरी दक्षता का अनुकूलन करते हैं। Mamba ध्यान तंत्र के बजाय स्टेट स्पेस मॉडल्स का उपयोग करता है, जिससे अनुक्रम लंबाई के साथ स्केलिंग वर्गानुपाती के बजाय रैखिक हो जाती है—उसी संसाधनों में बहुत लंबी अनुक्रमों को प्रोसेस करना संभव होता है।
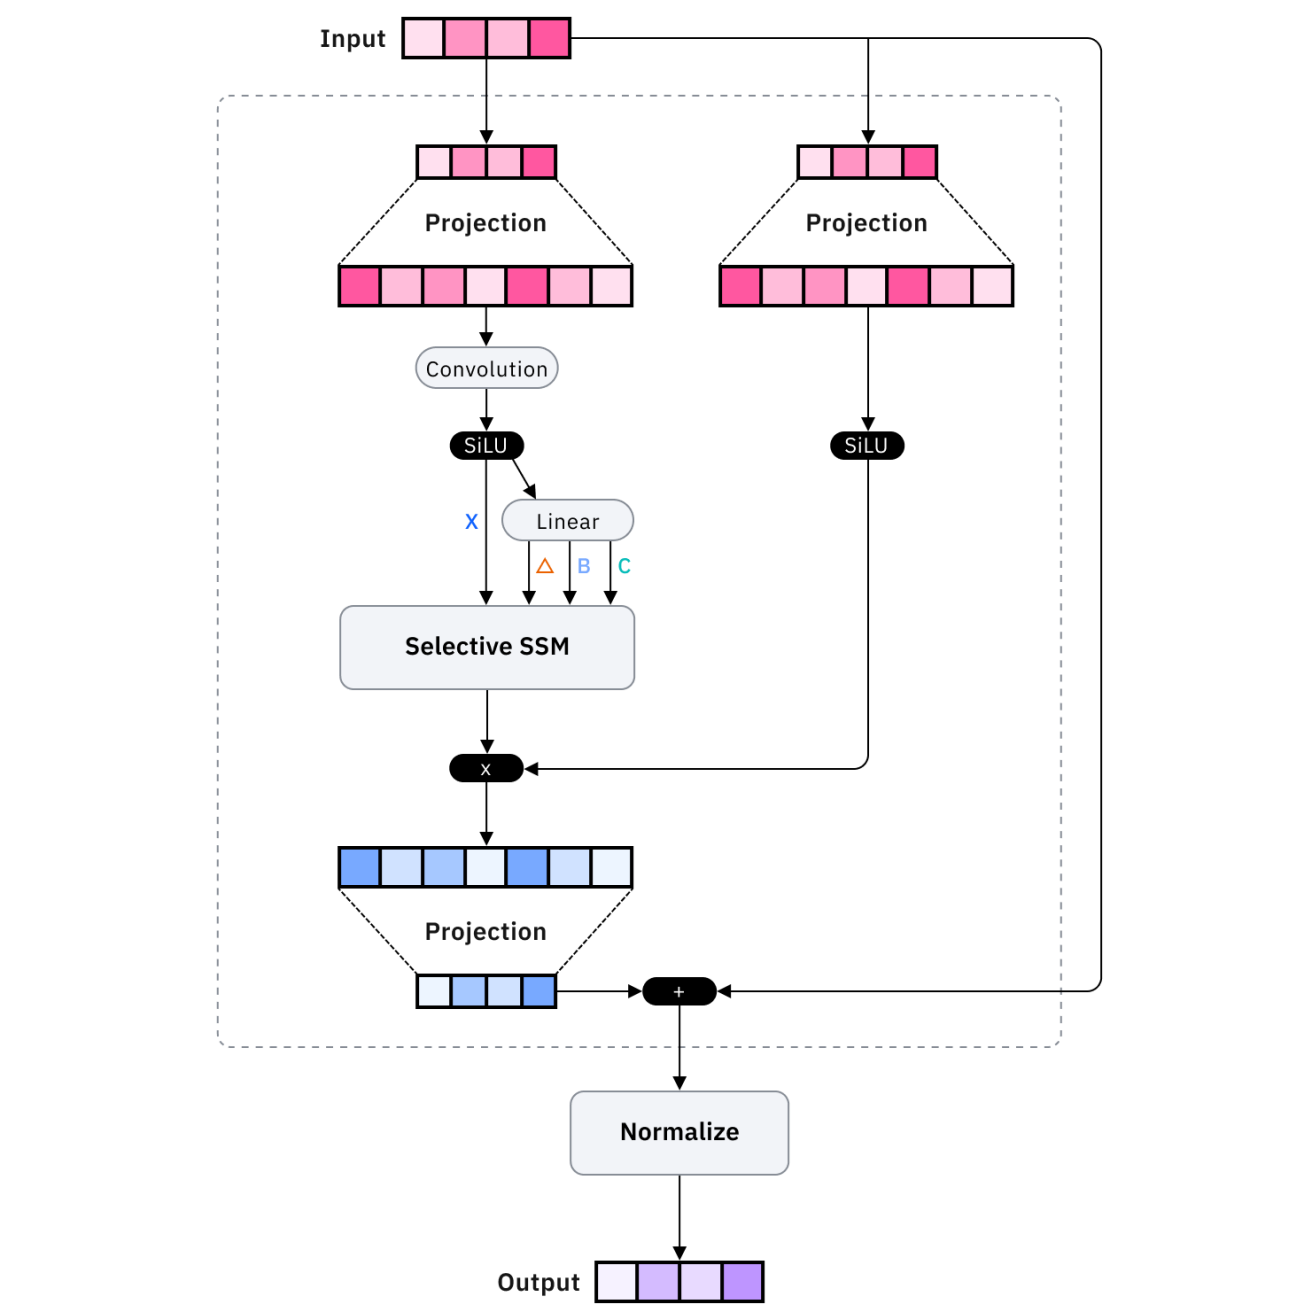
Recurrent memory transformers मानक ट्रांसफॉर्मर्स में recurrent कनेक्शंस जोड़ते हैं जो लॉन्ग-टर्म स्टेट बनाए रखते हैं, जिससे सीखी हुई मेमोरी प्रणालियों के माध्यम से जानकारी तात्कालिक संदर्भ विंडो से परे बनी रह सके।
ये आर्किटेक्चरल नवाचार शोध परिप्रेक्ष्य से आकर्षक हैं, पर प्रोडक्शन-रेडी समाधान क्या हैं? यहीं बाहरी मेमोरी प्लेटफ़ॉर्म काम आते हैं।
Mem0 और Zep जैसे प्लेटफ़ॉर्म प्रोडक्शन-रेडी बाहरी मेमोरी समाधान प्रदान करते हैं। Mem0 एक मैनेज्ड मेमोरी लेयर प्रदान करता है जो स्वतः प्रासंगिक जानकारी को निकालता, स्टोर करता, और रिट्रीव करता है। Zep में बातचीत संबंधी मेमोरी पर फोकस है—बिल्ट-इन सारांशण, तथ्य निष्कर्षण, और वेक्टर सर्च के साथ।
जबकि ये प्लेटफ़ॉर्म व्यावहारिक समाधान देते हैं, कुछ शोधकर्ता प्रेरणा एक अनपेक्षित स्रोत से ले रहे हैं: मानव मस्तिष्क वास्तव में यादें कैसे बनाता और मैनेज करता है।
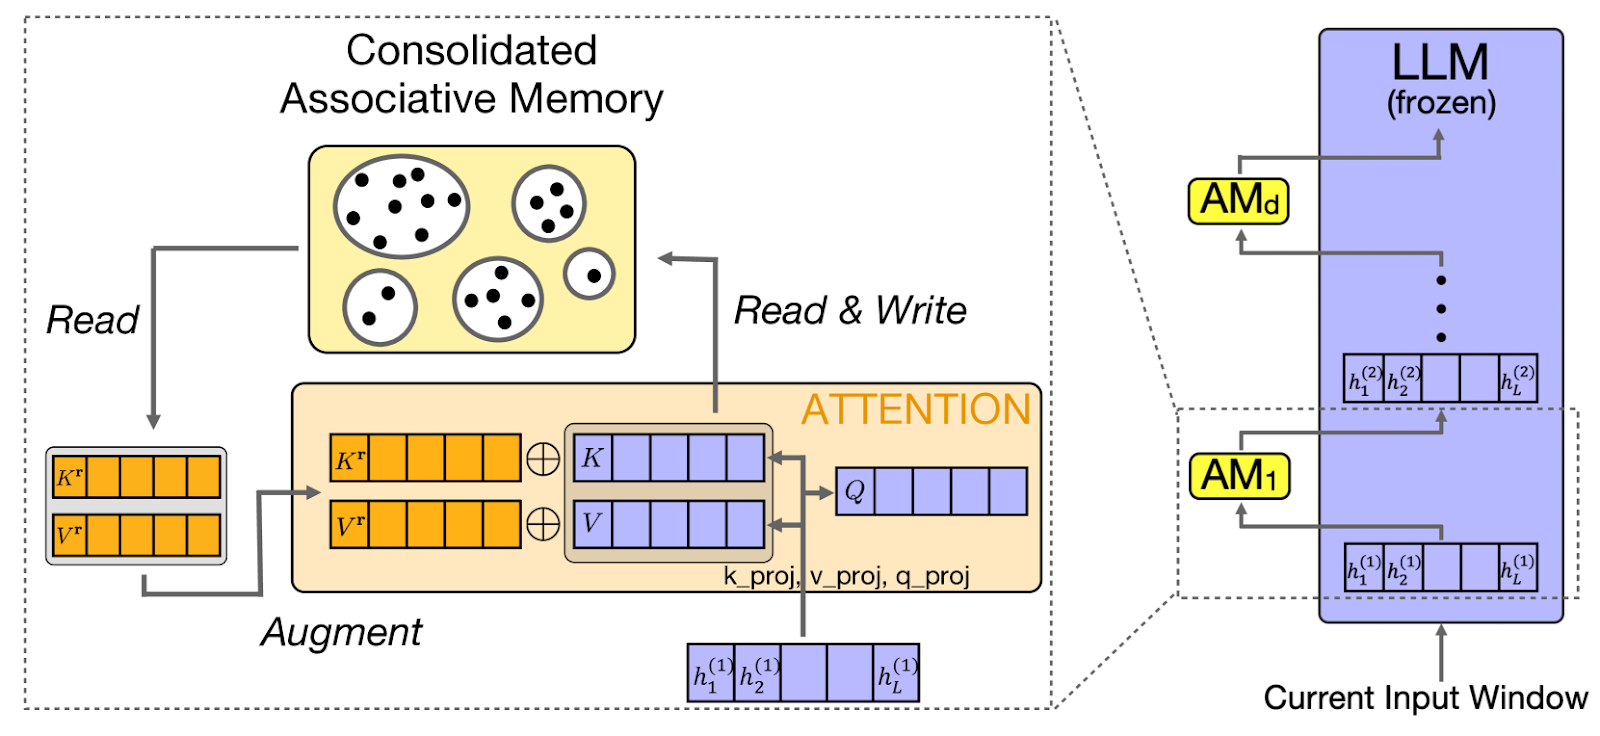
CAMELoT (Consolidated Associative Memory Enhanced Long Transformer) LLM मेमोरी में न्यूरोसाइंस सिद्धांत लागू करता है—कंसॉलिडेशन, नवीनता का पता लगाना, और हाल-फैक्टर वेटिंग। ये सिद्धांत मानव मेमोरी प्रणालियों को प्रतिबिंबित करते हैं, अधिक प्राकृतिक मेमोरी व्यवहार बनाते हुए।
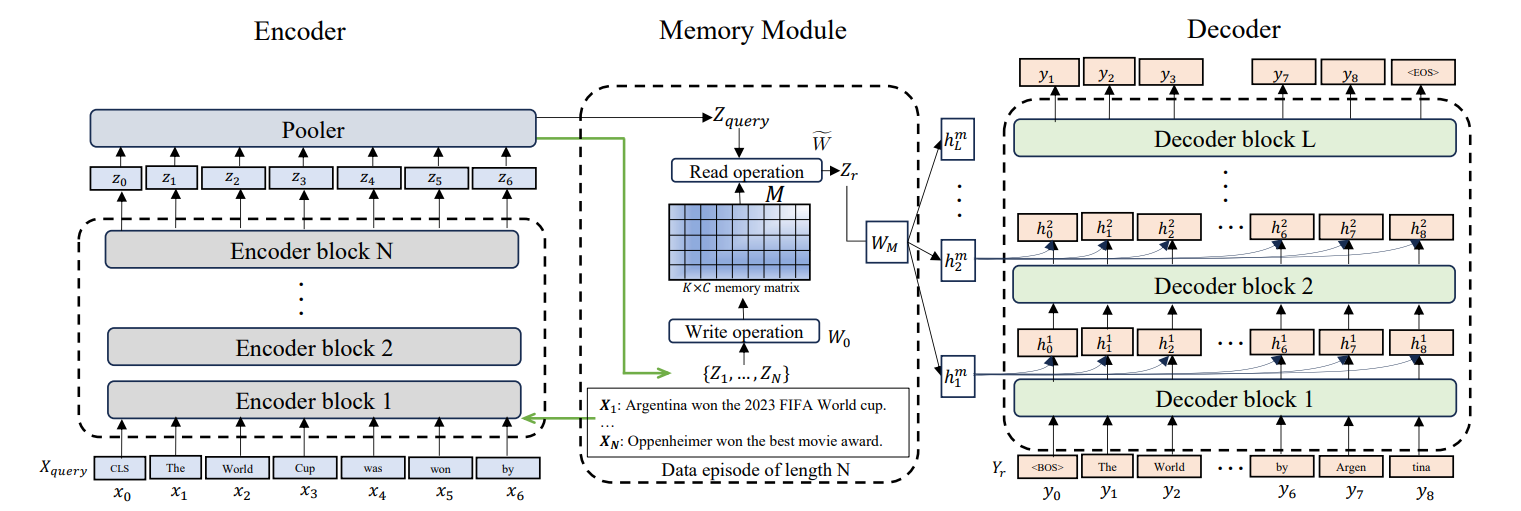
इन न्यूरोसाइंस सिद्धांतों पर निर्माण करते हुए, एक अन्य दृष्टिकोण, जैसे Laminar, विशेष रूप से इस पर केंद्रित है कि मनुष्य विशिष्ट अनुभवों और घटनाओं को कैसे याद रखते हैं।
Larimar LLMs को अलग-अलग मेमोरी एपिसोड्स बनाए रखने में सक्षम बनाता है। सभी पिछली जानकारी को समान रूप से ट्रीट करने के बजाय, एपिसोडिक मेमोरी जानकारी को अलग-अलग घटनाओं में संरचित करती है। यह संदर्भ लंबाई जनरलाइज़ेशन सक्षम करती है—मॉडल पूरी हिस्ट्री लोड किए बिना विशिष्ट पिछले एपिसोड्स का संदर्भ देता है।
ये उन्नत आर्किटेक्चर अपार संभावनाएँ दिखाते हैं, लेकिन वे नई जटिलताएँ भी लाते हैं। आइए देखें कि मेमोरी सिस्टम लागू करते समय कौन-सी व्यावहारिक चुनौतियाँ आती हैं और उन्हें दूर करने की रणनीतियाँ क्या हैं।
उन्नत आर्किटेक्चर होने के बावजूद, मैंने पाया है कि मेमोरी सिस्टम अक्सर ऐसी चुनौतियों का सामना करते हैं जिनके लिए सावधानीपूर्वक शमन की आवश्यकता होती है। इन बाधाओं और उनके समाधानों को समझना भरोसेमंद प्रोडक्शन सिस्टम बनाने के लिए महत्वपूर्ण है।
कैटास्ट्रॉफिक फॉरगेटिंग तब होती है जब मॉडल पहले से सीखी जानकारी खो देते हैं। समाधान में मेमोरी कंसॉलिडेशन (महत्वपूर्ण यादों को मजबूत करना), मेमोरी हायरेरकी (महत्वपूर्ण जानकारी को संरक्षित करना), और समय-समय पर मेमोरी रिफ्रेश शामिल हैं।
भूलने से परे, एक और महत्वपूर्ण चुनौती तब आती है जब मेमोरी सिस्टम मॉडल को गुमराह करते हैं। हेलुसिनेशन (विश्वसनीय लगने वाली परंतु गलत जानकारी उत्पन्न करना) त्रुटिपूर्ण मेमोरी से बढ़ सकता है। शमन में स्रोत एट्रिब्यूशन, रिट्रीव की गई यादों के लिए कॉन्फिडेंस स्कोरिंग, और सत्यापन चरण शामिल हैं।
अंततः, उपयोगकर्ता की बातचीत और प्राथमिकताओं को स्टोर करना महत्वपूर्ण गोपनीयता प्रश्न उठाता है। उपयोगकर्ता डेटा स्टोर करते समय गोपनीयता और सुरक्षा अनिवार्य हैं: डेटा एन्क्रिप्शन, रिटेंशन नीतियाँ जो पुराने डेटा को स्वतः पर्ज करती हैं, और एक्सेस कंट्रोल जो सुनिश्चित करते हैं कि उपयोगकर्ता केवल अपनी ही यादों तक पहुँचें।
मेमोरी इंटीग्रेट करने के लिए विचारशील API डिजाइन की आवश्यकता होती है। कोर पैटर्न में स्टेटफुल इंटीग्रेशन शामिल है, जहाँ मेमोरी सिस्टम अनुरोधों के बीच स्टेट बनाए रखता है, और स्टेटलेस इंटीग्रेशन, जहाँ प्रत्येक अनुरोध आवश्यक परिचयों (identifiers) के साथ आता है।
कुशल मेमोरी प्रबंधन में ट्रिमिंग (सबसे पुराने या कम प्रासंगिक संदेश हटाना), डिलीशन (विशिष्ट आइटम हटाना), और सारांशण (संदेशों को संपीड़ित करना) शामिल हैं। ये पैटर्न आवश्यक संदर्भ को संरक्षित रखते हुए मेमोरी को बजट में बनाए रखते हैं।
इन सैद्धांतिक पैटर्नों और चुनौतियों को समझना मूल्यवान है, पर असली परीक्षा इम्प्लीमेंटेशन में होती है। आइए इन अवधारणाओं को व्यावहारिक दिशानिर्देशों में बदलें जिन्हें आप अपने प्रोजेक्ट्स में लागू कर सकें।
यहाँ वे तरीके हैं जिनसे मैंने डेवलपर्स को LLM मेमोरी सिस्टम का सर्वोत्तम उपयोग करते देखा है।
प्रभावी संदर्भ प्रबंधन अपने टोकन बजट को समझने से शुरू होता है। गिनें कि आपका सिस्टम प्रॉम्प्ट, मेमोरी, और उत्तर कितने टोकन लेते हैं, और सुनिश्चित करें कि कुल सीमा के भीतर रहे। डेटा को पदानुक्रमित ढंग से संरचित करें—महत्वपूर्ण जानकारी वहाँ रखें जहाँ मॉडल सबसे अधिक ध्यान देता है—शुरुआत या अंत में।
उतना ही महत्वपूर्ण है कि मेमोरी सिस्टम में प्रवेश करने से पहले आप डेटा को कैसे तैयार करते हैं। डेटा तैयारी अत्यंत मायने रखती है। बड़े दस्तावेज़ों को मनमाने टोकन लिमिट्स की बजाय सेमांटिक खंडों में तोड़ें। संदर्भ निरंतरता के लिए खंडों में थोड़ा ओवरलैप रखें। प्रत्येक खंड के साथ मेटाडेटा जोड़ें ताकि फ़िल्टर्ड रिट्रीवल संभव हो।
एक बार आपका सिस्टम चलने लगे, तो आपको यह मापने के तरीके चाहिए कि यह वास्तव में काम कर रहा है या नहीं। मेमोरी मूल्यांकन के लिए रिकॉल एक्यूरेसी, हेलुसिनेशन दर, और उपयोगकर्ता संतुष्टि जैसी मीट्रिक्स ट्रैक करें। मेमोरी सिस्टम लेटेंसी, टोकन उपयोग, और रिट्रीवल प्रासंगिकता की निगरानी करें।
अंततः, आपकी रिट्रीवल रणनीति को उपयोगकर्ता प्रश्नों की जटिलता के अनुरूप ढलना चाहिए। लचीली रिट्रीवल रणनीतियाँ क्वेरी जटिलता के अनुसार अनुकूलित होती हैं—सरल क्वेरी के लिए कीवर्ड सर्च, जबकि जटिल प्रश्नों के लिए सेमांटिक समानता सर्च। उपयोगकर्ता, विषय, या समय अवधि के अनुसार जानकारी को व्यवस्थित करने के लिए मेमोरी नेमस्पेस लागू करें।
बड़े भाषा मॉडलों की मेमोरी इन मॉडलों को स्टेटलेस टेक्स्ट जेनरेटर से संदर्भ-संवेदनशील AI असिस्टेंट में बदल देती है जो सुसंगत, वैयक्तिकृत इंटरैक्शन करने में सक्षम हैं। इस ट्यूटोरियल में, मैंने संदर्भ विंडो से लेकर उन्नत आर्किटेक्चर्स तक LLM मेमोरी की बुनियाद की पड़ताल की है।
मेरे विचार से प्रमुख बातें हैं: तात्कालिक जरूरतों के लिए अच्छी तरह प्रबंधित संदर्भ विंडो और बातचीत बफर्स से शुरुआत करें; पैरामीट्रिक मेमोरी से परे स्केलेबल नॉलेज एक्सेस के लिए RAG लागू करें; प्रोडक्शन एप्लिकेशंस के लिए बाहरी मेमोरी प्लेटफ़ॉर्म का लाभ लें; और मीट्रिक्स व उपयोगकर्ता फीडबैक के माध्यम से मेमोरी की प्रभावशीलता का लगातार मूल्यांकन करें।
जैसे-जैसे LLM क्षमताएँ आगे बढ़ेंगी, मेमोरी प्रणालियाँ और भी परिष्कृत होंगी। व्यावहारिक दृष्टि से, ऐसे मेमोरी सिस्टम बनाने पर ध्यान दें जो उपयोगकर्ता आवश्यकताओं की सेवा करें: प्रासंगिक संदर्भ बनाए रखना, उपयुक्त रूप से भूलना, और स्वाभाविक इंटरैक्शन सक्षम करना—ताकि AI एप्लिकेशन सचमुच उपयोगी बनें।
सीखना जारी रखने के लिए, मैं निम्नलिखित संसाधनों को देखने की सलाह देता/देती हूँ:
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स