Veel ontwikkelaars bouwen chatbots en AI-assistents die op zichzelf staande vragen briljant kunnen beantwoorden, maar moeite hebben om samenhangende gesprekken te voeren. De oorzaak? Gebrek aan geheugen. Wanneer een gebruiker een vervolgvraag stelt die naar eerdere context verwijst, behandelen stateloze taalmodellen die als volledig nieuw, wat leidt tot frustrerende, repetitieve interacties.
Het begrijpen en implementeren van geheugen in large language models is cruciaal om AI-toepassingen te creëren die natuurlijk en intelligent aanvoelen. Geheugen stelt LLM’s in staat om context over gesprekken heen vast te houden, te leren van eerdere interacties en gepersonaliseerde reacties te geven. In deze tutorial neem ik je mee door de basis van LLM-geheugen, van eenvoudige contextvensters tot geavanceerde architecturen.
Als je nieuw bent met LLM’s, raad ik een van onze cursussen aan, zoals Developing LLM Applications with LangChain, Developing Large Language Models, of LLMOps Concepts.
Wat is LLM-geheugen?
Large language models verwerken informatie anders dan traditionele software. Waar databases expliciet data opslaan en ophalen, moeten LLM’s geheugen beheren binnen architecturale beperkingen zoals contextvensters en tokenlimieten. De uitdaging is om modellen relevante informatie te laten onthouden en onnodige details te laten vergeten, zodat samenhang behouden blijft zonder de rekenbronnen te overbelasten.
Voordat we in de implementatiedetails duiken, bepalen we eerst wat geheugen betekent in de context van large language models en waarom het belangrijk is voor effectieve AI-toepassingen.
De basis van geheugen in large language models
Geheugen in LLM’s verwijst naar het vermogen van het systeem om informatie uit eerdere interacties of trainingsdata vast te houden en te benutten. Dit is geen geheugen in de traditionele IT-zin. Het gaat om het vermogen van het model om context te behouden, naar eerdere uitwisselingen te verwijzen en geleerde patronen op nieuwe situaties toe te passen.
Geheugen is cruciaal omdat het losse vraag-antwoordparen verandert in samenhangende gesprekken. Zonder geheugen kan een LLM niet begrijpen wanneer je zegt: "vertel me daar meer over." Het model heeft context nodig om verwijzingen te interpreteren en voort te bouwen op eerdere uitwisselingen.
Ik denk vaak aan LLM-geheugen in analogie met menselijk geheugen. Mensen hebben sensorisch geheugen (directe waarneming), kortetermijngeheugen (actieve informatie) en langetermijngeheugen (opgeslagen kennis). LLM’s implementeren vergelijkbare systemen: contextvensters werken als kortetermijngeheugen, opgehaalde informatie fungeert als opgeroepen langetermijngeheugen, en getrainde parameters vertegenwoordigen permanente kennis.
Nu ik het basisconcept van geheugen in LLM’s heb behandeld, bekijken we hoe geheugensystemen worden geclassificeerd, zodat je de juiste aanpak voor jouw specifieke toepassing kunt kiezen.
De drie dimensies van LLM-geheugenclassificatie
Begrijpen hoe geheugen wordt geclassificeerd helpt bij het kiezen van de juiste aanpak voor je toepassing. LLM-geheugen kan langs drie kerndimensies worden ingedeeld: object, vorm en tijd.
Objectdimensie
De objectdimensie maakt onderscheid tussen persoonlijk geheugen en systeemgeheugen. Persoonlijk geheugen slaat gebruikersspecifieke informatie op, zoals voorkeuren en gespreksgeschiedenis.
Systeemgeheugen bevat algemene kennis en mogelijkheden die voor alle gebruikers beschikbaar zijn. Een klantenservicebot kan systeemgeheugen gebruiken voor productinformatie, terwijl persoonlijk geheugen de bestelgeschiedenis van elke klant bijhoudt.
Vormdimensie
De tweede dimensie, de vormdimensie, onderscheidt parametrisch van niet-parametrisch geheugen. Parametrisch geheugen wordt tijdens training in de modelgewichten gecodeerd. Niet-parametrisch geheugen bestaat buiten het model, opgeslagen in databases of vector stores. Parametrisch geheugen ligt vast na training, terwijl niet-parametrisch geheugen dynamisch kan worden bijgewerkt.
Tijdsdimensie
Tot slot categoriseert de tijdsdimensie geheugen naar duur: kortetermijn versus langetermijn. Kortetermijngeheugen beslaat het huidige gesprek en wordt in het contextvenster opgeslagen. Langetermijngeheugen blijft sessie-overstijgend bestaan, wordt extern opgeslagen en opgehaald wanneer nodig.
Met dit classificatiekader op zak bekijken we nu de specifieke typen geheugen die LLM’s in de praktijk implementeren.
Typen geheugen in LLM’s
Verschillende geheugentypen dienen verschillende doelen in LLM-toepassingen. Inzicht in deze typen helpt je effectieve geheugenarchitecturen te ontwerpen voor jouw specifieke use-case.
Semantisch geheugen
Semantisch geheugen slaat feiten en algemene kennis op die het systeem kan raadplegen en waarnaar het kan verwijzen. Hoewel modellen basiskennis hebben uit training, verwijst semantisch geheugen in de praktijk vaak naar externe kennisbanken, databases of documentopslag met feitelijke informatie.
Een klantenservicebot kan bijvoorbeeld semantisch geheugen hebben met productspecificaties, prijsinformatie en bedrijfsbeleid in een vector database. Zo kan het systeem accurate, up-to-date feiten ophalen en gebruiken zonder uitsluitend te vertrouwen op mogelijk verouderde trainingsdata. Semantisch geheugen wordt meestal extern opgeslagen en opgehaald wanneer nodig, waardoor het eenvoudig te updaten en te onderhouden is.
Episodisch geheugen
Waar semantisch geheugen over feiten en kennis gaat, richt episodisch geheugen zich op specifieke ervaringen. Episodisch geheugen legt eerdere interacties vast: welke vragen zijn gesteld, hoe het model reageerde en de context rond die uitwisselingen.
Episodisch geheugen stelt het model in staat om op natuurlijke wijze naar eerdere delen van het gesprek te verwijzen, met zinnen als "zoals we eerder bespraken" of "op basis van wat je me over je project vertelde." Dit type geheugen is doorgaans niet-parametrisch en wordt opgeslagen in conversatiebuffers of databases.
Procedureel geheugen
Procedureel geheugen omvat systeeminstructies en aangeleerde procedures. Dit omvat de systeemprompt die het gedrag van de AI bepaalt, richtlijnen voor hoe te reageren en taakspecifieke instructies.
Als je een model configureert om "altijd in opsommingstekens te antwoorden" of "nauwkeurigheid boven creativiteit te stellen", definieer je procedureel geheugen. Het bepaalt hoe het model informatie verwerkt en beantwoordt, in plaats van welke informatie het kent.
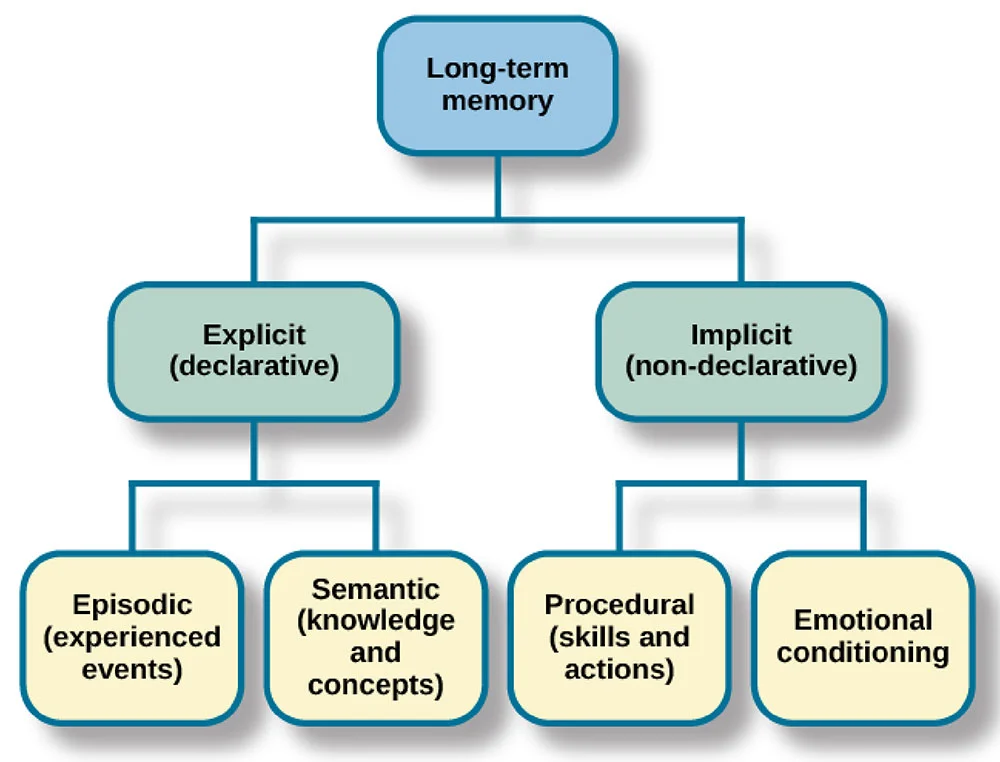
Types of Memories
Naast deze fundamentele geheugentypen bieden praktische implementaties, met name in frameworks zoals LangChain, verschillende vormen van conversatiegeheugen.
ConversationBufferMemory slaat alle berichten integraal op en behoudt de volledige gespreksgeschiedenis, ideaal voor korte gesprekken waarbij je volledige context nodig hebt. ConversationSummaryMemory comprimeert eerdere interacties tot samenvattingen, wat het aantal tokens vermindert terwijl kerninformatie voor langere gesprekken behouden blijft. ConversationBufferWindowMemory bewaart alleen de meest recente N berichten en creëert zo een schuivend venster met context dat goed werkt wanneer alleen recente uitwisselingen ertoe doen. ConversationSummaryBufferMemory combineert benaderingen: recente berichten blijven letterlijk behouden, terwijl oudere uitwisselingen worden samengevat. Dit biedt een balans tussen detail en efficiëntie. Elke vorm maakt een afweging tussen volledigheid en efficiëntie, zodat je kunt kiezen op basis van de specifieke behoeften van je toepassing.
Inzicht in deze geheugentypen is essentieel, maar ze opereren allemaal binnen een fundamentele beperking: het contextvenster. Laten we verkennen hoe deze architecturale limiet de implementatie van geheugen vormgeeft.
LLM-contextvensters: fundament en beperking
Een van de belangrijkste aspecten van LLM-geheugen om te begrijpen is volgens mij het concept van contextvensters. Laten we kort bekijken hoe ze werken.
Wat zijn contextvensters?
Een contextvenster is de maximale hoeveelheid tekst, gemeten in tokens, die een LLM in één verzoek kan verwerken. Tokens zijn stukjes tekst die ruwweg overeenkomen met woorden of subwoorden.
Het contextvenster fungeert als het directe werkgeheugen van het model. Alles wat het model in overweging neemt, moet in dit venster passen: systeemprompt, gespreksgeschiedenis, opgehaalde documenten en ruimte voor het antwoord. Naarmate gesprekken groeien, moeten oudere berichten plaatsmaken voor nieuwe.
De grootte van contextvensters varieert sterk. Zo ondersteunt GPT-5 400.000 tokens, kan Claude 4.5 Sonnet 200.000 tokens aan, en gaat Gemini 3 Pro tot 1,5 miljoen tokens. Grotere vensters bieden rijkere context, maar verhogen de rekencosts kwadratisch.
Hoewel grote contextvensters ideaal klinken, brengen ze aanzienlijke praktische uitdagingen mee die de uitrol in de praktijk beïnvloeden.
Uitdagingen en beperkingen van contextvensters
De grootste uitdaging met contextvensters is naar mijn ervaring het "lost in the middle"-probleem. Onderzoek toont aan dat LLM’s beter letten op informatie aan het begin en einde van het contextvenster, terwijl de inhoud in het midden minder aandacht krijgt. Simpelweg de context volproppen met informatie garandeert geen effectief gebruik.
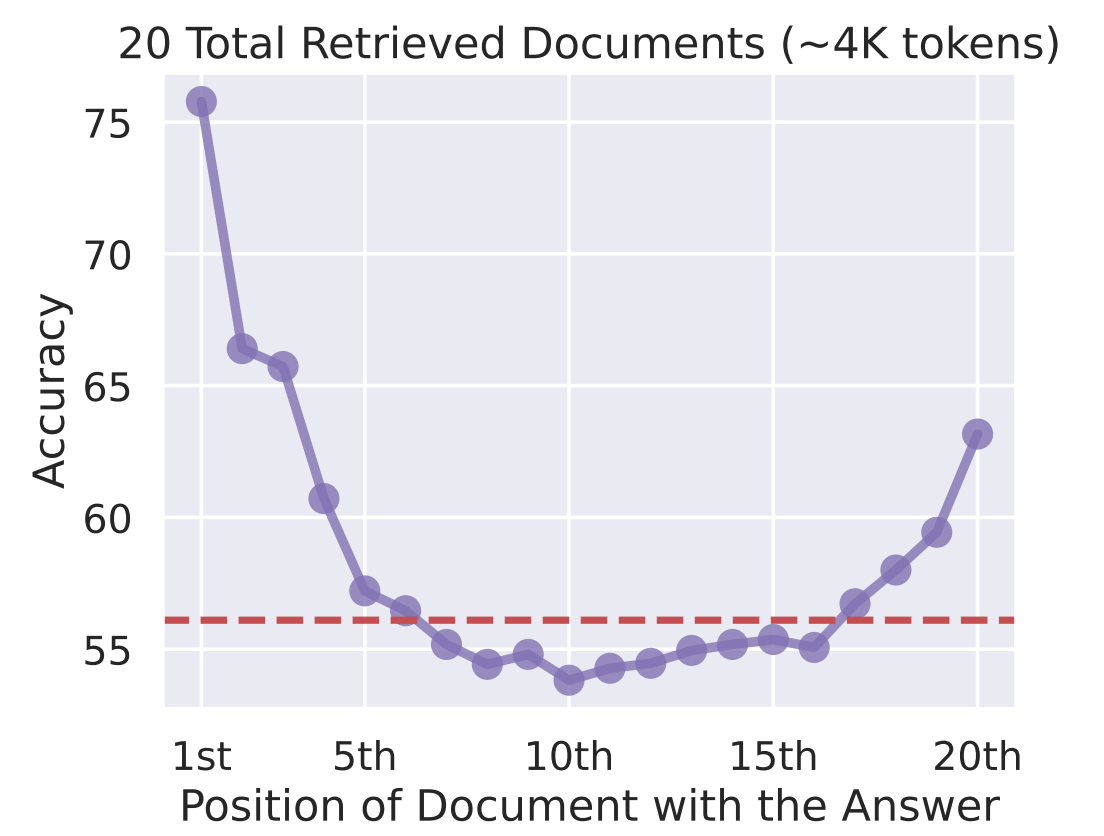
Accuracy vs. Position of Document with the Answer
Rekenkundige beperkingen maken het duur om contextvensters te vergroten. Het verwerken van een context van 100.000 tokens vereist aanzienlijk meer GPU-geheugen en -tijd dan een context van 10.000 tokens.
Voor productieapplicaties stapelen deze kosten zich snel op, wat de noodzaak vergroot van slimme geheugensystemen die selectief alleen relevante informatie opnemen.
Gezien deze beperkingen is de oplossing niet simpelweg grotere contextvensters, maar het bouwen van slimmere systemen die ze efficiënt benutten.
Contextvensters combineren met geheugensystemen
Effectieve LLM-toepassingen combineren contextvensters met geheugensystemen die verder reiken dan de directe context. Het patroon houdt in dat je het contextvenster gebruikt voor kortetermijn-, hoogprioritaire informatie, terwijl je langetermijngeheugen extern opslaat en selectief ophaalt.
Een typische architectuur houdt recente gespreksbeurten in het contextvenster, slaat oudere gesprekken op in een database en gebruikt retrievalmechanismen om relevante eerdere informatie terug te halen wanneer nodig. Dit balanceert volledigheid met efficiëntie en prestaties.
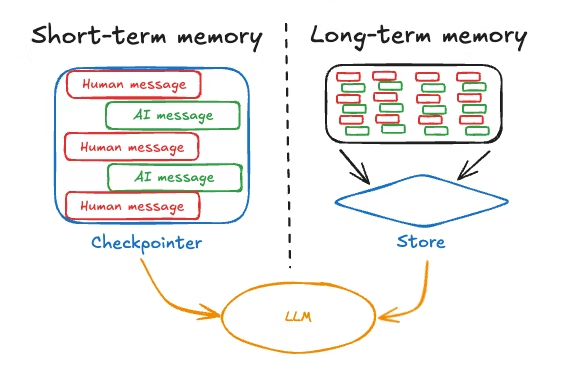
Short/Long-term Memory
Met dit architecturale begrip op zak, gaan we bekijken hoe je effectieve kortetermijngeheugensystemen implementeert die binnen deze beperkingen werken
Kortetermijngeheugensystemen implementeren in LLM’s
Kortetermijngeheugensystemen beheren informatie binnen de huidige sessie en maken vooral gebruik van het contextvenster. Ik zie dit als het werkgeheugen van het model: de informatie die het actief vasthoudt tijdens het verwerken van het huidige gesprek.
Laten we kijken hoe je deze beperkte maar cruciale geheugencapaciteit maximaliseert.
In-context leren
In-context leren verwijst naar het vermogen van het model om gedrag aan te passen op basis van voorbeelden of instructies in de prompt. Je leert het model wat te doen binnen het contextvenster in plaats van het te fine-tunen.
Het mechanisme is eenvoudig:
- Neem voorbeelden op van het gewenste gedrag, en het model leert het patroon.
- Voor sentimentclassificatie geef je meerdere voorbeeldparen van tekst en sentiment, en bied je daarna de nieuwe tekst aan. Het model leidt het patroon af en past het toe.
Voordelen van deze aanpak zijn onder meer:
- Snelle taakadaptatie zonder hertraining
- Flexibiliteit om gedrag te wijzigen door prompts aan te passen
- Domeinspecifieke taken aanleren met enkele voorbeelden.
Beperkingen zijn onder andere verminderde effectiviteit met veel voorbeelden door "lost in the middle", hogere tokenkosten en prestaties die zelden gelijk zijn aan getunede modellen.
In-context leren laat zien wat mogelijk is met kortetermijngeheugen, maar hoe wordt informatie eigenlijk opgeslagen zodat het model die kan gebruiken? Laten we de mechanismen achter geheugenvorming verkennen.
Herinneringen schrijven en opslaan
Geheugenvorming in LLM-systemen kan bewust (expliciet) of onbewust (impliciet) zijn.
- Bewuste vorming houdt in dat je het systeem expliciet instrueert om informatie te onthouden of mechanismen implementeert die kernfeiten uit gesprekken extraheren en opslaan.
- Onbewuste vorming gebeurt automatisch via de gespreksstroom. Naarmate berichten zich ophopen in het contextvenster, leveren ze impliciet geheugen.
Veel frameworks onderhouden automatisch conversatiebuffers en creëren zo impliciet geheugen zonder expliciete operaties. De uitdaging is het beheren van deze opstapeling: zorgen dat relevante informatie behouden blijft terwijl minder belangrijke details worden weggesnoeid.
Kortetermijngeheugen dekt onmiddellijke gespreksbehoeften, maar wat als je informatie langer wilt laten voortbestaan dan de huidige sessie? Dan worden langetermijnoplossingen essentieel.
Langetermijnoplossingen voor LLM-geheugen
Langetermijngeheugen stelt LLM’s in staat om informatie over sessies heen te behouden.
Waar kortetermijngeheugen vluchtig is en verdwijnt wanneer het gesprek eindigt, blijft langetermijngeheugen bestaan, zodat je AI gebruikersvoorkeuren, eerdere interacties en opgebouwde kennis in de tijd onthoudt.
Ik licht twee kernbenaderingen uit: tekstgebaseerde geheugensystemen die informatie extern opslaan en key-value caching die optimaliseert hoe het model eerder berekende informatie benadert.
Tekstgebaseerde geheugensystemen
Tekstgebaseerd geheugen slaat gespreksgeschiedenis en gebruikersinformatie op in databases of vector stores. Verwerving houdt in dat relevante informatie, voorkeuren, beslissingen, feiten of contextdetails worden vastgelegd.
Geheugenbeheer vereist compressie en organisatie. Samenvattingstechnieken comprimeren gesprekken tot kernpunten. Hiërarchische organisatie structureert herinneringen op thema’s, tijdsperioden of relevantie.
Benutting draait om retrieval. Vector-similarity search vindt relevante herinneringen op basis van semantische betekenis. Tijdgebaseerde retrieval geeft recentere informatie voorrang. Relevantiebeoordeling rangschikt herinneringen op belangrijkheid.
Tekstgebaseerde systemen bepalen wat je opslaat, maar er is ook de vraag hoe je retrieval efficiënter maakt. Daar komt key-value caching om de hoek kijken.
Key-value caching en aandachtoptimalisatie
Key-value (KV) caching verbetert de efficiëntie van tokengeneratie. Tijdens tekstgeneratie berekent het model aandacht over alle voorgaande tokens. KV-caching slaat deze tussentijdse berekeningen op, zodat ze bij het genereren van volgende tokens opnieuw gebruikt kunnen worden zonder herberekening.
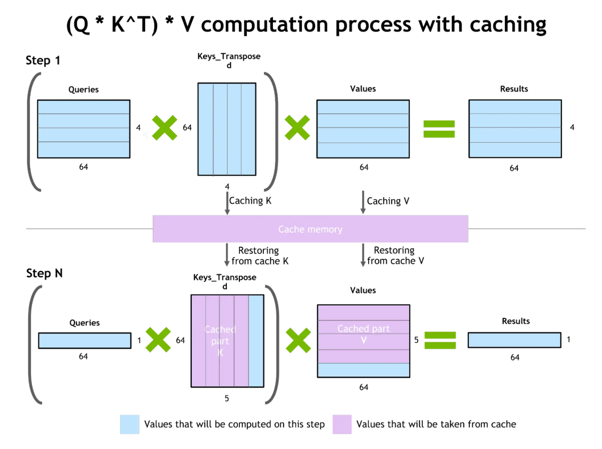
Key-value Caching and Attention Optimization
Het voordeel is aanzienlijk: lagere rekenkosten, wat snellere responsen en minder resourcegebruik mogelijk maakt. Wel verbruiken gecachte key-value-paren GPU-VRAM. Bij zeer lange contexten wordt de KV-cachegrootte een beperking.
Hoewel KV-caching optimaliseert hoe modellen hun contextvensters gebruiken, lost het het fundamentele probleem van beperkte geheugencapaciteit niet op. Retrieval-augmented generation biedt hier een aanvullende aanpak.
Retrieval-Augmented Generation (RAG)
Een van de recente ontwikkelingen die ik het interessantst vind, is Retrieval-Augmented Generation of RAG. RAG slaat een brug tussen intern en extern geheugen en breidt het geheugen van een LLM uit voorbij de beperkingen van het contextvenster.
In plaats van uitsluitend te vertrouwen op wat het model tijdens training leerde of wat in de huidige context past, haalt RAG precies op het juiste moment relevante informatie uit externe bronnen. Laten we RAG in meer detail bekijken.
Interne en externe geheugenbrug slaan
RAG-architectuur bestaat uit twee hoofdonderdelen: een retriever die externe kennisbanken doorzoekt naar relevante informatie en een generator (de LLM) die antwoorden produceert op basis van zowel de vraag als de opgehaalde context.
Wanneer een query binnenkomt, vindt de retriever relevante documenten uit vector databases of kennisbanken. Opgehaalde documenten worden in het contextvenster geïnjecteerd en bieden specifieke informatie om het antwoord te onderbouwen.
Voordelen van RAG zijn minder hallucinaties door naar echte documenten te verwijzen, hogere nauwkeurigheid door toegang tot up-to-date informatie buiten de trainingsdata en het opnemen van propriëtaire kennis zonder hertraining.
Uitdagingen zijn onder meer mogelijke hallucinaties wanneer opgehaalde documenten fouten bevatten, relevantieproblemen als retrieval onbruikbare informatie teruggeeft en de complexiteit van het beheren van vector databases.
De echte kracht van RAG wordt duidelijk wanneer we bekijken hoe het een van de meest fundamentele beperkingen aanpakt die we eerder bespraken: contextvensterbeperkingen.
Hoe RAG helpt met contextvensters
RAG breidt de context uit voorbij de venstergrootte door selectief alleen relevante informatie op te halen. In plaats van een volledige gespreksgeschiedenis te behouden, sla je die extern op en haal je waar nodig de relevante delen terug, zodat je in feite onbeperkte gesprekssduur kunt ondersteunen binnen de beperkingen van het contextvenster.
Strategieën om contextvensters met RAG te verbeteren zijn hybride retrieval die semantisch zoeken combineert met metadataverfijning, het her-ranken van opgehaalde resultaten om relevante documenten te prioriteren en recursieve retrieval waarbij het eerste antwoord van het model aanvullende retrieval aanstuurt.
RAG is een praktische, productierijpe aanpak om geheugen uit te breiden, maar de onderzoeksgemeenschap verlegt de grenzen met nieuwe architecturen die heroverwegen hoe modellen op fundamenteel niveau met geheugen omgaan.
Geavanceerde LLM-geheugenarchitecturen
Nieuwe architecturen en door neurowetenschap geïnspireerde systemen verbeteren de geheugencapaciteiten van LLM’s. Deze geavanceerde benaderingen herdenken hoe modellen met lang-contextinformatie omgaan, voorbij de traditionele transformerbeperkingen, om efficiëntere en menselijker geheugensystemen te creëren.
Nieuwe neurale architecturen
Architecturen zoals Mamba en recurrent memory transformers optimaliseren geheugenefficiëntie. Mamba gebruikt state space-modellen in plaats van attentionmechanismen, met lineaire in plaats van kwadratische schaalbaarheid met de sequencelengte, waardoor aanzienlijk langere reeksen verwerkt kunnen worden met vergelijkbare resources.
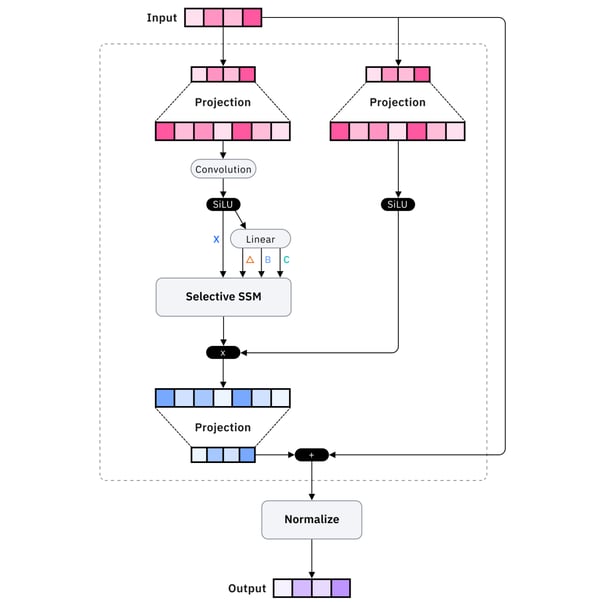
Mamba Block
Recurrent memory transformers breiden standaard transformers uit met recursieve verbindingen die een langetermijnstatus behouden, waardoor informatie voorbij het directe contextvenster kan voortbestaan via aangeleerde geheugemechanismen.
Deze architecturale innovaties zijn fascinerend vanuit onderzoeksoptiek, maar hoe zit het met productierijpe oplossingen? Daar komen externe geheugenplatforms in beeld.
Externe geheugensystemen
Platforms zoals Mem0 en Zep bieden productierijpe externe geheugenoplossingen. Mem0 levert een beheerde geheugenlaag die automatisch relevante informatie extraheert, opslaat en ophaalt. Zep richt zich op conversatiegeheugen met ingebouwde samenvatting, feitenextractie en vectorzoekopdrachten.
Hoewel deze platforms praktische oplossingen bieden, laten sommige onderzoekers zich inspireren door een onverwachte bron: hoe menselijke hersenen daadwerkelijk herinneringen vormen en beheren.
Neurowetenschap-geïnspireerde geheugenaugmentatie
CAMELoT (Consolidated Associative Memory Enhanced Long Transformer) past neurowetenschappelijke principes toe op LLM-geheugen, met consolidatie, nieuwigheidsdetectie en recency-weging. Deze principes spiegelen menselijke geheugensystemen en creëren natuurlijker geheugen gedrag.
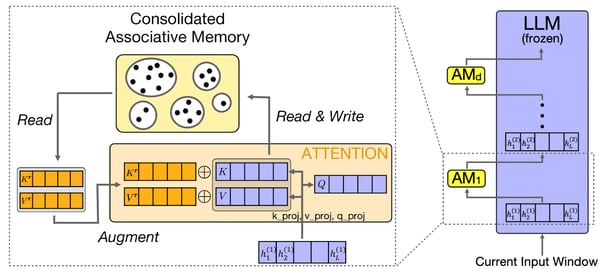
CAMELoT Pipeline
Voortbouwend op deze neurowetenschappelijke principes richt een andere aanpak, zoals Laminar, zich specifiek op hoe mensen onderscheidende ervaringen en gebeurtenissen onthouden.
Episodisch geheugen voor LLM’s
Larimar stelt LLM’s in staat om afzonderlijke geheugenepisodes te onderhouden. In plaats van alle eerdere informatie uniform te behandelen, structureert episodisch geheugen informatie in discrete gebeurtenissen. Dit maakt generalisatie over contextlengte mogelijk. Het model verwijst naar specifieke eerdere episodes zonder de volledige geschiedenis te laden.
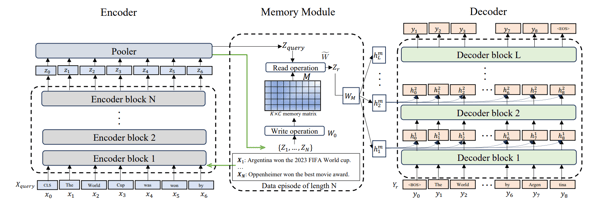
Larimar Architecture
Deze geavanceerde architecturen zijn veelbelovend, maar brengen ook nieuwe complexiteiten mee. Laten we de praktische uitdagingen bekijken die ontstaan bij het implementeren van geheugensystemen en strategieën om deze te overwinnen.
LLM-geheugenbeperkingen overwinnen
Zelfs met geavanceerde architecturen heb ik gemerkt dat geheugensystemen uitdagingen kennen die vaak zorgvuldige mitigatie vereisen. Inzicht in deze obstakels en hun oplossingen is cruciaal om robuuste productiesystemen te bouwen die gebruikers vertrouwen.
Veelvoorkomende uitdagingen
Catastrofale vergetelheid treedt op wanneer modellen eerder geleerde informatie kwijtraken. Oplossingen zijn geheugenconsolidatie, het versterken van belangrijke herinneringen, geheugenhiërarchieën, het behouden van kritieke informatie en periodieke geheugenverversing.
Naast vergeten is een andere kritieke uitdaging wanneer geheugensystemen het model actief misleiden. Hallucinatie (plausibele maar onjuiste informatie genereren) wordt verergerd door foutief geheugen. Mitigatie omvat bronattribuering, betrouwbaarheidscores voor opgehaalde herinneringen en verificatiestappen.
Het opslaan van gebruikersgesprekken en voorkeuren brengt tenslotte belangrijke privacyvragen met zich mee. Privacy- en beveiligingsoverwegingen zijn cruciaal bij het bewaren van gebruikersdata. Implementeer gegevensversleuteling, retentiebeleid dat oude data automatisch verwijdert, en toegangscontroles die waarborgen dat gebruikers alleen hun eigen herinneringen benaderen.
Integratie
Integratie van geheugen vereist doordacht API-ontwerp. Kernpatronen zijn stateful integratie, waarbij het geheugensysteem status over verzoeken heen bijhoudt, en stateless integratie, waarbij elk verzoek de benodigde identificatoren bevat.
Efficiënt geheugenbeheer gebruikt trimming (de oudste of minst relevante berichten verwijderen), deletion (specifieke items verwijderen) en samenvatting (berichten comprimeren). Deze patronen houden het geheugen binnen budget terwijl essentiële context behouden blijft.
Inzicht in deze theoretische patronen en uitdagingen is waardevol, maar de echte test is de implementatie. Laten we deze concepten vertalen naar praktische richtlijnen die je op je eigen projecten kunt toepassen.
Best practices voor LLM-geheugensystemen
Dit zijn enkele manieren waarop ik ontwikkelaars het meeste uit LLM-geheugensystemen heb zien halen.
Tokenbudgetten
Effectief contextbeheer begint met inzicht in je tokenbudget. Bereken hoeveel tokens je systeemprompt, geheugen en antwoord vereisen, en zorg dat de som binnen de limieten blijft. Structureer data hiërarchisch en plaats belangrijke informatie waar het model het best oplet—aan het begin of het einde.
Bereid de data voor
Even belangrijk is hoe je de data voorbereidt voordat die in je geheugensysteem komt. Datavoorbereiding is van groot belang. Hak grote documenten in semantische brokken in plaats van arbitraire tokenlimieten. Laat brokken licht overlappen voor contextcontinuïteit. Voeg metadata toe aan elke brok om gefilterde retrieval mogelijk te maken.
Test en meet
Als je systeem draait, heb je manieren nodig om te meten of het echt werkt. Geheugenevaluatie vereist het bijhouden van metrics zoals recall-nauwkeurigheid, hallucinatiegraad en gebruikerstevredenheid. Monitor latentie van het geheugensysteem, tokengebruik en relevantie van retrieval.
Heb een retrievalstrategie
Tot slot moet je retrievalstrategie zich aanpassen aan de complexiteit van wat gebruikers vragen. Flexibele retrievalstrategieën passen zich aan de vraagcomplexiteit aan. Eenvoudige queries gebruiken keyword search, terwijl complexe vragen baat hebben bij semantische similaritiesearch. Implementeer geheugen-namespaces om informatie te organiseren per gebruiker, onderwerp of periode.
Conclusie
Geheugen in large language models transformeert deze modellen van stateloze tekstgeneratoren naar contextbewuste AI-assistants die samenhangende, gepersonaliseerde interacties aankunnen. In deze tutorial heb ik de fundamenten van LLM-geheugen verkend, van contextvensters tot geavanceerde architecturen.
De kernpunten zijn volgens mij: begin met goed beheerde contextvensters en conversatiebuffers voor directe behoeften, implementeer RAG voor schaalbare kennistoegang buiten parametrisch geheugen, maak gebruik van externe geheugenplatforms voor productieapplicaties en evalueer de geheugeneffectiviteit continu via metrics en gebruikersfeedback.
Naarmate de mogelijkheden van LLM’s toenemen, worden geheugensystemen steeds geavanceerder. Richt je als practicus op het bouwen van geheugensystemen die aan gebruikersbehoeften voldoen: relevante context behouden, op gepaste wijze vergeten en natuurlijke interacties mogelijk maken die AI-toepassingen écht nuttig maken.
Om te blijven leren, raad ik de volgende bronnen aan:




Veel ontwikkelaars bouwen chatbots en AI-assistents die op zichzelf staande vragen briljant kunnen beantwoorden, maar moeite hebben om samenhangende gesprekken te voeren. De oorzaak? Gebrek aan geheugen. Wanneer een gebruiker een vervolgvraag stelt die naar eerdere context verwijst, behandelen stateloze taalmodellen die als volledig nieuw, wat leidt tot frustrerende, repetitieve interacties.
Het begrijpen en implementeren van geheugen in large language models is cruciaal om AI-toepassingen te creëren die natuurlijk en intelligent aanvoelen. Geheugen stelt LLM’s in staat om context over gesprekken heen vast te houden, te leren van eerdere interacties en gepersonaliseerde reacties te geven. In deze tutorial neem ik je mee door de basis van LLM-geheugen, van eenvoudige contextvensters tot geavanceerde architecturen.
Als je nieuw bent met LLM’s, raad ik een van onze cursussen aan, zoals Developing LLM Applications with LangChain, Developing Large Language Models, of LLMOps Concepts.
Wat is LLM-geheugen?
Large language models verwerken informatie anders dan traditionele software. Waar databases expliciet data opslaan en ophalen, moeten LLM’s geheugen beheren binnen architecturale beperkingen zoals contextvensters en tokenlimieten. De uitdaging is om modellen relevante informatie te laten onthouden en onnodige details te laten vergeten, zodat samenhang behouden blijft zonder de rekenbronnen te overbelasten.
Voordat we in de implementatiedetails duiken, bepalen we eerst wat geheugen betekent in de context van large language models en waarom het belangrijk is voor effectieve AI-toepassingen.
De basis van geheugen in large language models
Geheugen in LLM’s verwijst naar het vermogen van het systeem om informatie uit eerdere interacties of trainingsdata vast te houden en te benutten. Dit is geen geheugen in de traditionele IT-zin. Het gaat om het vermogen van het model om context te behouden, naar eerdere uitwisselingen te verwijzen en geleerde patronen op nieuwe situaties toe te passen.
Geheugen is cruciaal omdat het losse vraag-antwoordparen verandert in samenhangende gesprekken. Zonder geheugen kan een LLM niet begrijpen wanneer je zegt: "vertel me daar meer over." Het model heeft context nodig om verwijzingen te interpreteren en voort te bouwen op eerdere uitwisselingen.
Ik denk vaak aan LLM-geheugen in analogie met menselijk geheugen. Mensen hebben sensorisch geheugen (directe waarneming), kortetermijngeheugen (actieve informatie) en langetermijngeheugen (opgeslagen kennis). LLM’s implementeren vergelijkbare systemen: contextvensters werken als kortetermijngeheugen, opgehaalde informatie fungeert als opgeroepen langetermijngeheugen, en getrainde parameters vertegenwoordigen permanente kennis.
Nu ik het basisconcept van geheugen in LLM’s heb behandeld, bekijken we hoe geheugensystemen worden geclassificeerd, zodat je de juiste aanpak voor jouw specifieke toepassing kunt kiezen.
De drie dimensies van LLM-geheugenclassificatie
Begrijpen hoe geheugen wordt geclassificeerd helpt bij het kiezen van de juiste aanpak voor je toepassing. LLM-geheugen kan langs drie kerndimensies worden ingedeeld: object, vorm en tijd.
Objectdimensie
De objectdimensie maakt onderscheid tussen persoonlijk geheugen en systeemgeheugen. Persoonlijk geheugen slaat gebruikersspecifieke informatie op, zoals voorkeuren en gespreksgeschiedenis.
Systeemgeheugen bevat algemene kennis en mogelijkheden die voor alle gebruikers beschikbaar zijn. Een klantenservicebot kan systeemgeheugen gebruiken voor productinformatie, terwijl persoonlijk geheugen de bestelgeschiedenis van elke klant bijhoudt.
Vormdimensie
De tweede dimensie, de vormdimensie, onderscheidt parametrisch van niet-parametrisch geheugen. Parametrisch geheugen wordt tijdens training in de modelgewichten gecodeerd. Niet-parametrisch geheugen bestaat buiten het model, opgeslagen in databases of vector stores. Parametrisch geheugen ligt vast na training, terwijl niet-parametrisch geheugen dynamisch kan worden bijgewerkt.
Tijdsdimensie
Tot slot categoriseert de tijdsdimensie geheugen naar duur: kortetermijn versus langetermijn. Kortetermijngeheugen beslaat het huidige gesprek en wordt in het contextvenster opgeslagen. Langetermijngeheugen blijft sessie-overstijgend bestaan, wordt extern opgeslagen en opgehaald wanneer nodig.
Met dit classificatiekader op zak bekijken we nu de specifieke typen geheugen die LLM’s in de praktijk implementeren.
Typen geheugen in LLM’s
Verschillende geheugentypen dienen verschillende doelen in LLM-toepassingen. Inzicht in deze typen helpt je effectieve geheugenarchitecturen te ontwerpen voor jouw specifieke use-case.
Semantisch geheugen
Semantisch geheugen slaat feiten en algemene kennis op die het systeem kan raadplegen en waarnaar het kan verwijzen. Hoewel modellen basiskennis hebben uit training, verwijst semantisch geheugen in de praktijk vaak naar externe kennisbanken, databases of documentopslag met feitelijke informatie.
Een klantenservicebot kan bijvoorbeeld semantisch geheugen hebben met productspecificaties, prijsinformatie en bedrijfsbeleid in een vector database. Zo kan het systeem accurate, up-to-date feiten ophalen en gebruiken zonder uitsluitend te vertrouwen op mogelijk verouderde trainingsdata. Semantisch geheugen wordt meestal extern opgeslagen en opgehaald wanneer nodig, waardoor het eenvoudig te updaten en te onderhouden is.
Episodisch geheugen
Waar semantisch geheugen over feiten en kennis gaat, richt episodisch geheugen zich op specifieke ervaringen. Episodisch geheugen legt eerdere interacties vast: welke vragen zijn gesteld, hoe het model reageerde en de context rond die uitwisselingen.
Episodisch geheugen stelt het model in staat om op natuurlijke wijze naar eerdere delen van het gesprek te verwijzen, met zinnen als "zoals we eerder bespraken" of "op basis van wat je me over je project vertelde." Dit type geheugen is doorgaans niet-parametrisch en wordt opgeslagen in conversatiebuffers of databases.
Procedureel geheugen
Procedureel geheugen omvat systeeminstructies en aangeleerde procedures. Dit omvat de systeemprompt die het gedrag van de AI bepaalt, richtlijnen voor hoe te reageren en taakspecifieke instructies.
Als je een model configureert om "altijd in opsommingstekens te antwoorden" of "nauwkeurigheid boven creativiteit te stellen", definieer je procedureel geheugen. Het bepaalt hoe het model informatie verwerkt en beantwoordt, in plaats van welke informatie het kent.
Types of Memories
Naast deze fundamentele geheugentypen bieden praktische implementaties, met name in frameworks zoals LangChain, verschillende vormen van conversatiegeheugen.
ConversationBufferMemoryslaat alle berichten integraal op en behoudt de volledige gespreksgeschiedenis, ideaal voor korte gesprekken waarbij je volledige context nodig hebt.ConversationSummaryMemorycomprimeert eerdere interacties tot samenvattingen, wat het aantal tokens vermindert terwijl kerninformatie voor langere gesprekken behouden blijft.ConversationBufferWindowMemorybewaart alleen de meest recente N berichten en creëert zo een schuivend venster met context dat goed werkt wanneer alleen recente uitwisselingen ertoe doen.ConversationSummaryBufferMemorycombineert benaderingen: recente berichten blijven letterlijk behouden, terwijl oudere uitwisselingen worden samengevat. Dit biedt een balans tussen detail en efficiëntie. Elke vorm maakt een afweging tussen volledigheid en efficiëntie, zodat je kunt kiezen op basis van de specifieke behoeften van je toepassing.Inzicht in deze geheugentypen is essentieel, maar ze opereren allemaal binnen een fundamentele beperking: het contextvenster. Laten we verkennen hoe deze architecturale limiet de implementatie van geheugen vormgeeft.
LLM-contextvensters: fundament en beperking
Een van de belangrijkste aspecten van LLM-geheugen om te begrijpen is volgens mij het concept van contextvensters. Laten we kort bekijken hoe ze werken.
Wat zijn contextvensters?
Een contextvenster is de maximale hoeveelheid tekst, gemeten in tokens, die een LLM in één verzoek kan verwerken. Tokens zijn stukjes tekst die ruwweg overeenkomen met woorden of subwoorden.
Het contextvenster fungeert als het directe werkgeheugen van het model. Alles wat het model in overweging neemt, moet in dit venster passen: systeemprompt, gespreksgeschiedenis, opgehaalde documenten en ruimte voor het antwoord. Naarmate gesprekken groeien, moeten oudere berichten plaatsmaken voor nieuwe.
De grootte van contextvensters varieert sterk. Zo ondersteunt GPT-5 400.000 tokens, kan Claude 4.5 Sonnet 200.000 tokens aan, en gaat Gemini 3 Pro tot 1,5 miljoen tokens. Grotere vensters bieden rijkere context, maar verhogen de rekencosts kwadratisch.
Hoewel grote contextvensters ideaal klinken, brengen ze aanzienlijke praktische uitdagingen mee die de uitrol in de praktijk beïnvloeden.
Uitdagingen en beperkingen van contextvensters
De grootste uitdaging met contextvensters is naar mijn ervaring het "lost in the middle"-probleem. Onderzoek toont aan dat LLM’s beter letten op informatie aan het begin en einde van het contextvenster, terwijl de inhoud in het midden minder aandacht krijgt. Simpelweg de context volproppen met informatie garandeert geen effectief gebruik.
Accuracy vs. Position of Document with the Answer
Rekenkundige beperkingen maken het duur om contextvensters te vergroten. Het verwerken van een context van 100.000 tokens vereist aanzienlijk meer GPU-geheugen en -tijd dan een context van 10.000 tokens.
Voor productieapplicaties stapelen deze kosten zich snel op, wat de noodzaak vergroot van slimme geheugensystemen die selectief alleen relevante informatie opnemen.
Gezien deze beperkingen is de oplossing niet simpelweg grotere contextvensters, maar het bouwen van slimmere systemen die ze efficiënt benutten.
Contextvensters combineren met geheugensystemen
Effectieve LLM-toepassingen combineren contextvensters met geheugensystemen die verder reiken dan de directe context. Het patroon houdt in dat je het contextvenster gebruikt voor kortetermijn-, hoogprioritaire informatie, terwijl je langetermijngeheugen extern opslaat en selectief ophaalt.
Een typische architectuur houdt recente gespreksbeurten in het contextvenster, slaat oudere gesprekken op in een database en gebruikt retrievalmechanismen om relevante eerdere informatie terug te halen wanneer nodig. Dit balanceert volledigheid met efficiëntie en prestaties.
Short/Long-term Memory
Met dit architecturale begrip op zak, gaan we bekijken hoe je effectieve kortetermijngeheugensystemen implementeert die binnen deze beperkingen werken
Kortetermijngeheugensystemen implementeren in LLM’s
Kortetermijngeheugensystemen beheren informatie binnen de huidige sessie en maken vooral gebruik van het contextvenster. Ik zie dit als het werkgeheugen van het model: de informatie die het actief vasthoudt tijdens het verwerken van het huidige gesprek.
Laten we kijken hoe je deze beperkte maar cruciale geheugencapaciteit maximaliseert.
In-context leren
In-context leren verwijst naar het vermogen van het model om gedrag aan te passen op basis van voorbeelden of instructies in de prompt. Je leert het model wat te doen binnen het contextvenster in plaats van het te fine-tunen.
Het mechanisme is eenvoudig:
Voordelen van deze aanpak zijn onder meer:
Beperkingen zijn onder andere verminderde effectiviteit met veel voorbeelden door "lost in the middle", hogere tokenkosten en prestaties die zelden gelijk zijn aan getunede modellen.
In-context leren laat zien wat mogelijk is met kortetermijngeheugen, maar hoe wordt informatie eigenlijk opgeslagen zodat het model die kan gebruiken? Laten we de mechanismen achter geheugenvorming verkennen.
Herinneringen schrijven en opslaan
Geheugenvorming in LLM-systemen kan bewust (expliciet) of onbewust (impliciet) zijn.
Veel frameworks onderhouden automatisch conversatiebuffers en creëren zo impliciet geheugen zonder expliciete operaties. De uitdaging is het beheren van deze opstapeling: zorgen dat relevante informatie behouden blijft terwijl minder belangrijke details worden weggesnoeid.
Kortetermijngeheugen dekt onmiddellijke gespreksbehoeften, maar wat als je informatie langer wilt laten voortbestaan dan de huidige sessie? Dan worden langetermijnoplossingen essentieel.
Langetermijnoplossingen voor LLM-geheugen
Langetermijngeheugen stelt LLM’s in staat om informatie over sessies heen te behouden.
Waar kortetermijngeheugen vluchtig is en verdwijnt wanneer het gesprek eindigt, blijft langetermijngeheugen bestaan, zodat je AI gebruikersvoorkeuren, eerdere interacties en opgebouwde kennis in de tijd onthoudt.
Ik licht twee kernbenaderingen uit: tekstgebaseerde geheugensystemen die informatie extern opslaan en key-value caching die optimaliseert hoe het model eerder berekende informatie benadert.
Tekstgebaseerde geheugensystemen
Tekstgebaseerd geheugen slaat gespreksgeschiedenis en gebruikersinformatie op in databases of vector stores. Verwerving houdt in dat relevante informatie, voorkeuren, beslissingen, feiten of contextdetails worden vastgelegd.
Geheugenbeheer vereist compressie en organisatie. Samenvattingstechnieken comprimeren gesprekken tot kernpunten. Hiërarchische organisatie structureert herinneringen op thema’s, tijdsperioden of relevantie.
Benutting draait om retrieval. Vector-similarity search vindt relevante herinneringen op basis van semantische betekenis. Tijdgebaseerde retrieval geeft recentere informatie voorrang. Relevantiebeoordeling rangschikt herinneringen op belangrijkheid.
Tekstgebaseerde systemen bepalen wat je opslaat, maar er is ook de vraag hoe je retrieval efficiënter maakt. Daar komt key-value caching om de hoek kijken.
Key-value caching en aandachtoptimalisatie
Key-value (KV) caching verbetert de efficiëntie van tokengeneratie. Tijdens tekstgeneratie berekent het model aandacht over alle voorgaande tokens. KV-caching slaat deze tussentijdse berekeningen op, zodat ze bij het genereren van volgende tokens opnieuw gebruikt kunnen worden zonder herberekening.
Key-value Caching and Attention Optimization
Het voordeel is aanzienlijk: lagere rekenkosten, wat snellere responsen en minder resourcegebruik mogelijk maakt. Wel verbruiken gecachte key-value-paren GPU-VRAM. Bij zeer lange contexten wordt de KV-cachegrootte een beperking.
Hoewel KV-caching optimaliseert hoe modellen hun contextvensters gebruiken, lost het het fundamentele probleem van beperkte geheugencapaciteit niet op. Retrieval-augmented generation biedt hier een aanvullende aanpak.
Retrieval-Augmented Generation (RAG)
Een van de recente ontwikkelingen die ik het interessantst vind, is Retrieval-Augmented Generation of RAG. RAG slaat een brug tussen intern en extern geheugen en breidt het geheugen van een LLM uit voorbij de beperkingen van het contextvenster.
In plaats van uitsluitend te vertrouwen op wat het model tijdens training leerde of wat in de huidige context past, haalt RAG precies op het juiste moment relevante informatie uit externe bronnen. Laten we RAG in meer detail bekijken.
Interne en externe geheugenbrug slaan
RAG-architectuur bestaat uit twee hoofdonderdelen: een retriever die externe kennisbanken doorzoekt naar relevante informatie en een generator (de LLM) die antwoorden produceert op basis van zowel de vraag als de opgehaalde context.
Wanneer een query binnenkomt, vindt de retriever relevante documenten uit vector databases of kennisbanken. Opgehaalde documenten worden in het contextvenster geïnjecteerd en bieden specifieke informatie om het antwoord te onderbouwen.
Voordelen van RAG zijn minder hallucinaties door naar echte documenten te verwijzen, hogere nauwkeurigheid door toegang tot up-to-date informatie buiten de trainingsdata en het opnemen van propriëtaire kennis zonder hertraining.
Uitdagingen zijn onder meer mogelijke hallucinaties wanneer opgehaalde documenten fouten bevatten, relevantieproblemen als retrieval onbruikbare informatie teruggeeft en de complexiteit van het beheren van vector databases.
De echte kracht van RAG wordt duidelijk wanneer we bekijken hoe het een van de meest fundamentele beperkingen aanpakt die we eerder bespraken: contextvensterbeperkingen.
Hoe RAG helpt met contextvensters
RAG breidt de context uit voorbij de venstergrootte door selectief alleen relevante informatie op te halen. In plaats van een volledige gespreksgeschiedenis te behouden, sla je die extern op en haal je waar nodig de relevante delen terug, zodat je in feite onbeperkte gesprekssduur kunt ondersteunen binnen de beperkingen van het contextvenster.
Strategieën om contextvensters met RAG te verbeteren zijn hybride retrieval die semantisch zoeken combineert met metadataverfijning, het her-ranken van opgehaalde resultaten om relevante documenten te prioriteren en recursieve retrieval waarbij het eerste antwoord van het model aanvullende retrieval aanstuurt.
RAG is een praktische, productierijpe aanpak om geheugen uit te breiden, maar de onderzoeksgemeenschap verlegt de grenzen met nieuwe architecturen die heroverwegen hoe modellen op fundamenteel niveau met geheugen omgaan.
Geavanceerde LLM-geheugenarchitecturen
Nieuwe architecturen en door neurowetenschap geïnspireerde systemen verbeteren de geheugencapaciteiten van LLM’s. Deze geavanceerde benaderingen herdenken hoe modellen met lang-contextinformatie omgaan, voorbij de traditionele transformerbeperkingen, om efficiëntere en menselijker geheugensystemen te creëren.
Nieuwe neurale architecturen
Architecturen zoals Mamba en recurrent memory transformers optimaliseren geheugenefficiëntie. Mamba gebruikt state space-modellen in plaats van attentionmechanismen, met lineaire in plaats van kwadratische schaalbaarheid met de sequencelengte, waardoor aanzienlijk langere reeksen verwerkt kunnen worden met vergelijkbare resources.
Mamba Block
Recurrent memory transformers breiden standaard transformers uit met recursieve verbindingen die een langetermijnstatus behouden, waardoor informatie voorbij het directe contextvenster kan voortbestaan via aangeleerde geheugemechanismen.
Deze architecturale innovaties zijn fascinerend vanuit onderzoeksoptiek, maar hoe zit het met productierijpe oplossingen? Daar komen externe geheugenplatforms in beeld.
Externe geheugensystemen
Platforms zoals Mem0 en Zep bieden productierijpe externe geheugenoplossingen. Mem0 levert een beheerde geheugenlaag die automatisch relevante informatie extraheert, opslaat en ophaalt. Zep richt zich op conversatiegeheugen met ingebouwde samenvatting, feitenextractie en vectorzoekopdrachten.
Hoewel deze platforms praktische oplossingen bieden, laten sommige onderzoekers zich inspireren door een onverwachte bron: hoe menselijke hersenen daadwerkelijk herinneringen vormen en beheren.
Neurowetenschap-geïnspireerde geheugenaugmentatie
CAMELoT (Consolidated Associative Memory Enhanced Long Transformer) past neurowetenschappelijke principes toe op LLM-geheugen, met consolidatie, nieuwigheidsdetectie en recency-weging. Deze principes spiegelen menselijke geheugensystemen en creëren natuurlijker geheugen gedrag.
CAMELoT Pipeline
Voortbouwend op deze neurowetenschappelijke principes richt een andere aanpak, zoals Laminar, zich specifiek op hoe mensen onderscheidende ervaringen en gebeurtenissen onthouden.
Episodisch geheugen voor LLM’s
Larimar stelt LLM’s in staat om afzonderlijke geheugenepisodes te onderhouden. In plaats van alle eerdere informatie uniform te behandelen, structureert episodisch geheugen informatie in discrete gebeurtenissen. Dit maakt generalisatie over contextlengte mogelijk. Het model verwijst naar specifieke eerdere episodes zonder de volledige geschiedenis te laden.
Larimar Architecture
Deze geavanceerde architecturen zijn veelbelovend, maar brengen ook nieuwe complexiteiten mee. Laten we de praktische uitdagingen bekijken die ontstaan bij het implementeren van geheugensystemen en strategieën om deze te overwinnen.
LLM-geheugenbeperkingen overwinnen
Zelfs met geavanceerde architecturen heb ik gemerkt dat geheugensystemen uitdagingen kennen die vaak zorgvuldige mitigatie vereisen. Inzicht in deze obstakels en hun oplossingen is cruciaal om robuuste productiesystemen te bouwen die gebruikers vertrouwen.
Veelvoorkomende uitdagingen
Catastrofale vergetelheid treedt op wanneer modellen eerder geleerde informatie kwijtraken. Oplossingen zijn geheugenconsolidatie, het versterken van belangrijke herinneringen, geheugenhiërarchieën, het behouden van kritieke informatie en periodieke geheugenverversing.
Naast vergeten is een andere kritieke uitdaging wanneer geheugensystemen het model actief misleiden. Hallucinatie (plausibele maar onjuiste informatie genereren) wordt verergerd door foutief geheugen. Mitigatie omvat bronattribuering, betrouwbaarheidscores voor opgehaalde herinneringen en verificatiestappen.
Het opslaan van gebruikersgesprekken en voorkeuren brengt tenslotte belangrijke privacyvragen met zich mee. Privacy- en beveiligingsoverwegingen zijn cruciaal bij het bewaren van gebruikersdata. Implementeer gegevensversleuteling, retentiebeleid dat oude data automatisch verwijdert, en toegangscontroles die waarborgen dat gebruikers alleen hun eigen herinneringen benaderen.
Integratie
Integratie van geheugen vereist doordacht API-ontwerp. Kernpatronen zijn stateful integratie, waarbij het geheugensysteem status over verzoeken heen bijhoudt, en stateless integratie, waarbij elk verzoek de benodigde identificatoren bevat.
Efficiënt geheugenbeheer gebruikt trimming (de oudste of minst relevante berichten verwijderen), deletion (specifieke items verwijderen) en samenvatting (berichten comprimeren). Deze patronen houden het geheugen binnen budget terwijl essentiële context behouden blijft.
Inzicht in deze theoretische patronen en uitdagingen is waardevol, maar de echte test is de implementatie. Laten we deze concepten vertalen naar praktische richtlijnen die je op je eigen projecten kunt toepassen.
Best practices voor LLM-geheugensystemen
Dit zijn enkele manieren waarop ik ontwikkelaars het meeste uit LLM-geheugensystemen heb zien halen.
Tokenbudgetten
Effectief contextbeheer begint met inzicht in je tokenbudget. Bereken hoeveel tokens je systeemprompt, geheugen en antwoord vereisen, en zorg dat de som binnen de limieten blijft. Structureer data hiërarchisch en plaats belangrijke informatie waar het model het best oplet—aan het begin of het einde.
Bereid de data voor
Even belangrijk is hoe je de data voorbereidt voordat die in je geheugensysteem komt. Datavoorbereiding is van groot belang. Hak grote documenten in semantische brokken in plaats van arbitraire tokenlimieten. Laat brokken licht overlappen voor contextcontinuïteit. Voeg metadata toe aan elke brok om gefilterde retrieval mogelijk te maken.
Test en meet
Als je systeem draait, heb je manieren nodig om te meten of het echt werkt. Geheugenevaluatie vereist het bijhouden van metrics zoals recall-nauwkeurigheid, hallucinatiegraad en gebruikerstevredenheid. Monitor latentie van het geheugensysteem, tokengebruik en relevantie van retrieval.
Heb een retrievalstrategie
Tot slot moet je retrievalstrategie zich aanpassen aan de complexiteit van wat gebruikers vragen. Flexibele retrievalstrategieën passen zich aan de vraagcomplexiteit aan. Eenvoudige queries gebruiken keyword search, terwijl complexe vragen baat hebben bij semantische similaritiesearch. Implementeer geheugen-namespaces om informatie te organiseren per gebruiker, onderwerp of periode.
Conclusie
Geheugen in large language models transformeert deze modellen van stateloze tekstgeneratoren naar contextbewuste AI-assistants die samenhangende, gepersonaliseerde interacties aankunnen. In deze tutorial heb ik de fundamenten van LLM-geheugen verkend, van contextvensters tot geavanceerde architecturen.
De kernpunten zijn volgens mij: begin met goed beheerde contextvensters en conversatiebuffers voor directe behoeften, implementeer RAG voor schaalbare kennistoegang buiten parametrisch geheugen, maak gebruik van externe geheugenplatforms voor productieapplicaties en evalueer de geheugeneffectiviteit continu via metrics en gebruikersfeedback.
Naarmate de mogelijkheden van LLM’s toenemen, worden geheugensystemen steeds geavanceerder. Richt je als practicus op het bouwen van geheugensystemen die aan gebruikersbehoeften voldoen: relevante context behouden, op gepaste wijze vergeten en natuurlijke interacties mogelijk maken die AI-toepassingen écht nuttig maken.
Om te blijven leren, raad ik de volgende bronnen aan: