
Corso
Preprocessing per il Machine Learning in Python
4 ore
68.6K
Una rete neurale che rifiuta di convergere, con la loss piatta e gradienti che svaniscono o esplodono, spesso non ha nulla di sbagliato nell’architettura. Il problema è spesso molto più semplice: caratteristiche di input su scale totalmente diverse, dove una colonna va da 0 a 1 mentre un’altra arriva a decine di migliaia.
Per esperienza, questo schema si presenta continuamente nella pratica. Cinque minuti di preprocessing possono risolvere ciò che giorni di tuning degli iperparametri non riescono a fare.
In questo tutorial ti mostrerò come normalizzare i dati. Ti guiderò tra diverse tecniche di normalizzazione e quando applicarle, con implementazioni in Python incluse. Inoltre, imparerai errori comuni, fraintendimenti e come evitarli.
Se vuoi approfondire come preparare i dati per gli algoritmi di machine learning, ti consiglio il nostro corso Preprocessing for Machine Learning in Python.
La normalizzazione dei dati è il processo di trasformazione delle variabili numeriche affinché occupino intervalli comparabili o seguano una scala coerente.
Il termine ha significati diversi a seconda del contesto: nel machine learning, in genere significa riscalare i valori delle feature per evitare che la magnitudine detti l’importanza; nel design di database, indica l’organizzazione delle tabelle per eliminare la ridondanza.
Mi concentrerò principalmente sul significato nel machine learning, anche se tratteremo brevemente la normalizzazione dei database più avanti per chiarire la sovrapposizione terminologica.
Quando le feature esistono su scale diverse, alcuni algoritmi danno peso sproporzionato ai valori numericamente più grandi.
Una feature che misura il reddito in migliaia dominerà una che misura l’età in decenni, non perché il reddito sia più importante per il task predittivo, ma semplicemente perché i numeri sono più grandi. La normalizzazione mette le feature sullo stesso piano, così il modello può imparare quali contano davvero.
Oltre all’addestramento dei modelli, la normalizzazione aiuta anche per:
Quindi, qual è la differenza tra normalizzazione, scaling e standardizzazione? Questi tre termini compaiono spesso nella documentazione, usati come sinonimi nonostante abbiano significati distinti.
La distinzione pratica si riduce a se il tuo modello ha bisogno di valori entro limiti specifici. La normalizzazione min-max garantisce limiti, mentre la standardizzazione no. La tabella seguente riassume le differenze:
Per un confronto più approfondito su quando ogni approccio può fallire, il nostro blog Normalization vs. Standardization Explained copre bene i casi limite.
Ora che abbiamo chiarito i termini, vediamo alcuni classici casi d’uso. La normalizzazione serve a scopi diversi a seconda del contesto, dal migliorare le dinamiche di addestramento del modello al consentire confronti significativi tra fonti di dati eterogenee.
Le reti neurali e la regressione logistica aggiornano i pesi tramite discesa del gradiente, dove il contributo di ogni feature all’errore di previsione determina quanto si aggiusta il corrispondente peso.
Quando le magnitudini delle feature differiscono drasticamente, lo fanno anche i gradienti: le feature grandi producono grandi gradienti, quelle piccole gradienti piccoli. Questo squilibrio porta l’ottimizzatore a compiere passi enormi in alcune direzioni e appena percettibili in altre, causando addestramento instabile o mancata convergenza.
Gli algoritmi basati sulla distanza come kNN e k-means affrontano un problema analogo. Calcolano la similarità usando metriche di distanza, tipicamente la distanza euclidea, dove valori numericamente più grandi contribuiscono di più al calcolo solo per essere più grandi. Una feature che va da 0 a 10.000 dominerà una che va da 0 a 1, indipendentemente da quale sia rilevante per il task previsto.
Lo scaling assicura che tutte le feature contribuiscano in proporzione al loro reale valore predittivo, non al loro intervallo numerico arbitrario.
Quando costruisci punteggi compositi o combini misurazioni con unità diverse, i valori grezzi possono portare a confronti fuorvianti.
Una metrica di salute del cliente che combina spesa mensile in dollari, frequenza di login come conteggio ed età dell’account in giorni peserà gli importi in dollari molto di più solo perché quei numeri sono più grandi.
La normalizzazione ti permette di combinare queste misurazioni in modo che rifletta la loro reale importanza, non la loro magnitudine accidentale.
Questo vale anche per l’analisi esplorativa e la visualizzazione. Rappresentare feature su scale diverse rende più difficile individuare pattern o confrontare distribuzioni. Dati normalizzati offrono un quadro più pulito di come le feature si relazionano tra loro.
Le pipeline in produzione spesso attingono da più fonti di dati con convenzioni incoerenti. Il fatturato può essere riportato in dollari da un sistema e in migliaia da un altro. Le date compaiono come timestamp Unix in un’API e come stringhe formattate in un’altra.
Stabilire una scala e un formato coerenti prima dell’elaborazione a valle previene bug sottili difficili da diagnosticare in seguito.
Nel contesto dei database, la normalizzazione assume un significato diverso ma correlato: organizzare le tabelle affinché ogni informazione viva in un unico posto.
Questo previene anomalie di aggiornamento in cui cambiare un valore in un punto lascia valori contraddittori altrove. Sebbene le tecniche differiscano dallo scaling delle feature, la motivazione di fondo è simile: mantenere i dati coerenti e prevedibili.
Ogni approccio di normalizzazione fa assunzioni diverse sui tuoi dati e produce caratteristiche di output differenti. La scelta giusta dipende dalla distribuzione, dalla presenza di outlier e da ciò che si aspetta il tuo modello a valle.
La normalizzazione min-max comprime i valori in un intervallo fisso, tipicamente da 0 a 1, sottraendo il minimo e dividendo per l’ampiezza. Questo approccio preserva la forma della distribuzione originale, garantendo però che tutti i valori rientrino in limiti noti.
Come funziona: sottrai il minimo, dividi per l’ampiezza. Tutto qui.
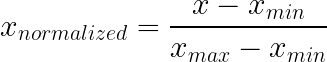
Cosa fa:
Ideale per:
A cosa fare attenzione:
Gli outlier possono mandare completamente in crisi la min-max. Immagina dati per lo più tra 10 e 100, ma un valore a 99.999? Quel singolo punto allunga così tanto l’ampiezza che tutto il resto si comprime in una sottile striscia vicino allo zero. Una sola osservazione sbagliata e l’intera feature è compromessa.
Considera anche cosa succede quando nuovi dati cadono fuori dall’intervallo di training. Valori di test oltre il massimo di training producono output sopra 1. Che questo crei problemi o meno dipende dal tuo modello.
La standardizzazione z-score trasforma i dati affinché la media sia zero e la deviazione standard sia uno, senza imporre limiti fissi all’output. Funziona bene per dati senza limiti naturali evidenti ed è ampiamente assunta o raccomandata da molte implementazioni di algoritmo.
Come funziona: sottrai la media, dividi per la deviazione standard.
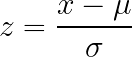
Cosa fa:
Ideale per:
Trade-off:
L’interpretabilità ne risente. "Questa osservazione è 1,7 deviazioni standard sopra la media" richiede più sforzo mentale di "questo è all’80% dell’intervallo". Se gli stakeholder devono capire direttamente i valori scalati, il min-max può comunicare meglio.
Gli outlier continuano a gonfiare media e dev std, distorcendo lo scaling per la maggior parte dei dati, ma meno che nella normalizzazione min-max.
Il robust scaling affronta la sensibilità agli outlier di min-max e z-score usando mediana e intervallo interquartile (IQR) invece di media e deviazione standard. Queste statistiche restano stabili indipendentemente dai valori estremi nelle code della distribuzione.
Come funziona: sottrai la mediana, dividi per l’IQR (differenza tra il 25° e il 75° percentile).
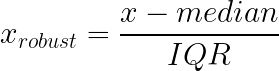
Cosa fa:
Ideale per:
Perché aiuta con dati asimmetrici:
Le distribuzioni dei redditi sono un buon esempio. La maggior parte guadagna importi moderati, alcuni enormi: una classica asimmetria a destra. La deviazione standard viene gonfiata dai redditi alti, rendendo la standardizzazione meno utile per la maggioranza delle osservazioni. Mediana e IQR restano ancorati al centro della distribuzione a prescindere.
La normalizzazione a norma unitaria (L1/L2) opera in modo diverso dalle tecniche sopra: invece di scalare le feature (colonne), di solito scala i singoli campioni (righe). Ogni vettore campione viene riscalato affinché la sua lunghezza sia 1 sotto una norma scelta (spesso L2), rimuovendo la magnitudine complessiva e mantenendo solo direzione/proporzioni.
Non confonderla con la regolarizzazione L1/L2 (Lasso/Ridge): la regolarizzazione modifica l’obiettivo di training aggiungendo una penalità sui pesi del modello per ridurre l’overfitting, non riscalando i vettori di input.
Come funziona: nella L2 ogni riga viene divisa per la sua norma euclidea, così la somma dei quadrati vale uno. La L1 usa la somma dei valori assoluti.
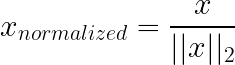
Cosa fa:
Ideale per:
Non utile per:
Situazioni in cui la magnitudine conta davvero. Se il conteggio totale di parole è significativo per il tuo task, normalizzarlo fa perdere informazione.
La normalizzazione dei database indica la ristrutturazione di tabelle relazionali per eliminare la ridondanza e migliorare l’integrità dei dati — ad esempio, assicurandosi che l’email di un cliente sia memorizzata in un unico posto invece che ripetuta in ogni riga d’ordine.
Non ha alcun legame con lo scaling delle feature.
Il termine semplicemente si sovrappone. Nel machine learning, "normalizzazione" quasi sempre si riferisce al ridimensionamento dei valori numerici. Nel data engineering o in SQL, si riferisce all’organizzazione delle strutture di tabella (spesso discussa come 1NF, 2NF o 3NF).
Distinzione chiave:
Se un data engineer ti chiede di "normalizzare il database", vuole che tu sistemi la struttura delle tabelle, non che esegua MinMaxScaler.
Per approfondire, dai un’occhiata a questa guida sulla normalizzazione dei database in SQL.
Implementare correttamente la normalizzazione richiede attenzione all’ordine delle operazioni, in particolare rispetto allo split train/test. Il codice in sé è semplice, ma errori sottili nella sequenza possono invalidare l’intera valutazione.
Scikit-learn ti fornisce gli scaler, ma la regola principale è procedurale, non matematica: prima fai lo split, fai fit solo sul train, poi riusa quel trasformatore fittato ovunque.
Perché tutta questa attenzione? Perché lo scaling apprende numeri dai dati: min/max, media/dev std, mediana/IQR. Se quei numeri vengono calcolati usando il test set, hai silenziosamente lasciato filtrare nel training informazioni future. Nulla va in crash, ma le tue metriche smettono di significare ciò che pensi significhino.
Un esempio minimale:
import pandas as pd
from sklearn.preprocessing import MinMaxScaler, StandardScaler, RobustScaler
from sklearn.model_selection import train_test_split

# Example data
data = pd.DataFrame({
    'age': [25, 32, 47, 51, 62, 28, 35, 44],
    'income': [30000, 45000, 72000, 85000, 120000, 38000, 55000, 67000],
    'score': [0.2, 0.5, 0.7, 0.4, 0.9, 0.3, 0.6, 0.8]
})

# Split happens before any scaling
train_data, test_data = train_test_split(data, test_size=0.25, random_state=42)
A questo punto, tratti lo split di training come "com’era il mondo quando ho costruito il modello". Lo split di test è "dati nuovi, mai visti". Il tuo scaler deve imparare il mondo solo dal primo.
La standardizzazione min-max è diretta: memorizza minimo e massimo del training per ogni colonna, poi applica la stessa mappatura in seguito.
scaler = MinMaxScaler()
scaler.fit(train_data)  # training only

train_scaled = scaler.transform(train_data)
test_scaled = scaler.transform(test_data)
Se ti capita di chiamare fit() sul test set, fermati. Questo vanifica lo scopo stesso di tenere da parte un test set.
StandardScaler memorizza media e deviazione standard dal training split e usa gli stessi valori per trasformare sia train che test.
scaler = StandardScaler()
scaler.fit(train_data)

train_standardized = scaler.transform(train_data)
test_standardized = scaler.transform(test_data)
Questo è quello che si rompe silenziosamente quando avviene leakage, perché media/dev std sono facili da "stabilizzare" usando per sbaglio più dati del dovuto.
RobustScaler fa lo stesso "fit una volta, riusa per sempre", ma usa mediana e IQR, così pochi punti estremi non dettano la scala.
scaler = RobustScaler()
scaler.fit(train_data)

train_robust = scaler.transform(train_data)
test_robust = scaler.transform(test_data)
Un indizio pratico che il robust scaling valga la pena: hai una lunga coda che vuoi davvero tenere (pagamenti, sinistri, picchi di sensori) e non vuoi che un giorno strano schiacci il resto della feature vicino allo zero.
Per lavoro esplorativo veloce, fare i conti direttamente in pandas va bene, purché tu sia onesto su cosa stai facendo: questo serve per dare un’occhiata alle distribuzioni, non per valutare modelli.
# Min-max
df_minmax = (data - data.min()) / (data.max() - data.min())

# Z-score
df_zscore = (data - data.mean()) / data.std()Pericolo qui: le statistiche sono basate sull’intero dataset. Se lo fai prima dello split, i valori di test influenzano la trasformazione. La valutazione perde significato perché il preprocessing ha già sbirciato risposte che non avrebbe dovuto vedere.
Lo schema di leakage in genere è questo:
Farlo nel modo sbagliato:
scaler = MinMaxScaler()
scaled_all = scaler.fit_transform(full_data)  # problem
train, test = split(scaled_all)
Questo approccio normalizza i dati prima dello split, quindi i dati di test hanno già influenzato la trasformazione.
Farlo nel modo giusto:
Suddividendo prima i dati, ci assicuriamo che lo scaler apprenda le statistiche solo dal training set, mantenendo il test davvero non visto.
scaler = MinMaxScaler()
scaler.fit(train_data)
train_scaled = scaler.transform(train_data)
test_scaled = scaler.transform(test_data)
Stesse operazioni, ordine diverso. E l’ordine è tutto il punto.
Se preferisci esercitarti end-to-end nel preprocessing (inclusa la standardizzazione corretta e l’evitare leakage), questo corso fa al caso tuo: Preprocessing for Machine Learning in Python.
Come detto prima, abbiamo significati diversi della stessa parola. Qui, “normalizzazione” non è una trasformazione numerica. È una decisione strutturale per smettere di duplicare fatti.
Se la tua tabella ordini memorizza customer_email in ogni riga, il database te lo permette. Il database accetterà anche contraddizioni in seguito: un’email in una riga, un’altra diversa in un’altra, e nessun modo ovvio per sapere quale sia “reale”.
Prima della normalizzazione:
CREATE TABLE orders_denormalized (
    order_id INT,
    customer_name VARCHAR(100),
    customer_email VARCHAR(100),
    product_name VARCHAR(100),
    product_price DECIMAL(10,2),
    quantity INT
);
I dettagli del cliente sono ripetuti in ogni riga. Aggiornare l’email significa trovare e modificare tutti i suoi ordini.
Dopo la normalizzazione:
CREATE TABLE customers (
    customer_id INT PRIMARY KEY,
    name VARCHAR(100),
    email VARCHAR(100)
);

CREATE TABLE products (
    product_id INT PRIMARY KEY,
    name VARCHAR(100),
    price DECIMAL(10,2)
);

CREATE TABLE orders (
    order_id INT PRIMARY KEY,
    customer_id INT REFERENCES customers(customer_id),
    product_id INT REFERENCES products(product_id),
    quantity INT
);
Le informazioni del cliente esistono una sola volta. Le query richiedono join, ma gli aggiornamenti avvengono in un unico punto.
Infine, voglio darti un quadro decisionale per la prossima volta che ti chiederai quale tecnica di normalizzazione usare.
Lo scaling min-max funziona meglio quando i tuoi dati hanno limiti noti e stabili che non cambieranno tra training e deploy. I valori dei pixel cadono sempre tra 0 e 255. I punteggi di probabilità non possono superare 1. I voti d’esame hanno minimi e massimi definiti.
Questo approccio si adatta anche quando il tuo modello si aspetta esplicitamente input limitati, come fanno alcune architetture di reti neurali. Evita però il min-max in presenza di outlier, perché un solo valore estremo può comprimere tutte le osservazioni normali in un intervallo stretto vicino allo zero.
La standardizzazione è una scelta di default ragionevole quando non hai forti assunzioni sui limiti o sulla distribuzione dei dati. Funziona bene per feature con intervalli variabili, limiti sconosciuti o distribuzioni circa a campana.
Molte implementazioni di algoritmo assumono o raccomandano input standardizzati, incluse la maggior parte dei framework per reti neurali e le librerie per regressione logistica. Se non sei sicuro quale approccio usare e i tuoi dati non hanno limiti naturali evidenti, la standardizzazione è di solito una scelta sicura.
Il robust scaling diventa la scelta giusta quando i tuoi dati contengono outlier significativi che rappresentano valori legittimi e non errori. I dati sulle transazioni finanziarie hanno tipicamente questa caratteristica: la maggior parte degli acquisti è piccola, ma occasionali spese elevate sono reali e dovrebbero rimanere nel dataset.
Distribuzioni dei redditi, letture di sensori con picchi occasionali e qualsiasi dato con forte asimmetria o code lunghe traggono vantaggio dal robust scaling. Mediana e IQR restano ancorati al grosso della distribuzione indipendentemente da ciò che accade agli estremi.
I modelli basati su alberi come random forest, XGBoost e gradient boosted trees dividono su soglie e non calcolano mai distanze o gradienti tra feature. La scala per loro è invisibile, quindi la normalizzazione aggiunge complessità senza benefici.
Le feature one-hot sono già binarie (0 e 1), quindi scalarle non serve a nulla. I dataset solo categoriali rientrano nella stessa categoria.
A volte, trasformazioni specifiche del dominio funzionano meglio delle normalizzazioni generiche:
Ecco una panoramica delle tecniche e dei loro casi d’uso:
Differenze di scala creano veri problemi per i modelli a cui importa. Le metriche di distanza favoriscono le feature a magnitudine elevata. La discesa del gradiente fa fatica quando i gradienti coprono ordini di grandezza. L’addestramento si blocca o esplode per ragioni non ovvie guardando solo il codice o l’architettura.
La normalizzazione risolve questo. Usa la min-max per dati con limiti, il robust scaling quando gli outlier sono reali e non possono essere rimossi, e la standardizzazione come default ragionevole. La meccanica è semplice: fai fit sul training, applica ovunque in modo coerente.
Per esperienza, ciò che costa tempo è non riconoscere quando lo scaling è importante, e poi fare debug del comportamento del modello per giorni quando la risposta era il preprocessing. O l’errore opposto, come applicare lo scaling in automatico a modelli a cui non interessa, aggiungendo complessità senza alcun beneficio.
Pronto a fare un salto di livello? Il nostro percorso completo Machine Learning Engineer ti insegna tutto ciò che devi sapere sul workflow di machine learning.
Corsi sulla normalizzazione dei dati
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



