
핵심 결과는 다음과 같습니다.
- 두 모델 모두 첫 시도에 장면을 올바르게 구현했습니다. 시간과 마우스 유니폼을 갖춘 실제 GLSL 프래그먼트 셰이더를 제공했고, 부드럽게 애니메이션되었으며, 한눈에 알아볼 수 있는 켈프 숲을 그렸습니다. 추가 지시는 필요하지 않았습니다.
- GPT-6.2 Sol의 장면이 더 현실적으로 보입니다. Opus 5.5의 버전은 다소 만화풍에 가깝게 느껴져, 브리프와의 일치도에서 한 점을 잃었습니다.
- 두 모델은 손전등의 다른 절반을 잘했습니다. Sol의 손전등은 장면 속으로 뻗어드는 3D 광원 원뿔처럼 느껴지는 반면, Opus 5.5의 손전등은 보다 평평한 2D 각도로 움직입니다. 하지만 Opus 5.5의 해조는 손전등을 피해 분명하고 즉각적으로 휘어지며, Sol의 밀려남 효과는 더 약합니다.
다음은 커서 근처의 줄기들이 눈에 띄게 비켜나는 Opus 5.5의 버전입니다.
장면의 브리프 일치도, 셰이더 품질, 커서 상호작용성, 효과가 실제 셰이더인지 여부를 기준으로 점수를 매겼습니다. 셰이더 품질과 기법은 둘 다 만점이었고, 차이가 난 항목은 다음과 같습니다.
| 지표 | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| 이번 실행 비용(USD) | $0.21 | $1.20 |
| 출력 토큰(추론 포함) | 16,476 | 44,996 |
| 심미적 일치도(주요 판별 기준) | 5 | 4 |
| 루브릭 점수(4개 축 평균) | 4.8 | 4.5 |
GPT-6.2 Sol은 현실감에서 근소하게 이겼으며, 이는 OpenAI의 "더 보기 좋은 3D 프런트엔드" 주장과 부합합니다. Sol은 광원 표현을, Opus 5.5는 밀쳐내기를 잘했고, 비용은 Sol이 약 1/6이었습니다.
이는 하나의 과제를 하나의 노력 설정에서 한 번씩 실행한 결과입니다. 두 모델 모두 기법 기준은 손쉽게 통과했으므로, 승부를 가른 것은 취향이었고 단일 실행이 암시할 수 있는 만큼만 말해줍니다.
GPT-6.2 Sol과 Claude Opus 5.5를 언제 선택할까
선택은 작업의 종류, 프롬프트 길이, 배포 환경에 달려 있습니다.
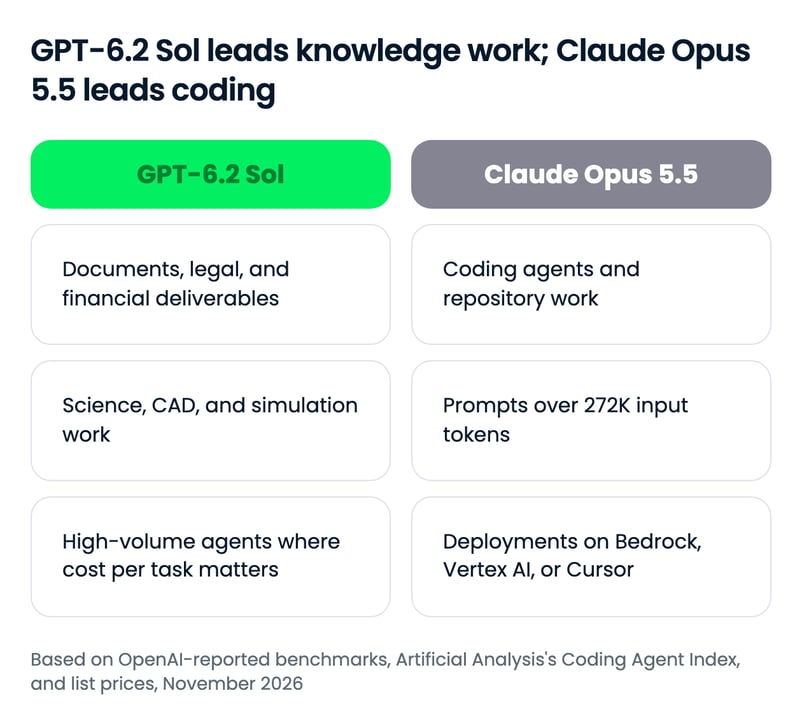
GPT-6.2 Sol을 기본값으로, Opus 5.5는 이유가 있을 때 선택하는 모델로 보시면 됩니다. 비용의 판도를 바꿀 수 있는 단 하나의 수치는 272K 토큰 임계값으로, 이를 넘으면 Sol의 할증으로 가격이 Opus 5.5에 근접합니다.
다음에 해당하면 GPT-6.2 Sol을 선택하세요
- 전문 산출물을 제작합니다. Sol은 GDPval v2에서 앞서고 Harvey의 법률 벤치마크에서는 Opus 5.5를 두 배 이상 상회합니다. 문서, 메모, 법률 초안이 주 무대입니다.
- 과학, CAD, 시뮬레이션 작업을 수행합니다. GPT-6.1 Sol이 Opus 5.5에 밀렸던 Terminal-Bench-Science와 BenchCAD에서 이제 선두입니다.
- 에이전트를 대량으로 운영합니다. OpenAI가 공개한 모든 차트에서 작업당 비용이 Opus 5.5의 일부에 불과하며, 여러 차트에서 high effort만으로도 최댓값에 근접한 점수를 냅니다.
- Codex, GitHub Copilot, Azure AI Foundry에서 작업합니다. GPT-6.2 Sol은 이미 이 세 곳 모두에 등록되어 있습니다.
다음에 해당하면 Claude Opus 5.5를 선택하세요
- 코딩 에이전트가 주요 워크로드입니다. Opus 5.5는 Artificial Analysis의 독립 Coding Agent Index에서 8점 앞서며, Anthropic의 Terminal-Bench 4.0과 CursorBench 결과에는 아직 GPT-6.2 Sol 대응 수치가 없습니다.
- 프롬프트가 272K 토큰을 자주 넘습니다. Opus 5.5는 롱 컨텍스트 할증이 없어, 코드베이스 전체를 담는 프롬프트의 비용이 두 모델에서 비슷합니다.
- Bedrock, Vertex AI, Cursor로 배포합니다. Opus 5.5는 세 곳 모두에 등록되어 있습니다. GPT-6.2 Sol은 Cursor 문서에 없고, 우리가 확인한 자료에서는 Bedrock이나 Vertex AI 등록도 찾지 못했습니다.
GPT-6.2 Sol과 Claude Opus 5.5 시작하기
접근성은 거의 동일하지만, OpenAI가 해당 플랫폼에서 자사 모델을 철수한 결정으로 GPT-6.2 Sol은 Cursor에서 사용할 수 없습니다.
| 접점 | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| 소비자용 앱 | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Claude 앱 |
| 퍼스트파티 API | OpenAI API | Claude API |
| 클라우드 플랫폼 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| 코딩 에이전트 | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| 서드파티 라우터 | OpenRouter | OpenRouter |
| API 모델 ID | gpt-6.2-sol | claude-opus-5-5 |
API 모델 ID는 gpt-6.2-sol과 claude-opus-5-5이며, OpenRouter에서는 openai/gpt-6.2-sol과 anthropic/claude-opus-5.5입니다.
첫 API 호출 만들기
두 모델을 가장 빠르게 시도하는 방법은 OpenRouter입니다. 모델 교체는 문자열 한 줄만 바꾸면 됩니다.
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)전체 빌드는 Opus 5.5 API 튜토리얼에서 처음부터 끝까지 에이전트 프로젝트를 따라가 보세요.
마무리
GPT-6.2 Sol은 Claude Opus 5.5보다 기본 선택지로 적합합니다. 공통 벤치마크의 절반가량에서 Opus 5.5를 앞서고, 나머지도 근소한 차이로 따라잡으면서 작업당 비용은 훨씬 저렴합니다. 코딩 에이전트, 매우 긴 프롬프트, Bedrock/Vertex AI/Cursor 배포에는 Opus 5.5가 여전히 맞습니다.
가장 흥미로운 점은 Sol의 가격이 변하지 않았다는 것입니다. OpenAI는 출력 토큰에서 승부를 냈습니다. Opus 5.5가 출시된 지 두 달 가까이 되어 현 속도에서는 아주 긴 시간처럼 느껴지므로, Anthropic의 다음 릴리스는 Sol과 품질과 효율에서 정면으로 맞붙을 것으로 봅니다.
두 모델 중 하나로 빌드하고 있다면, OpenAI Fundamentals 스킬 트랙이나 Introduction to Claude Models 과정을 추천드립니다.
FAQs
GPT-6.2 Sol이 Claude Opus 5.5보다 더 낫나요?
OpenAI 출시 차트에서 두 모델이 공유하는 대부분의 벤치마크에서는 그렇습니다. GPT-6.2 Sol은 Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA, BenchCAD에서 max effort 기준 Opus 5.5를 앞서며, 작업당 비용은 훨씬 낮습니다. 에이전틱 코딩에서는 Opus 5.5가 확실히 앞섭니다. 독립 Coding Agent Index에서 Opus 5.5는 58점, Sol은 50점입니다.
GPT-6.2 Sol은 Claude Opus 5.5보다 얼마나 저렴한가요?
GPT-6.2 Sol의 API 요금은 Opus 5.5의 절반입니다. 입력 100만 토큰당 $2 대 $4, 출력 100만 토큰당 $10 대 $20입니다. 작업당 최종 비용 격차는 더 큽니다. Sol이 출력 토큰을 더 적게 쓰기 때문입니다. 272K 입력 토큰을 넘는 프롬프트에서는 Sol의 할증으로 두 모델의 가격이 거의 비슷해집니다.
GPT-6.1 Sol과 GPT-6.2 Sol 사이에 무엇이 달라졌나요?
GPT-6.2 Sol은 GPT-6.1 Sol의 API 가격을 유지하면서 OpenAI의 대부분 벤치마크에서 더 높은 점수를 내고, 출력 토큰 사용량도 줄였습니다. Claude Opus 5.5 대비 가장 큰 변화는 Terminal-Bench-Science에서 뒤지던 것이 앞선 것으로, AutomationBench에서는 Opus 5.5의 우위가 약 1점으로 줄었습니다.
GPT-6.2 Sol과 Claude Opus 5.5는 어디에서 사용할 수 있나요?
GPT-6.2 Sol은 ChatGPT Work와 Codex(Plus, Pro, Enterprise, Edu 사용자), OpenAI API에서 사용할 수 있습니다. Claude Opus 5.5는 Claude 앱, Claude Code, Claude API, Cursor에서 사용할 수 있습니다. 둘 다 Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot, OpenRouter에서 이용 가능합니다.
GPT-6.2 Sol과 Claude Opus 5.5의 API 모델 ID는 무엇인가요?
OpenAI API 모델 ID는 gpt-6.2-sol, Claude API 모델 ID는 claude-opus-5-5입니다. OpenRouter에서는 openai/gpt-6.2-sol과 anthropic/claude-opus-5.5이므로, 동일한 클라이언트 코드에서 문자열 한 줄만 바꿔 모델을 전환할 수 있습니다.

Tom은 DataCamp의 데이터 사이언스 에디터입니다. 그는 AI 튜토리얼을 집필·편집하고, 새로운 LLM 출시 버전을 비교하며, AI 기반 워크플로를 구축합니다. 이전에는 도이치 텔레콤에서 데이터 사이언티스트로 근무했습니다. 업무 외에는 머신러닝으로 축구 경기를 예측합니다.
OpenAI가 GPT-6.2 Sol을 출시했습니다. GPT-6.2 제품군의 일상용 티어로, API 가격은 GPT-6.1 Sol과 정확히 같습니다. 우리가 GPT-6.1 Sol과 Claude Opus 5.5를 비교했을 때, 결론은 분명했습니다. 작업당 비용은 Sol, 최고 노력(max effort) 난이도의 하드 에이전트 런 성공률은 Opus 5.5. 그런데 OpenAI가 공개한 GPT-6.2 Sol의 출시 차트는 후자를 흔들고 있으며, 거의 모든 항목에서 Opus 5.5의 max effort 결과를 포함합니다.
이 글에서는 전문 업무와 과학, 코딩, 비즈니스 자동화, 가격을 기준으로 GPT-6.2 Sol과 Claude Opus 5.5를 비교한 뒤, 동일한 셰이더 빌드 과제로 두 모델을 직접 테스트합니다.
비교를 읽기 전에 GPT 모델의 작동 방식과 프롬프트 작성법을 더 정확히 이해하고 싶다면, GPT 모델의 아키텍처와 고급 프롬프트 작성법을 다루는 Intermediate ChatGPT 과정을 권합니다. AI와 데이터 분야 소식을 따라가려면 주간 뉴스레터 The Median 구독을 추천드립니다.
요약
GPT-6.2 Sol이란?
GPT-6.2 Sol은 OpenAI의 효율적인 중간급 추론 모델로, 2026년 11월 GPT-6.2 Astra와 함께 출시되었습니다.
OpenAI는 이를 일상 업무의 기본 모델로 소개하며, 강점은 효율성입니다. 높은 난이도의 작업에서 GPT-6.1 Sol보다 더 나은 결과를 더 적은 출력 토큰으로, 가격은 동일하게 제공합니다.
우리의 GPT-6.2 Astra 및 Sol 가이드는 전체 벤치마크와 두 가지 실습 테스트를 포함해 출시 내용을 다룹니다.
Claude Opus 5.5란?
Claude Opus 5.5는 2026년 9월 22일 출시된 Claude 5.5 제품군의 첫 모델로, 장시간 실행되는 에이전틱 코딩과 지식 업무를 위한 Anthropic의 모델입니다.
Anthropic은 대부분의 작업에서 Claude Fable 5.1 수준의 성능을 내면서 Opus 5 대비 운영 비용을 40% 낮췄다고 밝히며, 추론 모드를 끌 수 없도록 했습니다.
우리의 Claude Opus 5.5 가이드는 출시 내용을, Opus 5.5 API 튜토리얼은 AI 사건 조사 도구 구축 예제를 제공합니다.
GPT-6.2 Sol vs Claude Opus 5.5: 정면 비교
GPT-6.2 Sol은 이제 공통 벤치마크의 다수에서 Claude Opus 5.5보다 앞서며, Opus 5.5는 코딩과 자동화에서 근소 우위를 유지합니다.
GPT-6.1 Sol vs Opus 5.5 비교에서는 max effort 결과의 상당수를 Opus 5.5가 이끌었습니다. GPT-6.2 Sol에서는 OpenAI의 차트에 따르면 두 모델이 모두 등장한 9개 벤치마크 중 Sol이 5개에서 앞서고, 1개는 동률, 나머지 3개도 2점 미만 차이입니다. 예외는 코딩입니다. Artificial Analysis의 독립 Coding Agent Index에서는 Opus 5.5가 8점 앞섭니다.
전문 업무와 과학
여기서 6.1의 판정이 뒤집힙니다. 터미널에서 과학 작업을 시험하는 Terminal-Bench-Science 0.1에서 GPT-6.1 Sol은 max effort 기준으로 Opus 5.5에 6점 뒤졌습니다. GPT-6.2 Sol은 이제 68.0% 대 63.3%로 앞서며, 작업당 비용은 10분의 1도 안 됩니다.
OpenAI의 다른 전문 업무 차트들도 같은 방향을 가리킵니다.
장기 전문 워크플로를 시험하는 OpenAI의 Agents' Last Exam은 max effort에서 거의 무승부입니다. 이 차트에서 더 시사적인 점은 노력 단계입니다. Sol은 high effort에서 이미 Opus 5.5의 max를 넘고, 작업당 비용은 약 $0.69입니다.
문서, 법률 작업, CAD, 과학 분석에서는 이제 GPT-6.2 Sol이 더 저렴할 뿐 아니라, 가용 증거상 더 강력한 모델입니다.
코딩
코딩은 Opus 5.5가 여전히 명확히 앞서는 영역이며, 독립 수치에서는 OpenAI 차트보다 격차가 더 큽니다. FrontierCode, Terminal-Bench 4.1, SWE-Atlas-QnA를 결합한 Artificial Analysis의 Coding Agent Index에서, Claude Code의 Opus 5.5는 max effort로 58점을, Codex의 GPT-6.2 Sol은 최적 설정인 xhigh에서 50점을 기록합니다.
GPT-6.2 Sol의 해당 지수 점수는 사실 GPT-6.1 Sol보다 낮습니다. Artificial Analysis는 하락 원인을 SWE-Atlas-QnA에서 새 모델이 답변에 핵심 사실을 누락하는 경향이 커진 데서 찾습니다.
OpenAI의 자체 FrontierCode 2.0 차트에서는 max effort 기준으로 2점 미만의 격차입니다. 코딩 지수에서 max effort일 때 작업당 비용은 Opus 5.5가 약 10배 비싸지만(약 $12.60 대 약 $1.15), 결과의 정확성이 중요한 저장소 작업에는 Opus 5.5가 더 강합니다.
비즈니스 워크플로 자동화
비즈니스 앱 간 다단계 워크플로를 수행하는 에이전트를 시험하는 Zapier의 AutomationBench는 6.1 비교의 핵심이었습니다. Opus 5.5가 max effort에서 6점 앞섰죠. GPT-6.2 Sol에서는 그 격차가 1.4점으로 줄었습니다.
Sol은 일찍 평탄화됩니다. medium effort 이상에서 점수가 거의 같고, Opus 5.5는 꾸준히 상승해 max에서야 Sol을 앞지르는데, 이때 작업당 비용은 Sol의 약 5배입니다. 수천 건의 워크플로를 처리하는 지원 봇이나 세일즈 운영 에이전트에는 Sol이 이제 자명한 선택이며, 실패 비용이 가격 격차보다 큰 경우에만 Opus 5.5가 타당합니다.
일반 추론
Opus 5.5는 지식 업무, 코딩, 과학 전반 9개 평가를 종합한 Artificial Analysis Intelligence Index에서 근소한 우위를 유지합니다. xhigh effort의 Opus 5.5는 Sol의 max와 동률이며, 작업당 비용은 약 6배입니다. Vals Science Index에서는 동률이므로, 일반 추론은 약간 Anthropic 쪽으로 기우는 근소한 박빙입니다.
가격: 실제로 지불하는 비용
GPT-6.2 Sol은 토큰당 가격이 Opus 5.5의 절반이며, 작업당 최종 비용은 훨씬 더 저렴합니다.
GPT-6.2 Sol은 GPT-6.1 Sol의 요금을 유지하므로 토큰 단가 격차는 그대로입니다. 하지만 작업당 비용 격차는 달라졌습니다. Sol이 같은 일을 끝내는 데 필요한 출력 토큰이 줄었기 때문입니다. 아래의 단일 셰이더 실행에서도 같은 경향이 나타났습니다. Opus가 Sol보다 거의 6배 비쌌습니다($0.21 대 $1.20).
토큰 요금 나란히 보기
GPT-6.2 Sol은 프롬프트 입력 토큰이 272K를 넘기 전까지 표준 요금 전 항목에서 Opus 5.5의 정확히 절반입니다.
두 모델 모두 추론 토큰은 출력으로 과금하며, Opus 5.5의 사고(thinking)는 끌 수 없으므로 출력 요금이 가장 중요합니다.
실제 워크로드 비용은
각 합계는 (볼륨 ÷ 100만) × 요금을 입력과 출력에 대해 합산한 값입니다(표준 요금).
같은 작업의 비용이 달라지는 이유
두 모델은 서로 다른 토크나이저를 쓰지만, 더 큰 차이는 각 모델이 쓰는 출력 토큰 수입니다. OpenAI의 GDPval v2 차트에 따르면, max effort에서 Opus 5.5는 작업당 출력 토큰이 191,241개로 GPT-6.2 Sol(33,428개)보다 많고, high effort에서도 61,121 대 12,420입니다.
이는 OpenAI의 자체 측정치지만 두 모델을 직접 비교합니다. 균형형 어시스턴트 워크로드에서 Opus 5.5가 Sol보다 출력 토큰을 약 3배 썼다면(우리의 테스트에서도 그랬습니다), 월 비용은 Opus 5.5가 $19.00, Sol이 $4.50 정도가 됩니다.
그래서 요약 표의 작업당 비용 격차가 토큰 가격 2배 격차보다 훨씬 크게 벌어지는 것입니다.
GPT-6.2 Sol과 Claude Opus 5.5의 실제 수행
지금까지의 수치는 모두 OpenAI 차트에서 나왔으므로, 동일한 프롬프트와 동일한 도구로 두 모델에 같은 빌드 과제를 한 번씩 수행시켰습니다.
과제: 전체 창 크기의 애니메이션 GLSL 프래그먼트 셰이더로 구성된 황혼 무렵의 해조 숲(켈프 포레스트) 장면을 하나의 HTML 페이지에 구현하며, p5.js는 CDN에서 로드.
어려운 점은 장면 요소가 여러 개이며, 커서가 이들 전부에 변화를 주어야 한다는 것입니다.
이는 GPT-6.2가 3D 장면을 포함해 더 보기 좋고 잘 동작하는 프런트엔드를 만든다는 OpenAI의 주장을 점검합니다. 두 모델 모두 OpenCode에서 고정된 도구 표면(파일 읽기 및 편집만)과 높은 추론 노력으로 실행했으며, 각 모델은 새로운 세션에서 한 번씩 시도했고 프롬프트는 바이트 단위로 동일하게 전달했습니다.
다음은 GPT-6.2 Sol이 만든 결과입니다.