
Principalele constatări:
- Ambele au construit corect scena din prima încercare. Fiecare a furnizat un shader GLSL real de fragment cu uniforme de timp și mouse, animat cursiv, și a desenat o pădure de kelp pe care o recunoști dintr-o privire. Niciuna nu a avut nevoie de impulsuri.
- Scena GPT-6.2 Sol arată mai realist. Versiunea lui Opus 5.5 pare puțin mai caricaturală, ceea ce l-a costat un punct la cât de bine a corespuns scena cu cerința.
- Fiecare model a nimerit o jumătate diferită a lanternei. Lanterna lui Sol se simte ca un con de lumină 3D care pătrunde în scenă, în timp ce cea a lui Opus 5.5 se mișcă mai mult pe un unghi 2D plat. Dar kelpul lui Opus 5.5 se înclină departe de lanternă clar și receptiv, iar înclinarea departe a lui Sol e mai slabă.
Iată versiunea lui Opus 5.5, unde firele de lângă cursor cedează vizibil:
Le-am punctat pe amândouă după cât de îndeaproape scena a corespuns cerinței, calitatea shader-ului, interactivitatea cursorului și dacă efectul a fost un shader real. Calitatea și tehnica shader-ului au fost punctaj maxim pentru ambele; rândurile unde diferă:
| Măsură | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| Costul acestei rulari (USD) | $0,21 | $1,20 |
| Tokeni de ieșire (incl. raționament) | 16.476 | 44.996 |
| Potrivire estetică (discriminator primar) | 5 | 4 |
| Scor rubrică (media celor patru axe) | 4,8 | 4,5 |
GPT-6.2 Sol câștigă acest test la limită, pe realism, ceea ce se potrivește cu afirmația OpenAI despre front-end-uri 3D care arată mai bine. Sol a redat corect lumina, iar Opus 5.5 a redat corect împingerea, iar Sol a făcut-o la aproximativ o șesime din cost.
Aceasta este o singură rulare a unei singure sarcini la un singur nivel de efort. Ambele modele au trecut ușor de pragul tehnic, așa că ceea ce le-a separat a fost gustul, lucru pe care o singură rulare doar îl sugerează.
Când să alegi GPT-6.2 Sol vs Claude Opus 5.5
Alegerea se reduce la tipul de muncă, lungimea prompturilor și unde faci deployment.
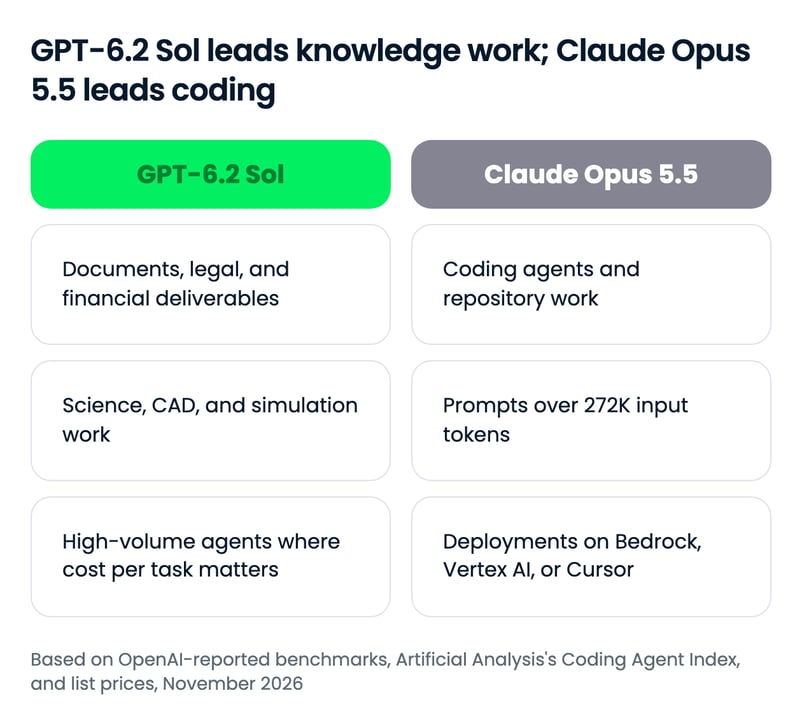
GPT-6.2 Sol ar trebui să fie implicitul tău, iar Opus 5.5 un model pe care îl alegi cu un motiv. Singurul număr care poate răsturna cazul de cost este pragul de 272K tokeni, peste care suprataxa lui Sol îl aduce aproape de prețul lui Opus 5.5.
Alege GPT-6.2 Sol dacă...
- Produci livrabile profesionale. Sol conduce pe GDPval v2 și mai mult decât dublează Opus 5.5 la benchmark-ul juridic al Harvey, deci documentele, notele și drafturile legale sunt terenul său.
- Rulezi muncă științifică, CAD sau de simulare. Conduce acum Terminal-Bench-Science și BenchCAD, două benchmark-uri unde GPT-6.1 Sol era în urmă față de Opus 5.5.
- Rulezi agenți la volum mare. Costul per sarcină este o fracțiune din cel al lui Opus 5.5 pe fiecare grafic publicat de OpenAI, iar pe mai multe grafice ale OpenAI obține scor aproape de maxim la efort high.
- Lucrezi în Codex, GitHub Copilot sau Azure AI Foundry. GPT-6.2 Sol este deja listat pe toate trei.
Alege Claude Opus 5.5 dacă...
- Agenții de coding sunt workload-ul tău principal. Opus 5.5 conduce cu 8 puncte pe Coding Agent Index independent al Artificial Analysis, iar rezultatele Anthropic pentru Terminal-Bench 4.0 și CursorBench nu au încă un corespondent GPT-6.2 Sol.
- Prompturile tale depășesc în mod obișnuit 272K tokeni. Opus 5.5 nu are suprataxă pentru context lung, astfel încât prompturile cu întregi codebase-uri costă cam la fel pe ambele.
- Faci deployment prin Bedrock, Vertex AI sau Cursor. Opus 5.5 este listat pe toate trei; GPT-6.2 Sol nu apare în documentația Cursor, iar în sursele noastre nu am găsit listare pe Bedrock sau Vertex AI.
Cum să începi cu GPT-6.2 Sol și Claude Opus 5.5
Accesul este aproape identic, cu excepția faptului că GPT-6.2 Sol nu este disponibil în Cursor, deoarece OpenAI a decis să-și retragă modelele de pe platformă.
| Suprafață | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Aplicație pentru consumatori | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Aplicațiile Claude |
| API de la primul furnizor | OpenAI API | Claude API |
| Platforme cloud | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agenți de coding | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Routere terțe | OpenRouter | OpenRouter |
| ID model API | gpt-6.2-sol | claude-opus-5-5 |
ID-urile modelelor API sunt gpt-6.2-sol și claude-opus-5-5; pe OpenRouter sunt openai/gpt-6.2-sol și anthropic/claude-opus-5.5.
Prima ta apelare API
Cel mai rapid mod de a le încerca pe ambele este OpenRouter, unde schimbarea modelelor este o schimbare de un singur string:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Pentru un build complet, tutorialul nostru API Opus 5.5 parcurge un proiect de agent de la început la sfârșit.
Gânduri finale
GPT-6.2 Sol ar trebui să fie alegerea implicită în fața lui Claude Opus 5.5. Îl depășește pe Opus 5.5 la aproximativ jumătate dintre benchmark-urile comune și se apropie pe restul la o fracțiune din costul per sarcină, ceea ce lasă Opus 5.5 drept alegerea pentru agenți de coding, prompturi foarte lungi și deployment-uri pe Bedrock, Vertex AI sau Cursor.
Ceea ce mi se pare cel mai interesant este că prețul lui Sol nu s-a schimbat: OpenAI a câștigat această rundă la tokenii de ieșire. Ține cont că Opus 5.5 este pe piață de aproape două luni, ceea ce se simte ca ani-lumină la ritmul actual, așa că mă aștept ca următoarea lansare a Anthropic să concureze cu Sol pe calitate și eficiență.
Dacă construiești pe oricare dintre modele, îți recomand OpenAI Fundamentals sau cursul nostru Introduction to Claude Models.
Întrebări frecvente
Este GPT-6.2 Sol mai bun decât Claude Opus 5.5?
Pe majoritatea benchmark-urilor comune din graficele de lansare ale OpenAI, da. GPT-6.2 Sol îl depășește pe Opus 5.5 la efort maxim pe Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA și BenchCAD, la mult mai puțin per sarcină. Opus 5.5 păstrează un avans clar la coding agentic: obține 58 față de 50 al lui Sol pe Coding Agent Index al Artificial Analysis, independent.
Cu cât e mai ieftin GPT-6.2 Sol decât Claude Opus 5.5?
Tarifele API ale GPT-6.2 Sol sunt la jumătate față de cele ale lui Opus 5.5: $2 vs $4 per milion de tokeni input și $10 vs $20 per milion de tokeni output. Per sarcină finalizată, decalajul e mai mare, deoarece Sol folosește mai puțini tokeni de ieșire. Pe prompturi peste 272K tokeni input, suprataxa lui Sol apropie cele două de același preț.
Ce s-a schimbat între GPT-6.1 Sol și GPT-6.2 Sol?
GPT-6.2 Sol păstrează prețurile API ale lui GPT-6.1 Sol, dar obține scoruri mai mari pe majoritatea benchmark-urilor OpenAI în timp ce folosește mai puțini tokeni de ieșire. Cele mai mari salturi față de Claude Opus 5.5 sunt pe Terminal-Bench-Science, unde Sol a trecut de la în urmă la în față, și pe AutomationBench, unde avansul lui Opus 5.5 s-a micșorat la aproximativ un punct.
Unde pot folosi GPT-6.2 Sol și Claude Opus 5.5?
GPT-6.2 Sol este în ChatGPT Work și Codex pentru utilizatorii Plus, Pro, Enterprise și Edu, și în OpenAI API. Claude Opus 5.5 este în aplicațiile Claude, Claude Code, Claude API și Cursor. Ambele sunt disponibile pe Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot și OpenRouter.
Care sunt ID-urile de model API pentru GPT-6.2 Sol și Claude Opus 5.5?
ID-ul modelului în OpenAI API este gpt-6.2-sol, iar ID-ul modelului în Claude API este claude-opus-5-5. Pe OpenRouter, cele două modele sunt openai/gpt-6.2-sol și anthropic/claude-opus-5.5, deci poți comuta între ele schimbând un singur string în același client.

Tom este Editor în Data Science la DataCamp. Scrie și editează tutoriale despre AI, compară noile versiuni de LLM și creează fluxuri de lucru bazate pe AI. Anterior, a lucrat în data science la Deutsche Telekom. În afara serviciului, face prognoze la meciuri de fotbal folosind învățarea automată.
OpenAI a lansat GPT-6.2 Sol, nivelul de zi cu zi al familiei GPT-6.2, la exact aceleași prețuri API ca GPT-6.1 Sol. Când am comparat GPT-6.1 Sol cu Claude Opus 5.5, împărțirea era clară: Sol pentru costul per sarcină, Opus 5.5 pentru cea mai mare rată de succes la rulările de agenți dificile la efort maxim. Graficele de lansare ale OpenAI pentru GPT-6.2 Sol pun sub semnul întrebării a doua jumătate, și includ Opus 5.5 la efort maxim pe aproape fiecare dintre ele.
În acest articol, voi compara GPT-6.2 Sol și Claude Opus 5.5 pe munca profesională și știință, coding, automatizare de business și prețuri, apoi le voi rula pe ambele pe același build practic de shader.
Dacă vrei o înțelegere mai fermă a modului în care funcționează modelele GPT și cum să le faci prompting eficient înainte de a citi comparația, îți recomand cursul Intermediate ChatGPT, care acoperă arhitectura din spatele modelelor GPT și scrierea avansată de prompturi. Pentru a ține pasul cu zona AI și data, îți recomand să te abonezi la newsletterul nostru săptămânal, The Median.
Pe scurt
Ce este GPT-6.2 Sol?
GPT-6.2 Sol este modelul eficient, de nivel mediu pentru raționare al OpenAI, lansat în noiembrie 2026 alături de GPT-6.2 Astra.
OpenAI îl numește modelul de bază pentru munca de zi cu zi, iar argumentul său este eficiența: rezultate mai bune decât GPT-6.1 Sol pe sarcini solicitante cu mai puțini tokeni de ieșire, la prețuri neschimbate.
Ghidul nostru GPT-6.2 Astra și Sol acoperă lansarea, cu setul complet de benchmark-uri și două teste practice.
Ce este Claude Opus 5.5?
Claude Opus 5.5 este modelul Anthropic pentru coding agentic de lungă durată și muncă bazată pe cunoaștere, lansat pe 22 septembrie 2026, ca primul model din familia Claude 5.5.
Anthropic îl poziționează la nivelul Claude Fable 5.1 pe majoritatea lucrărilor, în timp ce costă cu 40% mai puțin de rulat decât Opus 5, iar gândirea sa nu mai poate fi dezactivată.
Ghidul nostru Claude Opus 5.5 acoperă lansarea; tutorialul API Opus 5.5 construiește cu el un investigator AI de incidente.
GPT-6.2 Sol vs Claude Opus 5.5: comparație directă
GPT-6.2 Sol conduce acum Claude Opus 5.5 pe majoritatea benchmark-urilor comune, iar Opus 5.5 păstrează avantaje mici la coding și automatizare.
În comparația GPT-6.1 Sol vs Opus 5.5, Opus 5.5 conducea majoritatea rezultatelor la efort maxim. Cu GPT-6.2 Sol, graficele OpenAI arată Sol în față pe 5 din cele 9 benchmark-uri pe care apar ambele modele, la egalitate pe 1 și la mai puțin de 2 puncte în urmă pe celelalte 3. Excepția este coding-ul: pe Coding Agent Index al Artificial Analysis, independent, Opus 5.5 conduce cu 8 puncte.
Muncă profesională și știință
Aici se inversează verdictul de la 6.1. GPT-6.1 Sol era în urmă față de Opus 5.5 pe Terminal-Bench-Science 0.1, care testează munca științifică în terminal, cu 6 puncte la efort maxim. GPT-6.2 Sol îl conduce acum, 68,0% la 63,3%, la mai puțin de o zecime din costul per sarcină.
Restul graficelor OpenAI pentru munca profesională arată în aceeași direcție:
Agents' Last Exam, testul OpenAI pentru fluxuri de lucru profesionale cu orizont lung, este aproape egal la efort maxim. Punctul mai grăitor pe acel grafic este efortul: Sol la efort high este deja peste Opus 5.5 la max, pentru aproximativ $0,69 per sarcină.
Pentru documente, muncă juridică, CAD și analiză științifică, GPT-6.2 Sol este acum modelul mai puternic pe baza dovezilor disponibile, nu doar cel mai ieftin.
Coding
Coding-ul este zona unde Opus 5.5 încă are un avans clar, iar cifrele independente pun decalajul bine peste ce arată graficul OpenAI. Pe Coding Agent Index al Artificial Analysis, care combină FrontierCode, Terminal-Bench 4.1 și SWE-Atlas-QnA, Opus 5.5 în Claude Code obține 58 la efort max, față de 50 pentru GPT-6.2 Sol în Codex la cea mai bună setare, xhigh.
GPT-6.2 Sol obține de fapt un scor mai mic pe acel index decât GPT-6.1 Sol. Artificial Analysis pune scăderea pe seama SWE-Atlas-QnA, unde noul model e mai predispus să omită fapte cheie din răspunsuri.
Graficul intern OpenAI pentru FrontierCode 2.0 arată un decalaj sub 2 puncte la efort maxim. Opus 5.5 costă cam de zece ori mai mult per sarcină la efort maxim pe indexul de coding (aprox. $12,60 față de aprox. $1,15), dar pentru lucru pe depozite unde rezultatul trebuie să fie corect, este modelul mai puternic.
Automatizarea fluxurilor de lucru de business
AutomationBench, testul Zapier pentru agenți care rulează fluxuri de lucru multistep în aplicații de business, a fost titlul comparației 6.1: Opus 5.5 conducea cu 6 puncte la efort maxim. Cu GPT-6.2 Sol, decalajul a scăzut la 1,4 puncte.
Sol se aplatizează și mai devreme. Obține cam același scor de la efort medium în sus, în timp ce Opus 5.5 urcă constant și îl depășește pe Sol doar la max, unde fiecare sarcină costă de aproximativ cinci ori mai mult. Pentru un bot de suport sau un agent de sales-ops care rulează mii de fluxuri, Sol este acum alegerea evidentă; Opus 5.5 are sens doar acolo unde o rulare eșuată costă mai mult decât diferența de preț.
Raționament general
Opus 5.5 păstrează un mic avans pe Artificial Analysis Intelligence Index, un compozit din 9 evaluări în munca bazată pe cunoaștere, coding și știință. La efort xhigh, Opus 5.5 este la nivel cu Sol la max, pentru cam de șase ori costul per sarcină. Ei sunt la egalitate pe Vals Science Index, deci raționamentul general e aproape la paritate, cu o ușoară înclinare spre Anthropic.
Prețuri: ce plătești de fapt
GPT-6.2 Sol costă jumătate față de Opus 5.5 pe token și mult mai puțin per sarcină finalizată.
GPT-6.2 Sol păstrează tarifele lui GPT-6.1 Sol, deci decalajul de preț pe token e același ca înainte. Decalajul de cost per sarcină nu este, deoarece Sol are nevoie acum de mai puțini tokeni de ieșire pentru a finaliza aceeași muncă. Propria noastră rulare unică de shader, detaliată mai jos, arată la fel, cu Opus fiind aproape de 6x mai scump decât Sol ($0,21 față de $1,20).
Tarife pe token, alăturat
GPT-6.2 Sol costă exact jumătate din Opus 5.5 pe fiecare tarif standard, până când un prompt depășește 272K tokeni de input:
Ambele modele facturează tokenii de raționament ca output, iar gândirea lui Opus 5.5 nu poate fi dezactivată, așa că rata de ieșire este cea care contează cel mai mult.
Cât costă o încărcare reală de lucru
Fiecare total este (volum ÷ 1M) × tarif, însumat pe input și output, la tarife standard.
De ce aceeași sarcină costă sume diferite
Cele două modele folosesc tokenizatoare diferite, dar diferența mai mare este câți tokeni de ieșire consumă fiecare. Graficul GDPval v2 al OpenAI îl pune pe Opus 5.5 la 191.241 tokeni de ieșire per sarcină la efort max față de 33.428 pentru GPT-6.2 Sol, și la 61.121 față de 12.420 la efort high.
Acestea sunt măsurători ale OpenAI, dar compară direct subiecții. Dacă Opus 5.5 ar avea nevoie de aproximativ de 3 ori tokenii de ieșire ai lui Sol pe workload-ul de asistent echilibrat, cum a fost în propriul nostru test, factura sa lunară ar fi $19,00 față de $4,50 a lui Sol.
De aceea decalajele de cost per sarcină din tabelul de sumar sunt mult mai mari decât decalajul de 2x al prețului pe token.
Cum au performat GPT-6.2 Sol și Claude Opus 5.5
Fiecare număr de până acum vine din graficele OpenAI, așa că am rulat o sarcină de build pe ambele modele cu un prompt identic și unelte identice.
Sarcina: o singură pagină HTML cu un shader GLSL de fragment, pe tot ecranul, animat, al unei păduri de kelp subacvatice la amurg, găzduit de p5.js încărcat dintr-un CDN.
Partea grea este că scena are mai multe elemente, iar cursorul trebuie să le schimbe pe toate:
Testează afirmația OpenAI că GPT-6.2 construiește front-end-uri care arată și funcționează mai bine, inclusiv scene 3D. Ambele modele au rulat în OpenCode cu o suprafață de unelte „pinuită” (doar citire și editare fișiere), la efort de raționare high, cu câte o încercare fiecare într-o sesiune nouă și promptul livrat byte-cu-byte.
Iată ce a construit GPT-6.2 Sol: