
ข้อค้นพบหลัก:
- ทั้งสองสร้างฉากได้ถูกต้องตั้งแต่ครั้งแรก แต่ละโมเดลส่ง GLSL fragment shader จริงที่มียูนิเฟิร์มเวลาและเมาส์ แอนิเมชันลื่นไหล และวาดป่ากอเคลป์ที่มองออกทันทีว่าเป็นอะไร โดยไม่ต้องคอยจี้
- ฉากของ GPT-6.2 Sol ดูสมจริงกว่า เวอร์ชันของ Opus 5.5 ออกโทนการ์ตูนเล็กน้อย จึงเสียคะแนนในด้านความสอดคล้องกับบรีฟ
- แต่ละโมเดลทำไฟฉายถูกคนละครึ่ง ไฟฉายของ Sol ให้ความรู้สึกเป็นกรวยแสง 3 มิติที่พุ่งเข้าไปในฉาก ขณะที่ของ Opus 5.5 เคลื่อนที่ไปตามมุมราบ 2 มิติมากกว่า แต่สาหร่ายของ Opus 5.5 โค้งหนีไฟฉายอย่างชัดและตอบสนองดี ส่วนของ Sol โค้งหนีอ่อนกว่า
นี่คือเวอร์ชันของ Opus 5.5 ที่เส้นใกล้เคอร์เซอร์เห็นได้ชัดว่าแหวกทาง:
ให้คะแนนทั้งสองจากความสอดคล้องกับบรีฟ คุณภาพเชดเดอร์ ปฏิสัมพันธ์กับเคอร์เซอร์ และว่าเอฟเฟ็กต์เป็นเชดเดอร์จริงหรือไม่ คุณภาพและเทคนิคของเชดเดอร์ได้เต็มทั้งคู่ แถวที่ต่างกันมีดังนี้:
| ตัวชี้วัด | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| ต้นทุนครั้งนี้ (USD) | $0.21 | $1.20 |
| โทเคนเอาต์พุต (รวมการให้เหตุผล) | 16,476 | 44,996 |
| ความตรงตามสุนทรียะ (ตัวชี้วัดหลัก) | 5 | 4 |
| คะแนนรูบริก (ค่าเฉลี่ย 4 แกน) | 4.8 | 4.5 |
GPT-6.2 Sol ชนะการทดสอบนี้อย่างเฉียดฉิวด้วยความสมจริง ซึ่งสอดคล้องกับข้ออ้างของ OpenAI เรื่องเฟรอนต์เอนด์ 3 มิติที่ดูดีกว่า Sol ทำด้านแสงได้ถูก ส่วน Opus 5.5 ทำด้านแรงผลักถูก และ Sol ทำได้ที่ต้นทุนราวหนึ่งในหก
นี่คือการรันครั้งเดียวของงานเดียว ที่ระดับความพยายามเดียว ทั้งสองข้ามบาร์ด้านเทคนิคได้สบาย ดังนั้นสิ่งที่แยกกันออกคือรสนิยม ซึ่งการรันครั้งเดียวบอกได้เพียงเค้าเงา
ควรเลือก GPT-6.2 Sol หรือ Claude Opus 5.5 เมื่อใด
การเลือกขึ้นกับลักษณะงาน ความยาวของพรอมป์ต และแพลตฟอร์มที่ดีพลอย
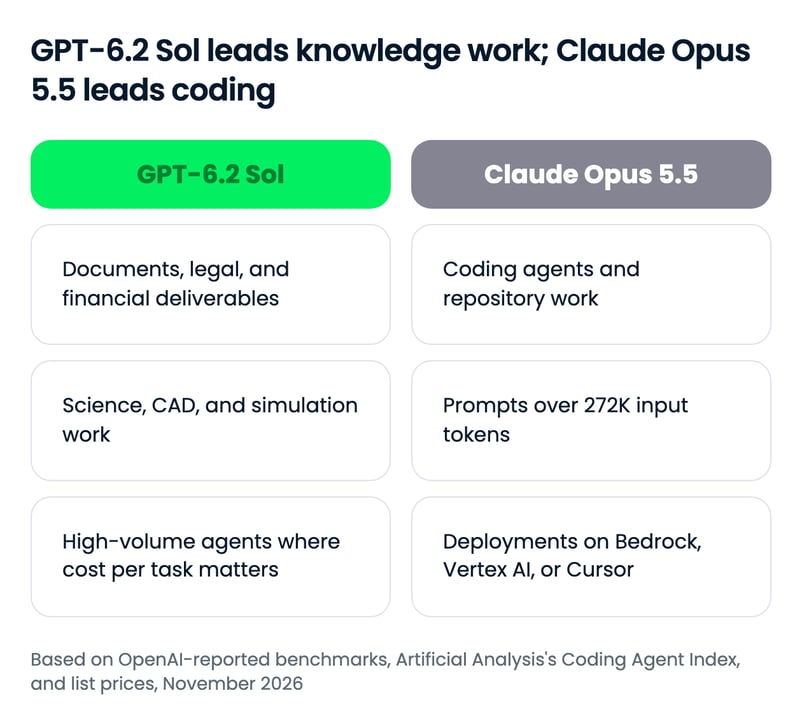
ควรตั้ง GPT-6.2 Sol เป็นค่าเริ่มต้น และเลือก Opus 5.5 เมื่อมีเหตุผล ตัวเลขเดียวที่อาจพลิกกรณีต้นทุนคือเกณฑ์ 272K โทเคน ที่เหนือจากนั้น ค่าบริการเสริมของ Sol ทำให้ราคาเข้าใกล้ของ Opus 5.5
เลือก GPT-6.2 Sol หาก...
- ผลิตงานส่งมอบระดับวิชาชีพ Sol นำบน GDPval v2 และทำคะแนนในเบนช์มาร์กกฎหมายของ Harvey ได้มากกว่า Opus 5.5 กว่าสองเท่า เอกสาร บันทึก และร่างงานกฎหมายคือถิ่นถนัด
- รันงานวิทยาศาสตร์ CAD หรือการจำลอง ตอนนี้นำบน Terminal-Bench-Science และ BenchCAD ซึ่งเป็นสองเบนช์มาร์กที่ GPT-6.1 Sol เคยตามหลัง Opus 5.5
- รันเอเจนต์ปริมาณสูง ต้นทุนต่อภารกิจต่ำกว่า Opus 5.5 เพียงเศษเสี้ยวในทุกชาร์ตของ OpenAI และบนหลายชาร์ตทำคะแนนใกล้ระดับสูงสุดตั้งแต่ความพยายาม high
- ทำงานใน Codex, GitHub Copilot หรือ Azure AI Foundry GPT-6.2 Sol มีรายชื่ออยู่ทั้งสามแล้ว
เลือก Claude Opus 5.5 หาก...
- เอเจนต์เขียนโค้ดคือเวิร์กโหลดหลัก Opus 5.5 นำบน Coding Agent Index ของ Artificial Analysis อยู่ 8 คะแนน และผลของ Terminal-Bench 4.0 และ CursorBench ของ Anthropic ยังไม่มีคู่เทียบสำหรับ GPT-6.2 Sol
- พรอมป์ตเกิน 272K โทเคนเป็นประจำ Opus 5.5 ไม่มีค่าบริการบริบทยาว ดังนั้นพรอมป์ตทั้งโค้ดเบสมีต้นทุนใกล้เคียงกันทั้งสอง
- ดีพลอยผ่าน Bedrock, Vertex AI หรือ Cursor Opus 5.5 มีรายชื่ออยู่ครบ; GPT-6.2 Sol ไม่อยู่ในเอกสาร Cursor และไม่พบรายชื่อใน Bedrock หรือ Vertex AI จากแหล่งข้อมูลของเรา
เริ่มต้นใช้งาน GPT-6.2 Sol และ Claude Opus 5.5 อย่างไร
การเข้าถึงเกือบเหมือนกัน ยกเว้น GPT-6.2 Sol ไม่พร้อมใช้ใน Cursor เพราะ OpenAI ตัดสินใจถอดโมเดลออกจากแพลตฟอร์มนั้น
| พื้นผิวการใช้งาน | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| แอปผู้ใช้ทั่วไป | ChatGPT Work (Plus, Pro, Enterprise, Edu) | แอป Claude |
| API ต้นทาง | OpenAI API | Claude API |
| แพลตฟอร์มคลาวด์ | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| เอเจนต์เขียนโค้ด | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| รูตเตอร์ภายนอก | OpenRouter | OpenRouter |
| API model ID | gpt-6.2-sol | claude-opus-5-5 |
API model ID คือ gpt-6.2-sol และ claude-opus-5-5; บน OpenRouter คือ openai/gpt-6.2-sol และ anthropic/claude-opus-5.5
เรียก API ครั้งแรก
วิธีลองทั้งสองที่เร็วที่สุดคือ OpenRouter ที่สลับโมเดลได้ด้วยการเปลี่ยนสตริงเดียว:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)สำหรับโปรเจกต์เต็มรูปแบบ บทเรียน API ของ Opus 5.5 จะพาเดินผ่านโปรเจกต์เอเจนต์ตั้งแต่ต้นจนจบ
ข้อคิดส่งท้าย
GPT-6.2 Sol ควรเป็นตัวเลือกเริ่มต้นเหนือ Claude Opus 5.5 มันชนะ Opus 5.5 บนเบนช์มาร์กร่วมกันราวครึ่งหนึ่ง และทำคะแนนไล่จี้ที่เหลือด้วยต้นทุนต่อภารกิจเพียงเศษเสี้ยว เหลือให้ Opus 5.5 เป็นตัวเลือกสำหรับเอเจนต์เขียนโค้ด พรอมป์ตที่ยาวมาก และการดีพลอยผ่าน Bedrock, Vertex AI หรือ Cursor
สิ่งที่น่าสนใจคือราคา Sol ไม่ได้เปลี่ยน: OpenAI ชนะรอบนี้ด้วยจำนวนโทเคนเอาต์พุต โปรดจำไว้ว่า Opus 5.5 เปิดตัวมากว่าเกือบสองเดือนแล้ว ซึ่งในจังหวะปัจจุบันถือว่านานมาก คาดว่า Anthropic รุ่นถัดไปจะออกมาแข่งกับ Sol ทั้งด้านคุณภาพและประสิทธิภาพ
หากกำลังพัฒนาบนโมเดลใดโมเดลหนึ่ง แนะนำ เส้นทางทักษะ OpenAI Fundamentals หรือคอร์ส Introduction to Claude Models ของเรา
คำถามที่พบบ่อย (FAQs)
GPT-6.2 Sol ดีกว่า Claude Opus 5.5 ไหม?
บนเบนช์มาร์กส่วนใหญ่ที่ทั้งสองมีในชาร์ตเปิดตัวของ OpenAI ใช่ GPT-6.2 Sol ชนะ Opus 5.5 ที่ความพยายามสูงสุดบน Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA และ BenchCAD ด้วยต้นทุนต่อภารกิจที่ต่ำกว่ามาก Opus 5.5 ยังคงนำชัดเจนด้านการเขียนโค้ดแบบเอเจนต์ โดยได้ 58 ต่อ 50 ของ Sol บน Coding Agent Index ของ Artificial Analysis ที่เป็นอิสระ
GPT-6.2 Sol ถูกกว่า Claude Opus 5.5 แค่ไหน?
อัตรา API ของ GPT-6.2 Sol ต่ำกว่า Opus 5.5 ครึ่งหนึ่ง: $2 เทียบกับ $4 ต่อหนึ่งล้านโทเคนอินพุต และ $10 เทียบกับ $20 ต่อหนึ่งล้านโทเคนเอาต์พุต ส่วนต้นทุนต่อภารกิจยิ่งห่าง เพราะ Sol ใช้โทเคนเอาต์พุตน้อยกว่า บนพรอมป์ตที่เกิน 272K โทเคนอินพุต ค่าบริการเสริมของ Sol ทำให้สองโมเดลมีราคาใกล้กัน
อะไรที่เปลี่ยนไประหว่าง GPT-6.1 Sol กับ GPT-6.2 Sol?
GPT-6.2 Sol คงราคา API ของ GPT-6.1 Sol ไว้ แต่ทำคะแนนสูงกว่าบนเบนช์มาร์กส่วนใหญ่ของ OpenAI และใช้โทเคนเอาต์พุตน้อยลง การกระโดดที่ใหญ่สุดเมื่อเทียบกับ Claude Opus 5.5 คือบน Terminal-Bench-Science ที่ Sol พลิกจากตามหลังเป็นนำหน้า และบน AutomationBench ที่ช่องว่างของ Opus 5.5 หดเหลือประมาณหนึ่งคะแนน
ใช้ GPT-6.2 Sol และ Claude Opus 5.5 ได้ที่ไหนบ้าง?
GPT-6.2 Sol ใช้ได้ใน ChatGPT Work และ Codex สำหรับผู้ใช้ Plus, Pro, Enterprise และ Edu และใน OpenAI API ส่วน Claude Opus 5.5 ใช้ได้ในแอป Claude, Claude Code, Claude API และ Cursor ทั้งคู่มีใน Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot และ OpenRouter
API model ID ของ GPT-6.2 Sol และ Claude Opus 5.5 คืออะไร?
OpenAI API model ID คือ gpt-6.2-sol และ Claude API model ID คือ claude-opus-5-5 บน OpenRouter สองโมเดลคือ openai/gpt-6.2-sol และ anthropic/claude-opus-5.5 จึงสลับโมเดลได้โดยเปลี่ยนสตริงเดียวในโค้ดไคลเอนต์ชุดเดียวกัน

Tom เป็นบรรณาธิการด้านวิทยาการข้อมูลที่ DataCamp ทำหน้าที่เขียนและบรรณาธิการบทช่วยสอนด้าน AI เปรียบเทียบการเปิดตัว LLM รุ่นใหม่ และสร้างเวิร์กโฟลว์ที่ขับเคลื่อนด้วย AI ก่อนหน้านี้เคยทำงานด้านวิทยาการข้อมูลที่ Deutsche Telekom นอกเวลางานใช้การเรียนรู้ของเครื่องพยากรณ์ผลการแข่งขันฟุตบอล
OpenAI ได้เปิดตัว GPT-6.2 Sol รุ่นสำหรับงานประจำของตระกูล GPT-6.2 ในราคาค่า API เดียวกับ GPT-6.1 Sol เป๊ะ เมื่อตอนที่เรา เปรียบเทียบ GPT-6.1 Sol กับ Claude Opus 5.5 บทสรุปชัดเจน: Sol เด่นเรื่องต้นทุนต่อภารกิจ ส่วน Opus 5.5 เด่นเรื่องอัตราความสำเร็จสูงสุดในการรันเอเจนต์งานยากที่ระดับความพยายามสูงสุด ชาร์ตเปิดตัวของ OpenAI สำหรับ GPT-6.2 Sol ทำให้ครึ่งหลังนั้นน่าสงสัยขึ้น และยังใส่ตัวเลขของ Opus 5.5 ที่ความพยายามสูงสุดไว้แทบทุกชุดทดสอบ
ในบทความนี้ จะเปรียบเทียบ GPT-6.2 Sol และ Claude Opus 5.5 ครอบคลุมงานวิชาชีพและวิทยาศาสตร์ การเขียนโค้ด ระบบอัตโนมัติทางธุรกิจ และราคา แล้วจึงรันทั้งคู่บนงานสร้างเชดเดอร์แบบลงมือทำเดียวกัน
หากต้องการจับหลักการทำงานของโมเดล GPT และวิธีพิมพ์พรอมป์ตให้ได้ผลก่อนอ่านการเปรียบเทียบ แนะนำคอร์ส Intermediate ChatGPT ที่ครอบคลุมสถาปัตยกรรมเบื้องหลังโมเดล GPT และการเขียนพรอมป์ตขั้นสูง หากต้องการติดตามข่าวสารวงการ AI และข้อมูล แนะนำสมัครจดหมายข่าวรายสัปดาห์ The Median
สรุปสั้นๆ
GPT-6.2 Sol คืออะไร?
GPT-6.2 Sol คือโมเดลให้เหตุผลระดับกลางที่มีประสิทธิภาพของ OpenAI เปิดตัวในเดือนพฤศจิกายน 2026 พร้อมกับ GPT-6.2 Astra
OpenAI วางตำแหน่งให้เป็นโมเดลหลักสำหรับงานประจำ จุดเด่นคือความคุ้มค่า: ให้ผลลัพธ์ดีกว่า GPT-6.1 Sol บนงานที่ท้าทาย โดยใช้โทเคนเอาต์พุตน้อยลง และราคาคงเดิม
คู่มือ GPT-6.2 Astra และ Sol ของเราครอบคลุมการเปิดตัว ชุดเบนช์มาร์กเต็ม และการทดสอบแบบลงมือทำสองงาน
Claude Opus 5.5 คืออะไร?
Claude Opus 5.5 คือโมเดลของ Anthropic สำหรับการเขียนโค้ดแบบเอเจนต์ระยะยาวและงานความรู้ เปิดตัวเมื่อ 22 กันยายน 2026 เป็นรุ่นแรกในตระกูล Claude 5.5
Anthropic จัดวางไว้ในระดับเดียวกับ Claude Fable 5.1 บนงานส่วนใหญ่ โดยมีต้นทุนรันต่ำกว่า Opus 5 อยู่ 40% และโหมดคิดไม่สามารถปิดได้แล้ว
คู่มือ Claude Opus 5.5 ของเรา ครอบคลุมการเปิดตัว ส่วน บทเรียน API ของ Opus 5.5 สร้างเอเจนต์สืบสวนเหตุการณ์ด้วยโมเดลนี้
GPT-6.2 Sol เทียบกับ Claude Opus 5.5: เปรียบเทียบกันตรงๆ
GPT-6.2 Sol ตอนนี้นำหน้า Claude Opus 5.5 บนเบนช์มาร์กที่ใช้ร่วมกันส่วนใหญ่ และ Opus 5.5 รักษาช่องว่างเล็กน้อยด้านการเขียนโค้ดและระบบอัตโนมัติ
ใน การเปรียบเทียบ GPT-6.1 Sol กับ Opus 5.5 ของเรา Opus 5.5 นำในหลายผลลัพธ์ที่ความพยายามสูงสุด สำหรับ GPT-6.2 Sol ชาร์ตของ OpenAI แสดงว่า Sol นำหน้าใน 5 จาก 9 เบนช์มาร์กที่ทั้งคู่ปรากฏ อยู่ระดับเดียวกัน 1 รายการ และตามไม่ถึง 2 คะแนนในอีก 3 รายการ ยกเว้นการเขียนโค้ด: บน Coding Agent Index ของ Artificial Analysis ที่เป็นอิสระ Opus 5.5 นำอยู่ 8 คะแนน
งานวิชาชีพและวิทยาศาสตร์
นี่คือจุดที่คำตัดสินของรุ่น 6.1 พลิก กลับกัน GPT-6.1 Sol ตามหลัง Opus 5.5 บน Terminal-Bench-Science 0.1 ซึ่งทดสอบงานวิทยาศาสตร์ในเทอร์มินัล อยู่ 6 คะแนนที่ความพยายามสูงสุด GPT-6.2 Sol ตอนนี้นำอยู่ 68.0% ต่อ 63.3% ที่ต้นทุนต่อภารกิจไม่ถึงหนึ่งในสิบ
ชาร์ตงานวิชาชีพอื่นๆ ของ OpenAI ก็ชี้ไปทิศทางเดียวกัน:
Agents' Last Exam การทดสอบเวิร์กโฟลว์วิชาชีพระยะยาวของ OpenAI คะแนนสูสีที่ความพยายามสูงสุด จุดที่บอกเล่ามากกว่าคือระดับความพยายาม: Sol ที่ระดับ high ทำคะแนนเหนือ Opus 5.5 ที่ max แล้ว ที่ต้นทุนประมาณ $0.69 ต่อภารกิจ
สำหรับเอกสาร งานกฎหมาย CAD และการวิเคราะห์เชิงวิทยาศาสตร์ จากหลักฐานที่มี GPT-6.2 Sol ตอนนี้เป็นโมเดลที่แข็งแกร่งกว่า ไม่ใช่แค่ถูกกว่า
การเขียนโค้ด
ด้านการเขียนโค้ด Opus 5.5 ยังนำชัดเจน และตัวเลขอิสระชี้ว่าช่องว่างมากกว่าที่ชาร์ตของ OpenAI แสดง บน Coding Agent Index ของ Artificial Analysis ซึ่งผนวก FrontierCode, Terminal-Bench 4.1 และ SWE-Atlas-QnA Opus 5.5 ใน Claude Code ได้ 58 ที่ความพยายามสูงสุด เทียบกับ 50 สำหรับ GPT-6.2 Sol ใน Codex ที่การตั้งค่าดีที่สุด xhigh
GPT-6.2 Sol ทำคะแนนบนดัชนีนี้ต่ำกว่า GPT-6.1 Sol ด้วยซ้ำ Artificial Analysis ระบุว่าตกจาก SWE-Atlas-QnA ซึ่งโมเดลใหม่มีแนวโน้มละหลักฐานสำคัญในคำตอบมากขึ้น
ชาร์ต FrontierCode 2.0 ของ OpenAI เองแสดงช่องว่างไม่ถึง 2 คะแนนที่ความพยายามสูงสุด Opus 5.5 มีต้นทุนต่อภารกิจสูงกว่าราวสิบเท่าบนดัชนีการเขียนโค้ดที่ความพยายามสูงสุด (ประมาณ $12.60 เทียบกับประมาณ $1.15) แต่สำหรับงานระดับรีโปซิตอรีที่ผลลัพธ์ต้องถูกต้อง มันยังเป็นโมเดลที่แข็งแกร่งกว่า
ระบบอัตโนมัติของเวิร์กโฟลว์ธุรกิจ
AutomationBench การทดสอบของ Zapier สำหรับเอเจนต์ที่รันเวิร์กโฟลว์หลายขั้นตอนข้ามแอปธุรกิจ เป็นไฮไลต์ของการเปรียบเทียบรุ่น 6.1: Opus 5.5 นำ 6 คะแนนที่ความพยายามสูงสุด กับ GPT-6.2 Sol ช่องว่างลดเหลือ 1.4 คะแนน
Sol ยังแผ่วเร็ว คะแนนใกล้เคียงกันตั้งแต่ระดับ medium ขึ้นไป ขณะที่ Opus 5.5 ไต่ขึ้นอย่างสม่ำเสมอและแซง Sol ได้เฉพาะที่ระดับ max ซึ่งแต่ละภารกิจมีต้นทุนราว 5 เท่า สำหรับบอทซัพพอร์ตหรือเอเจนต์เซลส์ออปส์ที่รันเวิร์กโฟลว์นับพัน ตอนนี้ Sol คือทางเลือกชัดเจน; Opus 5.5 เหมาะก็ต่อเมื่อค่าความล้มเหลวสูงกว่าค่าต่างของราคา
การให้เหตุผลทั่วไป
Opus 5.5 รักษาความนำเล็กน้อยบน Artificial Analysis Intelligence Index ซึ่งเป็นองค์รวมของการประเมิน 9 รายการครอบคลุมงานความรู้ การเขียนโค้ด และวิทยาศาสตร์ ที่ระดับ xhigh Opus 5.5 ทำคะแนนเท่ากับ Sol ที่ max แต่ต้นทุนต่อภารกิจประมาณหกเท่า ทั้งคู่เสมอกันบน Vals Science Index ดังนั้นการให้เหตุผลทั่วไปเกือบเท่ากันโดยเอียงไปทาง Anthropic เล็กน้อย
ราคา: จ่ายจริงเท่าไร
GPT-6.2 Sol มีราคาต่อโทเคนครึ่งหนึ่งของ Opus 5.5 และถูกกว่ามากต่อภารกิจที่เสร็จสิ้น
GPT-6.2 Sol คง อัตราของ GPT-6.1 Sol ดังนั้นช่องว่างราคาต่อโทเคนเหมือนเดิม ช่องว่างต้นทุนต่อภารกิจไม่เหมือนเดิม เพราะ Sol ตอนนี้ต้องใช้โทเคนเอาต์พุตน้อยลงเพื่อทำงานเดียวกันให้เสร็จ การรันเชดเดอร์เดี่ยวของเราเองด้านล่างก็ชี้ทางเดียวกัน โดย Opus แพงกว่า Sol เกือบ 6 เท่า ($0.21 เทียบกับ $1.20)
อัตราโทเคนเทียบกันข้างๆ
GPT-6.2 Sol มีค่าใช้จ่ายเท่าครึ่งของ Opus 5.5 ทุกอัตรามาตรฐาน จนกว่าพรอมป์ตจะเกิน 272K โทเคนขาเข้า:
ทั้งสองโมเดลคิดโทเคนการให้เหตุผลเป็นเอาต์พุต และโหมดคิดของ Opus 5.5 ปิดไม่ได้ ดังนั้นอัตราเอาต์พุตจึงสำคัญที่สุด
งานจริงมีค่าใช้จ่ายเท่าไร
ยอดรวมแต่ละรายการคำนวณเป็น (ปริมาณ ÷ 1M) × อัตรา รวมอินพุตและเอาต์พุต ที่อัตรามาตรฐาน
ทำไมงานเดียวกันถึงมีค่าใช้จ่ายต่างกัน
สองโมเดลใช้ตัวตัดโทเคนต่างกัน แต่ความต่างใหญ่กว่าคือจำนวนโทเคนเอาต์พุตที่ใช้ ชาร์ต GDPval v2 ของ OpenAI ระบุว่า Opus 5.5 ใช้โทเคนเอาต์พุตต่อภารกิจ 191,241 ที่ความพยายามสูงสุด เทียบกับ 33,428 ของ GPT-6.2 Sol และที่ระดับ high เท่ากับ 61,121 เทียบกับ 12,420
แม้จะเป็นการวัดของ OpenAI เอง แต่เปรียบเทียบสองโมเดลโดยตรง หาก Opus 5.5 ต้องใช้โทเคนเอาต์พุตมากกว่า Sol ราว 3 เท่าบนเวิร์กโหลดผู้ช่วยสมดุล เช่นเดียวกับที่เราเจอในการทดสอบ บิลรายเดือนจะเป็น $19.00 เทียบกับ $4.50 ของ Sol
นั่นคือเหตุผลที่ช่องว่างต้นทุนต่อภารกิจในตารางสรุปกว้างกว่าช่องว่างราคาต่อโทเคน 2 เท่ามาก
ผลการทำงานของ GPT-6.2 Sol และ Claude Opus 5.5
ตัวเลขทั้งหมดก่อนหน้านี้มาจากชาร์ตของ OpenAI จึงรันงานสร้างหนึ่งงานกับทั้งสองโมเดล โดยใช้พรอมป์ตและเครื่องมือเหมือนกันทุกประการ
งาน: หน้า HTML เดี่ยวที่มี GLSL fragment shader แบบเต็มหน้าต่างแสดงภาพป่ากอเคลป์ใต้ทะเลยามโพล้เพล้แบบมีแอนิเมชัน โฮสต์ด้วย p5.js ที่โหลดจาก CDN
ส่วนยากคือฉากมีองค์ประกอบหลายอย่าง และเคอร์เซอร์ต้องเปลี่ยนแปลงทุกองค์ประกอบ:
นี่คือการทดสอบข้ออ้างของ OpenAI ว่า GPT-6.2 สร้างเฟรอนต์เอนด์ที่ดูและทำงานได้ดีกว่า รวมถึงฉาก 3 มิติ ทั้งสองโมเดลรันใน OpenCode ด้วยพื้นผิวเครื่องมือแบบตรึง (อ่านและแก้ไขไฟล์เท่านั้น) ที่ระดับความพยายามให้เหตุผล high ครั้งละหนึ่งความพยายามในเซสชันใหม่ และพรอมป์ตส่งแบบตรงตัวอักษร
นี่คือสิ่งที่ GPT-6.2 Sol สร้าง: