
I risultati principali:
- Entrambi hanno costruito la scena correttamente al primo tentativo. Ognuno ha fornito un vero shader di frammento GLSL con uniform di tempo e mouse, animato in modo fluido, e ha disegnato una foresta di kelp riconoscibile a colpo d’occhio. Nessuno ha avuto bisogno di suggerimenti.
- La scena di GPT-6.2 Sol appare più realistica. La versione di Opus 5.5 sembra un po’ più cartoon, cosa che gli è costata un punto su quanto la scena rispettasse il brief.
- Ogni modello ha azzeccato metà della torcia. La torcia di Sol sembra un cono di luce 3D che entra nella scena, mentre quella di Opus 5.5 si muove più lungo un angolo 2D piatto. Ma il kelp di Opus 5.5 si piega via dalla torcia in modo chiaro e reattivo, mentre la piega-via di Sol è più debole.
Questa è la versione di Opus 5.5, in cui le fronde vicino al cursore cedono visibilmente:
Ho valutato entrambi su aderenza al brief, qualità dello shader, interattività del cursore e se l’effetto fosse uno shader reale. Qualità e tecnica dello shader a pieni voti per entrambi; le righe in cui differiscono:
| Misura | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| Costo di questa run (USD) | $0,21 | $1,20 |
| Token di output (incl. ragionamento) | 16.476 | 44.996 |
| Aderenza estetica (discriminante primaria) | 5 | 4 |
| Punteggio rubric (media di quattro assi) | 4,8 | 4,5 |
GPT-6.2 Sol vince di misura questo test, sulla resa realistica, in linea con l’affermazione di OpenAI su frontend 3D più belli. Sol ha azzeccato la luce e Opus 5.5 la spinta, e Sol lo ha fatto a circa un sesto del costo.
Questa è una run di un singolo task a un solo livello di sforzo. Entrambi i modelli hanno superato facilmente l’asticella tecnica, quindi a separarli è stato il gusto, che una singola run può solo suggerire.
Quando scegliere GPT-6.2 Sol vs Claude Opus 5.5
La scelta dipende dal tipo di lavoro, dalla lunghezza dei prompt e da dove effettui il deployment.
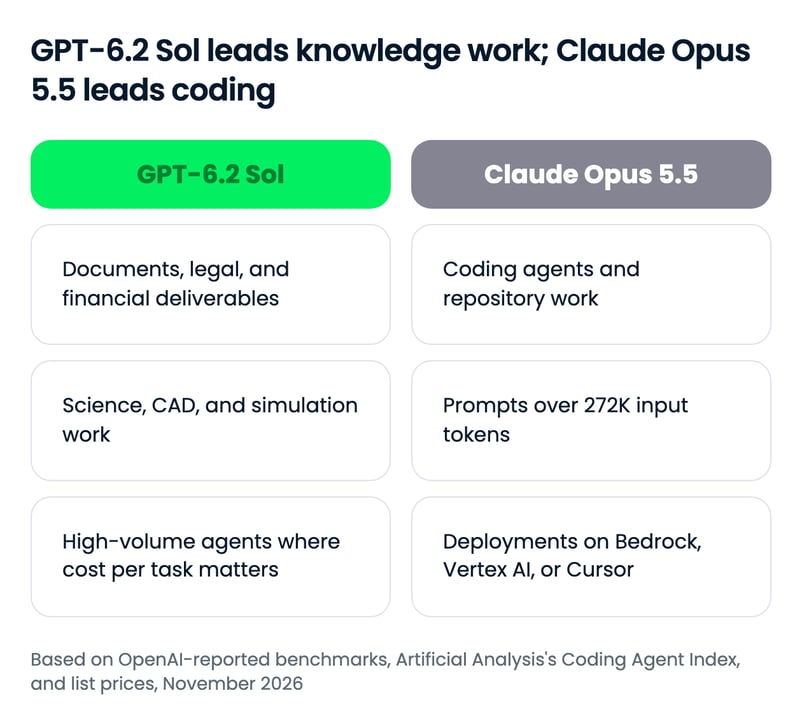
GPT-6.2 Sol dovrebbe essere il tuo predefinito, e Opus 5.5 un modello che scegli per un motivo. L’unico numero che può ribaltare il caso di costo è la soglia di 272K token, oltre la quale il sovrapprezzo di Sol lo avvicina al prezzo di Opus 5.5.
Scegli GPT-6.2 Sol se...
- Produci deliverable professionali. Sol è in testa su GDPval v2 e più che raddoppia Opus 5.5 sul benchmark legale di Harvey, quindi documenti, memo e bozze legali sono il suo terreno naturale.
- Esegui lavoro scientifico, CAD o di simulazione. Ora guida Terminal-Bench-Science e BenchCAD, due benchmark in cui GPT-6.1 Sol era dietro a Opus 5.5.
- Esegui agenti ad alto volume. Il suo costo per task è una frazione di quello di Opus 5.5 in ogni grafico pubblicato da OpenAI, e in diversi grafici di OpenAI segna vicino al massimo già a sforzo high.
- Lavori in Codex, GitHub Copilot o Azure AI Foundry. GPT-6.2 Sol è già elencato su tutti e tre.
Scegli Claude Opus 5.5 se...
- Gli agenti di coding sono il tuo carico principale. Opus 5.5 guida il Coding Agent Index indipendente di Artificial Analysis di 8 punti, e i risultati di Terminal-Bench 4.0 e CursorBench di Anthropic non hanno ancora un corrispettivo per GPT-6.2 Sol.
- I tuoi prompt superano abitualmente i 272K token. Opus 5.5 non ha sovrapprezzo per contesti lunghi, quindi i prompt sull’intero codebase costano più o meno uguale su entrambi.
- Fai deployment tramite Bedrock, Vertex AI o Cursor. Opus 5.5 è elencato su tutti e tre; GPT-6.2 Sol non è nella documentazione di Cursor, e non abbiamo trovato elenchi Bedrock o Vertex AI per esso nelle nostre fonti.
Come iniziare con GPT-6.2 Sol e Claude Opus 5.5
L’accesso è quasi identico, tranne che GPT-6.2 Sol non è disponibile in Cursor, dato che OpenAI ha deciso di ritirare i propri modelli dalla piattaforma.
| Superficie | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| App consumer | ChatGPT Work (Plus, Pro, Enterprise, Edu) | App Claude |
| API first-party | OpenAI API | Claude API |
| Piattaforme cloud | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agenti di coding | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Router di terze parti | OpenRouter | OpenRouter |
| ID modello API | gpt-6.2-sol | claude-opus-5-5 |
Gli ID modello API sono gpt-6.2-sol e claude-opus-5-5; su OpenRouter sono openai/gpt-6.2-sol e anthropic/claude-opus-5.5.
La tua prima chiamata API
Il modo più rapido per provarli entrambi è OpenRouter, dove cambiare modello richiede la modifica di una sola stringa:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Per una build completa, il nostro tutorial API di Opus 5.5 accompagna un progetto di agente dall’inizio alla fine.
Pensieri finali
GPT-6.2 Sol dovrebbe essere la scelta predefinita rispetto a Claude Opus 5.5. Supera Opus 5.5 su circa metà dei benchmark condivisi e si avvicina sugli altri a una frazione del costo per task, lasciando a Opus 5.5 la scelta per agenti di coding, prompt molto lunghi e deployment su Bedrock, Vertex AI o Cursor.
Ciò che trovo più interessante è che il prezzo di Sol non è mai cambiato: OpenAI ha vinto questo round sui token di output. Tieni presente che Opus 5.5 è uscito da quasi due mesi, che al ritmo attuale sembrano anni luce, quindi mi aspetto che il prossimo rilascio di Anthropic competi con Sol su qualità ed efficienza.
Se stai costruendo su uno dei due modelli, ti consiglio il nostro skill track OpenAI Fundamentals o il corso Introduction to Claude Models.
FAQ
GPT-6.2 Sol è migliore di Claude Opus 5.5?
Sui più dei benchmark condivisi nei grafici di lancio di OpenAI, sì. GPT-6.2 Sol batte Opus 5.5 al massimo sforzo su Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA e BenchCAD, a un costo per task molto inferiore. Opus 5.5 mantiene un chiaro vantaggio nel coding agentico: segna 58 contro i 50 di Sol sull’indice indipendente di Artificial Analysis, Coding Agent Index.
Quanto è più economico GPT-6.2 Sol rispetto a Claude Opus 5.5?
Le tariffe API di GPT-6.2 Sol sono la metà di quelle di Opus 5.5: $2 vs $4 per milione di token in input e $10 vs $20 per milione di token in output. Per task finito il divario è più ampio, perché Sol usa meno token di output. Su prompt oltre 272K token in input, il sovrapprezzo di Sol avvicina i due allo stesso prezzo.
Cosa è cambiato tra GPT-6.1 Sol e GPT-6.2 Sol?
GPT-6.2 Sol mantiene i prezzi API di GPT-6.1 Sol ma segna più in alto sulla maggior parte dei benchmark di OpenAI, usando meno token di output. I balzi più grandi contro Claude Opus 5.5 sono su Terminal-Bench-Science, dove Sol è passato da inseguire a guidare, e su AutomationBench, dove il vantaggio di Opus 5.5 si è ridotto a circa un punto.
Dove posso usare GPT-6.2 Sol e Claude Opus 5.5?
GPT-6.2 Sol è in ChatGPT Work e Codex per utenti Plus, Pro, Enterprise ed Edu, e nell’OpenAI API. Claude Opus 5.5 è nelle app Claude, in Claude Code, nella Claude API e in Cursor. Entrambi sono disponibili su Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot e OpenRouter.
Quali sono gli ID modello API per GPT-6.2 Sol e Claude Opus 5.5?
L’ID modello dell’OpenAI API è gpt-6.2-sol, e l’ID modello della Claude API è claude-opus-5-5. Su OpenRouter, i due modelli sono openai/gpt-6.2-sol e anthropic/claude-opus-5.5, così puoi passare dall’uno all’altro cambiando una singola stringa nello stesso client.

Tom è un Editor di Data Science in DataCamp. Scrive e modifica tutorial sull’IA, confronta le nuove release di LLM e crea flussi di lavoro potenziati dall’IA. In precedenza ha lavorato nella data science presso Deutsche Telekom. Fuori dal lavoro, prevede le partite di calcio con il machine learning.
OpenAI ha rilasciato GPT-6.2 Sol, il livello quotidiano della famiglia GPT-6.2, agli stessi identici prezzi API di GPT-6.1 Sol. Quando abbiamo confrontato GPT-6.1 Sol con Claude Opus 5.5, la divisione era netta: Sol per il costo per task, Opus 5.5 per il tasso di successo più alto nelle run agentiche difficili al massimo sforzo. I grafici di lancio di OpenAI per GPT-6.2 Sol mettono in dubbio questa seconda metà, includendo Opus 5.5 al massimo sforzo in quasi tutti.
In questo articolo, confronterò GPT-6.2 Sol e Claude Opus 5.5 tra lavoro professionale e scientifico, coding, automazione business e prezzi, per poi farli girare entrambi sullo stesso shader pratico.
Se vuoi una base più solida su come funzionano i modelli GPT e su come progettarne i prompt prima di leggere il confronto, ti consiglio il corso Intermediate ChatGPT, che copre l’architettura dei modelli GPT e la scrittura di prompt avanzati. Per restare aggiornato su AI e data, ti consiglio di iscriverti alla nostra newsletter settimanale, The Median.
TL;DR
Che cos’è GPT-6.2 Sol?
GPT-6.2 Sol è il modello di ragionamento efficiente di fascia media di OpenAI, rilasciato a novembre 2026 insieme a GPT-6.2 Astra.
OpenAI lo definisce il suo modello di riferimento per il lavoro quotidiano, e il suo punto di forza è l’efficienza: risultati migliori di GPT-6.1 Sol su task impegnativi con meno token di output, a prezzi invariati.
La nostra guida a GPT-6.2 Astra e Sol copre il lancio, con l’intero set di benchmark e due test pratici.
Che cos’è Claude Opus 5.5?
Claude Opus 5.5 è il modello di Anthropic per coding agentico di lunga durata e knowledge work, rilasciato il 22 settembre 2026 come primo modello della famiglia Claude 5.5.
Anthropic lo posiziona al livello di Claude Fable 5.1 sulla maggior parte dei lavori, con un costo di esecuzione inferiore del 40% rispetto a Opus 5, e il suo “thinking” non può più essere disattivato.
La nostra guida a Claude Opus 5.5 copre il lancio; il nostro tutorial API di Opus 5.5 costruisce con esso un investigatore di incidenti AI.
GPT-6.2 Sol vs Claude Opus 5.5: confronto diretto
GPT-6.2 Sol ora supera Claude Opus 5.5 sulla maggior parte dei benchmark condivisi, e Opus 5.5 mantiene piccoli vantaggi su coding e automazione.
Nel nostro confronto GPT-6.1 Sol vs Opus 5.5, Opus 5.5 guidava la maggior parte dei risultati al massimo sforzo. Con GPT-6.2 Sol, i grafici di OpenAI mostrano Sol avanti su 5 dei 9 benchmark in cui compaiono entrambi i modelli, alla pari su 1, e a meno di 2 punti sugli altri 3. Il coding è l’eccezione: sull’indice indipendente di Artificial Analysis, Coding Agent Index, Opus 5.5 è avanti di 8 punti.
Lavoro professionale e scienza
Qui si ribalta il verdetto della 6.1. GPT-6.1 Sol era dietro a Opus 5.5 su Terminal-Bench-Science 0.1, che testa il lavoro scientifico in un terminale, di 6 punti al massimo sforzo. Ora GPT-6.2 Sol lo supera, 68,0% contro 63,3%, a meno di un decimo del costo per task.
Il resto dei grafici di OpenAI sul lavoro professionale va nella stessa direzione:
Agents' Last Exam, il test di OpenAI sui workflow professionali a lungo orizzonte, è quasi un pareggio al massimo sforzo. Il punto più indicativo in quel grafico è lo sforzo: Sol a high è già sopra Opus 5.5 a max, a circa $0,69 per task.
Per documenti, lavoro legale, CAD e analisi scientifica, GPT-6.2 Sol è ora il modello più forte in base alle evidenze disponibili, non solo quello più economico.
Coding
Il coding è dove Opus 5.5 è ancora chiaramente in testa, e i numeri indipendenti mettono il divario ben oltre quanto mostrano i grafici di OpenAI. Sul Coding Agent Index di Artificial Analysis, che combina FrontierCode, Terminal-Bench 4.1 e SWE-Atlas-QnA, Opus 5.5 in Claude Code segna 58 al massimo sforzo, contro 50 per GPT-6.2 Sol in Codex alla sua impostazione migliore, xhigh.
GPT-6.2 Sol in realtà segna meno su quell’indice rispetto a GPT-6.1 Sol. Artificial Analysis attribuisce il calo a SWE-Atlas-QnA, dove il nuovo modello è più incline a omettere fatti chiave nelle risposte.
Il grafico FrontierCode 2.0 di OpenAI mostra un divario sotto i 2 punti al massimo sforzo. Opus 5.5 costa circa dieci volte tanto per task al massimo sforzo sull’indice di coding (circa $12,60 contro circa $1,15), ma per lavoro su repository dove il risultato deve essere giusto, è il modello più forte.
Automazione dei workflow business
AutomationBench, il test di Zapier sugli agenti che eseguono workflow multistep tra app business, era il titolo del confronto 6.1: Opus 5.5 era avanti di 6 punti al massimo sforzo. Con GPT-6.2 Sol, il divario scende a 1,4 punti.
Sol inoltre si appiattisce presto. Segna più o meno lo stesso da medium in su, mentre Opus 5.5 sale costantemente e supera Sol solo a max, dove ogni task costa circa cinque volte tanto. Per un bot di supporto o un agente sales-ops che esegue migliaia di workflow, Sol è ora la scelta ovvia; Opus 5.5 ha senso solo dove una run fallita costa più del gap di prezzo.
Ragionamento generale
Opus 5.5 mantiene un piccolo vantaggio sull’Artificial Analysis Intelligence Index, un composito di 9 valutazioni su knowledge work, coding e scienza. A sforzo xhigh, Opus 5.5 è alla pari con Sol a max, a circa sei volte il costo per task. Sono pari sul Vals Science Index, quindi il ragionamento generale è vicino alla parità con una lieve inclinazione verso Anthropic.
Prezzi: quanto paghi davvero
GPT-6.2 Sol costa la metà di Opus 5.5 per token e molto meno per task finito.
GPT-6.2 Sol mantiene le tariffe di GPT-6.1 Sol, quindi il divario di prezzo per token è lo stesso di prima. Il divario di costo per task no, perché Sol ora ha bisogno di meno token di output per finire lo stesso lavoro. La nostra singola run sullo shader, descritta sotto, va nella stessa direzione, con Opus quasi 6 volte più costoso di Sol ($0,21 contro $1,20).
Tariffe per token affiancate
GPT-6.2 Sol costa esattamente la metà di Opus 5.5 su ogni tariffa standard, finché un prompt non supera i 272K token in input:
Entrambi i modelli fatturano i token di ragionamento come output, e il “thinking” di Opus 5.5 non può essere disattivato, quindi è la sua tariffa di output quella che conta di più.
Quanto costa un carico di lavoro reale
Ogni totale è (volume ÷ 1M) × tariffa, sommato tra input e output, a tariffe standard.
Perché lo stesso task costa importi diversi
I due modelli usano tokenizer diversi, ma la differenza più grande è quanti token di output consumano. Il grafico GDPval v2 di OpenAI pone Opus 5.5 a 191.241 token di output per task a max contro i 33.428 di GPT-6.2 Sol, e a 61.121 contro 12.420 a high.
Queste sono misurazioni di OpenAI, ma confrontano direttamente i due soggetti. Se Opus 5.5 avesse bisogno di circa 3 volte i token di output di Sol sul workload assistant bilanciato, come nel nostro test, la sua bolletta mensile sarebbe di $19,00 contro $4,50 di Sol.
Ecco perché i divari di costo per task nella tabella di sintesi sono molto più ampi del divario 2x del prezzo per token.
Come si sono comportati GPT-6.2 Sol e Claude Opus 5.5
Tutti i numeri finora arrivano dai grafici di OpenAI, quindi ho eseguito un task di build contro entrambi i modelli con prompt e strumenti identici.
Il task: una singola pagina HTML con uno shader di frammento GLSL a finestra intera e animato di una foresta di kelp al crepuscolo sott’acqua, ospitato da p5.js caricato da CDN.
La parte difficile è che la scena ha diversi elementi, e il cursore deve modificarli tutti:
Mette alla prova l’affermazione di OpenAI secondo cui GPT-6.2 costruisce frontend che appaiono e funzionano meglio, incluse scene 3D. Entrambi i modelli sono stati eseguiti in OpenCode con una superficie strumenti fissata (solo lettura e modifica file), ad alto sforzo di ragionamento, con un tentativo ciascuno in una sessione nuova e il prompt inviato byte per byte.
Ecco cosa ha costruito GPT-6.2 Sol: