
主要发现:
- 两者首次尝试即正确搭建了场景。 都输出了真实的 GLSL 片段着色器,包含时间与鼠标 uniform,动画流畅,海带林一眼可辨,无需额外提示。
- GPT-6.2 Sol 的场景更逼真。 Opus 5.5 略显卡通,因此在“与任务描述的贴合度”上失了一分。
- 两款模型各自拿捏对了手电的不同一半。 Sol 的手电像一束深入场景的 3D 光锥;Opus 5.5 更像沿平面的 2D 光斜线。但 Opus 5.5 的海带会更清晰、更灵敏地避让手电,而 Sol 的避让效果较弱。
下面是 Opus 5.5 的版本,靠近光标的海带可见地让开:
我从“与任务描述的贴合度”、着色器质量、光标交互性,以及是否为真实着色器四个维度打分。着色器质量与实现技术两者均为满分;差异体现在以下几项:
| 指标 | GPT-6.2 Sol(high) | Claude Opus 5.5(high) |
|---|---|---|
| 本次运行成本(USD) | $0.21 | $1.20 |
| 输出 token(含推理) | 16,476 | 44,996 |
| 审美贴合度(主判别项) | 5 | 4 |
| 量表得分(四轴均值) | 4.8 | 4.5 |
GPT-6.2 Sol 以更逼真的呈现小胜本次测试,这与 OpenAI 关于“更好看的 3D 前端”的说法相符。Sol 把光效做对了,Opus 5.5 把“推开”做对了;而 Sol 的成本约为其六分之一。
这只是一次、一道、一个投入设定的任务。两者都轻松越过技术门槛,真正拉开差距的是审美取向,而单次测试只能给出有限暗示。
何时选择 GPT-6.2 Sol 或 Claude Opus 5.5
抉择取决于工作类型、提示长度与部署渠道。
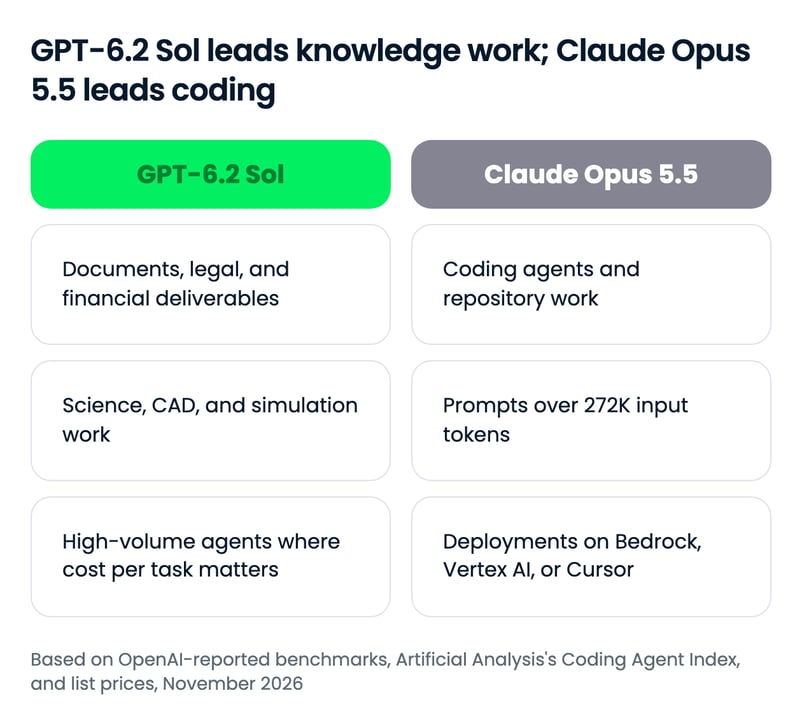
GPT-6.2 Sol 应作为默认选择,除非有明确理由才改用 Opus 5.5。唯一可能扭转成本对比的数字是 272K token 阈值,超过后 Sol 的附加费会让其价格接近 Opus 5.5。
在以下场景选 GPT-6.2 Sol:
- 产出专业级交付物。 Sol 在 GDPval v2 领先,并在 Harvey 法律基准上将 Opus 5.5 的分数翻倍有余;文档、备忘录与法律草案皆是其主场。
- 从事科学、CAD 或仿真工作。 它在 Terminal-Bench-Science 与 BenchCAD 上领先,这两项在 GPT-6.1 Sol 时还落后于 Opus 5.5。
- 高量级运行代理。 OpenAI 发布的每张图上,Sol 的单任务成本都是 Opus 5.5 的一小部分;且在多张图上,它在 high 投入已接近自身 max。
- 在 Codex、GitHub Copilot 或 Azure AI Foundry 中工作。 GPT-6.2 Sol 已在三者中上线。
在以下场景选 Claude Opus 5.5:
- 以编码代理为主。 Opus 5.5 在 Artificial Analysis 的独立 Coding Agent Index 上领先 8 分;Anthropic 的 Terminal-Bench 4.0 与 CursorBench 成绩目前还没有 GPT-6.2 Sol 的对应数据。
- 提示常常超过 272K token。 Opus 5.5 无长上下文附加费,因此整库级提示在两者间成本大致相当。
- 通过 Bedrock、Vertex AI 或 Cursor 部署。 Opus 5.5 已在三者上线;GPT-6.2 Sol 未见于 Cursor 文档,且我们在来源中未找到其 Bedrock 或 Vertex AI 的上架信息。
如何开始使用 GPT-6.2 Sol 与 Claude Opus 5.5
接入方式几乎相同,唯独 GPT-6.2 Sol 不在 Cursor 上线,因为 OpenAI 决定将其模型下架该平台。
| 渠道 | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| 消费级应用 | ChatGPT Work(Plus、Pro、Enterprise、Edu) | Claude 应用 |
| 第一方 API | OpenAI API | Claude API |
| 云平台 | Amazon Bedrock、Google Vertex AI、Azure AI Foundry | Amazon Bedrock、Google Vertex AI、Azure AI Foundry |
| 编码代理 | Codex、GitHub Copilot | Claude Code、Cursor、GitHub Copilot |
| 第三方路由 | OpenRouter | OpenRouter |
| API 模型 ID | gpt-6.2-sol | claude-opus-5-5 |
API 模型 ID 分别是 gpt-6.2-sol 与 claude-opus-5-5;在 OpenRouter 上分别为 openai/gpt-6.2-sol 与 anthropic/claude-opus-5.5。
发起您的第一条 API 调用
最快的试用方式是 OpenRouter,切换模型只需改动一个字符串:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)若要完成一个端到端的构建,我们的 Opus 5.5 API 教程提供从头到尾的代理项目演练。
结语
GPT-6.2 Sol 应作为优先于 Claude Opus 5.5 的默认选择。它在两者共享的基准里赢下约一半,并在其余项目上紧随其后,同时单任务成本只是其一小部分;因此 Opus 5.5 更适合编码代理、超长提示,以及在 Bedrock、Vertex AI 或 Cursor 上的部署。
更有意思的是,Sol 的价格从未改变:OpenAI 这一回靠“输出 token”取胜。请记住,Opus 5.5 已发布将近两个月——以当下节奏看几乎是“光年”——我也预期 Anthropic 的下个版本会在质量与效率上对标 Sol。
若您在这两款模型上构建,我推荐我们的 OpenAI Fundamentals 技能路径或 Introduction to Claude Models 课程。
常见问题
GPT-6.2 Sol 是否优于 Claude Opus 5.5?
若以 OpenAI 发布图表中两者共享的大多数基准来看,是的。GPT-6.2 Sol 在最大投入下于 Agents' Last Exam、Terminal-Bench-Science、GDPval v2、Harvey LAB-AA 与 BenchCAD 上均胜出,且单任务成本大幅更低。Opus 5.5 在代理式编码上仍有明显优势:在 Artificial Analysis 的独立 Coding Agent Index 上以 58 比 50 领先 Sol。
GPT-6.2 Sol 比 Claude Opus 5.5 便宜多少?
GPT-6.2 Sol 的 API 费率为 Opus 5.5 的一半:输入每百万 token $2 对 $4,输出每百万 token $10 对 $20。按完成的单项任务计价,差距更大,因为 Sol 使用更少的输出 token。若提示超过 272K 输入 token,Sol 的附加费会使两者价格接近。
GPT-6.1 Sol 与 GPT-6.2 Sol 有何变化?
GPT-6.2 Sol 保持 GPT-6.1 Sol 的 API 价格,但在 OpenAI 的多数基准上分数更高,同时使用更少的输出 token。相较 Claude Opus 5.5,提升最大的是 Terminal-Bench-Science(由落后转为领先)与 AutomationBench(Opus 5.5 的领先缩至约 1 分)。
我可以在哪使用 GPT-6.2 Sol 与 Claude Opus 5.5?
GPT-6.2 Sol 可在 ChatGPT Work 与 Codex(面向 Plus、Pro、Enterprise 与 Edu 用户)以及 OpenAI API 中使用。Claude Opus 5.5 可在 Claude 应用、Claude Code、Claude API 与 Cursor 中使用。两者均可在 Amazon Bedrock、Google Vertex AI、Azure AI Foundry、GitHub Copilot 与 OpenRouter 上使用。
GPT-6.2 Sol 与 Claude Opus 5.5 的 API 模型 ID 是什么?
OpenAI API 的模型 ID 为 gpt-6.2-sol,Claude API 的模型 ID 为 claude-opus-5-5。在 OpenRouter 上,二者分别为 openai/gpt-6.2-sol 与 anthropic/claude-opus-5.5,因此可在同一客户端代码中仅更改一个字符串完成切换。

Tom 是 DataCamp 的数据科学编辑,负责撰写与编辑 AI 教程、比较最新的 LLM 版本,并构建 AI 驱动的工作流程。在此之前,他曾在德国电信从事数据科学工作。工作之余,他利用机器学习预测足球比赛结果。
OpenAI 发布了 GPT-6.2 Sol,其 GPT-6.2 系列的日常工作档位,API 价格与 GPT-6.1 Sol 完全相同。我们在比较 GPT-6.1 Sol 与 Claude Opus 5.5时结论明确:按每个任务成本选 Sol,追求极限投入下的复杂代理成功率选 Opus 5.5。而 OpenAI 给出的 GPT-6.2 Sol 发布图表让后半截结论存疑,且几乎每张图都含有 Opus 5.5 的最大投入成绩。
本文将从专业与科研、编码、业务自动化与定价四方面比较 GPT-6.2 Sol 与 Claude Opus 5.5,并用同一上手着色器构建进行实测。
如果您想在阅读对比前更牢靠地理解 GPT 模型的工作原理与提示词撰写,我推荐 Intermediate ChatGPT 课程,涵盖 GPT 架构与进阶提示技巧。想跟进 AI 与数据领域动态,欢迎订阅我们的周报 The Median。
要点速览
什么是 GPT-6.2 Sol?
GPT-6.2 Sol 是 OpenAI 面向高效推理的中端模型,于 2026 年 11 月与 GPT-6.2 Astra 同期发布。
OpenAI 将其定位为日常工作的首选模型,卖点是效率:在保持价格不变的前提下,用更少的输出 token,在高要求任务上交出比 GPT-6.1 Sol 更好的成绩。
我们的GPT-6.2 Astra 与 Sol 指南覆盖了发布信息、完整基准集与两次上手测试。
什么是 Claude Opus 5.5?
Claude Opus 5.5 是 Anthropic 面向长时程代理式编码与知识工作的模型,于 2026 年 9 月 22 日发布,是 Claude 5.5 系列的首款模型。
Anthropic 将其定位在与 Claude Fable 5.1 相当的工作水平,同时运行成本较 Opus 5 低 40%,且其“思考”无法关闭。
我们的 Claude Opus 5.5 指南涵盖发布信息;我们的 Opus 5.5 API 教程用它构建了一名 AI 事件调查员。
GPT-6.2 Sol vs Claude Opus 5.5:正面对比
GPT-6.2 Sol 现已在多数共享基准上领先 Claude Opus 5.5,而 Opus 5.5 在编码与自动化上保持小幅优势。
在我们的GPT-6.1 Sol vs Opus 5.5 对比中,Opus 5.5 在多数最大投入结果上领先。到了 GPT-6.2 Sol,OpenAI 的图表显示:两者同台的 9 项基准里,Sol 领先 5 项、1 项持平、其余 3 项落后不足 2 分。例外是编码:在 Artificial Analysis 的独立 Coding Agent Index 上,Opus 5.5 领先 8 分。
专业工作与科学
这里是 6.1 版结论的翻转。GPT-6.1 Sol 在 Terminal-Bench-Science 0.1(在终端中进行科学工作)以最大投入落后 Opus 5.5 达 6 分。GPT-6.2 Sol 现以 68.0% 对 63.3% 领先,且单任务成本不到十分之一。
OpenAI 其余与专业工作相关的图表也指向相同结论:
Agents' Last Exam(OpenAI 的长视程专业流程测试)在最大投入几近平手。更有启发的是投入维度:Sol 在 high 时已高于 Opus 5.5 的 max,单任务约 $0.69。
在文档、法律、CAD 与科学分析上,基于现有证据,GPT-6.2 Sol 不仅更便宜,还是更强的模型。
编码
编码是 Opus 5.5 仍然明显领先的领域,独立数据给出的差距也大于 OpenAI 图表显示。Artificial Analysis 的 Coding Agent Index 综合 FrontierCode、Terminal-Bench 4.1 与 SWE-Atlas-QnA:Opus 5.5 在 Claude Code 中以最大投入得分 58,而 GPT-6.2 Sol 在 Codex 中最佳设置 xhigh 得分 50。
GPT-6.2 Sol 在该指数上的得分实际上低于 GPT-6.1 Sol。Artificial Analysis 将下滑归因于 SWE-Atlas-QnA,新模型更容易在回答中漏掉关键信息。
OpenAI 自家的 FrontierCode 2.0 图表在最大投入下显示两者差距不足 2 分。按该编码指数的最大投入,Opus 5.5 的单任务成本约为 Sol 的十倍(约 $12.60 对约 $1.15),但在需要确保结果正确的代码库级别工作中,Opus 5.5 更强。
业务流程自动化
AutomationBench(Zapier 的多步业务应用代理测试)是 6.1 对比的焦点:当时 Opus 5.5 在最大投入领先 6 分。到了 GPT-6.2 Sol,差距缩小至 1.4 分。
Sol 也更早“趋平”:从 medium 起分数就基本不变;Opus 5.5 则稳步上升,只在 max 时反超,而该投入下每个任务成本约为 Sol 的五倍。对需要跑上千条流程的客服或销售运营代理,Sol 现已是不二之选;只有在失败代价高于两者价差时,Opus 5.5 才更合理。
通用推理
Opus 5.5 在 Artificial Analysis Intelligence Index(涵盖知识工作、编码与科学的 9 项综合评估)上小幅领先。在 xhigh 投入下,Opus 5.5 与 Sol 的 max 成绩打平,但单任务成本约为后者的 6 倍。两者在 Vals Science Index 上打平,因此通用推理基本势均力敌、Anthropic 略占优。
定价:您实际要付多少钱
GPT-6.2 Sol 的每 token 价格是 Opus 5.5 的一半,而每个完成任务的花费更低。
GPT-6.2 Sol 沿用 GPT-6.1 Sol 的费率,因此 token 价格差仍为 2 倍。单任务成本差则更大,因为 Sol 现在用更少的输出 token 完成同样工作。我们自己的单次着色器运行(见下文)也指向相同方向,Opus 的成本几乎是 Sol 的 6 倍($0.21 对 $1.20)。
Token 费率一览
在标准费率下,GPT-6.2 Sol 在各项上都恰好是 Opus 5.5 的一半,直到提示超过 272K 个输入 token:
两款模型都将推理 token 计作输出;且 Opus 5.5 的“思考”无法关闭,因此其输出费率影响最大。
真实工作负载要花多少钱
总价 =(体量 ÷ 100 万)× 费率,并将输入与输出累加,按标准费率计算。
为何同一任务成本不同
两者使用不同的分词器,但更大的差异在于各自消耗的输出 token 数。OpenAI 的 GDPval v2 图显示,在最大投入下,Opus 5.5 每个任务输出 191,241 个 token,而 GPT-6.2 Sol 为 33,428;在 high 投入下,分别为 61,121 与 12,420。
这些是 OpenAI 的测量,但两者彼此直接可比。若在“均衡助理”负载上,Opus 5.5 的输出 token 约为 Sol 的 3 倍(与我们自测一致),其月账单将为 $19.00,而 Sol 为 $4.50。
这也是为何摘要表中的单任务成本差远大于 2 倍的 token 价差。
GPT-6.2 Sol 与 Claude Opus 5.5 的实测表现
以上数字均来自 OpenAI 图表,因此我用同一提示与同一工具,对两款模型各跑了一次构建任务。
任务:一个单页 HTML,包含铺满窗口的 GLSL 片段着色器,表现黄昏海带林的动态场景,由从 CDN 加载的 p5.js 托管。
难点在于场景元素较多,且光标需能改变所有元素:
这将检验 OpenAI 的主张:GPT-6.2 能构建更好看、更好用的前端,包括 3D 场景。两款模型均在 OpenCode 中运行,固定工具界面(仅读写文件),高推理投入,各自新会话只尝试一次,提示逐字节一致。
以下是 GPT-6.2 Sol 的作品: