
De belangrijkste bevindingen:
- Beide bouwden de scène in één keer goed. Elk leverde een echte GLSL-fragmentshader met time- en mouse-uniforms, animeerde soepel en tekende een kelpwoud dat je in één oogopslag herkent. Geen van beide had een zetje nodig.
- De scène van GPT-6.2 Sol oogt realistischer. De versie van Opus 5.5 leest wat meer cartoonesk, wat een punt kostte op hoe nauw de scène aansloot op de opdracht.
- Elk model kreeg een andere helft van de lamp goed. De lamp van Sol voelt als een 3D-lichtkegel die de scène in reikt, terwijl die van Opus 5.5 meer langs een vlakke 2D-hoek beweegt. Maar de kelp van Opus 5.5 buigt duidelijk en responsief weg van de lamp, terwijl Sols wegduweffect zwakker is.
Hier is de versie van Opus 5.5, waar de strengen nabij de cursor zichtbaar wijken:
Ik scoorde beide op hoe dicht de scène bij de opdracht lag, shaderkwaliteit, cursorinteractiviteit en of het effect een echte shader was. Shaderkwaliteit en techniek waren voor beiden volle bak; de rijen waar ze verschillen:
| Maatstaf | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| Kosten van deze run (USD) | $0,21 | $1,20 |
| Outputtokens (incl. redeneren) | 16.476 | 44.996 |
| Esthetische match (primaire discriminator) | 5 | 4 |
| Rubricscore (gemiddelde van vier assen) | 4,8 | 4,5 |
GPT-6.2 Sol wint deze test nipt, op realisme, wat past bij OpenAI's claim over beter ogende 3D-frontends. Sol kreeg het licht goed en Opus 5.5 het wegduwen goed, en Sol deed het voor ongeveer een zesde van de kosten.
Dit is één run van één taak op één inspanningsniveau. Beide modellen haalden de technische lat makkelijk, dus wat ze onderscheidde was smaak, waar één run slechts een hint over kan geven.
Wanneer kies je GPT-6.2 Sol vs Claude Opus 5.5
De keuze komt neer op het soort werk, de lengte van je prompts en waar je uitrolt.
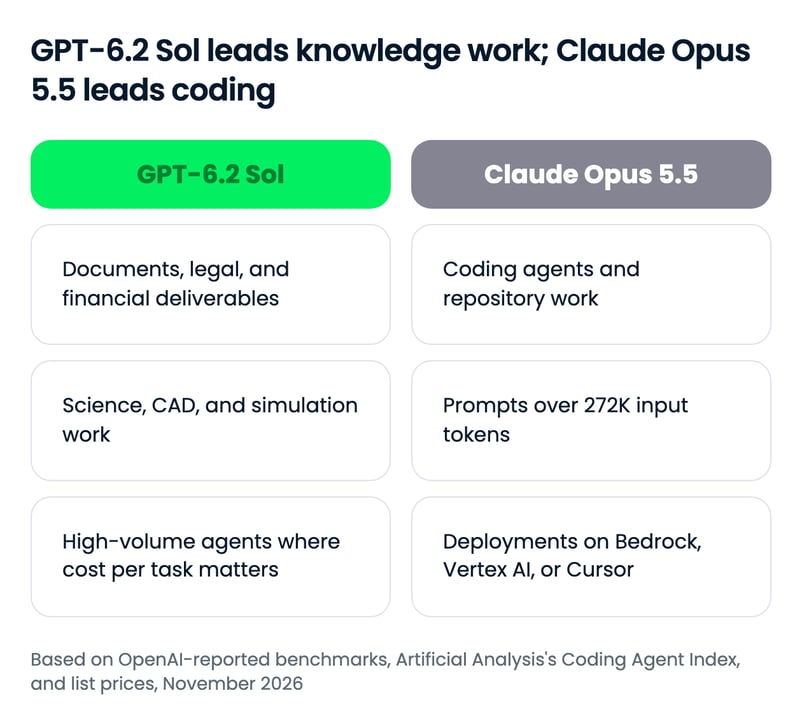
GPT-6.2 Sol zou je standaard moeten zijn, en Opus 5.5 een model dat je kiest met een reden. Het ene getal dat de kostenzaak kan omdraaien is de 272K-token-drempel, waarboven Sols toeslag het dicht bij de prijs van Opus 5.5 brengt.
Kies GPT-6.2 Sol als...
- Je professionele deliverables maakt. Sol leidt op GDPval v2 en verdubbelt Opus 5.5 ruimschoots op Harvey's juridische benchmark, dus documenten, memo's en juridische concepten zijn zijn thuisterrein.
- Je wetenschappelijk, CAD- of simulatie-werk draait. Het leidt nu Terminal-Bench-Science en BenchCAD, twee benchmarks waar GPT-6.1 Sol achterliep op Opus 5.5.
- Je agents op hoge volumes draait. De kosten per taak zijn een fractie van die van Opus 5.5 op elke grafiek die OpenAI publiceerde, en op meerdere grafieken scoort het dicht bij zijn max op high-inspanning.
- Je in Codex, GitHub Copilot of Azure AI Foundry werkt. GPT-6.2 Sol staat al op alle drie.
Kies Claude Opus 5.5 als...
- Codeeragents je hoofdworkload zijn. Opus 5.5 leidt Artificial Analysis' onafhankelijke Coding Agent Index met 8 punten, en Anthropics Terminal-Bench 4.0 en CursorBench-resultaten hebben nog geen GPT-6.2 Sol-tegenhanger.
- Je prompts routinematig boven 272K tokens uitkomen. Opus 5.5 kent geen lang-contexttoeslag, dus prompts met volledige codebases kosten bij beide ongeveer hetzelfde.
- Je uitrolt via Bedrock, Vertex AI of Cursor. Opus 5.5 staat op alle drie; GPT-6.2 Sol staat niet in de Cursor-docs en we vonden geen Bedrock- of Vertex AI-vermelding in onze bronnen.
Hoe je aan de slag gaat met GPT-6.2 Sol en Claude Opus 5.5
Toegang is bijna identiek, behalve dat GPT-6.2 Sol niet beschikbaar is in Cursor, aangezien OpenAI besloot hun modellen van het platform te halen.
| Surface | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Consumentenapp | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Claude-apps |
| Eigen API | OpenAI API | Claude API |
| Cloudplatforms | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Codeeragents | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Routers van derden | OpenRouter | OpenRouter |
| API-model-ID | gpt-6.2-sol | claude-opus-5-5 |
De API-model-ID's zijn gpt-6.2-sol en claude-opus-5-5; op OpenRouter zijn ze openai/gpt-6.2-sol en anthropic/claude-opus-5.5.
Je eerste API-call maken
De snelste manier om beide te proberen is OpenRouter, waar wisselen van model een verandering van één string is:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Voor een volledige build leidt onze Opus 5.5 API-tutorial je door een agentproject van begin tot eind.
Slotgedachten
GPT-6.2 Sol zou de standaardkeuze moeten zijn boven Claude Opus 5.5. Het verslaat Opus 5.5 op ongeveer de helft van de gedeelde benchmarks en komt op de rest dichtbij voor een fractie van de kosten per taak, waardoor Opus 5.5 overblijft voor codeeragents, zeer lange prompts en deployments op Bedrock, Vertex AI of Cursor.
Wat ik het interessantst vind, is dat Sols prijs nooit veranderde: OpenAI won deze ronde op outputtokens. Houd in gedachten dat Opus 5.5 al bijna twee maanden uit is, wat bij het huidige tempo als lichtjaren voelt, dus ik verwacht dat Anthropics volgende release met Sol zal concurreren op kwaliteit en efficiëntie.
Als je op een van beide modellen bouwt, raad ik onze OpenAI Fundamentals-skill track aan of onze cursus Introduction to Claude Models.
FAQ's
Is GPT-6.2 Sol beter dan Claude Opus 5.5?
Op de meeste benchmarks die de twee delen in OpenAI's lanceringsgrafieken wel. GPT-6.2 Sol verslaat Opus 5.5 op max-inspanning op Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA en BenchCAD, voor veel minder per taak. Opus 5.5 behoudt een duidelijke voorsprong in agentisch coderen: het scoort 58 tegen 50 voor Sol op Artificial Analysis' onafhankelijke Coding Agent Index.
Hoeveel goedkoper is GPT-6.2 Sol dan Claude Opus 5.5?
De API-tarieven van GPT-6.2 Sol zijn de helft van die van Opus 5.5: $2 vs $4 per miljoen inputtokens en $10 vs $20 per miljoen outputtokens. Per voltooide taak is de kloof groter, omdat Sol minder outputtokens gebruikt. Bij prompts boven 272K inputtokens brengt Sols toeslag de twee dicht bij dezelfde prijs.
Wat is er veranderd tussen GPT-6.1 Sol en GPT-6.2 Sol?
GPT-6.2 Sol behoudt de API-prijzen van GPT-6.1 Sol, maar scoort hoger op de meeste van OpenAI's benchmarks terwijl het minder outputtokens gebruikt. De grootste sprongen ten opzichte van Claude Opus 5.5 zijn op Terminal-Bench-Science, waar Sol van achterstand naar voorsprong ging, en AutomationBench, waar de voorsprong van Opus 5.5 kromp tot ongeveer één punt.
Waar kan ik GPT-6.2 Sol en Claude Opus 5.5 gebruiken?
GPT-6.2 Sol is beschikbaar in ChatGPT Work en Codex voor Plus-, Pro-, Enterprise- en Edu-gebruikers, en in de OpenAI API. Claude Opus 5.5 is beschikbaar in de Claude-apps, Claude Code, de Claude API en Cursor. Beide zijn beschikbaar op Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot en OpenRouter.
Wat zijn de API-model-ID's voor GPT-6.2 Sol en Claude Opus 5.5?
De OpenAI API-model-ID is gpt-6.2-sol, en de Claude API-model-ID is claude-opus-5-5. Op OpenRouter zijn de twee modellen openai/gpt-6.2-sol en anthropic/claude-opus-5.5, zodat je tussen ze kunt wisselen door één string in dezelfde clientcode te veranderen.

Tom is Data Science Editor bij DataCamp. Hij schrijft en redigeert AI-tutorials, vergelijkt nieuwe LLM-releases en bouwt AI-gestuurde workflows. Eerder werkte hij in data science bij Deutsche Telekom. Buiten het werk voorspelt hij voetbalwedstrijden met machine learning.


OpenAI heeft GPT-6.2 Sol uitgebracht, de alledaagse variant binnen de GPT-6.2-familie, tegen precies dezelfde API-prijzen als GPT-6.1 Sol. Toen we GPT-6.1 Sol vergeleken met Claude Opus 5.5, was de verdeling duidelijk: Sol voor lage kosten per taak, Opus 5.5 voor het hoogste slagingspercentage bij moeilijke agent-runs op maximale inspanning. De lanceringsgrafieken van OpenAI voor GPT-6.2 Sol zetten die tweede helft op losse schroeven en tonen Opus 5.5 op maximale inspanning in bijna allemaal.
In dit artikel vergelijk ik GPT-6.2 Sol en Claude Opus 5.5 op het gebied van professioneel werk en wetenschap, coderen, bedrijfsautomatisering en prijzen, en laat ik ze daarna allebei dezelfde praktische shader-build uitvoeren.
Wil je eerst beter begrijpen hoe GPT-modellen werken en hoe je ze goed kunt prompten, dan raad ik de cursus Intermediate ChatGPT aan, die de architectuur achter GPT-modellen en geavanceerd promptschrijven behandelt. Om bij te blijven in AI en data raad ik aan je te abonneren op onze wekelijkse nieuwsbrief, The Median.
TL;DR
Wat is GPT-6.2 Sol?
GPT-6.2 Sol is OpenAI's efficiënte, mid-tier redeneermodel, uitgebracht in november 2026 naast GPT-6.2 Astra.
OpenAI noemt het het go-to-model voor dagelijks werk, met als unique selling point efficiëntie: betere resultaten dan GPT-6.1 Sol op veeleisende taken met minder outputtokens, tegen ongewijzigde prijzen.
Onze GPT-6.2 Astra- en Sol-gids behandelt de lancering, met de volledige benchmarkset en twee praktische tests.
Wat is Claude Opus 5.5?
Claude Opus 5.5 is Anthropics model voor langdurig agentisch coderen en kenniswerk, uitgebracht op 22 september 2026 als het eerste model in de Claude 5.5-familie.
Anthropic positioneert het op het niveau van Claude Fable 5.1 voor het meeste werk, terwijl het 40% minder kost om te draaien dan Opus 5, en het denken kan niet meer worden uitgeschakeld.
Onze Claude Opus 5.5-gids behandelt de lancering; onze Opus 5.5 API-tutorial bouwt er een AI-incidentonderzoeker mee.
GPT-6.2 Sol vs Claude Opus 5.5: directe vergelijking
GPT-6.2 Sol leidt Claude Opus 5.5 nu op de meeste gedeelde benchmarks, en Opus 5.5 behoudt kleine voorsprongen bij coderen en automatisering.
In onze GPT-6.1 Sol vs Opus 5.5-vergelijking leidde Opus 5.5 de meeste max-inspanningresultaten. Met GPT-6.2 Sol laten OpenAI's grafieken Sol voor lopen op 5 van de 9 benchmarks waarop beide modellen voorkomen, gelijk op 1 en minder dan 2 punten achter op de andere 3. Coderen is de uitzondering: op Artificial Analysis' onafhankelijke Coding Agent Index leidt Opus 5.5 met 8 punten.
Professioneel werk en wetenschap
Hier kantelt het 6.1-oordeel. GPT-6.1 Sol liep op Terminal-Bench-Science 0.1, dat wetenschappelijk werk in een terminal test, 6 punten achter op max-inspanning. GPT-6.2 Sol leidt nu: 68,0% tegen 63,3%, voor minder dan een tiende van de kosten per taak.
De rest van OpenAI's grafieken voor professioneel werk wijst dezelfde kant op:
Agents' Last Exam, OpenAI's test van langlopende professionele workflows, is op max-inspanning bijna gelijk. Het meest veelzeggend is de inspanning: Sol op high zit al boven Opus 5.5 op max, voor ongeveer $0,69 per taak.
Voor documenten, juridisch werk, CAD en wetenschappelijke analyse is GPT-6.2 Sol op basis van het beschikbare bewijs nu het sterkere model, niet alleen het goedkopere.
Coderen
Coderen is waar Opus 5.5 nog duidelijk leidt, en de onafhankelijke cijfers zetten de kloof ruim boven wat OpenAI's grafiek laat zien. Op Artificial Analysis' Coding Agent Index, die FrontierCode, Terminal-Bench 4.1 en SWE-Atlas-QnA combineert, scoort Opus 5.5 in Claude Code 58 op max-inspanning, tegen 50 voor GPT-6.2 Sol in Codex op zijn beste instelling, xhigh.
GPT-6.2 Sol scoort op die index zelfs lager dan GPT-6.1 Sol. Artificial Analysis herleidt de daling tot SWE-Atlas-QnA, waar het nieuwe model eerder kernfeiten uit zijn antwoorden weglaat.
OpenAI's eigen FrontierCode 2.0-grafiek toont een kloof van minder dan 2 punten op max-inspanning. Opus 5.5 kost ongeveer tien keer zoveel per taak op de coding-index (ongeveer $12,60 tegen ongeveer $1,15), maar voor repository-werk waar het resultaat moet kloppen, is het het sterkere model.
Automatisering van bedrijfsworkflows
AutomationBench, Zapiers test van agents die meertrapsworkflows over bedrijfsapps uitvoeren, was de headline van de 6.1-vergelijking: Opus 5.5 leidde met 6 punten op max-inspanning. Met GPT-6.2 Sol is de kloof geslonken tot 1,4 punt.
Sol vlakt ook eerder af. Het scoort vanaf medium inspanning ongeveer hetzelfde, terwijl Opus 5.5 gestaag oploopt en Sol pas inhaalt op max, waar elke taak ongeveer vijf keer zoveel kost. Voor een supportbot of sales-ops-agent die duizenden workflows draait, is Sol nu de logische keuze; Opus 5.5 is alleen logisch waar een mislukte run meer kost dan het prijsverschil.
Algemene redenering
Opus 5.5 behoudt een kleine voorsprong op de Artificial Analysis Intelligence Index, een samenstelling van 9 evaluaties over kenniswerk, coderen en wetenschap. Op xhigh-inspanning scoort Opus 5.5 gelijk aan Sol op max, voor ongeveer zes keer de kosten per taak. Ze staan gelijk op de Vals Science Index, dus algemene redenering is nagenoeg pariteit met een kleine Anthropic-neiging.
Prijzen: wat je werkelijk betaalt
GPT-6.2 Sol is half zo duur als Opus 5.5 per token en veel goedkoper per voltooide taak.
GPT-6.2 Sol behoudt de tarieven van GPT-6.1 Sol, dus het tokenprijsgat is hetzelfde als voorheen. Het kosten-per-taak-gat niet, omdat Sol nu minder outputtokens nodig heeft om hetzelfde werk te voltooien. Onze eigen enkele shaderrun, hieronder besproken, wijst dezelfde kant op, waarbij Opus bijna 6x zo duur was als Sol ($0,21 tegen $1,20).
Tokenprijzen naast elkaar
GPT-6.2 Sol kost precies de helft van Opus 5.5 op elke standaardprijs, totdat een prompt de 272K inputtokens passeert:
Beide modellen rekenen redeneertokens als output, en bij Opus 5.5 kun je het denken niet uitschakelen, dus het outputtarief is het belangrijkst.
Wat een echte workload kost
Elke totaalprijs is (volume ÷ 1M) × tarief, opgeteld over input en output, tegen standaardtarieven.
Waarom dezelfde taak verschillende bedragen kost
De twee modellen gebruiken verschillende tokenizers, maar het grotere verschil is hoeveel outputtokens elk besteedt. OpenAI's GDPval v2-grafiek zet Opus 5.5 op 191.241 outputtokens per taak op max-inspanning tegenover 33.428 voor GPT-6.2 Sol, en op 61.121 tegenover 12.420 op high.
Dat zijn OpenAI's eigen metingen, maar ze vergelijken de twee direct. Als Opus 5.5 ongeveer 3 keer zoveel outputtokens nodig had als Sol op de gebalanceerde assistent-workload, zoals in onze eigen test, dan zou de maandrekening $19,00 zijn tegen $4,50 voor Sol.
Dat is waarom de kosten-per-taakkloven in de samenvatting veel groter zijn dan de 2x tokenprijskloof.
Hoe GPT-6.2 Sol en Claude Opus 5.5 presteerden
Alle cijfers tot nu toe komen uit OpenAI's grafieken, dus ik draaide één buildtaak tegen beide modellen met een identieke prompt en identieke tooling.
De taak: een enkele HTML-pagina met een full-window, geanimeerde GLSL fragmentshader van een onderwater kelpwoud in de schemering, gehost door p5.js geladen vanaf een CDN.
Het moeilijke is dat de scène verschillende elementen heeft en de cursor ze allemaal moet veranderen:
Het test OpenAI's claim dat GPT-6.2 frontends bouwt die er beter uitzien en beter werken, inclusief 3D-scènes. Beide modellen draaiden in OpenCode met een vastgezet tool-oppervlak (alleen bestand lezen en bewerken), op hoge redeneerinspanning, met één poging elk in een nieuwe sessie en de prompt byte-voor-byte aangeleverd.
Dit is wat GPT-6.2 Sol bouwde: