
Najważniejsze wnioski:
- Oba zbudowały scenę poprawnie za pierwszym razem. Każdy dostarczył prawdziwy fragment shader GLSL z uniformami czasu i myszy, płynnie animowany, rysujący las kelpów, który rozpoznasz na pierwszy rzut oka. Żaden nie potrzebował podpowiedzi.
- Scena GPT-6.2 Sol wygląda bardziej realistycznie. Wersja Opus 5.5 jest nieco bardziej kreskówkowa, co kosztowało go punkt w ocenie dopasowania sceny do briefu.
- Każdy model dobrze zrobił inną „połówkę” latarki. Latarka Sol wygląda jak stożek światła 3D sięgający w głąb sceny, podczas gdy u Opus 5.5 porusza się bardziej po płaskim kącie 2D. Za to kelpy w Opus 5.5 wyraźnie i responsywnie uginają się od latarki, a u Sol efekt odpychania jest słabszy.
Oto wersja Opus 5.5, w której łodygi przy kurszorze wyraźnie ustępują:
Oceniłem oba pod kątem dopasowania sceny do briefu, jakości shadera, interakcji z kursorem oraz tego, czy efekt to prawdziwy shader. Jakość i technika shadera były na pełną punktację u obu; wiersze, w których się różnią:
| Miara | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| Koszt tego przebiegu (USD) | $0,21 | $1,20 |
| Tokeny wyjściowe (w tym rozumowanie) | 16 476 | 44 996 |
| Dopasowanie estetyczne (główny rozstrzygacz) | 5 | 4 |
| Wynik wg rubryki (średnia z czterech osi) | 4,8 | 4,5 |
GPT-6.2 Sol wygrywa ten test nieznacznie, realizmem, co pasuje do tezy OpenAI o lepiej wyglądających frontendach 3D. Sol dobrze oddał światło, a Opus 5.5 — „odpychanie”, i Sol zrobił to za około jedną szóstą kosztu.
To jeden przebieg jednego zadania przy jednym ustawieniu wysiłku. Oba modele łatwo przeskoczyły poprzeczkę techniczną, więc zadecydował gust, a na to pojedynczy przebieg może tylko rzucić światło.
Kiedy wybrać GPT-6.2 Sol, a kiedy Claude Opus 5.5
Wybór zależy od rodzaju pracy, długości promptów i miejsca wdrożenia.
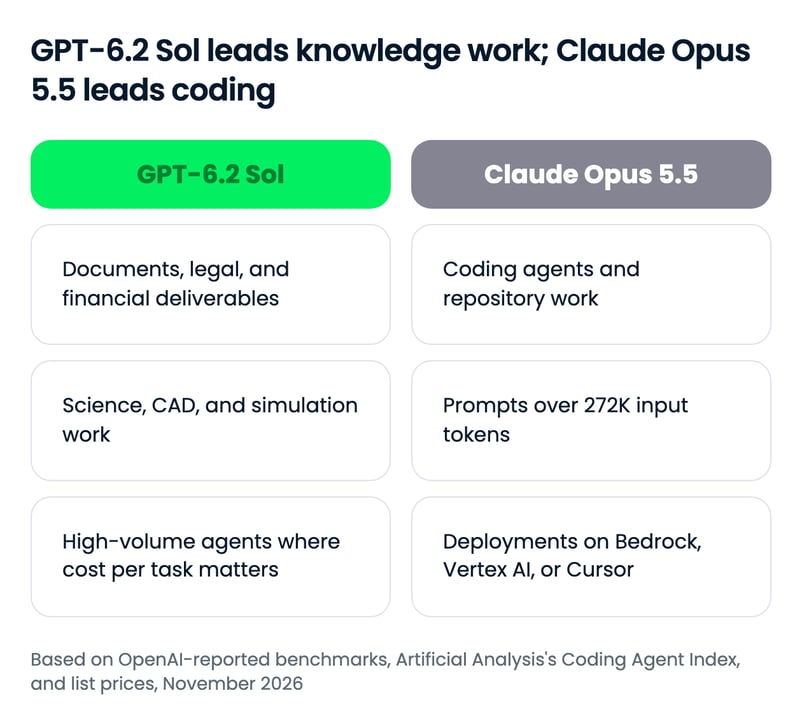
GPT-6.2 Sol powinien być twoim domyślnym wyborem, a Opus 5.5 — modelem wybieranym z konkretnego powodu. Jedyna liczba, która może odwrócić rachunek kosztów, to próg 272K tokenów, powyżej którego dopłata Sol zbliża go cenowo do Opus 5.5.
Wybierz GPT-6.2 Sol, jeśli...
- Tworzysz profesjonalne materiały. Sol prowadzi w GDPval v2 i ponad dwukrotnie przebija Opus 5.5 w benchmarku prawnym Harvey, więc dokumenty, notatki i szkice prawne to jego naturalne środowisko.
- Uruchamiasz zadania naukowe, CAD lub symulacje. Teraz prowadzi w Terminal-Bench-Science i BenchCAD, dwóch benchmarkach, w których GPT-6.1 Sol przegrywał z Opus 5.5.
- Uruchamiasz agentów na dużą skalę. Jego koszt na zadanie to ułamek kosztu Opus 5.5 na każdym wykresie opublikowanym przez OpenAI, a na kilku z nich Sol osiąga blisko maksimum już przy high.
- Pracujesz w Codex, GitHub Copilot lub Azure AI Foundry. GPT-6.2 Sol jest już dostępny na wszystkich trzech.
Wybierz Claude Opus 5.5, jeśli...
- Twoim głównym obciążeniem są agenci kodujący. Opus 5.5 prowadzi w niezależnym Coding Agent Index od Artificial Analysis o 8 punktów, a wyniki Anthropic dla Terminal-Bench 4.0 i CursorBench nie mają jeszcze odpowiednika dla GPT-6.2 Sol.
- Twoje prompty rutynowo przekraczają 272K tokenów. Opus 5.5 nie ma dopłaty za długi kontekst, więc prompty obejmujące całe codebase’y kosztują mniej więcej tyle samo na obu.
- Wdrażasz przez Bedrock, Vertex AI lub Cursor. Opus 5.5 jest dostępny na wszystkich trzech; GPT-6.2 Sol nie figuruje w dokumentacji Cursor, a w naszych źródłach nie znaleźliśmy go na Bedrock ani Vertex AI.
Jak zacząć z GPT-6.2 Sol i Claude Opus 5.5
Dostęp jest prawie identyczny, z tym wyjątkiem, że GPT-6.2 Sol nie jest dostępny w Cursor, bo OpenAI zdecydowało się wycofać swoje modele z tej platformy.
| Powierzchnia | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Aplikacja konsumencka | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Aplikacje Claude |
| API pierwszej strony | OpenAI API | Claude API |
| Platformy chmurowe | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agenci kodujący | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Routery zewnętrzne | OpenRouter | OpenRouter |
| ID modelu w API | gpt-6.2-sol | claude-opus-5-5 |
ID modeli w API to gpt-6.2-sol i claude-opus-5-5; na OpenRouter to openai/gpt-6.2-sol i anthropic/claude-opus-5.5.
Pierwsze wywołanie API
Najszybsza droga, by wypróbować oba, to OpenRouter, gdzie zmiana modelu to zmiana jednego łańcucha znaków:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Dla pełnej budowy nasz samouczek API Opus 5.5 przeprowadza przez projekt agenta od początku do końca.
Na koniec
GPT-6.2 Sol powinien być domyślnym wyborem zamiast Claude Opus 5.5. Wygrywa z Opusem 5.5 na około połowie wspólnych benchmarków i zbliża się na reszcie przy ułamku kosztu na zadanie, co zostawia Opus 5.5 jako wybór do agentów kodujących, bardzo długich promptów oraz wdrożeń na Bedrock, Vertex AI czy Cursor.
Najciekawsze jest dla mnie to, że cena Sol w ogóle się nie zmieniła: OpenAI wygrało tę rundę tokenami wyjściowymi. Pamiętaj, że Opus 5.5 jest na rynku od prawie dwóch miesięcy, co przy obecnym tempie brzmi jak lata świetlne, więc spodziewam się, że kolejna wersja Anthropic powalczy z Sol jakością i efektywnością.
Jeśli budujesz na którymkolwiek z modeli, polecam nasz ścieżkę umiejętności OpenAI Fundamentals lub kurs Introduction to Claude Models.
FAQ
Czy GPT-6.2 Sol jest lepszy niż Claude Opus 5.5?
Na większości wspólnych benchmarków z wykresów startowych OpenAI — tak. GPT-6.2 Sol wygrywa z Opus 5.5 przy maksymalnym wysiłku na Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA i BenchCAD, za znacznie mniejsze pieniądze na zadanie. Opus 5.5 zachowuje wyraźne prowadzenie w agentowym kodowaniu: ma 58 wobec 50 Sol w niezależnym Coding Agent Index od Artificial Analysis.
O ile tańszy jest GPT-6.2 Sol od Claude Opus 5.5?
Cennik API GPT-6.2 Sol to połowa stawek Opus 5.5: $2 vs $4 za milion tokenów wejściowych i $10 vs $20 za milion tokenów wyjściowych. Za ukończone zadanie różnica jest większa, bo Sol używa mniej tokenów wyjściowych. Przy promptach powyżej 272K tokenów wejściowych dopłata Sol zbliża oba modele cenowo.
Co się zmieniło między GPT-6.1 Sol a GPT-6.2 Sol?
GPT-6.2 Sol zachowuje ceny API GPT-6.1 Sol, ale osiąga wyższe wyniki na większości benchmarków OpenAI, używając mniej tokenów wyjściowych. Największe skoki względem Claude Opus 5.5 są w Terminal-Bench-Science, gdzie Sol przeszedł z pozycji goniącego do prowadzenia, i w AutomationBench, gdzie przewaga Opus 5.5 skurczyła się do około jednego punktu.
Gdzie mogę używać GPT-6.2 Sol i Claude Opus 5.5?
GPT-6.2 Sol jest dostępny w ChatGPT Work i Codex dla użytkowników Plus, Pro, Enterprise i Edu oraz w OpenAI API. Claude Opus 5.5 jest dostępny w aplikacjach Claude, Claude Code, Claude API i Cursor. Oba są dostępne na Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot i OpenRouter.
Jakie są ID modeli API dla GPT-6.2 Sol i Claude Opus 5.5?
ID modelu w OpenAI API to gpt-6.2-sol, a ID modelu w Claude API to claude-opus-5-5. Na OpenRouter modele to openai/gpt-6.2-sol i anthropic/claude-opus-5.5, więc możesz przełączać się między nimi, zmieniając jeden łańcuch znaków w tym samym kliencie.

Tom jest redaktorem ds. data science w DataCamp. Pisze i redaguje tutoriale o AI, porównuje nowe wydania LLM i tworzy przepływy pracy zasilane przez AI. Wcześniej pracował w obszarze data science w Deutsche Telekom. Po pracy prognozuje wyniki meczów piłkarskich z wykorzystaniem uczenia maszynowego.
OpenAI wypuściło GPT-6.2 Sol, codzienny wariant rodziny GPT-6.2, dokładnie w tych samych cenach API co GPT-6.1 Sol. Gdy porównywaliśmy GPT-6.1 Sol z Claude Opus 5.5, podział był jasny: Sol dla kosztu na zadanie, Opus 5.5 dla najwyższego odsetka sukcesów w trudnych, agentowych przebiegach przy maksymalnym wysiłku. Wykresy startowe OpenAI dla GPT-6.2 Sol podają tę drugą część w wątpliwość i obejmują Opusa 5.5 na maksymalnym wysiłku prawie wszędzie.
W tym artykule porównam GPT-6.2 Sol i Claude Opus 5.5 w pracy profesjonalnej i nauce, kodowaniu, automatyzacji biznesu oraz cenach, a potem uruchomię oba na tym samym praktycznym zadaniu z shaderem.
Jeśli chcesz lepiej zrozumieć, jak działają modele GPT i jak skutecznie je promptować, zanim przejdziesz do porównania, polecam kurs Intermediate ChatGPT, który omawia architekturę modeli GPT i zaawansowane pisanie promptów. Aby być na bieżąco ze światem AI i danych, polecam nasz cotygodniowy newsletter The Median.
TL;DR
Czym jest GPT-6.2 Sol?
GPT-6.2 Sol to wydajny, średniej klasy model rozumowania od OpenAI, wydany w listopadzie 2026 razem z GPT-6.2 Astra.
OpenAI nazywa go modelem „na co dzień”, a jego główną zaletą jest efektywność: lepsze wyniki niż GPT-6.1 Sol w wymagających zadaniach przy mniejszej liczbie tokenów wyjściowych i niezmienionych cenach.
Nasz przewodnik po GPT-6.2 Astra i Sol omawia premierę, pełny zestaw benchmarków i dwa testy praktyczne.
Czym jest Claude Opus 5.5?
Claude Opus 5.5 to model Anthropic do długotrwałego, agentowego kodowania i pracy wiedzochłonnej, wydany 22 września 2026 jako pierwszy model z rodziny Claude 5.5.
Anthropic pozycjonuje go na poziomie Claude Fable 5.1 w większości zadań, przy 40% niższym koszcie działania niż Opus 5, a jego „thinking” nie może już być wyłączone.
Nasz przewodnik po Claude Opus 5.5 omawia premierę; nasz samouczek API Opus 5.5 buduje z nim AI do badania incydentów.
GPT-6.2 Sol vs Claude Opus 5.5: bezpośrednie porównanie
GPT-6.2 Sol prowadzi teraz z Claude Opus 5.5 na większości wspólnych benchmarków, a Opus 5.5 utrzymuje niewielkie przewagi w kodowaniu i automatyzacji.
W naszym porównaniu GPT-6.1 Sol z Opus 5.5 Opus 5.5 prowadził w większości wyników przy maksymalnym wysiłku. W przypadku GPT-6.2 Sol wykresy OpenAI pokazują Sol z przodu w 5 z 9 benchmarków, na których pojawiają się oba modele, remis w 1 i stratę poniżej 2 punktów w pozostałych 3. Wyjątkiem jest kodowanie: w niezależnym Coding Agent Index od Artificial Analysis Opus 5.5 prowadzi o 8 punktów.
Praca profesjonalna i nauka
Tu werdykt 6.1 się odwraca. GPT-6.1 Sol tracił do Opus 5.5 na Terminal-Bench-Science 0.1, który testuje pracę naukową w terminalu, o 6 punktów przy maksymalnym wysiłku. GPT-6.2 Sol teraz prowadzi: 68,0% do 63,3%, za mniej niż jedną dziesiątą kosztu na zadanie.
Pozostałe wykresy OpenAI dotyczące pracy profesjonalnej wskazują w tym samym kierunku:
Agents' Last Exam, test OpenAI długohoryzontowych przepływów pracy profesjonalnej, jest bliski remisu przy maksymalnym wysiłku. Bardziej wymowny jest poziom wysiłku: Sol przy high jest już powyżej Opus 5.5 przy max, za około $0,69 na zadanie.
Do dokumentów, pracy prawnej, CAD i analiz naukowych GPT-6.2 Sol jest teraz mocniejszym modelem na podstawie dostępnych danych, nie tylko tańszym.
Kodowanie
Kodowanie to obszar, w którym Opus 5.5 nadal wyraźnie prowadzi, a niezależne liczby pokazują lukę większą niż na wykresie OpenAI. W Coding Agent Index od Artificial Analysis, który łączy FrontierCode, Terminal-Bench 4.1 i SWE-Atlas-QnA, Opus 5.5 w Claude Code uzyskuje 58 przy max, wobec 50 dla GPT-6.2 Sol w Codex przy najlepszym ustawieniu, xhigh.
GPT-6.2 Sol faktycznie wypada na tym indeksie gorzej niż GPT-6.1 Sol. Artificial Analysis wiąże spadek z SWE-Atlas-QnA, gdzie nowy model częściej pomija kluczowe fakty w odpowiedziach.
Wykres OpenAI dla FrontierCode 2.0 pokazuje lukę poniżej 2 punktów przy maksymalnym wysiłku. Opus 5.5 kosztuje około dziesięć razy więcej na zadanie przy max na indeksie kodowania (około $12,60 wobec około $1,15), ale do pracy na repozytoriach, gdzie wynik musi być poprawny, jest mocniejszym modelem.
Automatyzacja przepływów biznesowych
AutomationBench, test Zapia agentów wykonujących wielokrokowe przepływy przez aplikacje biznesowe, był nagłówkiem porównania 6.1: Opus 5.5 prowadził o 6 punktów przy max. W GPT-6.2 Sol różnica spadła do 1,4 punktu.
Sol też szybciej się „wypłaszcza”. Osiąga zbliżone wyniki od medium w górę, podczas gdy Opus 5.5 rośnie stopniowo i wyprzedza Sol dopiero przy max, gdzie każde zadanie kosztuje około pięć razy więcej. Dla bota wsparcia czy agenta sales-ops uruchamiającego tysiące przepływów Sol jest teraz oczywistym wyborem; Opus 5.5 ma sens tylko tam, gdzie nieudany przebieg kosztuje więcej niż różnica w cenie.
Ogólne rozumowanie
Opus 5.5 utrzymuje niewielką przewagę w Artificial Analysis Intelligence Index, złożonym z 9 ewaluacji pracy wiedzochłonnej, kodowania i nauki. Przy xhigh Opus 5.5 jest na poziomie Sol przy max, za około sześciokrotny koszt na zadanie. Remisują w Vals Science Index, więc ogólne rozumowanie jest bliskie parytetu z lekkim przechyłem na Anthropic.
Ceny: ile faktycznie płacisz
GPT-6.2 Sol kosztuje o połowę mniej niż Opus 5.5 za token i znacznie mniej za ukończone zadanie.
GPT-6.2 Sol zachowuje stawki GPT-6.1 Sol, więc różnica w cenie za token jest taka jak wcześniej. Różnica w koszcie na zadanie już nie, bo Sol potrzebuje teraz mniej tokenów wyjściowych, by ukończyć to samo. Nasz własny pojedynczy przebieg shadera, omówiony niżej, pokazuje to samo: Opus był prawie 6x droższy niż Sol ($0,21 wobec $1,20).
Stawki za token obok siebie
GPT-6.2 Sol kosztuje dokładnie połowę Opus 5.5 przy każdej standardowej stawce, dopóki prompt nie przekroczy 272K tokenów wejściowych:
Oba modele rozliczają tokeny rozumowania jako wyjściowe, a „thinking” w Opus 5.5 nie da się wyłączyć, więc najbardziej liczy się jego stawka wyjściowa.
Ile kosztuje realne obciążenie
Każdy wynik to (wolumen ÷ 1M) × stawka, zsumowane dla wejścia i wyjścia, wg stawek standardowych.
Dlaczego to samo zadanie kosztuje różnie
Modele używają różnych tokenizatorów, ale większa różnica to liczba tokenów wyjściowych. Wykres GDPval v2 OpenAI pokazuje Opus 5.5 na 191 241 tokenów wyjściowych na zadanie przy max wobec 33 428 dla GPT-6.2 Sol, oraz 61 121 wobec 12 420 przy high.
To pomiary OpenAI, ale porównują bezpośrednio te dwa modele. Gdyby Opus 5.5 potrzebował ok. 3x tokenów wyjściowych Sol przy obciążeniu asystenta zrównoważonego, jak w naszym teście, jego miesięczny rachunek wyniósłby $19,00 wobec $4,50 dla Sol.
Dlatego różnice kosztu na zadanie w tabeli podsumowującej są znacznie szersze niż 2x różnica w cenach tokenów.
Jak wypadły GPT-6.2 Sol i Claude Opus 5.5
Wszystkie dotychczasowe liczby pochodzą z wykresów OpenAI, więc uruchomiłem jedno zadanie budowy na obu modelach z identycznym promptem i identycznymi narzędziami.
Zadanie: pojedyncza strona HTML z pełnoekranowym, animowanym fragment shaderem GLSL przedstawiającym podwodny las kelpów o zmierzchu, hostowana przez p5.js ładowane z CDN.
Trudność polega na tym, że scena ma kilka elementów i kursor musi zmieniać je wszystkie:
To sprawdza tezę OpenAI, że GPT-6.2 buduje frontend’y, które wyglądają i działają lepiej, w tym sceny 3D. Oba modele działały w OpenCode z przypiętą powierzchnią narzędzia (tylko odczyt i edycja plików), przy wysokim wysiłku rozumowania, po jednej próbie w świeżej sesji i prompt dostarczony bajt w bajt.
Oto co zbudował GPT-6.2 Sol: