
As principais conclusões:
- Ambos construíram a cena corretamente na primeira tentativa. Cada um entregou um fragment shader GLSL real, com uniforms de tempo e mouse, animação suave e uma floresta de kelp reconhecível de imediato. Nenhum precisou de ajuste.
- A cena do GPT-6.2 Sol parece mais realista. A versão do Opus 5.5 pende um pouco mais para o estilo cartunesco, o que custou um ponto na aderência estética ao briefing.
- Cada modelo acertou uma metade diferente da lanterna. A lanterna do Sol parece um cone de luz 3D avançando pela cena, enquanto a do Opus 5.5 se move mais num ângulo 2D plano. Mas o kelp do Opus 5.5 se afasta da lanterna de forma clara e responsiva, e o “afastamento” do Sol é mais sutil.
Aqui está a versão do Opus 5.5, em que as hastes perto do cursor cedem visivelmente:
Avaliei ambos pela aderência ao briefing, qualidade do shader, interatividade com o cursor e se o efeito era um shader real. Qualidade e técnica do shader receberam nota máxima nos dois; as linhas em que diferem:
| Métrica | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| Custo desta execução (USD) | US$ 0,21 | US$ 1,20 |
| Tokens de saída (incl. raciocínio) | 16.476 | 44.996 |
| Aderência estética (discriminador primário) | 5 | 4 |
| Score do rubrico (média de quatro eixos) | 4,8 | 4,5 |
O GPT-6.2 Sol vence este teste por pouco, pela dose de realismo, o que combina com a afirmação da OpenAI sobre frontends 3D com aparência melhor. O Sol acertou a luz e o Opus 5.5 acertou o empurrão, e o Sol fez isso por cerca de um sexto do custo.
Este é um run único de uma tarefa, em um nível de esforço. Ambos passaram facilmente na barra técnica, então o que os separou foi gosto, que um único run só consegue sugerir.
Quando escolher GPT-6.2 Sol vs Claude Opus 5.5
A escolha depende do tipo de trabalho, do comprimento dos seus prompts e de onde você vai implantar.
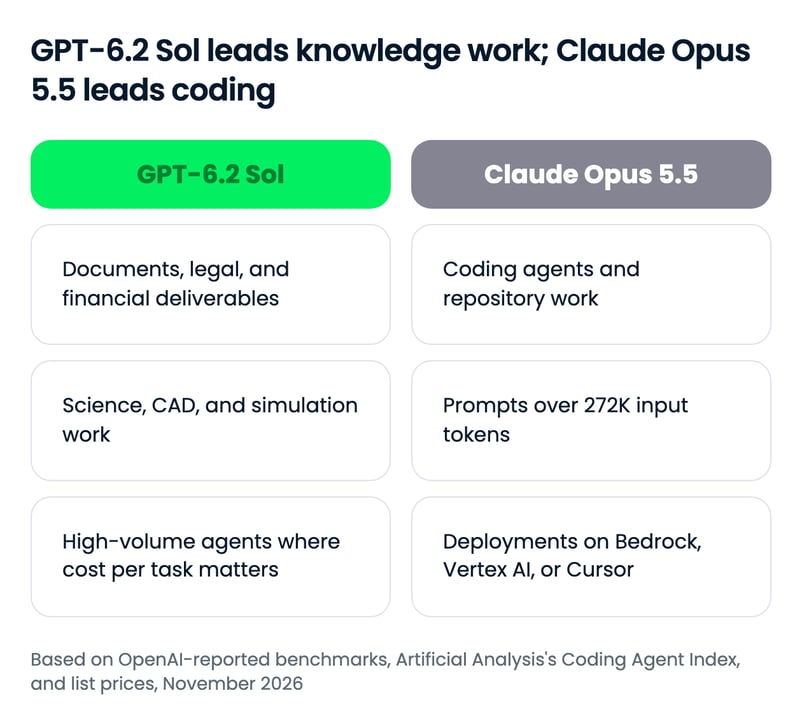
O GPT-6.2 Sol deve ser o seu padrão, e o Opus 5.5 um modelo escolhido por um motivo específico. O único número que pode inverter o caso de custo é o limite de 272K tokens: acima disso, o sobrepreço do Sol o aproxima do preço do Opus 5.5.
Escolha o GPT-6.2 Sol se...
- Você produz entregáveis profissionais. O Sol lidera no GDPval v2 e mais que dobra o Opus 5.5 no benchmark jurídico da Harvey, então documentos, memorandos e minutas legais são seu território.
- Você roda trabalhos científicos, de CAD ou simulação. Agora ele lidera o Terminal-Bench-Science e o BenchCAD, dois benchmarks em que o GPT-6.1 Sol ficava atrás do Opus 5.5.
- Você roda agentes em alto volume. Seu custo por tarefa é uma fração do Opus 5.5 em todos os gráficos publicados pela OpenAI, e em vários deles ele chega perto do máximo já no esforço high.
- Você trabalha no Codex, GitHub Copilot ou Azure AI Foundry. O GPT-6.2 Sol já está listado nos três.
Escolha o Claude Opus 5.5 se...
- Agentes de código são seu workload principal. O Opus 5.5 lidera o Coding Agent Index independente da Artificial Analysis por 8 pontos, e os resultados no Terminal-Bench 4.0 e no CursorBench da Anthropic ainda não têm contraparte do GPT-6.2 Sol.
- Seus prompts passam rotineiramente de 272K tokens. O Opus 5.5 não tem sobrepreço para contexto longo, então prompts com bases de código inteiras custam praticamente o mesmo em ambos.
- Você implanta via Bedrock, Vertex AI ou Cursor. O Opus 5.5 está listado nos três; o GPT-6.2 Sol não aparece na documentação do Cursor, e não encontramos listagem dele no Bedrock ou no Vertex AI nas nossas fontes.
Como começar com GPT-6.2 Sol e Claude Opus 5.5
O acesso é quase idêntico, com a exceção de que o GPT-6.2 Sol não está disponível no Cursor, já que a OpenAI decidiu retirar seus modelos da plataforma.
| Superfície | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| App para consumidor | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Apps do Claude |
| API proprietária | OpenAI API | Claude API |
| Plataformas de nuvem | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agentes de código | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Roteadores de terceiros | OpenRouter | OpenRouter |
| ID do modelo na API | gpt-6.2-sol | claude-opus-5-5 |
Os IDs de modelo na API são gpt-6.2-sol e claude-opus-5-5; no OpenRouter são openai/gpt-6.2-sol e anthropic/claude-opus-5.5.
Fazendo sua primeira chamada de API
A forma mais rápida de testar ambos é o OpenRouter, onde trocar de modelo é mudar uma única string:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Para um build completo, nosso tutorial da API do Opus 5.5 percorre um projeto de agente do início ao fim.
Considerações finais
O GPT-6.2 Sol deve ser a escolha padrão em relação ao Claude Opus 5.5. Ele supera o Opus 5.5 em cerca de metade dos benchmarks compartilhados e chega perto nos demais por uma fração do custo por tarefa, deixando o Opus 5.5 como opção para agentes de código, prompts muito longos e implantações no Bedrock, Vertex AI ou Cursor.
O que mais me chama atenção é que o preço do Sol não mudou: a OpenAI venceu esta rodada nos tokens de saída. Lembre que o Opus 5.5 já está no mercado há quase dois meses, o que, no ritmo atual, parece uma eternidade, então espero que o próximo lançamento da Anthropic concorra com o Sol em qualidade e eficiência.
Se você está construindo em cima de qualquer um dos modelos, recomendo nossa trilha de habilidades OpenAI Fundamentals ou o curso Introduction to Claude Models.
FAQs
O GPT-6.2 Sol é melhor que o Claude Opus 5.5?
Na maioria dos benchmarks que os dois compartilham nos gráficos de lançamento da OpenAI, sim. O GPT-6.2 Sol supera o Opus 5.5 no esforço máximo no Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA e BenchCAD, por um custo muito menor por tarefa. O Opus 5.5 mantém liderança clara em codificação agentiva: marca 58 contra 50 do Sol no Coding Agent Index independente da Artificial Analysis.
Quanto mais barato é o GPT-6.2 Sol do que o Claude Opus 5.5?
As tarifas de API do GPT-6.2 Sol são a metade das do Opus 5.5: US$ 2 vs US$ 4 por milhão de tokens de entrada e US$ 10 vs US$ 20 por milhão de tokens de saída. Por tarefa concluída a diferença é maior, porque o Sol usa menos tokens de saída. Em prompts acima de 272K tokens de entrada, o sobrepreço do Sol aproxima os dois do mesmo valor.
O que mudou entre o GPT-6.1 Sol e o GPT-6.2 Sol?
O GPT-6.2 Sol mantém os preços de API do GPT-6.1 Sol, mas pontua mais alto na maioria dos benchmarks da OpenAI usando menos tokens de saída. Os maiores saltos em relação ao Claude Opus 5.5 estão no Terminal-Bench-Science, onde o Sol passou de atrás para à frente, e no AutomationBench, onde a vantagem do Opus 5.5 encolheu para cerca de um ponto.
Onde posso usar o GPT-6.2 Sol e o Claude Opus 5.5?
O GPT-6.2 Sol está no ChatGPT Work e no Codex para usuários Plus, Pro, Enterprise e Edu, e na OpenAI API. O Claude Opus 5.5 está nos apps do Claude, no Claude Code, na Claude API e no Cursor. Ambos estão disponíveis no Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot e OpenRouter.
Quais são os IDs dos modelos de API do GPT-6.2 Sol e do Claude Opus 5.5?
O ID do modelo na OpenAI API é gpt-6.2-sol, e o ID do modelo na Claude API é claude-opus-5-5. No OpenRouter, os dois modelos são openai/gpt-6.2-sol e anthropic/claude-opus-5.5, então você pode alternar entre eles mudando uma única string no mesmo client.

Tom é editor de ciência de dados na DataCamp. Ele escreve e revisa tutoriais de IA, compara novos lançamentos de LLM e cria fluxos de trabalho com IA. Antes, atuou em ciência de dados na Deutsche Telekom. Fora do trabalho, ele faz previsões de partidas de futebol com aprendizado de máquina.






A OpenAI lançou o GPT-6.2 Sol, o nível para o dia a dia da família GPT-6.2, exatamente com os mesmos preços de API do GPT-6.1 Sol. Quando comparamos o GPT-6.1 Sol com o Claude Opus 5.5, a divisão ficou clara: Sol para custo por tarefa, Opus 5.5 para a maior taxa de sucesso em execuções de agentes difíceis no esforço máximo. Os gráficos de lançamento da OpenAI para o GPT-6.2 Sol colocam essa segunda parte em dúvida e incluem o Opus 5.5 no esforço máximo em quase todos eles.
Neste artigo, vou comparar GPT-6.2 Sol e Claude Opus 5.5 em trabalho profissional e ciência, código, automação de negócios e preços, e depois rodar ambos no mesmo build prático de shader.
Se você quer entender melhor como os modelos GPT funcionam e como fazer bons prompts antes de ler a comparação, recomendo o curso Intermediate ChatGPT, que cobre a arquitetura por trás dos modelos GPT e técnicas avançadas de prompt. Para acompanhar o universo de IA e dados, recomendo assinar nossa newsletter semanal, The Median.
Resumo (TL;DR)
O que é o GPT-6.2 Sol?
O GPT-6.2 Sol é o modelo de raciocínio eficiente de nível intermediário da OpenAI, lançado em novembro de 2026 junto com o GPT-6.2 Astra.
A OpenAI o apresenta como seu modelo de referência para o trabalho do dia a dia, com eficiência como diferencial: melhores resultados que o GPT-6.1 Sol em tarefas exigentes com menos tokens de saída, sem mudança de preço.
Nosso guia do GPT-6.2 Astra e Sol cobre o lançamento, com o conjunto completo de benchmarks e dois testes práticos.
O que é o Claude Opus 5.5?
O Claude Opus 5.5 é o modelo da Anthropic voltado para codificação agentiva de longa duração e trabalho de conhecimento, lançado em 22 de setembro de 2026, como o primeiro modelo da família Claude 5.5.
A Anthropic o posiciona no nível do Claude Fable 5.1 na maior parte do trabalho, custando 40% menos para rodar do que o Opus 5, e seu “pensamento” não pode mais ser desativado.
Nosso guia do Claude Opus 5.5 cobre o lançamento; nosso tutorial da API do Opus 5.5 constrói com ele um investigador de incidentes de IA.
GPT-6.2 Sol vs Claude Opus 5.5: comparação direta
O GPT-6.2 Sol agora lidera o Claude Opus 5.5 na maioria dos benchmarks compartilhados, e o Opus 5.5 mantém vantagens estreitas em código e automação.
Na nossa comparação entre GPT-6.1 Sol e Opus 5.5, o Opus 5.5 liderava a maioria dos resultados no esforço máximo. Com o GPT-6.2 Sol, os gráficos da OpenAI mostram o Sol à frente em 5 dos 9 benchmarks em que ambos aparecem, empatado em 1 e a menos de 2 pontos nos outros 3. Código é a exceção: no Coding Agent Index da Artificial Analysis, independente, o Opus 5.5 lidera por 8 pontos.
Trabalho profissional e ciência
É aqui que o veredito do 6.1 vira. O GPT-6.1 Sol ficava 6 pontos atrás do Opus 5.5 no Terminal-Bench-Science 0.1, que testa trabalho científico em terminal, no esforço máximo. O GPT-6.2 Sol agora lidera: 68,0% contra 63,3%, por menos de um décimo do custo por tarefa.
O restante dos gráficos de trabalho profissional da OpenAI aponta na mesma direção:
O Agents' Last Exam, teste da OpenAI para fluxos de trabalho profissionais de longo horizonte, fica perto de um empate no esforço máximo. O ponto mais revelador no gráfico é o esforço: o Sol em high já fica acima do Opus 5.5 em max, por cerca de US$ 0,69 por tarefa.
Para documentos, trabalhos jurídicos, CAD e análise científica, o GPT-6.2 Sol agora é o modelo mais forte com base nas evidências disponíveis, não apenas o mais barato.
Código
Em código, o Opus 5.5 ainda lidera com clareza, e os números independentes mostram uma diferença bem maior do que o gráfico da OpenAI sugere. No Coding Agent Index da Artificial Analysis, que combina FrontierCode, Terminal-Bench 4.1 e SWE-Atlas-QnA, o Opus 5.5 no Claude Code marca 58 no esforço máximo, contra 50 do GPT-6.2 Sol no Codex no seu melhor ajuste, xhigh.
O GPT-6.2 Sol na verdade pontua abaixo do GPT-6.1 Sol nesse índice. A Artificial Analysis atribui a queda ao SWE-Atlas-QnA, onde o novo modelo tende mais a omitir fatos-chave nas respostas.
O próprio gráfico FrontierCode 2.0 da OpenAI mostra uma diferença inferior a 2 pontos no esforço máximo. O Opus 5.5 custa cerca de dez vezes mais por tarefa no esforço máximo no índice de código (cerca de US$ 12,60 contra cerca de US$ 1,15), mas para trabalho em repositório onde o resultado precisa estar certo, ele é o modelo mais forte.
Automação de fluxos de trabalho de negócios
O AutomationBench, teste da Zapier para agentes executando fluxos multietapas em apps de negócios, foi a manchete da comparação 6.1: o Opus 5.5 liderava por 6 pontos no esforço máximo. Com o GPT-6.2 Sol, a diferença caiu para 1,4 ponto.
O Sol também estabiliza cedo. Ele marca praticamente o mesmo a partir do esforço medium para cima, enquanto o Opus 5.5 sobe de forma constante e só ultrapassa o Sol no max, onde cada tarefa custa cerca de cinco vezes mais. Para um bot de suporte ou um agente de sales ops rodando milhares de fluxos, o Sol agora é a escolha óbvia; o Opus 5.5 só faz sentido onde uma execução com falha custa mais do que a diferença de preço.
Raciocínio geral
O Opus 5.5 mantém uma pequena liderança no Artificial Analysis Intelligence Index, um composto de 9 avaliações em trabalho de conhecimento, código e ciência. No esforço xhigh, o Opus 5.5 empata com o Sol no max, por cerca de seis vezes o custo por tarefa. Eles empatam no Vals Science Index, então o raciocínio geral está perto da paridade com leve vantagem para a Anthropic.
Preços: o que você realmente paga
O GPT-6.2 Sol custa metade do Opus 5.5 por token e bem menos por tarefa concluída.
O GPT-6.2 Sol mantém as tarifas do GPT-6.1 Sol, então a diferença de preço por token é a mesma de antes. A diferença de custo por tarefa não é, porque o Sol agora precisa de menos tokens de saída para concluir o mesmo trabalho. Nosso próprio run único de shader, descrito abaixo, aponta na mesma direção, com o Opus saindo quase 6x mais caro que o Sol (US$ 0,21 contra US$ 1,20).
Tarifas por token, lado a lado
O GPT-6.2 Sol custa exatamente metade do Opus 5.5 em cada tarifa padrão, até que um prompt passe de 272K tokens de entrada:
Ambos os modelos cobram tokens de raciocínio como saída, e o “pensamento” do Opus 5.5 não pode ser desligado, então a tarifa de saída é a que mais pesa.
Quanto custa um workload real
Cada total é (volume ÷ 1M) × tarifa, somado entre entrada e saída, nas tarifas padrão.
Por que a mesma tarefa custa valores diferentes
Os dois modelos usam tokenizadores diferentes, mas a diferença maior é quantos tokens de saída cada um gasta. O gráfico GDPval v2 da OpenAI coloca o Opus 5.5 em 191.241 tokens de saída por tarefa no esforço máximo contra 33.428 do GPT-6.2 Sol, e em 61.121 contra 12.420 no esforço high.
Essas são medições da própria OpenAI, mas comparam diretamente os dois. Se o Opus 5.5 precisasse de cerca de 3 vezes os tokens de saída do Sol no workload de assistente balanceado, como no nosso teste, sua fatura mensal seria de US$ 19,00 contra US$ 4,50 do Sol.
É por isso que as diferenças de custo por tarefa na tabela-resumo ficam muito maiores do que a diferença 2x de preço por token.
Como o GPT-6.2 Sol e o Claude Opus 5.5 se saíram
Até aqui, todos os números vêm dos gráficos da OpenAI, então rodei uma tarefa de build com ambos os modelos, com prompt idêntico e ferramentas idênticas.
A tarefa: uma única página HTML com um fragment shader GLSL em tela cheia e animado de uma floresta de kelp subaquática ao entardecer, hospedado por p5.js carregado de um CDN.
A parte difícil é que a cena tem vários elementos, e o cursor precisa alterar todos eles:
Isso testa a afirmação da OpenAI de que o GPT-6.2 constrói frontends que “parecem e funcionam melhor”, incluindo cenas 3D. Ambos os modelos rodaram no OpenCode com superfície de ferramenta fixada (apenas leitura e edição de arquivos), em alto esforço de raciocínio, com uma tentativa cada em sessão nova e o prompt entregue byte a byte.
Aqui está o que o GPT-6.2 Sol construiu: