
Başlıca bulgular:
- Her ikisi de sahneyi ilk denemede doğru inşa etti. İkisi de zaman ve fare uniform’ları olan gerçek bir GLSL fragment shader’ı teslim etti, akıcı animasyon sundu ve ilk bakışta tanınan bir yosun ormanı çizdi. Hiçbiri yönlendirmeye ihtiyaç duymadı.
- GPT-6.2 Sol’ün sahnesi daha gerçekçi görünüyor. Opus 5.5’in versiyonu biraz daha çizgi filmvari okunuyor; bu da brife ne kadar uyduğuna dair puanlamada ona bir puana mal oldu.
- Her model fenerin farklı yarısını doğru yaptı. Sol’ün feneri sahnenin içine uzanan 3B bir ışık konisi gibi hissettirirken, Opus 5.5’inki daha düz bir 2B açı boyunca hareket ediyor. Ama Opus 5.5’in yosunları fenerden bariz ve duyarlı şekilde uzaklaşıyor; Sol’ün “uzaklaşma” etkisi daha zayıf.
İmlece yakın şeritlerin gözle görülür şekilde yol verdiği Opus 5.5’in versiyonu şöyleydi:
İkisini de brife uyum, shader kalitesi, imleç etkileşimi ve etkinin gerçek bir shader olup olmadığına göre puanladım. Shader kalitesi ve teknik ikisi için de tam puandı; farklılaştıkları satırlar:
| Ölçüt | GPT-6.2 Sol (yüksek) | Claude Opus 5.5 (yüksek) |
|---|---|---|
| Bu çalıştırmanın maliyeti (USD) | $0,21 | $1,20 |
| Çıktı token’ları (akıl yürütme dâhil) | 16.476 | 44.996 |
| Estetik uyum (birincil ayrıştırıcı) | 5 | 4 |
| Rubrik puanı (dört eksenin ortalaması) | 4,8 | 4,5 |
GPT-6.2 Sol bu testi gerçekçilik üzerinden kıl payı kazanıyor; bu da OpenAI’nin daha iyi görünen 3B ön yüzler iddiasıyla örtüşüyor. Sol ışığı doğru yaptı, Opus 5.5 itme etkisini; Sol bunu maliyetin yaklaşık altıda birine yaptı.
Bu, tek bir görevde, tek bir çaba ayarında tek bir çalıştırma. İki model de teknik çıtayı rahat geçti; onları ayıran tat oldu ki tek bir çalıştırma bunun yalnızca ipucunu verebilir.
GPT-6.2 Sol ve Claude Opus 5.5’i Ne Zaman Seçmeli?
Seçim, işin türüne, istemlerinizin uzunluğuna ve dağıtım yüzeyinize bağlı.
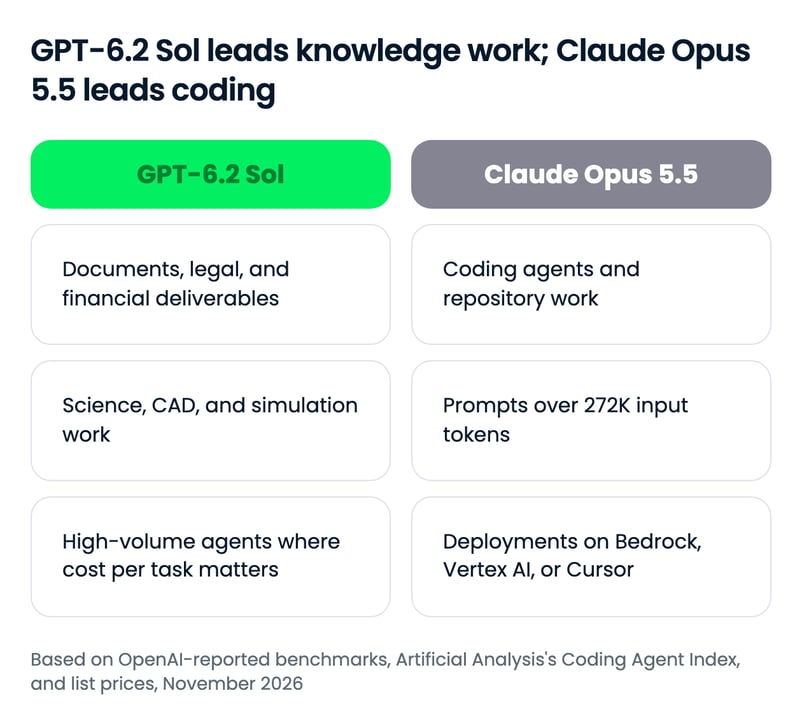
Varsayılanınız GPT-6.2 Sol olmalı; Opus 5.5 ise bir sebeple seçtiğiniz model. Maliyet tablosunu tersine çevirebilecek tek sayı, 272K token eşiği; bunun üzerindeki istemlerde Sol’ün ek ücreti, onu Opus 5.5’in fiyatına yaklaştırır.
Şu durumlarda GPT-6.2 Sol’u seçin...
- Profesyonel teslimatlar üretiyorsanız. Sol, GDPval v2’de önde ve Harvey’nin hukuk kıyaslamasında Opus 5.5’i ikiye katlıyor; dolayısıyla belgeler, notlar ve hukuk taslakları onun doğal alanı.
- Bilimsel, CAD veya simülasyon çalışmaları yürütüyorsanız. GPT-6.1 Sol’un Opus 5.5’in gerisinde kaldığı iki kıyaslama olan Terminal-Bench-Science ve BenchCAD’de artık önde.
- Ajanları yüksek hacimde çalıştırıyorsanız. Görev başına maliyeti OpenAI’nin yayımladığı her grafikte Opus 5.5’in küçük bir kısmı ve OpenAI’nin bazı grafiklerinde yüksek çabada, maksimuma yakın puan alıyor.
- Codex, GitHub Copilot veya Azure AI Foundry’de çalışıyorsanız. GPT-6.2 Sol, üçünün de listesinde yer alıyor.
Şu durumlarda Claude Opus 5.5’i seçin...
- Ana iş yükünüz kodlama ajanlarıysa. Opus 5.5, Artificial Analysis’in bağımsız Coding Agent Index’inde 8 puan önde ve Anthropic’in Terminal-Bench 4.0 ve CursorBench sonuçlarının henüz GPT-6.2 Sol karşılığı yok.
- İstemleriniz rutin olarak 272K token’ı aşıyorsa. Opus 5.5’te uzun bağlam ek ücreti yok; dolayısıyla tüm kod tabanını taşıyan istemlerde iki modelin maliyeti yaklaşık aynı.
- Bedrock, Vertex AI veya Cursor üzerinden dağıtıyorsanız. Opus 5.5 üçünün de listesinde; GPT-6.2 Sol Cursor dokümanlarında yok ve kaynaklarımızda Bedrock veya Vertex AI listesinde bulamadık.
GPT-6.2 Sol ve Claude Opus 5.5 ile Nasıl Başlanır
Erişim neredeyse aynı; tek fark, OpenAI modellerini platformdan çekmeye karar verdiği için GPT-6.2 Sol’un Cursor’da mevcut olmaması.
| Yüzey | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Tüketici uygulaması | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Claude uygulamaları |
| Birinci taraf API | OpenAI API | Claude API |
| Bulut platformları | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Kodlama ajanları | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Üçüncü taraf yönlendiriciler | OpenRouter | OpenRouter |
| API model kimliği | gpt-6.2-sol | claude-opus-5-5 |
API model kimlikleri gpt-6.2-sol ve claude-opus-5-5; OpenRouter’da openai/gpt-6.2-sol ve anthropic/claude-opus-5.5.
İlk API çağrınızı yapmak
İkisini de denemenin en hızlı yolu, modelleri tek bir dize değişikliğiyle değiştirebildiğiniz OpenRouter:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Tam bir kurulum için, Opus 5.5 API eğitimimiz baştan sona bir ajan projesini anlatıyor.
Son Düşünceler
Claude Opus 5.5’e kıyasla varsayılan tercih GPT-6.2 Sol olmalı. Paylaştıkları kıyaslamaların yaklaşık yarısında Opus 5.5’i geçiyor ve kalanında ona çok yaklaşıyor; üstelik görev başına çok daha düşük maliyetle. Böylece Opus 5.5, kodlama ajanları, çok uzun istemler ve Bedrock, Vertex AI veya Cursor dağıtımları için tercih edilen model olarak kalıyor.
En ilginç bulduğum nokta, Sol’ün fiyatının hiç değişmemesi: OpenAI bu raundu çıktı token’larında kazandı. Opus 5.5’in neredeyse iki aydır piyasada olduğunu akılda tutun; mevcut hızda bu “ışık yılı” gibi geliyor, bu yüzden Anthropic’in bir sonraki sürümünün Sol ile kalite ve verimlilikte rekabet etmesini bekliyorum.
Her iki modelle de geliştirme yapıyorsanız, OpenAI Fundamentals yetkinlik yolumuzu veya Claude Modellerine Giriş kursumuzu öneririm.
SSS
GPT-6.2 Sol, Claude Opus 5.5’ten daha mı iyi?
OpenAI’nin lansman grafiklerinde iki modelin paylaştığı kıyaslamaların çoğunda evet. GPT-6.2 Sol, Agents’ Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA ve BenchCAD’de en yüksek çabada Opus 5.5’i, çok daha düşük görev başı maliyetle geçiyor. Opus 5.5, ajansal kodlamada net bir üstünlüğünü koruyor: Artificial Analysis’in bağımsız Coding Agent Index’inde Sol’ün 50 puanına karşı 58 alıyor.
GPT-6.2 Sol, Claude Opus 5.5’ten ne kadar daha ucuz?
GPT-6.2 Sol’un API tarifeleri, Opus 5.5’in yarısı: milyon başına girdi token’ında $2’ya karşı $4 ve milyon başına çıktı token’ında $10’a karşı $20. Bitmiş görev başına fark daha geniş; çünkü Sol daha az çıktı token’ı kullanıyor. 272K girdi token’ını aşan istemlerde Sol’ün ek ücreti, ikisini fiyatta birbirine yaklaştırır.
GPT-6.1 Sol ile GPT-6.2 Sol arasında ne değişti?
GPT-6.2 Sol, GPT-6.1 Sol’un API fiyatlarını koruyor; ancak OpenAI’nin kıyaslamalarının çoğunda daha yüksek puan alırken daha az çıktı token’ı kullanıyor. Claude Opus 5.5’e karşı en büyük sıçramalar, Sol’ün geriden gelip öne geçtiği Terminal-Bench-Science ve Opus 5.5’in üstünlüğünün yaklaşık bir puana indiği AutomationBench’te.
GPT-6.2 Sol ve Claude Opus 5.5’i nerede kullanabilirim?
GPT-6.2 Sol; ChatGPT Work ve Codex’te Plus, Pro, Enterprise ve Edu kullanıcılarına ve OpenAI API’da mevcut. Claude Opus 5.5; Claude uygulamalarında, Claude Code’da, Claude API’da ve Cursor’da mevcut. Her ikisi de Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot ve OpenRouter’da kullanılabiliyor.
GPT-6.2 Sol ve Claude Opus 5.5’in API model kimlikleri nedir?
OpenAI API model kimliği gpt-6.2-sol ve Claude API model kimliği claude-opus-5-5. OpenRouter’da iki model openai/gpt-6.2-sol ve anthropic/claude-opus-5.5; böylece aynı istemci kodunda tek bir dizeyi değiştirerek aralarında geçiş yapabilirsiniz.

Tom, DataCamp’te Veri Bilimi Editörüdür. Yapay zekâ eğitimleri yazar ve düzenler, yeni LLM sürümlerini karşılaştırır ve yapay zekâ destekli iş akışları oluşturur. Daha önce Deutsche Telekom’da veri bilimi alanında çalıştı. İş dışında, makine öğrenmesiyle futbol maçlarını tahmin eder.




OpenAI, GPT-6.2 Sol’ü, GPT-6.2 ailesinin günlük kullanım katmanını, GPT-6.1 Sol ile tam olarak aynı API fiyatlarıyla yayınladı. GPT-6.1 Sol ile Claude Opus 5.5’i karşılaştırdığımızda tablo netti: görev başına maliyet için Sol, en yüksek çabayla zorlu ajan çalıştırmalarında en yüksek başarı oranı için Opus 5.5. OpenAI’nin GPT-6.2 Sol için lansman grafikleri ikinci kısmı sorgulatıyor ve neredeyse hepsinde Opus 5.5’i en yüksek çabayla dahil ediyor.
Bu yazıda GPT-6.2 Sol ve Claude Opus 5.5’i profesyonel iş ve bilim, kodlama, iş otomasyonu ve fiyatlandırma alanlarında karşılaştıracak, ardından ikisini aynı uygulamalı shader çalıştırmasında test edeceğim.
Kıyaslamaya geçmeden önce GPT modellerinin nasıl çalıştığını ve onları etkili biçimde nasıl yönlendireceğinizi daha iyi kavramak isterseniz, GPT modellerinin mimarisini ve ileri seviye istem yazımını ele alan Orta Düzey ChatGPT kursunu öneririm. Yapay zekâ ve veri alanındaki gelişmeleri takip etmek için haftalık bültenimiz The Median’a abone olmanızı tavsiye ederim.
Özet
GPT-6.2 Sol Nedir?
GPT-6.2 Sol, OpenAI’nin Kasım 2026’da GPT-6.2 Astra ile birlikte çıkardığı verimli, orta seviye akıl yürütme modelidir.
OpenAI, bunu günlük işler için başvurulacak modeli olarak tanımlıyor ve öne çıkan özelliği verimlilik: değişmeyen fiyatlarda, talepkâr görevlerde GPT-6.1 Sol’a kıyasla daha iyi sonuçlar ve daha az çıktı token’ı.
GPT-6.2 Astra ve Sol rehberimiz, lansmanı tam kıyaslama seti ve iki uygulamalı testle ele alıyor.
Claude Opus 5.5 Nedir?
Claude Opus 5.5, Anthropic’in uzun soluklu ajansal kodlama ve bilgi işçiliği için tasarlanmış modeli olup, 22 Eylül 2026’da Claude 5.5 ailesinin ilk modeli olarak yayınlandı.
Anthropic, onu çoğu işte Claude Fable 5.1 seviyesine konumlandırıyor; Opus 5’e kıyasla çalıştırma maliyeti %40 daha düşük ve düşünme modu artık kapatılamıyor.
Claude Opus 5.5 rehberimiz lansmanı kapsıyor; Opus 5.5 API eğitimimiz onunla bir yapay zekâ olay soruşturucusu inşa ediyor.
GPT-6.2 Sol vs Claude Opus 5.5: Bire Bir Karşılaştırma
GPT-6.2 Sol artık paylaşılan kıyaslamaların çoğunda Claude Opus 5.5’in önünde, Opus 5.5 ise kodlama ve otomasyonda dar üstünlükler koruyor.
GPT-6.1 Sol vs Opus 5.5 karşılaştırmamızda, Opus 5.5 en yüksek çaba sonuçlarının çoğunda öndeydi. GPT-6.2 Sol ile OpenAI’nin grafiklerinde Sol, her iki modelin de göründüğü 9 kıyaslamanın 5’inde önde, 1’inde başa baş ve diğer 3’ünde 2 puanın altında geride. İstisna kodlama: Artificial Analysis’in bağımsız Coding Agent Index’inde Opus 5.5, 8 puanla önde.
Profesyonel iş ve bilim
6.1 kararının tersine döndüğü yer burası. GPT-6.1 Sol, terminalde bilimsel çalışmaları test eden Terminal-Bench-Science 0.1’de, en yüksek çabada Opus 5.5’in 6 puan gerisindeydi. GPT-6.2 Sol şimdi %68,0’a karşı %63,3 ile önde ve görev başına maliyeti onda birinden az.
OpenAI’nin profesyonel iş grafiklerinin geri kalanı da aynı yöne işaret ediyor:
OpenAI’nin uzun ufuklu profesyonel iş akışları testi Agents’ Last Exam, en yüksek çabada neredeyse beraberlik. O grafikte daha anlamlı nokta çaba düzeyi: yüksek çabada Sol, yaklaşık $0,69 görev başı maliyetle zaten max çabadaki Opus 5.5’in üzerinde.
Belgeler, hukuki çalışmalar, CAD ve bilimsel analiz için, mevcut kanıtlara göre GPT-6.2 Sol artık yalnızca daha ucuz değil, daha güçlü model.
Kodlama
Kodlama, Opus 5.5’in hâlâ net biçimde önde olduğu alan ve bağımsız sayılar, OpenAI’nin grafiğinin gösterdiğinden daha büyük bir fark koyuyor. FrontierCode, Terminal-Bench 4.1 ve SWE-Atlas-QnA’yı birleştiren Artificial Analysis’in Coding Agent Index’inde, Claude Code’da Opus 5.5 en yüksek çabada 58 puan alırken, GPT-6.2 Sol Codex’te en iyi ayarı xhigh’ta 50 puanda kalıyor.
GPT-6.2 Sol, bu endekste aslında GPT-6.1 Sol’dan daha düşük puan alıyor. Artificial Analysis, düşüşü yeni modelin SWE-Atlas-QnA’da yanıtlarda kilit gerçekleri atlama olasılığının artmasına bağlıyor.
OpenAI’nin kendi FrontierCode 2.0 grafiği, en yüksek çabada 2 puanın altında bir fark gösteriyor. Kodlama endeksinde en yüksek çabada Opus 5.5’in görev başına maliyeti yaklaşık on kat daha fazla (yaklaşık $12,60’a karşı yaklaşık $1,15), ancak sonucun mutlaka doğru olması gereken depo çalışmaları için daha güçlü model o.
İş akışı otomasyonu
Zapier’in iş uygulamaları arasında çok adımlı iş akışları yürüten ajanları test ettiği AutomationBench, 6.1 karşılaştırmasının manşetiydi: Opus 5.5 en yüksek çabada 6 puan öndeydi. GPT-6.2 Sol ile fark 1,4 puana indi.
Sol ayrıca erken yataylaşıyor. Orta çabadan itibaren hemen hemen aynı puanı alırken, Opus 5.5 istikrarlı biçimde tırmanıyor ve yalnızca görev başına maliyetin beş katına çıktığı en yüksek çabada Sol’u geçiyor. Binlerce iş akışı yürüten bir destek botu veya satış operasyonları ajanı için Sol artık bariz tercih; Opus 5.5 ancak başarısız bir çalıştırmanın maliyeti fiyat farkını aşarsa mantıklı.
Genel akıl yürütme
Opus 5.5, bilgi işçiliği, kodlama ve bilimi kapsayan 9 değerlendirmenin bileşiği olan Artificial Analysis Intelligence Index’te küçük bir üstünlüğünü koruyor. Xhigh çabada Opus 5.5, görev başına maliyeti yaklaşık altı katına çıkmasına rağmen, Sol’un max seviyedeki puanına yetişiyor. Vals Science Index’te başa başlar; genel akıl yürütme, hafif Anthropic eğilimli bir dengeye yakın.
Fiyatlandırma: gerçekte ne ödersiniz
GPT-6.2 Sol, token başına Opus 5.5’in yarı fiyatına ve bitmiş görev başına çok daha ucuz.
GPT-6.2 Sol, GPT-6.1 Sol’un tarifelerini koruyor; dolayısıyla token fiyat farkı eskisi gibi. Görev başına maliyet farkı ise aynı değil; çünkü Sol, aynı işi bitirmek için artık daha az çıktı token’ına ihtiyaç duyuyor. Aşağıda ele alınan tekil shader çalıştırmamız da aynı yönde: Opus, Sol’den neredeyse 6 kat pahalıydı ($0,21’e karşı $1,20).
Token tarifeleri yan yana
GPT-6.2 Sol, bir istem 272K giriş token’ını aşana kadar her standart tarifede Opus 5.5’in tam yarı fiyatına:
Her iki model de akıl yürütme token’larını çıktı olarak faturalandırıyor ve Opus 5.5’in düşünmesi kapatılamadığından, en çok çıktı ücreti önem taşıyor.
Gerçek bir iş yükü neye mal olur
Her toplam, giriş ve çıkış için (hacim ÷ 1M) × tarife hesabının toplamıdır; standart tarifeler baz alınmıştır.
Aynı görevin maliyeti neden farklı
İki model farklı belirteçleyiciler (tokenizer) kullanıyor, ancak daha büyük fark her birinin harcadığı çıktı token’ı sayısı. OpenAI’nin GDPval v2 grafiği, en yüksek çabada Opus 5.5’i görev başına 191.241 çıktı token’ında, GPT-6.2 Sol’u ise 33.428’de; yüksek çabada da 61.121’e karşı 12.420’de gösteriyor.
Bunlar OpenAI’nin kendi ölçümleri, fakat iki konuyu doğrudan karşılaştırıyorlar. Opus 5.5, dengeli asistan iş yükünde Sol’ün çıktı token’larının yaklaşık 3 katına ihtiyaç duysaydı, bizim testimizde olduğu gibi, aylık faturası Sol’ün $4,50’una karşı $19,00 olurdu.
Özet tablodaki görev başına maliyet farklarının, 2x token fiyat farkından neden çok daha geniş olduğunun sebebi bu.
GPT-6.2 Sol ve Claude Opus 5.5 Nasıl Performans Gösterdi?
Buraya kadar her sayı OpenAI’nin grafiklerinden geliyor; bu yüzden ikisini de aynı istem ve aynı araçlarla tek bir derleme görevi üzerinde çalıştırdım.
Görev: p5.js’i bir CDN’den yükleyen, tam pencereyi kaplayan, alacakaranlıkta su altı yosun ormanı (kelp) sahnesi çizen animasyonlu bir GLSL fragment shader içeren tek sayfalık bir HTML.
Zor olan, sahnede birkaç öğe olması ve imlecin hepsini etkilemesi:
Bu, OpenAI’nin GPT-6.2’nin özellikle 3B sahneler dahil daha iyi görünen ve daha iyi çalışan ön yüzler kurduğu iddiasını yokluyor. Her iki model de OpenCode’da sabitlenmiş araç yüzeyiyle (yalnızca dosya okuma ve düzenleme), yüksek akıl yürütme çabasında, yeni bir oturumda birer deneme ve baytına dokunulmadan iletilen istemle çalıştırıldı.
GPT-6.2 Sol’ün ortaya koyduğu çalışma şöyleydi: