
Die wichtigsten Erkenntnisse:
- Beide bauten die Szene beim ersten Versuch korrekt. Beide lieferten einen echten GLSL-Fragment-Shader mit Time- und Mouse-Uniforms, animierten flüssig und zeichneten einen Kelpwald, der auf Anhieb erkennbar ist. Es brauchte keinen Anstoß.
- Die Szene von GPT-6.2 Sol wirkt realistischer. Die Version von Opus 5.5 liest sich etwas cartoonhafter, was bei der Übereinstimmung mit dem Briefing einen Punkt kostete.
- Jedes Modell traf eine andere Hälfte der Taschenlampe gut. Sols Lichtkegel fühlt sich wie ein 3D-Kegel an, der in die Szene greift, während Opus 5.5 stärker in einem flachen 2D-Winkel wirkt. Dafür weicht bei Opus 5.5 das Kelp klar und reaktionsschnell vor der Lampe zurück, während Sols Wegdrück-Effekt schwächer ist.
Hier ist die Version von Opus 5.5, bei der die Halme in Cursor-Nähe sichtbar nachgeben:
Ich habe beide danach bewertet, wie genau die Szene dem Briefing entsprach, nach Shader-Qualität, Cursor-Interaktivität und ob der Effekt ein echter Shader war. Bei Shader-Qualität und -Technik gab es für beide volle Punktzahl; Unterschiede zeigten sich hier:
| Messgröße | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| Kosten dieses Laufs (USD) | $0,21 | $1,20 |
| Output-Tokens (inkl. Reasoning) | 16.476 | 44.996 |
| Ästhetische Übereinstimmung (Hauptkriterium) | 5 | 4 |
| Rubric-Score (Mittelwert aus vier Achsen) | 4,8 | 4,5 |
GPT-6.2 Sol gewinnt diesen Test knapp – wegen der realistischeren Optik. Das passt zu OpenAIs Aussage über besser aussehende 3D-Frontends. Sol hat das Licht richtig getroffen, Opus 5.5 das Wegdrücken – und Sol tat das zu etwa einem Sechstel der Kosten.
Das ist ein Lauf, eine Aufgabe, ein Effort-Setting. Beide Modelle nahmen die technische Hürde mühelos; der Unterschied lag letztlich im Geschmack – und den kann ein einzelner Lauf nur skizzieren.
Wann du GPT-6.2 Sol vs Claude Opus 5.5 wählst
Die Wahl hängt von der Art der Arbeit, der Länge deiner Prompts und der Zielumgebung ab.
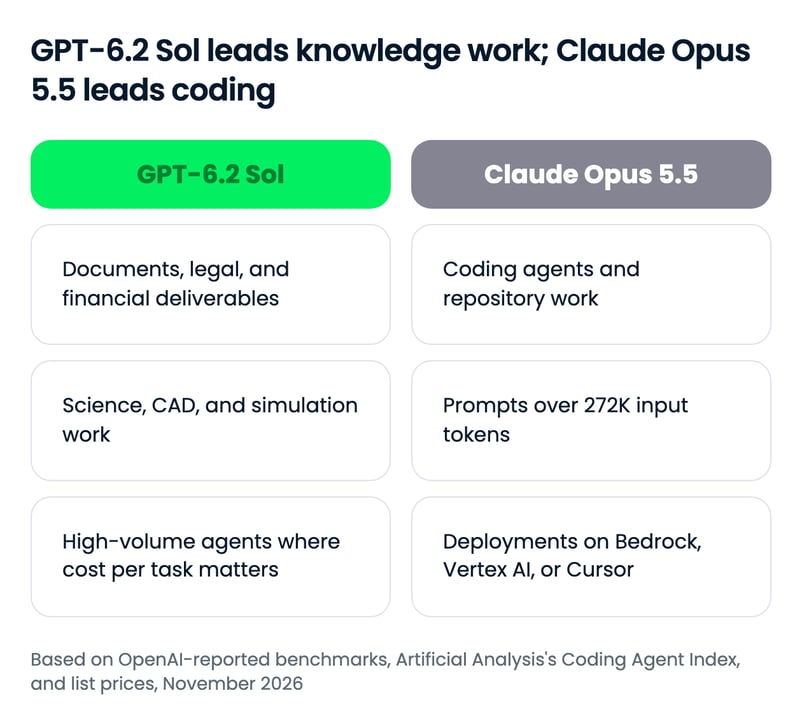
GPT-6.2 Sol sollte dein Standard sein, und Opus 5.5 ein Modell, das du aus gutem Grund wählst. Die eine Zahl, die das Kostenargument kippen kann, ist die 272K-Token-Schwelle – darüber bringt Sols Zuschlag es preislich nahe an Opus 5.5 heran.
Wähle GPT-6.2 Sol, wenn ...
- du professionelle Deliverables produzierst. Sol führt bei GDPval v2 und übertrifft Opus 5.5 beim Harvey-Rechtsbenchmark mehr als doppelt – also ideal für Dokumente, Memos und juristische Entwürfe.
- du wissenschaftliche Arbeiten, CAD oder Simulationen fährst. Es führt jetzt Terminal-Bench-Science und BenchCAD – zwei Benchmarks, bei denen GPT-6.1 Sol noch hinter Opus 5.5 lag.
- du Agenten mit hohem Volumen betreibst. Die Kosten pro Aufgabe sind auf allen veröffentlichten OpenAI-Charts nur ein Bruchteil von Opus 5.5, und auf mehreren Charts erreicht Sol schon bei High-Effort fast sein Maximum.
- du in Codex, GitHub Copilot oder Azure AI Foundry arbeitest. GPT-6.2 Sol ist dort bereits gelistet.
Wähle Claude Opus 5.5, wenn ...
- Coding-Agenten dein Haupt-Workload sind. Opus 5.5 führt den unabhängigen Coding Agent Index von Artificial Analysis mit 8 Punkten, und Anthropics Terminal-Bench 4.0- und CursorBench-Ergebnisse haben noch kein GPT-6.2-Sol-Pendant.
- deine Prompts regelmäßig über 272K Tokens liegen. Opus 5.5 hat keinen Long-Context-Zuschlag, sodass Whole-Codebase-Prompts bei beiden Modellen ähnlich kosten.
- du über Bedrock, Vertex AI oder Cursor deployst. Opus 5.5 ist auf allen drei gelistet; GPT-6.2 Sol steht nicht in den Cursor-Dokumenten, und in unseren Quellen fanden wir keine Bedrock- oder Vertex-AI-Listung.
So startest du mit GPT-6.2 Sol und Claude Opus 5.5
Der Zugang ist fast identisch, außer dass GPT-6.2 Sol nicht in Cursor verfügbar ist, seit OpenAI seine Modelle von der Plattform zurückgezogen hat.
| Surface | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Consumer-App | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Claude-Apps |
| First-Party-API | OpenAI API | Claude API |
| Cloud-Plattformen | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Coding-Agenten | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Drittanbieter-Router | OpenRouter | OpenRouter |
| API-Model-ID | gpt-6.2-sol | claude-opus-5-5 |
Die API-Model-IDs sind gpt-6.2-sol und claude-opus-5-5; auf OpenRouter heißen sie openai/gpt-6.2-sol und anthropic/claude-opus-5.5.
Deinen ersten API-Call machen
Am schnellsten probierst du beide über OpenRouter aus – der Modellwechsel ist dort eine Ein-String-Änderung:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Für ein komplettes Build führt unser Opus-5.5-API-Tutorial ein Agentenprojekt von Anfang bis Ende durch.
Fazit
GPT-6.2 Sol sollte gegenüber Claude Opus 5.5 die Standardwahl sein. Es schlägt Opus 5.5 in etwa der Hälfte der gemeinsamen Benchmarks und liegt beim Rest knapp dahinter – zu einem Bruchteil der Kosten pro Aufgabe. Damit bleibt Opus 5.5 die erste Wahl für Coding-Agenten, sehr lange Prompts sowie Deployments auf Bedrock, Vertex AI oder Cursor.
Am interessantesten finde ich, dass Sols Preis nie geändert wurde: OpenAI hat diese Runde über die Output-Tokens gewonnen. Bedenke, dass Opus 5.5 seit fast zwei Monaten draußen ist – bei dem aktuellen Tempo ist das eine Ewigkeit. Ich erwarte daher, dass Anthropics nächstes Release bei Qualität und Effizienz zu Sol aufschließt.
Wenn du auf einem der Modelle aufbaust, empfehle ich unseren OpenAI Fundamentals-Lernpfad oder den Kurs Introduction to Claude Models.
FAQs
Ist GPT-6.2 Sol besser als Claude Opus 5.5?
Auf den meisten gemeinsamen Benchmarks in OpenAIs Launch-Charts: ja. GPT-6.2 Sol schlägt Opus 5.5 bei Max-Effort in Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA und BenchCAD – und das zu deutlich geringeren Kosten pro Aufgabe. Opus 5.5 behält beim agentischen Coding einen klaren Vorsprung: Es erzielt 58 Punkte gegenüber 50 für Sol im unabhängigen Coding Agent Index von Artificial Analysis.
Wie viel günstiger ist GPT-6.2 Sol als Claude Opus 5.5?
Die API-Tarife von GPT-6.2 Sol betragen die Hälfte derer von Opus 5.5: $2 vs. $4 pro Million Input-Tokens und $10 vs. $20 pro Million Output-Tokens. Pro abgeschlossener Aufgabe ist der Abstand größer, weil Sol weniger Output-Tokens nutzt. Bei Prompts über 272K Input-Tokens bringt Sols Zuschlag beide preislich nahe zusammen.
Was hat sich zwischen GPT-6.1 Sol und GPT-6.2 Sol geändert?
GPT-6.2 Sol behält die API-Preise von GPT-6.1 Sol, erzielt aber auf den meisten OpenAI-Benchmarks höhere Werte und verwendet weniger Output-Tokens. Die größten Sprünge gegenüber Claude Opus 5.5 sind bei Terminal-Bench-Science, wo Sol vom Rückstand zur Führung wechselte, und bei AutomationBench, wo Opus 5.5s Vorsprung auf etwa einen Punkt schrumpfte.
Wo kann ich GPT-6.2 Sol und Claude Opus 5.5 nutzen?
GPT-6.2 Sol ist in ChatGPT Work und Codex für Plus-, Pro-, Enterprise- und Edu-Nutzer sowie in der OpenAI API verfügbar. Claude Opus 5.5 gibt es in den Claude-Apps, in Claude Code, über die Claude API und in Cursor. Beide sind auf Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot und OpenRouter verfügbar.
Wie lauten die API-Model-IDs für GPT-6.2 Sol und Claude Opus 5.5?
Die OpenAI-API-Model-ID lautet gpt-6.2-sol, die Claude-API-Model-ID claude-opus-5-5. Auf OpenRouter heißen die Modelle openai/gpt-6.2-sol und anthropic/claude-opus-5.5, sodass du in demselben Client-Code durch das Ändern eines einzelnen Strings umschalten kannst.

Tom ist Redakteur für Data Science bei DataCamp. Er schreibt und redigiert KI-Tutorials, vergleicht neue LLM-Releases und entwickelt KI-gestützte Workflows. Zuvor arbeitete er im Data-Science-Bereich bei der Deutschen Telekom. Abseits der Arbeit sagt er Fußballspiele mit Machine Learning voraus.




OpenAI hat GPT-6.2 Sol veröffentlicht, die Alltagsstufe der GPT-6.2-Familie, zu exakt denselben API-Preisen wie GPT-6.1 Sol. Als wir GPT-6.1 Sol mit Claude Opus 5.5 verglichen haben, war die Aufteilung klar: Sol für die Kosten pro Aufgabe, Opus 5.5 für die höchste Erfolgsquote bei harten Agentenläufen mit maximalem Aufwand. OpenAIs Launch-Charts zu GPT-6.2 Sol stellen diese zweite Hälfte in Frage – und sie enthalten Opus 5.5 mit Max-Effort in fast allen Vergleichen.
In diesem Artikel vergleiche ich GPT-6.2 Sol und Claude Opus 5.5 in den Bereichen professionelle Arbeit und Wissenschaft, Coding, Geschäftsautomatisierung und Preise – und lasse beide anschließend denselben Shader in einem Praxistest bauen.
Wenn du vorab besser verstehen willst, wie GPT-Modelle funktionieren und wie du sie gezielt promptest, empfehle ich den Kurs Intermediate ChatGPT, der die Architektur hinter GPT-Modellen und fortgeschrittenes Prompting behandelt. Um beim Thema KI und Daten am Ball zu bleiben, abonniere unseren wöchentlichen Newsletter The Median.
TL;DR
Was ist GPT-6.2 Sol?
GPT-6.2 Sol ist OpenAIs effizientes Reasoning-Modell der Mittelklasse, veröffentlicht im November 2026 zusammen mit GPT-6.2 Astra.
OpenAI positioniert es als Standardmodell für die tägliche Arbeit. Das Verkaufsargument ist Effizienz: bessere Ergebnisse als GPT-6.1 Sol bei anspruchsvollen Aufgaben mit weniger Output-Tokens – bei unveränderten Preisen.
Unser Leitfaden zu GPT-6.2 Astra und Sol deckt den Launch ab – inklusive aller Benchmarks und zwei Praxis-Tests.
Was ist Claude Opus 5.5?
Claude Opus 5.5 ist Anthropics Modell für langlaufendes agentisches Coding und Wissensarbeit, veröffentlicht am 22. September 2026 als erstes Modell der Claude-5.5-Familie.
Anthropic positioniert es auf dem Niveau von Claude Fable 5.1 bei den meisten Aufgaben, bei 40% geringeren Laufkosten als Opus 5 – und sein "Denken" lässt sich nicht mehr abschalten.
Unser Leitfaden zu Claude Opus 5.5 behandelt den Launch; unser Opus-5.5-API-Tutorial baut damit einen KI-Incident-Investigator.
GPT-6.2 Sol vs Claude Opus 5.5: Direktvergleich
GPT-6.2 Sol liegt inzwischen bei den meisten gemeinsamen Benchmarks vorn, während Opus 5.5 beim Coding und bei der Automatisierung knappe Vorteile behält.
In unserem Vergleich GPT-6.1 Sol vs Opus 5.5 führte Opus 5.5 die meisten Max-Effort-Ergebnisse an. Mit GPT-6.2 Sol zeigen OpenAIs Charts Sol vorne in 5 von 9 Benchmarks, gleichauf in einem und weniger als 2 Punkte hinten in den übrigen 3. Die Ausnahme ist Coding: Beim unabhängigen Coding Agent Index von Artificial Analysis liegt Opus 5.5 um 8 Punkte vorn.
Professionelle Arbeit und Wissenschaft
Hier dreht sich das 6.1-Urteil. GPT-6.1 Sol lag bei Terminal-Bench-Science 0.1, einem Test wissenschaftlicher Terminal-Arbeit, mit Max-Effort 6 Punkte hinter Opus 5.5. GPT-6.2 Sol liegt jetzt vorn – 68,0% zu 63,3% – bei weniger als einem Zehntel der Kosten pro Aufgabe.
Die übrigen Charts zu professioneller Arbeit deuten in dieselbe Richtung:
Agents' Last Exam, OpenAIs Test langwieriger professioneller Workflows, ist bei Max-Effort nahezu ein Unentschieden. Aussagekräftiger ist der Blick auf den Aufwand: Sol liegt bei High-Effort bereits über Opus 5.5 bei Max – für rund $0,69 pro Aufgabe.
Für Dokumente, juristische Arbeit, CAD und wissenschaftliche Analysen ist GPT-6.2 Sol nach derzeitigem Stand das stärkere Modell – nicht nur das günstigere.
Coding
Beim Coding liegt Opus 5.5 weiterhin klar vorn, und die unabhängigen Zahlen zeigen eine größere Lücke, als OpenAIs Chart nahelegt. Im Coding Agent Index von Artificial Analysis, der FrontierCode, Terminal-Bench 4.1 und SWE-Atlas-QnA kombiniert, erzielt Opus 5.5 in Claude Code bei Max-Effort 58 Punkte, gegenüber 50 für GPT-6.2 Sol in Codex bei seiner besten Einstellung, xhigh.
GPT-6.2 Sol schneidet auf diesem Index sogar schlechter ab als GPT-6.1 Sol. Artificial Analysis führt das auf SWE-Atlas-QnA zurück, wo das neue Modell eher zentrale Fakten in Antworten auslässt.
OpenAIs eigener FrontierCode-2.0-Chart zeigt bei Max-Effort weniger als 2 Punkte Abstand. Opus 5.5 kostet auf dem Coding-Index bei Max-Effort etwa das Zehnfache pro Aufgabe (rund $12,60 vs. etwa $1,15), aber für Repository-Arbeit, bei der das Ergebnis stimmen muss, ist es das stärkere Modell.
Automatisierung von Geschäfts-Workflows
AutomationBench, Zapiers Test von Agenten in mehrstufigen Workflows über Business-Apps, war der Aufmacher im 6.1-Vergleich: Opus 5.5 führte mit 6 Punkten bei Max-Effort. Mit GPT-6.2 Sol schrumpft die Lücke auf 1,4 Punkte.
Sol flacht zudem früher ab. Ab Medium-Effort liegt es etwa gleichauf, während Opus 5.5 stetig steigt und Sol erst bei Max überholt – dann aber zu etwa dem Fünffachen der Kosten pro Aufgabe. Für Support-Bots oder Sales-Ops-Agenten mit tausenden Workflows ist Sol nun die klare Wahl; Opus 5.5 lohnt sich nur, wenn ein Fehlversuch teurer ist als der Preisunterschied.
Allgemeines Reasoning
Opus 5.5 behält einen kleinen Vorsprung beim Artificial Analysis Intelligence Index, einem Komposit aus 9 Bewertungen zu Wissensarbeit, Coding und Wissenschaft. Bei xhigh liegt Opus 5.5 gleichauf mit Sol auf Max – zu etwa dem Sechsfachen der Kosten pro Aufgabe. Beim Vals Science Index herrscht Gleichstand, insgesamt also nahezu Parität mit leichter Anthropic-Tendenz.
Preise: Was du tatsächlich zahlst
GPT-6.2 Sol kostet pro Token die Hälfte von Opus 5.5 – und pro abgeschlossener Aufgabe deutlich weniger.
GPT-6.2 Sol behält die Tarife von GPT-6.1 Sol, also bleibt der Token-Preisabstand unverändert. Der Abstand bei den Kosten pro Aufgabe vergrößert sich jedoch, weil Sol jetzt weniger Output-Tokens benötigt. Unser eigener Shaderlauf unten zeigt dasselbe Bild: Opus war fast 6x so teuer wie Sol ($0,21 gegenüber $1,20).
Token-Tarife im direkten Vergleich
GPT-6.2 Sol kostet bei allen Standardtarifen exakt die Hälfte von Opus 5.5 – bis ein Prompt 272K Input-Tokens überschreitet:
Beide Modelle rechnen Reasoning-Tokens als Output ab, und bei Opus 5.5 lässt sich das Denken nicht abschalten – daher ist der Output-Tarif hier am wichtigsten.
Was eine echte Last kostet
Jede Summe ist (Volumen ÷ 1M) × Tarif, addiert über Input und Output, zu Standardtarifen.
Warum dieselbe Aufgabe unterschiedlich viel kostet
Die Modelle nutzen unterschiedliche Tokenizer, aber entscheidender ist die Menge an Output-Tokens. OpenAIs GDPval-v2-Chart zeigt Opus 5.5 bei Max-Effort mit 191.241 Output-Tokens pro Aufgabe gegenüber 33.428 bei GPT-6.2 Sol – und bei High-Effort mit 61.121 gegenüber 12.420.
Das sind OpenAIs eigene Messungen, vergleichen aber direkt dieselbe Aufgabe. Wenn Opus 5.5 beim Workload "Ausgewogener Assistent" etwa dreimal so viele Output-Tokens bräuchte wie Sol, wie in unserem Test, läge die Monatsrechnung bei $19,00 gegenüber $4,50.
Deshalb fallen die Kosten-pro-Aufgabe-Abstände in der Übersicht deutlich größer aus als die 2x-Differenz bei den Tokenpreisen.
So haben sich GPT-6.2 Sol und Claude Opus 5.5 geschlagen
Bisher stammen alle Zahlen aus OpenAIs Charts. Also habe ich eine Build-Aufgabe mit identischem Prompt und identischem Tooling gegen beide Modelle gefahren.
Die Aufgabe: Eine einzelne HTML-Seite mit einem vollflächigen, animierten GLSL-Fragment-Shader eines Unterwasser-Kelpwaldes in der Dämmerung, gehostet von p5.js aus einem CDN.
Die Schwierigkeit: Die Szene hat mehrere Elemente, und der Cursor muss sie alle beeinflussen:
Das prüft OpenAIs Behauptung, GPT-6.2 baue Frontends, die besser aussehen und funktionieren – auch 3D-Szenen. Beide Modelle liefen in OpenCode mit fixiertem Tool-Surface (nur Datei lesen und bearbeiten), bei hohem Reasoning-Aufwand, jeweils ein Versuch in einer frischen Session und der Prompt Byte für Byte identisch.
So sah das Ergebnis von GPT-6.2 Sol aus: