
Les principaux constats :
- Les deux ont construit la scène correctement du premier coup. Chacun a livré un vrai shader de fragment GLSL avec des uniforms de temps et de souris, animé de manière fluide, et a dessiné une forêt de kelp reconnaissable au premier regard. Aucun n’a eu besoin d’un recadrage.
- La scène de GPT-6.2 Sol paraît plus réaliste. La version d’Opus 5.5 est un peu plus « cartoon », ce qui lui a coûté un point sur l’adéquation esthétique au brief.
- Chaque modèle a réussi une moitié différente de l’effet lampe. La lampe de Sol ressemble à un cône de lumière 3D qui pénètre dans la scène, tandis que celle d’Opus 5.5 se déplace davantage selon un angle 2D. Mais les algues d’Opus 5.5 se plient clairement et de façon réactive devant la lampe, et l’effet « repoussé » de Sol est plus faible.
Voici la version d’Opus 5.5, où les brins proches du curseur cèdent visiblement :
J’ai noté les deux selon la fidélité au brief, la qualité du shader, l’interactivité au curseur, et le fait que l’effet soit bien un shader réel. La qualité et la technique du shader ont obtenu la note maximale pour les deux ; voici les lignes où ils diffèrent :
| Mesure | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| Coût de ce run (USD) | 0,21 $ | 1,20 $ |
| Tokens de sortie (raisonnement inclus) | 16 476 | 44 996 |
| Correspondance esthétique (critère principal) | 5 | 4 |
| Score du barème (moyenne sur quatre axes) | 4,8 | 4,5 |
GPT-6.2 Sol remporte ce test de peu, sur le réalisme, ce qui cadre avec l’affirmation d’OpenAI sur des frontends 3D plus réussis. Sol a bien géré la lumière et Opus 5.5 a bien géré la poussée, et Sol l’a fait pour environ un sixième du coût.
Il s’agit d’un run, d’une tâche, à un niveau d’effort. Les deux modèles ont franchi sans peine la barre technique ; ce qui les a départagés, c’est le goût, et un seul run ne peut qu’en donner un aperçu.
Quand choisir GPT-6.2 Sol vs Claude Opus 5.5
Le choix dépend du type de travail, de la longueur de vos prompts et de votre surface de déploiement.
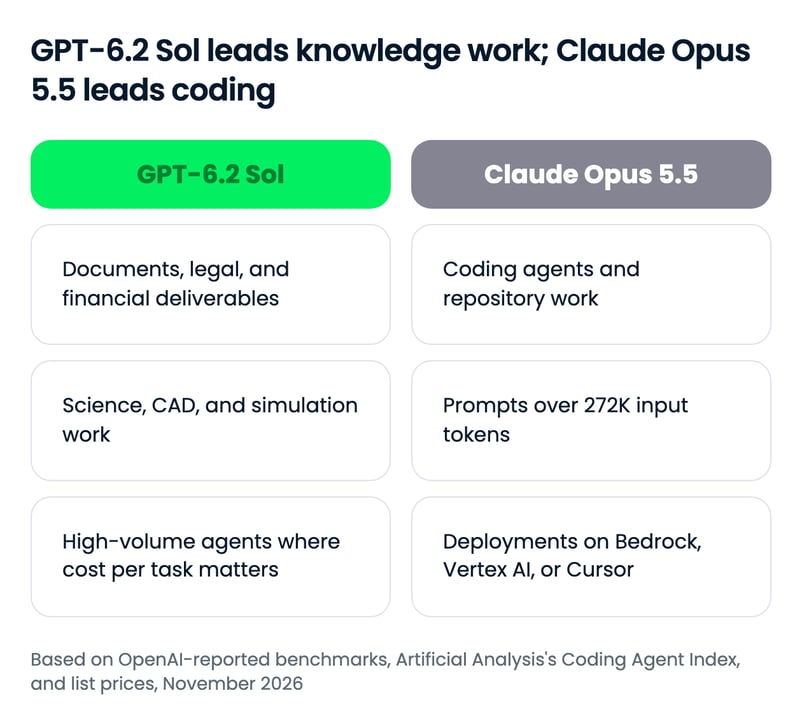
GPT-6.2 Sol devrait être votre défaut, et Opus 5.5 un choix motivé. Le seul chiffre qui peut inverser l’avantage coût, c’est le seuil des 272 K tokens, au-delà duquel le surcoût de Sol le rapproche du prix d’Opus 5.5.
Choisissez GPT-6.2 Sol si…
- Vous produisez des livrables professionnels. Sol mène sur GDPval v2 et fait plus que doubler Opus 5.5 sur le benchmark juridique d’Harvey, donc documents, notes et brouillons juridiques sont son terrain de prédilection.
- Vous exécutez des travaux scientifiques, CAO ou de simulation. Il mène désormais sur Terminal-Bench-Science et BenchCAD, deux benchmarks où GPT-6.1 Sol était derrière Opus 5.5.
- Vous faites tourner des agents à grand volume. Son coût par tâche est une fraction de celui d’Opus 5.5 sur tous les graphiques publiés par OpenAI, et sur plusieurs graphiques il atteint presque son maximum dès le niveau high.
- Vous travaillez dans Codex, GitHub Copilot ou Azure AI Foundry. GPT-6.2 Sol est déjà listé sur les trois.
Choisissez Claude Opus 5.5 si…
- Les agents de codage sont votre charge principale. Opus 5.5 mène de 8 points sur le Coding Agent Index indépendant d’Artificial Analysis, et les résultats d’Anthropic sur Terminal-Bench 4.0 et CursorBench n’ont pas encore d’équivalent GPT-6.2 Sol.
- Vos prompts dépassent régulièrement 272 K tokens. Opus 5.5 n’a pas de surcoût long contexte, donc les prompts englobant des bases de code entières coûtent à peu près pareil sur les deux.
- Vous déployez via Bedrock, Vertex AI ou Cursor. Opus 5.5 est listé sur les trois ; GPT-6.2 Sol n’apparaît pas dans la doc Cursor, et nous n’avons trouvé aucune entrée Bedrock ou Vertex AI pour lui dans nos sources.
Comment démarrer avec GPT-6.2 Sol et Claude Opus 5.5
L’accès est presque identique, à ceci près que GPT-6.2 Sol n’est pas disponible dans Cursor, OpenAI ayant décidé de retirer ses modèles de la plateforme.
| Surface | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| App grand public | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Apps Claude |
| API propriétaire | OpenAI API | Claude API |
| Plateformes cloud | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agents de code | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Routeurs tiers | OpenRouter | OpenRouter |
| ID du modèle API | gpt-6.2-sol | claude-opus-5-5 |
Les IDs de modèle API sont gpt-6.2-sol et claude-opus-5-5 ; sur OpenRouter, ce sont openai/gpt-6.2-sol et anthropic/claude-opus-5.5.
Faire votre premier appel API
La voie la plus rapide pour essayer les deux est OpenRouter, où changer de modèle tient en une chaîne :
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Pour un build complet, notre tutoriel API Opus 5.5 détaille un projet d’agent de bout en bout.
Conclusion
GPT-6.2 Sol devrait être le choix par défaut face à Claude Opus 5.5. Il surpasse Opus 5.5 sur environ la moitié de leurs benchmarks communs et s’approche des autres pour une fraction du coût par tâche, ce qui laisse à Opus 5.5 le rôle de choix pour les agents de code, les prompts très longs, et les déploiements sur Bedrock, Vertex AI ou Cursor.
Ce que je trouve le plus intéressant, c’est que le prix de Sol n’a jamais changé : OpenAI a gagné cette manche sur les tokens de sortie. Gardez à l’esprit qu’Opus 5.5 est sorti depuis presque deux mois, ce qui, au rythme actuel, paraît une éternité ; je m’attends donc à ce que la prochaine version d’Anthropic rivalise avec Sol sur la qualité et l’efficacité.
Si vous construisez sur l’un ou l’autre modèle, je vous recommande notre parcours de compétences OpenAI Fundamentals ou notre cours Introduction to Claude Models.
FAQ
GPT-6.2 Sol est-il meilleur que Claude Opus 5.5 ?
Sur la plupart des benchmarks partagés figurant dans les graphiques de lancement d’OpenAI, oui. GPT-6.2 Sol bat Opus 5.5 à effort max sur Agents’ Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA et BenchCAD, pour un coût nettement inférieur par tâche. Opus 5.5 conserve une avance nette en codage agentique : il obtient 58 contre 50 pour Sol sur le Coding Agent Index indépendant d’Artificial Analysis.
De combien GPT-6.2 Sol est-il moins cher que Claude Opus 5.5 ?
Les tarifs API de GPT-6.2 Sol sont la moitié de ceux d’Opus 5.5 : 2 $ vs 4 $ par million de tokens d’entrée et 10 $ vs 20 $ par million de tokens de sortie. Par tâche terminée, l’écart est plus large, car Sol utilise moins de tokens en sortie. Sur des prompts au-delà de 272 K tokens d’entrée, le surcoût de Sol rapproche les deux modèles en prix.
Qu’est-ce qui a changé entre GPT-6.1 Sol et GPT-6.2 Sol ?
GPT-6.2 Sol conserve les prix API de GPT-6.1 Sol mais obtient de meilleurs scores sur la plupart des benchmarks d’OpenAI tout en utilisant moins de tokens de sortie. Les plus grands progrès face à Claude Opus 5.5 concernent Terminal-Bench-Science, où Sol est passé de derrière à devant, et AutomationBench, où l’avance d’Opus 5.5 s’est réduite à environ un point.
Où puis-je utiliser GPT-6.2 Sol et Claude Opus 5.5 ?
GPT-6.2 Sol est disponible dans ChatGPT Work et Codex pour les utilisateurs Plus, Pro, Enterprise et Edu, ainsi que via l’OpenAI API. Claude Opus 5.5 est dans les apps Claude, Claude Code, la Claude API et Cursor. Les deux sont disponibles sur Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot et OpenRouter.
Quels sont les IDs de modèle API de GPT-6.2 Sol et Claude Opus 5.5 ?
L’ID du modèle dans l’OpenAI API est gpt-6.2-sol, et l’ID dans la Claude API est claude-opus-5-5. Sur OpenRouter, les deux modèles sont openai/gpt-6.2-sol et anthropic/claude-opus-5.5, ce qui permet d’alterner entre eux en changeant une seule chaîne dans le même client.

Tom est rédacteur en data science chez DataCamp. Il rédige et édite des tutoriels sur l'IA, compare les nouvelles versions de LLM et conçoit des workflows propulsés par l'IA. Auparavant, il a travaillé en data science chez Deutsche Telekom. En dehors du travail, il prévoit les résultats de matchs de football grâce à l'apprentissage automatique.







OpenAI a lancé GPT-6.2 Sol, la version du quotidien de la famille GPT-6.2, aux mêmes tarifs API que GPT-6.1 Sol. Lorsque nous avons comparé GPT-6.1 Sol à Claude Opus 5.5, la répartition était nette : Sol pour le coût par tâche, Opus 5.5 pour le meilleur taux de réussite sur des runs agents difficiles au niveau d’effort maximal. Les graphiques de lancement d’OpenAI pour GPT-6.2 Sol remettent en cause cette seconde moitié, et ils incluent Opus 5.5 au niveau max sur presque tous.
Dans cet article, je compare GPT-6.2 Sol et Claude Opus 5.5 sur le travail professionnel et la science, le code, l’automatisation métier et la tarification, puis je les fais tourner tous deux sur le même build de shader en conditions réelles.
Si vous souhaitez d’abord mieux comprendre le fonctionnement des modèles GPT et comment les solliciter efficacement, je vous recommande le cours Intermediate ChatGPT, qui couvre l’architecture des modèles GPT et l’écriture de prompts avancés. Pour suivre l’actualité de l’IA et des données, abonnez-vous à notre newsletter hebdomadaire, The Median.
TL;DR
Qu’est-ce que GPT-6.2 Sol ?
GPT-6.2 Sol est le modèle de raisonnement efficace de milieu de gamme d’OpenAI, sorti en novembre 2026 aux côtés de GPT-6.2 Astra.
OpenAI le présente comme son modèle de référence pour le travail au quotidien, et son atout est l’efficacité : de meilleurs résultats que GPT-6.1 Sol sur des tâches exigeantes, avec moins de tokens de sortie, à prix inchangés.
Notre guide GPT-6.2 Astra et Sol couvre le lancement, l’ensemble des benchmarks et deux tests pratiques.
Qu’est-ce que Claude Opus 5.5 ?
Claude Opus 5.5 est le modèle d’Anthropic pour le codage agentique de longue durée et le travail de connaissance, lancé le 22 septembre 2026 comme premier modèle de la famille Claude 5.5.
Anthropic le positionne au niveau de Claude Fable 5.1 sur la plupart des usages tout en coûtant 40 % de moins à l’exécution qu’Opus 5, et son raisonnement ne peut plus être désactivé.
Notre guide Claude Opus 5.5 couvre le lancement ; notre tutoriel API Opus 5.5 construit avec lui un enquêteur d’incidents IA.
GPT-6.2 Sol vs Claude Opus 5.5 : comparatif face à face
GPT-6.2 Sol devance désormais Claude Opus 5.5 sur la plupart des benchmarks communs, et Opus 5.5 conserve de légères avances sur le code et l’automatisation.
Dans notre comparatif GPT-6.1 Sol vs Opus 5.5, Opus 5.5 menait la plupart des résultats au niveau d’effort maximal. Avec GPT-6.2 Sol, les graphiques d’OpenAI montrent Sol en tête sur 5 des 9 benchmarks où les deux apparaissent, à égalité sur 1, et à moins de 2 points sur les 3 autres. Le code fait exception : sur le Coding Agent Index d’Artificial Analysis (indépendant), Opus 5.5 mène de 8 points.
Travail professionnel et science
C’est là que le verdict 6.1 s’inverse. GPT-6.1 Sol était derrière Opus 5.5 sur Terminal-Bench-Science 0.1, qui teste le travail scientifique en terminal, de 6 points à effort max. GPT-6.2 Sol passe devant, 68,0 % contre 63,3 %, pour moins d’un dixième du coût par tâche.
Le reste des graphiques « travail professionnel » d’OpenAI va dans le même sens :
Agents’ Last Exam, le test d’OpenAI pour des workflows professionnels de long terme, est quasiment à égalité à effort max. Le point le plus parlant du graphique est l’effort : Sol au niveau high se situe déjà au-dessus d’Opus 5.5 au niveau max, pour environ 0,69 $ par tâche.
Pour les documents, le juridique, la CAO et l’analyse scientifique, GPT-6.2 Sol est désormais le modèle le plus performant au vu des éléments disponibles, pas seulement le moins cher.
Code
Le code est le domaine où Opus 5.5 garde clairement l’avantage, et les chiffres indépendants montrent un écart plus élevé que celui des graphiques d’OpenAI. Sur le Coding Agent Index d’Artificial Analysis, qui combine FrontierCode, Terminal-Bench 4.1 et SWE-Atlas-QnA, Opus 5.5 dans Claude Code obtient 58 à effort max, contre 50 pour GPT-6.2 Sol dans Codex à son meilleur réglage, xhigh.
GPT-6.2 Sol obtient d’ailleurs un score inférieur à celui de GPT-6.1 Sol sur cet index. Artificial Analysis attribue la baisse à SWE-Atlas-QnA, où le nouveau modèle omet plus souvent des faits clés dans ses réponses.
Le graphique FrontierCode 2.0 d’OpenAI montre un écart inférieur à 2 points à effort max. Opus 5.5 coûte environ dix fois plus par tâche à effort max sur l’index de code (environ 12,60 $ contre environ 1,15 $), mais pour du travail sur dépôt où le résultat doit être exact, c’est le modèle le plus solide.
Automatisation des workflows métier
AutomationBench, le test de Zapier d’agents exécutant des workflows multi-étapes sur des apps métier, était le point d’orgue de la comparaison 6.1 : Opus 5.5 menait de 6 points à effort max. Avec GPT-6.2 Sol, l’écart descend à 1,4 point.
Sol se stabilise aussi plus tôt. Il obtient à peu près le même score à partir de l’effort medium, tandis qu’Opus 5.5 grimpe régulièrement et ne dépasse Sol qu’au niveau max, où chaque tâche coûte environ cinq fois plus. Pour un bot de support ou un agent sales-ops exécutant des milliers de workflows, Sol s’impose désormais ; Opus 5.5 n’a de sens que si un échec coûte plus cher que l’écart de prix.
Raisonnement général
Opus 5.5 garde un léger avantage sur l’Artificial Analysis Intelligence Index, un composite de 9 évaluations couvrant le travail de connaissance, le code et la science. Au niveau xhigh, Opus 5.5 est au niveau de Sol en max, pour un coût par tâche environ six fois supérieur. Ils sont à égalité sur le Vals Science Index, donc le raisonnement général est au coude-à-coude avec une légère inclinaison Anthropic.
Tarifs : ce que vous payez vraiment
GPT-6.2 Sol coûte deux fois moins qu’Opus 5.5 par token et bien moins par tâche terminée.
GPT-6.2 Sol conserve les tarifs de GPT-6.1 Sol, donc l’écart de prix par token reste le même. Pas l’écart de coût par tâche, car Sol a désormais besoin de moins de tokens de sortie pour terminer le même travail. Notre propre run unique de shader, détaillé ci-dessous, va dans le même sens, avec Opus presque 6× plus cher que Sol (1,20 $ contre 0,21 $).
Tarifs par token côte à côte
GPT-6.2 Sol coûte exactement la moitié d’Opus 5.5 sur chaque tarif standard, jusqu’à ce qu’un prompt dépasse 272 K tokens en entrée :
Les deux modèles facturent les tokens de raisonnement en sortie, et la « pensée » d’Opus 5.5 ne peut pas être désactivée : c’est donc son tarif de sortie qui pèse le plus.
Ce que coûte une vraie charge
Chaque total est (volume ÷ 1 M) × tarif, somme de l’entrée et de la sortie, aux tarifs standard.
Pourquoi la même tâche coûte un montant différent
Les deux modèles utilisent des tokenizers différents, mais l’écart majeur vient du nombre de tokens de sortie dépensés. Le graphique GDPval v2 d’OpenAI place Opus 5.5 à 191 241 tokens de sortie par tâche à effort max contre 33 428 pour GPT-6.2 Sol, et à 61 121 contre 12 420 à effort high.
Ce sont des mesures d’OpenAI, mais elles comparent directement les deux sujets. Si Opus 5.5 nécessitait environ 3 fois plus de tokens de sortie que Sol sur la charge « assistant équilibré », comme dans notre propre test, sa facture mensuelle serait de 19,00 $ contre 4,50 $ pour Sol.
C’est pourquoi les écarts de coût par tâche dans le tableau récapitulatif sont bien plus larges que le simple 2× des tarifs par token.
Performances de GPT-6.2 Sol et Claude Opus 5.5
Tous les chiffres jusqu’ici proviennent des graphiques d’OpenAI, donc j’ai lancé une tâche de build contre les deux modèles avec un prompt et des outils strictement identiques.
La tâche : une page HTML unique avec un shader de fragment GLSL plein écran, animé, représentant une forêt de kelp au crépuscule sous l’eau, hébergé par p5.js chargé depuis un CDN.
La difficulté vient du nombre d’éléments de la scène, et du curseur qui doit tous les influencer :
Cela met à l’épreuve l’affirmation d’OpenAI selon laquelle GPT-6.2 construit des frontends plus beaux et plus fonctionnels, y compris des scènes 3D. Les deux modèles ont tourné dans OpenCode avec une surface d’outil verrouillée (lecture et édition de fichiers uniquement), à effort de raisonnement high, avec une tentative chacun dans une session neuve et le prompt transmis à l’octet près.
Voici ce que GPT-6.2 Sol a produit :