
Основные выводы:
- Обе с первой попытки правильно собрали сцену. Каждая выдала реальный GLSL‑фрагментный шейдер с uniform‑переменными времени и мыши, с плавной анимацией, и нарисовала лес ламинарии, узнаваемый с первого взгляда. Подталкивать не пришлось.
- Сцена GPT-6.2 Sol выглядит более реалистично. Версия Opus 5.5 воспринимается чуть более мультяшной, из‑за чего она потеряла балл по соответствию брифу.
- Каждая модель правильно реализовала «свою половину» фонаря. У Sol фонарь ощущается как 3D‑конус света, уходящий вглубь сцены, тогда как у Opus 5.5 он движется больше по плоской 2D‑оси. Зато ламинарии у Opus 5.5 заметно и отзывчиво изгибаются от фонаря; у Sol эффект отталкивания слабее.
Вот версия Opus 5.5, где стебли рядом с курсором явно уступают:
Я оценивал обе работы по степени соответствия брифу, качеству шейдера, интерактивности с курсором и тому, является ли эффект реальным шейдером. По качеству и технике — у обеих полный балл; различия — в следующих строках:
| Метрика | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| Стоимость этого прогона (USD) | $0.21 | $1.20 |
| Выходные токены (вкл. рассуждения) | 16 476 | 44 996 |
| Эстетическое соответствие (главный критерий) | 5 | 4 |
| Сводный балл (среднее по четырём осям) | 4,8 | 4,5 |
GPT-6.2 Sol выигрывает этот тест с небольшим отрывом — за счёт реализма, что соответствует заявлению OpenAI о более красивых 3D‑фронтендах. Sol правильно сделал свет, Opus 5.5 — отталкивание, и Sol сделал это примерно за шестую часть стоимости.
Это один прогон одной задачи при одном уровне усилия. Обе модели легко преодолели технический порог, поэтому решающим оказались вкусовые различия, а один прогон может лишь наметить их.
Когда выбирать GPT-6.2 Sol vs Claude Opus 5.5
Выбор зависит от типа работы, длины ваших промптов и платформы развёртывания.
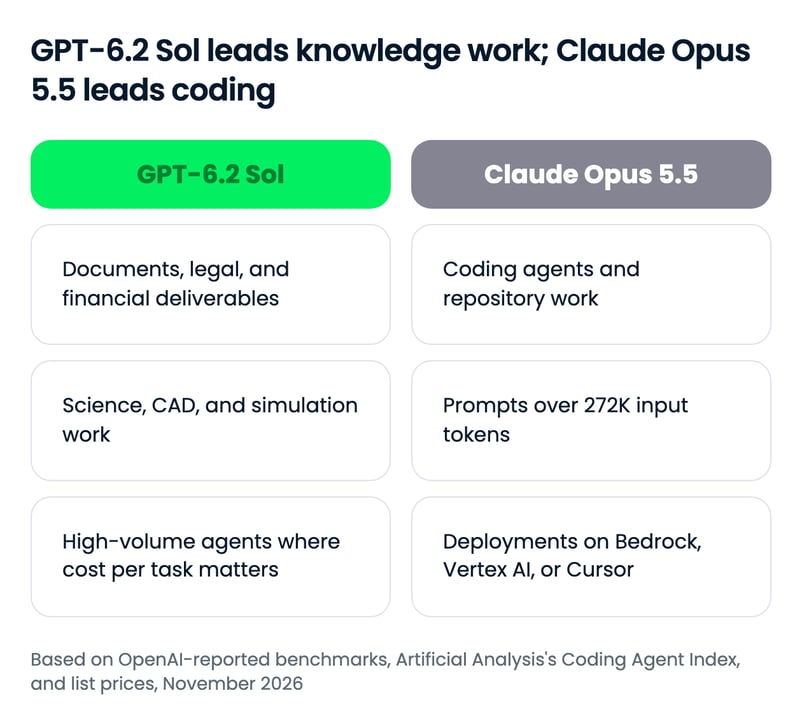
GPT-6.2 Sol должен быть выбором по умолчанию, а Opus 5.5 — моделью, которую выбирают с конкретной целью. Единственное число, способное перевернуть ценовой расклад, — порог в 272K токенов, выше которого надбавка Sol делает его близким по цене к Opus 5.5.
Выберите GPT-6.2 Sol, если…
- Вы создаёте профессиональные материалы. Sol лидирует на GDPval v2 и более чем вдвое опережает Opus 5.5 на юридическом бенчмарке Harvey, так что документы, записки и юридические черновики — его стихия.
- Вы выполняете научные, CAD‑ или моделирующие задачи. Теперь он лидирует на Terminal-Bench-Science и BenchCAD — двух бенчмарках, где GPT-6.1 Sol уступал Opus 5.5.
- Вы запускаете агентов в больших объёмах. Его цена за задачу — доля от стоимости Opus 5.5 на всех диаграммах OpenAI, и на нескольких диаграммах OpenAI он достигает почти максимума уже на high.
- Вы работаете в Codex, GitHub Copilot или Azure AI Foundry. GPT-6.2 Sol уже доступен на всех трёх.
Выберите Claude Opus 5.5, если…
- Кодирующие агенты — ваш основной сценарий. Opus 5.5 опережает независимый Coding Agent Index от Artificial Analysis на 8 пунктов, а результаты Anthropic по Terminal-Bench 4.0 и CursorBench пока не имеют аналога у GPT-6.2 Sol.
- Ваши промпты регулярно превышают 272K токенов. У Opus 5.5 нет надбавки за длинный контекст, так что промпты с целыми кодовыми базами стоят примерно одинаково на обеих.
- Вы развёртываете через Bedrock, Vertex AI или Cursor. Opus 5.5 есть на всех трёх; GPT-6.2 Sol отсутствует в документации Cursor, и в наших источниках нет его листинга в Bedrock или Vertex AI.
Как начать работу с GPT-6.2 Sol и Claude Opus 5.5
Доступ почти одинаков, за исключением того, что GPT-6.2 Sol недоступен в Cursor, поскольку OpenAI решила убрать свои модели с платформы.
| Площадка | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Пользовательское приложение | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Приложения Claude |
| Собственный API | OpenAI API | Claude API |
| Облачные платформы | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Кодирующие агенты | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Сторонние роутеры | OpenRouter | OpenRouter |
| ID модели в API | gpt-6.2-sol | claude-opus-5-5 |
ID моделей в API: gpt-6.2-sol и claude-opus-5-5; на OpenRouter — openai/gpt-6.2-sol и anthropic/claude-opus-5.5.
Первый вызов API
Самый быстрый способ попробовать обе — OpenRouter, где переключение модели — это замена одной строки:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Для полноценной сборки наш учебник по Opus 5.5 API проводит через проект агента от начала до конца.
Итоги
GPT-6.2 Sol должен быть выбором по умолчанию вместо Claude Opus 5.5. Он обходит Opus 5.5 примерно на половине общих бенчмарков и близок на остальных при доле стоимости за задачу, что оставляет Opus 5.5 выбором для кодирующих агентов, очень длинных промптов и развёртываний в Bedrock, Vertex AI или Cursor.
Самое интересное, что цена Sol не менялась: OpenAI выиграла этот раунд на выходных токенах. Помните, что Opus 5.5 вышла почти два месяца назад — по нынешним меркам это целая вечность, — так что можно ожидать, что следующий релиз Anthropic будет конкурировать с Sol по качеству и эффективности.
Если вы строите на любой из моделей, рекомендуем наш скилл‑трек OpenAI Fundamentals или курс Introduction to Claude Models.
FAQs
Лучше ли GPT-6.2 Sol, чем Claude Opus 5.5?
По большинству общих бенчмарков на диаграммах запуска OpenAI — да. GPT-6.2 Sol обходит Opus 5.5 при максимальном усилии на Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA и BenchCAD — и при гораздо меньшей цене за задачу. Opus 5.5 сохраняет явное лидерство в агентном кодировании: он набирает 58 против 50 у Sol по независимому Coding Agent Index от Artificial Analysis.
Насколько GPT-6.2 Sol дешевле, чем Claude Opus 5.5?
Тарифы API GPT-6.2 Sol составляют половину от Opus 5.5: $2 против $4 за миллион входных токенов и $10 против $20 за миллион выходных. За завершённую задачу разрыв ещё шире, поскольку Sol использует меньше выходных токенов. На промптах свыше 272K входных токенов надбавка Sol делает цену обеих моделей близкой.
Что изменилось между GPT-6.1 Sol и GPT-6.2 Sol?
GPT-6.2 Sol сохранил цены API GPT-6.1 Sol, но показывает более высокие результаты на большинстве бенчмарков OpenAI и использует меньше выходных токенов. Наибольшие скачки относительно Claude Opus 5.5 — на Terminal-Bench-Science, где Sol из отстающего стал лидером, и на AutomationBench, где преимущество Opus 5.5 сократилось примерно до одного пункта.
Где я могу использовать GPT-6.2 Sol и Claude Opus 5.5?
GPT-6.2 Sol доступен в ChatGPT Work и Codex для пользователей Plus, Pro, Enterprise и Edu, а также через OpenAI API. Claude Opus 5.5 доступен в приложениях Claude, Claude Code, через Claude API и в Cursor. Обе модели доступны на Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot и OpenRouter.
Какие ID моделей в API у GPT-6.2 Sol и Claude Opus 5.5?
ID модели в OpenAI API — gpt-6.2-sol, а в Claude API — claude-opus-5-5. На OpenRouter эти модели — openai/gpt-6.2-sol и anthropic/claude-opus-5.5, так что можно переключаться между ними, меняя одну строку в одном и том же клиентском коде.

Том — редактор по Data Science в DataCamp. Он пишет и редактирует обучающие материалы по ИИ, сравнивает новые релизы LLM и создаёт рабочие процессы на основе ИИ. Ранее работал в области науки о данных в Deutsche Telekom. Вне работы занимается прогнозированием футбольных матчей с помощью машинного обучения.
OpenAI выпустила GPT-6.2 Sol, повседневный уровень семейства GPT-6.2, по тем же ценам API, что и GPT-6.1 Sol. Когда мы сравнивали GPT-6.1 Sol с Claude Opus 5.5, расклад был очевиден: Sol — по цене за задачу, Opus 5.5 — по наивысшей успешности в сложных агентных прогонах при максимальном усилии. Диаграммы запуска OpenAI для GPT-6.2 Sol ставят под сомнение вторую часть, и на почти каждой из них указан Opus 5.5 при максимальном усилии.
В этой статье мы сравним GPT-6.2 Sol и Claude Opus 5.5 по профессиональной и научной работе, программированию, бизнес-автоматизации и ценам, а затем запустим оба на одном и том же практическом сборе шейдера.
Если перед сравнением вы хотите лучше понять, как работают модели GPT и как правильно их промптить, рекомендуем курс Intermediate ChatGPT, который охватывает архитектуру моделей GPT и продвинутые техники написания промптов. Чтобы быть в курсе AI и данных, подпишитесь на нашу еженедельную рассылку The Median.
Коротко
Что такое GPT-6.2 Sol?
GPT-6.2 Sol — это эффективная, среднеуровневая модель рассуждений от OpenAI, выпущенная в ноябре 2026 года вместе с GPT-6.2 Astra.
OpenAI называет её основным выбором для повседневной работы, а ключевое преимущество — эффективность: лучшие результаты, чем у GPT-6.1 Sol, на требовательных задачах при меньшем числе выходных токенов и без изменения цен.
Наш гайд по GPT-6.2 Astra и Sol рассказывает о запуске, включает полный набор бенчмарков и два практических теста.
Что такое Claude Opus 5.5?
Claude Opus 5.5 — модель Anthropic для длительного агентного кодирования и работы с знаниями, выпущенная 22 сентября 2026 года как первая в семействе Claude 5.5.
Anthropic позиционирует её на уровне Claude Fable 5.1 по большинству задач при затратах на 40% ниже, чем у Opus 5, а «мышление» теперь нельзя отключить.
Наш гайд по Claude Opus 5.5 описывает запуск; наш учебник по Opus 5.5 API строит с её помощью ИИ-расследователя инцидентов.
GPT-6.2 Sol vs Claude Opus 5.5: сравнение лицом к лицу
GPT-6.2 Sol теперь лидирует над Claude Opus 5.5 на большинстве общих бенчмарков, а Opus 5.5 сохраняет небольшие преимущества в кодировании и автоматизации.
В нашем сравнении GPT-6.1 Sol и Opus 5.5 Opus 5.5 лидировал по большинству результатов при максимальном усилии. С GPT-6.2 Sol диаграммы OpenAI показывают преимущество Sol в 5 из 9 бенчмарков, где представлены обе модели, паритет в 1 и отставание менее чем на 2 пункта в остальных 3. Исключение — кодирование: по независимому Coding Agent Index от Artificial Analysis Opus 5.5 опережает на 8 пунктов.
Профессиональная работа и наука
Именно здесь вердикт 6.1 переворачивается. GPT-6.1 Sol отставал от Opus 5.5 на Terminal-Bench-Science 0.1, который проверяет научную работу в терминале, на 6 пунктов при максимальном усилии. GPT-6.2 Sol теперь лидирует: 68,0% против 63,3% — и при цене за задачу менее одной десятой.
Остальные диаграммы OpenAI по профессиональной работе указывают в ту же сторону:
Agents' Last Exam, тест OpenAI на длинные профессиональные процессы, почти сводится к ничьей при максимальном усилии. Более показательная деталь — усилие: Sol на high уже выше Opus 5.5 на max — примерно за $0.69 за задачу.
Для документов, юридической работы, CAD и научной аналитики GPT-6.2 Sol теперь сильнее на основании доступных данных, а не просто дешевле.
Кодирование
Кодирование — область, где Opus 5.5 всё ещё явно лидирует, и независимые цифры показывают разрыв больше, чем на диаграмме OpenAI. В Coding Agent Index от Artificial Analysis, который объединяет FrontierCode, Terminal-Bench 4.1 и SWE-Atlas-QnA, Opus 5.5 в Claude Code набирает 58 при max, против 50 у GPT-6.2 Sol в Codex при его лучшем режиме xhigh.
На этом индексе GPT-6.2 Sol фактически показывает результат ниже, чем GPT-6.1 Sol. Artificial Analysis связывает падение с SWE-Atlas-QnA, где новая модель чаще опускает ключевые факты в ответах.
Собственная диаграмма OpenAI по FrontierCode 2.0 показывает разрыв менее 2 пунктов при максимальном усилии. Opus 5.5 стоит примерно в десять раз дороже за задачу на кодовом индексе при max (около $12.60 против примерно $1.15), но для работы с репозиториями, где результат должен быть безошибочным, это более сильная модель.
Автоматизация бизнес-процессов
AutomationBench, тест Zapier на агентов, выполняющих многошаговые процессы в бизнес‑приложениях, был главным сюжетом сравнения 6.1: Opus 5.5 лидировал на 6 пунктов при максимальном усилии. С GPT-6.2 Sol разрыв сократился до 1,4 пункта.
Sol также «выравнивается» раньше. Он набирает примерно одинаково, начиная с medium, тогда как Opus 5.5 растёт равномерно и обгоняет Sol только на max, где каждая задача стоит примерно в пять раз дороже. Для саппорт‑бота или sales‑ops агента с тысячами сценариев Sol теперь очевидный выбор; Opus 5.5 имеет смысл лишь там, где провал стоит дороже ценовой разницы.
Общее рассуждение
Opus 5.5 сохраняет небольшое преимущество в Artificial Analysis Intelligence Index — композите из 9 оценок по работе с знаниями, кодированию и науке. На xhigh Opus 5.5 сравнивается с Sol на max — при примерно шестикратной разнице в цене за задачу. На Vals Science Index — ничья, так что общее рассуждение близко к паритету с небольшим уклоном в пользу Anthropic.
Цены: что вы платите на самом деле
GPT-6.2 Sol стоит вдвое дешевле Opus 5.5 за токен и значительно дешевле за завершённую задачу.
GPT-6.2 Sol сохраняет тарифы GPT-6.1 Sol, так что разрыв по цене токена прежний. Но разрыв по цене за задачу — уже нет, потому что Sol теперь нуждается в меньшем числе выходных токенов для завершения той же работы. Наш собственный единичный прогон шейдера, описанный ниже, указывает в ту же сторону: Opus оказался почти в 6 раз дороже Sol ($0.21 против $1.20).
Ставки за токены рядом
GPT-6.2 Sol стоит ровно половину от Opus 5.5 по каждому стандартному тарифу, пока промпт не превысит 272K входных токенов:
Обе модели считают токены рассуждения как вывод, а «мышление» у Opus 5.5 нельзя отключить, так что ставка на вывод здесь ключевая.
Сколько стоит реальная нагрузка
Каждая сумма — это (объём ÷ 1M) × тариф, сложенный по вводу и выводу на стандартных ставках.
Почему одна и та же задача стоит по-разному
Модели используют разные токенайзеры, но важнее — сколько выходных токенов тратит каждая. На диаграмме OpenAI по GDPval v2 у Opus 5.5 — 191 241 выходной токен на задачу при max против 33 428 у GPT-6.2 Sol, и 61 121 против 12 420 при high.
Это измерения OpenAI, но они напрямую сопоставляют модели. Если бы Opus 5.5 требовал примерно в 3 раза больше выходных токенов, чем Sol, на нагрузке «сбалансированный ассистент», как это было в нашем тесте, его месячный счёт был бы $19.00 против $4.50 у Sol.
Поэтому разрывы по цене за задачу в сводной таблице куда шире, чем двукратная разница в цене за токен.
Как выступили GPT-6.2 Sol и Claude Opus 5.5
Все цифры до этого — из диаграмм OpenAI, поэтому я провёл одну сборочную задачу на обеих моделях с идентичным промптом и идентичными инструментами.
Задача: одна HTML‑страница с полноэкранным анимированным GLSL‑фрагментным шейдером подводного леса ламинарии на закате, на p5.js с CDN.
Сложность в том, что в сцене несколько элементов, и курсор должен менять их все:
Тест проверяет утверждение OpenAI, что GPT-6.2 строит фронтенды, которые выглядят и работают лучше, включая 3D‑сцены. Обе модели запускались в OpenCode с закреплённой поверхностью инструментов (только чтение и редактирование файлов), на высоком уровне рассуждений, по одной попытке в новой сессии и с промптом, переданным байт в байт.
Вот что построил GPT-6.2 Sol: