
Temuan utama:
- Keduanya membangun adegan dengan benar pada percobaan pertama. Masing-masing mengirim shader fragmen GLSL nyata dengan uniform waktu dan mouse, animasi mulus, dan menggambar hutan rumput laut yang langsung dikenali. Keduanya tidak butuh dorongan tambahan.
- Adegan GPT-6.2 Sol tampak lebih realistis. Versi Opus 5.5 terasa sedikit lebih kartun, yang mengurangi satu poin pada seberapa dekat adegan dengan brief.
- Masing-masing model berhasil pada separuh aspek senter yang berbeda. Senter Sol terasa seperti kerucut cahaya 3D yang menjangkau ke dalam adegan, sementara milik Opus 5.5 bergerak lebih pada sudut 2D datar. Namun rumput laut pada Opus 5.5 membengkok menjauh dari senter dengan jelas dan responsif, dan efek membengkok-men-jauh pada Sol lebih lemah.
Berikut versi Opus 5.5, di mana untaian dekat kursor terlihat menyingkir:
Saya menilai keduanya pada kesesuaian adegan dengan brief, kualitas shader, interaktivitas kursor, dan apakah efeknya shader nyata. Kualitas dan teknik shader mendapat nilai penuh untuk keduanya; baris tempat mereka berbeda:
| Ukuran | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| Biaya run ini (USD) | $0,21 | $1,20 |
| Token output (termasuk penalaran) | 16.476 | 44.996 |
| Kecocokan estetika (pembeda utama) | 5 | 4 |
| Skor rubrik (rata-rata empat sumbu) | 4,8 | 4,5 |
GPT-6.2 Sol menang tipis pada uji ini, pada aspek realisme, yang sesuai dengan klaim OpenAI tentang frontend 3D yang lebih bagus. Sol benar pada cahaya dan Opus 5.5 benar pada efek dorong, dan Sol melakukannya dengan sekitar seperenam biaya.
Ini adalah satu run dari satu tugas pada satu setelan upaya. Keduanya dengan mudah melewati ambang teknik, jadi yang membedakan adalah selera, yang hanya bisa diisyaratkan oleh satu run.
Kapan Memilih GPT-6.2 Sol vs Claude Opus 5.5
Pilihan bermuara pada jenis pekerjaan, panjang prompt Anda, dan tempat Anda melakukan deployment.
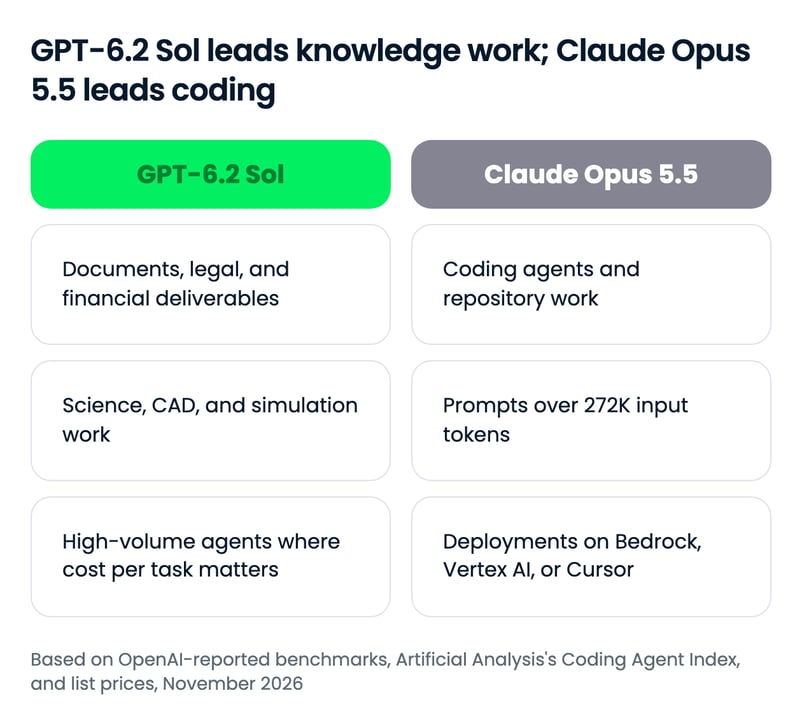
GPT-6.2 Sol sebaiknya menjadi default Anda, dan Opus 5.5 adalah model yang Anda pilih karena alasan khusus. Satu angka yang bisa membalik kasus biaya adalah ambang 272K token, di atasnya biaya tambahan Sol membuatnya mendekati harga Opus 5.5.
Pilih GPT-6.2 Sol jika...
- Anda menghasilkan deliverable profesional. Sol memimpin pada GDPval v2 dan lebih dari dua kali lipat Opus 5.5 pada tolok ukur legal Harvey, jadi dokumen, memo, dan draf legal adalah wilayah utamanya.
- Anda menjalankan pekerjaan sains, CAD, atau simulasi. Kini memimpin Terminal-Bench-Science dan BenchCAD, dua tolok ukur di mana GPT-6.1 Sol tertinggal dari Opus 5.5.
- Anda menjalankan agen dalam volume tinggi. Biaya per tugasnya hanya sebagian kecil dari Opus 5.5 pada setiap grafik yang dipublikasikan OpenAI, dan pada beberapa grafik OpenAI nilainya mendekati maksimum sudah pada upaya high.
- Anda bekerja di Codex, GitHub Copilot, atau Azure AI Foundry. GPT-6.2 Sol sudah terdaftar pada ketiganya.
Pilih Claude Opus 5.5 jika...
- Agen coding adalah beban kerja utama Anda. Opus 5.5 memimpin 8 poin pada Artificial Analysis Coding Agent Index yang independen, dan hasil Terminal-Bench 4.0 dan CursorBench dari Anthropic belum memiliki padanan GPT-6.2 Sol.
- Prompt Anda rutin melewati 272K token. Opus 5.5 tidak memiliki biaya tambahan konteks panjang, jadi prompt basis kode utuh berbiaya kira-kira sama pada keduanya.
- Anda melakukan deployment melalui Bedrock, Vertex AI, atau Cursor. Opus 5.5 terdaftar pada ketiganya; GPT-6.2 Sol tidak ada di dokumentasi Cursor, dan kami tidak menemukan listing Bedrock atau Vertex AI untuknya dalam sumber kami.
Cara Memulai dengan GPT-6.2 Sol dan Claude Opus 5.5
Akses hampir identik, kecuali GPT-6.2 Sol tidak tersedia di Cursor, karena OpenAI memutuskan menarik model mereka dari platform tersebut.
| Permukaan | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Aplikasi konsumen | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Aplikasi Claude |
| API pihak pertama | OpenAI API | Claude API |
| Platform cloud | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agen coding | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Router pihak ketiga | OpenRouter | OpenRouter |
| ID model API | gpt-6.2-sol | claude-opus-5-5 |
ID model API adalah gpt-6.2-sol dan claude-opus-5-5; pada OpenRouter masing-masing adalah openai/gpt-6.2-sol dan anthropic/claude-opus-5.5.
Melakukan panggilan API pertama Anda
Cara tercepat mencoba keduanya adalah OpenRouter, di mana mengganti model cukup mengubah satu string:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Untuk build lengkap, tutorial API Opus 5.5 kami memandu proyek agen dari awal hingga akhir.
Pikiran Akhir
GPT-6.2 Sol seharusnya menjadi pilihan default dibanding Claude Opus 5.5. Ia mengungguli Opus 5.5 pada sekitar setengah tolok ukur yang sama dan mendekati pada sisanya dengan sebagian kecil biaya per tugas, yang menyisakan Opus 5.5 sebagai pilihan untuk agen coding, prompt sangat panjang, serta deployment di Bedrock, Vertex AI, atau Cursor.
Yang paling menarik bagi saya adalah harga Sol tidak pernah berubah: OpenAI memenangkan putaran ini pada token output. Ingat bahwa Opus 5.5 telah rilis hampir dua bulan, yang terasa seperti bertahun-tahun pada kecepatan saat ini, jadi saya memperkirakan rilis Anthropic berikutnya akan bersaing dengan Sol pada kualitas dan efisiensi.
Jika Anda membangun di atas salah satu model, saya merekomendasikan skill track OpenAI Fundamentals kami atau kursus Introduction to Claude Models.
FAQ
Apakah GPT-6.2 Sol lebih baik daripada Claude Opus 5.5?
Pada sebagian besar tolok ukur yang sama di grafik peluncuran OpenAI, ya. GPT-6.2 Sol mengungguli Opus 5.5 pada upaya maksimum di Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA, dan BenchCAD, dengan biaya per tugas yang jauh lebih rendah. Opus 5.5 tetap unggul jelas dalam agentic coding: skornya 58 melawan 50 milik Sol pada Artificial Analysis Coding Agent Index yang independen.
Seberapa jauh lebih murah GPT-6.2 Sol dibanding Claude Opus 5.5?
Tarif API GPT-6.2 Sol separuh dari Opus 5.5: $2 vs $4 per satu juta token input dan $10 vs $20 per satu juta token output. Per tugas selesai selisihnya lebih lebar, karena Sol menggunakan lebih sedikit token output. Pada prompt di atas 272K token input, biaya tambahan Sol membuat keduanya mendekati harga yang sama.
Apa yang berubah antara GPT-6.1 Sol dan GPT-6.2 Sol?
GPT-6.2 Sol mempertahankan harga API GPT-6.1 Sol tetapi mencetak lebih tinggi pada sebagian besar tolok ukur OpenAI sambil menggunakan lebih sedikit token output. Lompatan terbesar terhadap Claude Opus 5.5 ada pada Terminal-Bench-Science, di mana Sol dari tertinggal menjadi memimpin, dan AutomationBench, di mana keunggulan Opus 5.5 menyusut menjadi sekitar satu poin.
Di mana saya bisa menggunakan GPT-6.2 Sol dan Claude Opus 5.5?
GPT-6.2 Sol tersedia di ChatGPT Work dan Codex untuk pengguna Plus, Pro, Enterprise, dan Edu, serta OpenAI API. Claude Opus 5.5 tersedia di aplikasi Claude, Claude Code, Claude API, dan Cursor. Keduanya tersedia di Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot, dan OpenRouter.
Apa ID model API untuk GPT-6.2 Sol dan Claude Opus 5.5?
ID model OpenAI API adalah gpt-6.2-sol, dan ID model Claude API adalah claude-opus-5-5. Di OpenRouter, kedua model adalah openai/gpt-6.2-sol dan anthropic/claude-opus-5.5, sehingga Anda dapat beralih di antara keduanya dengan mengganti satu string dalam kode klien yang sama.

Tom adalah Editor Data Science di DataCamp. Ia menulis dan menyunting tutorial AI, membandingkan rilis LLM terbaru, dan membangun alur kerja berbasis AI. Sebelumnya, ia bekerja di bidang data science di Deutsche Telekom. Di luar pekerjaan, ia membuat prediksi pertandingan sepak bola dengan pembelajaran mesin.


OpenAI telah merilis GPT-6.2 Sol, tier penggunaan harian dari keluarga GPT-6.2, dengan harga API yang persis sama seperti GPT-6.1 Sol. Ketika kami membandingkan GPT-6.1 Sol dengan Claude Opus 5.5, pembagiannya jelas: Sol unggul pada biaya per tugas, Opus 5.5 memiliki tingkat keberhasilan tertinggi pada agen tugas sulit di upaya maksimum. Grafik peluncuran OpenAI untuk GPT-6.2 Sol membuat paruh kedua itu diragukan, dan mereka menyertakan Opus 5.5 pada upaya maksimum di hampir semuanya.
Dalam artikel ini, saya akan membandingkan GPT-6.2 Sol dan Claude Opus 5.5 pada pekerjaan profesional dan sains, coding, otomatisasi bisnis, serta penetapan harga, lalu menjalankan keduanya pada build shader langsung yang sama.
Jika Anda ingin pemahaman lebih kuat tentang cara kerja model GPT dan cara membuat prompt yang baik sebelum membaca perbandingan ini, saya merekomendasikan kursus Intermediate ChatGPT, yang membahas arsitektur di balik model GPT dan teknik penulisan prompt lanjutan. Untuk mengikuti perkembangan dunia AI dan data, berlangganan buletin mingguan kami, The Median.
Ringkasnya
Apa itu GPT-6.2 Sol?
GPT-6.2 Sol adalah model penalaran tingkat menengah yang efisien dari OpenAI, dirilis pada November 2026 bersamaan dengan GPT-6.2 Astra.
OpenAI menyebutnya model andalan untuk kerja sehari-hari, dan nilai jualnya adalah efisiensi: hasil lebih baik daripada GPT-6.1 Sol pada tugas menuntut dengan lebih sedikit token output, pada harga yang tidak berubah.
Panduan GPT-6.2 Astra dan Sol kami membahas peluncurannya, dengan set tolok ukur lengkap dan dua uji langsung.
Apa itu Claude Opus 5.5?
Claude Opus 5.5 adalah model Anthropic untuk agentic coding jangka panjang dan pekerjaan pengetahuan, dirilis pada 22 September 2026, sebagai model pertama dalam keluarga Claude 5.5.
Anthropic memposisikannya setara dengan Claude Fable 5.1 pada sebagian besar pekerjaan sambil berbiaya 40% lebih murah untuk dijalankan daripada Opus 5, dan proses berpikirnya tidak lagi bisa dimatikan.
Panduan Claude Opus 5.5 kami membahas peluncurannya; tutorial API Opus 5.5 kami membangun investigator insiden AI dengannya.
GPT-6.2 Sol vs Claude Opus 5.5: Perbandingan Langsung
GPT-6.2 Sol kini unggul atas Claude Opus 5.5 pada sebagian besar tolok ukur bersama, dan Opus 5.5 mempertahankan keunggulan tipis pada coding dan otomatisasi.
Dalam perbandingan GPT-6.1 Sol vs Opus 5.5 kami, Opus 5.5 memimpin sebagian besar hasil upaya maksimum. Dengan GPT-6.2 Sol, grafik OpenAI menunjukkan Sol unggul pada 5 dari 9 tolok ukur yang diikuti kedua model, setara pada 1, dan tertinggal kurang dari 2 poin pada 3 lainnya. Coding adalah pengecualian: pada Artificial Analysis Coding Agent Index yang independen, Opus 5.5 unggul 8 poin.
Pekerjaan profesional dan sains
Di sinilah putusan 6.1 berbalik. GPT-6.1 Sol tertinggal 6 poin dari Opus 5.5 pada Terminal-Bench-Science 0.1, yang menguji pekerjaan sains di terminal, pada upaya maksimum. GPT-6.2 Sol kini memimpin, 68,0% berbanding 63,3%, dengan biaya per tugas kurang dari sepersepuluhnya.
Sisa grafik pekerjaan profesional OpenAI mengarah sama:
Agents' Last Exam, uji OpenAI untuk alur kerja profesional jangka panjang, hampir seri pada upaya maksimum. Poin yang lebih berarti pada grafik itu adalah upaya: Sol pada upaya high sudah berada di atas Opus 5.5 pada upaya max, dengan biaya sekitar $0,69 per tugas.
Untuk dokumen, pekerjaan legal, CAD, dan analisis ilmiah, GPT-6.2 Sol kini menjadi model yang lebih kuat berdasarkan bukti yang ada, bukan sekadar yang lebih murah.
Coding
Coding adalah area di mana Opus 5.5 masih jelas memimpin, dan angka independen menempatkan jaraknya jauh di atas yang ditunjukkan grafik OpenAI. Pada Artificial Analysis Coding Agent Index, yang menggabungkan FrontierCode, Terminal-Bench 4.1, dan SWE-Atlas-QnA, Opus 5.5 di Claude Code mencetak 58 pada upaya maksimum, melawan 50 untuk GPT-6.2 Sol di Codex pada setelan terbaiknya, xhigh.
GPT-6.2 Sol justru mencetak lebih rendah pada indeks itu dibanding GPT-6.1 Sol. Artificial Analysis menelusuri penurunan ke SWE-Atlas-QnA, di mana model baru lebih mungkin mengabaikan fakta kunci dalam jawabannya.
Grafik FrontierCode 2.0 milik OpenAI sendiri menunjukkan selisih kurang dari 2 poin pada upaya maksimum. Opus 5.5 berbiaya sekitar sepuluh kali lipat per tugas pada indeks coding pada upaya maksimum (sekitar $12,60 melawan sekitar $1,15), tetapi untuk pekerjaan repositori yang hasilnya harus benar, ia adalah model yang lebih kuat.
Otomatisasi alur kerja bisnis
AutomationBench, uji Zapier untuk agen yang menjalankan alur kerja multilangkah di berbagai aplikasi bisnis, menjadi sorotan perbandingan 6.1: Opus 5.5 unggul 6 poin pada upaya maksimum. Dengan GPT-6.2 Sol, jarak turun menjadi 1,4 poin.
Sol juga cepat datar. Skornya kira-kira sama dari upaya medium ke atas, sementara Opus 5.5 naik stabil dan hanya menyalip Sol pada upaya max, di mana setiap tugas berbiaya sekitar lima kali lipat. Untuk bot dukungan atau agen sales-ops yang menjalankan ribuan alur kerja, Sol kini pilihan yang jelas; Opus 5.5 hanya masuk akal ketika run yang gagal berbiaya lebih mahal daripada selisih harga.
Penalaran umum
Opus 5.5 mempertahankan keunggulan kecil pada Artificial Analysis Intelligence Index, komposit dari 9 evaluasi lintas kerja pengetahuan, coding, dan sains. Pada upaya xhigh, Opus 5.5 setara dengan Sol pada upaya max, dengan kira-kira enam kali biaya per tugas. Keduanya seri pada Vals Science Index, jadi penalaran umum mendekati paritas dengan sedikit kecondongan ke Anthropic.
Harga: apa yang sebenarnya Anda bayar
GPT-6.2 Sol berharga separuh Opus 5.5 per token dan jauh lebih murah per tugas selesai.
GPT-6.2 Sol mempertahankan tarif GPT-6.1 Sol, jadi selisih harga token sama seperti sebelumnya. Selisih biaya per tugas tidak, karena Sol kini butuh lebih sedikit token output untuk menyelesaikan pekerjaan yang sama. Satu run shader kami sendiri, dibahas di bawah, mengarah sama, dengan Opus hampir 6x lebih mahal daripada Sol ($0,21 melawan $1,20).
Tarif token berdampingan
GPT-6.2 Sol berbiaya persis separuh Opus 5.5 pada setiap tarif standar, hingga sebuah prompt melewati 272K token input:
Kedua model menagih token penalaran sebagai output, dan proses berpikir Opus 5.5 tidak bisa dimatikan, jadi tarif output adalah yang paling penting.
Biaya beban kerja nyata
Setiap total adalah (volume ÷ 1M) × tarif, dijumlahkan antara input dan output, pada tarif standar.
Mengapa tugas yang sama berbiaya berbeda
Kedua model memakai tokenizer berbeda, tetapi perbedaan yang lebih besar adalah berapa banyak token output yang dihabiskan masing-masing. Grafik GDPval v2 OpenAI menempatkan Opus 5.5 pada 191.241 token output per tugas pada upaya maksimum melawan 33.428 untuk GPT-6.2 Sol, dan pada 61.121 melawan 12.420 pada upaya high.
Itu adalah pengukuran OpenAI sendiri, tetapi membandingkan dua subjek secara langsung. Jika Opus 5.5 butuh sekitar 3 kali token output Sol pada beban kerja asisten seimbang, seperti pada uji kami, tagihan bulanannya akan $19,00 melawan $4,50 milik Sol.
Itulah mengapa selisih biaya per tugas di tabel ringkasan jauh lebih lebar daripada selisih harga token 2x.
Kinerja GPT-6.2 Sol dan Claude Opus 5.5
Semua angka sejauh ini berasal dari grafik OpenAI, jadi saya menjalankan satu tugas build terhadap kedua model dengan prompt dan tooling yang identik.
Tugas: satu halaman HTML dengan shader fragmen GLSL layar penuh yang dianimasikan tentang hutan rumput laut saat senja, di-host oleh p5.js yang dimuat dari CDN.
Bagian tersulit adalah adegan memiliki beberapa elemen, dan kursor harus mengubah semuanya:
Ini menguji klaim OpenAI bahwa GPT-6.2 membangun frontend yang tampak dan bekerja lebih baik, termasuk adegan 3D. Kedua model dijalankan di OpenCode dengan permukaan tool disematkan (hanya baca dan edit file), pada upaya penalaran high, dengan satu percobaan masing-masing dalam sesi baru dan prompt dikirim byte demi byte.
Berikut hasil buatan GPT-6.2 Sol: