
Las conclusiones principales:
- Ambos construyeron la escena correctamente a la primera. Cada uno entregó un fragment shader GLSL real con uniforms de tiempo y ratón, animado con fluidez, y dibujó un bosque de kelp reconocible al instante. Ninguno necesitó correcciones.
- La escena de GPT-6.2 Sol se ve más realista. La versión de Opus 5.5 resulta algo más caricaturesca, lo que le restó un punto en el ajuste estético al briefing.
- Cada modelo acertó con una mitad distinta de la linterna. La luz de Sol se siente como un cono 3D que penetra en la escena, mientras que la de Opus 5.5 se mueve más en un ángulo 2D plano. Pero el kelp de Opus 5.5 se inclina lejos de la linterna de forma clara y reactiva, y el empuje de Sol es más débil.
Aquí está la versión de Opus 5.5, donde las hebras cerca del cursor ceden visiblemente:
Puntué a ambos según el ajuste al briefing, la calidad del shader, la interactividad con el cursor y si el efecto era un shader real. Calidad y técnica del shader: nota máxima para ambos; las filas donde difieren:
| Medida | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| Coste de esta ejecución (USD) | $0,21 | $1,20 |
| Tokens de salida (incl. razonamiento) | 16.476 | 44.996 |
| Ajuste estético (discriminador principal) | 5 | 4 |
| Puntuación de la rúbrica (media de cuatro ejes) | 4,8 | 4,5 |
GPT-6.2 Sol gana por poco esta prueba, por realismo, lo que encaja con la afirmación de OpenAI sobre frontends 3D con mejor aspecto. Sol clavó la luz y Opus 5.5 clavó el empuje, y Sol lo hizo por aproximadamente una sexta parte del coste.
Es una ejecución de una sola tarea y a un nivel de esfuerzo. Ambos modelos superaron el listón técnico con holgura, así que lo que los separó fue el gusto, y una sola ejecución solo puede dar una pista.
Cuándo elegir GPT-6.2 Sol vs Claude Opus 5.5
La elección depende del tipo de trabajo, la longitud de tus prompts y dónde despliegas.
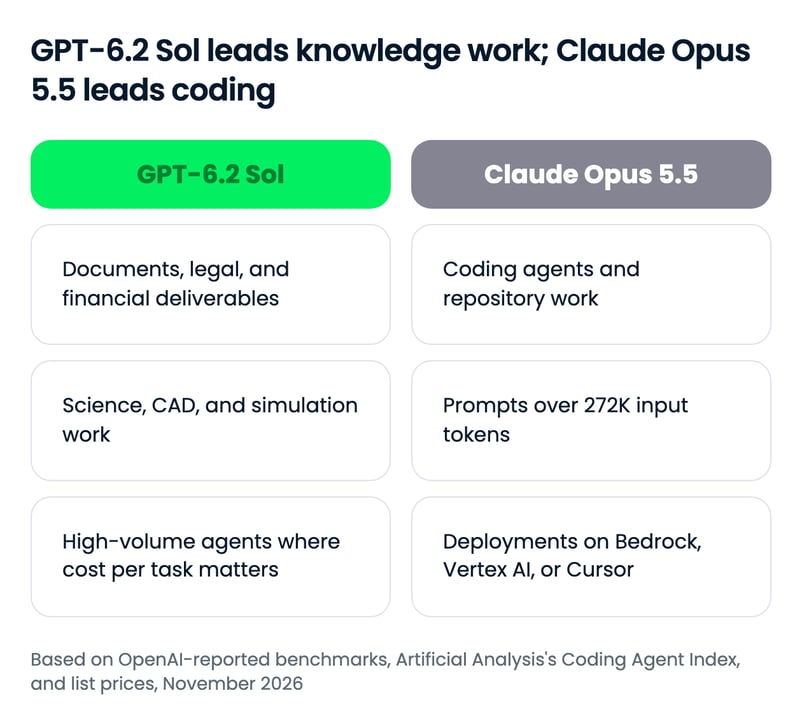
GPT-6.2 Sol debería ser tu opción por defecto, y Opus 5.5 un modelo que eliges por un motivo. La única cifra que puede darle la vuelta al caso de coste es el umbral de 272K tokens: por encima, el recargo de Sol lo acerca al precio de Opus 5.5.
Elige GPT-6.2 Sol si...
- Generas entregables profesionales. Sol lidera en GDPval v2 y más que duplica a Opus 5.5 en el benchmark legal de Harvey, así que documentos, notas y borradores legales son su terreno natural.
- Haces trabajo científico, CAD o de simulación. Ahora lidera en Terminal-Bench-Science y BenchCAD, dos benchmarks donde GPT-6.1 Sol iba por detrás de Opus 5.5.
- Ejecutas agentes a gran volumen. Su coste por tarea es una fracción del de Opus 5.5 en todos los gráficos que publicó OpenAI, y en varios alcanza cerca de su máximo ya en high.
- Trabajas en Codex, GitHub Copilot o Azure AI Foundry. GPT-6.2 Sol ya aparece en los tres.
Elige Claude Opus 5.5 si...
- Tu principal carga es con agentes de código. Opus 5.5 lidera el Coding Agent Index independiente de Artificial Analysis por 8 puntos, y los resultados de Terminal-Bench 4.0 y CursorBench de Anthropic no tienen aún homólogo para GPT-6.2 Sol.
- Tus prompts superan habitualmente los 272K tokens. Opus 5.5 no tiene recargo por contexto largo, así que los prompts con bases de código completas cuestan parecido en ambos.
- Despliegas vía Bedrock, Vertex AI o Cursor. Opus 5.5 está en los tres; GPT-6.2 Sol no aparece en la documentación de Cursor, y no encontramos listados de Bedrock o Vertex AI para él en nuestras fuentes.
Cómo empezar con GPT-6.2 Sol y Claude Opus 5.5
El acceso es casi idéntico, salvo que GPT-6.2 Sol no está disponible en Cursor, ya que OpenAI decidió retirar sus modelos de la plataforma.
| Superficie | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| App de consumo | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Apps de Claude |
| API propia | OpenAI API | Claude API |
| Plataformas cloud | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agentes de código | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Routers de terceros | OpenRouter | OpenRouter |
| ID de modelo en API | gpt-6.2-sol | claude-opus-5-5 |
Los IDs de modelo en la API son gpt-6.2-sol y claude-opus-5-5; en OpenRouter son openai/gpt-6.2-sol y anthropic/claude-opus-5.5.
Tu primera llamada al API
La forma más rápida de probar ambos es OpenRouter, donde cambiar de modelo es modificar una sola cadena:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Para un proyecto completo, nuestro tutorial del API de Opus 5.5 recorre un agente de principio a fin.
Conclusiones
GPT-6.2 Sol debería ser la elección por defecto frente a Claude Opus 5.5. Supera a Opus 5.5 en alrededor de la mitad de los benchmarks que comparten y se acerca en el resto con una fracción del coste por tarea, lo que deja a Opus 5.5 como la opción para agentes de código, prompts muy largos y despliegues en Bedrock, Vertex AI o Cursor.
Lo más interesante es que el precio de Sol no cambió: OpenAI ha ganado esta ronda con los tokens de salida. Ten en cuenta que Opus 5.5 lleva casi dos meses en el mercado, que a este ritmo parece una eternidad, así que espero que el próximo lanzamiento de Anthropic compita con Sol en calidad y eficiencia.
Si estás construyendo sobre cualquiera de los dos modelos, te recomiendo el itinerario de habilidades OpenAI Fundamentals o el curso Introduction to Claude Models.
FAQs
¿GPT-6.2 Sol es mejor que Claude Opus 5.5?
En la mayoría de los benchmarks que ambos comparten en los gráficos de lanzamiento de OpenAI, sí. GPT-6.2 Sol supera a Opus 5.5 a máximo esfuerzo en Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA y BenchCAD, por mucho menos coste por tarea. Opus 5.5 mantiene una ventaja clara en programación con agentes: puntúa 58 frente a 50 de Sol en el Coding Agent Index independiente de Artificial Analysis.
¿Cuánto más barato es GPT-6.2 Sol que Claude Opus 5.5?
Las tarifas de API de GPT-6.2 Sol son la mitad que las de Opus 5.5: $2 vs $4 por millón de tokens de entrada y $10 vs $20 por millón de tokens de salida. Por tarea terminada, la brecha es mayor, porque Sol usa menos tokens de salida. En prompts por encima de 272K tokens de entrada, el recargo de Sol acerca ambos precios.
¿Qué cambió entre GPT-6.1 Sol y GPT-6.2 Sol?
GPT-6.2 Sol mantiene los precios de API de GPT-6.1 Sol pero puntúa más alto en la mayoría de los benchmarks de OpenAI usando menos tokens de salida. Los mayores saltos frente a Claude Opus 5.5 están en Terminal-Bench-Science, donde Sol pasó de ir por detrás a liderar, y en AutomationBench, donde la ventaja de Opus 5.5 se redujo a alrededor de un punto.
¿Dónde puedo usar GPT-6.2 Sol y Claude Opus 5.5?
GPT-6.2 Sol está en ChatGPT Work y Codex para usuarios Plus, Pro, Enterprise y Edu, y en el OpenAI API. Claude Opus 5.5 está en las apps de Claude, Claude Code, el Claude API y Cursor. Ambos están disponibles en Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot y OpenRouter.
¿Cuáles son los IDs de modelo en la API de GPT-6.2 Sol y Claude Opus 5.5?
El ID de modelo en la API de OpenAI es gpt-6.2-sol, y el ID en la API de Claude es claude-opus-5-5. En OpenRouter, los modelos son openai/gpt-6.2-sol y anthropic/claude-opus-5.5, por lo que puedes alternarlos cambiando una sola cadena en el mismo cliente.

Tom es editor de data science en DataCamp. Escribe y edita tutoriales de IA, compara nuevos lanzamientos de LLM y crea flujos de trabajo con IA. Antes trabajó en data science en Deutsche Telekom. Fuera del trabajo, pronostica partidos de fútbol con aprendizaje automático.





OpenAI ha lanzado GPT-6.2 Sol, la gama para el día a día de la familia GPT-6.2, con exactamente los mismos precios de API que GPT-6.1 Sol. Cuando comparamos GPT-6.1 Sol con Claude Opus 5.5, el reparto estaba claro: Sol ganaba en coste por tarea y Opus 5.5 en tasas de éxito máximas en ejecuciones de agentes difíciles a máximo esfuerzo. Los gráficos de lanzamiento de OpenAI para GPT-6.2 Sol ponen en duda esa segunda parte, e incluyen a Opus 5.5 a máximo esfuerzo en casi todos.
En este artículo, compararé GPT-6.2 Sol y Claude Opus 5.5 en trabajo profesional y ciencia, programación, automatización de negocio y precios, y después los pondré a prueba con el mismo encargo práctico de shader.
Si quieres entender mejor cómo funcionan los modelos GPT y cómo sacarles partido con buenos prompts antes de leer la comparativa, te recomiendo el curso Intermediate ChatGPT, que cubre la arquitectura detrás de los modelos GPT y técnicas avanzadas de prompting. Para estar al día en IA y datos, suscríbete a nuestra newsletter semanal, The Median.
Resumen
¿Qué es GPT-6.2 Sol?
GPT-6.2 Sol es el modelo de razonamiento eficiente de gama media de OpenAI, lanzado en noviembre de 2026 junto a GPT-6.2 Astra.
OpenAI lo presenta como su modelo de referencia para el trabajo diario, y su punto fuerte es la eficiencia: mejores resultados que GPT-6.1 Sol en tareas exigentes con menos tokens de salida, manteniendo precios.
Nuestra guía de GPT-6.2 Astra y Sol cubre el lanzamiento, con el conjunto completo de benchmarks y dos pruebas prácticas.
¿Qué es Claude Opus 5.5?
Claude Opus 5.5 es el modelo de Anthropic para programación con agentes de larga duración y trabajo de conocimiento, lanzado el 22 de septiembre de 2026 como el primer modelo de la familia Claude 5.5.
Anthropic lo sitúa al nivel de Claude Fable 5.1 en la mayor parte del trabajo, con un coste un 40% inferior al de Opus 5, y su razonamiento ya no puede desactivarse.
Nuestra guía de Claude Opus 5.5 cubre el lanzamiento; nuestro tutorial del API de Opus 5.5 construye con él un investigador de incidentes de IA.
GPT-6.2 Sol vs Claude Opus 5.5: comparación directa
GPT-6.2 Sol supera ahora a Claude Opus 5.5 en la mayoría de los benchmarks comunes, y Opus 5.5 mantiene ventajas ajustadas en programación y automatización.
En nuestra comparativa GPT-6.1 Sol vs Opus 5.5, Opus 5.5 lideraba la mayoría de resultados a máximo esfuerzo. Con GPT-6.2 Sol, los gráficos de OpenAI muestran a Sol por delante en 5 de los 9 benchmarks en los que aparecen ambos modelos, empatado en 1 y a menos de 2 puntos en los otros 3. La excepción es la programación: en el Coding Agent Index independiente de Artificial Analysis, Opus 5.5 aventaja por 8 puntos.
Trabajo profesional y ciencia
Aquí es donde se da la vuelta al veredicto de 6.1. GPT-6.1 Sol iba por detrás de Opus 5.5 en Terminal-Bench-Science 0.1, que evalúa trabajo científico en terminal, por 6 puntos a máximo esfuerzo. GPT-6.2 Sol ahora lo supera, 68,0% frente a 63,3%, a menos de una décima del coste por tarea.
El resto de gráficos de OpenAI sobre trabajo profesional apuntan en la misma dirección:
Agents' Last Exam, la prueba de OpenAI para flujos profesionales de largo recorrido, queda casi en empate a máximo esfuerzo. Lo más revelador es el esfuerzo: Sol en high ya se sitúa por encima de Opus 5.5 en max, por unos $0,69 por tarea.
Para documentos, trabajo legal, CAD y análisis científico, GPT-6.2 Sol es ahora el modelo más sólido con la evidencia disponible, no solo el más barato.
Programación
La programación es donde Opus 5.5 todavía lidera con claridad, y las cifras independientes amplían la brecha frente a lo que muestra el gráfico de OpenAI. En el Coding Agent Index de Artificial Analysis, que combina FrontierCode, Terminal-Bench 4.1 y SWE-Atlas-QnA, Opus 5.5 en Claude Code obtiene 58 a máximo esfuerzo, frente a 50 de GPT-6.2 Sol en Codex en su mejor ajuste, xhigh.
De hecho, GPT-6.2 Sol puntúa más bajo en ese índice que GPT-6.1 Sol. Artificial Analysis atribuye la caída a SWE-Atlas-QnA, donde el modelo nuevo omite con más frecuencia datos clave en sus respuestas.
El propio gráfico de OpenAI para FrontierCode 2.0 muestra una brecha inferior a 2 puntos a máximo esfuerzo. Opus 5.5 cuesta unas diez veces más por tarea a máximo esfuerzo en el índice de programación (unos $12,60 frente a unos $1,15), pero para trabajo sobre repositorios donde el resultado debe ser correcto, es el modelo más fuerte.
Automatización de flujos de negocio
AutomationBench, la prueba de Zapier para agentes que ejecutan flujos multietapa entre apps de negocio, fue el titular de la comparativa 6.1: Opus 5.5 lideraba por 6 puntos a máximo esfuerzo. Con GPT-6.2 Sol, la brecha baja a 1,4 puntos.
Sol también se estabiliza antes. Puntúa parecido desde esfuerzo medio en adelante, mientras que Opus 5.5 sube de forma constante y solo adelanta a Sol en max, donde cada tarea cuesta unas cinco veces más. Para un bot de soporte o un agente de ventas que ejecuta miles de flujos, Sol es ahora la elección obvia; Opus 5.5 solo compensa cuando un fallo cuesta más que la diferencia de precio.
Razonamiento general
Opus 5.5 mantiene una pequeña ventaja en el Artificial Analysis Intelligence Index, un compuesto de 9 evaluaciones de trabajo de conocimiento, programación y ciencia. A xhigh, Opus 5.5 empata con Sol en max, por aproximadamente seis veces el coste por tarea. Empatan en el Vals Science Index, así que el razonamiento general está cerca de la paridad con una ligera inclinación a Anthropic.
Precios: lo que realmente pagas
GPT-6.2 Sol cuesta la mitad que Opus 5.5 por token y mucho menos por tarea terminada.
GPT-6.2 Sol mantiene las tarifas de GPT-6.1 Sol, así que la diferencia de precio por token sigue igual. La brecha en coste por tarea no, porque Sol ahora necesita menos tokens de salida para terminar el mismo trabajo. Nuestra ejecución única del shader, más abajo, apunta en la misma línea, con Opus casi 6x más caro que Sol ($0,21 frente a $1,20).
Tarifas por token, lado a lado
GPT-6.2 Sol cuesta exactamente la mitad que Opus 5.5 en cada tarifa estándar, hasta que un prompt supera los 272K tokens de entrada:
Ambos modelos facturan los tokens de razonamiento como salida, y el razonamiento de Opus 5.5 no se puede desactivar, así que su tarifa de salida es la que más pesa.
Lo que cuesta una carga real de trabajo
Cada total es (volumen ÷ 1M) × tarifa, sumado entre entrada y salida, a tarifas estándar.
Por qué la misma tarea cuesta distinto
Los dos modelos usan tokenizadores diferentes, pero la mayor diferencia es cuántos tokens de salida consume cada uno. El gráfico de GDPval v2 de OpenAI sitúa a Opus 5.5 en 191.241 tokens de salida por tarea a máximo esfuerzo frente a 33.428 de GPT-6.2 Sol, y en 61.121 frente a 12.420 a esfuerzo alto.
Son mediciones de OpenAI, pero comparan directamente a ambos. Si Opus 5.5 necesitase unos 3 veces los tokens de salida de Sol en la carga de asistente equilibrado, como en nuestra prueba, su factura mensual sería de $19,00 frente a $4,50 de Sol.
Por eso las diferencias de coste por tarea de la tabla resumen son mucho mayores que el 2x en precio por token.
Cómo rindieron GPT-6.2 Sol y Claude Opus 5.5
Hasta ahora, todas las cifras provienen de gráficos de OpenAI, así que ejecuté una tarea de construcción con ambos modelos usando el mismo prompt y las mismas herramientas.
La tarea: una única página HTML con un fragment shader GLSL a pantalla completa y animado de un bosque de kelp submarino al atardecer, servido con p5.js desde un CDN.
La dificultad es que la escena tiene varios elementos, y el cursor debe afectar a todos:
Pone a prueba la afirmación de OpenAI de que GPT-6.2 construye frontends que se ven y funcionan mejor, incluidas escenas 3D. Ambos modelos se ejecutaron en OpenCode con una superficie de herramientas fija (leer y editar archivos), a alto esfuerzo de razonamiento, con un intento cada uno en una sesión nueva y el prompt entregado byte a byte.
Esto es lo que construyó GPT-6.2 Sol: