
Kết quả chính:
- Cả hai đều dựng đúng cảnh ngay lần đầu. Mỗi bên đều tạo một GLSL fragment shader thực sự với uniform thời gian và chuột, hoạt họa mượt, và vẽ một rừng tảo bẹ có thể nhận ra ngay. Không bên nào cần gợi ý thêm.
- Cảnh của GPT-6.2 Sol trông chân thực hơn. Phiên bản của Opus 5.5 có phần giống hoạt hình hơn, khiến nó mất một điểm về mức độ khớp thẩm mỹ với đề bài.
- Mỗi mô hình làm đúng một nửa hiệu ứng đèn. Đèn của Sol cho cảm giác như một hình nón sáng 3D vươn vào cảnh, còn của Opus 5.5 di chuyển nhiều theo góc 2D phẳng. Nhưng tảo của Opus 5.5 uốn tránh đèn rõ ràng và nhạy hơn, còn hiệu ứng uốn tránh của Sol yếu hơn.
Đây là phiên bản của Opus 5.5, nơi các dải tảo gần con trỏ nhường chỗ thấy rõ:
Tôi chấm điểm cả hai theo mức độ khớp đề bài, chất lượng shader, tính tương tác với con trỏ, và việc hiệu ứng có phải shader thật hay không. Chất lượng và kỹ thuật shader đều đạt điểm tối đa; các hàng khác biệt như sau:
| Chỉ số | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| Chi phí lần chạy này (USD) | $0,21 | $1,20 |
| Token đầu ra (kể cả lý luận) | 16.476 | 44.996 |
| Khớp thẩm mỹ (tiêu chí chính) | 5 | 4 |
| Điểm rubric (trung bình bốn trục) | 4,8 | 4,5 |
GPT-6.2 Sol thắng sít sao ở bài thử này, nhờ tính chân thực, phù hợp với tuyên bố của OpenAI về giao diện 3D đẹp mắt hơn. Sol làm đúng phần “ánh sáng”, Opus 5.5 làm đúng phần “đẩy”, và Sol làm điều đó với chi phí chỉ khoảng một phần sáu.
Đây là một lần chạy cho một tác vụ ở một mức nỗ lực. Cả hai đều vượt ngưỡng kỹ thuật dễ dàng, nên thứ phân định là gu thẩm mỹ, điều mà một lần chạy chỉ gợi ý phần nào.
Khi nào chọn GPT-6.2 Sol và khi nào chọn Claude Opus 5.5
Lựa chọn phụ thuộc vào loại công việc, độ dài lời nhắc, và nơi bạn triển khai.
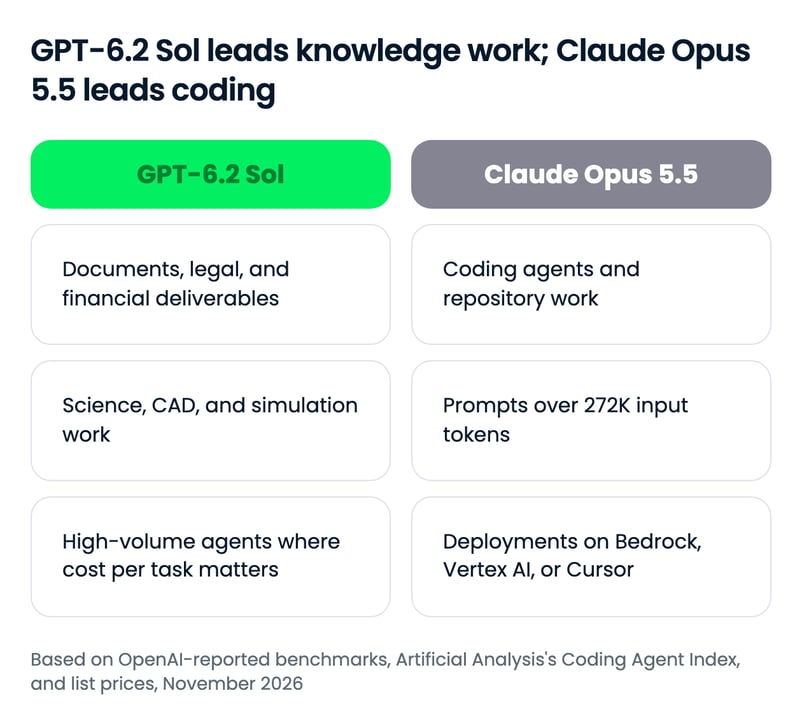
GPT-6.2 Sol nên là mặc định của bạn, và Opus 5.5 là mô hình bạn chọn vì một lý do cụ thể. Con số duy nhất có thể đảo ngược bài toán chi phí là ngưỡng 272K token: trên ngưỡng đó, phụ phí của Sol khiến giá tiến gần Opus 5.5.
Hãy chọn GPT-6.2 Sol nếu...
- Bạn sản xuất sản phẩm chuyên môn. Sol dẫn ở GDPval v2 và vượt hơn gấp đôi Opus 5.5 ở điểm chuẩn pháp lý của Harvey, nên tài liệu, bản ghi nhớ, và dự thảo pháp lý là sân nhà của nó.
- Bạn chạy công việc khoa học, CAD, hoặc mô phỏng. Nó nay dẫn Terminal-Bench-Science và BenchCAD, hai điểm chuẩn mà GPT-6.1 Sol từng kém Opus 5.5.
- Bạn vận hành tác tử ở khối lượng lớn. Chi phí mỗi tác vụ của nó chỉ bằng một phần nhỏ của Opus 5.5 trên mọi biểu đồ OpenAI công bố, và trên vài biểu đồ, nó đạt gần mức tối đa ngay ở nỗ lực cao.
- Bạn làm việc trong Codex, GitHub Copilot, hoặc Azure AI Foundry. GPT-6.2 Sol đã có mặt trên cả ba.
Hãy chọn Claude Opus 5.5 nếu...
- Tác tử lập trình là khối lượng chính. Opus 5.5 dẫn Coding Agent Index độc lập của Artificial Analysis 8 điểm, và kết quả Terminal-Bench 4.0 và CursorBench của Anthropic chưa có đối chứng GPT-6.2 Sol.
- Lời nhắc của bạn thường vượt 272K token. Opus 5.5 không có phụ phí ngữ cảnh dài, nên lời nhắc cả codebase có chi phí gần như nhau ở cả hai.
- Bạn triển khai qua Bedrock, Vertex AI, hoặc Cursor. Opus 5.5 có mặt trên cả ba; GPT-6.2 Sol chưa có trong tài liệu Cursor, và chúng tôi không thấy nó được liệt kê trên Bedrock hay Vertex AI trong các nguồn của mình.
Bắt đầu với GPT-6.2 Sol và Claude Opus 5.5 như thế nào
Quyền truy cập gần như giống hệt, trừ việc GPT-6.2 Sol không có trên Cursor, do OpenAI quyết định rút mô hình của họ khỏi nền tảng này.
| Bề mặt | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Ứng dụng người dùng | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Ứng dụng Claude |
| API chính chủ | OpenAI API | Claude API |
| Nền tảng đám mây | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Tác tử lập trình | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Bộ định tuyến bên thứ ba | OpenRouter | OpenRouter |
| ID mô hình API | gpt-6.2-sol | claude-opus-5-5 |
ID mô hình API là gpt-6.2-sol và claude-opus-5-5; trên OpenRouter là openai/gpt-6.2-sol và anthropic/claude-opus-5.5.
Thực hiện gọi API đầu tiên
Cách nhanh nhất để thử cả hai là OpenRouter, nơi việc chuyển mô hình chỉ cần đổi một chuỗi:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)Để xây dựng hoàn chỉnh, hướng dẫn API Opus 5.5 của chúng tôi đi qua một dự án tác tử từ đầu đến cuối.
Kết luận
GPT-6.2 Sol nên là lựa chọn mặc định thay vì Claude Opus 5.5. Nó vượt Opus 5.5 ở khoảng một nửa số điểm chuẩn chung và bám sát ở phần còn lại với chi phí mỗi tác vụ chỉ bằng một phần nhỏ, khiến Opus 5.5 phù hợp hơn cho tác tử lập trình, lời nhắc rất dài, và triển khai trên Bedrock, Vertex AI, hoặc Cursor.
Điều tôi thấy thú vị nhất là giá của Sol không hề đổi: OpenAI thắng vòng này nhờ token đầu ra. Lưu ý Opus 5.5 đã ra mắt gần hai tháng, điều này như cả “thế kỷ” ở nhịp độ hiện tại, nên tôi kỳ vọng bản phát hành tiếp theo của Anthropic sẽ cạnh tranh với Sol về chất lượng và hiệu suất.
Nếu bạn xây dựng trên bất kỳ mô hình nào, tôi khuyên theo học lộ trình kỹ năng OpenAI Fundamentals hoặc khóa Introduction to Claude Models của chúng tôi.
Câu hỏi thường gặp
GPT-6.2 Sol có tốt hơn Claude Opus 5.5 không?
Trên hầu hết điểm chuẩn chung trong các biểu đồ ra mắt của OpenAI, có. GPT-6.2 Sol vượt Opus 5.5 ở mức nỗ lực tối đa tại Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA, và BenchCAD, với chi phí mỗi tác vụ thấp hơn nhiều. Opus 5.5 vẫn dẫn rõ ở lập trình tác tử: nó đạt 58 so với 50 của Sol trên Coding Agent Index độc lập của Artificial Analysis.
GPT-6.2 Sol rẻ hơn Claude Opus 5.5 bao nhiêu?
Giá API của GPT-6.2 Sol bằng một nửa Opus 5.5: $2 so với $4 mỗi triệu token đầu vào và $10 so với $20 mỗi triệu token đầu ra. Tính theo tác vụ hoàn tất, khoảng cách còn rộng hơn vì Sol dùng ít token đầu ra hơn. Với lời nhắc vượt 272K token đầu vào, phụ phí của Sol khiến giá hai bên tiến gần nhau.
Có gì thay đổi giữa GPT-6.1 Sol và GPT-6.2 Sol?
GPT-6.2 Sol giữ mức giá API của GPT-6.1 Sol nhưng đạt điểm cao hơn trên hầu hết điểm chuẩn của OpenAI trong khi dùng ít token đầu ra hơn. Tăng mạnh nhất so với Claude Opus 5.5 là ở Terminal-Bench-Science, nơi Sol từ kém thành dẫn, và AutomationBench, nơi lợi thế của Opus 5.5 thu hẹp còn khoảng một điểm.
Tôi có thể dùng GPT-6.2 Sol và Claude Opus 5.5 ở đâu?
GPT-6.2 Sol có trong ChatGPT Work và Codex cho người dùng Plus, Pro, Enterprise, và Edu, cùng OpenAI API. Claude Opus 5.5 có trong ứng dụng Claude, Claude Code, Claude API, và Cursor. Cả hai đều có trên Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot, và OpenRouter.
ID mô hình API của GPT-6.2 Sol và Claude Opus 5.5 là gì?
ID mô hình API của OpenAI là gpt-6.2-sol, và của Claude API là claude-opus-5-5. Trên OpenRouter, hai mô hình là openai/gpt-6.2-sol và anthropic/claude-opus-5.5, vì vậy bạn có thể chuyển đổi giữa chúng chỉ bằng cách thay một chuỗi trong cùng client.

Tom là Biên tập viên Khoa học Dữ liệu tại DataCamp. Anh viết và biên tập các hướng dẫn về AI, so sánh các bản phát hành LLM mới, và xây dựng quy trình làm việc được hỗ trợ bởi AI. Trước đây, anh làm việc trong lĩnh vực khoa học dữ liệu tại Deutsche Telekom. Ngoài công việc, anh dự báo các trận bóng đá bằng học máy.


OpenAI đã phát hành GPT-6.2 Sol, phiên bản cho công việc thường nhật của dòng GPT-6.2, với mức giá API giống hệt GPT-6.1 Sol. Khi chúng tôi so sánh GPT-6.1 Sol với Claude Opus 5.5, ranh giới khá rõ: Sol cho chi phí mỗi tác vụ, Opus 5.5 cho tỷ lệ thành công cao nhất ở các lần chạy tác tử khó ở mức nỗ lực tối đa. Biểu đồ ra mắt của OpenAI cho GPT-6.2 Sol khiến nửa sau đó bị nghi ngờ, và họ có đưa Opus 5.5 ở mức nỗ lực tối đa trên hầu hết mọi biểu đồ.
Trong bài viết này, tôi sẽ so sánh GPT-6.2 Sol và Claude Opus 5.5 trên các hạng mục: công việc chuyên môn và khoa học, lập trình, tự động hóa nghiệp vụ, và giá, rồi chạy cả hai trên cùng một bài dựng shader thực tế.
Nếu bạn muốn nắm chắc hơn cách các mô hình GPT hoạt động và cách nhắc lệnh hiệu quả trước khi đọc phần so sánh, tôi khuyên học khóa Intermediate ChatGPT, bao quát kiến trúc phía sau các mô hình GPT và kỹ thuật nhắc nâng cao. Để theo sát lĩnh vực AI và dữ liệu, hãy đăng ký bản tin hàng tuần The Median của chúng tôi.
Tóm tắt nhanh
GPT-6.2 Sol là gì?
GPT-6.2 Sol là mô hình suy luận tầm trung hiệu quả của OpenAI, ra mắt tháng 11/2026 cùng GPT-6.2 Astra.
OpenAI gọi đây là mô hình chủ lực cho công việc thường ngày, với điểm bán là hiệu suất: kết quả tốt hơn GPT-6.1 Sol trên các tác vụ đòi hỏi, dùng ít token đầu ra hơn, với mức giá không đổi.
Hướng dẫn GPT-6.2 Astra và Sol của chúng tôi bao quát buổi ra mắt, kèm bộ điểm chuẩn đầy đủ và hai bài thử thực tế.
Claude Opus 5.5 là gì?
Claude Opus 5.5 là mô hình của Anthropic dành cho lập trình tác tử chạy dài và công việc tri thức, ra mắt ngày 22/09/2026, là mô hình đầu tiên trong dòng Claude 5.5.
Anthropic định vị nó ở mức Claude Fable 5.1 cho hầu hết công việc nhưng chi phí vận hành thấp hơn Opus 5 đến 40%, và chế độ “suy nghĩ” không thể tắt.
Hướng dẫn Claude Opus 5.5 của chúng tôi bao quát buổi ra mắt; hướng dẫn API Opus 5.5 xây dựng một tác tử điều tra sự cố AI với mô hình này.
GPT-6.2 Sol vs Claude Opus 5.5: So sánh trực diện
GPT-6.2 Sol hiện dẫn Claude Opus 5.5 trên đa số điểm chuẩn chung, còn Opus 5.5 giữ khoảng cách nhỏ ở lập trình và tự động hóa.
Trong so sánh GPT-6.1 Sol vs Opus 5.5 của chúng tôi, Opus 5.5 dẫn ở phần lớn kết quả mức nỗ lực tối đa. Với GPT-6.2 Sol, biểu đồ của OpenAI cho thấy Sol dẫn ở 5/9 điểm chuẩn cả hai cùng xuất hiện, ngang ở 1, và kém dưới 2 điểm ở 3 còn lại. Lập trình là ngoại lệ: trên Coding Agent Index độc lập của Artificial Analysis, Opus 5.5 dẫn 8 điểm.
Công việc chuyên môn và khoa học
Đây là nơi kết luận thời 6.1 đảo chiều. GPT-6.1 Sol kém Opus 5.5 ở Terminal-Bench-Science 0.1, bài thử công việc khoa học trong terminal, 6 điểm ở mức tối đa. GPT-6.2 Sol nay dẫn, 68,0% so với 63,3%, với chi phí mỗi tác vụ chưa đến một phần mười.
Các biểu đồ công việc chuyên môn khác của OpenAI cũng chỉ cùng hướng:
Agents' Last Exam, bài thử của OpenAI về quy trình làm việc chuyên môn dài hạn, gần như hòa ở mức tối đa. Điểm đáng chú ý hơn trên biểu đồ là nỗ lực: Sol ở mức high đã vượt Opus 5.5 ở mức max, với khoảng $0,69 mỗi tác vụ.
Với tài liệu, công việc pháp lý, CAD, và phân tích khoa học, theo bằng chứng hiện có, GPT-6.2 Sol nay là mô hình mạnh hơn, không chỉ rẻ hơn.
Lập trình
Lập trình là nơi Opus 5.5 vẫn dẫn rõ, và số liệu độc lập cho thấy khoảng cách lớn hơn những gì biểu đồ OpenAI thể hiện. Trên Coding Agent Index của Artificial Analysis, kết hợp FrontierCode, Terminal-Bench 4.1, và SWE-Atlas-QnA, Opus 5.5 trong Claude Code đạt 58 ở mức tối đa, so với 50 cho GPT-6.2 Sol trong Codex ở thiết lập tốt nhất, xhigh.
GPT-6.2 Sol thực tế còn điểm thấp hơn GPT-6.1 Sol trên chỉ số đó. Artificial Analysis quy nguyên nhân cho SWE-Atlas-QnA, nơi mô hình mới hay bỏ sót các dữ kiện then chốt trong câu trả lời.
Biểu đồ FrontierCode 2.0 của chính OpenAI cho thấy khoảng cách dưới 2 điểm ở mức tối đa. Opus 5.5 đắt gấp khoảng mười lần mỗi tác vụ ở mức tối đa trên chỉ số lập trình (khoảng $12,60 so với khoảng $1,15), nhưng với công việc trên kho mã nơi kết quả phải chính xác, đây là mô hình mạnh hơn.
Tự động hóa quy trình nghiệp vụ
AutomationBench, bài thử của Zapier về tác tử chạy quy trình nhiều bước trên các ứng dụng nghiệp vụ, từng là tiêu điểm ở so sánh 6.1: Opus 5.5 dẫn 6 điểm ở mức tối đa. Với GPT-6.2 Sol, khoảng cách giảm còn 1,4 điểm.
Sol cũng “bão hòa” sớm. Điểm của nó gần như ngang nhau từ mức medium trở lên, trong khi Opus 5.5 tăng dần và chỉ vượt Sol ở mức max, nơi mỗi tác vụ đắt gấp khoảng năm lần. Với bot hỗ trợ hay tác tử sales-ops chạy hàng nghìn quy trình, Sol giờ là lựa chọn hiển nhiên; Opus 5.5 chỉ hợp lý khi một lần chạy hỏng tốn kém hơn chênh lệch giá.
Lý luận tổng quát
Opus 5.5 giữ lợi thế nhỏ trên Artificial Analysis Intelligence Index, hợp phần của 9 đánh giá bao trùm công việc tri thức, lập trình và khoa học. Ở mức xhigh, Opus 5.5 ngang điểm Sol ở mức max, với chi phí mỗi tác vụ gấp khoảng sáu lần. Cả hai hòa ở Vals Science Index, nên lý luận tổng quát gần như ngang, hơi nghiêng Anthropic.
Giá: bạn thực trả là bao nhiêu
GPT-6.2 Sol có giá mỗi token bằng một nửa Opus 5.5 và rẻ hơn nhiều mỗi tác vụ hoàn tất.
GPT-6.2 Sol giữ mức giá của GPT-6.1 Sol, nên chênh lệch giá theo token vẫn như trước. Chênh lệch chi phí theo tác vụ thì không, vì Sol nay cần ít token đầu ra hơn để hoàn tất cùng khối lượng công việc. Lần chạy shader riêng của chúng tôi dưới đây cũng cho kết quả tương tự, với Opus đắt gần 6 lần so với Sol ($0,21 so với $1,20).
Bảng giá token cạnh nhau
GPT-6.2 Sol có giá đúng bằng một nửa Opus 5.5 ở mọi mức tiêu chuẩn, cho đến khi lời nhắc vượt 272K token đầu vào:
Cả hai mô hình tính token lý luận như đầu ra, và “suy nghĩ” của Opus 5.5 không thể tắt, nên mức giá đầu ra là yếu tố quan trọng nhất.
Khối lượng công việc thực tế tốn bao nhiêu
Tổng chi phí = (khối lượng ÷ 1M) × mức giá, cộng đầu vào và đầu ra, ở mức tiêu chuẩn.
Vì sao cùng tác vụ lại có chi phí khác nhau
Hai mô hình dùng bộ mã hóa token khác nhau, nhưng khác biệt lớn hơn là số token đầu ra mỗi bên dùng. Biểu đồ GDPval v2 của OpenAI cho thấy Opus 5.5 ở mức 191.241 token đầu ra mỗi tác vụ ở nỗ lực tối đa so với 33.428 của GPT-6.2 Sol, và 61.121 so với 12.420 ở nỗ lực cao.
Đó là đo đạc của chính OpenAI, nhưng so sánh trực tiếp hai đối tượng. Nếu Opus 5.5 cần khoảng gấp 3 lần token đầu ra của Sol trên khối lượng “trợ lý cân bằng”, như trong thử nghiệm của chúng tôi, hóa đơn tháng của nó sẽ là $19,00 so với $4,50 của Sol.
Đó là lý do các khoảng cách chi phí mỗi tác vụ trong bảng tóm tắt lớn hơn nhiều so với chênh lệch giá token 2x.
Kết quả thực thi của GPT-6.2 Sol và Claude Opus 5.5
Mọi con số đến đây đều từ biểu đồ của OpenAI, nên tôi đã chạy một tác vụ dựng với cả hai mô hình bằng lời nhắc và công cụ giống hệt nhau.
Tác vụ: một trang HTML đơn với GLSL fragment shader toàn màn hình, có hoạt họa về khu rừng tảo bẹ dưới nước lúc hoàng hôn, chạy bằng p5.js nạp từ CDN.
Điểm khó là cảnh có nhiều yếu tố, và con trỏ phải làm thay đổi tất cả:
Bài thử này kiểm chứng tuyên bố của OpenAI rằng GPT-6.2 dựng giao diện nhìn và vận hành tốt hơn, bao gồm các cảnh 3D. Cả hai mô hình chạy trong OpenCode với bề mặt công cụ cố định (chỉ đọc và chỉnh sửa tệp), ở mức nỗ lực lý luận cao, mỗi bên một lần trong phiên mới và lời nhắc gửi giống hệt từng byte.
Đây là những gì GPT-6.2 Sol dựng được: