
मुख्य निष्कर्ष:
- दोनों ने पहली बार में सीन सही बनाया। हर एक ने समय और माउस यूनिफॉर्म्स के साथ एक वास्तविक GLSL फ्रैगमेंट शेडर दिया, जो स्मूथली एनिमेट हुआ, और एक ऐसा केल्प फ़ॉरेस्ट बनाया जिसे आप झट से पहचान लेते हैं। किसी को भी धक्का देने की ज़रूरत नहीं पड़ी।
- GPT-6.2 Sol का सीन अधिक यथार्थपरक दिखता है। Opus 5.5 का वर्ज़न थोड़ा कार्टून-सा लगता है, जिससे ब्रीफ़ से मेल खाने पर इसे एक अंक का नुकसान हुआ।
- हर मॉडल ने टॉर्च के अलग-अलग आधे हिस्से को सही किया। Sol की टॉर्च एक 3D प्रकाश-शंकु जैसी लगती है जो सीन में भीतर तक जाती है, जबकि Opus 5.5 की टॉर्च अधिक फ्लैट 2D कोण पर चलती महसूस होती है। लेकिन Opus 5.5 की केल्प टहनियाँ टॉर्च से स्पष्ट और तत्परता से हटती हैं, जबकि Sol का हटना कमज़ोर है।
यह रहा Opus 5.5 का वर्ज़न, जहाँ कर्सर के पास की टहनियाँ साफ़ तौर पर रास्ता देती दिखती हैं:
मैंने दोनों को इस आधार पर स्कोर किया कि सीन ब्रीफ़ से कितना मेल खाता है, शेडर क्वालिटी, कर्सर इंटरैक्टिविटी, और क्या इफ़ेक्ट वास्तविक शेडर था। शेडर क्वालिटी और तकनीक पर दोनों के पूरे अंक थे; जहाँ अंतर आया, वे पंक्तियाँ:
| माप | GPT-6.2 Sol (high) | Claude Opus 5.5 (high) |
|---|---|---|
| इस रन की लागत (USD) | $0.21 | $1.20 |
| आउटपुट टोकन (रीजनिंग सहित) | 16,476 | 44,996 |
| एस्थेटिक मैच (मुख्य भेदक) | 5 | 4 |
| रूब्रिक स्कोर (चार अक्षों का माध्य) | 4.8 | 4.5 |
GPT-6.2 Sol यह टेस्ट मामूली अंतर से जीतता है, यथार्थवाद पर, जो OpenAI के बेहतर-दिखने वाले 3D फ्रंटएंड के दावे से मेल खाता है। Sol ने लाइट को सही पकड़ा और Opus 5.5 ने पुश को, और Sol ने यह लगभग एक-छठी लागत पर किया।
यह एक कार्य का एक रन है, एक प्रयास सेटिंग पर। दोनों मॉडलों ने तकनीक की कसौटी आसानी से पार की, इसलिए जो उन्हें अलग करता है वह है बनावट/रुचि, जिसे एकल रन केवल संकेत दे सकता है।
कब चुनें GPT-6.2 Sol बनाम Claude Opus 5.5
चयन आपके काम के प्रकार, प्रॉम्प्ट की लंबाई, और आप कहाँ डिप्लॉय करते हैं, इस पर निर्भर करता है।
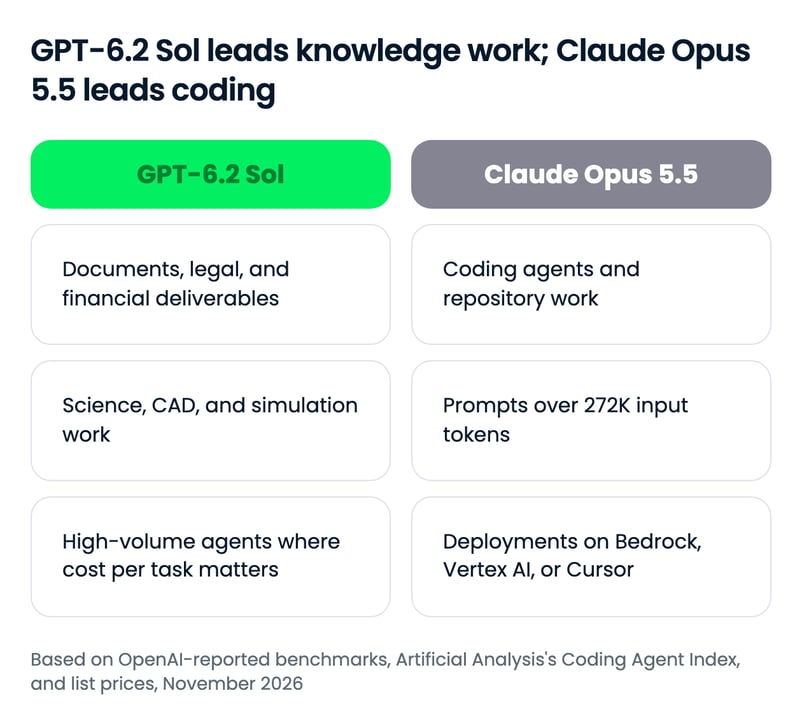
GPT-6.2 Sol आपका डिफ़ॉल्ट होना चाहिए, और Opus 5.5 वह मॉडल जिसे आप किसी विशेष कारण से चुनें। लागत के मामले को पलट सकने वाली एक संख्या है 272K-टोकन थ्रेशहोल्ड, जिसके ऊपर Sol का सरचार्ज इसे Opus 5.5 की कीमत के क़रीब ले आता है।
GPT-6.2 Sol चुनें यदि...
- आप पेशेवर डिलिवरेबल्स बनाते हैं। Sol GDPval v2 पर आगे है और Harvey के लीगल बेंचमार्क पर Opus 5.5 से दोगुने से अधिक स्कोर करता है, इसलिए दस्तावेज़, मेमो, और कानूनी ड्राफ्ट इसकी स्वाभाविक ताकत हैं।
- आप वैज्ञानिक, CAD, या सिमुलेशन कार्य चलाते हैं। अब यह Terminal-Bench-Science और BenchCAD पर आगे है—दो बेंचमार्क जहाँ GPT-6.1 Sol Opus 5.5 से पीछे था।
- आप उच्च मात्रा में एजेंट्स चलाते हैं। OpenAI के हर चार्ट पर इसकी प्रति कार्य लागत Opus 5.5 की तुलना में एक अंश है, और OpenAI के कई चार्ट पर यह हाई प्रयास पर अपने अधिकतम के क़रीब स्कोर करता है।
- आप Codex, GitHub Copilot, या Azure AI Foundry में काम करते हैं। GPT-6.2 Sol तीनों पर पहले से सूचीबद्ध है।
Claude Opus 5.5 चुनें यदि...
- कोडिंग एजेंट्स आपका मुख्य वर्कलोड हैं। Opus 5.5 Artificial Analysis के स्वतंत्र Coding Agent Index पर 8 अंकों से आगे है, और Anthropic के Terminal-Bench 4.0 और CursorBench नतीजों का GPT-6.2 Sol समकक्ष अभी नहीं है।
- आपके प्रॉम्प्ट नियमित रूप से 272K टोकन पार करते हैं। Opus 5.5 पर कोई लॉन्ग-कॉन्टेक्स्ट सरचार्ज नहीं है, इसलिए पूरे-कोडबेस प्रॉम्प्ट पर दोनों की कीमत लगभग समान पड़ती है।
- आप Bedrock, Vertex AI, या Cursor के माध्यम से डिप्लॉय करते हैं। Opus 5.5 तीनों पर सूचीबद्ध है; GPT-6.2 Sol Cursor डॉक्स में नहीं है, और हमारे स्रोतों में हमें इसका Bedrock या Vertex AI लिस्टिंग नहीं मिला।
GPT-6.2 Sol और Claude Opus 5.5 के साथ कैसे शुरू करें
एक्सेस लगभग एक जैसा है, सिवाय इसके कि GPT-6.2 Sol Cursor में उपलब्ध नहीं है, क्योंकि OpenAI ने अपने मॉडल्स को उस प्लेटफ़ॉर्म से हटाने का फ़ैसला किया।
| सरफेस | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| कंज़्यूमर ऐप | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Claude ऐप्स |
| फ़र्स्ट-पार्टी API | OpenAI API | Claude API |
| क्लाउड प्लेटफ़ॉर्म | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| कोडिंग एजेंट्स | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| थर्ड-पार्टी राउटर्स | OpenRouter | OpenRouter |
| API मॉडल ID | gpt-6.2-sol | claude-opus-5-5 |
API मॉडल ID हैं gpt-6.2-sol और claude-opus-5-5; OpenRouter पर ये openai/gpt-6.2-sol और anthropic/claude-opus-5.5 हैं।
अपनी पहली API कॉल करना
दोनों को आज़माने का सबसे तेज़ तरीका है OpenRouter, जहाँ मॉडल स्विच करना एक स्ट्रिंग बदलने जितना आसान है:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)पूरा बिल्ड करने के लिए, हमारा Opus 5.5 API ट्यूटोरियल एक एजेंट प्रोजेक्ट को शुरू से अंत तक समझाता है।
अंतिम विचार
Claude Opus 5.5 की तुलना में GPT-6.2 Sol डिफ़ॉल्ट पसंद होनी चाहिए। यह साझा बेंचमार्क के लगभग आधे में Opus 5.5 को हराता है और बाकी में क़रीब पहुँचता है—प्रति कार्य लागत के एक अंश पर—जिससे Opus 5.5 कोडिंग एजेंट्स, बहुत लंबे प्रॉम्प्ट्स, और Bedrock, Vertex AI, या Cursor डिप्लॉयमेंट्स के लिए पसंद बनता है।
मेरी नज़र में सबसे दिलचस्प बात यह है कि Sol की कीमत बदली ही नहीं: OpenAI ने यह राउंड आउटपुट टोकन पर जीता। ध्यान रखें कि Opus 5.5 को लगभग दो महीने हो चुके हैं—वर्तमान रफ़्तार पर यह प्रकाश-वर्षों जैसा लगता है—इसलिए मुझे उम्मीद है कि Anthropic की अगली रिलीज़ क्वालिटी और दक्षता पर Sol से टक्कर लेगी।
यदि आप किसी भी मॉडल पर बना रहे हैं, तो मैं हमारे OpenAI Fundamentals स्किल ट्रैक या हमारे Introduction to Claude Models कोर्स की सिफारिश करता हूँ।
FAQs
क्या GPT-6.2 Sol, Claude Opus 5.5 से बेहतर है?
OpenAI के लॉन्च चार्ट्स में जिन अधिकांश बेंचमार्क को दोनों साझा करते हैं, उन पर हाँ। GPT-6.2 Sol, Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA, और BenchCAD पर अधिकतम प्रयास में Opus 5.5 से आगे है, और प्रति कार्य लागत कहीं कम है। एजेंटिक कोडिंग में Opus 5.5 स्पष्ट बढ़त रखता है: Artificial Analysis के स्वतंत्र Coding Agent Index पर यह Sol के 50 के मुकाबले 58 स्कोर करता है।
GPT-6.2 Sol, Claude Opus 5.5 से कितना सस्ता है?
GPT-6.2 Sol की API दरें Opus 5.5 की आधी हैं: प्रति मिलियन इनपुट टोकन $2 बनाम $4 और प्रति मिलियन आउटपुट टोकन $10 बनाम $20। प्रति पूर्ण कार्य अंतर और चौड़ा है, क्योंकि Sol कम आउटपुट टोकन उपयोग करता है। 272K से अधिक इनपुट टोकन वाले प्रॉम्प्ट पर, Sol का सरचार्ज दोनों को कीमत में क़रीब ले आता है।
GPT-6.1 Sol और GPT-6.2 Sol के बीच क्या बदला?
GPT-6.2 Sol ने GPT-6.1 Sol की API कीमतें बरकरार रखीं लेकिन OpenAI के अधिकांश बेंचमार्क पर अधिक स्कोर किया, और कम आउटपुट टोकन उपयोग किए। Claude Opus 5.5 के मुकाबले सबसे बड़े उछाल Terminal-Bench-Science पर हैं, जहाँ Sol पीछे रहने से आगे निकल गया, और AutomationBench पर, जहाँ Opus 5.5 की बढ़त घटकर लगभग एक अंक रह गई।
मैं GPT-6.2 Sol और Claude Opus 5.5 कहाँ उपयोग कर सकता/सकती हूँ?
GPT-6.2 Sol, ChatGPT Work और Codex में Plus, Pro, Enterprise, और Edu यूज़र्स के लिए, और OpenAI API में उपलब्ध है। Claude Opus 5.5 Claude ऐप्स, Claude Code, Claude API, और Cursor में उपलब्ध है। दोनों Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot, और OpenRouter पर उपलब्ध हैं।
GPT-6.2 Sol और Claude Opus 5.5 के API मॉडल ID क्या हैं?
OpenAI API मॉडल ID gpt-6.2-sol है, और Claude API मॉडल ID claude-opus-5-5 है। OpenRouter पर दोनों मॉडल openai/gpt-6.2-sol और anthropic/claude-opus-5.5 हैं, इसलिए आप एक ही क्लाइंट कोड में एक स्ट्रिंग बदलकर उनके बीच स्विच कर सकते हैं।

टॉम DataCamp में डेटा साइंस संपादक हैं। वे एआई ट्यूटोरियल लिखते और संपादित करते हैं, नए LLM रिलीज़ की तुलना करते हैं, और एआई-संचालित वर्कफ़्लो बनाते हैं। इससे पहले, वे Deutsche Telekom में डेटा साइंस के क्षेत्र में काम करते थे। काम के अलावा, वे मशीन लर्निंग की मदद से फुटबॉल मैचों का पूर्वानुमान लगाते हैं।
OpenAI ने GPT-6.2 Sol जारी किया है, जो इसकी GPT-6.2 फैमिली का रोज़मर्रा का टियर है, और इसकी API कीमतें GPT-6.1 Sol के समान ही रखी हैं। जब हमने GPT-6.1 Sol की तुलना Claude Opus 5.5 से की, तस्वीर साफ़ थी: प्रति कार्य लागत के लिए Sol, और अधिकतम प्रयास पर कठिन एजेंट रन में सबसे अधिक सफलता दर के लिए Opus 5.5। GPT-6.2 Sol के लिए OpenAI के लॉन्च चार्ट्स उस दूसरे हिस्से पर सवाल उठाते हैं, और वे लगभग हर चार्ट पर अधिकतम प्रयास के साथ Opus 5.5 को शामिल करते हैं।
इस लेख में, मैं GPT-6.2 Sol और Claude Opus 5.5 की तुलना पेशेवर कार्य और विज्ञान, कोडिंग, बिज़नेस ऑटोमेशन, और प्राइसिंग में करूंगा, और फिर दोनों को एक ही हैंड्स-ऑन शेडर बिल्ड पर चलाऊंगा।
यदि आप तुलना पढ़ने से पहले यह बेहतर समझना चाहते हैं कि GPT मॉडल कैसे काम करते हैं और उन्हें अच्छे से प्रॉम्प्ट कैसे करें, तो मैं Intermediate ChatGPT कोर्स की सिफारिश करता हूँ, जो GPT मॉडलों के आर्किटेक्चर और उन्नत प्रॉम्प्ट लेखन को कवर करता है। AI और डेटा स्पेस से अपडेट रहने के लिए, हमारे साप्ताहिक न्यूज़लेटर The Median को सब्सक्राइब करें।
संक्षेप में
GPT-6.2 Sol क्या है?
GPT-6.2 Sol OpenAI का कुशल, मिड-टियर रीजनिंग मॉडल है, जिसे नवंबर 2026 में GPT-6.2 Astra के साथ रिलीज़ किया गया।
OpenAI इसे रोज़मर्रा के काम के लिए अपना पसंदीदा मॉडल कहता है, और इसकी खासियत है दक्षता: मांग वाले कार्यों पर GPT-6.1 Sol से बेहतर नतीजे, कम आउटपुट टोकन के साथ, और कीमतें अपरिवर्तित।
हमारा GPT-6.2 Astra और Sol गाइड लॉन्च को कवर करता है, जिसमें पूरा बेंचमार्क सेट और दो हैंड्स-ऑन टेस्ट शामिल हैं।
Claude Opus 5.5 क्या है?
Claude Opus 5.5 Anthropic का लंबे समय तक चलने वाली एजेंटिक कोडिंग और नॉलेज वर्क के लिए मॉडल है, जिसे 22 सितंबर, 2026 को Claude 5.5 फैमिली के पहले मॉडल के रूप में जारी किया गया।
Anthropic इसे अधिकांश कार्यों पर Claude Fable 5.1 के स्तर पर रखता है जबकि इसे Opus 5 की तुलना में 40% कम लागत पर चलाया जा सकता है, और इसकी थिंकिंग अब बंद नहीं की जा सकती।
हमारा Claude Opus 5.5 गाइड लॉन्च को कवर करता है; हमारा Opus 5.5 API ट्यूटोरियल इसके साथ एक AI घटना अन्वेषक बनाता है।
GPT-6.2 Sol बनाम Claude Opus 5.5: आमने-सामने तुलना
GPT-6.2 Sol अब अधिकांश साझा बेंचमार्क पर Claude Opus 5.5 से आगे है, और Opus 5.5 कोडिंग और ऑटोमेशन पर हल्की बढ़त बनाए रखता है।
हमारी GPT-6.1 Sol बनाम Opus 5.5 तुलना में, Opus 5.5 अधिकांश अधिकतम-प्रयास नतीजों में आगे था। GPT-6.2 Sol के साथ, OpenAI के चार्ट दिखाते हैं कि 9 साझा बेंचमार्क में से 5 पर Sol आगे है, 1 पर बराबर है, और बाकी 3 पर 2 अंकों से कम पीछे है। अपवाद है कोडिंग: Artificial Analysis के स्वतंत्र Coding Agent Index पर, Opus 5.5 8 अंकों से आगे है।
पेशेवर काम और विज्ञान
यहीं 6.1 का फ़ैसला पलटता है। GPT-6.1 Sol अधिकतम प्रयास पर Terminal-Bench-Science 0.1—जो टर्मिनल में वैज्ञानिक काम की परीक्षा लेता है—पर Opus 5.5 से 6 अंक पीछे था। GPT-6.2 Sol अब 68.0% बनाम 63.3% से आगे है, और वह भी प्रति कार्य लागत के दसवें हिस्से से कम पर।
OpenAI के बाकी प्रोफ़ेशनल-वर्क चार्ट भी यही दिशा दिखाते हैं:
Agents' Last Exam, जो OpenAI का लंबी-अवधि प्रोफ़ेशनल वर्कफ़्लोज़ का टेस्ट है, अधिकतम प्रयास पर लगभग बराबरी पर है। उस चार्ट पर अधिक बताने वाली बात है प्रयास: हाई प्रयास पर Sol पहले से ही Opus 5.5 के अधिकतम से ऊपर बैठता है, लगभग $0.69 प्रति कार्य पर।
दस्तावेज़, कानूनी कार्य, CAD, और वैज्ञानिक विश्लेषण के लिए, उपलब्ध साक्ष्य के आधार पर GPT-6.2 Sol अब न केवल सस्ता, बल्कि अधिक सक्षम मॉडल है।
कोडिंग
कोडिंग वह क्षेत्र है जहाँ Opus 5.5 अब भी साफ़ तौर पर आगे है, और स्वतंत्र आँकड़े OpenAI के चार्ट से बड़ा अंतर दिखाते हैं। Artificial Analysis के Coding Agent Index—जो FrontierCode, Terminal-Bench 4.1, और SWE-Atlas-QnA को जोड़ता है—पर Claude Code में Opus 5.5 अधिकतम प्रयास पर 58 स्कोर करता है, जबकि Codex में अपने सर्वश्रेष्ठ सेटिंग xhigh पर GPT-6.2 Sol 50।
GPT-6.2 Sol वास्तव में उस इंडेक्स पर GPT-6.1 Sol से कम स्कोर करता है। Artificial Analysis इस गिरावट को SWE-Atlas-QnA से जोड़ता है, जहाँ नया मॉडल अपने जवाबों में अहम तथ्यों को छोड़ने की अधिक संभावना दिखाता है।
OpenAI का अपना FrontierCode 2.0 चार्ट अधिकतम प्रयास पर 2 अंकों से कम का अंतर दिखाता है। कोडिंग इंडेक्स पर अधिकतम प्रयास पर Opus 5.5 प्रति कार्य लगभग दस गुना महँगा पड़ता है (लगभग $12.60 बनाम लगभग $1.15), लेकिन ऐसे रिपोजिटरी कार्यों के लिए जहाँ नतीजा सही होना अनिवार्य है, यह अधिक सक्षम मॉडल है।
बिज़नेस वर्कफ़्लो ऑटोमेशन
AutomationBench, जो Zapier का बिज़नेस ऐप्स में मल्टिस्टेप वर्कफ़्लो चलाने वाले एजेंट्स का टेस्ट है, 6.1 तुलना की सुर्ख़ी था: Opus 5.5 अधिकतम प्रयास पर 6 अंकों से आगे था। GPT-6.2 Sol के साथ, यह अंतर 1.4 अंकों पर आ गया है।
Sol जल्दी समतल भी हो जाता है। यह मीडियम प्रयास से ऊपर लगभग समान स्कोर करता है, जबकि Opus 5.5 लगातार चढ़ता है और केवल अधिकतम पर Sol को पार करता है, जहाँ हर कार्य की लागत लगभग पाँच गुना है। सपोर्ट बॉट या सेल्स-ऑप्स एजेंट जो हज़ारों वर्कफ़्लो चलाते हैं, उनके लिए अब Sol साफ़ पसंद है; Opus 5.5 वहीँ समझ में आता है जहाँ असफल रन की कीमत कीमत-अंतर से ज़्यादा हो।
सामान्य तर्क-क्षमता
Opus 5.5 Artificial Analysis Intelligence Index पर हल्की बढ़त रखता है, जो नॉलेज वर्क, कोडिंग, और विज्ञान के 9 मूल्याँकनों का मिश्रण है। xhigh प्रयास पर, Opus 5.5 प्रति कार्य लागत में लगभग छह गुना पर Sol के अधिकतम के बराबर स्कोर करता है। Vals Science Index पर दोनों बराबरी पर हैं, इसलिए सामान्य तर्क-क्षमता लगभग समान है, हल्का Anthropic झुकाव के साथ।
कीमत: आपको वास्तव में क्या चुकाना पड़ता है
GPT-6.2 Sol प्रति टोकन Opus 5.5 की आधी कीमत है और प्रति पूर्ण कार्य बहुत सस्ता।
GPT-6.2 Sol ने GPT-6.1 Sol की दरें बरकरार रखी हैं, इसलिए टोकन-कीमत का अंतर पहले जैसा ही है। प्रति कार्य लागत का अंतर वैसा नहीं है, क्योंकि अब Sol को वही काम पूरा करने के लिए कम आउटपुट टोकन चाहिए। हमारा अपना एकल शेडर रन, नीचे कवर किया गया, भी यही दिशा दिखाता है, जहाँ Opus Sol से लगभग 6x महँगा था ($0.21 बनाम $1.20)।
टोकन दरें साथ-साथ
GPT-6.2 Sol हर मानक दर पर Opus 5.5 से बिल्कुल आधी लागत का है, जब तक कि कोई प्रॉम्प्ट 272K इनपुट टोकन से आगे न बढ़ जाए:
दोनों मॉडल रीजनिंग टोकन को आउटपुट के रूप में बिल करते हैं, और Opus 5.5 की थिंकिंग बंद नहीं की जा सकती, इसलिए इसकी आउटपुट दर सबसे अधिक मायने रखती है।
वास्तविक वर्कलोड की कीमत
हर टोटल = (वॉल्यूम ÷ 1M) × दर, इनपुट और आउटपुट पर जोड़कर, मानक दरों पर।
एक ही कार्य की कीमत अलग क्यों पड़ती है
दोनों मॉडल अलग टोकनाइज़र इस्तेमाल करते हैं, लेकिन बड़ा अंतर यह है कि हर मॉडल कितने आउटपुट टोकन खर्च करता है। OpenAI के GDPval v2 चार्ट में अधिकतम प्रयास पर प्रति कार्य Opus 5.5 के 191,241 आउटपुट टोकन दिखते हैं, जबकि GPT-6.2 Sol के 33,428, और उच्च प्रयास पर 61,121 बनाम 12,420।
ये OpenAI के अपने माप हैं, लेकिन वे दोनों की सीधी तुलना करते हैं। यदि बैलेंस्ड असिस्टेंट वर्कलोड पर Opus 5.5 को Sol के आउटपुट टोकन की लगभग 3 गुना ज़रूरत पड़ी, जैसा कि हमारे अपने टेस्ट में हुआ, तो इसका मासिक बिल $19.00 होगा, जबकि Sol का $4.50।
इसीलिए सारणी में प्रति कार्य लागत के अंतर 2x टोकन-कीमत के अंतर से कहीं अधिक चौड़े दिखते हैं।
GPT-6.2 Sol और Claude Opus 5.5 का प्रदर्शन
अब तक हर संख्या OpenAI के चार्ट से आई है, इसलिए मैंने दोनों मॉडलों पर एक जैसा प्रॉम्प्ट और एक जैसे टूलिंग के साथ एक बिल्ड कार्य चलाया।
कार्य: एक सिंगल HTML पेज जिसमें एक फुल-विंडो, एनिमेटेड GLSL फ्रैगमेंट शेडर हो—शाम के समय अंडरवॉटर केल्प फ़ॉरेस्ट का—और जिसे p5.js (CDN से लोडेड) होस्ट करे।
कठिन हिस्सा यह है कि सीन में कई तत्व हैं, और कर्सर को उन सबको बदलना होता है:
यह OpenAI के उस दावे की जाँच करता है कि GPT-6.2 बेहतर दिखने वाले और बेहतर काम करने वाले फ्रंटएंड—3D सीन सहित—बनाता है। दोनों मॉडल OpenCode में एक पिन्ड टूल सरफेस (सिर्फ़ फ़ाइल पढ़ना और संपादन) के साथ, उच्च रीजनिंग प्रयास पर, हर एक को एक नए सत्र में एक-एक प्रयास, और प्रॉम्प्ट को बाइट-फॉर-बाइट दिया गया।
यह है GPT-6.2 Sol ने क्या बनाया: