
Huvudfynden:
- Båda byggde scenen korrekt på första försöket. Var och en levererade en riktig GLSL-fragmentshader med tids- och musuniformer, animerade jämnt och ritade en tångskog du känner igen direkt. Ingen behövde någon puff.
- GPT-6.2 Sols scen ser mer realistisk ut. Opus 5.5:s version känns lite mer tecknad, vilket kostade den en poäng på hur nära scenen låg briefen.
- Varje modell fick olika halva av lampan rätt. Sols lampa känns som en 3D-ljuskägla som når in i scenen, medan Opus 5.5:s rör sig mer längs en platt 2D-vinkel. Men Opus 5.5:s tång böjer sig tydligt och responsivt bort från lampan, och Sols bortböj är svagare.
Här är Opus 5.5:s version, där stråna nära markören synligt ger vika:
Jag poängsatte båda på hur nära scenen låg briefen, shaderkvalitet, markörinteraktivitet och om effekten var en riktig shader. Shaderkvalitet och -teknik var full pott för båda; raderna där de skiljer sig:
| Mått | GPT-6.2 Sol (hög) | Claude Opus 5.5 (hög) |
|---|---|---|
| Kostnad för denna körning (USD) | $0,21 | $1,20 |
| Utgående tokens (inkl. resonemang) | 16 476 | 44 996 |
| Estetisk träffsäkerhet (primär utslagsgivare) | 5 | 4 |
| Rubrikpoäng (medel av fyra axlar) | 4,8 | 4,5 |
GPT-6.2 Sol vinner detta test knappt, på realism, vilket stämmer med OpenAIs påstående om snyggare 3D-frontender. Sol fick ljuset rätt och Opus 5.5 fick undanputtet rätt, och Sol gjorde det för ungefär en sjättedel av kostnaden.
Detta är en körning av en uppgift vid en ansträngningsnivå. Båda modellerna klarade teknikribban enkelt, så det som skiljde dem åt var smak, vilket en enda körning bara kan antyda.
När du ska välja GPT-6.2 Sol vs Claude Opus 5.5
Valet handlar om typen av arbete, längden på dina promptar och var du distribuerar.
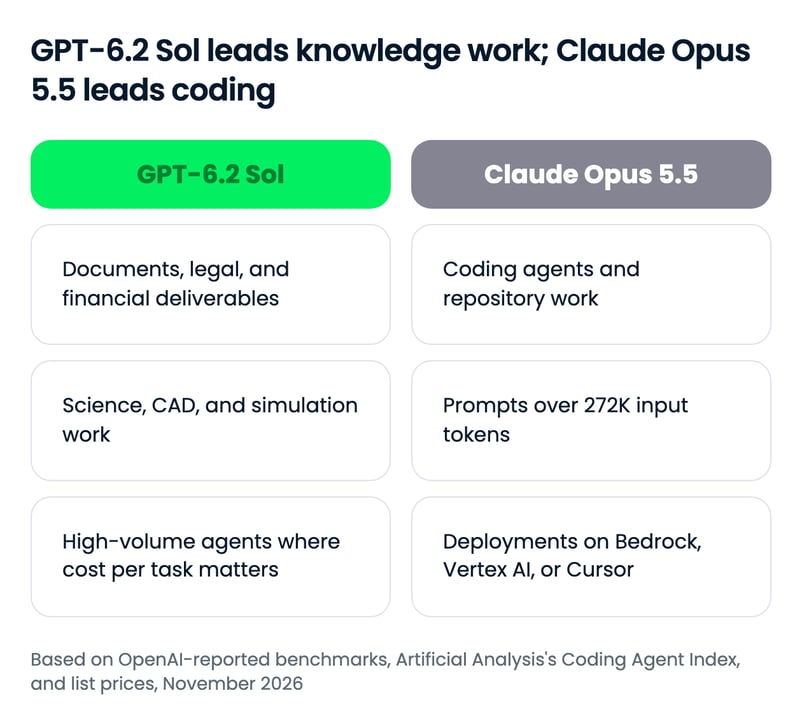
GPT-6.2 Sol bör vara din standard, och Opus 5.5 en modell du väljer av en anledning. Det enda tal som kan vända kostnadsfallet är tröskeln på 272K tokens, över vilken Sols tillägg för lång kontext gör att priset närmar sig Opus 5.5:s.
Välj GPT-6.2 Sol om...
- Du producerar professionella leverabler. Sol leder på GDPval v2 och mer än fördubblar Opus 5.5 på Harveys juridiska benchmark, så dokument, PM och juridiska utkast är dess hemmaplan.
- Du kör vetenskapligt arbete, CAD eller simulering. Den leder nu Terminal-Bench-Science och BenchCAD, två benchmarktester där GPT-6.1 Sol låg efter Opus 5.5.
- Du kör agenter i hög volym. Dess kostnad per uppgift är en bråkdel av Opus 5.5:s i varje diagram OpenAI publicerade, och i flera av OpenAIs diagram ligger den nära sitt max redan vid hög ansträngning.
- Du arbetar i Codex, GitHub Copilot eller Azure AI Foundry. GPT-6.2 Sol är redan listad på alla tre.
Välj Claude Opus 5.5 om...
- Kodningsagenter är din huvudarbetsbelastning. Opus 5.5 leder Artificial Analysis oberoende Coding Agent Index med 8 poäng, och Anthropics Terminal-Bench 4.0 och CursorBench-resultat har ännu ingen motsvarighet för GPT-6.2 Sol.
- Dina promptar passerar rutinmässigt 272K tokens. Opus 5.5 har inget tillägg för lång kontext, så promptar för hela kodbaser kostar ungefär detsamma på båda.
- Du distribuerar via Bedrock, Vertex AI eller Cursor. Opus 5.5 är listad på alla tre; GPT-6.2 Sol finns inte i Cursors dokumentation, och vi hittade ingen Bedrock- eller Vertex AI-listning för den i våra källor.
Så kommer du igång med GPT-6.2 Sol och Claude Opus 5.5
Tillgången är nästan identisk, förutom att GPT-6.2 Sol inte är tillgänglig i Cursor, eftersom OpenAI har valt att dra tillbaka sina modeller från plattformen.
| Yta | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Konsumentapp | ChatGPT Work (Plus, Pro, Enterprise, Edu) | Claude-appar |
| Förstapart-API | OpenAI API | Claude API |
| Molnplattformar | Amazon Bedrock, Google Vertex AI, Azure AI Foundry | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Kodningsagenter | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Tredjepartsroutrar | OpenRouter | OpenRouter |
| API-modell-ID | gpt-6.2-sol | claude-opus-5-5 |
API-modell-ID:na är gpt-6.2-sol och claude-opus-5-5; på OpenRouter är de openai/gpt-6.2-sol och anthropic/claude-opus-5.5.
Din första API-anrop
Det snabbaste sättet att prova båda är OpenRouter, där byte av modell är en ändring av en sträng:
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)För ett fullständigt bygge går vår API-handledning för Opus 5.5 igenom ett agentprojekt från början till slut.
Avslutande tankar
GPT-6.2 Sol bör vara förstahandsvalet framför Claude Opus 5.5. Den slår Opus 5.5 på ungefär hälften av deras gemensamma benchmarktester och kommer nära på resten till en bråkdel av kostnaden per uppgift, vilket lämnar Opus 5.5 som valet för kodningsagenter, mycket långa promptar och distributioner via Bedrock, Vertex AI eller Cursor.
Det jag tycker är mest intressant är att Sols pris aldrig ändrades: OpenAI vann denna omgång på utgående tokens. Tänk på att Opus 5.5 har varit ute i nästan två månader, vilket känns som ljusår i nuvarande takt, så jag förväntar mig att Anthropics nästa släpp konkurrerar med Sol på kvalitet och effektivitet.
Om du bygger på någon av modellerna rekommenderar jag vår kompetensväg OpenAI Fundamentals eller vår kurs Introduction to Claude Models.
Vanliga frågor
Är GPT-6.2 Sol bättre än Claude Opus 5.5?
På de flesta benchmarktester som de två delar i OpenAIs lanseringsdiagram, ja. GPT-6.2 Sol slår Opus 5.5 vid maxinsats på Agents' Last Exam, Terminal-Bench-Science, GDPval v2, Harvey LAB-AA och BenchCAD, till betydligt lägre kostnad per uppgift. Opus 5.5 behåller en tydlig ledning i agentisk kodning: den får 58 mot Sols 50 på Artificial Analysis oberoende Coding Agent Index.
Hur mycket billigare är GPT-6.2 Sol än Claude Opus 5.5?
GPT-6.2 Sols API-priser är hälften av Opus 5.5:s: $2 vs $4 per miljon input-tokens och $10 vs $20 per miljon output-tokens. Per färdig uppgift är gapet större, eftersom Sol använder färre utgående tokens. På promptar över 272K input-tokens gör Sols tillägg att de två hamnar nära samma pris.
Vad ändrades mellan GPT-6.1 Sol och GPT-6.2 Sol?
GPT-6.2 Sol behåller GPT-6.1 Sols API-priser men får högre poäng på de flesta av OpenAIs benchmarktester samtidigt som den använder färre utgående tokens. De största hoppen mot Claude Opus 5.5 är på Terminal-Bench-Science, där Sol gick från att ligga efter till att leda, och AutomationBench, där Opus 5.5:s ledning krympte till ungefär en poäng.
Var kan jag använda GPT-6.2 Sol och Claude Opus 5.5?
GPT-6.2 Sol finns i ChatGPT Work och Codex för Plus-, Pro-, Enterprise- och Edu-användare, samt i OpenAI API. Claude Opus 5.5 finns i Claude-apparna, Claude Code, Claude API och Cursor. Båda är tillgängliga på Amazon Bedrock, Google Vertex AI, Azure AI Foundry, GitHub Copilot och OpenRouter.
Vilka är API-modell-ID:na för GPT-6.2 Sol och Claude Opus 5.5?
OpenAI API:s modell-ID är gpt-6.2-sol, och Claude API:s modell-ID är claude-opus-5-5. På OpenRouter är de två modellerna openai/gpt-6.2-sol och anthropic/claude-opus-5.5, så du kan växla mellan dem genom att ändra en enda sträng i samma klientkod.

Tom är redaktör inom data science på DataCamp. Han skriver och redigerar AI-handledningar, jämför nya LLM-släpp och bygger AI-drivna arbetsflöden. Tidigare arbetade han med data science på Deutsche Telekom. Utanför jobbet förutspår han fotbollsmatcher med maskininlärning.
OpenAI har släppt GPT-6.2 Sol, vardagsnivån i GPT-6.2-familjen, till exakt samma API-priser som GPT-6.1 Sol. När vi jämförde GPT-6.1 Sol med Claude Opus 5.5 var uppdelningen tydlig: Sol för kostnad per uppgift, Opus 5.5 för högst framgångsgrad på svåra agentkörningar vid maxinsats. OpenAIs lanseringsdiagram för GPT-6.2 Sol sår tvivel om den andra halvan, och de inkluderar Opus 5.5 vid maxinsats i nästan alla.
I den här artikeln jämför jag GPT-6.2 Sol och Claude Opus 5.5 inom professionellt arbete och vetenskap, kodning, affärsautomatisering och prissättning, och kör dem sedan båda på samma praktiska shader-bygge.
Om du vill få ett fastare grepp om hur GPT-modeller fungerar och hur du skriver bra uppmaningar innan du läser jämförelsen rekommenderar jag kursen Intermediate ChatGPT, som täcker arkitekturen bakom GPT-modeller och avancerad promptskrivning. För att hänga med inom AI och data rekommenderar jag att du prenumererar på vårt veckobrev The Median.
Sammanfattning
Vad är GPT-6.2 Sol?
GPT-6.2 Sol är OpenAIs effektiva resonemangsmodell i mellanklassen, släppt i november 2026 tillsammans med GPT-6.2 Astra.
OpenAI beskriver den som sin modell för vardagsarbete, och dess försäljningsargument är effektivitet: bättre resultat än GPT-6.1 Sol på krävande uppgifter med färre utgående tokens, till oförändrade priser.
Vår guide till GPT-6.2 Astra och Sol täcker lanseringen, med hela benchmarkuppsättningen och två praktiska tester.
Vad är Claude Opus 5.5?
Claude Opus 5.5 är Anthropics modell för långvarig agentisk kodning och kunskapsarbete, släppt den 22 september 2026 som den första modellen i Claude 5.5-familjen.
Anthropic positionerar den på nivån för Claude Fable 5.1 på det mesta av arbetet, samtidigt som den kostar 40% mindre att köra än Opus 5, och dess “tänkande” kan inte längre stängas av.
Vår guide till Claude Opus 5.5 täcker lanseringen; vår API-handledning för Opus 5.5 bygger en AI-incidentutredare med den.
GPT-6.2 Sol vs Claude Opus 5.5: Direkt jämförelse
GPT-6.2 Sol leder nu Claude Opus 5.5 på de flesta gemensamma benchmarktester, och Opus 5.5 behåller små ledningar inom kodning och automatisering.
I vår jämförelse mellan GPT-6.1 Sol och Opus 5.5 ledde Opus 5.5 de flesta maxinsatsresultaten. Med GPT-6.2 Sol visar OpenAIs diagram Sol före på 5 av de 9 benchmarktester som båda modellerna finns med på, lika på 1, och mindre än 2 poäng efter på de övriga 3. Kodning är undantaget: på Artificial Analysis oberoende Coding Agent Index leder Opus 5.5 med 8 poäng.
Professionellt arbete och vetenskap
Det är här 6.1-utfallet vänder. GPT-6.1 Sol låg 6 poäng efter Opus 5.5 på Terminal-Bench-Science 0.1, som testar vetenskapligt arbete i en terminal, vid maxinsats. GPT-6.2 Sol leder nu med 68,0% mot 63,3%, till mindre än en tiondel av kostnaden per uppgift.
Resten av OpenAIs diagram för professionellt arbete pekar åt samma håll:
Agents' Last Exam, OpenAIs test av professionella arbetsflöden med lång horisont, är nära oavgjort vid maxinsats. Den mer talande punkten i det diagrammet är ansträngning: Sol på hög ansträngning ligger redan över Opus 5.5 på max, för cirka $0,69 per uppgift.
För dokument, juridiskt arbete, CAD och vetenskaplig analys är GPT-6.2 Sol nu den starkare modellen enligt tillgängliga bevis, inte bara den billigare.
Kodning
Kodning är där Opus 5.5 fortfarande tydligt leder, och de oberoende siffrorna sätter gapet klart över vad OpenAIs diagram visar. På Artificial Analysis Coding Agent Index, som kombinerar FrontierCode, Terminal-Bench 4.1 och SWE-Atlas-QnA, får Opus 5.5 i Claude Code 58 vid maxinsats, mot 50 för GPT-6.2 Sol i Codex på sin bästa inställning, xhigh.
GPT-6.2 Sol får faktiskt lägre poäng på det indexet än GPT-6.1 Sol gjorde. Artificial Analysis spår nedgången till SWE-Atlas-QnA, där den nya modellen oftare utelämnar nyckelfakta i sina svar.
OpenAIs eget FrontierCode 2.0-diagram visar ett gap på under 2 poäng vid maxinsats. Opus 5.5 kostar ungefär tio gånger så mycket per uppgift vid maxinsats på kodningsindexet (cirka $12,60 mot cirka $1,15), men för arbete i kodförråd där resultatet måste bli rätt är det den starkare modellen.
Automatisering av affärsarbetsflöden
AutomationBench, Zapiers test av agenter som kör flerstegsarbetsflöden över affärsappar, var rubriken i 6.1-jämförelsen: Opus 5.5 ledde med 6 poäng vid maxinsats. Med GPT-6.2 Sol är gapet nere på 1,4 poäng.
Sol planar också ut tidigt. Den får ungefär samma poäng från medium och uppåt, medan Opus 5.5 klättrar stadigt och går bara om Sol vid max, där varje uppgift kostar ungefär fem gånger så mycket. För en supportbot eller en sales ops-agent som kör tusentals arbetsflöden är Sol nu det självklara valet; Opus 5.5 är bara vettigt där en misslyckad körning kostar mer än prisskillnaden.
Allmänt resonemang
Opus 5.5 behåller en liten ledning på Artificial Analysis Intelligence Index, en sammansättning av 9 utvärderingar inom kunskapsarbete, kodning och vetenskap. Vid xhigh-ansträngning ligger Opus 5.5 jämsides med Sol på max, till ungefär sex gånger kostnaden per uppgift. De är lika på Vals Science Index, så allmänt resonemang är nära paritet med en svag lutning mot Anthropic.
Prissättning: vad du faktiskt betalar
GPT-6.2 Sol kostar hälften så mycket som Opus 5.5 per token och är betydligt billigare per färdig uppgift.
GPT-6.2 Sol behåller GPT-6.1 Sols priser, så tokenprisskillnaden är densamma som tidigare. Skillnaden i kostnad per uppgift är det inte, eftersom Sol nu behöver färre utgående tokens för att slutföra samma arbete. Vår egen enskilda shaderkörning, som beskrivs nedan, pekar åt samma håll, där Opus var nästan 6x så dyr som Sol ($0,21 mot $1,20).
Tokenpriser sida vid sida
GPT-6.2 Sol kostar exakt hälften av Opus 5.5 på varje standardpris, tills en prompt passerar 272K inparametrar (input tokens):
Båda modellerna debiterar resonemangstokens som output, och Opus 5.5:s tänkande kan inte stängas av, så dess outputpris är det som betyder mest.
Vad en verklig arbetsbelastning kostar
Varje totalsumma är (volym ÷ 1M) × pris, summerat över input och output, till standardpriser.
Varför samma uppgift kostar olika mycket
De två modellerna använder olika tokenizer, men den större skillnaden är hur många utgående tokens var och en spenderar. OpenAIs GDPval v2-diagram sätter Opus 5.5 på 191 241 utgående tokens per uppgift vid maxinsats mot GPT-6.2 Sols 33 428, och på 61 121 mot 12 420 vid hög ansträngning.
Detta är OpenAIs egna mätningar, men de jämför ämnena direkt. Om Opus 5.5 behövde cirka 3 gånger så många utgående tokens som Sol på den balanserade assistentarbetsbelastningen, som i vårt eget test, skulle dess månadsfaktura vara $19,00 mot Sols $4,50.
Det är därför gapen i kostnad per uppgift i sammanfattningstabellen är mycket större än den dubbla tokenprisskillnaden.
Hur GPT-6.2 Sol och Claude Opus 5.5 presterade
Alla siffror hittills kommer från OpenAIs diagram, så jag körde en bygguppgift mot båda modellerna med en identisk prompt och identiska verktyg.
Uppgiften: en enda HTML-sida med en helskärms, animerad GLSL-fragmentshader av en tångskog under vatten i skymningen, hostad av p5.js laddad från ett CDN.
Det svåra är att scenen har flera element, och markören måste ändra allihop:
Det prövar OpenAIs påstående att GPT-6.2 bygger frontender som ser ut och fungerar bättre, inklusive 3D-scener. Båda modellerna kördes i OpenCode med en fast verktygsyta (endast fil-läsning och -redigering), vid hög resonemangsansträngning, med ett försök var i en ny session och prompten levererad byte för byte.
Här är vad GPT-6.2 Sol byggde: