
主な結果は次のとおりです。
- 両者とも初回でシーンを正しく構築。 いずれも time と mouse の uniform を備えた本物の GLSL フラグメントシェーダを生成し、滑らかにアニメーションし、ひと目でわかるコンブ林を描きました。手直しは不要でした。
- GPT-6.2 Sol のシーンはより現実的。 Opus 5.5 のバージョンはややカートゥーン調に見え、その分、ブリーフへの合致度で 1 ポイント差がつきました。
- 懐中電灯の表現は、それぞれ半分ずつ得意が分かれた。 Sol の光はシーンに差し込む 3D の光錐のように感じられる一方、Opus 5.5 の光はより平面的な 2D 角度で動きます。ただし、Opus 5.5 のコンブは懐中電灯から明確かつ反応よく逃げ、Sol の「押しのけ」は弱めです。
こちらが Opus 5.5 のバージョンで、カーソル付近の茎が目に見えてよけています。
ブリーフとの一致度、シェーダ品質、カーソルのインタラクション、効果が本物のシェーダであるかを評価軸に採点しました。シェーダの品質と技法は両者満点で、差がついた行は以下のとおりです。
| Measure | GPT-6.2 Sol(high) | Claude Opus 5.5(high) |
|---|---|---|
| この実行のコスト(USD) | $0.21 | $1.20 |
| 出力トークン(推論含む) | 16,476 | 44,996 |
| 審美的一致度(主な判定基準) | 5 | 4 |
| 総合評価(4 軸の平均) | 4.8 | 4.5 |
このテストでは、リアリズムで僅差ながら GPT-6.2 Sol に軍配。OpenAI の「より見映えのする 3D フロントエンド」という主張と整合します。光は Sol、押しのけは Opus 5.5 が優れ、しかも Sol はコストが約 1/6 でした。
もっとも、これは 1 つのタスクを 1 つの努力設定で 1 回ずつ走らせた結果です。両モデルとも技術的ハードルは難なくクリアしており、差を分けたのは審美性で、単発の実行からは示唆にとどまります。
GPT-6.2 Sol と Claude Opus 5.5 を選ぶ基準
選択の決め手は、作業の種類、プロンプトの長さ、デプロイ先です。
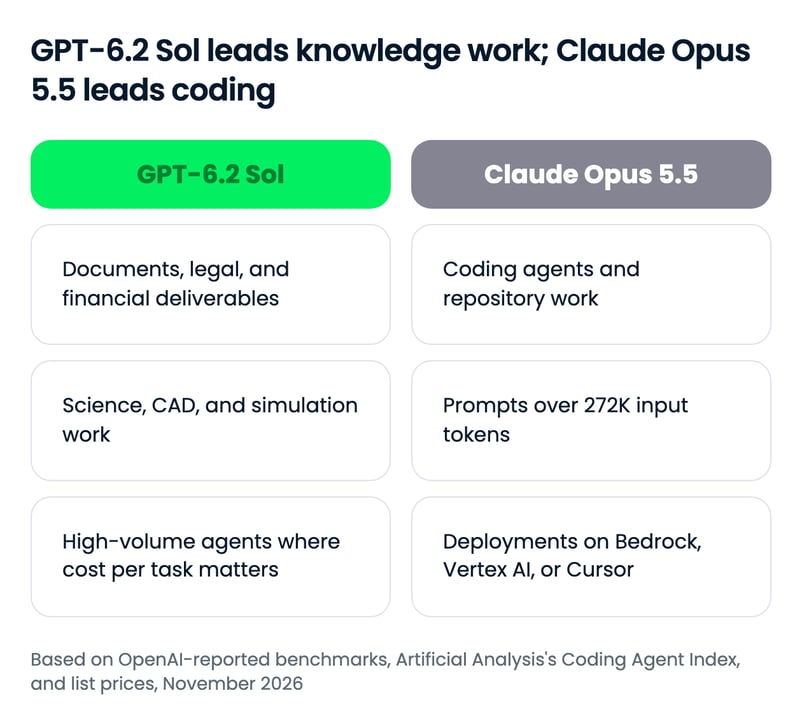
基本は GPT-6.2 Sol を標準とし、理由があるときに Opus 5.5 を選ぶのがよいでしょう。コスト面で逆転し得る唯一の数字は 272K トークンの閾値で、これを超えると Sol の追加料金で Opus 5.5 に近い価格になります。
GPT-6.2 Sol を選ぶなら…
- プロ向けの成果物を作成する。 Sol は GDPval v2 でリードし、Harvey の法務ベンチマークでは Opus 5.5 の 2 倍以上のスコアです。文書、メモ、法務ドラフトは得意領域です。
- サイエンス、CAD、シミュレーションを回す。 GPT-6.1 Sol が Opus 5.5 に劣後していた Terminal-Bench-Science と BenchCAD で、いまはリードしています。
- 高ボリュームでエージェントを運用する。 OpenAI が公開したすべてのチャートで、タスクあたりコストは Opus 5.5 の一部にとどまり、いくつかでは high の時点で max 近くのスコアに達します。
- Codex、GitHub Copilot、Azure AI Foundry を使う。 GPT-6.2 Sol はすでに 3 つすべてで利用可能です。
Claude Opus 5.5 を選ぶなら…
- 主なワークロードがコーディングエージェント。 Opus 5.5 は Artificial Analysis の独立評価 Coding Agent Index で 8 ポイントのリード。Anthropic の Terminal-Bench 4.0 と CursorBench の結果にも、GPT-6.2 Sol の対抗データは未掲載です。
- プロンプトが常時 272K トークンを超える。 Opus 5.5 には長文追加料金がないため、コードベース丸ごとのプロンプトでは両者はほぼ同価格です。
- Bedrock、Vertex AI、または Cursor でデプロイする。 Opus 5.5 は 3 つすべてで利用可能。GPT-6.2 Sol は Cursor のドキュメントに記載がなく、当方の情報源では Bedrock と Vertex AI の掲載も確認できませんでした。
GPT-6.2 Sol と Claude Opus 5.5 のはじめ方
アクセス手段はほぼ同じですが、OpenAI が自社モデルを Cursor から引き上げたため、GPT-6.2 Sol は Cursor では利用できません。
| Surface | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| コンシューマアプリ | ChatGPT Work(Plus, Pro, Enterprise, Edu) | Claude アプリ |
| ファーストパーティ API | OpenAI API | Claude API |
| クラウドプラットフォーム | Amazon Bedrock、Google Vertex AI、Azure AI Foundry | Amazon Bedrock、Google Vertex AI、Azure AI Foundry |
| コーディングエージェント | Codex、GitHub Copilot | Claude Code、Cursor、GitHub Copilot |
| サードパーティルーター | OpenRouter | OpenRouter |
| API モデル ID | gpt-6.2-sol | claude-opus-5-5 |
API モデル ID は gpt-6.2-sol と claude-opus-5-5。OpenRouter では openai/gpt-6.2-sol と anthropic/claude-opus-5.5 です。
最初の API コールを試す
最短で試すなら OpenRouter。モデルの切り替えは文字列を 1 箇所変えるだけです。
import os
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
response = client.chat.completions.create(
model="openai/gpt-6.2-sol", # swap for "anthropic/claude-opus-5.5"
messages=[{"role": "user", "content": "Summarize this incident report in five bullet points."}],
)
print(response.choices[0].message.content)本格的な構築には、Opus 5.5 API チュートリアルで、エージェントプロジェクトを最初から最後まで解説しています。
まとめ
GPT-6.2 Sol は、Claude Opus 5.5 よりも標準選択に適しています。共有ベンチマークの約半数で Opus 5.5 を上回り、残りでも僅差で、しかもタスクあたりのコストはごく一部。そのため、Opus 5.5 はコーディングエージェント、超長文プロンプト、Bedrock・Vertex AI・Cursor でのデプロイに限って選ぶのが妥当です。
特に興味深いのは、Sol の価格自体は変わっていない点です。OpenAI は出力トークンで今回の勝負に勝ちました。なお、Opus 5.5 はリリースから約 2 か月が経っており、いまの開発速度では「光年」の差にも感じられます。次の Anthropic のリリースは、品質と効率で Sol に対抗してくると見ています。
どちらのモデルでも開発するなら、OpenAI Fundamentals スキルトラックや、Introduction to Claude Models コースをおすすめします。
FAQs
GPT-6.2 Sol は Claude Opus 5.5 より優れていますか?
OpenAI のローンチチャートで両者が共有する多くのベンチマークでは、そのとおりです。GPT-6.2 Sol は、Agents' Last Exam、Terminal-Bench-Science、GDPval v2、Harvey LAB-AA、BenchCAD で最大努力時に Opus 5.5 を上回り、しかもタスクあたりのコストがはるかに低い結果でした。エージェント型コーディングでは Opus 5.5 が明確にリードを維持しており、Artificial Analysis の独立評価 Coding Agent Index では Sol の 50 に対して 58 を記録しています。
GPT-6.2 Sol は Claude Opus 5.5 よりどれくらい安いですか?
GPT-6.2 Sol の API レートは Opus 5.5 の半分で、入力 100 万トークンあたり $2(対 $4)、出力 100 万トークンあたり $10(対 $20)です。タスク完了あたりのコスト差はさらに広がり、Sol は出力トークン使用量が少ないためです。入力 272K トークンを超えるプロンプトでは、Sol の追加料金により、両者の価格は近づきます。
GPT-6.1 Sol と GPT-6.2 Sol の違いは何ですか?
GPT-6.2 Sol は GPT-6.1 Sol の API 価格を据え置きつつ、OpenAI のベンチマークの多くでスコアを伸ばし、出力トークンも削減しています。Claude Opus 5.5 に対する最大の伸びは Terminal-Bench-Science での逆転と、AutomationBench での差の縮小(約 1 ポイント)です。
GPT-6.2 Sol と Claude Opus 5.5 はどこで使えますか?
GPT-6.2 Sol は ChatGPT Work と Codex(Plus、Pro、Enterprise、Edu)、および OpenAI API で利用できます。Claude Opus 5.5 は Claude アプリ、Claude Code、Claude API、Cursor で利用可能です。両者とも Amazon Bedrock、Google Vertex AI、Azure AI Foundry、GitHub Copilot、OpenRouter で利用できます。
GPT-6.2 Sol と Claude Opus 5.5 の API モデル ID は?
OpenAI API のモデル ID は gpt-6.2-sol、Claude API のモデル ID は claude-opus-5-5 です。OpenRouter では openai/gpt-6.2-sol と anthropic/claude-opus-5.5 なので、同じクライアントコードで文字列を 1 箇所変えるだけで切り替えられます。

TomはDataCampのデータサイエンス編集者です。AIチュートリアルの執筆・編集、新しいLLMリリースの比較、AIを活用したワークフローの構築を担当しています。以前はDeutsche Telekomでデータサイエンスに携わっていました。仕事以外では、機械学習を使ってサッカーの試合結果を予測しています。
OpenAI は GPT-6.2 Sol を、GPT-6.1 Sol とまったく同じ API 価格でリリースしました。以前、GPT-6.1 Sol と Claude Opus 5.5 を比較した際には、結論は明快でした。タスクあたりのコストなら Sol、最大努力の難易度の高いエージェント実行での成功率では Opus 5.5。しかし、OpenAI の GPT-6.2 Sol のローンチチャートは後者に疑問を投げかけており、ほぼすべての項目で最大努力の Opus 5.5 を併記しています。
本記事では、プロフェッショナルワークとサイエンス、コーディング、業務自動化、価格の観点で GPT-6.2 Sol と Claude Opus 5.5 を比較し、さらに同一条件のシェーダー構築タスクで両者を実機テストします。
比較を読む前に GPT モデルの仕組みやプロンプト設計をしっかり押さえたい方には、GPT モデルのアーキテクチャと高度なプロンプト作成を扱う Intermediate ChatGPT コースをおすすめします。AI とデータ領域の最新動向を追うには、週刊ニュースレター The Median の購読もご検討ください。
要点
GPT-6.2 Sol とは?
GPT-6.2 Sol は、OpenAI の効率重視のミッドレンジ推論モデルで、2026年11月に GPT-6.2 Astra と同時リリースされました。
OpenAI は日常業務のための定番モデルと位置づけており、売りは効率性です。要求の厳しいタスクで GPT-6.1 Sol より良い結果を、より少ない出力トークンで、価格据え置きのまま実現します。
ローンチの詳細、ベンチマーク一式、2つの実機テストは GPT-6.2 Astra と Sol ガイドで解説しています。
Claude Opus 5.5 とは?
Claude Opus 5.5 は、エージェント型の長時間コーディングやナレッジワーク向けに Anthropic が提供するモデルで、Claude 5.5 ファミリーの初号として 2026年9月22日にリリースされました。
Anthropic は、ほとんどの業務で Claude Fable 5.1 と同等の水準に位置づけつつ、Opus 5 よりも 40% 安価で、思考モードはオフにできなくなったと述べています。
Claude Opus 5.5 ガイドではローンチを、Opus 5.5 API チュートリアルでは AI インシデント調査官の構築を取り上げています。
GPT-6.2 Sol vs Claude Opus 5.5:直接比較
GPT-6.2 Sol は、共有ベンチマークの多くで Claude Opus 5.5 を上回り、Opus 5.5 はコーディングと自動化で僅差のリードを保っています。
GPT-6.1 Sol vs Opus 5.5 の比較では、最大努力の結果の多くで Opus 5.5 が先行していました。GPT-6.2 Sol では、OpenAI のチャート上で両モデルが掲載されている 9 つのベンチマークのうち、Sol が 5 つで先行、1 つで同点、残り 3 つでも 2 ポイント未満の差に迫っています。例外はコーディングで、Artificial Analysis の独立評価 Coding Agent Index では Opus 5.5 が 8 ポイントのリードです。
プロフェッショナルワークとサイエンス
ここが 6.1 の結論が覆る領域です。ターミナル上での科学業務を試す Terminal-Bench-Science 0.1 では、最大努力で GPT-6.1 Sol は Opus 5.5 に 6 ポイント差で後れを取っていました。GPT-6.2 Sol はこれを逆転し、68.0% 対 63.3%、かつタスクあたりのコストは十分の一未満です。
OpenAI の他のプロフェッショナルワーク系チャートも同様の傾向を示します。
長期的なプロ業務フローを試す OpenAI の Agents' Last Exam は、最大努力ではほぼ引き分けです。同チャートで注目すべきは努力レベルで、Sol は high の時点で、約 $0.69/タスクで、max の Opus 5.5 を上回っています。
ドキュメント、法務、CAD、科学分析では、GPT-6.2 Sol は安価なだけでなく、現時点の証拠ではより強力なモデルです。
コーディング
コーディングは依然として Opus 5.5 が明確に優位で、独立評価の数値は OpenAI のチャート以上の差を示します。FrontierCode、Terminal-Bench 4.1、SWE-Atlas-QnA を統合する Artificial Analysis の Coding Agent Index では、Claude Code 上の Opus 5.5(max)が 58、Codex 上の GPT-6.2 Sol(最良設定 xhigh)は 50 です。
GPT-6.2 Sol は、このインデックスで GPT-6.1 Sol よりスコアが低下しています。Artificial Analysis はその要因を SWE-Atlas-QnA に求め、新モデルは解答から重要な事実を省きがちだと分析しています。
OpenAI の FrontierCode 2.0 チャートでは最大努力で 2 ポイント未満の差です。コーディングインデックスの最大努力では、タスクあたりのコストは Opus 5.5 が約 10 倍(約 $12.60 対 約 $1.15)ですが、リポジトリを扱い結果の正確性が最重視される場面では、より強力なのは Opus 5.5 です。
業務ワークフローの自動化
業務アプリをまたぐ多段ワークフローを実行するエージェントを評価する Zapier の AutomationBench は、6.1 比較のハイライトでした。最大努力で Opus 5.5 が 6 ポイント先行。しかし GPT-6.2 Sol では、その差は 1.4 ポイントに縮小しました。
Sol は早い段階で頭打ちになる傾向もあります。medium 以上でほぼ同じスコアなのに対し、Opus 5.5 は着実に伸び、コストが約 5 倍となる max でようやく Sol を逆転します。多数のワークフローを回すサポートボットや営業オペレーションのエージェントには、いまや Sol が明らかな選択肢で、失敗の代償が価格差を大きく上回る場面に限って Opus 5.5 を選ぶ妥当性があります。
一般的な推論
Opus 5.5 は、ナレッジワーク・コーディング・サイエンスの 9 評価を合成した Artificial Analysis Intelligence Index で小幅なリードを維持しています。xhigh の Opus 5.5 は、タスクあたりコストが約 6 倍にもかかわらず、max の Sol と同水準です。Vals Science Index では同点で、一般推論は拮抗しつつわずかに Anthropic 側に分があります。
価格:実際に支払う金額
GPT-6.2 Sol はトークン単価が Opus 5.5 の半額で、タスク完了あたりのコストはさらに安くなります。
GPT-6.2 Sol は GPT-6.1 Sol の料金を据え置いており、トークン単価の差は以前と同じです。ただしタスクあたりのコスト差は、Sol が同じ作業をより少ない出力トークンで済ませるため、さらに広がります。以下の単一シェーダー実行でも同傾向で、Opus は Sol のほぼ 6 倍のコスト($0.21 対 $1.20)でした。
トークン単価の比較
GPT-6.2 Sol は、各標準レートで Opus 5.5 のちょうど半額です(入力 272K トークンを超えるまでは):
両モデルとも推論トークンは出力として課金され、Opus 5.5 の思考モードはオフにできないため、最も重要なのは出力レートです。
実際のワークロードのコスト
各合計は(ボリューム ÷ 100万)× レートの、入力と出力の合算(標準レート)です。
同じタスクでもコストが違う理由
両モデルはトークナイザが異なりますが、より大きい違いは消費する出力トークン量です。OpenAI の GDPval v2 のチャートでは、最大努力でのタスクあたり出力トークンが Opus 5.5 は 191,241、GPT-6.2 Sol は 33,428、high でも 61,121 対 12,420 となっています。
これらは OpenAI の測定値ですが、比較対象は同一です。もしバランス型アシスタントのワークロードで Opus 5.5 が出力トークンを Sol の約 3 倍消費するなら(当方のテスト結果に近い)、月額は Sol の $4.50 に対して $19.00 となります。
このため、冒頭の表のタスクあたりコストの差は、トークン単価 2 倍の差よりはるかに大きくなります。
GPT-6.2 Sol と Claude Opus 5.5 の実力検証
ここまでの数値はすべて OpenAI のチャートに基づくため、同一プロンプト・同一ツールで 1 件のビルドタスクを両モデルに実行させました。
タスク: 夕暮れ時の海中のコンブ林を描く、ウィンドウ全体のアニメーション GLSL フラグメントシェーダを 1 枚の HTML ページに実装。p5.js は CDN から読み込み。
難しいのは、シーン内の複数要素を用意し、カーソル操作ですべてが変化することです。
これは、OpenAI の「GPT-6.2 は見た目も動作も優れたフロントエンド(3D シーン含む)を構築する」という主張の検証です。両モデルとも OpenCode 上で、ツール面は固定(ファイル読み取りと編集のみ)、推論努力は high、各 1 回の新規セッション、プロンプトはバイトレベルで同一にして実行しました。
こちらが GPT-6.2 Sol の成果です。