{count, plural, one {강의} other {강의}}
대형 언어 모델(LLM)의 개념
{hours}시간
112.2K
이번 주 Meta는 Muse Spark 이후 첫 주요 모델 계열인 Muse Wonder와 Muse Wonder Full을 공개했습니다. 둘 다 여러 단계를 거치는 작업을 처리하는 AI 에이전트를 위해 설계되었습니다.
Meta의 출시 글은 Muse Wonder가 14개월에 걸친 AI 작업 재구축의 결과라고 밝힙니다. 알아둘 두 가지 새 용어는 과거 대화에서 유용한 세부 정보를 상기하는 Active Memory와 작업이 막혀도 지속적으로 진행하는 Active Focus입니다.
일반 Muse Wonder는 Meta Model API와 Muse Code에서 사용할 수 있으며, 화제의 대부분을 차지한 결과의 기반인 Muse Wonder Full은 가장 비싼 두 가지 Muse Code 요금제에서만 실행됩니다. 이에 대해서는 뒤에서 더 다룹니다.
출시를 보고 정리한 핵심은 다음과 같습니다.
Muse Wonder와 Muse Wonder Full은 Meta가 지금까지 가장 역량이 높다고 밝힌 추론 모델로, 개인 및 업무 작업을 처리하는 에이전트를 위해 만들어졌습니다. 모델 카드에는 텍스트, 이미지, 비디오, 오디오 입력과 텍스트 전용 출력이 기재되어 있어, 두 모델 모두 이미지·비디오·오디오를 생성하지 않습니다. Meta의 개발자 문서에는 PDF 입력이 추가로 명시되어 있고, 컨텍스트 윈도는 1,048,576 토큰으로 안내됩니다.
Meta의 리서치 블로그에 따르면 두 모델은 Muse Spark의 학습 작업을 기반으로 하며 Meta의 Prometheus 데이터센터에서 학습되었습니다. 파라미터 수는 공개되지 않았습니다.
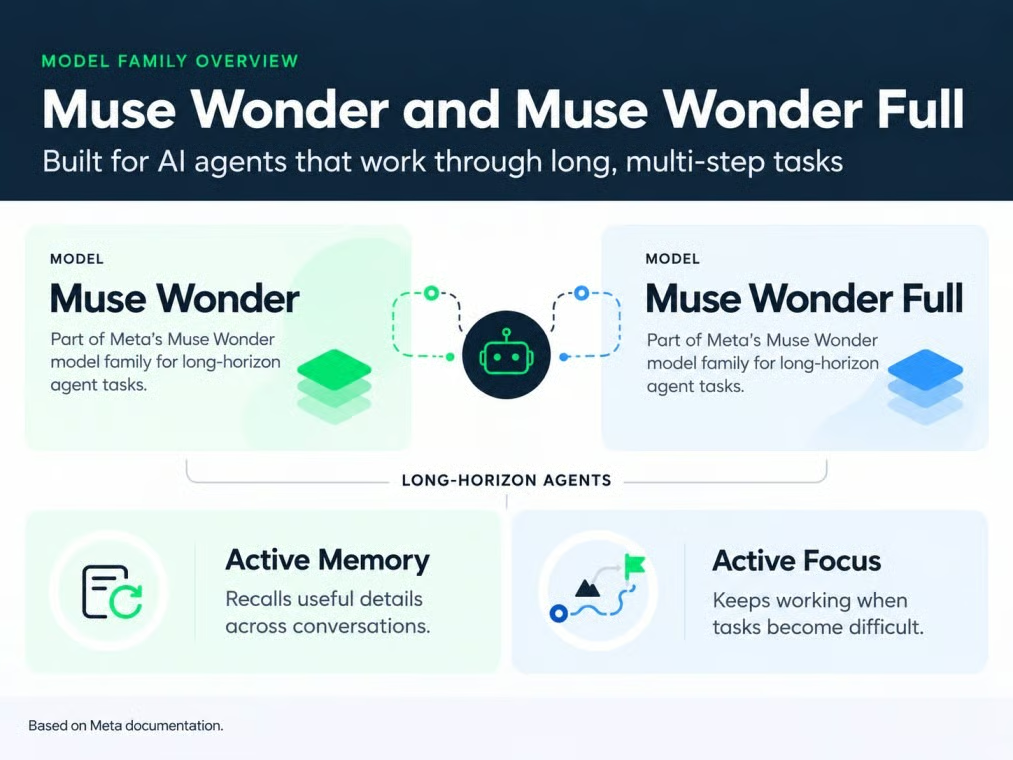
Muse Wonder는 두 가지 변형으로 제공됩니다. 이미지: 필자.
두 모델 중 Muse Wonder Full은 별도의, 더 강력한 모델입니다. 개발자 문서에 따르면 일반 Muse Wonder(muse-wonder-1.0)의 추론을 "max"로 높여도 Muse Wonder Full(muse-wonder-full-1.0)로 전환되지는 않습니다.
Meta가 Muse라는 이름을 여러 곳에 쓰고 있다는 점을 눈치채셨을 겁니다. 정리하면:
Meta가 Muse Wonder가 무언가를 "한다"고 말할 때, 종종 Muse Code가 절반을 담당합니다. 아래의 코딩 결과 대부분에 해당합니다.
Muse Wonder의 핵심 기능은 Active Memory와 Active Focus이며, Meta는 긴 코딩 작업에서 이를 강조합니다. 두 기능의 생각은 단순합니다. 에이전트는 올바른 세부 정보를 기억해야 하며, 계획이 실패해도 계속 진행해야 합니다.
Active Memory는 중요한 세부 정보를 대화 간에 유지하고 지금 필요한 것을 불러오는 능력에 대한 Meta의 용어입니다. 예를 들어 3월에 재택근무 예산을 $3,000으로 정하고, 4월에 $4,000으로 올린 뒤, 5월에 가구 후보 목록을 요청한다고 해보겠습니다. 좋은 메모리는 상기시키지 않아도 에이전트가 4월의 금액을 사용하는 것입니다.
Meta의 근거는 사실이 갱신되는 긴 대화를 테스트하는 자체 시험 MemoryBench입니다. Muse Wonder는 여기서 85.6점을 기록하지만, 이는 수개월에 걸친 회상에 대해 말해주지 않으며, API를 기반으로 구축된 앱은 여전히 그러한 사실을 자체적으로 저장해야 합니다. 오래된 예산을 기준으로 일하는 에이전트는 손해를 볼 수 있기에, 개인적으로 가장 궁금한 기능입니다.
Active Focus는 끈기, 즉 다른 접근을 시도하고, 장애물을 뚫고, 중요한 행동 전에 확인하는 것을 의미하는 Meta의 명칭입니다. 테스트 30개가 실패하는 코드 마이그레이션을 떠올려 보세요. 집중하는 에이전트는 코드를 고치고 테스트를 다시 실행하지만, 약한 에이전트는 통과하도록 테스트만 수정합니다.
Meta는 또 다른 자체 시험인 FocusBench와 SWE-Marathon으로 이를 측정합니다(벤치마크 절에서 다룹니다). 어느 것도 작업 완료를 보장하지 않으며, 백그라운드 작업은 모델 주변 소프트웨어에 좌우됩니다. 이는 항상 켜진 에이전트의 위험을 다룬 저희 OpenAI Dots 설명서에서 다룹니다.
Muse Wonder는 긴 코딩 작업을 계획하고 작업을 보조 에이전트로 분담하며, Muse Code가 도구 실행과 승인 절차를 담당합니다. Meta의 개발자 페이지는 동시에 많은 파일을 편집하며 "수 시간 동안 실행"되는 작업에 적합하다고 소개합니다.
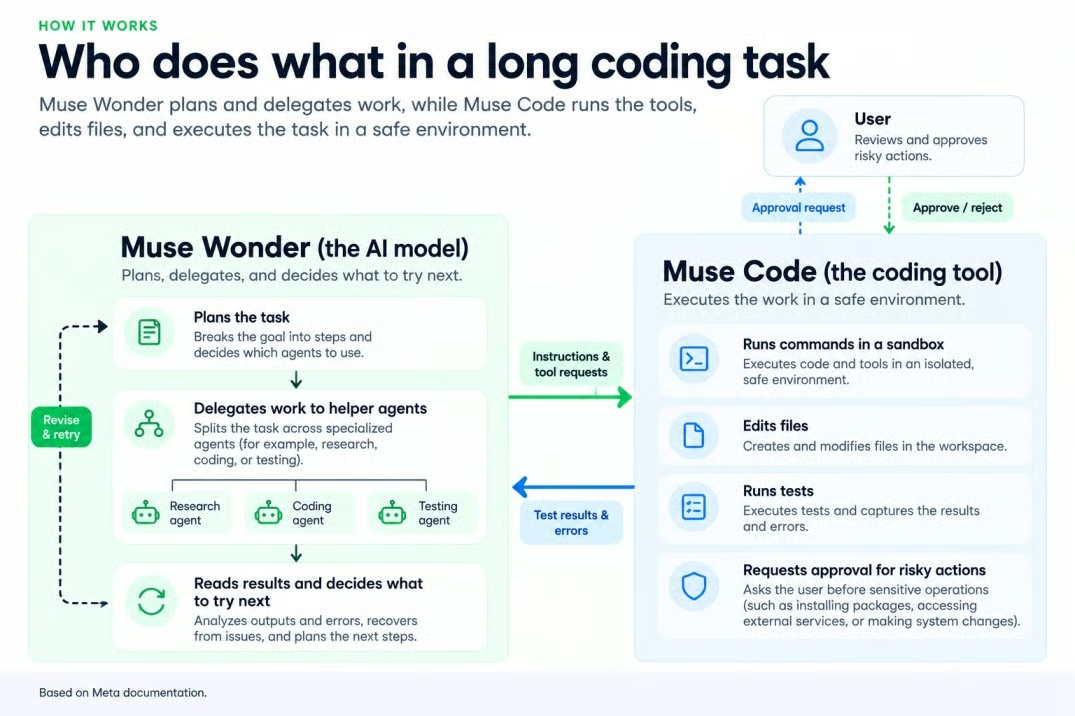
Muse Wonder는 계획하고, Muse Code는 실행합니다. 이미지: 필자.
Meta의 데모 중 하나는 이미지로부터 제작한 플레이 가능한 3D 주방 게임입니다. 모델 카드에 3D 추론이 알려진 약점으로 적혀 있어 다소 의아한 선택입니다(저라면 다른 데모를 골랐을 겁니다).
Meta의 표는 긴 코딩과 일부 전문 벤치마크에서 Muse Wonder Full에 유리하며, 터미널 코딩과 제로부터의 구축에서는 Claude Opus 5.5가 앞섭니다. 아래 수치는 별도 표기가 없는 한 Meta의 결과이며, 거의 모든 모델이 최고 추론 설정에서 평가되었습니다(예외는 표시합니다).
Meta의 표에서 Muse Wonder Full은 두 가지 긴 코딩 테스트 모두에서 1위를 차지합니다. 서두에서 말했듯이 DeepSWE v1.1에서 79.0점을 기록했고, 일반 Muse Wonder는 78.8로 근소하게 뒤를 잇습니다. 현재로서는 Datacurve의 공개 DeepSWE 리더보드에 Muse Wonder가 아직 없기 때문에 Meta의 수치를 따릅니다.
SWE-Marathon은 20개의 수시간 프로젝트 중 하나라도 테스트가 실패하면 0점을 받기에 주목할 만합니다. Meta는 Muse Wonder Full을 (최고 설정 바로 아래 단계에서) 57.5, Muse Wonder를 53.1로 보고하며, Claude Opus 5.5는 46.3, GPT-6 Astra는 42.5입니다. 경쟁 모델은 각 회사의 자체 코딩 도구에서 실행되어 완전히 공정한 비교는 아니라고 Meta 스스로 밝히며, 프로젝트가 20개뿐이라 한 프로젝트가 점수를 몇 점씩 흔들 수 있습니다.
Abundant AI의 자체 SWE-Marathon 리더보드는 보다 보수적으로 Muse Wonder Full 53.1%, 일반 Muse Wonder 52.5%(둘 다 Muse Code에서 최고 설정)로, Claude Sonnet 5.5의 51.3%를 근소하게 앞섭니다. Claude Haiku 5.5는 공개 5일 전 릴리스로 50.0%에 위치합니다. 두 목록은 서로 다른 시험이므로 혼동하지 마세요.
Muse Wonder가 앱 전반에 걸쳐 작업을 수행할 수 있다는 Meta의 주장은 엇갈린 지지를 얻습니다. 업무 워크플로가 올바른 상태로 끝나는지를 검사하는 AutomationBench-AA에서 Muse Wonder Full은 GPT-6 Astra의 41.6, Claude Opus 5.5의 41.2 대비 45.4로 앞서지만, 여전히 대부분의 워크플로를 실패합니다.
데스크톱 작업 108개로 구성된 OSWorld V2.1은 더 많은 정보를 줍니다. Muse Wonder Full은 부분 점수 78.4를 받지만 작업을 완전히 마치는 비율은 39.4%에 불과하며, 부분 점수는 두 Claude 모델이 더 높습니다. 보험 서류 같은 경우 대부분 단계를 맞춰도 완료하지 못하면 실패이므로, 지켜볼 숫자는 39.4%입니다.
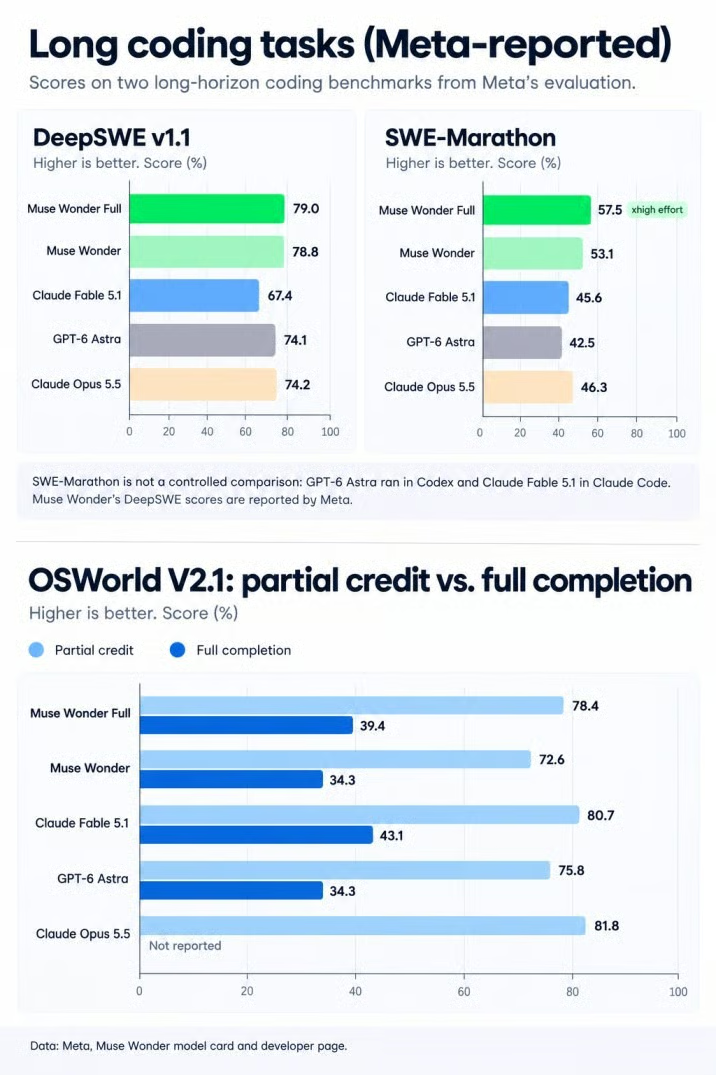
코딩 선도 성과 뒤에는 낮은 완료율이 숨겨져 있습니다. 출처: Meta; 이미지: 필자.
Muse Wonder Full은 법률 벤치마크에서 앞서고, 건강에서는 뒤처지며, 금융은 박빙입니다. 법률 점수는 작게 들리지만 Claude Opus 5.5의 세 배입니다. Artificial Analysis의 버전에서는 모든 요구 사항을 충족하며 허구 내용이 없어야 문서로 인정되며, Muse Wonder Full은 13.1, Claude Opus 5.5는 4.2를 기록합니다. 그래도 약 87% 작업은 실패한다는 뜻입니다.
금융은 거의 무승부로, Muse Wonder Full이 Vals Finance Agent V2에서 59.1, Claude Opus 5.5는 58.6입니다. 건강은 반대로 HealthBench Pro에서 Muse Wonder Full 62.3, Claude Opus 5.5 65.6, GPT-6 Astra 65.3입니다.
Meta의 자체 표에서 Muse Wonder Full은 14개의 시험 중 6개에서 Claude Opus 5.5에 뒤처졌고, GPT-6 Astra는 3개에서 이를 앞섰습니다. 아래 표는 앞에서 다루지 않은 패배 사례를 모았습니다.
|
벤치마크 |
시험 내용 |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
터미널 코딩 |
57.1 |
52.0 |
59.1 |
59.6 |
52.0 |
|
ProgramBench |
제로부터 프로그램 구축 |
59.0 |
50.0 |
52.5 |
70.5 |
55.5 |
|
AA Intelligence Index v4.3 |
광범위 복합 지수 |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
전문 도구 사용 |
75.3 |
70.5 |
66.1 |
75.4 |
73.1 |
|
GDP.pdf |
PDF에서 작업 |
33.2 |
30.8 |
34.2 |
30.6 |
27.6 |
출처: 출시 시점 Meta의 Muse Wonder 개발자 페이지. 모든 모델은 최고 추론 설정.
ProgramBench는 코더가 주목해야 할 패배이며, 격차도 작지 않습니다. 모델이 제로부터 프로그램을 재구축하도록 요구하며, 11.5포인트 차이는 기존 코드베이스를 수정하는 것과 무(無)에서 만드는 것이 다른 역량임을 보여줍니다.
Artificial Analysis는 Muse Wonder Full을 55.8로 기재하며, Meta의 표는 이를 반올림해 56으로 표기합니다. Claude Sonnet 5.5는 56.0입니다.
Muse Wonder의 벤치마크 결과를 신뢰할 수 있을까요? 완전히는 어렵습니다. Meta의 모델 카드는 표가 세 가지 유형의 근거를 섞고 있음을 보여줍니다.
앞서 언급했듯이 거의 모든 점수는 최고 추론 설정을 사용하므로 각 모델의 최적 상태를 보고 있는 것입니다. 시험자에 따라 결과도 달라집니다. 예를 들어 Anthropic은 Terminal-Bench 4.0에서 Claude Opus 5.5에 66.4%를 보고하는 반면, Meta의 표에서는 59.6입니다. Muse Wonder Full이 Spark 모델보다 익숙하지 않은 작업을 더 잘 처리한다는 Meta의 주장은 자체 분석에 기반합니다.
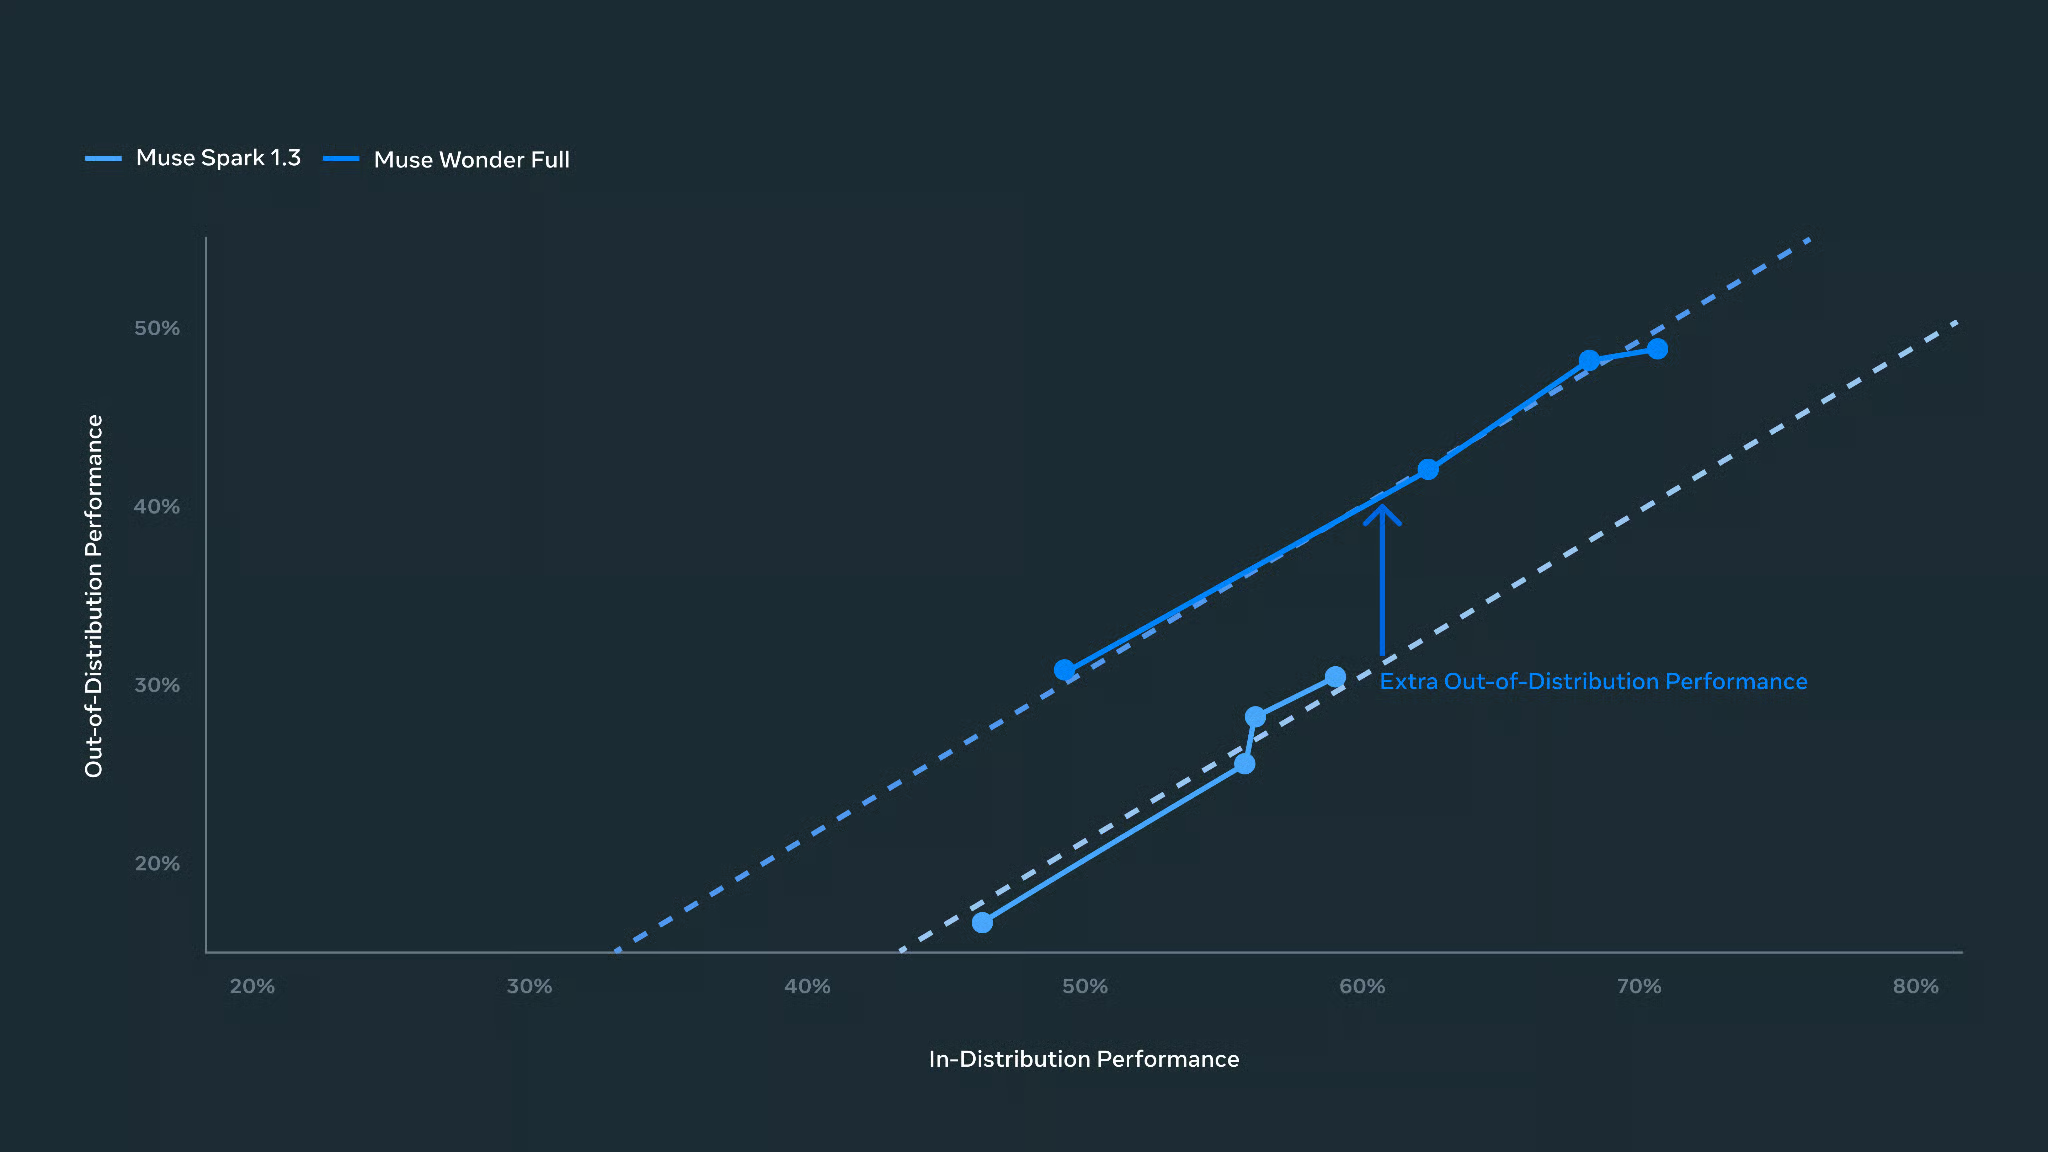
Meta는 낯선 작업에서의 성능을 비교합니다. 출처: Meta.
Meta의 수치에 따르면, Muse Wonder Full은 긴 코딩 작업에서 우승하지만(오직 Muse Code 내에서만), Claude Opus 5.5는 터미널 작업과 제로부터의 구축에서 앞서며, GPT-6 Astra는 Meta의 표에서 단 한 항목만 1위를 차지합니다. 이 절은 벤치마크를 종합하므로 익숙하게 들릴 수 있습니다.
자동화는 갈립니다. Muse Wonder Full은 AutomationBench-AA에서 앞서지만, OSWorld 부분 점수에서는 Claude 계열이 앞섭니다. 전체 완료 점수가 보고된 모델 중 대부분의 작업을 끝내는 모델은 없습니다. 광범위 추론에서는 Claude Opus 5.5가 Artificial Analysis 지수에서 선두이며, 일반 Muse Wonder는 52.4를 기록합니다.
가격에서는 일반 Muse Wonder가 다소 약해 보입니다. GPT-6.1 Sol은 토큰당 가격이 절반이고 같은 지수에서 51.8을 기록하며, Claude Sonnet 5.5의 가격도 GPT-6.1 Sol과 동일합니다.
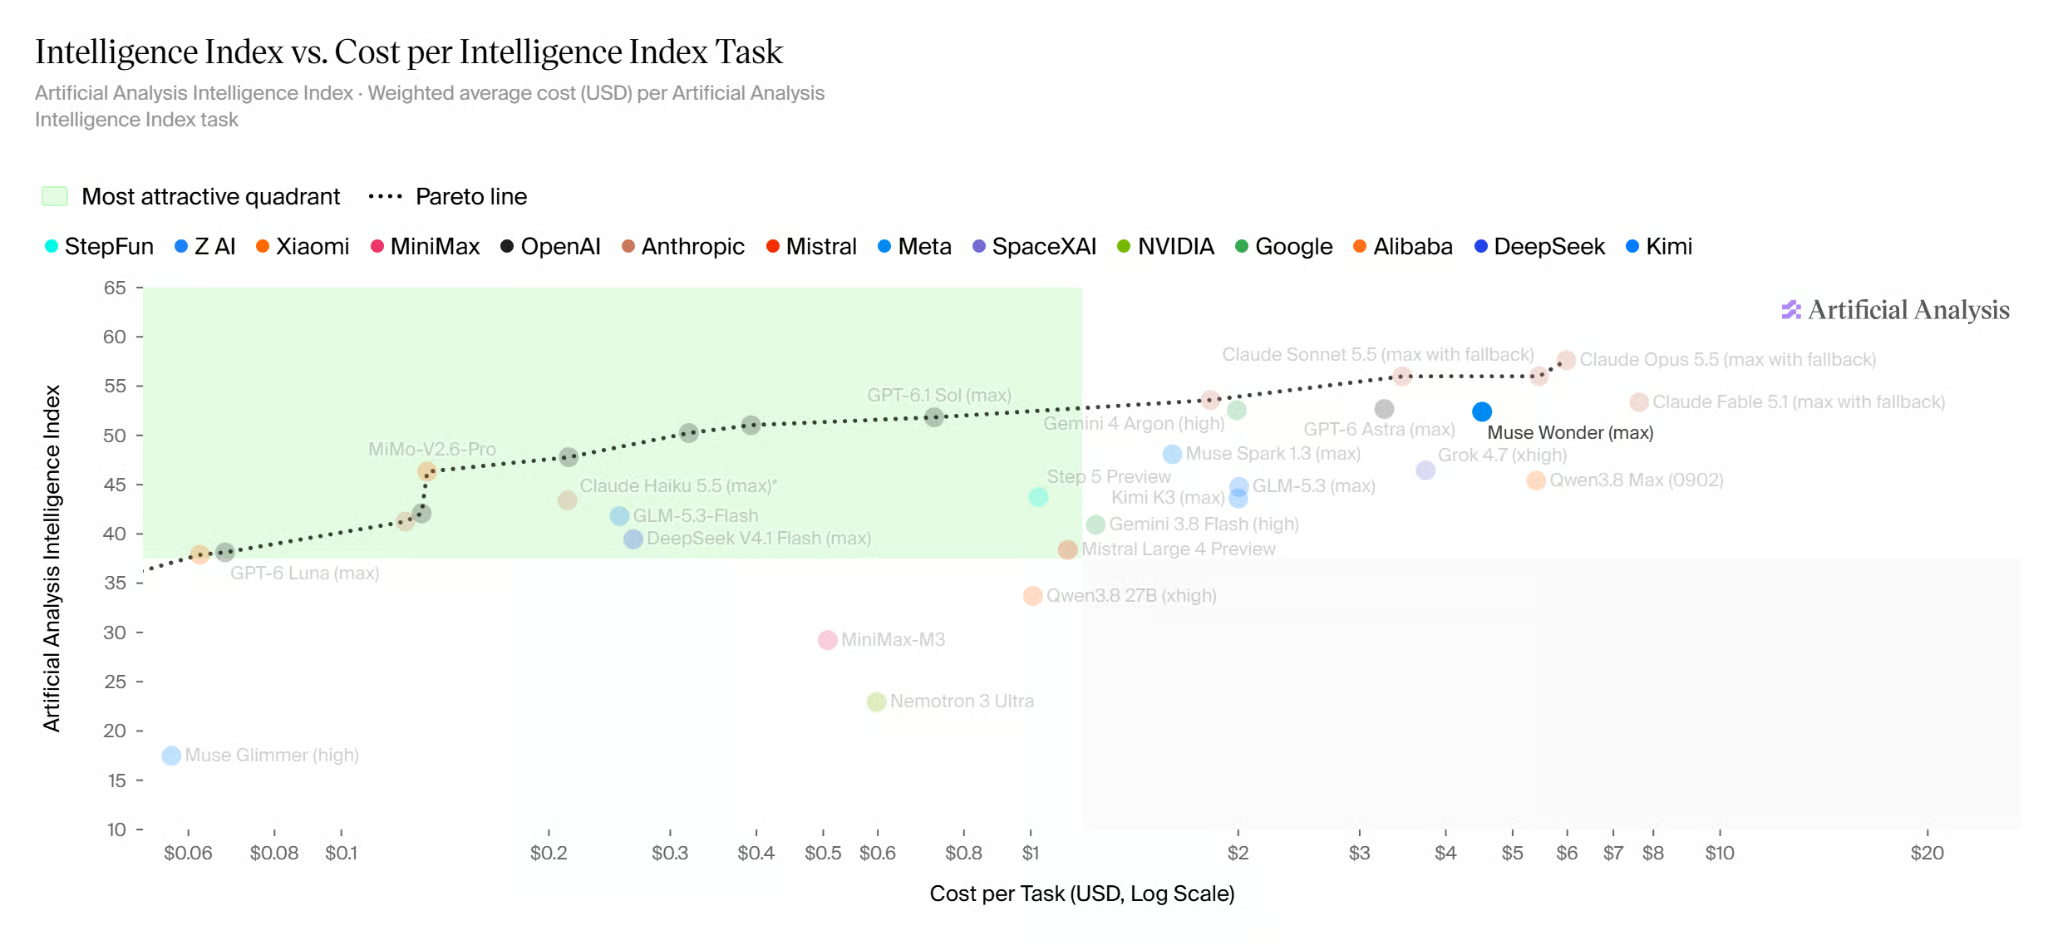
Muse Wonder는 비용과 지능을 저울질합니다. 출처: Artificial Analysis.
이 절에서 Gemini 4 Argon을 빼려다가 포함했습니다. Meta가 이를 테스트하지 않았고, 저희 Gemini 4 Argon 커버리지에서도 먼저 신뢰할 수 있는 보안 팀에 제공됐다고 언급했습니다. 공통된 결과가 없으면 공정한 일대일 비교는 어렵기에, 워크로드와 작업 완료 비용으로 선택하세요.
Muse Wonder는 두 가지 작업 유형에 가장 적합합니다. 대규모 소프트웨어 변경과 다단계 브라우저 워크플로입니다. Meta의 결혼식 좌석 배치 데모 같은 장기 계획 작업은 모델 주변의 앱에 더 좌우됩니다.
이 활용 사례는 적어도 기존 코드를 변경하는 부분에서는 근거가 가장 탄탄합니다. Muse Code에서 Muse Wonder는 파일 전반에 걸쳐 작업하고, 테스트를 실행하며, 실패를 읽고, 재시도합니다. 이는 DeepSWE와 SWE-Marathon이 측정하는 역량입니다. 실제 코드에서는 작업에 필요한 권한만 부여하고 사람이 변경 사항을 검토하세요.
Meta의 Saturday Run Planning 데모는 Muse Wonder가 "브라우저에서 직접, 앱 전반에 걸쳐 작업"하는 모습을 보여주며, 다른 데모는 보험 청구를 처리합니다. Muse Wonder Full이 데스크톱 작업을 10개 중 4개 미만만 완전히 마친다는 점을 감안하면, 실제 워크플로에서는 제출이나 결제 전에 반드시 승인이 필요합니다.
Muse Wonder 비용은 두 가지 방식으로 지불합니다. 일반 Muse Wonder는 토큰당 과금이고, Muse Wonder Full이 포함된 Muse Code는 월 정액제입니다. 서두에서 언급했듯이 Muse Wonder Full은 Muse Code로만 이용할 수 있습니다.
Meta의 요금 페이지는 일반 Muse Wonder를 입력 100만 토큰당 $4.00, 캐시된 입력 $0.20, 출력 $20.00로 기재합니다. Muse Spark 1.3의 $1.25와 $4.25에서 큰 폭으로 오른 수치이며, Claude Opus 5.5의 가격과 동일합니다. 이는 Meta가 Muse Wonder의 위치를 어떻게 보는지 시사합니다.
GPT-6 Astra는 $10, 캐시 $1, 출력 $50이며, GPT-6.1 Sol은 $2, $0.10, $10입니다. 아래 가정은 출시일 기준 가격을 1건의 코딩 작업(입력 300만 토큰, 이 중 240만 토큰 캐시, 출력 20만 토큰)에 적용한 것으로, 단일 요청이 272,000 토큰을 넘지 않는다고 가정합니다. 그 지점을 넘으면 GPT-6 Astra의 요금이 올라갑니다.
|
모델 |
비캐시 입력 (0.6M) |
캐시 입력 (2.4M) |
출력 (0.2M) |
작업당 합계 |
|
Muse Wonder |
$2.40 |
$0.48 |
$4.00 |
$6.88 |
|
Claude Opus 5.5 |
$2.40 |
$0.48 |
$4.00 |
$6.88 |
|
GPT-6 Astra |
$6.00 |
$2.40 |
$10.00 |
$18.40 |
|
GPT-6.1 Sol |
$1.20 |
$0.24 |
$2.00 |
$3.44 |
토큰 가격이 같으면 시도당 비용도 같으므로 비교해야 할 숫자는 작업 완료당 비용입니다. Muse Wonder가 두 번에 한 번 완료한다면 $13.76이며, 이는 GPT-6.1 Sol 가격의 모델이 네 번에 한 번 완료하는 비용과 같습니다(두 비율은 예시를 위한 가정).
Muse Wonder Full은 토큰 과금이 아닌 월 정액을 받는 Muse Code 요금제에서만 제공됩니다. API만 사용할 계획이라면 이 부분은 건너뛰어도 됩니다. Meta의 구독 문서에는 네 가지 요금제가 나옵니다.
Meta의 Muse Code 제품 페이지에는 Power와 Maximum의 가격만 표시되어 있어 다소 의아하니, 하위 요금제는 결제 시 확인하세요. 일반 Muse Wonder는 모든 요금제에 포함됩니다.
각 요금제는 시간이 지나면 초기화되는 사용 한도를 갖습니다. 미사용 할당량은 이월되지 않으며, 구독은 API 크레딧으로 사용할 수 없습니다.
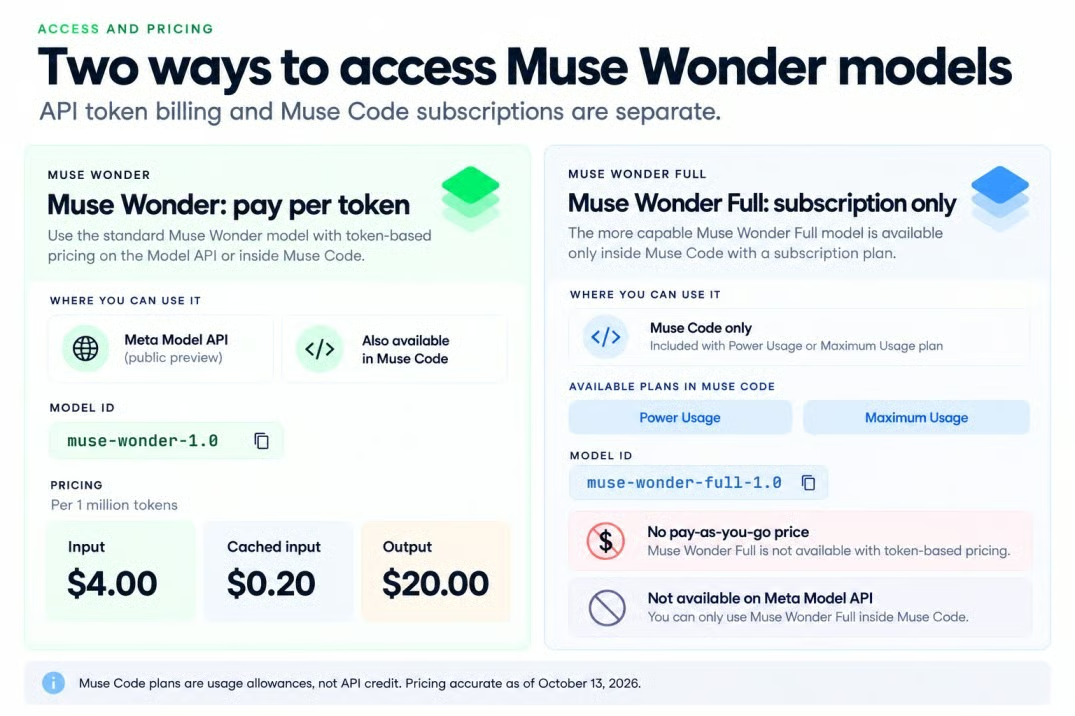
Muse Wonder 가격은 두 경로를 따릅니다. 출처: Meta; 이미지: 필자.
Power는 Muse Wonder Full을 가장 저렴하게 시험해 볼 수 있는 방법이지만, Meta는 큰 작업을 몇 건까지 처리할 수 있는지 밝히지 않았습니다. 이는 주시할 부분입니다. 초기 사용자 한 명은 소수의 작은 요청만으로도 입문 요금제의 5시간 한도의 절반 가까이를 썼다고 했는데, 이는 개발자 반응 절에서 다룹니다.
서두의 구분을 다시 정리하면: 일반 Muse Wonder는 Meta Model API와 Muse Code에서, Muse Wonder Full은 Muse Code에서만 사용할 수 있습니다.
Muse Wonder API를 사용하려면 Meta 개발자 계정, API 키, 결제가 필요하며, 모델 ID는 muse-wonder-1.0입니다. Meta는 제품 페이지에서 여전히 API를 "공개 미리보기"라고 부르며, OpenAI SDK로 구축된 코드는 엔드포인트를 바꿔 연동할 수 있고, Meta는 OpenRouter도 경로로 안내합니다.
접근은 전 세계에서 가능한 것은 아닙니다. Meta의 지리적 사용 정책은 중국, 러시아, 이란, 파키스탄, 에리트레아, 에티오피아 등을 포함한 여러 지역을 차단합니다.
Muse Wonder Full을 사용하려면 Power 또는 Maximum Muse Code 요금제, Meta 계정, 그리고 만 18세 이상 또는 거주지의 성년이어야 합니다. 가격 절에서 설명했듯이 Model API로는 어떤 가격으로도 제공되지 않으며, ID muse-wonder-full-1.0는 Muse Code 안에서만 동작합니다. Muse Code 문서에는 macOS, Linux, Windows가 기재되어 있으나, 제품 페이지에는 macOS와 Windows만 언급됩니다.
여기서의 위험은 Meta가 홍보하는 것과 같은 지점에서 나옵니다. 긴 실행과 개인 파일에 대한 접근입니다.
모델 카드는 에이전트에 영향을 줄 수 있는 세 가지 약점을 명시합니다. 각각이 다른 문제를 일으킵니다.
도구를 사용할 수 있는 모델에서는 개별 답변 품질 문제에 그치지 않습니다. 두 시간짜리 작업의 초반에 잘못 클릭하거나 잘못 가정하면 이후가 모두 망가질 수 있습니다.
모드에 따라 다르므로, Muse Code를 민감한 저장소에 연결하기 전에 반드시 읽어보세요. Meta의 서비스 약관(출시 3일 전 갱신)에 따르면 Meta는 Standard Services로 전송된 콘텐츠로 학습하지 않으며, Contributor 모드로 전송된 콘텐츠는 모델의 "학습, 개발, 평가, 개선"에 사용될 수 있습니다.
Muse Code 구독은 더 많은 사용량과 맞바꾸어 Contributor 모드에서 시작하며, 설정에서 Standard로 전환해야 합니다. 전환은 이후에만 적용되므로, 이미 전송한 내용은 계속 학습에 사용될 수 있습니다. 이 기본값은 달갑지 않습니다.
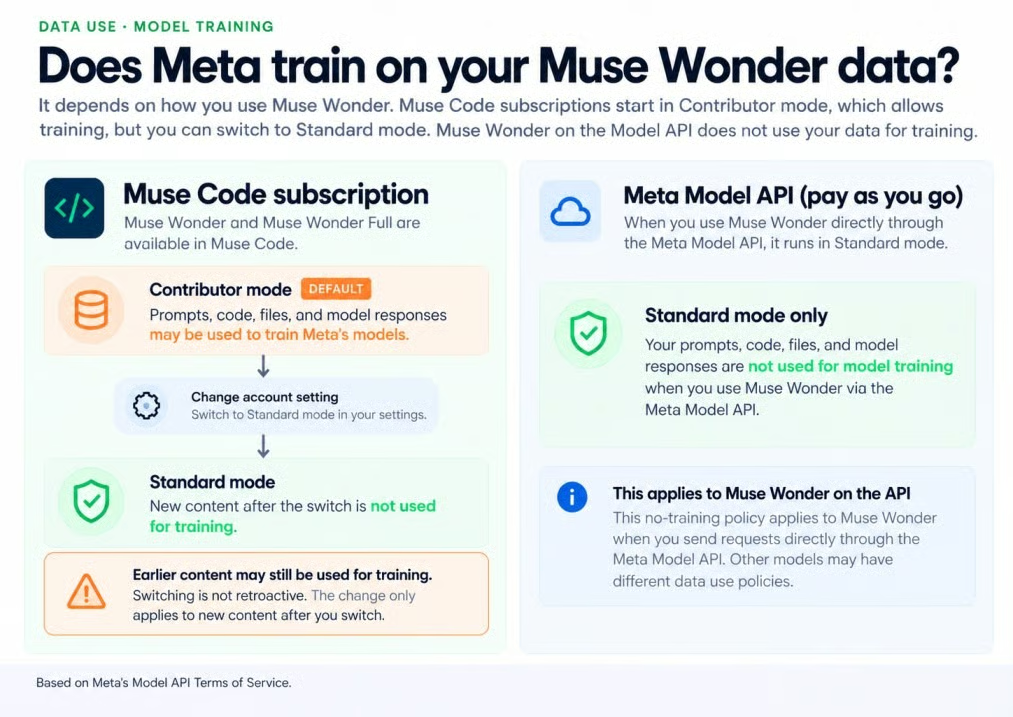
Contributor 콘텐츠는 Meta 모델 학습에 사용될 수 있습니다. 출처: Meta 약관; 이미지: 필자.
약관은 또한 Contributor 모드에서는 비공개 코드 등 민감·기밀·개인 정보를 제출해서는 안 된다고 명시합니다. 종량제 API의 일반 Muse Wonder는 Standard 모드에서만 실행됩니다.
Meta는 Muse Wonder Full을 Superintelligence Scaling Framework로 테스트했습니다. 보호 장치가 없으면 화학 및 생물학적 위협에서 고위험 수준에 도달할 가능성을 배제하지 않으며, 보호 장치를 적용하면 모든 위험 영역을 "중간 또는 그 이하"로 평가합니다.
위험 등급이 안전 보장을 의미하지는 않으며, 더 완전한 안전 보고서는 "곧" 공개될 예정입니다. 모델 카드의 조언은 단순합니다. 되돌릴 수 없는 행동에는 인간의 확인을 요구하고, 에이전트를 제한된 권한의 샌드박스에 가두세요.
출시 당일 X의 반응은 빠른 진전, 성능의 들쭉날쭉함, 사용 한도에 대한 불만으로 갈렸습니다. 이는 통제된 평가가 아닌 짧은 시험과 개인적 인상입니다.
신중한 긍정은 Muse Wonder를 제한적으로 시험한 초기 테스터에게서 나왔습니다. 핵심은 4월 Muse Spark 이후 Meta의 모델이 크게 발전했다는 점이었습니다.
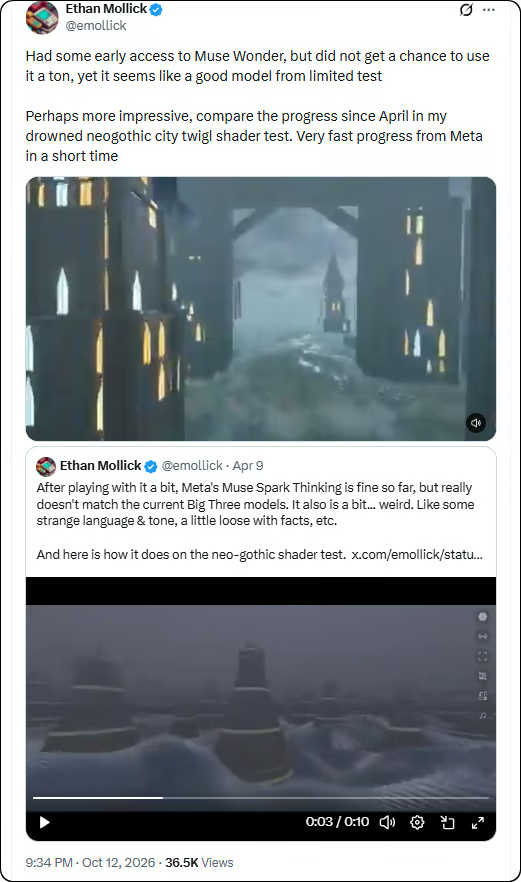
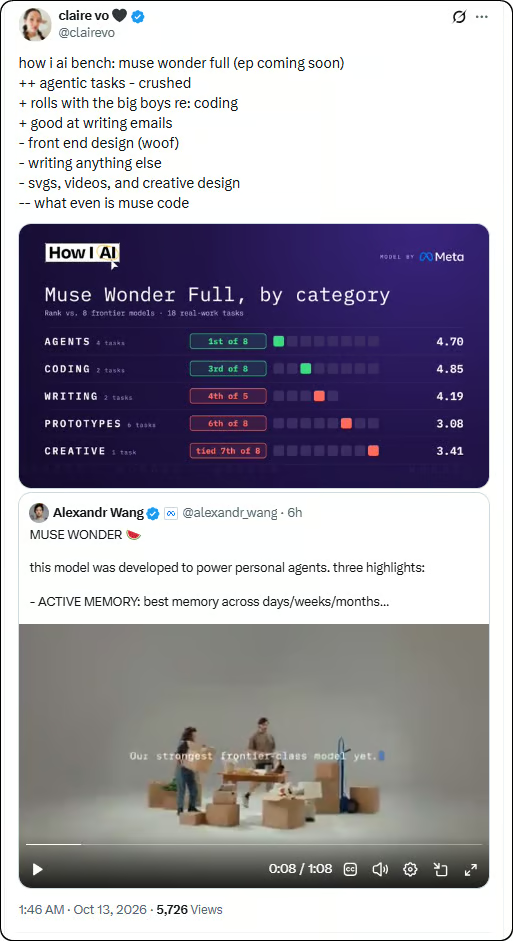
더 넓은 카테고리 테스트는 깔끔하지 않았습니다. Muse Wonder Full은 에이전트와 코딩에서 최상위권이었지만, 글쓰기·프런트엔드 디자인·창의 작업에서는 뒤처졌습니다.
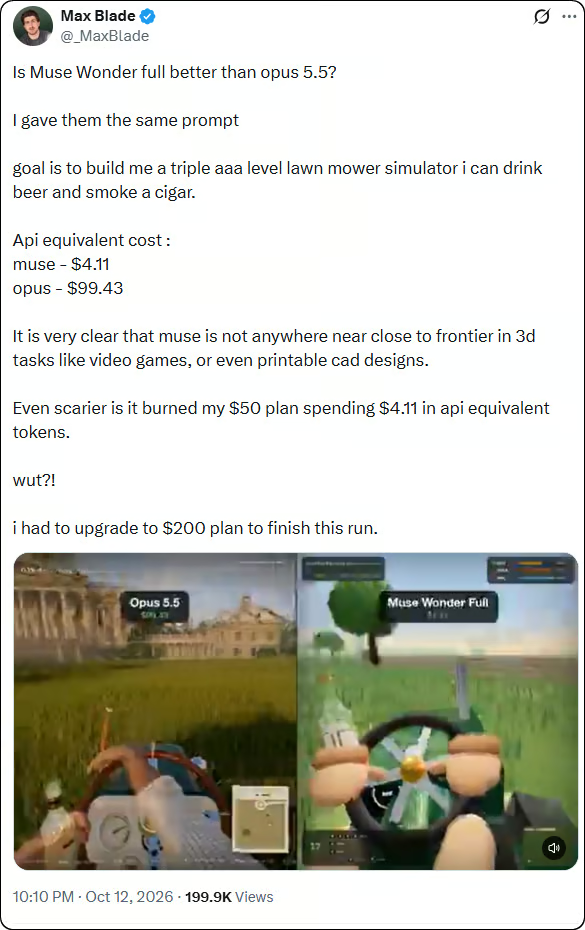
가장 날카로운 불만은 비용과 요금제 한도였습니다. 동일 프롬프트 잔디 깎는 기계 테스트에서 Muse Wonder Full은 API 환산 토큰으로 약 $4.11을 사용했지만 3D 결과는 Claude Opus 5.5보다 약했고, 완료하려면 $50 요금제에서 $200 요금제로 업그레이드해야 했다고 합니다.
종합하면, 게시물들은 Muse Wonder가 경쟁력 있지만 고르지 않음을 시사합니다. 특정 결과를 전형으로 보기 전에는 반복 시험이 더 필요합니다.
출시 근거의 대부분은 여전히 Meta에서 나옵니다. Muse Wonder Full에는 종량제 API가 없고, 일반 Muse Wonder는 Claude Opus 5.5와 같은 가격이지만 여러 테스트에서 뒤처집니다.
API 에이전트에는 일반 Muse Wonder를, 긴 저장소 작업에는 Muse Wonder Full을 테스트하겠습니다. 터미널 작업이나 제로부터의 구축에는 Claude Opus 5.5를 유지하고, 비용이 관건일 때는 GPT-6.1 Sol이나 Claude Sonnet 5.5를 쓰겠습니다.
DataCamp와 함께 학습하세요
{count, plural, one {강의} other {강의}}
{count, plural, one {강의} other {강의}}
{count, plural, one {강의} other {강의}}