{count, plural, one {Kurs} few {Kursy} many {Kursów} other {Kursów}}
Koncepcje dużych modeli językowych (LLM)
{hours} godz.
112.3K
W tym tygodniu Meta wydała Muse Wonder i Muse Wonder Full — swoją pierwszą dużą rodzinę modeli po Muse Spark. Oba są stworzone dla agentów AI, którzy realizują wieloetapowe zadania.
W poście ogłaszającym premierę Meta nazywa Muse Wonder efektem 14-miesięcznej przebudowy prac nad AI. Dwa nowe pojęcia warte poznania to Active Memory, które przypomina sobie przydatne szczegóły z wcześniejszych rozmów, oraz Active Focus, które utrzymuje pracę nad zadaniem, gdy utknie.
Zwykłe Muse Wonder jest dostępne przez Meta Model API oraz Muse Code, natomiast Muse Wonder Full — model stojący za większością „nagłówkowych” wyników — działa tylko w Muse Code na dwóch najdroższych planach. Do tego wrócimy za chwilę.
Oto moje wnioski po starcie:
Muse Wonder i Muse Wonder Full to modele rozumowania, które Meta nazywa dotychczas najzdolniejszymi, stworzone dla agentów obsługujących zadania osobiste i zawodowe. Karta modelu wymienia wejścia: tekst, obraz, wideo i audio oraz wyjście wyłącznie tekstowe, więc żaden model nie generuje obrazów, wideo ani audio. W dokumentacji dla deweloperów dodano obsługę PDF i podano okno kontekstu 1 048 576 tokenów.
Na blogu badawczym Meta pisze, że oba modele bazują na pracach szkoleniowych Muse Spark i były trenowane w centrum danych Prometheus. Nie podano liczby parametrów.
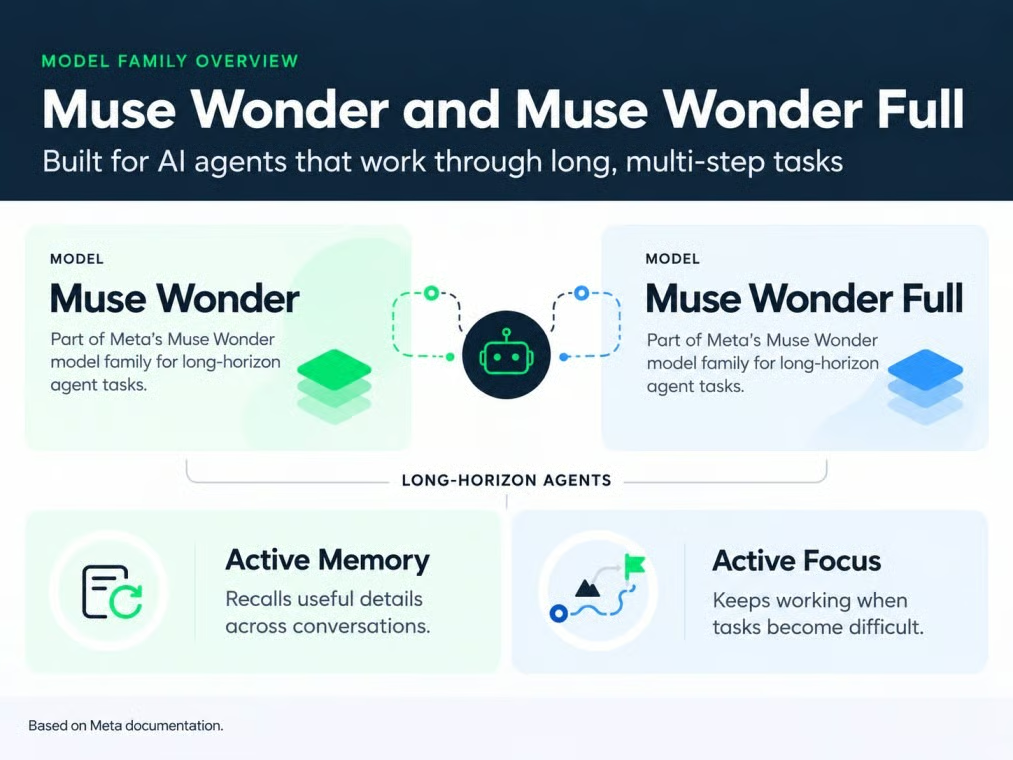
Muse Wonder występuje w dwóch wariantach. Obraz: autor.
Z tych dwóch Muse Wonder Full to odrębny, bardziej zaawansowany model. Dokumentacja dla deweloperów mówi, że podkręcenie zwykłego Muse Wonder (muse-wonder-1.0) do "max" w rozumowaniu nie przełącza go w Muse Wonder Full (muse-wonder-full-1.0).
Być może zauważyłeś, że Meta używa nazwy Muse do kilku rzeczy. Podsumowanie:
Gdy Meta mówi, że Muse Wonder coś „robi”, często połowę pracy wykonuje Muse Code. Dotyczy to większości wyników kodowania poniżej.
Najważniejsze funkcje Muse Wonder to Active Memory i Active Focus, a Meta prezentuje je na długich zadaniach programistycznych. Idea obu jest prosta: agent musi pamiętać właściwe szczegóły i iść dalej, gdy plan zawiedzie.
Active Memory to określenie Met y na przenoszenie ważnych informacji między rozmowami i wyciąganie tych, które są potrzebne teraz. Załóżmy, że w marcu ustalasz budżet na domowe biuro 3000 dolarów, w kwietniu podnosisz go do 4000, a w maju prosisz o shortlistę mebli. Dobra pamięć oznacza, że agent użyje kwietniowej kwoty bez przypominania.
Dowodem Met y jest MemoryBench — jej własny test długich rozmów, w których fakty ulegają zmianie. Muse Wonder zdobywa tam 85,6, ale to nie mówi nic o pamięci w skali miesięcy, a aplikacja zbudowana na API i tak musi sama przechowywać te fakty. To funkcja, której jestem najbardziej ciekaw, bo agent działający na starym budżecie może cię kosztować pieniądze.
Active Focus to nazwa Met y na wytrwałość: próbowanie innego podejścia, przechodzenie przez blokery i meldowanie się przed ważnymi działaniami. Wyobraź sobie migrację kodu, gdzie 30 testów pada. Skoncentrowany agent poprawia swój kod i ponownie uruchamia testy, podczas gdy słabszy po prostu edytuje testy tak, by przeszły.
Meta mierzy to FocusBenchem — kolejnym własnym testem — oraz SWE-Marathon, do którego wrócę w sekcji benchmarków. Żaden z nich nie gwarantuje ukończenia zadania, a praca w tle zależy od oprogramowania wokół modelu — ryzyko, które omawia nasze wyjaśnienie OpenAI Dots dla zawsze aktywnych agentów.
Muse Wonder planuje długie zadania kodowania i dzieli pracę między agentów pomocniczych, podczas gdy Muse Code uruchamia narzędzia i zatwierdzenia. Strona dla deweloperów Met y poleca go do zadań, które „trwają godzinami”, z wieloma plikami edytowanymi jednocześnie.
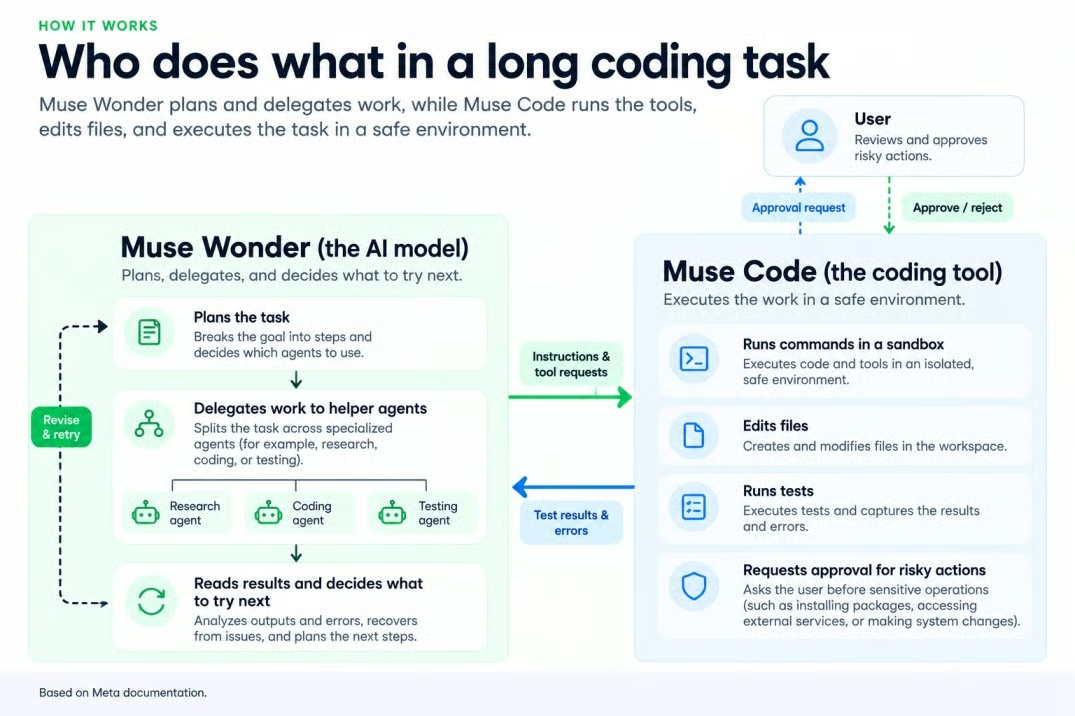
Muse Wonder planuje; Muse Code wykonuje. Obraz: autor.
Jedno z dem Met y to grywalna trójwymiarowa kuchnia zbudowana ze zdjęć. To dziwny wybór, skoro karta modelu wymienia rozumowanie 3D jako znaną słabość (wybrałbym inne demo).
Tabela Met y faworyzuje Muse Wonder Full w długim kodowaniu i części benchmarków profesjonalnych, podczas gdy Claude Opus 5.5 prowadzi w kodowaniu terminalowym i budowaniu programów od zera. Poniższe liczby pochodzą od Met y, o ile nie zaznaczono inaczej, a niemal każdy model działa na najwyższym ustawieniu rozumowania (zaznaczę jeden wyjątek).
Muse Wonder Full zajmuje pierwsze miejsce w obu długich testach kodowania w tabeli Met y. Jak wspomniałem we wstępie, ma 79,0 na DeepSWE v1.1, a zwykłe Muse Wonder jest tuż za nim z 78,8. To na razie liczby Met y, bo publiczna tabela DeepSWE Datacurve nie wymienia jeszcze Muse Wonder.
SWE-Marathon to ten, na który bym patrzył, bo jego 20 wielogodzinnych projektów dostaje zero, jeśli choć jeden test zawiedzie. Meta podaje Muse Wonder Full na poziomie 57,5 (o jeden stopień poniżej najwyższego ustawienia) i Muse Wonder 53,1, przy 46,3 dla Claude Opus 5.5 i 42,5 dla GPT-6 Astra. Modele konkurencji działały we własnych narzędziach do kodowania, więc sama Meta mówi, że porównanie nie jest w pełni fair, a przy zaledwie 20 projektach jeden projekt może przesunąć wynik o kilka punktów.
Leaderboard SWE-Marathon Abundant AI przedstawia to bardziej skromnie: Muse Wonder Full 53,1% i zwykłe Muse Wonder 52,5%, oba na najwyższym ustawieniu w Muse Code, tuż przed Claude Sonnet 5.5 z 51,3%. Claude Haiku 5.5, wypuszczony przez Anthropic pięć dni wcześniej, ma 50,0%. To dwie oddzielne listy z różnych testów, więc nie mieszaj ich.
Twierdzenie Met y, że Muse Wonder potrafi wykonywać pracę w różnych aplikacjach, ma mieszane poparcie. W AutomationBench-AA, które sprawdza, czy procesy biznesowe kończą się we właściwym stanie, Muse Wonder Full ma 45,4 wobec 41,6 dla GPT-6 Astra i 41,2 dla Claude Opus 5.5, więc prowadzi, choć wciąż nie zalicza większości workflowów.
OSWorld V2.1, zestaw 108 zadań na pulpicie, mówi więcej. Muse Wonder Full zdobywa 78,4 w punktacji częściowej, ale w pełni kończy tylko 39,4% zadań, a oba modele Claude przebijają jego wynik częściowy. W przypadku formularza ubezpieczeniowego „większość kroków dobrze” to wciąż porażka, więc 39,4% to liczba do obserwacji.
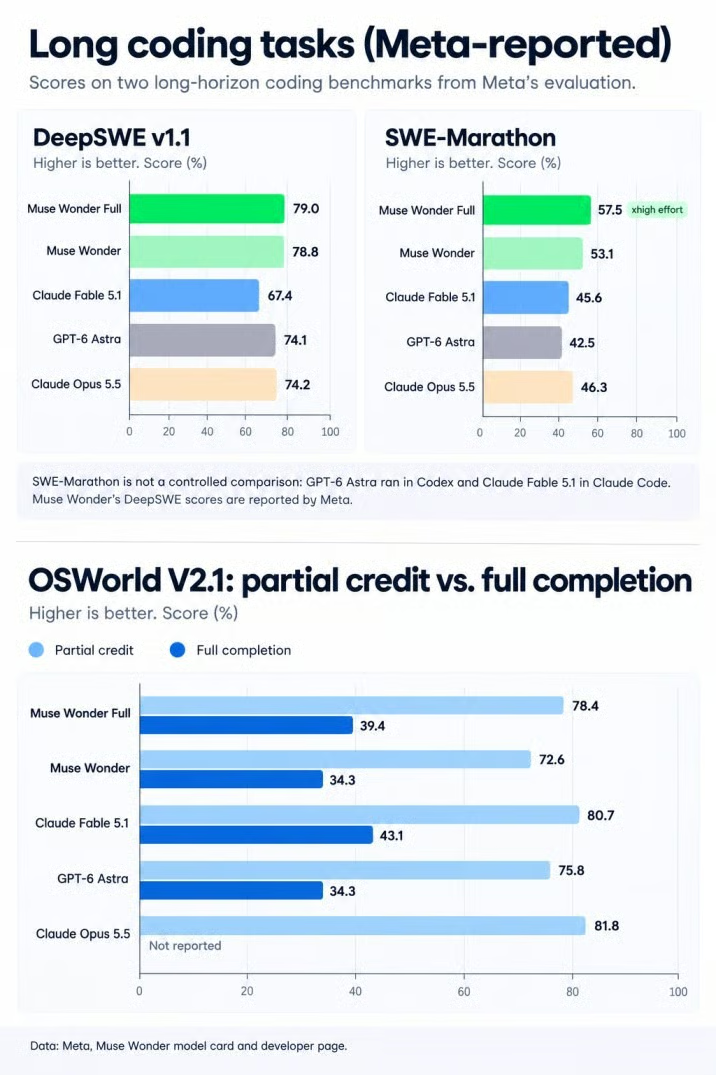
Prowadzenie w kodzie maskuje niższe wskaźniki ukończenia. Źródło: Meta; obraz: autor.
Muse Wonder Full prowadzi w benchmarku prawnym i odstaje w zdrowotnym, a finanse są niemal remisem. Wynik prawny brzmi mało, ale i tak jest trzykrotnością wyniku Claude Opus 5.5. W wersji Artificial Analysis dokument prawny liczy się tylko, jeśli spełnia wszystkie wymagania bez zmyślonych treści, a Muse Wonder Full zdobywa 13,1 wobec 4,2 dla Claude Opus 5.5, co wciąż oznacza porażkę w ok. 87% zadań.
Finanse to niemal remis: Muse Wonder Full ma 59,1 na Vals Finance Agent V2 wobec 58,6 dla Claude Opus 5.5. Zdrowie idzie w drugą stronę: Muse Wonder Full ma 62,3 na HealthBench Pro, za Claude Opus 5.5 (65,6) i GPT-6 Astra (65,3).
Muse Wonder Full przegrywa z Claude Opus 5.5 w sześciu z 14 testów w tabeli Met y, a GPT-6 Astra wygrywa trzy. Ta tabela zbiera porażki nieomówione powyżej.
|
Benchmark |
Co testuje |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Kodowanie w terminalu |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Budowanie programów od zera |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Szeroki indeks złożony |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Profesjonalną obsługę narzędzi |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Pracę na PDF-ach |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Źródło: strona deweloperska Muse Wonder w dniu premiery. Wszystkie modele na najwyższym ustawieniu rozumowania.
ProgramBench to porażka, na którą powinni zwrócić uwagę programiści — i to spora. Test polega na odbudowie programu od zera, a luka 11,5 punktu pokazuje, że edycja istniejącej bazy kodu i budowanie od niczego to różne umiejętności.
Artificial Analysis podaje dla Muse Wonder Full 55,8, co Meta zaokrągla do 56, podczas gdy Claude Sonnet 5.5 ma 56,0.
Czy można ufać wynikom benchmarków Muse Wonder? Nie w pełni. Karta modelu Met y pokazuje, że tabela miesza trzy rodzaje dowodów:
Jak wspomniałem, niemal każdy wynik używa najwyższego ustawienia rozumowania, więc widzisz każdy model w najlepszej formie. Rezultaty różnią się też w zależności od testującego: Anthropic raportuje 66,4% dla Claude Opus 5.5 na Terminal-Bench 4.0, wobec 59,6 w tabeli Met y. Twierdzenie Met y, że Muse Wonder Full lepiej radzi sobie z nieznanymi zadaniami niż modele Spark, opiera się na jej własnej analizie.
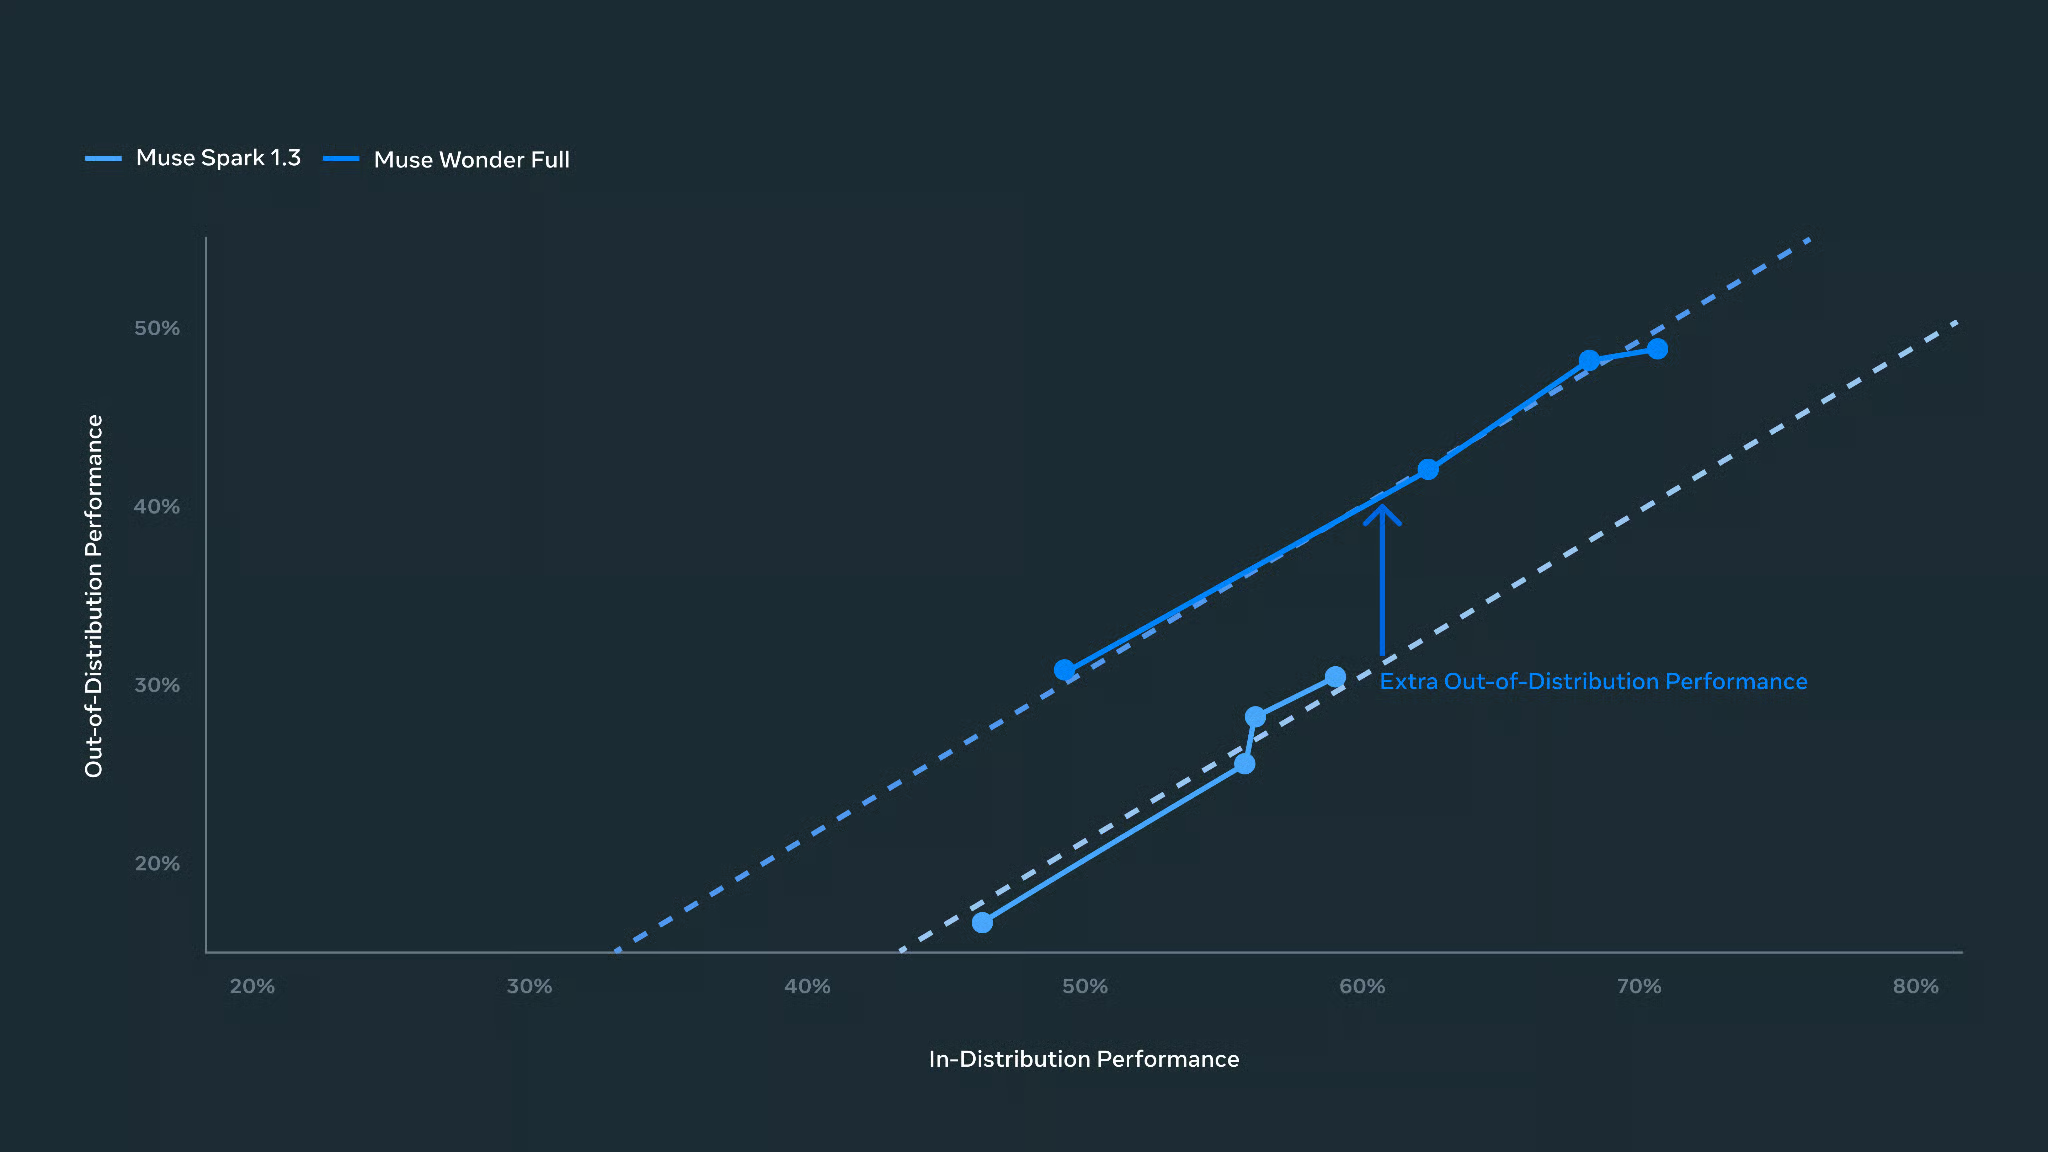
Meta porównuje wydajność na nieznanych zadaniach. Źródło: Meta.
Według liczb Met y Muse Wonder Full wygrywa długie zadania kodowania (ale tylko w Muse Code), Claude Opus 5.5 wygrywa pracę w terminalu i budowanie od zera, a GPT-6 Astra wygrywa tylko jeden wiersz w tabeli Met y. Ta część zbiera benchmarki w całość, więc może brzmieć znajomo.
Automatyzacja jest podzielona, bo Muse Wonder Full prowadzi w AutomationBench-AA, podczas gdy modele Claude prowadzą w OSWorld (częściowe punkty). Wśród modeli z raportowanym pełnym ukończeniem żaden nie kończy większości zadań. W szerokim rozumowaniu Claude Opus 5.5 prowadzi w indeksie Artificial Analysis, gdzie zwykłe Muse Wonder ma 52,4.
Cena to miejsce, gdzie zwykłe Muse Wonder wygląda słabiej. GPT-6.1 Sol kosztuje o połowę mniej za token i ma 51,8 w tym samym indeksie, a Claude Sonnet 5.5 kosztuje tyle co GPT-6.1 Sol.
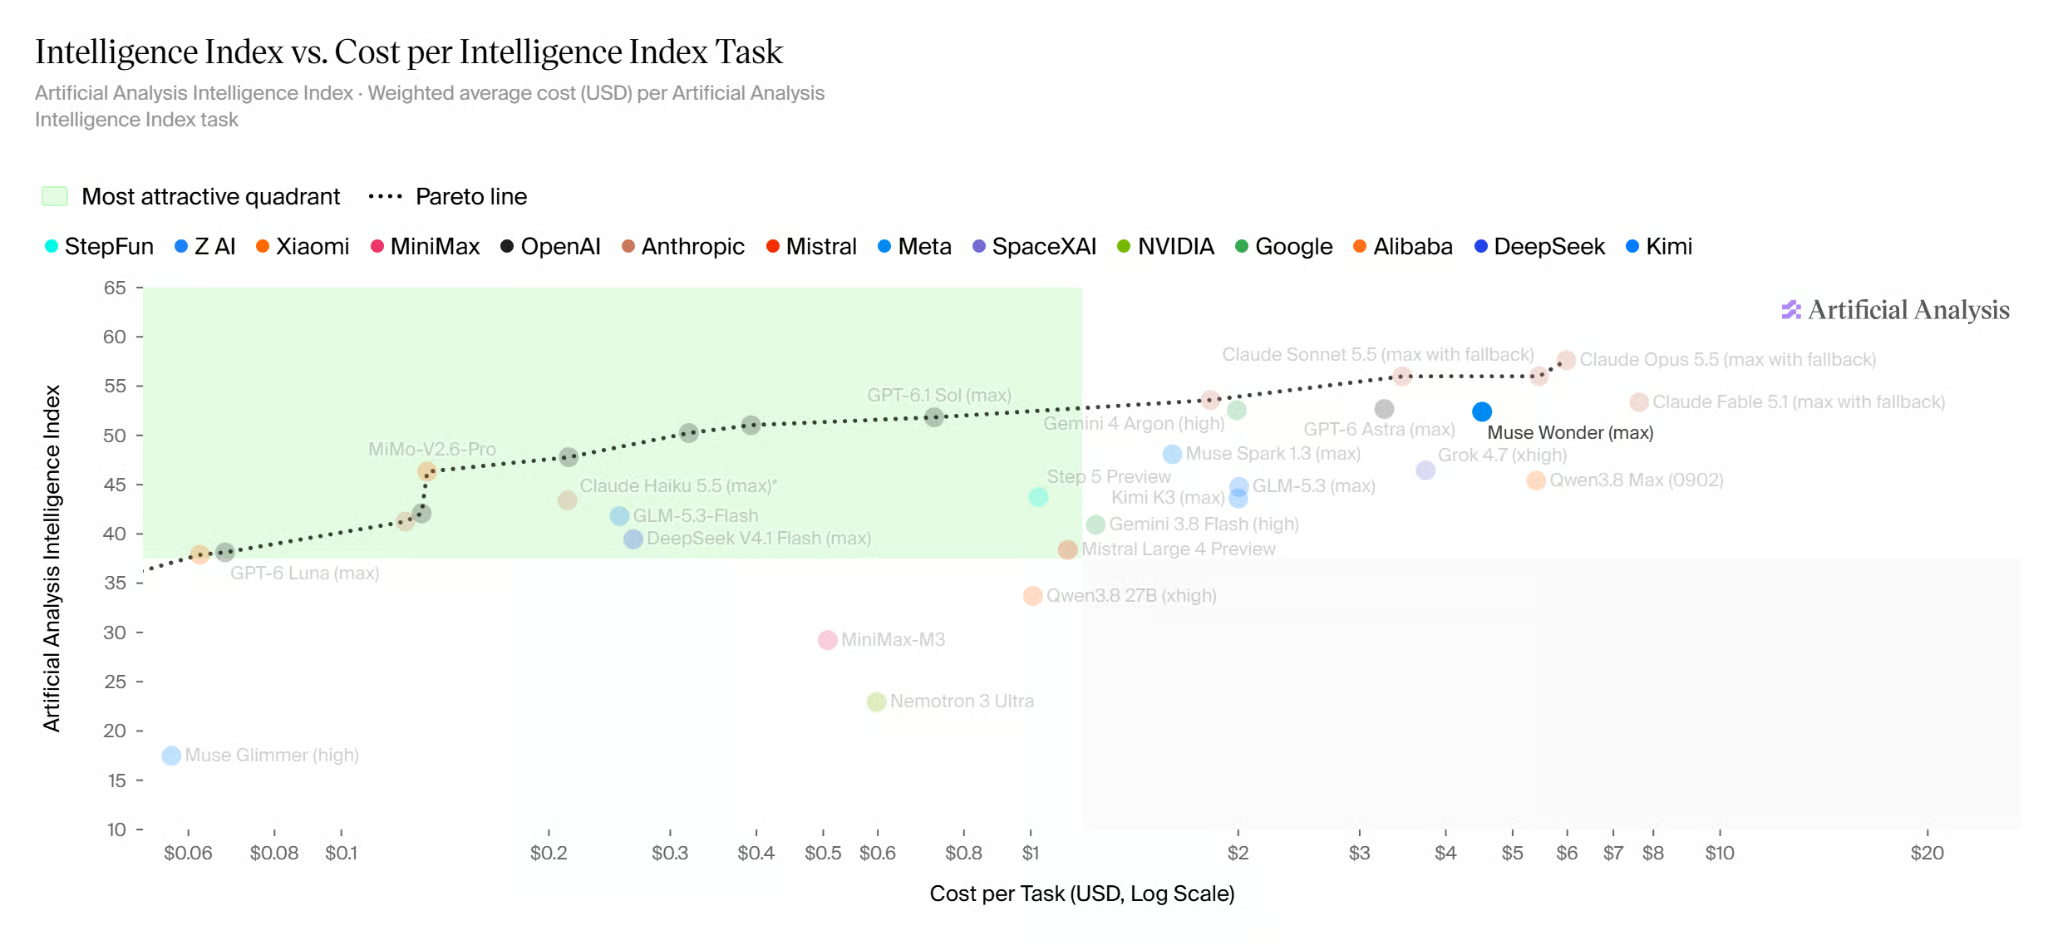
Muse Wonder wymienia koszt na inteligencję. Źródło: Artificial Analysis.
Prawie pominąłem Gemini 4 Argon w tej sekcji, bo Meta go nie testowała, a jak opisujemy w materiale o Gemini 4 Argon, najpierw trafił do zaufanych zespołów cyberbezpieczeństwa. Bez wspólnych wyników nie ma uczciwego pojedynku, więc wybieraj według typu pracy i kosztu ukończenia zadania.
Muse Wonder najlepiej pasuje do dwóch typów pracy: dużych zmian w oprogramowaniu oraz wieloetapowych workflowów w przeglądarce. Długie zadania planistyczne, jak demo z planowaniem miejsc na weselu od Met y, bardziej zależą od aplikacji wokół modelu.
To zastosowanie ma najsilniejsze dowody — przynajmniej dla zmian w istniejącym kodzie. W Muse Code Muse Wonder pracuje między plikami, uruchamia testy, czyta błędy i próbuje ponownie, co właśnie mierzą DeepSWE i SWE-Marathon. Na prawdziwym kodzie dawaj mu tylko te uprawnienia, których wymaga zadanie, a zmiany niech przegląda człowiek.
Demo Saturday Run Planning Met y pokazuje Muse Wonder „pracujące bezpośrednio w przeglądarce i między aplikacjami”, a inne demo obsługuje zgłoszenie ubezpieczeniowe. Ponieważ Muse Wonder Full w pełni kończy mniej niż 4 na 10 zadań na pulpicie, realny workflow wymaga twojej zgody przed jakimkolwiek wysłaniem lub płatnością.
Za Muse Wonder płacisz na dwa sposoby: za token w przypadku zwykłego Muse Wonder, albo stałą miesięczną opłatę za plan Muse Code, który — jak wspomniałem we wstępie — jest jedyną drogą do Muse Wonder Full.
Na stronie cen Meta zwykłe Muse Wonder kosztuje 4,00 dol. za milion tokenów wejścia, 0,20 dol. za wejście z cache i 20,00 dol. za wyjście. To duży skok względem 1,25 i 4,25 dol. w Muse Spark 1.3 i dokładnie tyle, co ceny Claude Opus 5.5, co mówi, gdzie Meta lokuje Muse Wonder.
GPT-6 Astra ma 10 dol., 1 dol. z cache i 50 dol., a GPT-6.1 Sol 2 dol., 0,10 dol. i 10 dol.. Hipotetyka poniżej stosuje te ceny z dnia premiery do jednego zadania kodowania z 3 mln tokenów wejścia (2,4 mln z cache) i 200 000 tokenów wyjścia, zakładając, że żądanie nie przekracza 272 000 tokenów, powyżej czego ceny GPT-6 Astry rosną.
|
Model |
Niecachowane wejście (0,6M) |
Cache’owane wejście (2,4M) |
Wyjście (0,2M) |
Suma za zadanie |
|
Muse Wonder |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
Claude Opus 5.5 |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
GPT-6 Astra |
$6,00 |
$2,40 |
$10,00 |
$18,40 |
|
GPT-6.1 Sol |
$1,20 |
$0,24 |
$2,00 |
$3,44 |
Równe ceny za token oznaczają równe rachunki za podejście, więc liczbą do porównania jest koszt za ukończone zadanie. Jeśli Muse Wonder kończy jedno na dwa podejścia, to $13,76 — tyle samo, co model w cenach GPT-6.1 Sol kończący jedno na cztery (obie stopy wymyślone na potrzeby przykładu).
Muse Wonder Full jest dostępne tylko w miesięcznych planach Muse Code, które pobierają stałą opłatę zamiast naliczania za token. Możesz pominąć tę część, jeśli planujesz używać tylko API. Dokumentacja subskrypcji Met y wymienia cztery plany:
Na stronie produktu Muse Code widać ceny tylko dla Power i Maximum, co dziwnie pominięto, więc sprawdź niższe plany przy kasie. Zwykłe Muse Wonder jest na każdym planie.
Każdy plan ma limit użycia odnawiany w czasie. Niewykorzystany limit nie przechodzi dalej, a subskrypcji nie można użyć jako kredytu do API.
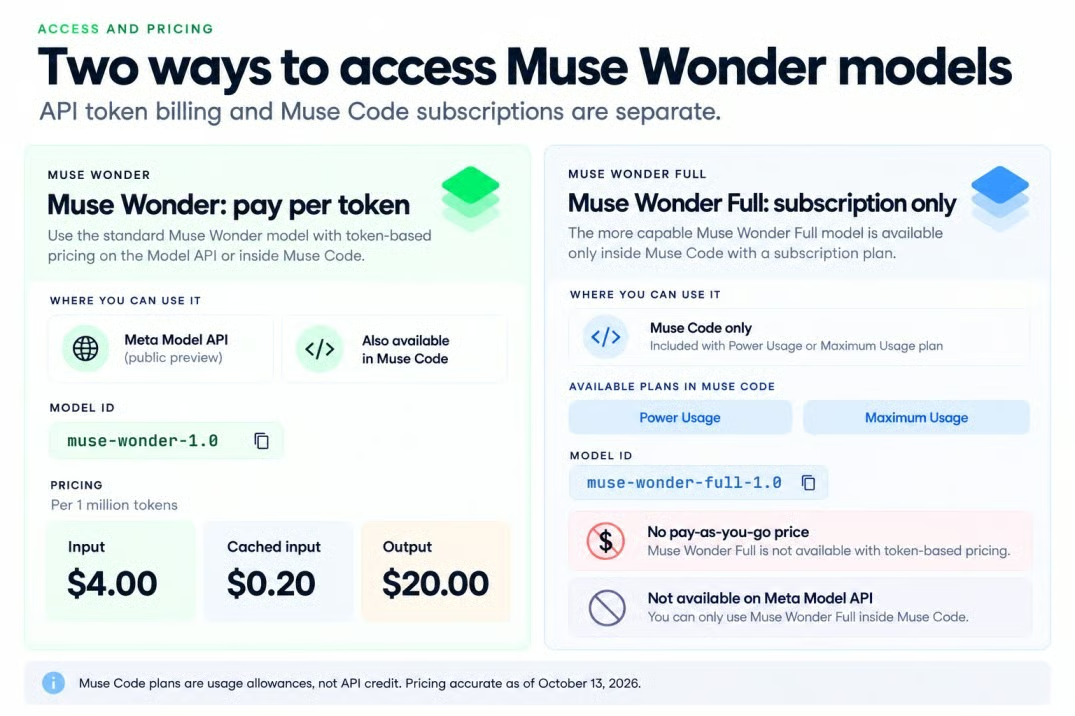
Ceny Muse Wonder biegną dwiema ścieżkami. Źródło: Meta; obraz: autor.
Power to najtańszy sposób, by spróbować Muse Wonder Full, choć Meta nie podała, ile dużych zadań obejmuje jego limit. To element, który bym obserwował, bo jeden wczesny użytkownik powiedział, że kilka małych żądań zużyło około połowy 5-godzinnego limitu planu wejściowego — do czego wrócę w reakcjach deweloperów.
Podsumowując podział ze wstępu: zwykłe Muse Wonder jest dostępne przez Meta Model API i Muse Code, a Muse Wonder Full tylko przez Muse Code.
Aby użyć API Muse Wonder, potrzebujesz konta deweloperskiego Meta, klucza API i rozliczeń, a ID modelu to muse-wonder-1.0. Meta nadal nazywa API „public preview” na stronie produktu, kod zbudowany na SDK OpenAI można na nie przekierować, a Meta wymienia też OpenRouter jako ścieżkę.
Dostęp nie jest globalny. Polityka użycia geograficznego Met y blokuje kilka miejsc, w tym Chiny, Rosję, Iran, Pakistan, Erytreę i Etiopię.
Aby uzyskać Muse Wonder Full, potrzebujesz planu Muse Code Power lub Maximum, konta Meta i mieć 18 lat lub wiek pełnoletniości w miejscu zamieszkania. Jak pisałem w sekcji cen, nie ma go w Model API za żadną cenę, a jego ID, muse-wonder-full-1.0, działa tylko w Muse Code. Dokumentacja Muse Code wymienia macOS, Linux i Windows, choć strona produktu wspomina tylko macOS i Windows.
Ryzyka wynikają tu z tych samych rzeczy, które Meta promuje: długich uruchomień i dostępu do twoich prywatnych plików.
Karta modelu wymienia trzy słabości, które mogą wpływać na agenta. Każda powoduje inny problem:
To nie są odosobnione problemy z jakością odpowiedzi, gdy model może używać narzędzi. Zły klik lub błędne założenie wcześnie w dwugodzinnym zadaniu może zepsuć resztę.
To zależy od trybu, więc przeczytaj to, zanim skierujesz Muse Code na prywatne repozytorium. Regulamin Met y, zaktualizowany trzy dni przed premierą, mówi, że Meta nie trenuje na treściach wysyłanych do Standard Services, podczas gdy treści wysyłane w trybie Contributor mogą być użyte do „trenowania, rozwijania, oceny i ulepszania” modeli.
Subskrypcje Muse Code startują w trybie Contributor w zamian za większy limit użycia i musisz przełączyć się na Standard w ustawieniach. Przełączenie działa tylko w przód, więc wszystko, co już wysłałeś, może nadal być użyte do treningu. Ten domyślny stan trudno mi polubić.
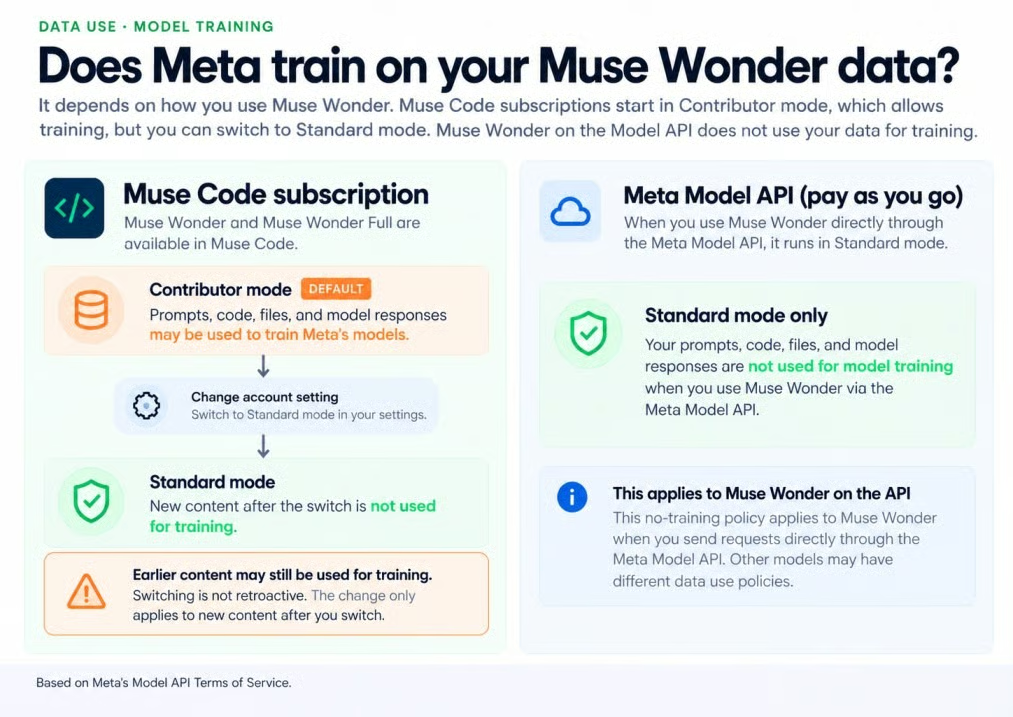
Treści w trybie Contributor mogą trenować modele Meta. Źródło: regulamin Meta; obraz: autor.
Regulamin mówi też, że „nie wolno przesyłać wrażliwych, poufnych ani osobistych informacji” w trybie Contributor, w tym prywatnego kodu. Zwykłe Muse Wonder w API pay-as-you-go działa wyłącznie w trybie Standard.
Meta testowała Muse Wonder Full w ramach Superintelligence Scaling Framework. Bez zabezpieczeń Meta nie wyklucza osiągnięcia wysokiego ryzyka w obszarach zagrożeń chemicznych i biologicznych, a z zabezpieczeniami ocenia każde ryzyko jako „umiarkowane lub niższe”.
Ocena ryzyka nie jest gwarancją bezpieczeństwa, a pełniejszy raport ma się pojawić „wkrótce”. Rada z karty modelu jest prosta: wymagaj potwierdzenia przez człowieka dla działań nieodwracalnych i trzymaj agenta w piaskownicy z ograniczonymi uprawnieniami.
Reakcje w dniu premiery na X były podzielone między szybki postęp, nierówną wydajność i frustrację limitami użycia. To krótkie testy i osobiste wrażenia, nie kontrolowane ewaluacje.
Ostrożnie pozytywny głos przyszedł od wczesnego testera, który miał mało czasu z Muse Wonder, ale uznał je za obiecujące. Większy punkt to to, jak bardzo modele Met y poszły naprzód od Muse Spark w kwietniu.
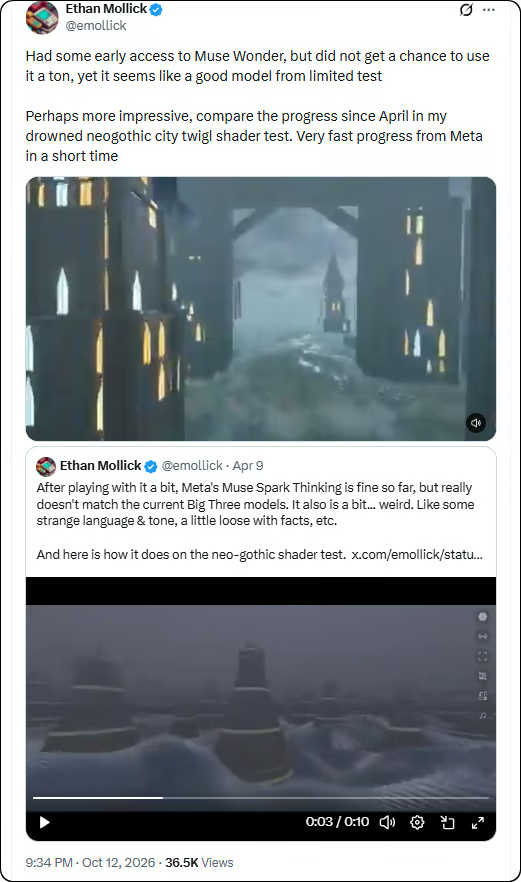
Szerszy test kategorii dał mniej schludny obraz. Muse Wonder Full był blisko czołówki dla agentów i kodowania, ale odstawał w pisaniu, projektowaniu front-endu i pracy kreatywnej.
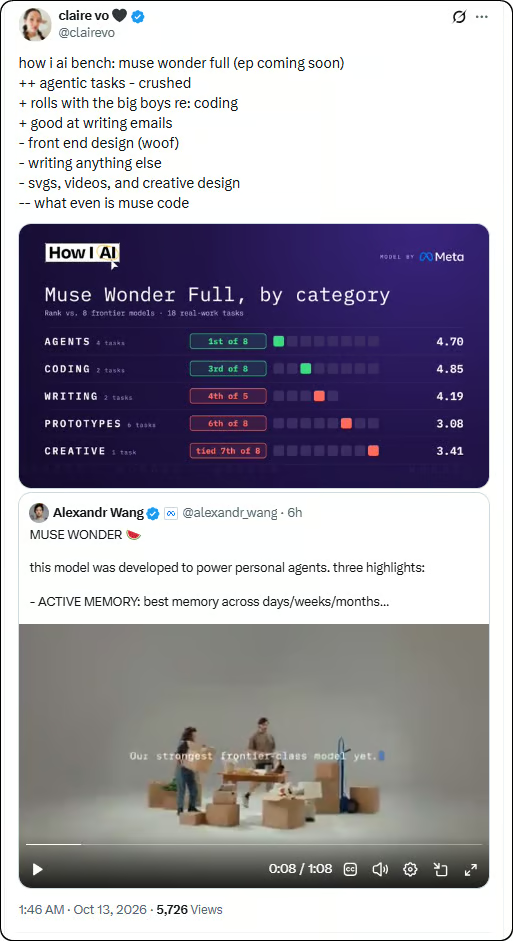
Najostrzejsza skarga dotyczyła kosztów i limitów planów. W jednym teście z kosiarką na tym samym promcie Muse Wonder Full zużył ok. 4,11 dol. w tokenach (ekwiwalent API), ale dał słabszy wynik 3D niż Claude Opus 5.5, a tester powiedział, że dokończenie wymagało przejścia z planu za 50 dol. na 200 dol.
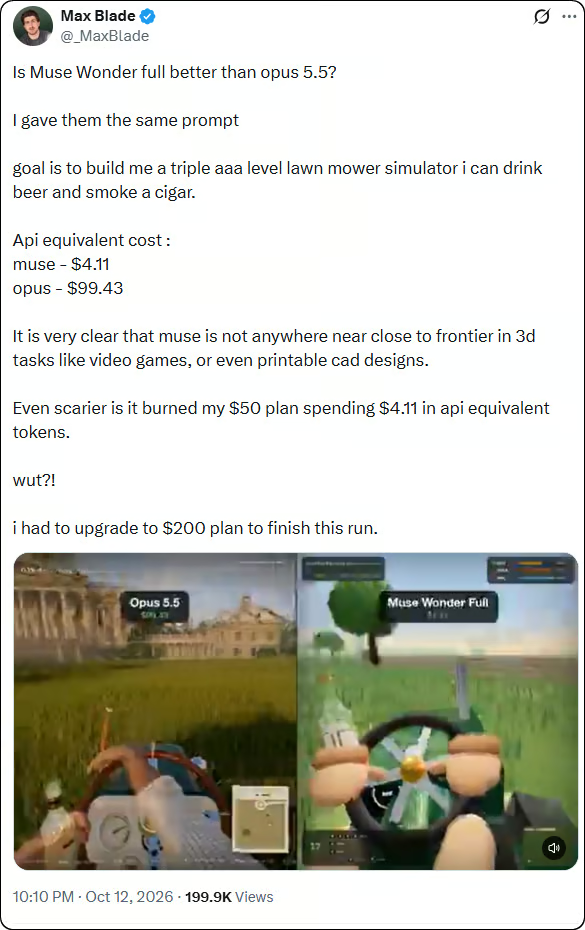
Razem posty sugerują, że Muse Wonder jest konkurencyjny, ale nierówny. Potrzeba więcej powtarzalnych testów, zanim uzna się pojedynczy wynik za typowy.
Większość dowodów z premiery pochodzi wciąż od Met y. Muse Wonder Full nie ma API w modelu pay-as-you-go, a zwykłe Muse Wonder kosztuje tyle co Claude Opus 5.5, jednocześnie odstając w kilku testach.
Testowałbym zwykłe Muse Wonder dla agentów API i Muse Wonder Full do długiej pracy na repozytoriach. Trzymałbym Claude Opus 5.5 do pracy w terminalu lub budowania programów od zera, a GPT-6.1 Sol lub Claude Sonnet 5.5 gdy decyduje koszt.
Ucz się z DataCamp
{count, plural, one {Kurs} few {Kursy} many {Kursów} other {Kursów}}
{count, plural, one {Kurs} few {Kursy} many {Kursów} other {Kursów}}
{count, plural, one {Kurs} few {Kursy} many {Kursów} other {Kursów}}