{count, plural, one {Kursus} other {Kursus}}
Konsep Large Language Models (LLM)
{hours} jam
112.2K
Minggu ini, Meta merilis Muse Wonder dan Muse Wonder Full, keluarga model besar pertamanya setelah Muse Spark. Keduanya dibuat untuk agen AI yang menangani pekerjaan bertahap multi-langkah.
Postingan peluncuran Meta menyebut Muse Wonder sebagai hasil dari pembangunan ulang pekerjaan AI selama 14 bulan. Dua istilah baru yang perlu diketahui adalah Active Memory, yang mengingat detail berguna dari percakapan sebelumnya, dan Active Focus, yang terus bekerja saat sebuah tugas terhambat.
Muse Wonder reguler tersedia melalui Meta Model API dan Muse Code, sementara Muse Wonder Full, model di balik sebagian besar hasil utama, hanya berjalan di Muse Code pada dua paket termahalnya. Kita akan membahas itu lebih lanjut nanti.
Berikut poin yang saya tangkap dari peluncuran:
Muse Wonder dan Muse Wonder Full adalah model penalaran yang disebut Meta sebagai yang paling andal sejauh ini, dibuat untuk agen yang menangani tugas pribadi dan kerja. Kartu model mencantumkan masukan teks, gambar, video, dan audio serta keluaran hanya teks, jadi tidak ada model yang menghasilkan gambar, video, atau audio. Dokumen pengembang Meta menambahkan masukan PDF dan menetapkan jendela konteks sebesar 1.048.576 token.
Blog riset Meta menyatakan keduanya dibangun di atas pekerjaan pelatihan Muse Spark dan dilatih di pusat data Prometheus milik Meta. Tidak ada jumlah parameter yang diungkap.
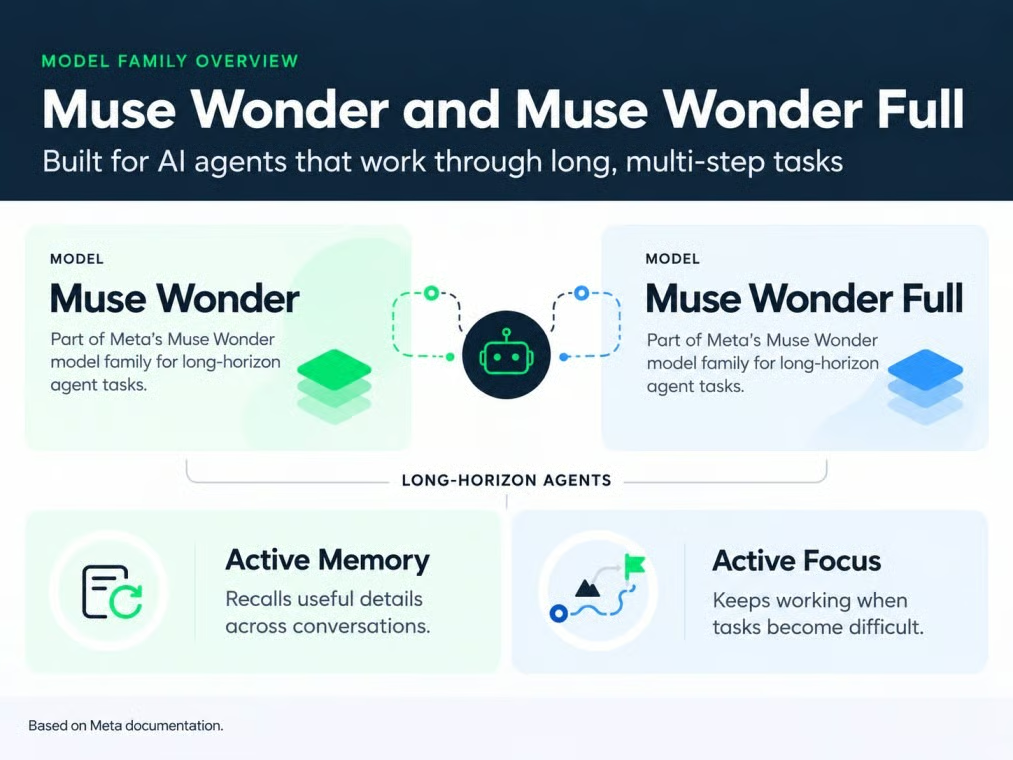
Muse Wonder hadir dalam dua varian. Gambar oleh Penulis.
Dari keduanya, Muse Wonder Full adalah model terpisah yang lebih andal. Dokumen pengembang menyatakan menaikkan penalaran Muse Wonder reguler (muse-wonder-1.0) ke "max" tidak mengalihkannya ke Muse Wonder Full (muse-wonder-full-1.0).
Anda mungkin menyadari Meta menggunakan nama Muse untuk beberapa hal. Ringkasannya:
Saat Meta mengatakan Muse Wonder "melakukan" sesuatu, sering kali Muse Code yang menangani setengah pekerjaannya. Itu berlaku untuk sebagian besar hasil pengodean di bawah ini.
Fitur utama Muse Wonder adalah Active Memory dan Active Focus, dan pekerjaan pengodean panjang menjadi tempat Meta memamerkannya. Gagasan di balik keduanya sederhana: sebuah agen harus mengingat detail yang tepat dan terus maju saat rencana gagal.
Active Memory adalah istilah Meta untuk membawa detail penting lintas percakapan dan memanggil yang dibutuhkan saat ini. Misalnya Anda menetapkan anggaran kantor-rumah $3.000 pada Maret, menaikkannya menjadi $4.000 pada April, dan meminta daftar singkat furnitur pada Mei. Ingatan yang baik berarti agen menggunakan angka April tanpa pengingat.
Bukti Meta adalah MemoryBench, ujiannya sendiri atas percakapan panjang di mana fakta diperbarui. Muse Wonder mencetak 85,6 di sana, tetapi itu tidak mengatakan apa pun tentang daya ingat selama berbulan-bulan, dan aplikasi yang dibangun di atas API tetap harus menyimpan fakta-fakta tersebut sendiri. Ini fitur yang paling membuat saya penasaran, karena agen yang bekerja berdasarkan anggaran lama bisa merugikan Anda.
Active Focus adalah istilah Meta untuk kegigihan: mencoba pendekatan lain, menembus penghalang, dan meminta konfirmasi sebelum tindakan penting. Bayangkan migrasi kode di mana 30 pengujian gagal. Agen yang fokus memperbaiki kodenya dan menjalankan ulang pengujian, sementara yang lebih lemah hanya mengedit pengujiannya agar lolos.
Meta mengukurnya dengan FocusBench, satu lagi ujiannya sendiri, dan dengan SWE-Marathon, yang akan saya bahas di bagian tolok ukur. Keduanya tidak menjamin tugas selesai, dan kerja di latar bergantung pada perangkat lunak di sekitar model, sebuah risiko yang dibahas dalam penjelasan OpenAI Dots kami untuk agen yang selalu aktif.
Muse Wonder merencanakan pekerjaan pengodean panjang dan membagi pekerjaan ke agen pembantu, sementara Muse Code menjalankan alat dan persetujuan. Halaman pengembang Meta memasarkannya untuk tugas yang "berjalan berjam-jam," dengan banyak file diedit sekaligus.
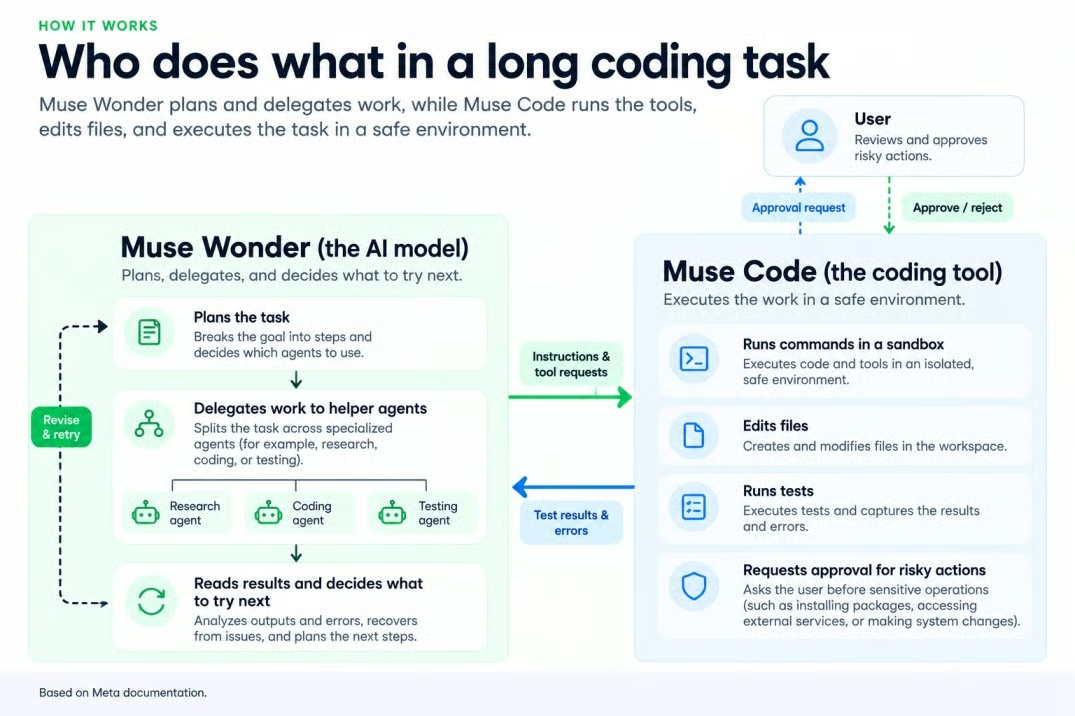
Muse Wonder merencanakan; Muse Code mengeksekusi. Gambar oleh Penulis.
Salah satu demo Meta adalah gim dapur 3D yang dapat dimainkan dan dibangun dari gambar. Ini pilihan yang aneh, karena kartu model mencantumkan penalaran 3D sebagai kelemahan yang diketahui (saya akan memilih demo lain).
Tabel Meta mengunggulkan Muse Wonder Full pada pengodean panjang dan beberapa tolok ukur profesional, sementara Claude Opus 5.5 memimpin dalam pengodean terminal dan membangun program dari nol. Angka-angka di bawah ini berasal dari Meta kecuali disebutkan, dengan hampir setiap model pada pengaturan penalaran tertinggi (saya akan menandai satu pengecualian).
Muse Wonder Full berada di puncak kedua uji pengodean panjang di tabel Meta. Seperti saya sebutkan di pengantar, model ini meraih 79,0 pada DeepSWE v1.1, dengan Muse Wonder reguler tak jauh di belakang pada 78,8. Itu adalah angka dari Meta untuk saat ini, karena papan peringkat DeepSWE publik Datacurve belum mencantumkan Muse Wonder.
SWE-Marathon yang patut dipantau, karena 20 proyek multi-jamnya bernilai nol jika satu tes saja gagal. Meta melaporkan Muse Wonder Full pada 57,5 (satu tingkat di bawah setelan tertinggi) dan Muse Wonder pada 53,1, dibanding 46,3 untuk Claude Opus 5.5 dan 42,5 untuk GPT-6 Astra. Model pesaing dijalankan di alat pengodean perusahaan masing-masing, sehingga Meta sendiri mengatakan perbandingannya tidak sepenuhnya adil, dan dengan hanya 20 proyek, satu proyek bisa mengubah skor beberapa poin.
Papan peringkat SWE-Marathon milik Abundant AI sendiri menempatkannya lebih moderat: Muse Wonder Full pada 53,1% dan Muse Wonder reguler pada 52,5%, keduanya pada setelan tertinggi di Muse Code, sedikit di depan Claude Sonnet 5.5 pada 51,3%. Claude Haiku 5.5, yang dirilis Anthropic lima hari sebelumnya, berada di 50,0%. Kedua daftar berasal dari pengujian terpisah, jadi jangan dicampur.
Klaim Meta bahwa Muse Wonder dapat menyelesaikan pekerjaan lintas aplikasi mendapat dukungan yang beragam. Pada AutomationBench-AA, yang memeriksa apakah alur kerja bisnis berakhir dalam keadaan yang benar, Muse Wonder Full mencetak 45,4 dibanding 41,6 untuk GPT-6 Astra dan 41,2 untuk Claude Opus 5.5, jadi ia memimpin meskipun masih gagal pada sebagian besar alur kerja.
OSWorld V2.1, kumpulan 108 tugas desktop, memberi gambaran lebih. Muse Wonder Full meraih 78,4 pada kredit parsial tetapi sepenuhnya menyelesaikan hanya 39,4% tugas, dan kedua model Claude mengalahkan skor parsialnya. Untuk formulir asuransi, menyelesaikan sebagian besar langkah tetaplah tugas yang gagal, jadi 39,4% adalah angka yang perlu diperhatikan.
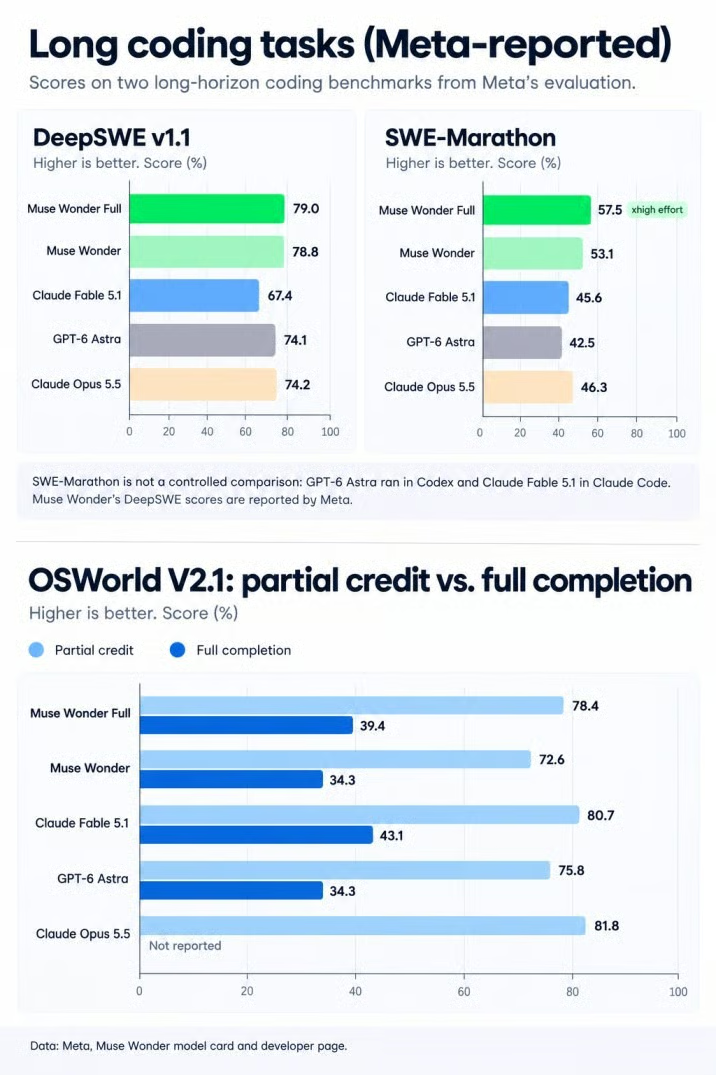
Keunggulan pengodean menutupi tingkat penyelesaian yang lebih rendah. Sumber: Meta; gambar oleh Penulis.
Muse Wonder Full memimpin tolok ukur hukum dan tertinggal pada kesehatan, dengan keuangan hampir seri. Skor hukumnya terdengar kecil, namun tetap tiga kali lipat Claude Opus 5.5. Dalam versi Artificial Analysis, sebuah dokumen hukum dihitung hanya jika memenuhi setiap persyaratan tanpa konten yang dibuat-buat, dan Muse Wonder Full mencetak 13,1 dibanding 4,2 untuk Claude Opus 5.5, yang tetap berarti gagal sekitar 87% tugas.
Keuangan hampir imbang, dengan Muse Wonder Full pada 59,1 di Vals Finance Agent V2 dibanding 58,6 untuk Claude Opus 5.5. Kesehatan sebaliknya: Muse Wonder Full mencetak 62,3 pada HealthBench Pro, di belakang Claude Opus 5.5 (65,6) dan GPT-6 Astra (65,3).
Muse Wonder Full tertinggal dari Claude Opus 5.5 pada enam dari 14 uji di tabel Meta sendiri, dan GPT-6 Astra mengalahkannya pada tiga uji. Tabel ini mengumpulkan kekalahan yang belum dibahas di atas.
|
Tolok ukur |
Apa yang diuji |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Pengodean terminal |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Membangun program dari nol |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Komposit luas |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Penggunaan alat profesional |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Bekerja dari PDF |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Sumber: halaman pengembang Muse Wonder Meta saat peluncuran. Semua model pada setelan penalaran tertinggi.
ProgramBench adalah kekalahan yang perlu diperhatikan para pengembang, dan jaraknya tidak dekat. Tolok ukur ini meminta model membangun ulang program dari nol, dan selisih 11,5 poin menunjukkan bahwa mengedit basis kode yang ada dan membangun dari kosong adalah keterampilan berbeda.
Artificial Analysis mencantumkan Muse Wonder Full pada 55,8, yang dibulatkan Meta menjadi 56, sementara Claude Sonnet 5.5 mencetak 56,0.
Bisakah Anda mempercayai hasil tolok ukur Muse Wonder? Tidak sepenuhnya. Kartu model Meta menunjukkan bahwa tabelnya mencampur tiga jenis bukti:
Seperti yang saya catat sebelumnya, hampir setiap skor menggunakan setelan penalaran tertinggi, jadi Anda melihat masing-masing model pada kondisi terbaiknya. Hasil juga bergeser tergantung penguji: Anthropic melaporkan 66,4% untuk Claude Opus 5.5 pada Terminal-Bench 4.0, dibanding 59,6 di tabel Meta. Klaim Meta bahwa Muse Wonder Full menangani tugas yang tidak familiar lebih baik daripada model Spark bertumpu pada analisis internalnya sendiri.
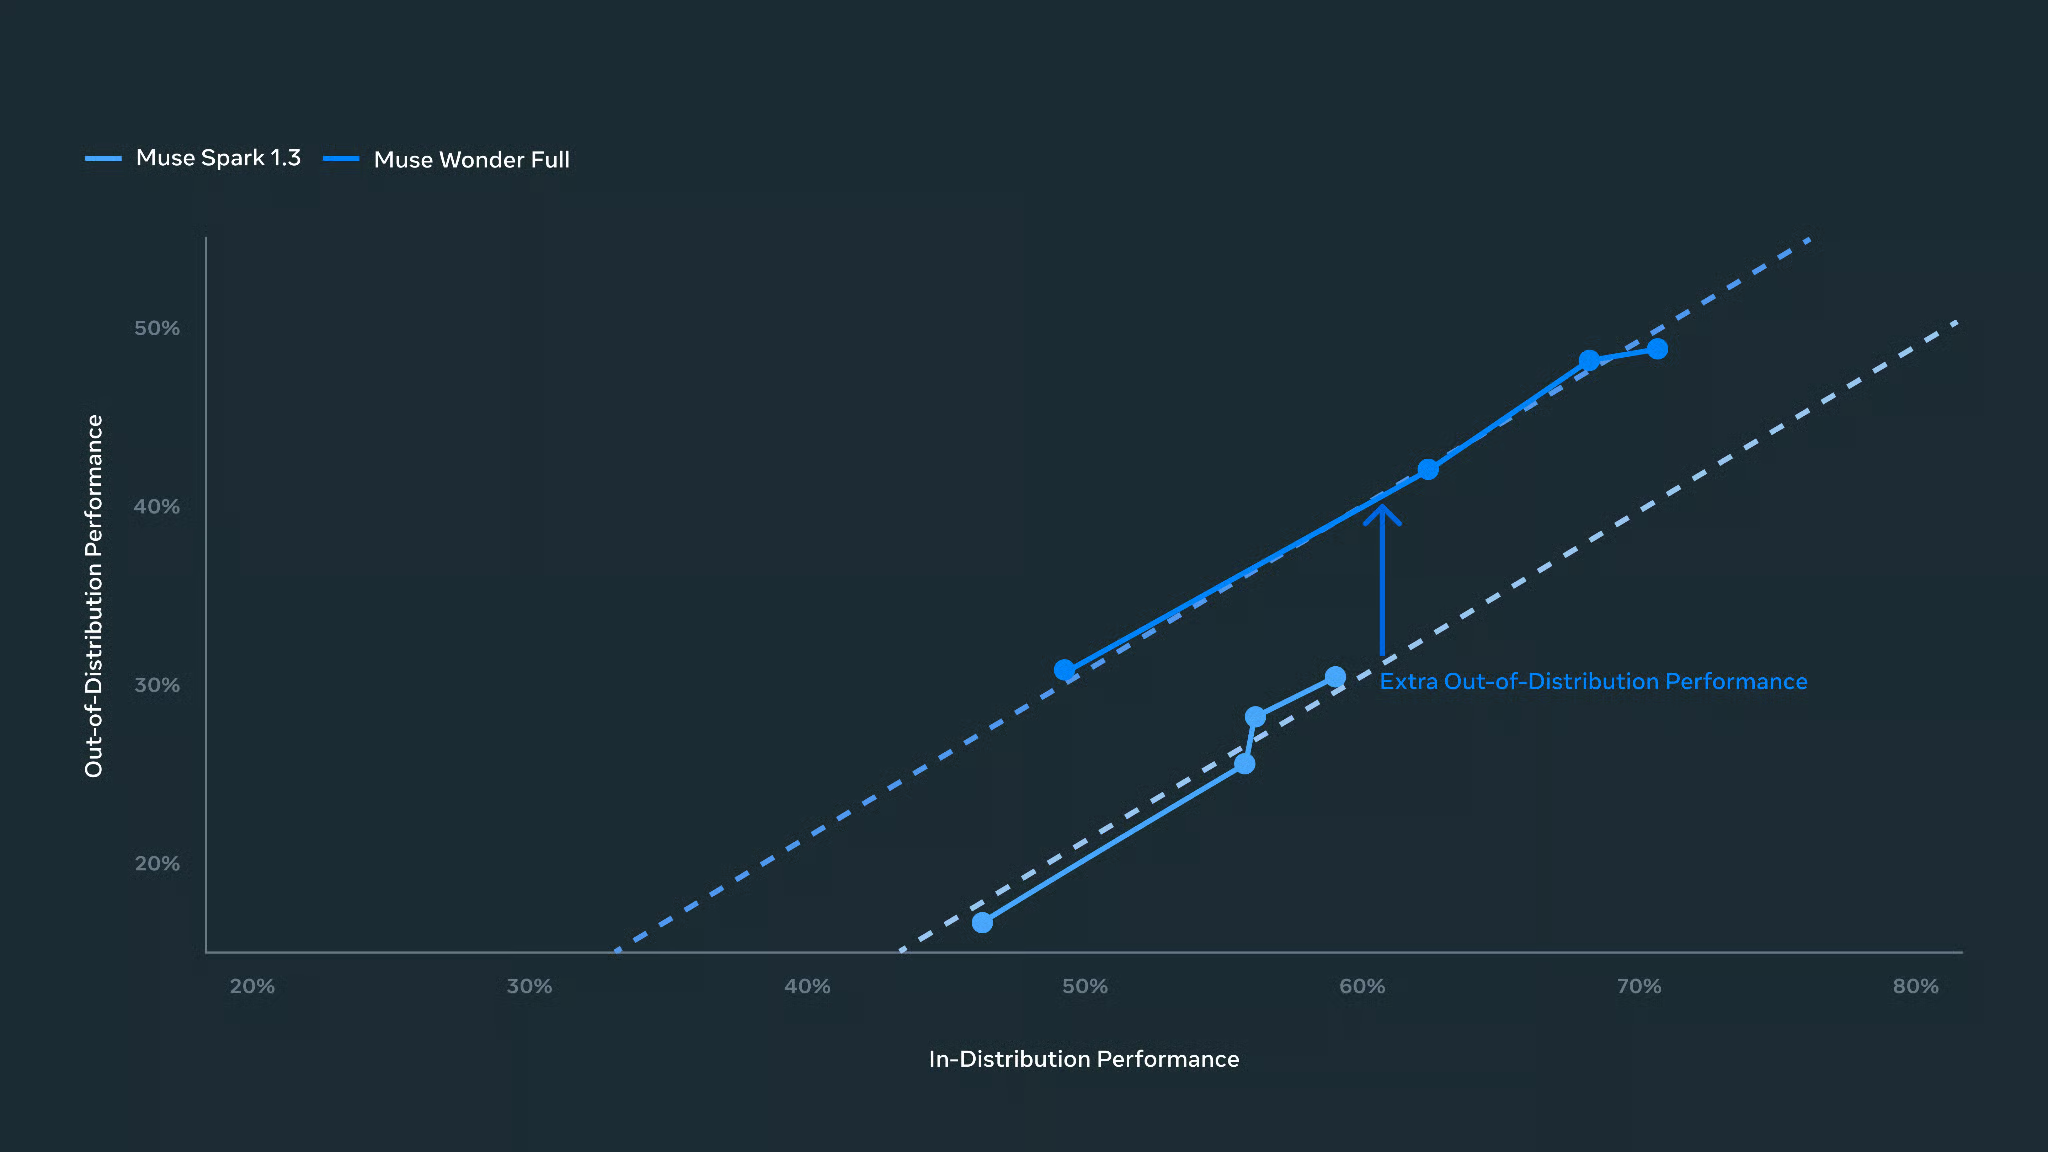
Meta membandingkan performa pada tugas yang tidak familiar. Sumber: Meta.
Berdasarkan angka Meta, Muse Wonder Full menang pada pekerjaan pengodean panjang (namun hanya di dalam Muse Code), Claude Opus 5.5 menang pada kerja terminal dan membangun dari nol, dan GPT-6 Astra hanya berada di puncak satu baris di tabel Meta. Bagian ini merangkum tolok ukur, jadi akan terdengar familiar.
Automasi terbagi, karena Muse Wonder Full memimpin AutomationBench-AA sementara model Claude memimpin pada kredit parsial OSWorld. Di antara model dengan skor penyelesaian penuh yang dilaporkan, tidak ada yang menyelesaikan sebagian besar tugas. Pada penalaran luas, Claude Opus 5.5 memimpin indeks Artificial Analysis, sementara Muse Wonder reguler mencetak 52,4.
Harga adalah titik di mana Muse Wonder reguler terlihat lebih lemah. GPT-6.1 Sol berharga setengah per token dan mencetak 51,8 pada indeks yang sama, dan Claude Sonnet 5.5 berharga sama dengan GPT-6.1 Sol.
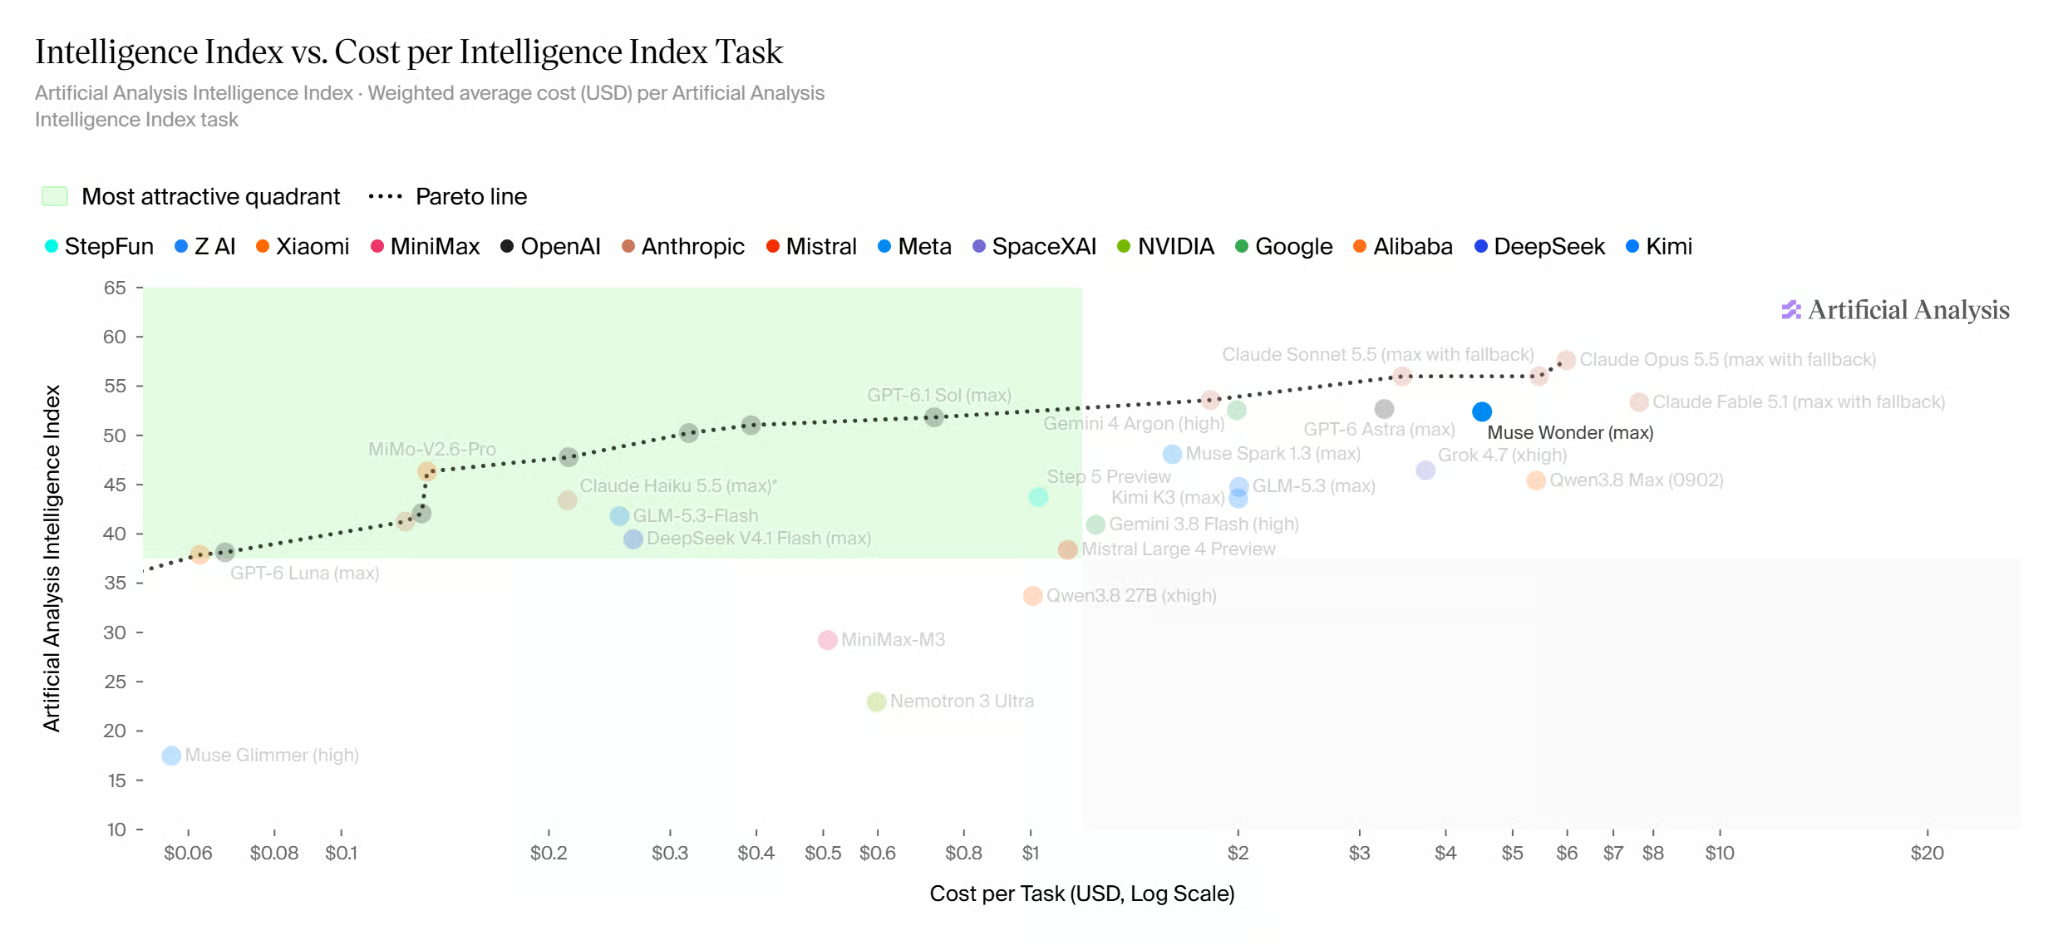
Muse Wonder menukar biaya dengan kecerdasan. Sumber: Artificial Analysis.
Saya hampir tidak memasukkan Gemini 4 Argon di bagian ini, karena Meta tidak mengujinya, dan seperti yang dicatat dalam liputan Gemini 4 Argon kami, model ini pertama kali diberikan ke tim keamanan siber tepercaya. Tanpa hasil bersama, tidak ada perbandingan langsung yang adil, jadi pilihlah berdasarkan beban kerja dan biaya untuk menyelesaikan tugas.
Muse Wonder paling cocok untuk dua jenis pekerjaan: perubahan perangkat lunak berskala besar dan alur kerja peramban multi-langkah. Pekerjaan perencanaan panjang, seperti demo denah tempat duduk pernikahan Meta, lebih bergantung pada aplikasi di sekitar model.
Kasus penggunaan ini memiliki bukti terkuat, setidaknya untuk mengubah kode yang sudah ada. Di Muse Code, Muse Wonder bekerja lintas file, menjalankan tes, membaca kegagalan, dan mencoba lagi, yang merupakan inti dari pengukuran DeepSWE dan SWE-Marathon. Pada kode nyata, berikan hanya izin yang dibutuhkan tugas dan minta tinjauan manusia atas perubahannya.
Demo Saturday Run Planning Meta menunjukkan Muse Wonder "bekerja langsung di peramban dan lintas aplikasi," dan demo lain menangani klaim asuransi. Karena Muse Wonder Full sepenuhnya menyelesaikan kurang dari 4 dari 10 tugas desktop, alur kerja nyata perlu persetujuan Anda sebelum apa pun dikirim atau dibayar.
Anda membayar Muse Wonder dengan dua cara: per token untuk Muse Wonder reguler, atau paket bulanan tetap Muse Code, yang, seperti saya sebutkan di pengantar, merupakan satu-satunya cara mendapatkan Muse Wonder Full.
Halaman harga Meta mencantumkan Muse Wonder reguler pada $4,00 per sejuta token masukan, $0,20 untuk masukan yang di-cache, dan $20,00 untuk keluaran. Itu lompatan besar dari $1,25 dan $4,25 milik Muse Spark 1.3, dan menyamai harga Claude Opus 5.5, yang memberi gambaran posisi Muse Wonder menurut Meta.
GPT-6 Astra terdaftar $10, $1 untuk cache, dan $50, dan GPT-6.1 Sol pada $2, $0,10, dan $10. Ilustrasi di bawah menerapkan harga saat peluncuran tersebut pada satu tugas pengodean dengan 3 juta token masukan (2,4 juta di-cache) dan 200.000 token keluaran, dengan asumsi tidak ada satu permintaan pun yang melewati 272.000 token, tempat harga GPT-6 Astra naik.
|
Model |
Masukan tak di-cache (0,6M) |
Masukan di-cache (2,4M) |
Keluaran (0,2M) |
Total per tugas |
|
Muse Wonder |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
Claude Opus 5.5 |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
GPT-6 Astra |
$6,00 |
$2,40 |
$10,00 |
$18,40 |
|
GPT-6.1 Sol |
$1,20 |
$0,24 |
$2,00 |
$3,44 |
Harga token yang sama berarti tagihan per percobaan yang sama, jadi angka yang perlu dibandingkan adalah biaya per tugas selesai. Jika Muse Wonder menyelesaikan satu dari dua kali, biayanya $13,76, sama dengan model berharga GPT-6.1 Sol yang menyelesaikan satu dari empat kali (kedua laju dibuat-buat untuk contoh).
Muse Wonder Full hanya tersedia dalam paket bulanan Muse Code, yang menagih tarif tetap alih-alih per token. Anda bisa melewati bagian ini jika hanya berencana menggunakan API. Dokumentasi langganan Meta mencantumkan empat paket:
Halaman produk Muse Code Meta hanya menampilkan harga untuk Power dan Maximum, yang agak janggal untuk diabaikan, jadi periksa paket lebih rendah saat checkout. Muse Wonder reguler ada di setiap paket.
Setiap paket memiliki batas penggunaan yang disetel ulang seiring waktu. Jatah yang tidak terpakai tidak bisa diakumulasikan, dan langganan tidak bisa digunakan sebagai kredit API.
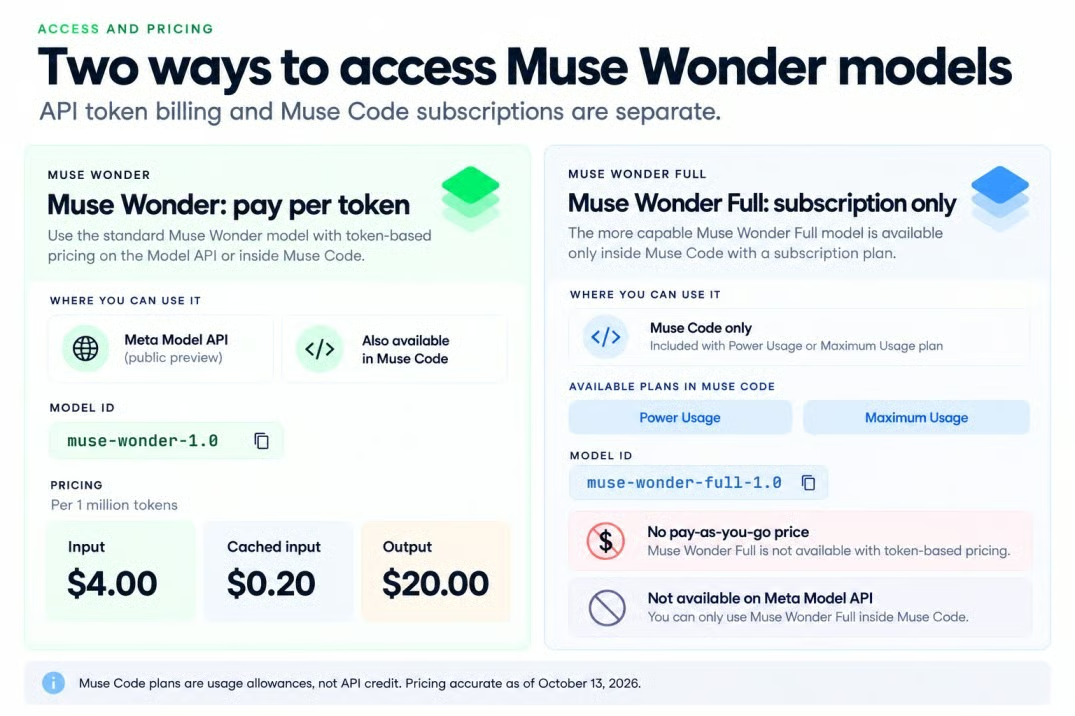
Harga Muse Wonder mengikuti dua rute. Sumber: Meta; gambar oleh Penulis.
Power adalah cara termurah untuk mencoba Muse Wonder Full, meski Meta belum mengatakan berapa banyak tugas besar yang ditanggung jatahnya. Itu bagian yang saya pantau, karena satu pengguna awal mengatakan beberapa permintaan kecil menghabiskan sekitar setengah dari batas 5 jam paket pemula, yang akan saya bahas di reaksi pengembang.
Mengulang pemisahan dari pengantar: Muse Wonder reguler tersedia melalui Meta Model API dan Muse Code, dan Muse Wonder Full hanya melalui Muse Code.
Untuk menggunakan API Muse Wonder, Anda memerlukan akun pengembang Meta, kunci API, dan penagihan, dan ID modelnya adalah muse-wonder-1.0. Meta masih menyebut API sebagai "public preview" di halaman produknya, kode yang dibangun di atas SDK OpenAI dapat diarahkan ke sana, dan Meta juga mencantumkan OpenRouter sebagai jalur.
Akses tidak bersifat global. Kebijakan Penggunaan Geografis Meta memblokir beberapa tempat, termasuk Tiongkok, Rusia, Iran, Pakistan, Eritrea, dan Ethiopia.
Untuk mendapatkan Muse Wonder Full, Anda memerlukan paket Muse Code Power atau Maximum, akun Meta, dan berusia 18 tahun atau usia mayoritas di tempat tinggal Anda. Seperti saya bahas di bagian harga, model ini tidak ada di Model API berapa pun harganya, dan ID-nya, muse-wonder-full-1.0, hanya berfungsi di dalam Muse Code. Dokumentasi Muse Code mencantumkan macOS, Linux, dan Windows, meski halaman produknya hanya menyebut macOS dan Windows.
Risiko di sini berasal dari hal yang sama yang dipromosikan Meta: durasi berjalan yang lama dan akses ke file pribadi Anda.
Kartu model menyebutkan tiga kelemahan yang dapat memengaruhi agen. Masing-masing menyebabkan masalah berbeda:
Ini bukan masalah kualitas jawaban yang berdiri sendiri ketika model dapat menggunakan alat. Klik yang salah atau asumsi buruk di awal tugas dua jam dapat merusak sisanya.
Itu bergantung pada mode, jadi bacalah ini sebelum mengarahkan Muse Code ke repositori privat. Ketentuan Layanan Meta, diperbarui tiga hari sebelum peluncuran, menyatakan Meta tidak akan melatih pada konten yang dikirim ke Standard Services, sementara konten yang dikirim dalam mode Contributor dapat digunakan untuk "melatih, mengembangkan, mengevaluasi, dan meningkatkan" modelnya.
Langganan Muse Code dimulai dalam mode Contributor, dengan imbalan penggunaan lebih banyak, dan Anda harus beralih ke Standard di pengaturan Anda. Peralihan hanya berlaku ke depan, jadi apa pun yang sudah Anda kirim masih dapat digunakan untuk pelatihan. Saya kurang menyukai bawaan tersebut.
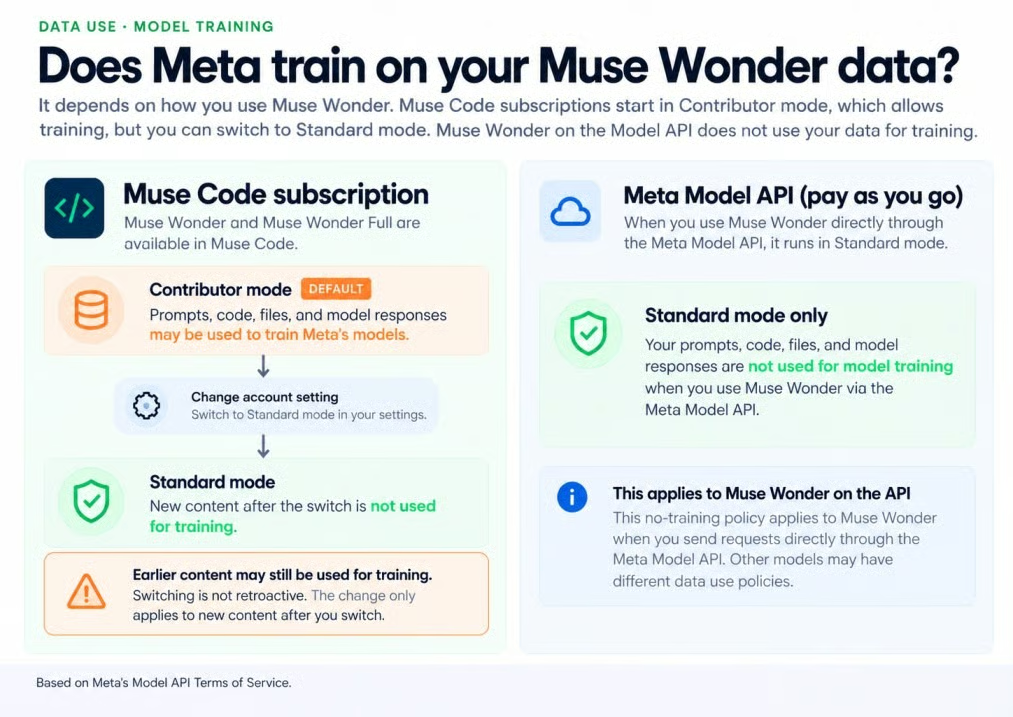
Konten Contributor dapat melatih model Meta. Sumber: Ketentuan Meta; gambar oleh Penulis.
Ketentuan juga menyatakan Anda "tidak boleh mengirimkan informasi sensitif, rahasia, atau pribadi" dalam mode Contributor, termasuk kode privat. Muse Wonder reguler pada API pay-as-you-go berjalan hanya dalam mode Standard.
Meta menguji Muse Wonder Full di bawah Superintelligence Scaling Framework miliknya. Tanpa pengaman, Meta tidak menutup kemungkinan model ini mencapai tingkat risiko tinggi untuk ancaman kimia dan biologis, dan dengan pengaman Meta menilai setiap area risiko "sedang atau lebih rendah."
Penilaian risiko bukanlah jaminan keamanan, dan laporan keamanan yang lebih lengkap masih akan hadir "segera." Saran di kartu model sederhana: minta konfirmasi manusia untuk tindakan yang tidak bisa dibatalkan, dan jalankan agen di sandbox dengan izin terbatas.
Reaksi hari peluncuran di X terbagi antara kemajuan cepat, performa yang tidak merata, dan frustrasi dengan batas penggunaan. Ini adalah uji singkat dan kesan pribadi, bukan evaluasi terkontrol.
Pandangan positif yang berhati-hati datang dari penguji awal yang memiliki waktu terbatas dengan Muse Wonder namun menilai tampilannya menjanjikan. Poin besarnya adalah sejauh mana model Meta berkembang sejak Muse Spark pada April.
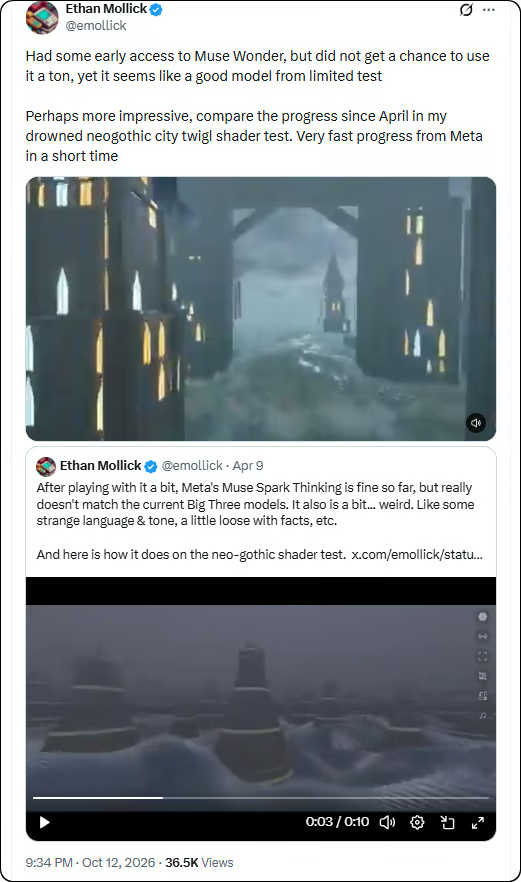
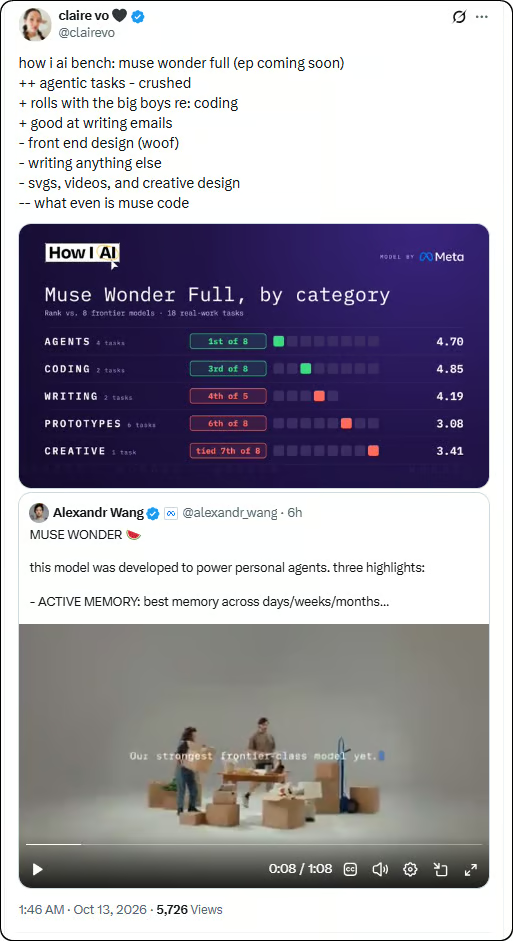
Uji kategori yang lebih luas memberi cerita yang kurang rapi. Muse Wonder Full berada dekat puncak untuk agen dan pengodean, namun tertinggal pada penulisan, desain front-end, dan pekerjaan kreatif.
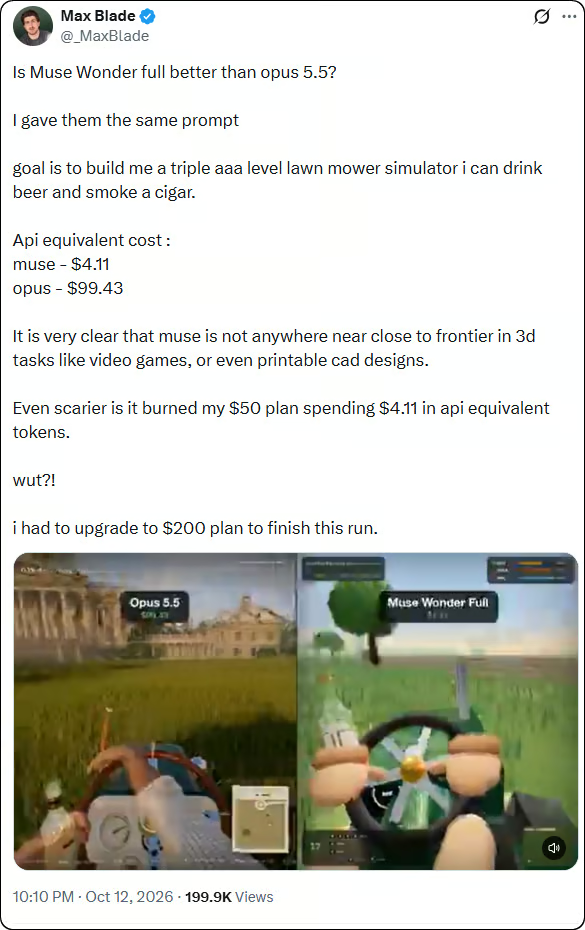
Keluhan paling tajam adalah tentang biaya dan batas paket. Dalam uji mesin pemotong rumput dengan prompt yang sama, Muse Wonder Full menggunakan sekitar $4,11 dalam token ekuivalen API namun menghasilkan hasil 3D yang lebih lemah daripada Claude Opus 5.5, dan penguji mengatakan penyelesaian memerlukan peningkatan dari paket $50 ke paket $200.
Secara keseluruhan, unggahan-unggahan tersebut menyiratkan Muse Wonder kompetitif namun tidak merata. Diperlukan lebih banyak uji berulang sebelum menganggap satu hasil sebagai tipikal.
Sebagian besar bukti peluncuran masih berasal dari Meta. Muse Wonder Full tidak memiliki API pay-as-you-go, dan Muse Wonder reguler berharga sama dengan Claude Opus 5.5 sekaligus tertinggal pada beberapa uji.
Saya akan menguji Muse Wonder reguler untuk agen API dan Muse Wonder Full untuk pekerjaan repositori panjang. Saya akan tetap menggunakan Claude Opus 5.5 untuk kerja terminal atau membangun program dari nol, dan menggunakan GPT-6.1 Sol atau Claude Sonnet 5.5 ketika biaya menjadi penentu.
Belajar bersama DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt