
{count, plural, other {课程}}
Large Language Models (LLMs) 概念
{hours} 小时
112.2K
本周,Meta 发布了 Muse Wonder 和 Muse Wonder Full,这是其在Muse Spark 之后推出的首个主要模型家族。两者均为可处理多步骤任务的 AI 代理而构建。
Meta 的发布文章称,Muse Wonder 是其 AI 工作历时 14 个月重构的成果。需要了解的两个新术语是 Active Memory(主动记忆),用于回忆过往对话中的有用细节,以及 Active Focus(主动专注),用于在任务停滞时继续推进。
常规版 Muse Wonder 可通过Meta Model API 和 Muse Code 使用;而 Muse Wonder Full——支撑大多数头条成绩的模型——仅在 Muse Code 的两档最高价方案中可用。后文将详细展开。
以下是我从发布中提炼的要点:
Muse Wonder 与 Muse Wonder Full 是 Meta 称其迄今能力最强的推理模型,为处理个人与工作任务的代理而构建。其模型卡显示支持文本、图像、视频与音频输入,输出仅为文本,因此两者均不生成图像、视频或音频。Meta 的开发者文档补充了 PDF 输入,并将上下文窗口标为 1,048,576 个 token。
Meta 的研究博客称,两者均基于 Muse Spark 的训练工作并在 Meta 的 Prometheus 数据中心完成训练。未公布参数规模。
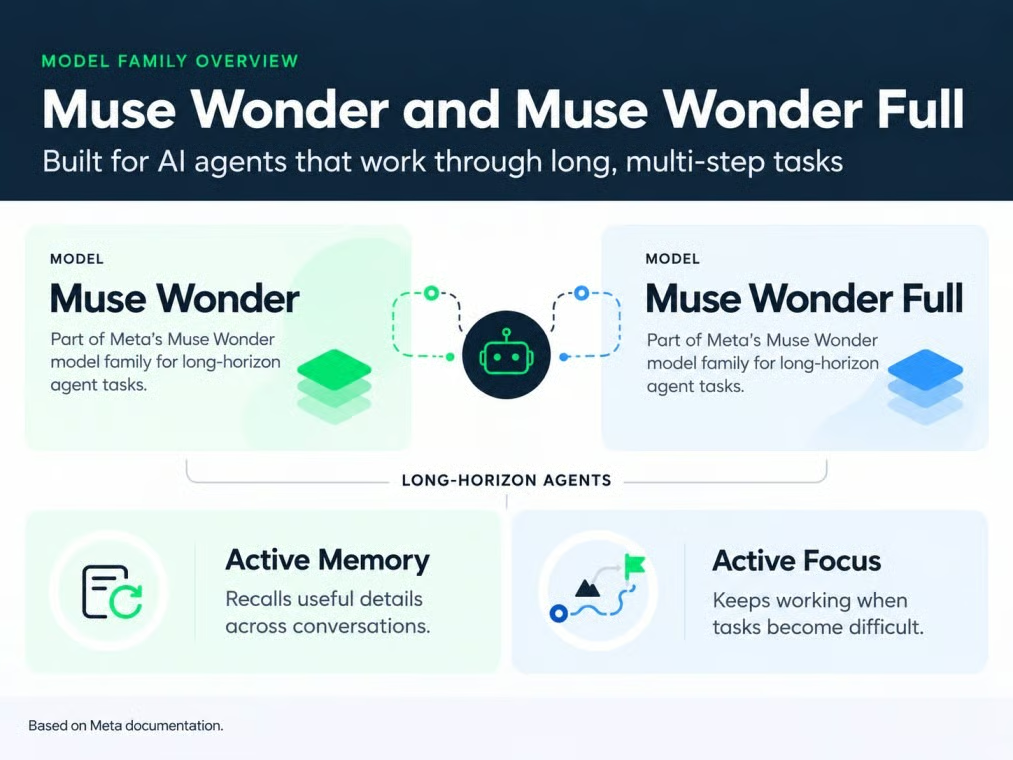
Muse Wonder 提供两个变体。图片由作者制作。
两者之中,Muse Wonder Full 是单独、更强的模型。开发者文档称将常规版 Muse Wonder(muse-wonder-1.0)的推理调到"max"并不会切换到 Muse Wonder Full(muse-wonder-full-1.0)。
您或许注意到 Meta 将 Muse 用于多种产品。回顾如下:
当 Meta 说 Muse Wonder “能做”某事时,往往有一半工作由 Muse Code 完成。下文多数编码结果均属此类。
Muse Wonder 的关键特性是 Active Memory 与 Active Focus,Meta 主要在长时编码任务上展示它们。两者背后的思路很简单:代理必须记住正确的细节,并在计划受挫时坚持推进。
Active Memory 是 Meta 对跨会话携带重要细节并在当前调取所需信息的命名。比如您 3 月设定家庭办公室预算 $3,000,4 月提高到 $4,000,5 月请求家具候选清单。良好的记忆意味着代理无需提醒就会采用 4 月的数额。
Meta 的证据是 MemoryBench,这是其自研的在长对话中更新事实的测试。Muse Wonder 得分 85.6,但这并不能说明数月后的回忆能力,而且基于 API 构建的应用仍需自行存储这些事实。这是我最关心的功能,因为代理若按旧预算工作,可能会让您多花钱。
Active Focus 是 Meta 对“坚持性”的命名:尝试其他方法、跨越阻碍,并在重要操作前进行确认。设想一次代码迁移导致 30 个测试失败。一个专注的代理会修复代码并重跑测试,而较弱的代理可能只是修改测试以使其通过。
Meta 通过自研的 FocusBench 测量这一点,并借助SWE-Marathon,我会在基准部分介绍。二者都不保证任务一定完成,且后台运行取决于模型周边的软件支持,我们的OpenAI Dots 解读覆盖了常驻型代理的这些风险。
Muse Wonder 负责规划长时编码工作并将任务拆分给辅助代理,而 Muse Code 负责运行工具与审批。Meta 的开发者页面将其定位于“运行数小时”的任务,同时可同时编辑多个文件。
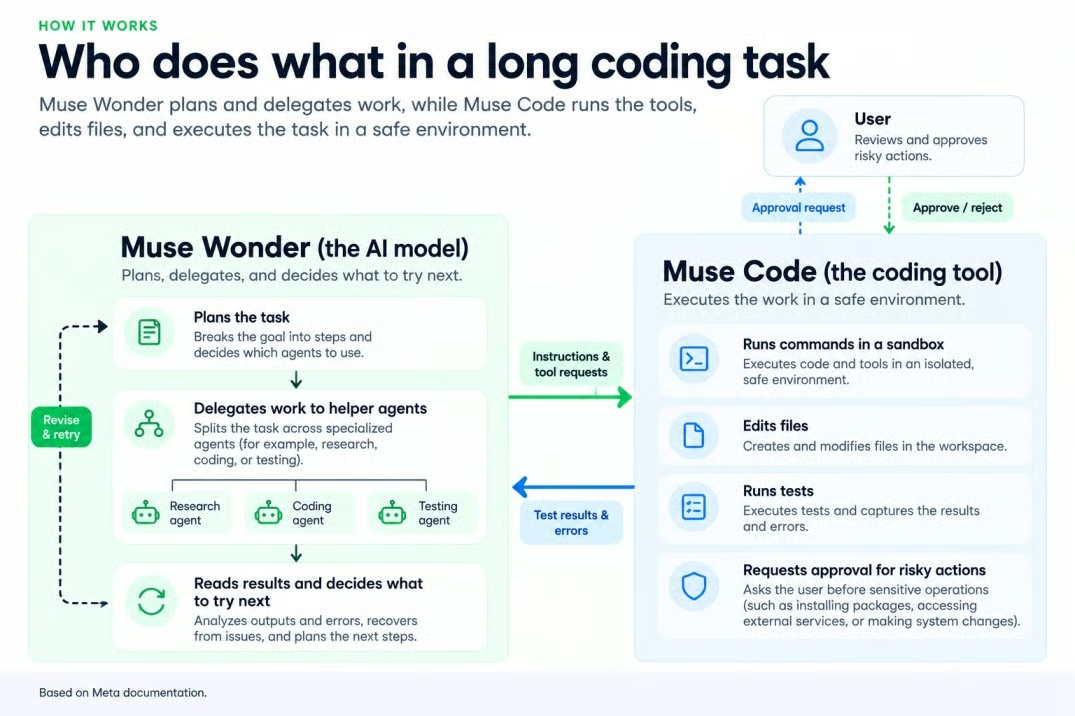
Muse Wonder 负责规划;Muse Code 负责执行。图片由作者制作。
Meta 的演示之一是一款基于图像构建的可玩 3D 厨房游戏。这一选择略显奇怪,因为模型卡将 3D 推理列为已知弱项(我会选其他示例)。
Meta 的表格显示,Muse Wonder Full 在长时编码和部分专业基准中占优,而 Claude Opus 5.5 在终端编码与从零构建程序方面领先。除非另有注明,下文数据来自 Meta,几乎所有模型均使用最高推理设定(我会标出唯一例外)。
在 Meta 的表格中,Muse Wonder Full 在两项长时编码测试中均居首。如开头所述,它在 DeepSWE v1.1 上得分 79.0,常规版 Muse Wonder 紧随其后为 78.8。眼下这是 Meta 的数据,因为 Datacurve 的公开 DeepSWE 排行榜尚未列出 Muse Wonder。
我更关注 SWE-Marathon,因为其 20 个多小时项目中,只要有一个测试失败就记零分。Meta 报告 Muse Wonder Full 为 57.5(略低于其最高设定),Muse Wonder 为 53.1;相比之下,Claude Opus 5.5 为 46.3,GPT-6 Astra 为 42.5。竞争模型运行在各自公司的编码工具中,因此 Meta 自己也表示横向对比并不完全公平;且仅 20 个项目,单个项目就可能带来数分波动。
Abundant AI 的 SWE-Marathon 排行更为保守:Muse Wonder Full 为 53.1%,常规版 Muse Wonder 为 52.5%,二者均在 Muse Code 内以最高设定运行,略高于 Claude Sonnet 5.5 的 51.3%。Claude Haiku 5.5(Anthropic 早五天发布)为 50.0%。两份榜单来自不同测试,请勿混用。
Meta 关于 Muse Wonder 能跨应用执行工作的说法,得到的支持不一。在AutomationBench-AA 上(用于检查业务流程是否达到正确最终状态),Muse Wonder Full 得分 45.4,对比 GPT-6 Astra 的 41.6 和 Claude Opus 5.5 的 41.2,因此它领先,但仍未能完成大多数流程。
OSWorld V2.1(108 个桌面任务)更具参考价值。Muse Wonder Full 的部分得分为 78.4,但完全完成的任务仅 39.4%,且两款 Claude 模型的部分得分都更高。对保险表单而言,多数步骤正确但未完全完成仍算失败,因此 39.4% 才是关键指标。
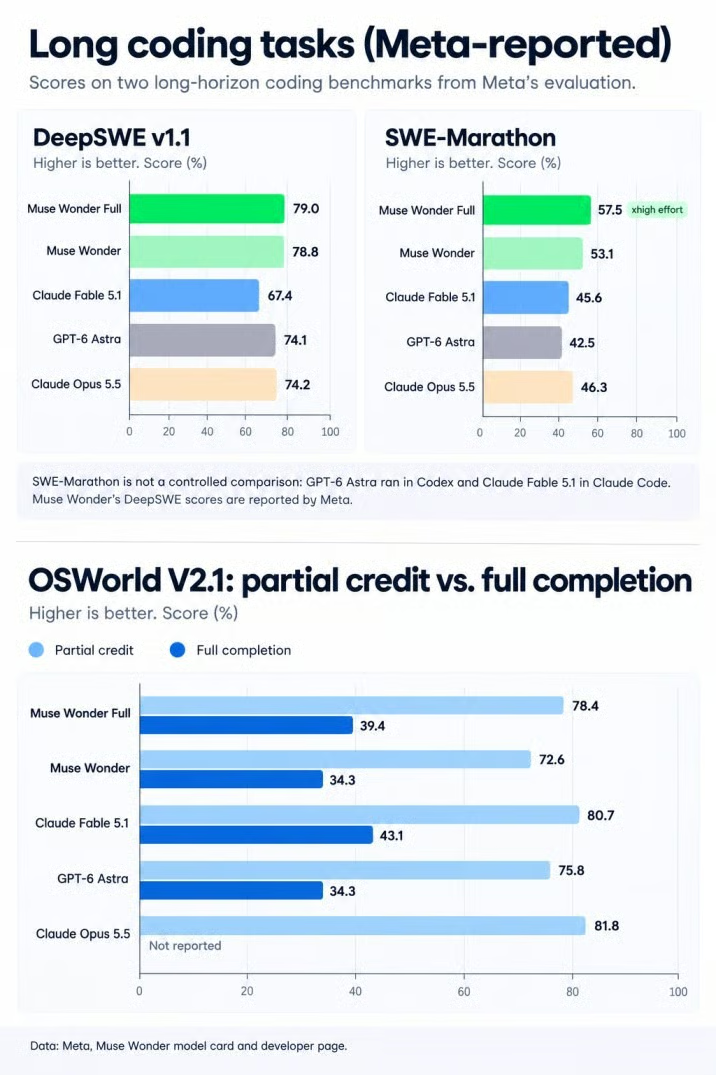
编码优势掩盖了较低的完成率。来源:Meta;图片由作者制作。
Muse Wonder Full 在法律基准中领先,在健康方面落后,金融几乎打成平手。其法律得分看起来很小,但仍是 Claude Opus 5.5 的三倍。在Artificial Analysis 的版本中,法律文书仅在满足所有要求且无臆造内容时计入,Muse Wonder Full 得分 13.1,而 Claude Opus 5.5 为 4.2,这仍意味着约 87% 的任务未完成。
金融几乎持平,Muse Wonder Full 在Vals Finance Agent V2 上为 59.1,Claude Opus 5.5 为 58.6。健康方向则相反:Muse Wonder Full 在 HealthBench Pro 上得分 62.3,落后于 Claude Opus 5.5(65.6)与 GPT-6 Astra(65.3)。
在 Meta 自己的表格中,Muse Wonder Full 在 14 项测试中有 6 项落后于 Claude Opus 5.5,而 GPT-6 Astra 在 3 项上胜出。下表汇总了前文未涵盖的失利项目。
|
Benchmark |
What it tests |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Terminal coding |
57.1 |
52.0 |
59.1 |
59.6 |
52.0 |
|
ProgramBench |
Building programs from scratch |
59.0 |
50.0 |
52.5 |
70.5 |
55.5 |
|
AA Intelligence Index v4.3 |
Broad composite |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Professional tool use |
75.3 |
70.5 |
66.1 |
75.4 |
73.1 |
|
GDP.pdf |
Work from PDFs |
33.2 |
30.8 |
34.2 |
30.6 |
27.6 |
来源:Meta 于发布时的 Muse Wonder 开发者页面。所有模型均为最高推理设定。
ProgramBench 是编码人员应最在意的失利,且差距不小。它要求模型从零重建程序,11.5 分的差距表明,编辑现有代码库与从无到有构建是两种不同的能力。
Artificial Analysis 将 Muse Wonder Full 列为 55.8,Meta 表中四舍五入为 56,而 Claude Sonnet 5.5 为 56.0。
能否完全信任 Muse Wonder 的基准结果? 并不完全。Meta 的模型卡显示,该表混合了三类证据:
如前所述,几乎所有分数都采用最高推理设定,因此您看到的是各模型的最佳水平。结果也会随测试方变化:Anthropic 报告 Claude Opus 5.5 在 Terminal-Bench 4.0 上为 66.4%,而 Meta 表中为 59.6。Meta 关于 Muse Wonder Full 在不熟悉任务上优于 Spark 模型的说法,主要基于其自家分析。
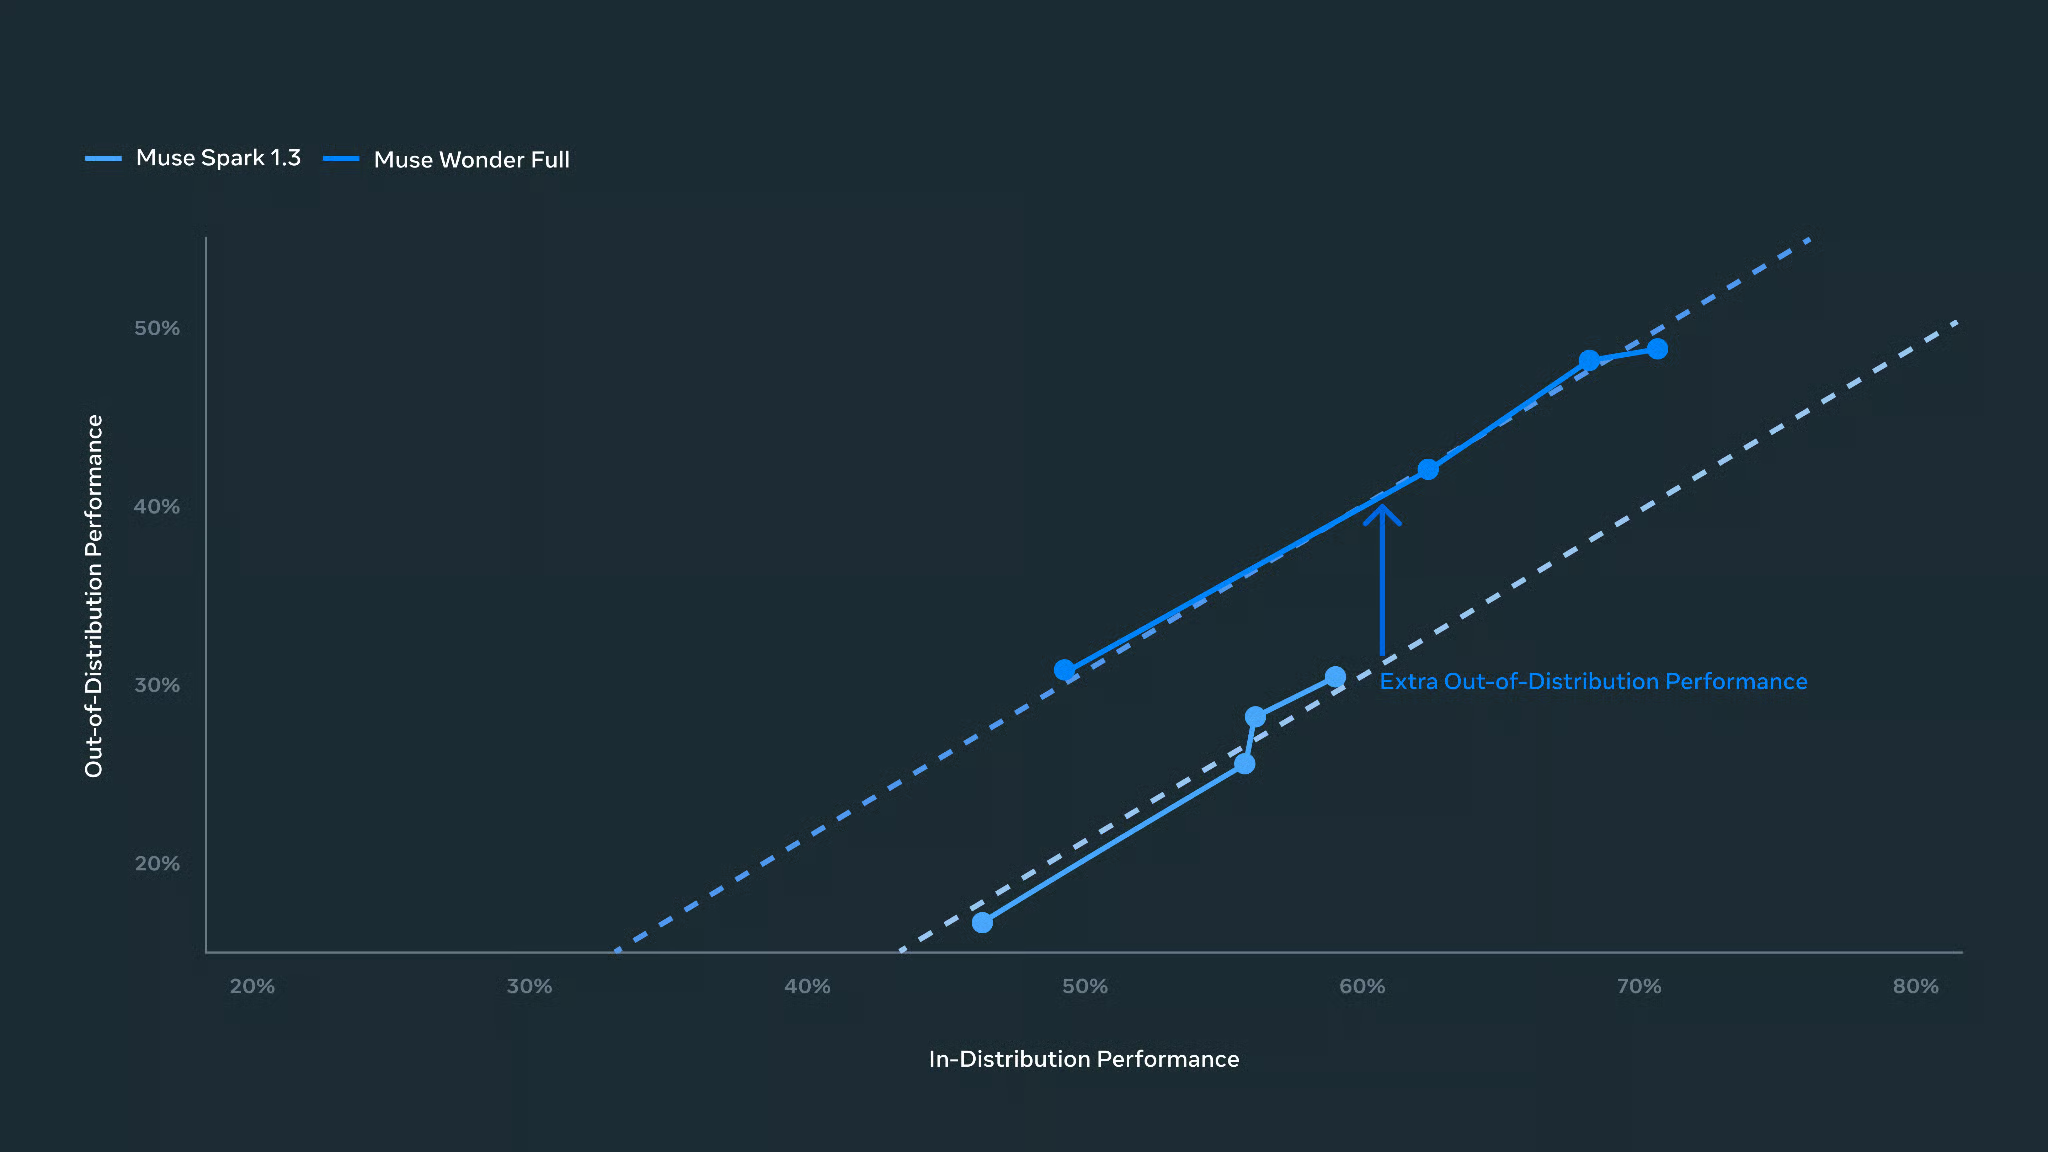
Meta 对不熟悉任务的表现对比。来源:Meta。
按 Meta 的数据,Muse Wonder Full 在长时编码任务上胜出(但仅限于 Muse Code 内),Claude Opus 5.5 则在终端工作与从零构建方面领先,而 GPT-6 Astra 在 Meta 表格中仅领先一项。本节将基准汇总,内容会与前文相呼应。
自动化方面分化明显:Muse Wonder Full 领跑 AutomationBench-AA,而 Claude 系列在 OSWorld 的部分得分上领先。在报告了完整完成率的模型中,均未能完成多数任务。在广义推理方面,Claude Opus 5.5 领跑 Artificial Analysis 指数,常规版 Muse Wonder 得分为 52.4。
价格是常规版 Muse Wonder 较弱的一面。GPT-6.1 Sol 的每 token 价格是其一半,在同一指数中得分 51.8,而 Claude Sonnet 5.5 的价格与 GPT-6.1 Sol 相同。
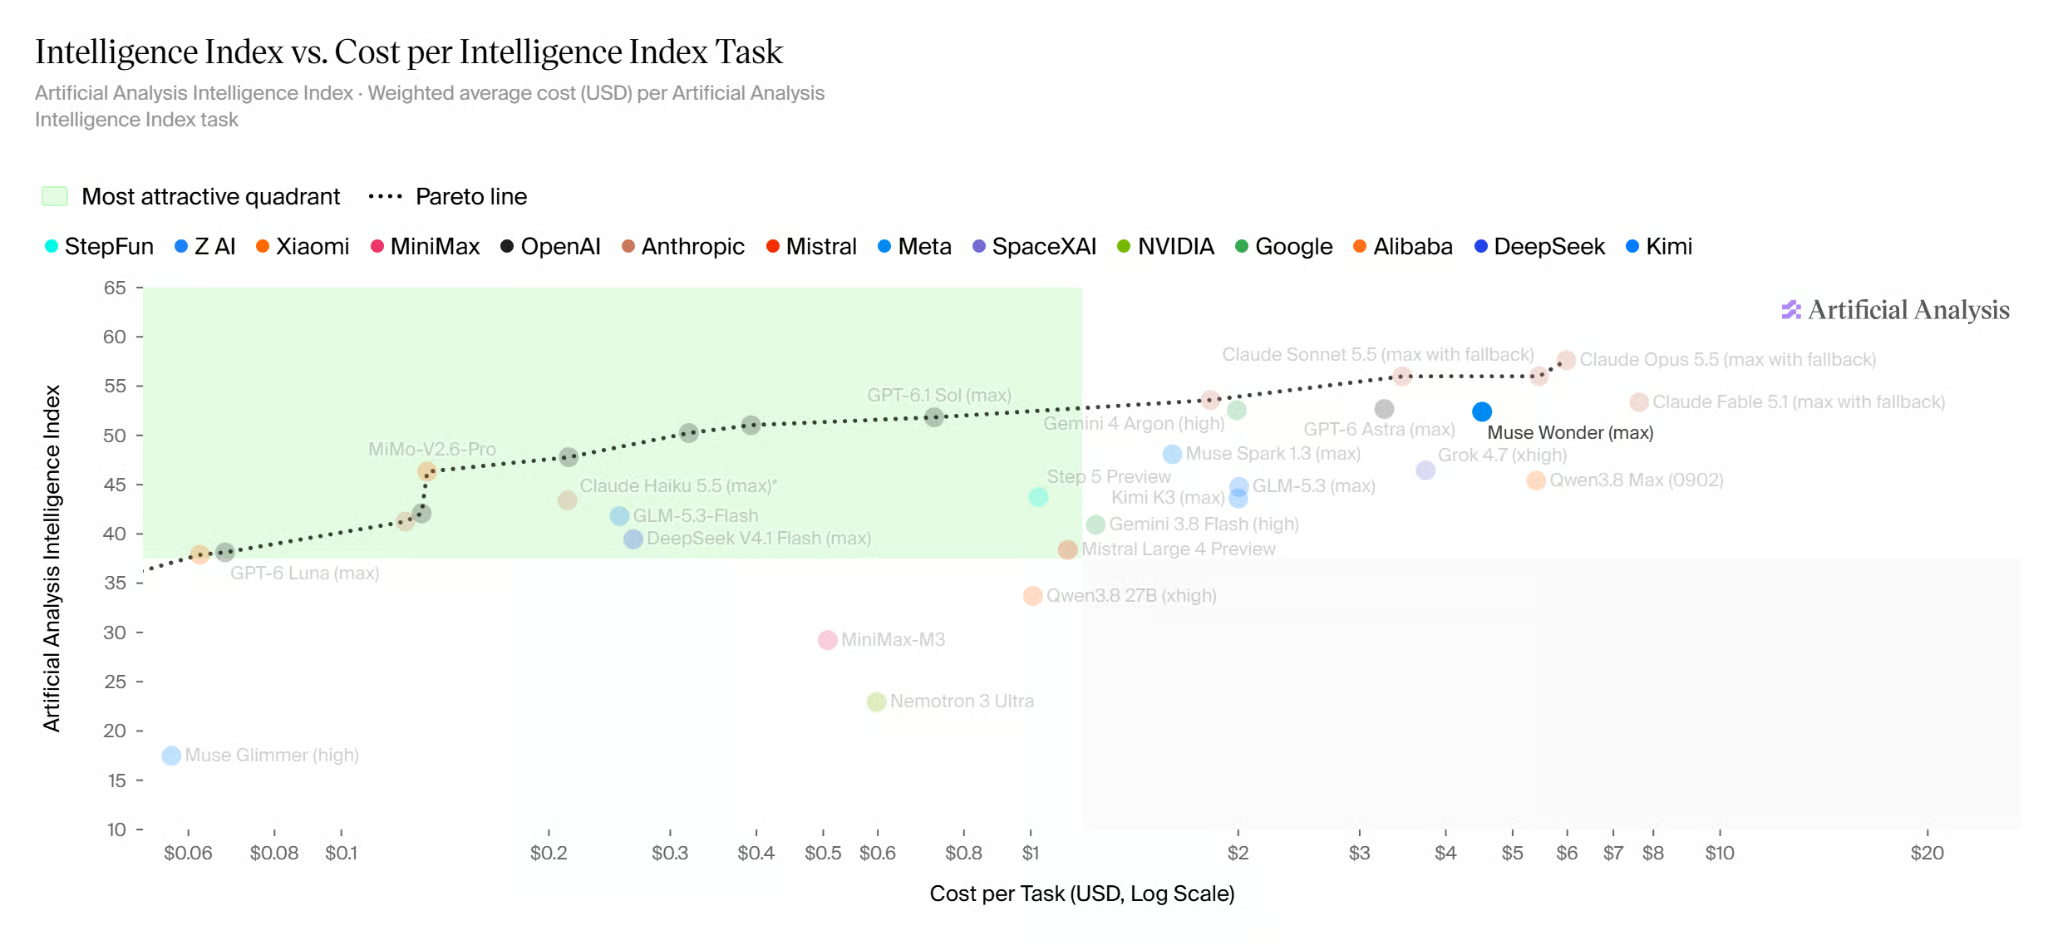
Muse Wonder 在成本与智能之间取舍。来源:Artificial Analysis。
我几乎想把 Gemini 4 Argon 从本节剔除,因为 Meta 并未测试它,且正如我们的Gemini 4 Argon 报道所述,它先向受信任的网络安全团队开放。缺乏可比结果时,无法进行公平对比,因此应根据工作负载与完成任务的成本来选择。
Muse Wonder 最适合两类工作:大型软件变更与多步骤的浏览器工作流。长时间的规划类任务(如 Meta 的婚礼席位图示例)则更多依赖模型周边的应用。
该场景的证据最为充分,至少对于修改已有代码而言。在 Muse Code 中,Muse Wonder 跨文件工作、运行测试、阅读失败并重试,正是 DeepSWE 与 SWE-Marathon 所衡量的。在真实代码上,应仅授予任务所需权限,并由人工审核变更。
Meta 的“Saturday Run Planning”演示展示了 Muse Wonder“直接在浏览器与跨应用工作”,另一个演示处理了保险理赔。鉴于 Muse Wonder Full 完整完成的桌面任务不足四成,实际工作流在提交或支付前必须获得您的批准。
付费方式有两种:常规版 Muse Wonder 按 token 计费;Muse Code 方案按月固定收费——正如开头所述,这也是获取 Muse Wonder Full 的唯一方式。
Meta 的定价页面列出,常规版 Muse Wonder 的未缓存输入为每百万 $4.00,缓存输入 $0.20,输出 $20.00。这比 Muse Spark 1.3 的 $1.25 与 $4.25 有大幅提升,并与Claude Opus 5.5 的价格相当,这也表明 Meta 对 Muse Wonder 定位的判断。
GPT-6 Astra 标价为 $10、$1(缓存)与$50;GPT-6.1 Sol 为$2、$0.10 与 $10。下表将这些首发价应用于一个包含 300 万输入 token(其中 240 万为缓存)与 20 万输出 token 的编码任务,假设无单次请求超过 272,000 token,否则 GPT-6 Astra 的价格会上调。
|
Model |
Uncached input (0.6M) |
Cached input (2.4M) |
Output (0.2M) |
Total per task |
|
Muse Wonder |
$2.40 |
$0.48 |
$4.00 |
$6.88 |
|
Claude Opus 5.5 |
$2.40 |
$0.48 |
$4.00 |
$6.88 |
|
GPT-6 Astra |
$6.00 |
$2.40 |
$10.00 |
$18.40 |
|
GPT-6.1 Sol |
$1.20 |
$0.24 |
$2.00 |
$3.44 |
相同的 token 价格意味着每次尝试的账单相同,因此应比较“每个完成任务的成本”。若 Muse Wonder 两次完成一次,即 $13.76;若另一款以 GPT-6.1 Sol 价位的模型四次完成一次,成本亦为 $13.76(两项完成率仅为示例)。
Muse Wonder Full 只随 Muse Code 的包月方案提供,按月固定收费而非按 token 计费。若您只打算使用 API,可跳过本节。Meta 的订阅文档列出四档方案:
Meta 的Muse Code 产品页仅显示 Power 与 Maximum 的价格,略显奇怪,建议在结账时确认低档方案。常规版 Muse Wonder 在所有方案中均可用。
各方案的使用配额会随时间重置。未用完的配额不会结转,订阅亦不可作为 API 额度使用。
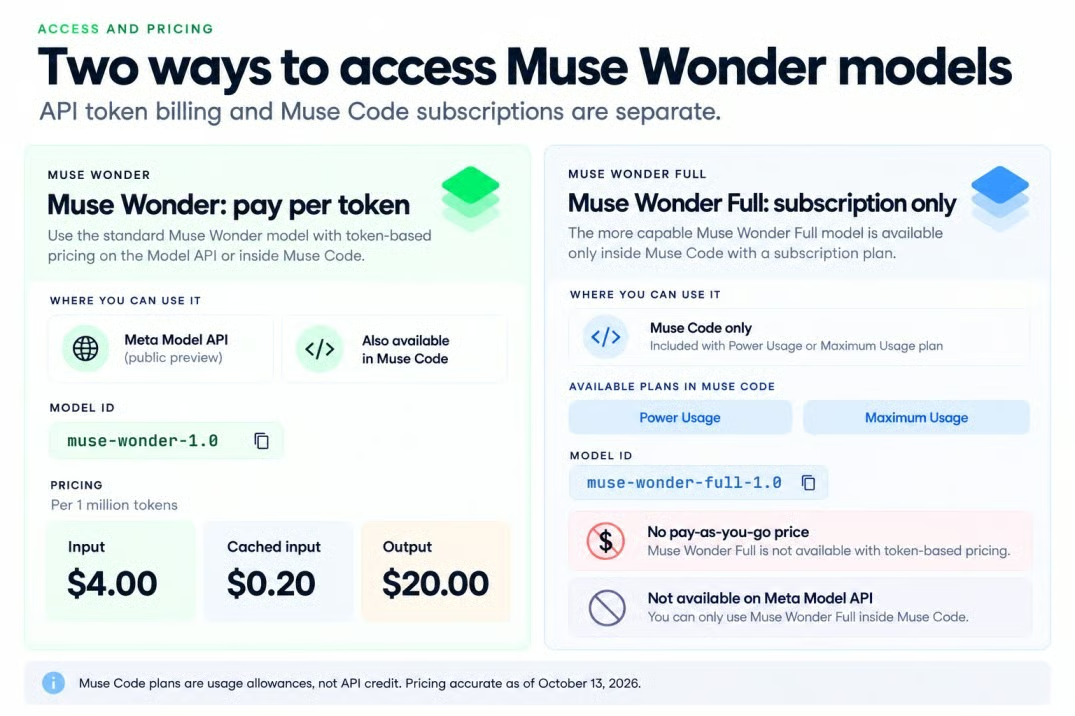
Muse Wonder 的定价与访问有两条路径。来源:Meta;图片由作者制作。
Power 是尝试 Muse Wonder Full 的最低成本方式,但 Meta 尚未说明其配额可覆盖多少大型任务。这一点值得关注;有早期用户称,几次小请求就用掉了入门方案 5 小时限额的大约一半,我会在开发者反馈中提到。
回到开头的划分:常规版 Muse Wonder 可通过 Meta Model API 与 Muse Code 使用,而 Muse Wonder Full 仅通过 Muse Code 使用。
要使用 Muse Wonder API,您需要 Meta 开发者账号、API 密钥与计费设置,模型 ID 为muse-wonder-1.0。Meta 仍在其产品页将该 API 标注为“公开预览”,基于 OpenAI SDK 构建的代码可指向该接口,Meta 亦列出 OpenRouter 作为接入途径。
访问并非全球开放。Meta 的地理使用政策限制了多个地区,包括中国、俄罗斯、伊朗、巴基斯坦、厄立特里亚与埃塞俄比亚。
要获得 Muse Wonder Full,您需要订阅 Muse Code 的 Power 或 Maximum 方案,拥有 Meta 账号,并年满 18 岁或达到您所在地区的法定成年年龄。如定价部分所述,它在任何价格下都不提供 Model API,且其 IDmuse-wonder-full-1.0 仅在 Muse Code 内可用。Muse Code 文档列出 macOS、Linux 与 Windows,但其产品页仅提及 macOS 与 Windows。
相关风险正源自 Meta 主打的卖点:长时间运行与对您私有文件的访问。
模型卡列出了三项可能影响代理的弱点。各自导致不同问题:
当模型可以使用工具时,这些并非孤立的答案质量问题。两小时任务初期的一次错误点击或错误假设,可能毁掉后续全部工作。
这取决于模式,因此在将 Muse Code 指向私有仓库前请先阅读。Meta 的服务条款在发布前三天更新,称 Meta 不会使用发送至其标准服务(Standard Services)的内容进行训练,而在贡献者模式(Contributor)中发送的内容可能用于“训练、开发、评估与改进”其模型。
Muse Code 订阅默认启用贡献者模式,以更高配额为交换,您需在设置中切换到标准模式。切换仅对未来生效,已发送的内容仍可能用于训练。这个默认设置我并不喜欢。
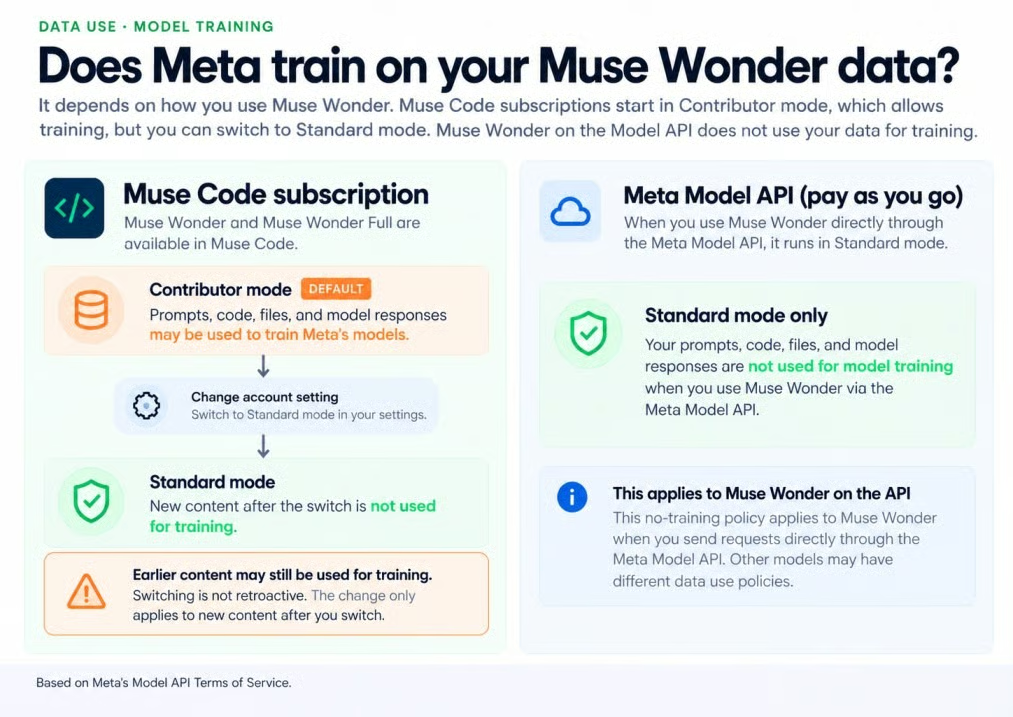
贡献者内容可能用于训练 Meta 模型。来源:Meta 条款;图片由作者制作。
条款还规定,您在贡献者模式下“不得提交敏感、机密或个人信息”,包括私有代码。按次付费 API 下的常规版 Muse Wonder 仅在标准模式中运行。
Meta 按其超级智能扩展框架测试了 Muse Wonder Full。若无防护,Meta 不排除其在化学与生物威胁方面达到高风险级别;在有防护的情况下,Meta 将各风险领域评为“中等或以下”。
风险评级并非安全保证,更详尽的安全报告仍将“很快”发布。模型卡的建议很直接:对不可撤销的操作要求人工确认,并将代理置于权限受限的沙盒中。
X 平台上的首日反馈在快速进步、不稳定表现与对使用限额的抱怨之间分化。这些都是短期试用与个人观感,并非对照评估。
较为谨慎的正面观点来自一位早期测试者,他的试用时间有限,但认为表现不错。更大的看点是,Meta 的模型自 4 月的 Muse Spark 以来进步明显。
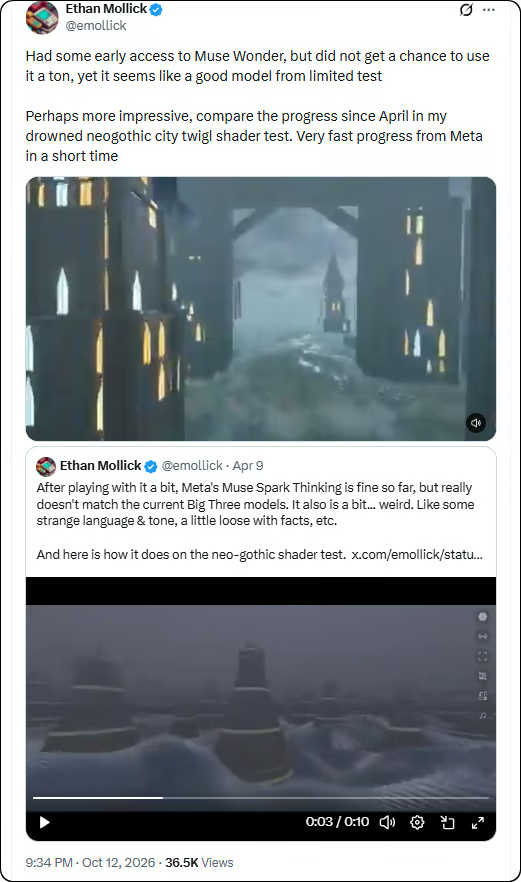
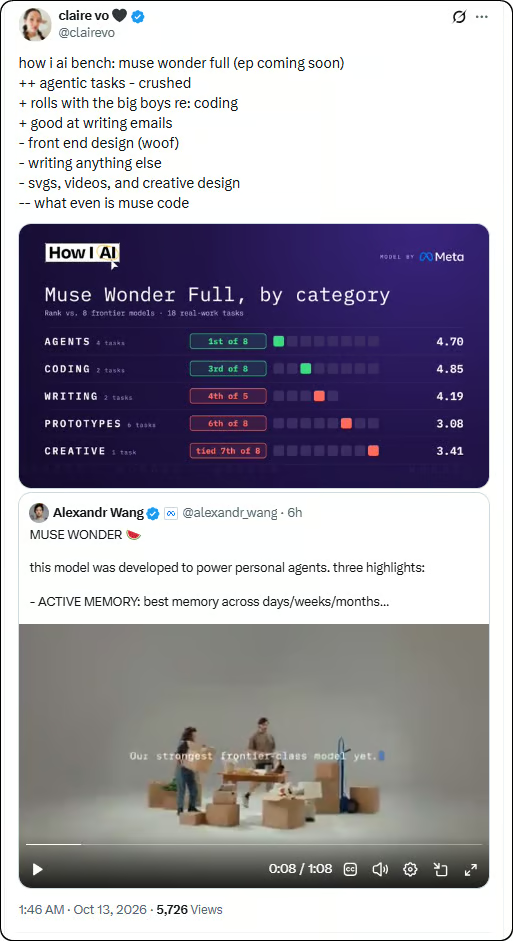
更广泛的类别测试则不那么整齐。Muse Wonder Full 在代理与编码方面接近顶尖,但在写作、前端设计与创意工作上落后。
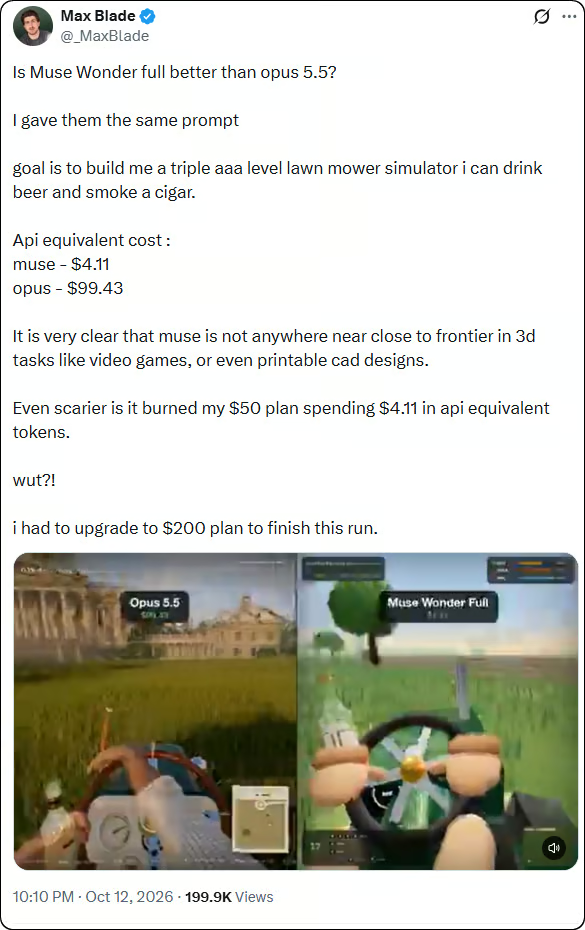
最尖锐的抱怨集中在成本与方案限额。在一次相同提示的割草机测试中,Muse Wonder Full 消耗了约 $4.11 的等价 API token,但 3D 结果弱于 Claude Opus 5.5,而且测试者称要完成任务需从 $50 方案升级到 $200 方案。
综合来看,这些帖文表明 Muse Wonder 具备竞争力但表现不均衡。在将任何单次结果视为常态前,还需要更多重复测试。
目前的发布证据仍主要来自 Meta。本次未提供 Muse Wonder Full 的按次 API,而常规版 Muse Wonder 的价格与 Claude Opus 5.5 相同,却在多项测试上落后。
我会将常规版 Muse Wonder 用于 API 代理,将 Muse Wonder Full 用于长时仓库工作;保留 Claude Opus 5.5 处理终端工作或从零构建程序;当成本决定取舍时,使用 GPT-6.1 Sol 或 Claude Sonnet 5.5。
与 DataCamp 一起学习
{count, plural, other {课程}}
{count, plural, other {课程}}
{count, plural, other {课程}}