{count, plural, one {Corso} other {Corsi}}
Concetti sui Large Language Models (LLM)
{hours} ore
112.2K
Questa settimana, Meta ha rilasciato Muse Wonder e Muse Wonder Full, la sua prima grande famiglia di modelli dopo Muse Spark. Entrambi sono pensati per agenti AI che gestiscono lavori multi-step.
Il post di lancio di Meta definisce Muse Wonder il risultato di una ricostruzione di 14 mesi del suo lavoro sull'AI. I due nuovi termini da conoscere sono Active Memory, che richiama dettagli utili da conversazioni passate, e Active Focus, che continua a lavorare quando un'attività si blocca.
Il Muse Wonder standard è disponibile tramite la Meta Model API e Muse Code, mentre Muse Wonder Full, il modello dietro la maggior parte dei risultati di punta, gira solo in Muse Code nei suoi due piani più costosi. Su tutto questo entreremo più nel dettaglio dopo.
Ecco cosa mi porto a casa dal lancio:
Muse Wonder e Muse Wonder Full sono modelli di ragionamento che Meta definisce i più capaci finora, costruiti per agenti che gestiscono attività personali e lavorative. La model card elenca input di testo, immagini, video e audio e output solo testuale, quindi nessuno dei due modelli genera immagini, video o audio. Le doc per sviluppatori aggiungono input PDF e fissano la finestra di contesto a 1.048.576 token.
Il blog di ricerca di Meta afferma che entrambi si basano sul lavoro di training di Muse Spark e sono stati addestrati nel data center Prometheus di Meta. Non ci sono conteggi dei parametri.
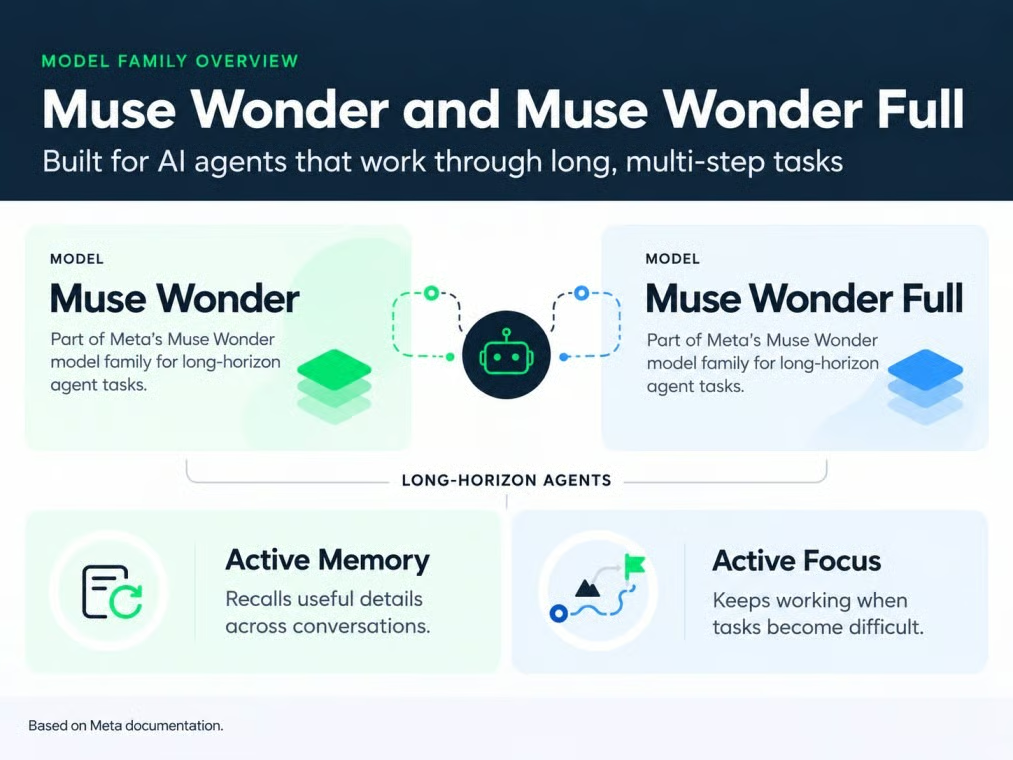
Muse Wonder è disponibile in due varianti. Immagine dell'autore.
Tra i due, Muse Wonder Full è un modello separato e più capace. Le doc per sviluppatori dicono che portare Muse Wonder standard (muse-wonder-1.0) a "max" ragionamento non lo trasforma in Muse Wonder Full (muse-wonder-full-1.0).
Avrai notato che Meta usa il nome Muse per diverse cose. Ricapitolando:
Quando Meta dice che Muse Wonder "fa" qualcosa, spesso Muse Code svolge metà del lavoro. Questo vale per la maggior parte dei risultati di coding qui sotto.
Le caratteristiche principali di Muse Wonder sono Active Memory e Active Focus, e i lavori di coding lunghi sono dove Meta le mette in mostra. L'idea alla base di entrambe è semplice: un agente deve ricordare i dettagli giusti e continuare quando un piano fallisce.
Active Memory è il termine di Meta per portare con sé dettagli importanti tra conversazioni e recuperare quelli di cui ha bisogno ora. Metti che imposti un budget per l'home office di $3.000 a marzo, lo alzi a $4.000 ad aprile e chiedi una shortlist di mobili a maggio. Una buona memoria significa che l'agente usa la cifra di aprile senza promemoria.
La prova di Meta è MemoryBench, il suo test di conversazioni lunghe con fatti aggiornati. Muse Wonder ottiene 85,6, ma questo non dice nulla sul richiamo a distanza di mesi, e un'app costruita sull'API deve comunque archiviare quei fatti. È la funzione che mi incuriosisce di più, perché un agente che lavora con un budget vecchio può costarti denaro.
Active Focus è il nome di Meta per la perseveranza: provare un altro approccio, superare i blocchi e fare check-in prima di azioni importanti. Immagina una migrazione di codice in cui 30 test falliscono. Un agente focalizzato corregge il codice e rilancia i test, mentre uno più debole modifica solo i test per farli passare.
Meta misura questo con FocusBench, un altro dei suoi test, e con SWE-Marathon, di cui parlerò nella sezione benchmark. Nessuno dei due garantisce il completamento del compito, e lavorare in background dipende dal software intorno al modello, un rischio che il nostro approfondimento su OpenAI Dots copre per gli agenti always-on.
Muse Wonder pianifica lavori di coding lunghi e suddivide il lavoro tra agenti di supporto, mentre Muse Code esegue gli strumenti e le approvazioni. La pagina per sviluppatori di Meta lo propone per attività che "durano ore", con molti file modificati in parallelo.
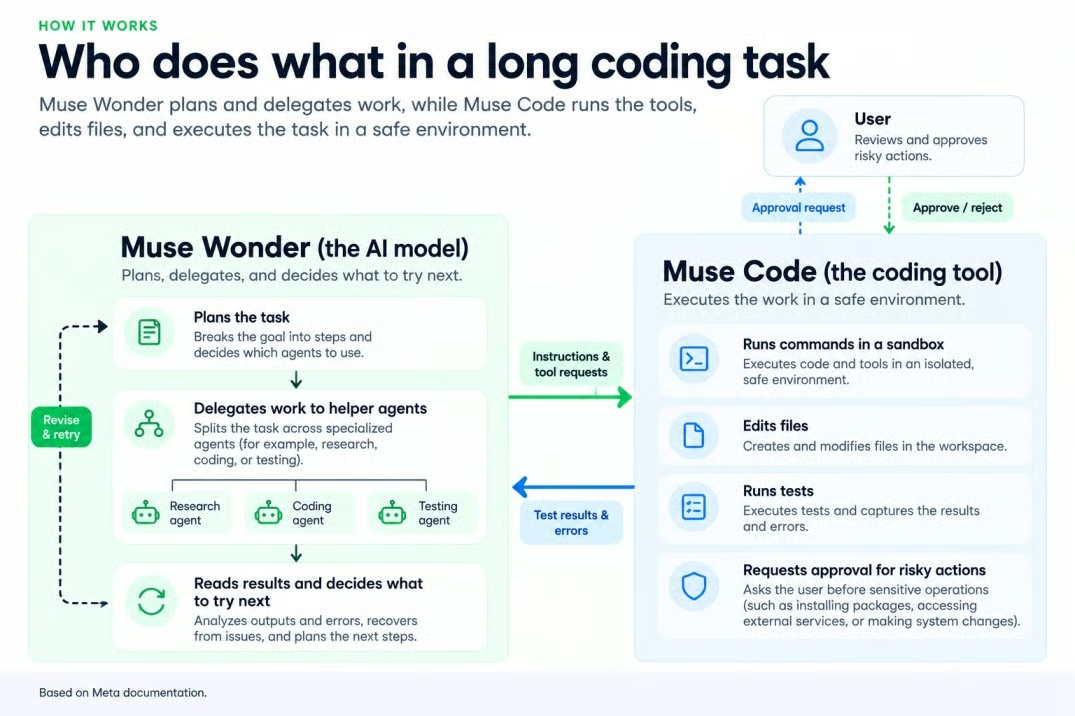
Muse Wonder pianifica; Muse Code esegue. Immagine dell'autore.
Una delle demo di Meta è un gioco 3D giocabile in cucina costruito da immagini. È una scelta curiosa, dato che la model card elenca il ragionamento 3D come una debolezza nota (io avrei scelto un'altra demo).
La tabella di Meta favorisce Muse Wonder Full nei compiti di coding lunghi e in alcuni benchmark professionali, mentre Claude Opus 5.5 guida nel coding da terminale e nella costruzione di programmi da zero. I numeri qui sotto sono di Meta salvo diversa indicazione, con quasi tutti i modelli alla massima impostazione di ragionamento (segnalerò l'unica eccezione).
Muse Wonder Full è in cima a entrambi i test di coding lunghi nella tabella di Meta. Come detto nell'intro, ottiene 79,0 su DeepSWE v1.1, con Muse Wonder standard subito dietro a 78,8. Per ora sono numeri di Meta, perché la leaderboard pubblica DeepSWE di Datacurve non elenca ancora Muse Wonder.
SWE-Marathon è quello che terrei d'occhio, perché i suoi 20 progetti di più ore valgono zero se fallisce anche un solo test. Meta riporta Muse Wonder Full a 57,5 (un gradino sotto la sua impostazione più alta) e Muse Wonder a 53,1, contro 46,3 per Claude Opus 5.5 e 42,5 per GPT-6 Astra. I modelli rivali sono stati eseguiti all'interno dei rispettivi strumenti di coding aziendali, quindi la stessa Meta dice che il confronto non è del tutto equo, e con solo 20 progetti, un progetto può spostare il punteggio di parecchi punti.
La leaderboard di Abundant AI per SWE-Marathon è più prudente: Muse Wonder Full al 53,1% e Muse Wonder standard al 52,5%, entrambi alla massima impostazione in Muse Code, appena davanti a Claude Sonnet 5.5 al 51,3%. Claude Haiku 5.5, rilasciato da Anthropic cinque giorni prima, è al 50,0%. Le due liste derivano da test separati, quindi non mischiarle.
L'affermazione di Meta che Muse Wonder può svolgere lavoro tra app ottiene un supporto misto. Su AutomationBench-AA, che verifica se i workflow aziendali finiscono nello stato corretto, Muse Wonder Full segna 45,4 contro 41,6 per GPT-6 Astra e 41,2 per Claude Opus 5.5, quindi è in testa pur fallendo la maggior parte dei workflow.
OSWorld V2.1, un set di 108 compiti desktop, è più indicativo. Muse Wonder Full ottiene 78,4 come credito parziale ma completa interamente solo il 39,4% dei compiti, e entrambi i modelli Claude superano il suo punteggio parziale. Per un modulo assicurativo, azzeccare la maggior parte dei passaggi è comunque un compito fallito, quindi il 39,4% è il numero da guardare.
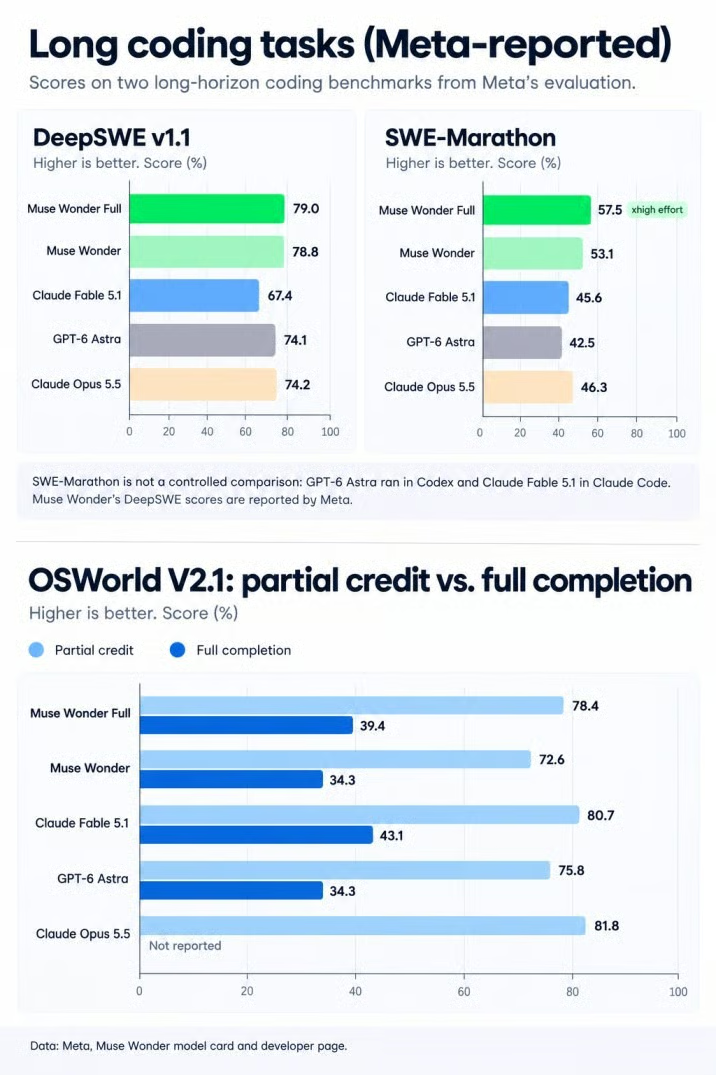
I vantaggi nel coding nascondono tassi di completamento più bassi. Fonte: Meta; immagine dell'autore.
Muse Wonder Full guida il benchmark legale e resta indietro in quello sanitario, con la finanza quasi in parità. Il suo punteggio legale sembra minuscolo, ed è comunque tre volte quello di Claude Opus 5.5. Nella versione di Artificial Analysis, un documento legale conta solo se soddisfa ogni requisito senza contenuti inventati, e Muse Wonder Full ottiene 13,1 contro 4,2 di Claude Opus 5.5, il che significa comunque fallire circa l'87% dei compiti.
La finanza è quasi in parità, con Muse Wonder Full a 59,1 su Vals Finance Agent V2 contro 58,6 per Claude Opus 5.5. La salute va al contrario: Muse Wonder Full ottiene 62,3 su HealthBench Pro, dietro a Claude Opus 5.5 (65,6) e GPT-6 Astra (65,3).
Muse Wonder Full è dietro a Claude Opus 5.5 in sei dei 14 test nella tabella di Meta stessa, e GPT-6 Astra lo supera in tre. Questa tabella raccoglie le sconfitte non coperte sopra.
|
Benchmark |
Cosa testa |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Coding da terminale |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Creazione di programmi da zero |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Ampio composito |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Uso di strumenti professionali |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Lavoro da PDF |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Fonte: pagina per sviluppatori di Muse Wonder al lancio. Tutti i modelli alla massima impostazione di ragionamento.
ProgramBench è la sconfitta che dovrebbe interessare ai coder, e non è ravvicinata. Chiede ai modelli di ricostruire un programma da zero, e un divario di 11,5 punti mostra che modificare un codice esistente e costruire dal niente sono abilità diverse.
Artificial Analysis riporta Muse Wonder Full a 55,8, che la tabella di Meta arrotonda a 56, mentre Claude Sonnet 5.5 ottiene 56,0.
Ci si può fidare dei risultati di benchmark di Muse Wonder? Non del tutto. La model card di Meta mostra che la tabella mescola tre tipi di evidenza:
Come notato, quasi ogni punteggio usa la massima impostazione di ragionamento, quindi stai vedendo ogni modello al suo meglio. I risultati variano anche in base al tester: Anthropic riporta il 66,4% per Claude Opus 5.5 su Terminal-Bench 4.0, contro 59,6 nella tabella di Meta. L'affermazione di Meta che Muse Wonder Full gestisca meglio i compiti non familiari rispetto ai modelli Spark si basa sulla sua analisi.
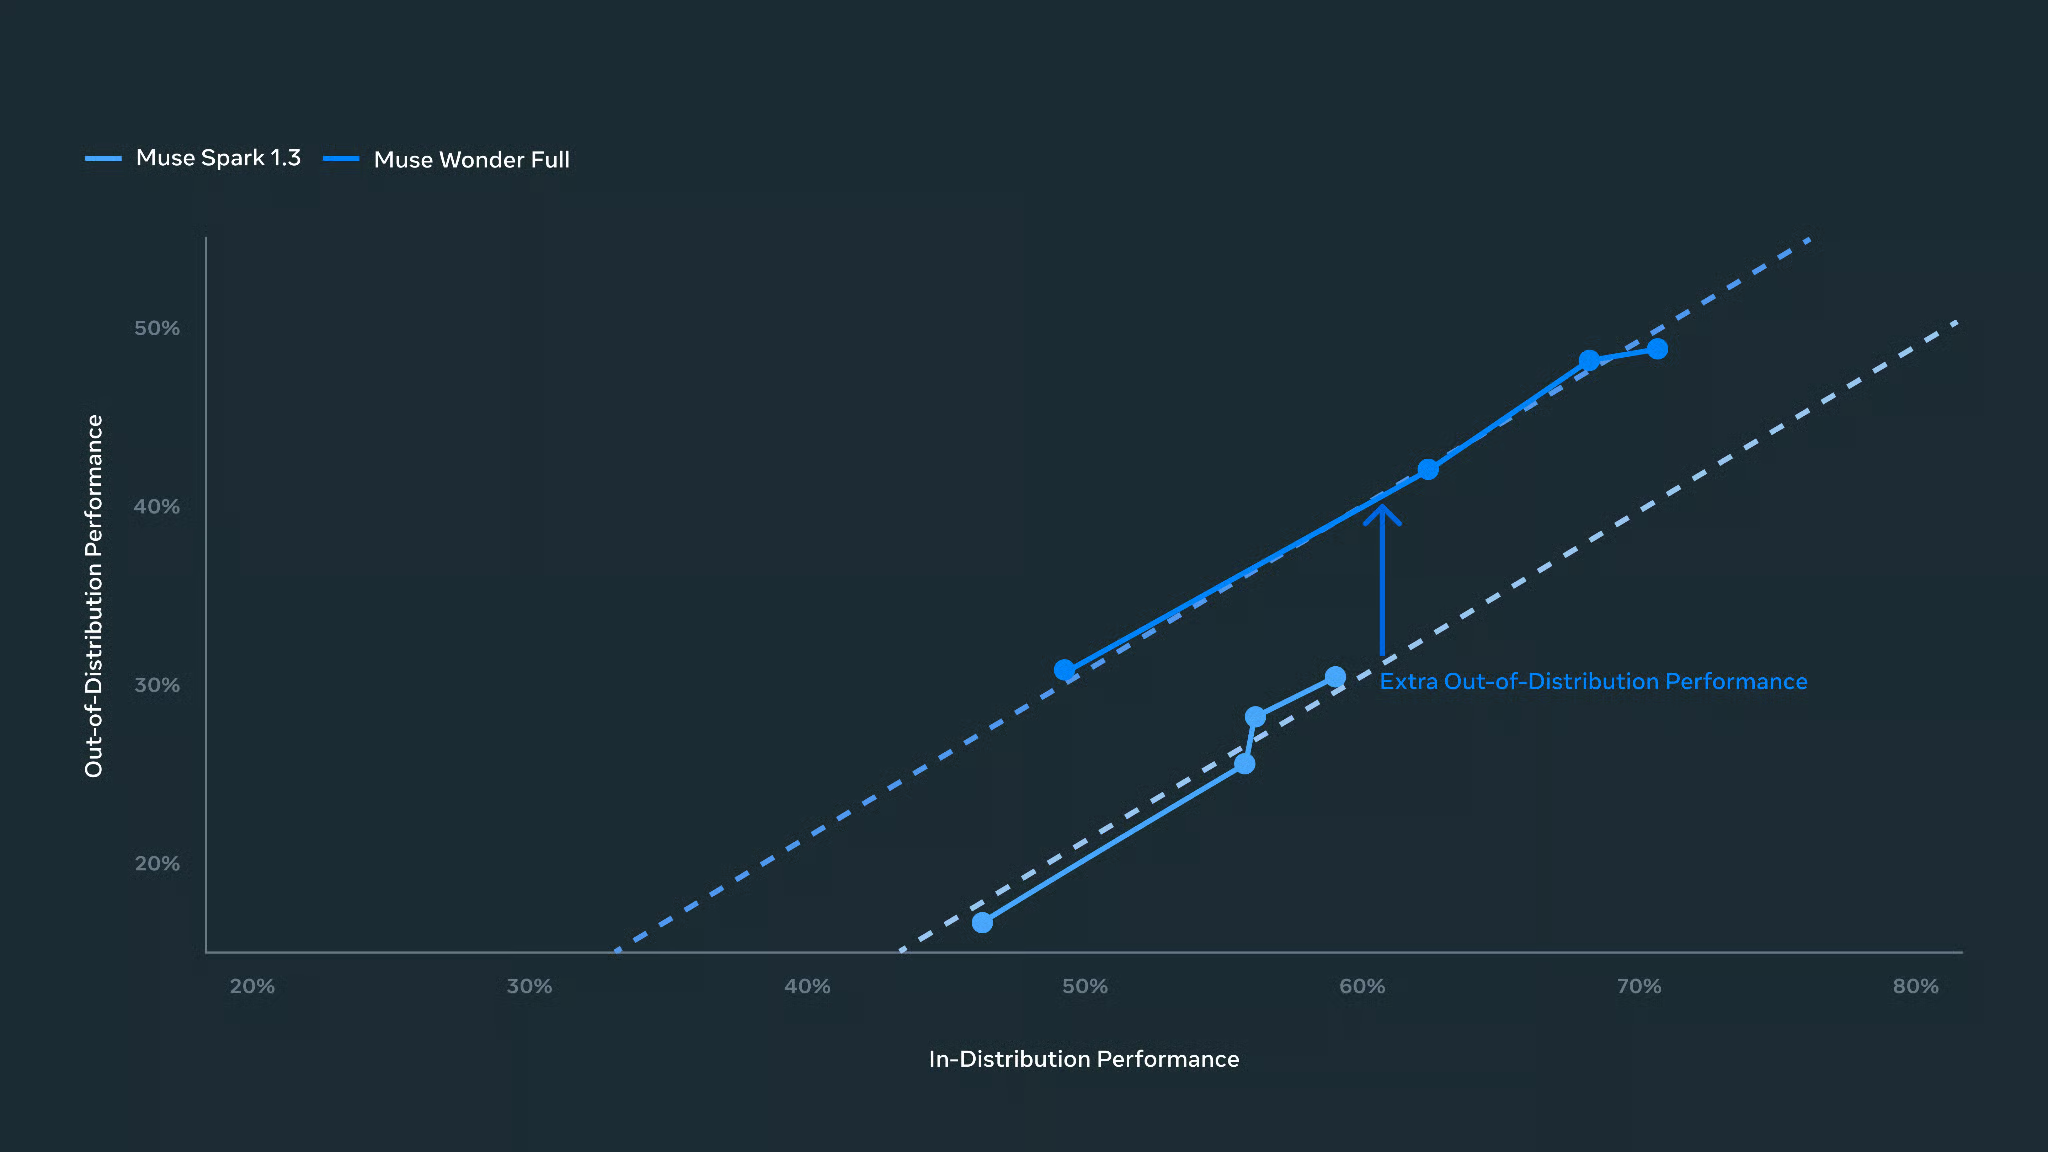
Meta confronta le prestazioni su compiti non familiari. Fonte: Meta.
Secondo i numeri di Meta, Muse Wonder Full vince i lavori di coding lunghi (ma solo dentro Muse Code), Claude Opus 5.5 vince il lavoro da terminale e la costruzione da zero, e GPT-6 Astra è in cima solo a una riga della tabella di Meta. Questa parte riunisce i benchmark, quindi suonerà familiare.
L'automazione è divisa, dato che Muse Wonder Full guida AutomationBench-AA mentre i modelli Claude guidano su OSWorld per credito parziale. Tra i modelli con un punteggio di completamento pieno riportato, nessuno completa la maggior parte dei compiti. Sul ragionamento ampio, Claude Opus 5.5 guida l'indice di Artificial Analysis, dove Muse Wonder standard segna 52,4.
Il prezzo è dove Muse Wonder standard sembra più debole. GPT-6.1 Sol costa la metà per token e segna 51,8 sullo stesso indice, e Claude Sonnet 5.5 costa quanto GPT-6.1 Sol.
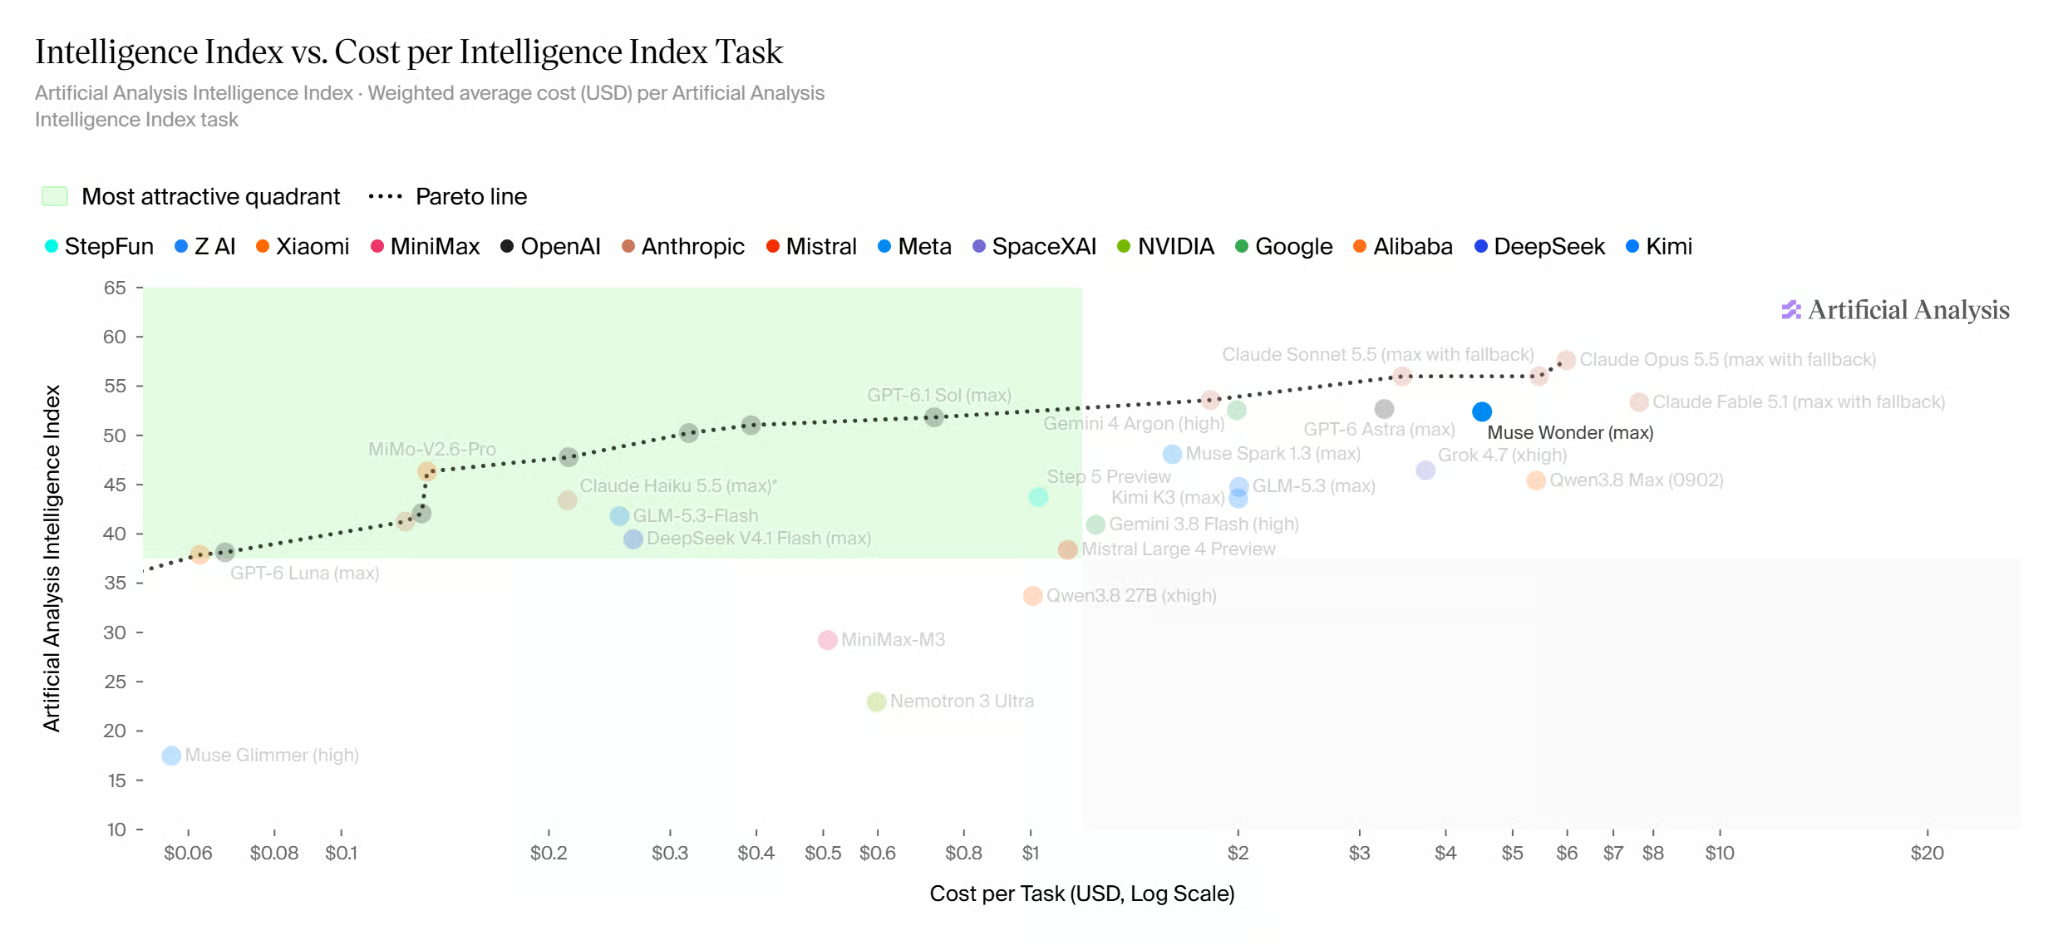
Muse Wonder scambia costo contro intelligenza. Fonte: Artificial Analysis.
Stavo quasi per lasciare fuori Gemini 4 Argon, perché Meta non l'ha testato e, come segnaliamo nella copertura di Gemini 4 Argon, è andato prima a team di cybersecurity di fiducia. Senza risultati condivisi non c'è un confronto testa a testa equo, quindi scegli in base al carico di lavoro e al costo di portare a termine un compito.
Muse Wonder si adatta meglio a due tipi di lavoro: grandi modifiche software e workflow da browser multi-step. I lavori di pianificazione lunghi, come la demo del tableau per i posti al matrimonio di Meta, dipendono più dall'app intorno al modello.
Questo caso d'uso ha le prove più solide, almeno per modificare codice già esistente. In Muse Code, Muse Wonder lavora tra file, esegue test, legge i fallimenti e riprova: esattamente ciò che misurano DeepSWE e SWE-Marathon. Su codice reale, concedigli solo i permessi necessari al compito e fai revisionare le modifiche a una persona.
La demo Saturday Run Planning di Meta mostra Muse Wonder che "lavora direttamente in un browser e tra app", e un'altra demo gestisce una pratica assicurativa. Dato che Muse Wonder Full completa interamente meno di 4 compiti desktop su 10, un workflow reale richiede la tua approvazione prima di inviare o pagare qualsiasi cosa.
Paghi Muse Wonder in due modi: a token per Muse Wonder standard, oppure con un piano mensile flat di Muse Code, che, come detto nell'intro, è l'unico modo per ottenere Muse Wonder Full.
La pagina prezzi di Meta elenca Muse Wonder standard a $4,00 per milione di token in input, $0,20 per l'input in cache e $20,00 per l'output. È un grande salto rispetto a $1,25 e $4,25 di Muse Spark 1.3, e coincide con i prezzi di Claude Opus 5.5, il che indica dove Meta posiziona Muse Wonder.
GPT-6 Astra è listato a $10, $1 in cache e $50, e GPT-6.1 Sol a $2, $0,10 e $10. L'ipotesi qui sotto applica quei prezzi del giorno di lancio a un compito di coding con 3 milioni di token in input (2,4 milioni in cache) e 200.000 token in output, assumendo che nessuna singola richiesta superi i 272.000 token, soglia oltre la quale i prezzi di GPT-6 Astra aumentano.
|
Modello |
Input non in cache (0,6M) |
Input in cache (2,4M) |
Output (0,2M) |
Totale per task |
|
Muse Wonder |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
Claude Opus 5.5 |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
GPT-6 Astra |
$6,00 |
$2,40 |
$10,00 |
$18,40 |
|
GPT-6.1 Sol |
$1,20 |
$0,24 |
$2,00 |
$3,44 |
Prezzi per token uguali significano conti uguali per tentativo, quindi il numero da confrontare è il costo per compito completato. Se Muse Wonder finisce una volta su due, sono $13,76, lo stesso di un modello ai prezzi di GPT-6.1 Sol che finisce una volta su quattro (entrambi i tassi inventati per l'esempio).
Muse Wonder Full è disponibile solo con i piani mensili di Muse Code, che addebitano una tariffa flat invece che a token. Puoi saltare questa parte se prevedi di usare solo l'API. La documentazione sugli abbonamenti di Meta elenca quattro piani:
La pagina prodotto di Muse Code mostra prezzi solo per Power e Maximum, cosa curiosa da omettere, quindi verifica i piani inferiori al checkout. Muse Wonder standard è presente in ogni piano.
Ogni piano ha un limite di utilizzo che si resetta nel tempo. Le quote non utilizzate non si accumulano e l'abbonamento non può essere usato come credito API.
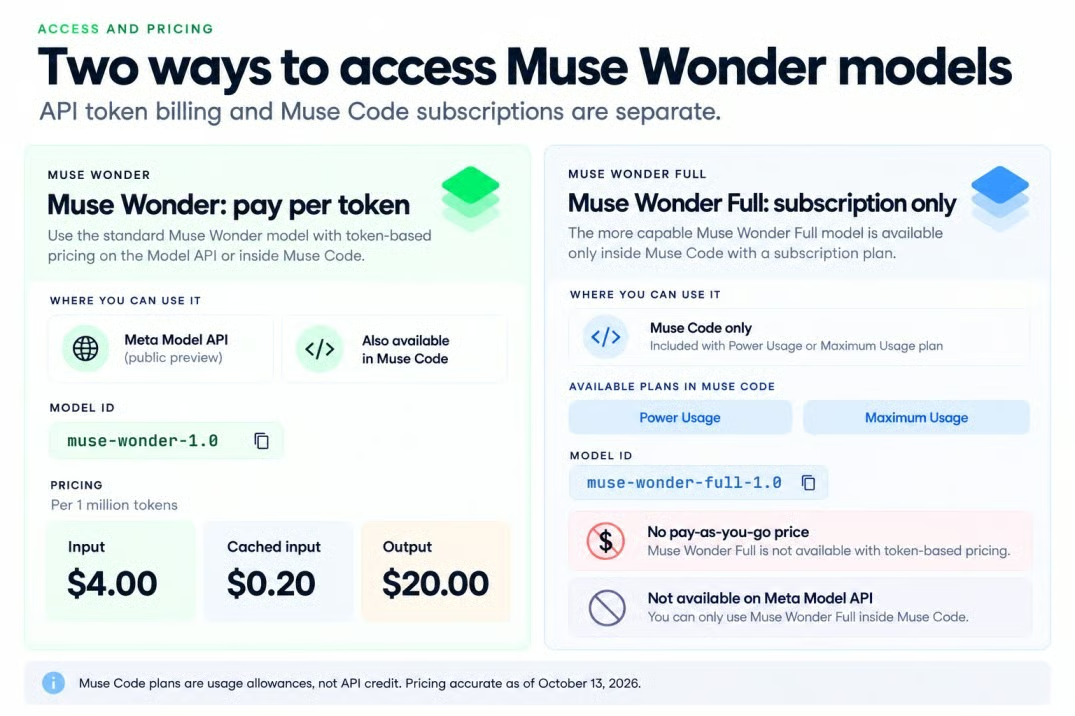
I prezzi di Muse Wonder seguono due percorsi. Fonte: Meta; immagine dell'autore.
Power è il modo più economico per provare Muse Wonder Full, anche se Meta non ha detto quante attività grandi copra la sua allocazione. È la parte che terrei d'occhio, dato che un utente iniziale ha detto che alcune richieste piccole hanno usato circa metà del limite di 5 ore di un piano d'ingresso, come tratterò nelle reazioni degli sviluppatori.
Ricapitolando la divisione dell'intro: Muse Wonder standard è disponibile tramite la Meta Model API e Muse Code, e Muse Wonder Full solo tramite Muse Code.
Per usare l'API di Muse Wonder ti serve un account sviluppatore Meta, una chiave API e la fatturazione, e l'ID del modello è muse-wonder-1.0. Meta definisce ancora l'API una "public preview" sulla sua pagina prodotto, il codice costruito sullo SDK di OpenAI può essere puntato su di essa, e Meta elenca anche OpenRouter come percorso.
L'accesso non è globale. La Geographic Use Policy di Meta blocca diversi luoghi, tra cui Cina, Russia, Iran, Pakistan, Eritrea ed Etiopia.
Per ottenere Muse Wonder Full ti serve un piano Power o Maximum di Muse Code, un account Meta e avere 18 anni o l'età della maggiore età dove vivi. Come visto nella sezione prezzi, non è disponibile nella Model API a nessun prezzo, e il suo ID, muse-wonder-full-1.0, funziona solo dentro Muse Code. La documentazione di Muse Code elenca macOS, Linux e Windows, anche se la pagina prodotto menziona solo macOS e Windows.
I rischi qui derivano dalle stesse cose che Meta sta promuovendo: esecuzioni lunghe e accesso ai tuoi file privati.
La model card indica tre debolezze che possono influire su un agente. Ognuna causa un problema diverso:
Questi non sono problemi isolati di qualità delle risposte quando il modello può usare strumenti. Un click sbagliato o un presupposto errato all'inizio di un compito di due ore può rovinare il resto.
Dipende dalla modalità, quindi leggi questo prima di puntare Muse Code su un repository privato. I Termini di servizio di Meta, aggiornati tre giorni prima del lancio, affermano che Meta non addestrerà sui contenuti inviati ai suoi Servizi Standard, mentre i contenuti inviati in modalità Contributor possono essere usati per "addestrare, sviluppare, valutare e migliorare" i suoi modelli.
Gli abbonamenti a Muse Code partono in modalità Contributor, in cambio di più utilizzo, e devi passare a Standard nelle impostazioni. Il passaggio vale solo in avanti, quindi tutto ciò che hai già inviato può ancora essere usato per il training. Trovo quel default difficile da apprezzare.
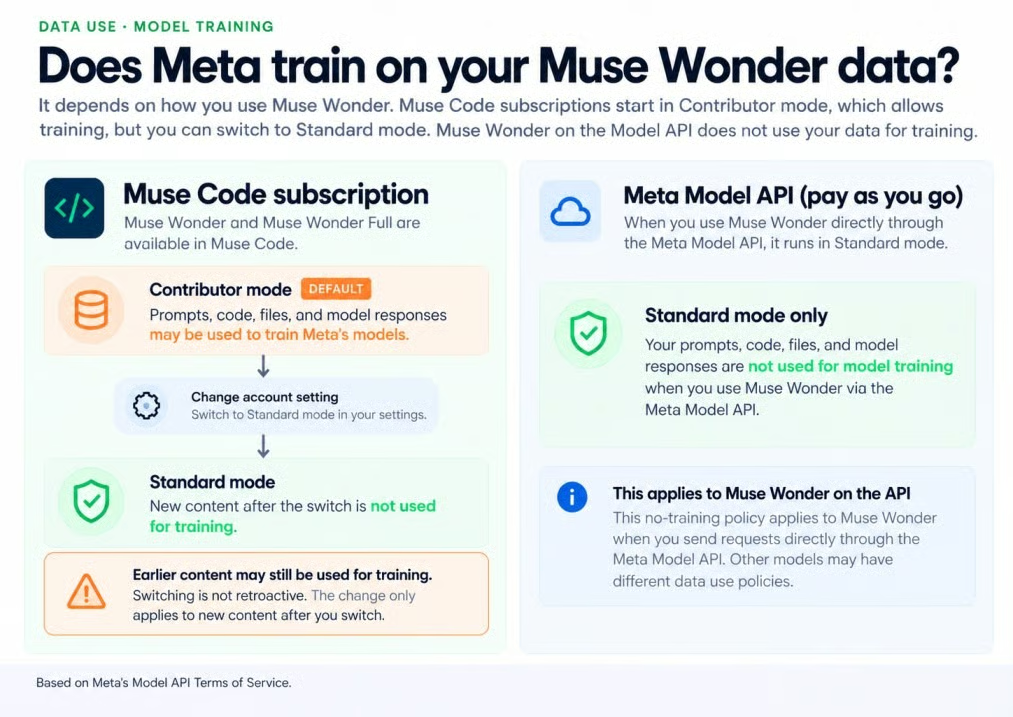
I contenuti dei Contributor possono addestrare i modelli di Meta. Fonte: Termini Meta; immagine dell'autore.
I termini dicono anche che "non devi inviare informazioni sensibili, confidenziali o personali" in modalità Contributor, incluso codice privato. Muse Wonder standard sull'API a consumo gira solo in modalità Standard.
Meta ha testato Muse Wonder Full secondo il suo Superintelligence Scaling Framework. Senza salvaguardie, Meta non esclude che raggiunga il livello ad alto rischio per minacce chimiche e biologiche, e con salvaguardie valuta ogni area di rischio come "moderata o inferiore".
Una valutazione del rischio non è una garanzia di sicurezza, e un rapporto di sicurezza più completo è ancora in arrivo "presto". Il consiglio della model card è semplice: richiedi conferma umana per azioni non reversibili e tieni l'agente in un sandbox con permessi limitati.
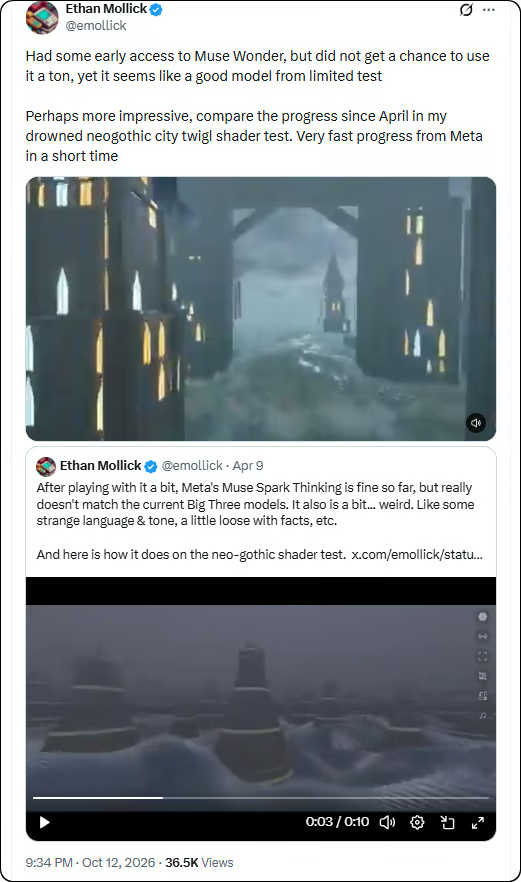
Le reazioni del giorno del lancio su X si dividono tra progressi rapidi, prestazioni irregolari e frustrazione per i limiti dei piani. Si tratta di test brevi e impressioni personali, non valutazioni controllate.
La visione cautamente positiva è arrivata da un tester precoce che ha avuto poco tempo con Muse Wonder ma l'ha trovato promettente. Il punto più grande era quanto i modelli di Meta fossero avanzati rispetto a Muse Spark di aprile.
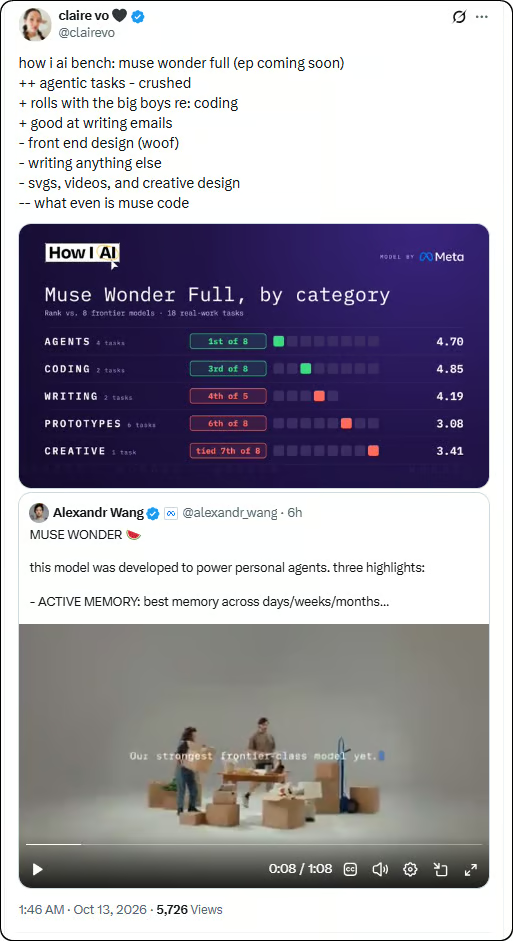
Un test di categoria più ampio ha raccontato una storia meno ordinata. Muse Wonder Full è arrivato vicino alla cima per agenti e coding, ma è rimasto indietro in scrittura, design front-end e lavori creativi.
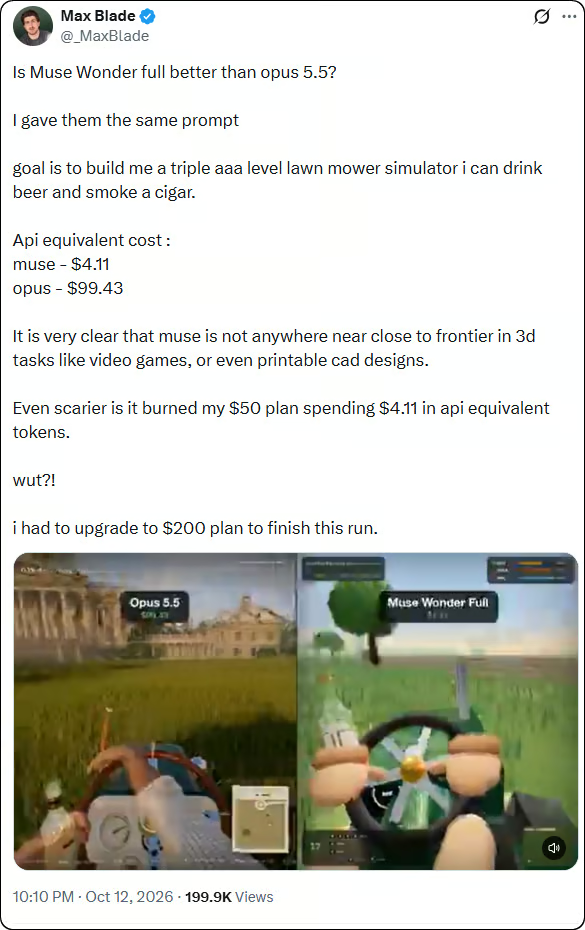
La critica più netta riguardava i costi e i limiti dei piani. In un test identico su un tosaerba, Muse Wonder Full ha usato circa $4,11 in token equivalenti all'API ma ha prodotto un risultato 3D più debole di Claude Opus 5.5, e il tester ha detto che per finire è servito passare dal piano da $50 a quello da $200.
Insieme, i post suggeriscono che Muse Wonder è competitivo ma irregolare. Servono più test ripetuti prima di trattare un singolo risultato come tipico.
La maggior parte delle prove di lancio arriva ancora da Meta. Muse Wonder Full non ha un'API a consumo, e Muse Wonder standard costa quanto Claude Opus 5.5 pur restando indietro in diversi test.
Io testerei Muse Wonder standard per agenti via API e Muse Wonder Full per lavori lunghi su repository. Terrei Claude Opus 5.5 per lavoro da terminale o costruzione di programmi da zero, e userei GPT-6.1 Sol o Claude Sonnet 5.5 quando decide il costo.
Impara con DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min