{count, plural, one {Kurs} other {Kurser}}
Koncept inom stora språkmodeller (LLM)
{hours} tim
112.2K
Den här veckan släppte Meta Muse Wonder och Muse Wonder Full, deras första stora modellsvit efter Muse Spark. Båda är byggda för AI-agenter som hanterar flerstegsuppgifter.
Metas lanseringsinlägg kallar Muse Wonder resultatet av 14 månaders ombyggnad av deras AI-arbete. De två nya begreppen att känna till är Active Memory, som minns användbara detaljer från tidigare konversationer, och Active Focus, som fortsätter arbeta när en uppgift kör fast.
Vanliga Muse Wonder finns via Meta Model API och Muse Code, medan Muse Wonder Full, modellen bakom de flesta rubrikresultat, bara körs i Muse Code på dess två dyraste planer. Vi går in på allt det där senare.
Det här tog jag med mig från lanseringen:
Muse Wonder och Muse Wonder Full är resonemangsmodeller som Meta kallar sina mest kapabla hittills, byggda för agenter som hanterar personliga och arbetsrelaterade uppgifter. Modellkortet listar text-, bild-, video- och ljudinmatning samt endast textutdata, så ingen av modellerna genererar bilder, video eller ljud. Metas utvecklardokumentation lägger till PDF-inmatning och anger kontextfönstret till 1 048 576 token.
Metas forskningsblogg säger att båda bygger vidare på Muse Sparks träningsarbete och tränades i Metas datacenter Prometheus. Inga parameterantal anges.
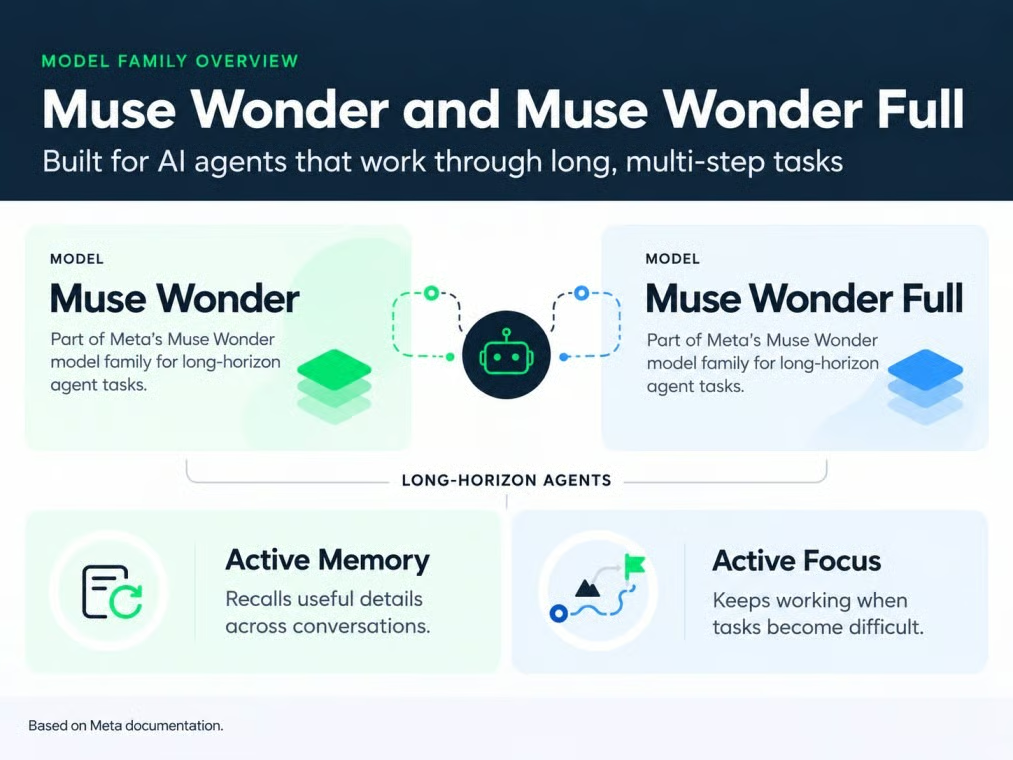
Muse Wonder finns i två varianter. Bild av författaren.
Av de två är Muse Wonder Full en separat, mer kapabel modell. Utvecklardokumentationen säger att att vrida upp vanliga Muse Wonder (muse-wonder-1.0) till "max" resonemang inte växlar över till Muse Wonder Full (muse-wonder-full-1.0).
Du kanske har märkt att Meta använder namnet Muse för flera saker. Sammanfattningsvis:
När Meta säger att Muse Wonder ”gör” något, gör Muse Code ofta halva jobbet. Det gäller för de flesta kodningsresultat nedan.
Muse Wonders nyckelfunktioner är Active Memory och Active Focus, och långa kodningsjobb är där Meta visar upp dem. Idén bakom båda är enkel: en agent måste minnas rätt detaljer och fortsätta när en plan misslyckas.
Active Memory är Metas term för att bära med sig viktiga detaljer mellan konversationer och plocka fram dem som behövs nu. Säg att du sätter en hemmakontorsbudget på 3 000 dollar i mars, höjer den till 4 000 i april och ber om en shortlist för möbler i maj. God minnesförmåga innebär att agenten använder april-siffran utan påminnelse.
Metas belägg är MemoryBench, deras eget test av långa konversationer där fakta uppdateras. Muse Wonder får 85,6 på det, men det säger inget om återkallelse över månader, och en app byggd på API:t måste ändå lagra de där fakta själv. Det här är funktionen jag är mest nyfiken på, eftersom en agent som arbetar utifrån en gammal budget kan kosta dig pengar.
Active Focus är Metas namn för uthållighet: att prova ett annat angreppssätt, arbeta igenom hinder och stämma av före viktiga åtgärder. Föreställ dig en kodmigrering där 30 tester fallerar. En fokuserad agent fixar sin kod och kör om testerna, där en svagare bara ändrar testerna så att de går igenom.
Meta mäter detta med FocusBench, ytterligare ett av deras egna tester, och med SWE-Marathon, som jag kommer till i benchmarkavsnittet. Ingendera garanterar en slutförd uppgift, och bakgrundsarbete beror på programvaran runt modellen, en risk som vår genomgång av OpenAI Dots täcker för alltid-på-agenter.
Muse Wonder planerar långa kodningsjobb och delar upp arbetet mellan hjälpagenter, medan Muse Code kör verktygen och godkännandena. Metas utvecklarsida marknadsför det för uppgifter som ”kör i timmar”, med många filer som redigeras samtidigt.
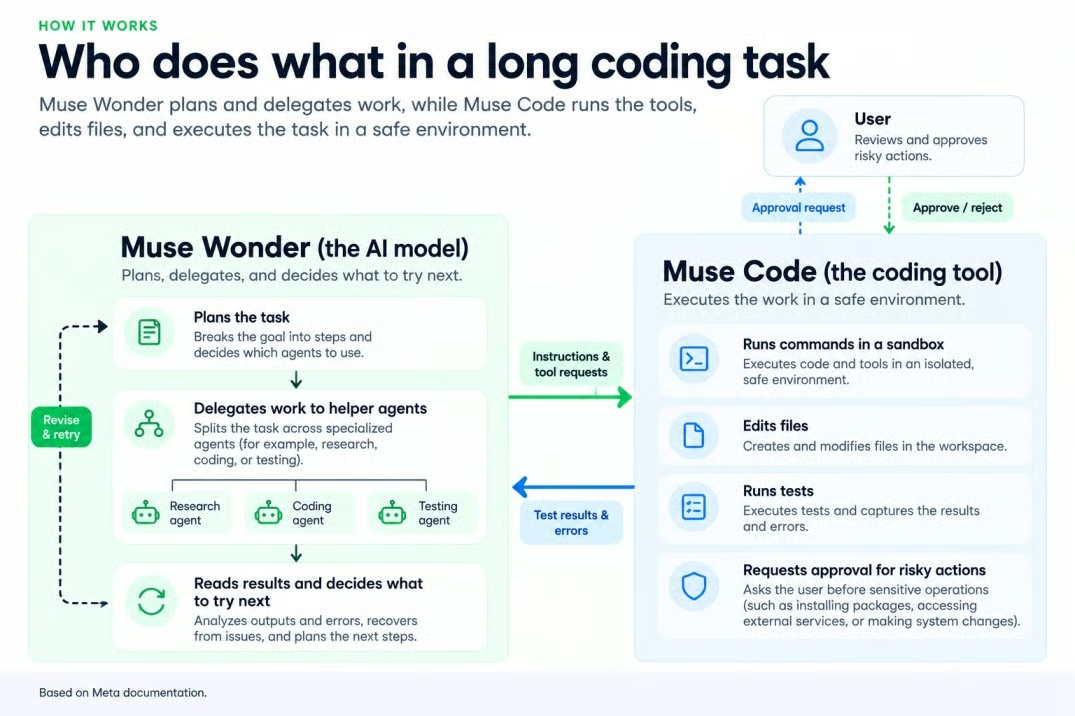
Muse Wonder planerar; Muse Code exekverar. Bild av författaren.
Ett av Metas demoklipp är ett spelbar 3D-kök byggt från bilder. Det är ett märkligt val, eftersom modellkortet listar 3D-resonemang som en känd svaghet (jag hade valt ett annat demo).
Metas tabell gynnar Muse Wonder Full på långa kodningsuppgifter och vissa professionella benchmark, medan Claude Opus 5.5 leder på terminalkodning och att bygga program från grunden. Siffrorna nedan är Metas om inget annat anges, med nästan varje modell på sin högsta resonemangsinställning (jag flaggar undantaget).
Muse Wonder Full toppar båda de långa kodningstesterna i Metas tabell. Som jag nämnde i inledningen får den 79,0 på DeepSWE v1.1, med vanliga Muse Wonder strax bakom på 78,8. Det är Metas siffror för nu, eftersom Datacurves offentliga DeepSWE-topplista ännu inte listar Muse Wonder.
SWE-Marathon är den jag skulle hålla ögonen på, eftersom dess 20 flertimmarsprojekt ger noll om ett enda test misslyckas. Meta rapporterar Muse Wonder Full på 57,5 (ett hack under dess högsta inställning) och Muse Wonder på 53,1, mot 46,3 för Claude Opus 5.5 och 42,5 för GPT-6 Astra. Rivalmodeller kördes i sina egna företags kodverktyg, så Meta säger själv att jämförelsen inte är helt rättvis, och med bara 20 projekt kan ett projekt flytta en poäng med flera enheter.
Abundant AIs egen SWE-Marathon-topplista tonar ner det: Muse Wonder Full på 53,1 % och vanliga Muse Wonder på 52,5 %, båda på sin högsta inställning i Muse Code, precis före Claude Sonnet 5.5 på 51,3 %. Claude Haiku 5.5, som Anthropic släppte fem dagar tidigare, ligger på 50,0 %. De två listorna kommer från separata tester, så blanda dem inte.
Metas påstående att Muse Wonder kan utföra arbete över appar får blandat stöd. På AutomationBench-AA, som kontrollerar om affärsarbetsflöden landar i rätt tillstånd, får Muse Wonder Full 45,4 mot 41,6 för GPT-6 Astra och 41,2 för Claude Opus 5.5, så den leder samtidigt som den fortfarande misslyckas på de flesta arbetsflöden.
OSWorld V2.1, en uppsättning av 108 skrivbordsuppgifter, säger mer. Muse Wonder Full får 78,4 i delkredit men slutför fullt ut bara 39,4 % av uppgifterna, och båda Claude-modellerna slår dess delkredit. För en försäkringsblankett är att få de flesta steg rätt fortfarande en misslyckad uppgift, så 39,4 % är siffran att hålla koll på.
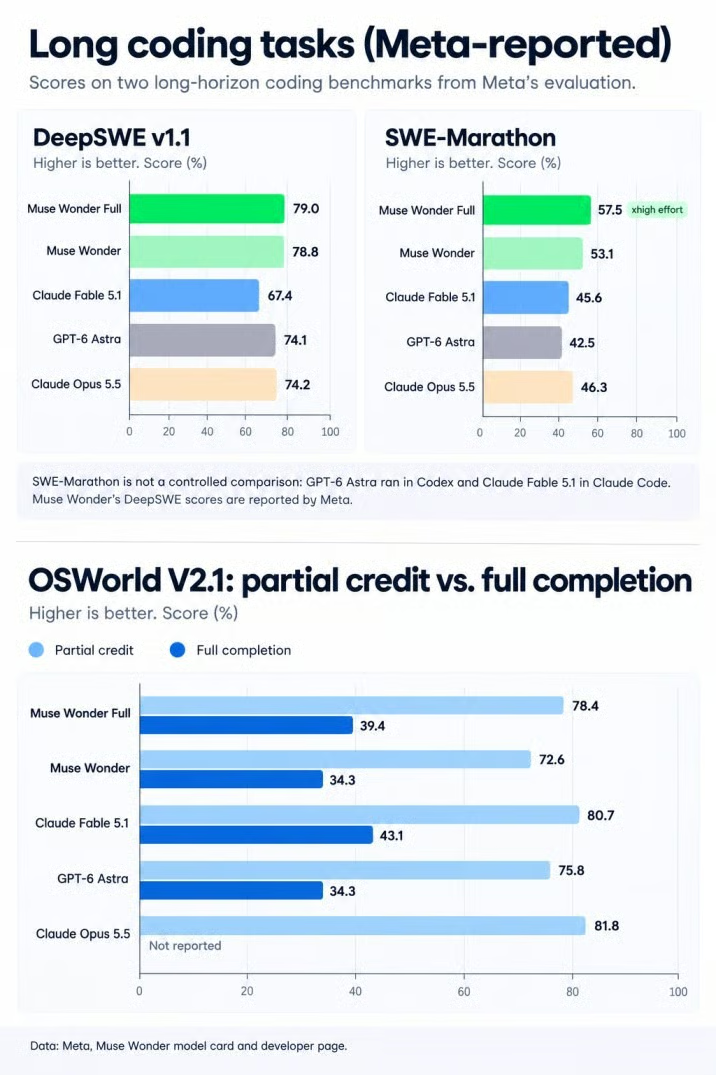
Ledning i kodning döljer lägre slutförandegrad. Källa: Meta; bild av författaren.
Muse Wonder Full leder det juridiska benchmarktestet och ligger efter inom hälsa, med finans nära oavgjort. Dess juridiska poäng låter liten, och den är ändå tre gånger Claude Opus 5.5:s. I Artificial Analysis version räknas ett juridiskt dokument bara om det uppfyller varje krav utan påhittat innehåll, och Muse Wonder Full får 13,1 mot 4,2 för Claude Opus 5.5, vilket fortfarande betyder misslyckande på cirka 87 % av uppgifterna.
Finans är nästan oavgjort, med Muse Wonder Full på 59,1 på Vals Finance Agent V2 mot 58,6 för Claude Opus 5.5. Hälsa går åt andra hållet: Muse Wonder Full får 62,3 på HealthBench Pro, efter Claude Opus 5.5 (65,6) och GPT-6 Astra (65,3).
Muse Wonder Full ligger efter Claude Opus 5.5 på sex av de 14 testerna i Metas egen tabell, och GPT-6 Astra slår den på tre. Den här tabellen samlar förlusterna som inte täcks ovan.
|
Benchmark |
Vad det testar |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Terminalkodning |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Bygga program från grunden |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Brett kompositmått |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Professionell verktygsanvändning |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Arbete från PDF:er |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Källa: Metas Muse Wonder-utvecklarsida vid lansering. Alla modeller på sin högsta resonemangsinställning.
ProgramBench är den förlust som kodare bör bry sig om, och den är inte jämn. Den ber modeller återskapa ett program från grunden, och ett glapp på 11,5 poäng visar att att redigera en befintlig kodbas och att bygga från noll är olika färdigheter.
Artificial Analysis listar Muse Wonder Full på 55,8, vilket Metas tabell avrundar till 56, medan Claude Sonnet 5.5 får 56,0.
Kan du lita på Muse Wonders benchmarkresultat? Inte fullt ut. Metas modellkort visar att tabellen blandar tre sorters underlag:
Som jag noterade tidigare använder nästan varje poäng den högsta resonemangsinställningen, så du ser varje modell när den är som bäst. Resultat skiftar också med testaren: Anthropic rapporterar 66,4 % för Claude Opus 5.5 på Terminal-Bench 4.0, mot 59,6 i Metas tabell. Metas påstående att Muse Wonder Full hanterar obekanta uppgifter bättre än Spark-modellerna vilar på deras egen analys.
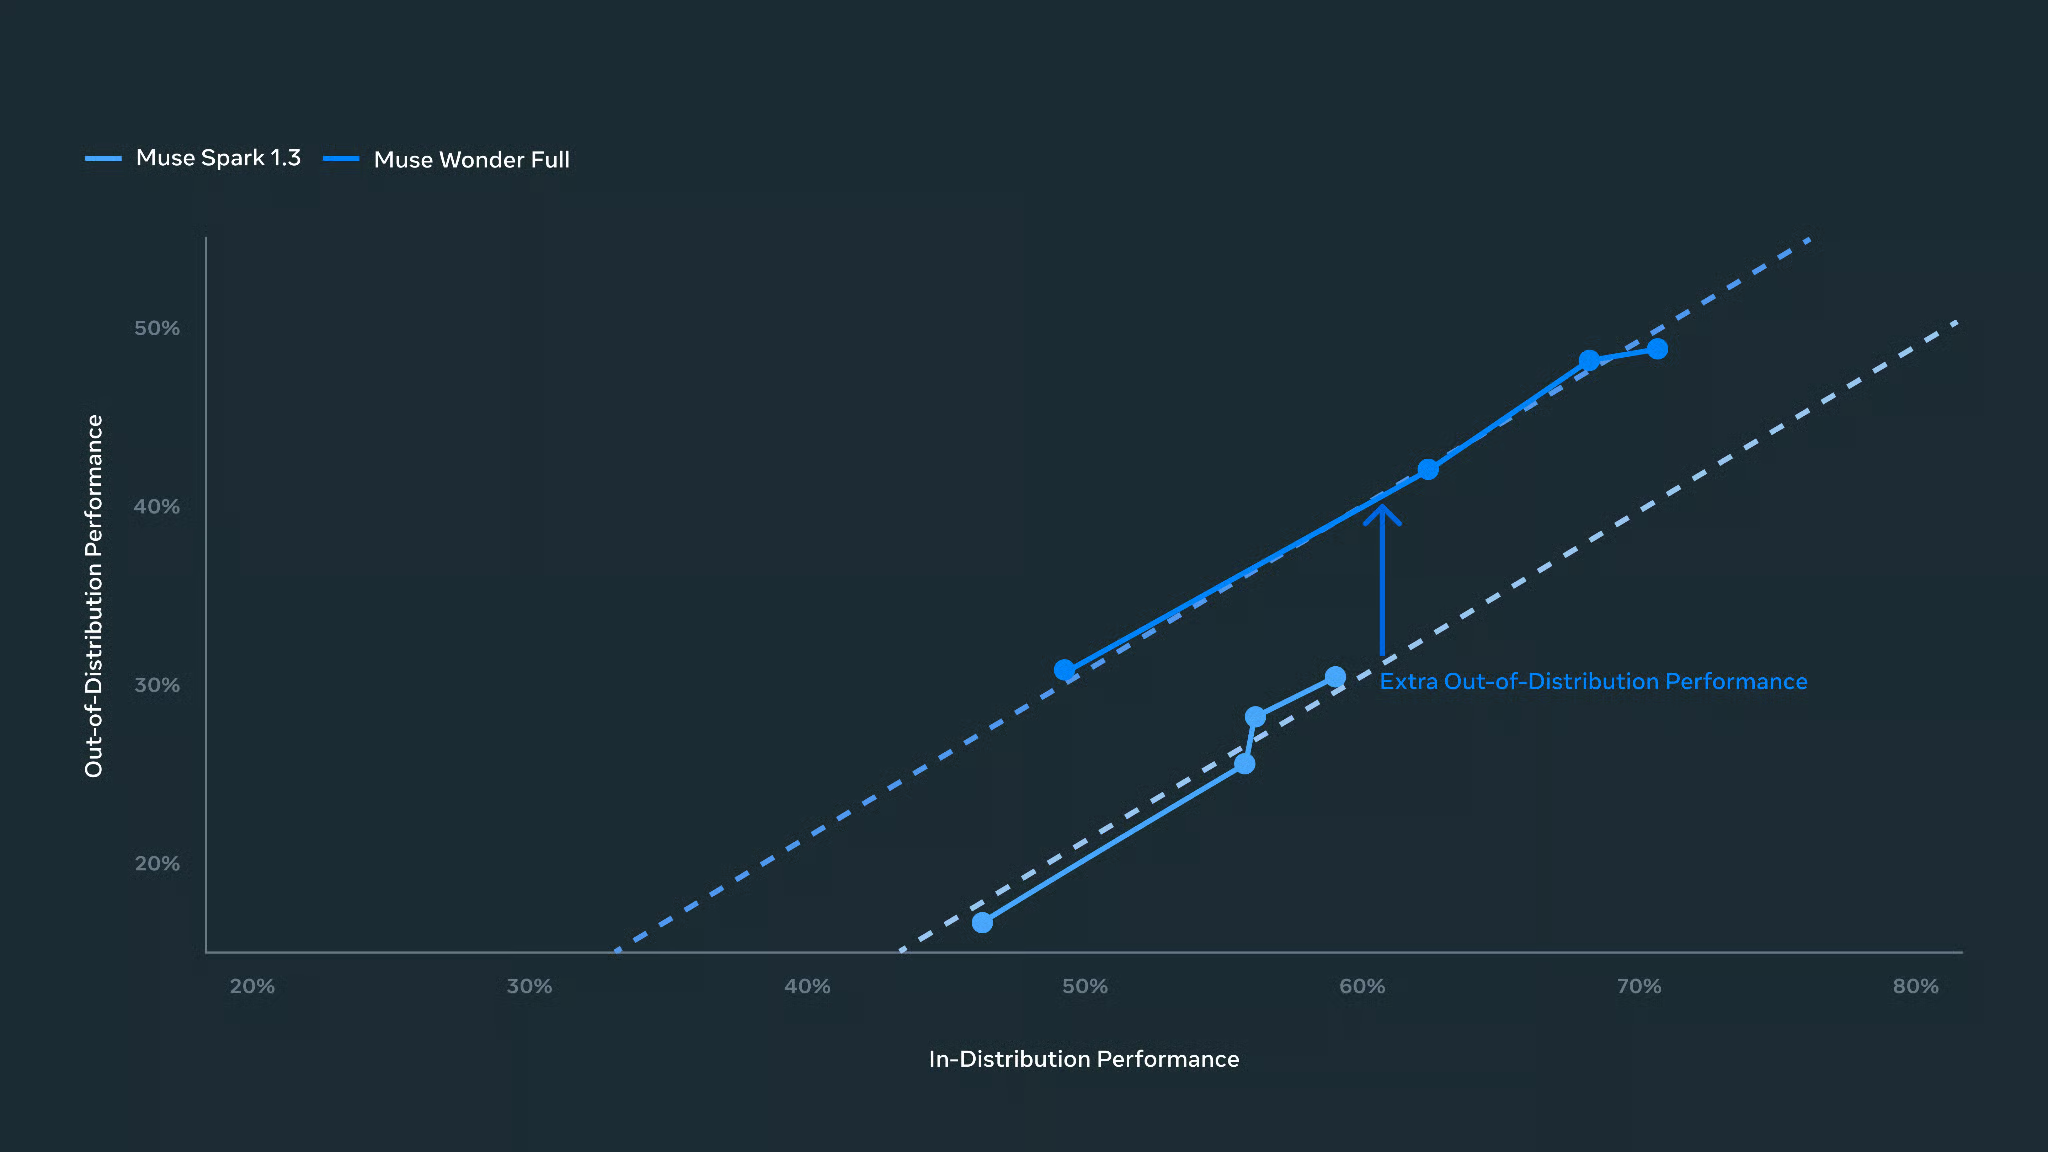
Meta jämför prestanda på obekanta uppgifter. Källa: Meta.
Enligt Metas siffror vinner Muse Wonder Full långa kodningsjobb (men bara inne i Muse Code), Claude Opus 5.5 vinner terminalarbete och att bygga från grunden, och GPT-6 Astra toppar bara en rad i Metas tabell. Den här delen sammanställer benchmarken, så det kommer att låta bekant.
Automation är delad, eftersom Muse Wonder Full leder AutomationBench-AA medan Claude-modellerna leder på OSWorlds delkredit. Bland modeller med en rapporterad fullständig slutförandegrad slutför ingen de flesta uppgifter. På brett resonemang leder Claude Opus 5.5 Artificial Analysis-indexet, där vanliga Muse Wonder får 52,4.
Priset är där vanliga Muse Wonder ser svagare ut. GPT-6.1 Sol kostar hälften så mycket per token och får 51,8 på samma index, och Claude Sonnet 5.5 kostar lika mycket som GPT-6.1 Sol.
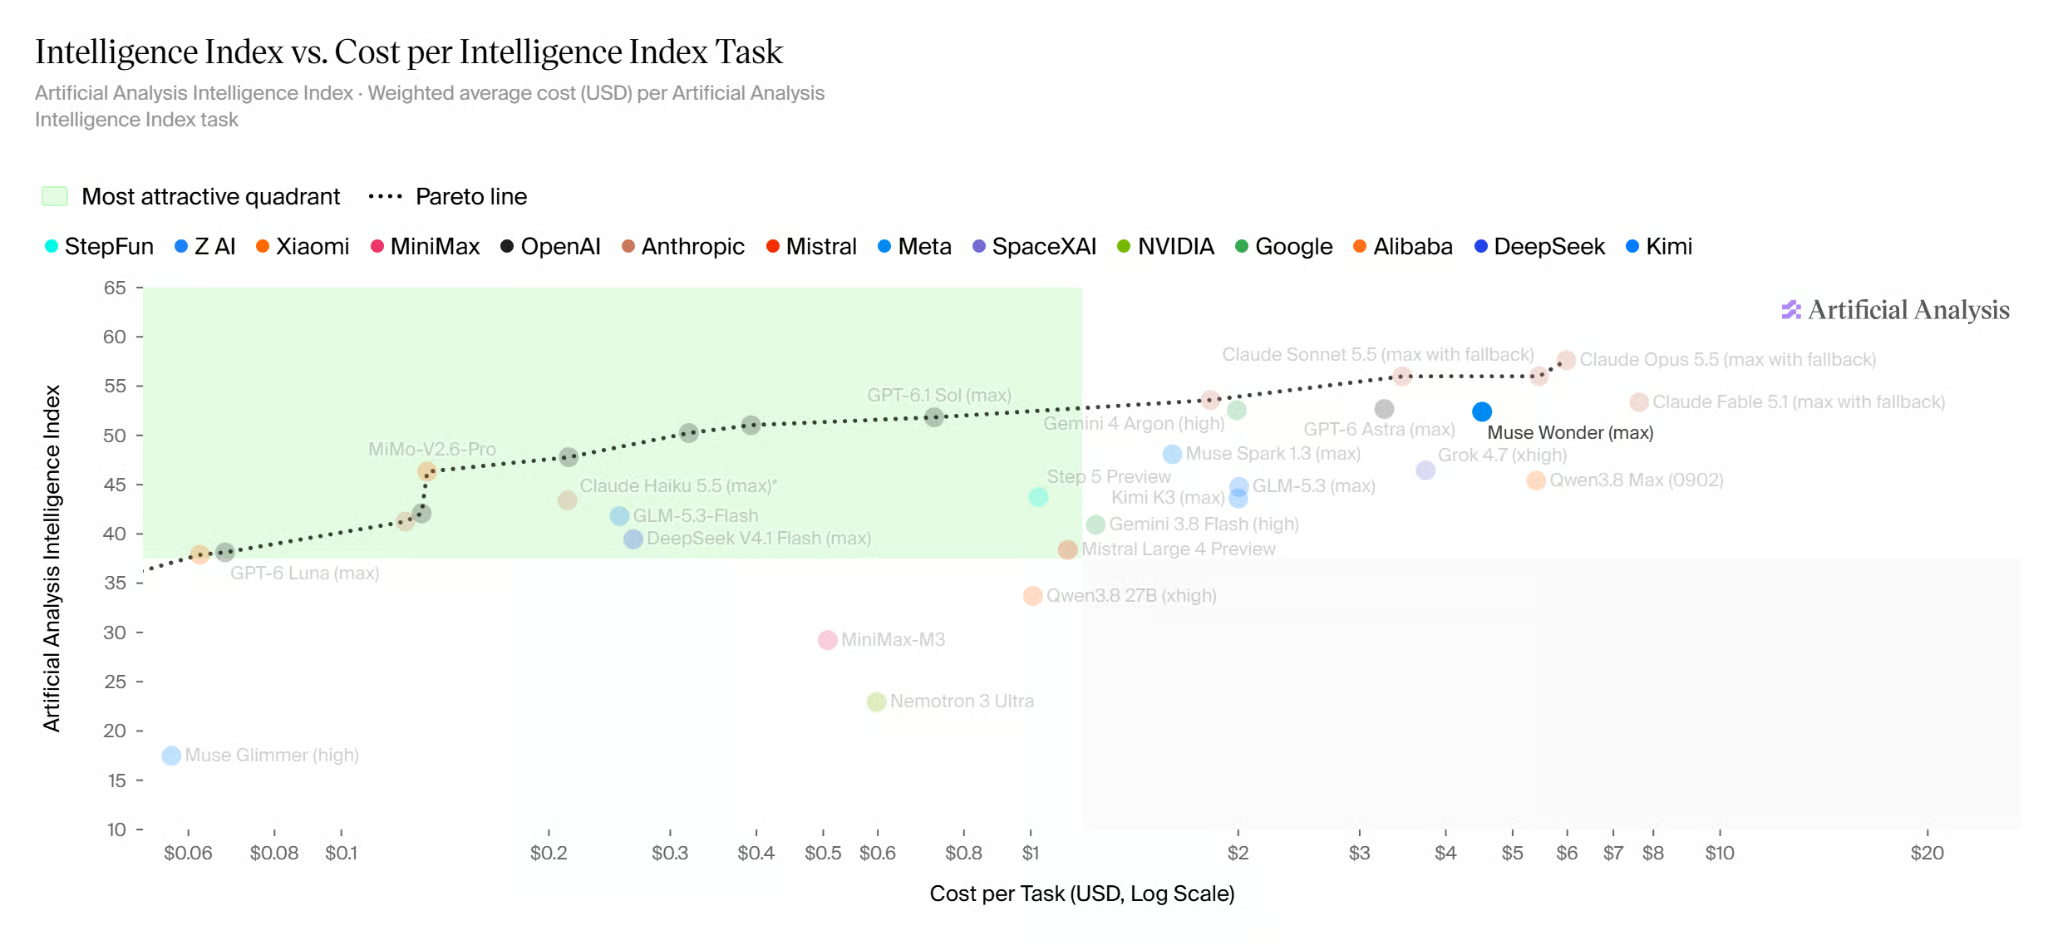
Muse Wonder väger kostnad mot intelligens. Källa: Artificial Analysis.
Jag var nära att lämna Gemini 4 Argon utanför det här avsnittet, eftersom Meta inte testade den, och som vår täckning av Gemini 4 Argon noterar, gick den först till betrodda cybersäkerhetsteam. Utan delade resultat finns ingen rättvis head-to-head, så välj efter arbetslast och kostnaden för att slutföra en uppgift.
Muse Wonder passar bäst för två typer av arbete: stora programvaruändringar och flerstegsarbetsflöden i webbläsaren. Långa planeringsuppgifter, som Metas demo med bordsplacering på bröllop, beror mer på appen runt modellen.
Detta användningsfall har starkast stöd, åtminstone för att ändra kod som redan finns. I Muse Code arbetar Muse Wonder över filer, kör tester, läser fel och försöker igen, vilket är vad DeepSWE och SWE-Marathon mäter. På riktig kod, ge den bara de behörigheter uppgiften kräver och låt en person granska ändringarna.
Metas demo ”Saturday Run Planning” visar Muse Wonder ”som arbetar direkt i en webbläsare och över appar”, och ett annat demo hanterar en försäkringsskada. Eftersom Muse Wonder Full slutför fullt ut färre än 4 av 10 skrivbordsuppgifter, behöver ett verkligt arbetsflöde ditt godkännande innan något skickas in eller betalas.
Du betalar för Muse Wonder på ett av två sätt: per token för vanliga Muse Wonder, eller en fast månadsplan för Muse Code, vilket, som jag nämnde i inledningen, är det enda sättet att få Muse Wonder Full.
Metas prissida listar vanliga Muse Wonder på 4,00 dollar per miljon indata-token, 0,20 för cachad indata och 20,00 för utdata. Det är ett stort hopp från Muse Spark 1.3:s 1,25 och 4,25, och det matchar Claude Opus 5.5:s priser, vilket säger något om var Meta anser att Muse Wonder står.
GPT-6 Astra listas på 10 dollar, 1 dollar cachad och 50 dollar, och GPT-6.1 Sol på 2, 0,10 och 10 dollar. Det hypotetiska exemplet nedan tillämpar dessa lanseringsdagens priser på en kodningsuppgift med 3 miljoner indata-token (2,4 miljoner cachade) och 200 000 utdata-token, under antagandet att ingen enskild förfrågan går över 272 000 token, där GPT-6 Astras priser går upp.
|
Modell |
Ej cachad indata (0,6 M) |
Cachad indata (2,4 M) |
Utdata (0,2 M) |
Totalt per uppgift |
|
Muse Wonder |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
Claude Opus 5.5 |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
GPT-6 Astra |
$6,00 |
$2,40 |
$10,00 |
$18,40 |
|
GPT-6.1 Sol |
$1,20 |
$0,24 |
$2,00 |
$3,44 |
Likadana tokenpriser innebär likad nota per försök, så siffran att jämföra är kostnad per slutförd uppgift. Om Muse Wonder slutför en gång av två, är det 13,76 dollar, samma som en modell med GPT-6.1 Sols priser som slutför en gång av fyra (båda frekvenserna påhittade för exemplet).
Muse Wonder Full finns bara med Muse Codes månadsplaner, som tar en fast avgift istället för per token. Du kan hoppa över detta om du bara tänker använda API:t. Metas prenumerationsdokumentation listar fyra planer:
Metas produktsida för Muse Code visar bara priser för Power och Maximum, vilket är märkligt att utelämna, så kolla de lägre planerna i kassan. Vanliga Muse Wonder finns på varje plan.
Varje plan har en användningsgräns som återställs över tid. Oanvänd tilldelning följer inte med, och prenumerationen kan inte användas som API-kredit.
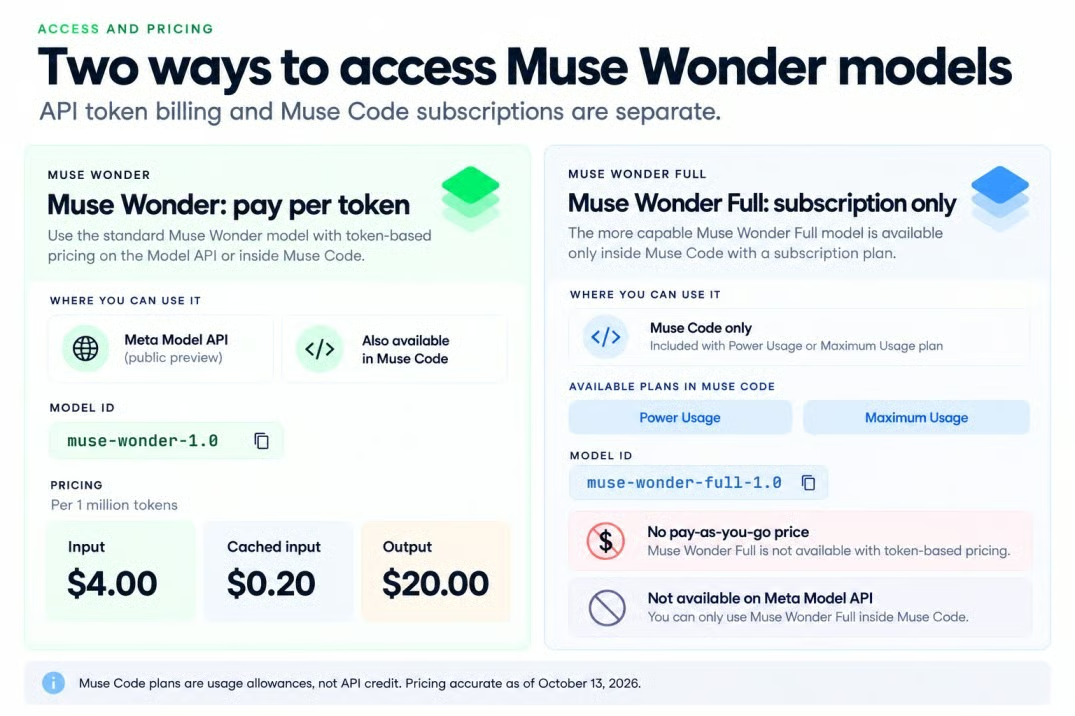
Prissättningen för Muse Wonder följer två vägar. Källa: Meta; bild av författaren.
Power är det billigaste sättet att prova Muse Wonder Full, även om Meta inte har sagt hur många stora uppgifter dess tilldelning täcker. Det är den delen jag skulle bevaka, eftersom en tidig användare sa att några små förfrågningar använde ungefär hälften av en instegsplans 5-timmarsgräns, vilket jag tar upp i utvecklarreaktionerna.
För att återknyta till uppdelningen i inledningen: vanliga Muse Wonder finns via Meta Model API och Muse Code, och Muse Wonder Full bara via Muse Code.
För att använda Muse Wonder API behöver du ett Meta-utvecklarkonto, en API-nyckel och fakturering, och modell-ID:t är muse-wonder-1.0. Meta kallar fortfarande API:t en ”public preview” på sin produktsida, kod byggd på OpenAIs SDK kan pekas mot det, och Meta listar även OpenRouter som en väg.
Åtkomst är inte global. Metas Geographic Use Policy blockerar flera platser, inklusive Kina, Ryssland, Iran, Pakistan, Eritrea och Etiopien.
För att få Muse Wonder Full behöver du en Power- eller Maximum-plan för Muse Code, ett Meta-konto och vara 18 år eller myndig där du bor. Som jag tog upp i prisavsnittet finns den inte i Model API till något pris, och dess ID, muse-wonder-full-1.0, fungerar bara i Muse Code. Muse Codes dokumentation listar macOS, Linux och Windows, även om dess produktsida bara nämner macOS och Windows.
Riskerna här kommer från samma saker som Meta lyfter fram: långa körningar och åtkomst till dina privata filer.
Modellkortet namnger tre svagheter som kan påverka en agent. Var och en orsakar ett annat problem:
Detta är inte isolerade kvalitetsproblem i svar när modellen kan använda verktyg. Ett felaktigt klick eller dåligt antagande tidigt i en tvåtimmarsuppgift kan förstöra resten.
Det beror på läge, så läs detta innan du pekar Muse Code mot ett privat repo. Metas användarvillkor, uppdaterade tre dagar före lansering, säger att Meta inte tränar på innehåll som skickas till deras Standard Services, medan innehåll som skickas i Contributor-läge kan användas för att ”träna, utveckla, utvärdera och förbättra” deras modeller.
Muse Code-prenumerationer börjar i Contributor-läge, i utbyte mot mer användning, och du måste byta till Standard i dina inställningar. Bytet gäller bara framåt, så allt du redan skickat kan fortfarande användas för träning. Den förinställningen har jag svårt att uppskatta.
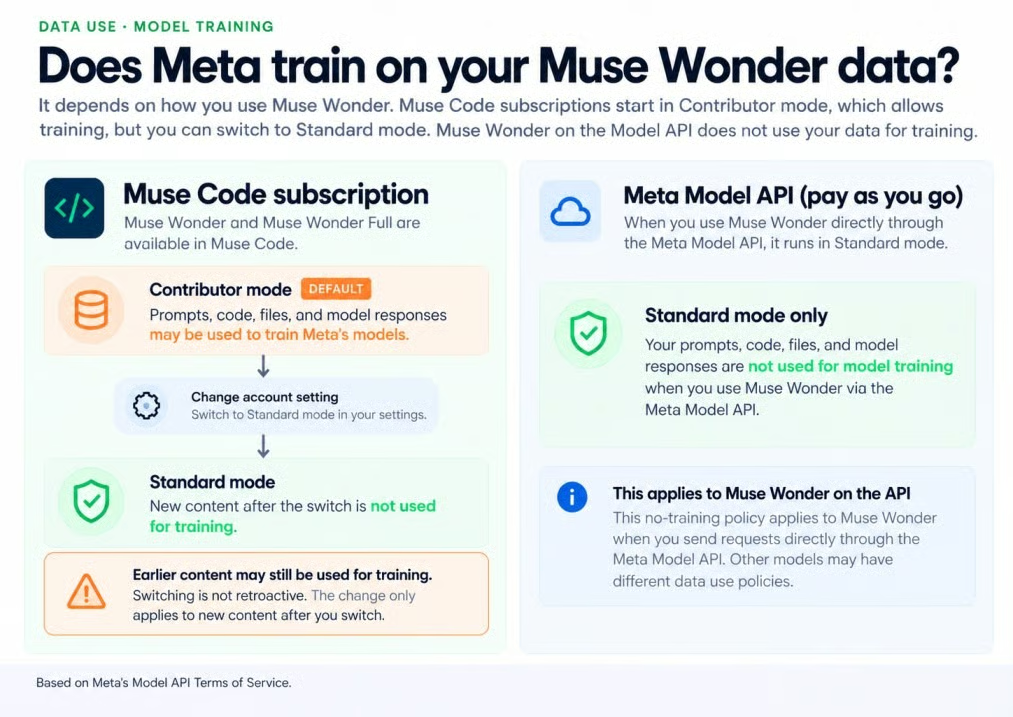
Innehåll i Contributor-läge kan träna Metas modeller. Källa: Metas villkor; bild av författaren.
Villkoren säger också att du ”inte får skicka känslig, konfidentiell eller personlig information” i Contributor-läge, inklusive privat kod. Vanliga Muse Wonder på API med pay-as-you-go körs endast i Standard-läge.
Meta testade Muse Wonder Full enligt deras Superintelligence Scaling Framework. Utan skyddsmekanismer utesluter inte Meta att den når högrisknivå för kemiska och biologiska hot, och med skydd åsätter den varje riskområde ”måttlig eller lägre”.
En riskbedömning är ingen säkerhetsgaranti, och en mer komplett säkerhetsrapport kommer fortfarande ”snart”. Modellkortets råd är enkelt: kräv mänsklig bekräftelse för åtgärder du inte kan ångra, och håll agenten i en sandbox med begränsade behörigheter.
Reaktioner på X på lanseringsdagen delades mellan snabb framstegstakt, ojämn prestanda och frustration över användningsgränser. Det här är korta tester och personliga intryck, inte kontrollerade utvärderingar.
Den försiktigt positiva synen kom från en tidig testare som hade begränsad tid med Muse Wonder men tyckte att det såg bra ut. Den större poängen var hur långt Metas modeller hade kommit sedan Muse Spark i april.
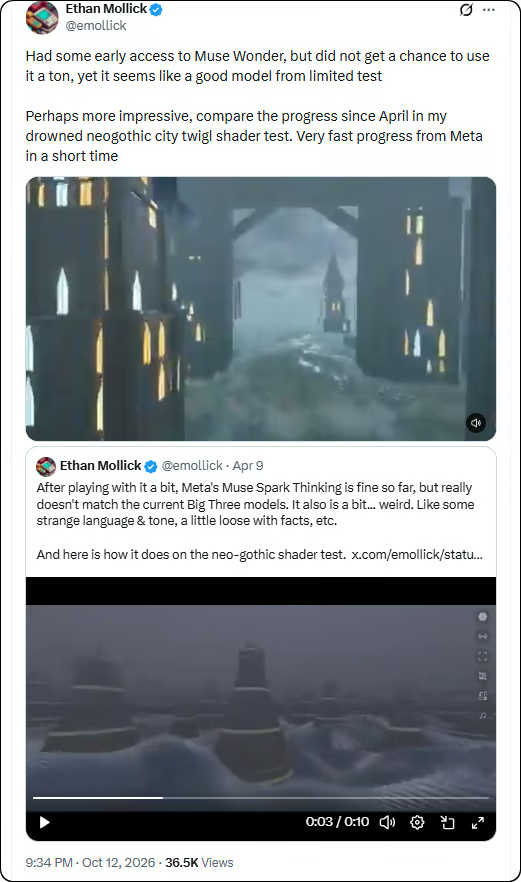
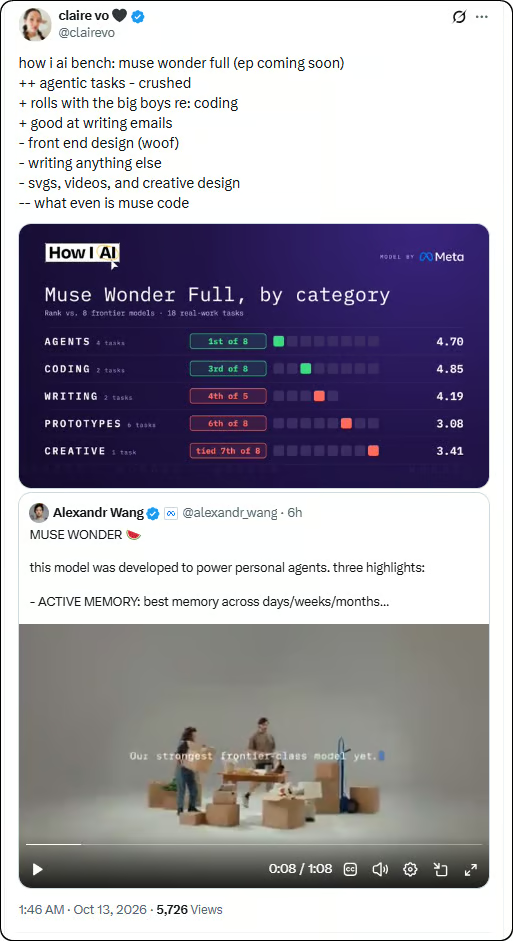
Ett bredare kategoritest gav en mindre prydlig bild. Muse Wonder Full rankade nära toppen för agenter och kodning, men halkade efter på skrivande, front-end-design och kreativt arbete.
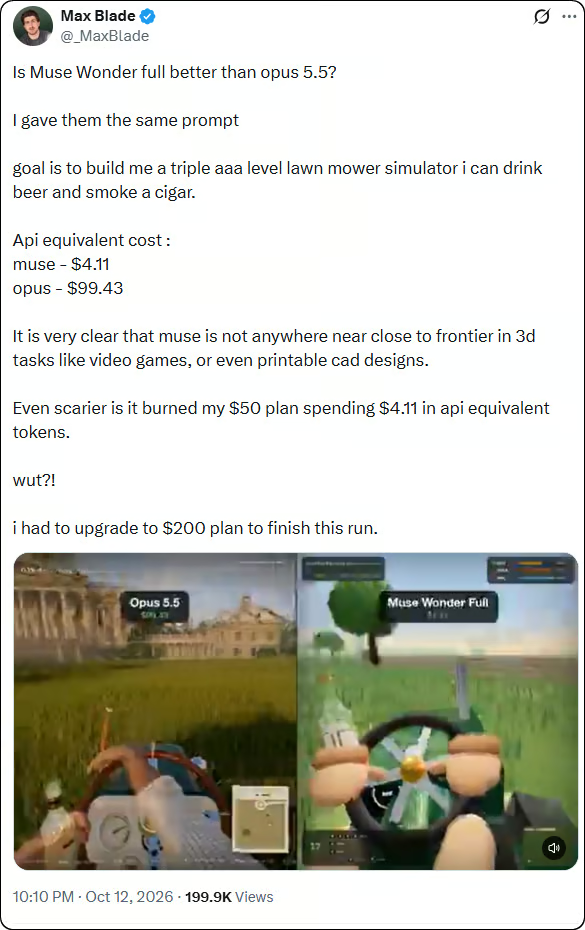
Den skarpaste invändningen gällde kostnad och plangränser. I ett likadant prompttest för gräsklippare använde Muse Wonder Full ungefär 4,11 dollar i API-ekvivalenta token men gav ett svagare 3D-resultat än Claude Opus 5.5, och testaren sa att slutförande krävde uppgradering från 50-dollarsplanen till 200-dollarsplanen.
Tillsammans antyder inläggen att Muse Wonder är konkurrenskraftig men ojämn. Fler upprepade tester behövs innan man behandlar något enskilt resultat som typiskt.
Det mesta av lanseringsunderlaget kommer fortfarande från Meta. Muse Wonder Full har inget API med pay-as-you-go, och vanliga Muse Wonder kostar lika mycket som Claude Opus 5.5 samtidigt som den ligger efter på flera tester.
Jag skulle testa vanliga Muse Wonder för API-agenter och Muse Wonder Full för långt arbete i repo. Jag skulle behålla Claude Opus 5.5 för terminalarbete eller att bygga program från grunden, och använda GPT-6.1 Sol eller Claude Sonnet 5.5 när kostnaden avgör.
Lär dig med DataCamp
{count, plural, one {Kurs} other {Kurser}}
{count, plural, one {Kurs} other {Kurser}}
{count, plural, one {Kurs} other {Kurser}}