{count, plural, one {Курс} few {Курса} many {Курсов} other {Курса}}
Концепции больших языковых моделей (LLM)
{hours} ч
112.2K
На этой неделе Meta выпустила Muse Wonder и Muse Wonder Full — своё первое крупное семейство моделей после Muse Spark. Обе модели созданы для ИИ-агентов, которые решают многошаговые задачи.
В публикации о запуске Meta называет Muse Wonder результатом 14‑месячной переработки работы над ИИ. Два новых термина, которые стоит знать: Active Memory — вспоминает полезные детали из прошлых диалогов, и Active Focus — продолжает работу, когда задача «застревает».
Обычная Muse Wonder доступна через Meta Model API и Muse Code, а Muse Wonder Full, модель, стоящая за большинством «витринных» результатов, работает только в Muse Code на двух самых дорогих тарифах. Ниже разберёмся подробнее.
Главные выводы из запуска:
Muse Wonder и Muse Wonder Full — рассуждающие модели, которые Meta называет своими самыми способными на сегодня; они предназначены для агентов, помогающих в личных и рабочих задачах. В карточке модели указаны входы: текст, изображения, видео и аудио; выход — только текст. То есть ни одна из моделей не генерирует изображения, видео или аудио. В документации для разработчиков добавлен PDF‑вход и указан контекст 1 048 576 токенов.
В исследовательском блоге Meta говорится, что обе модели опираются на тренировочную базу Muse Spark и обучались в дата‑центре Prometheus. Число параметров не раскрывается.
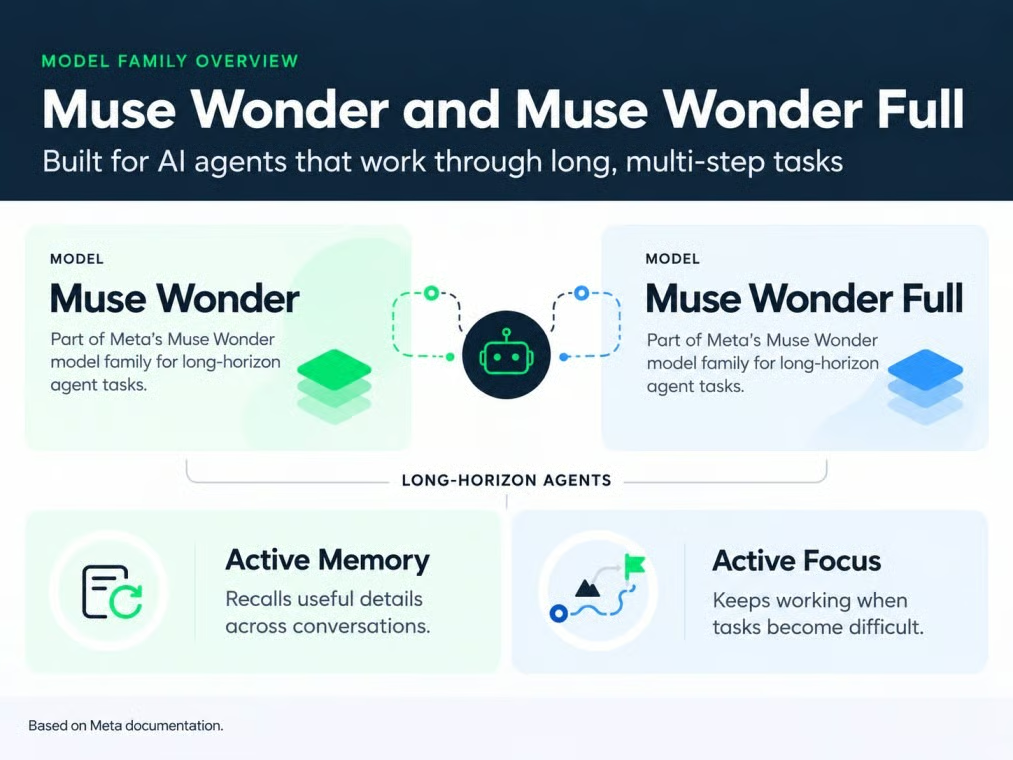
У Muse Wonder две версии. Изображение автора.
Из двух вариантов Muse Wonder Full — это отдельная, более способная модель. В документации указано, что повышение уровня рассуждений у обычной Muse Wonder (muse-wonder-1.0) до "max" не превращает её в Muse Wonder Full (muse-wonder-full-1.0).
Вы могли заметить, что Meta использует имя Muse для разных вещей. Кратко:
Когда Meta говорит, что Muse Wonder что‑то «делает», нередко половину работы выполняет Muse Code. Это относится к большинству приведённых ниже результатов по коду.
Ключевые возможности Muse Wonder — Active Memory и Active Focus, и Meta демонстрирует их прежде всего на длинных задачах по программированию. Идея проста: агент должен помнить нужные детали и не сдаваться, если план не сработал.
Active Memory — термин Meta для переноса важных деталей между разговорами и актуализации нужных сейчас. Допустим, вы в марте задали бюджет на домашний офис $3000, в апреле повысили до $4000, а в мае попросили короткий список мебели. Хорошая память означает, что агент возьмёт апрельскую сумму без напоминаний.
В качестве доказательства Meta приводит MemoryBench — собственный тест длинных диалогов с обновлениями фактов. Muse Wonder набирает на нём 85,6, но это ничего не говорит о вспоминании через месяцы, а приложению на основе API всё равно нужно само хранить эти факты. Это функция, которая интересует больше всего: агент, работающий по старому бюджету, может стоить вам денег.
Active Focus — термин Meta для настойчивости: пробовать другой подход, обходить блокеры и уточнять перед важными действиями. Представьте миграцию кода, где падают 30 тестов. «Сфокусированный» агент правит код и снова гоняет тесты, а более слабый просто подправит тесты, чтобы они проходили.
Meta измеряет это при помощи FocusBench — ещё одного своего теста, а также SWE-Marathon, о котором расскажем в разделе бенчмарков. Ни один тест не гарантирует завершение задачи, а работа «в фоне» зависит от окружения вокруг модели — на этот риск для «всегда включённых» агентов у нас есть объяснение OpenAI Dots.
Muse Wonder планирует длинные кодовые задачи и делит работу между вспомогательными агентами, а Muse Code запускает инструменты и согласования. Страница для разработчиков рекомендует её для задач, которые «идут часами», с одновременным редактированием множества файлов.
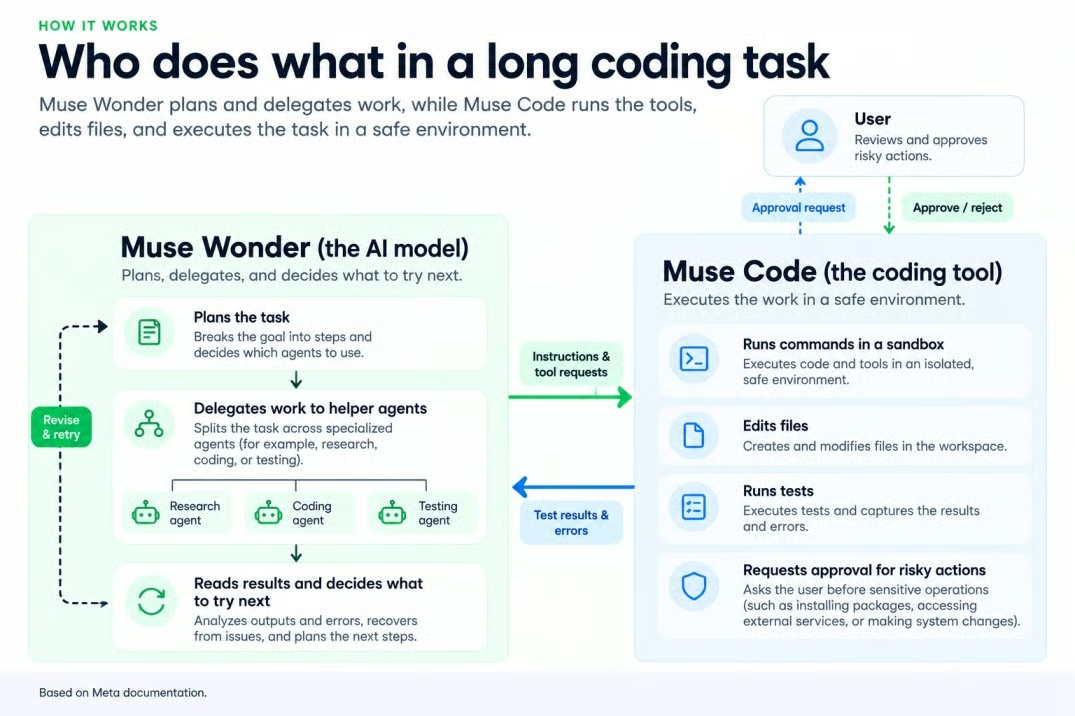
Muse Wonder планирует; Muse Code исполняет. Изображение автора.
Один из демо‑примеров Meta — играбельная 3D‑игра‑кухня, собранная из изображений. Выбор странный, учитывая, что в карточке модели 3D‑рассуждения указаны как известная слабость (я бы выбрал другое демо).
Таблица Meta благоволит Muse Wonder Full в длинном коде и некоторых профессиональных бенчмарках, тогда как Claude Opus 5.5 лидирует в терминальной разработке и создании программ с нуля. Приведённые ниже цифры — от Meta, если не указано иное; почти все модели запущены на максимальном уровне рассуждений (об одном исключении скажу отдельно).
Muse Wonder Full возглавляет оба длинных теста по коду в таблице Meta. Как упоминалось, на DeepSWE v1.1 она набирает 79,0, а обычная Muse Wonder — 78,8. Это пока цифры Meta, так как публичная таблица лидеров DeepSWE от Datacurve ещё не содержит Muse Wonder.
SWE‑Marathon я бы отслеживал особенно: его 20 многочасовых проектов получают ноль при провале хоть одного теста. Meta сообщает 57,5 для Muse Wonder Full (на ступень ниже максимума) и 53,1 для Muse Wonder, против 46,3 у Claude Opus 5.5 и 42,5 у GPT‑6 Astra. Конкурентные модели работали в собственных инструментах компаний, поэтому даже Meta отмечает, что сравнение не совсем корректно; к тому же при 20 проектах один проект может сдвинуть счёт на несколько пунктов.
Собственная таблица лидеров SWE‑Marathon от Abundant AI даёт более скромную картину: Muse Wonder Full — 53,1%, обычная Muse Wonder — 52,5%, обе на максимальном уровне в Muse Code, чуть впереди Claude Sonnet 5.5 с 51,3%. Claude Haiku 5.5, выпущенный Anthropic за пять дней до этого, — 50,0%. Списки — из разных тестов, не смешивайте их.
Утверждение Meta, что Muse Wonder может выполнять работу в разных приложениях, подтверждается неоднозначно. В AutomationBench‑AA, который проверяет, приходят ли бизнес‑процессы к верному конечному состоянию, Muse Wonder Full набирает 45,4 против 41,6 у GPT‑6 Astra и 41,2 у Claude Opus 5.5 — лидер, но всё ещё проваливает большинство сценариев.
OSWorld V2.1 — набор из 108 десктопных задач — даёт больше информации. Muse Wonder Full получает 78,4 по частичным кредитам, но полностью завершает лишь 39,4% задач; при этом обе модели Claude превосходят её по частичному баллу. Для страховой формы «почти все шаги верно» — это всё равно провал, поэтому следить нужно за 39,4%.
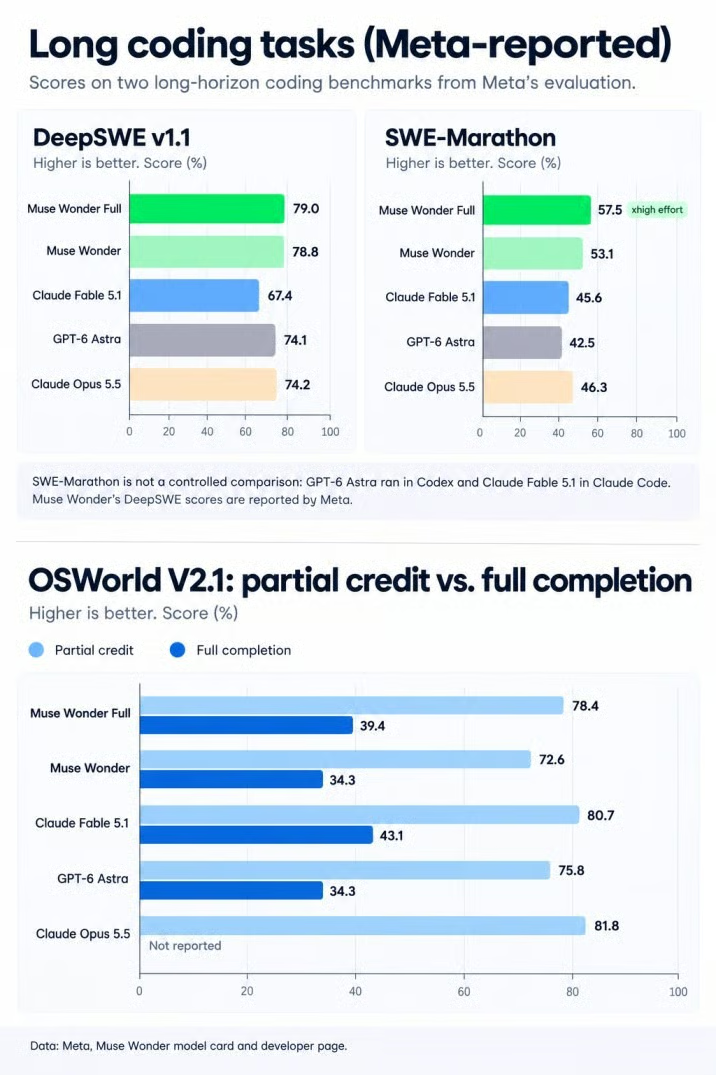
Лидерство в коде скрывает низкие доли завершения. Источник: Meta; изображение автора.
Muse Wonder Full лидирует в юридическом бенчмарке и отстаёт в медицине; по финансам почти паритет. Её юридический балл звучит маленьким, но он в три раза выше, чем у Claude Opus 5.5. В версии Artificial Analysis юридический документ засчитывается только при выполнении всех требований и без «выдумок», и Muse Wonder Full набирает 13,1 против 4,2 у Claude Opus 5.5 — что всё равно означает провал около 87% задач.
По финансам почти ничья: Muse Wonder Full — 59,1 на Vals Finance Agent V2 против 58,6 у Claude Opus 5.5. В медицине наоборот: у Muse Wonder Full 62,3 на HealthBench Pro, позади Claude Opus 5.5 (65,6) и GPT‑6 Astra (65,3).
Muse Wonder Full уступает Claude Opus 5.5 в шести из 14 тестов в таблице Meta, а GPT-6 Astra опережает её в трёх. Ниже собраны проигрыши, не рассмотренные выше.
|
Бенчмарк |
Что измеряет |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal‑Bench 4.0‑AA |
Терминальная разработка |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Сборка программ с нуля |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Широкий композитный индекс |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Профессиональное использование инструментов |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Работа с PDF |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Источник: страница разработчика Muse Wonder на момент запуска. Все модели — на максимальном уровне рассуждений.
ProgramBench — поражение, на которое разработчикам стоит обратить внимание, и разрыв там немалый. Тест просит модели собрать программу с нуля; разница в 11,5 пунктов показывает, что править существующую кодовую базу и строить с нуля — разные навыки.
Artificial Analysis даёт Muse Wonder Full 55,8 (в таблице Meta округлено до 56), тогда как Claude Sonnet 5.5 набирает 56,0.
Можно ли полностью доверять бенчмаркам Muse Wonder? Не совсем. Карточка модели Meta показывает, что в таблице смешаны три вида данных:
Как отмечалось, почти все баллы получены на максимальном уровне рассуждений, так что вы видите каждую модель в лучшей форме. Результаты зависят и от тестировщика: например, Anthropic сообщает 66,4% для Claude Opus 5.5 на Terminal‑Bench 4.0 против 59,6 в таблице Meta. Утверждение Meta, что Muse Wonder Full лучше справляется с незнакомыми задачами, чем модели Spark, основано на её собственном анализе.
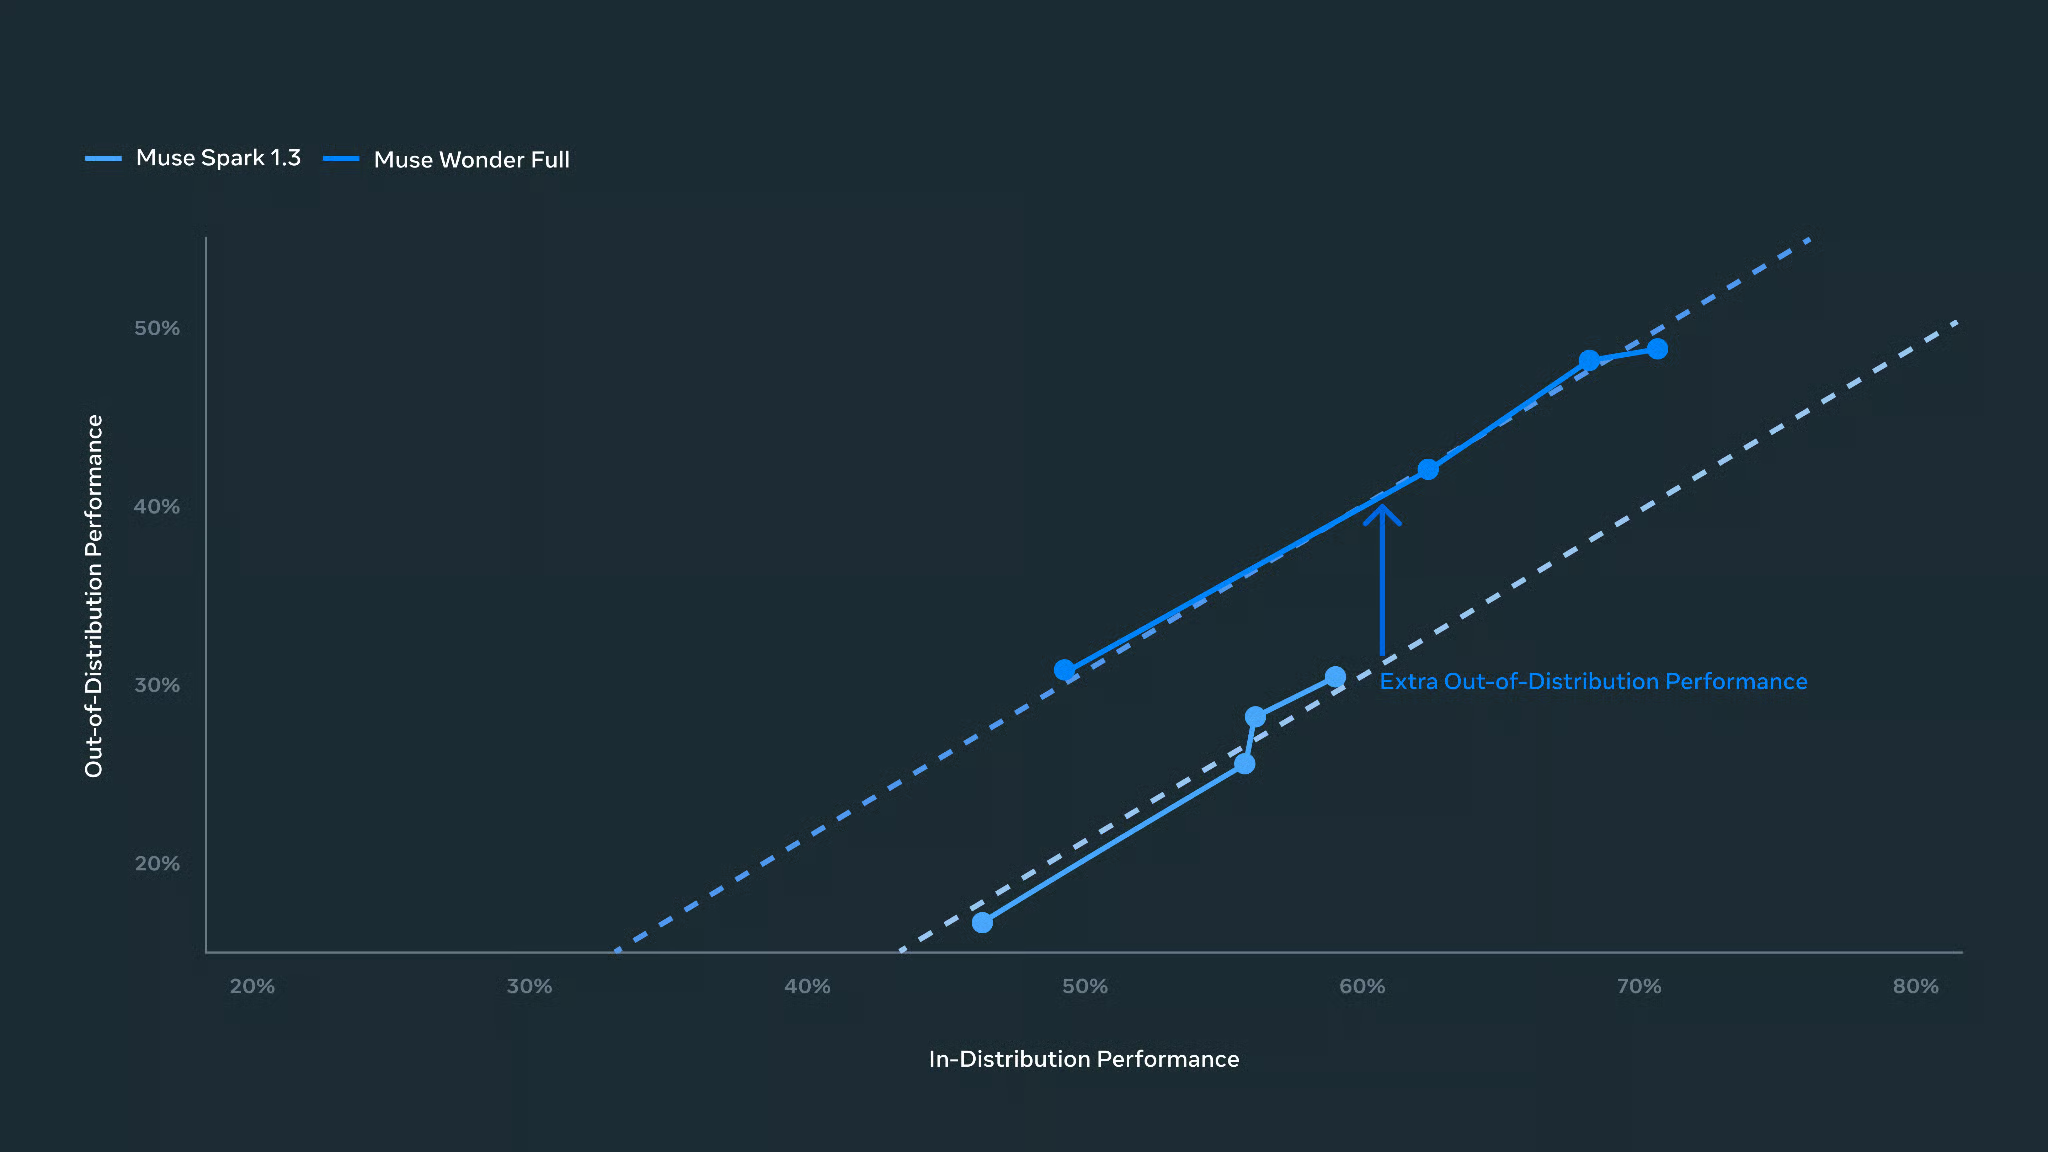
Meta сравнивает работу на незнакомых задачах. Источник: Meta.
По данным Meta, Muse Wonder Full выигрывает длинные кодовые задачи (но только внутри Muse Code), Claude Opus 5.5 лидирует в терминальной работе и разработке с нуля, а GPT‑6 Astra возглавляет лишь одну строку таблицы Meta. Ниже собраны результаты бенчмарков, поэтому часть уже знакома.
В автоматизации картина смешанная: Muse Wonder Full лидирует в AutomationBench‑AA, а модели Claude — в OSWorld по частичным кредитам. Среди моделей с отчётной долей полного завершения ни одна не закрывает большинство задач. В широком рассуждении лидирует Claude Opus 5.5 по индексу Artificial Analysis; обычная Muse Wonder набирает 52,4.
По цене обычная Muse Wonder выглядит слабее. GPT‑6.1 Sol стоит вдвое дешевле за токен и набирает 51,8 в том же индексе, а Claude Sonnet 5.5 стоит как GPT‑6.1 Sol.
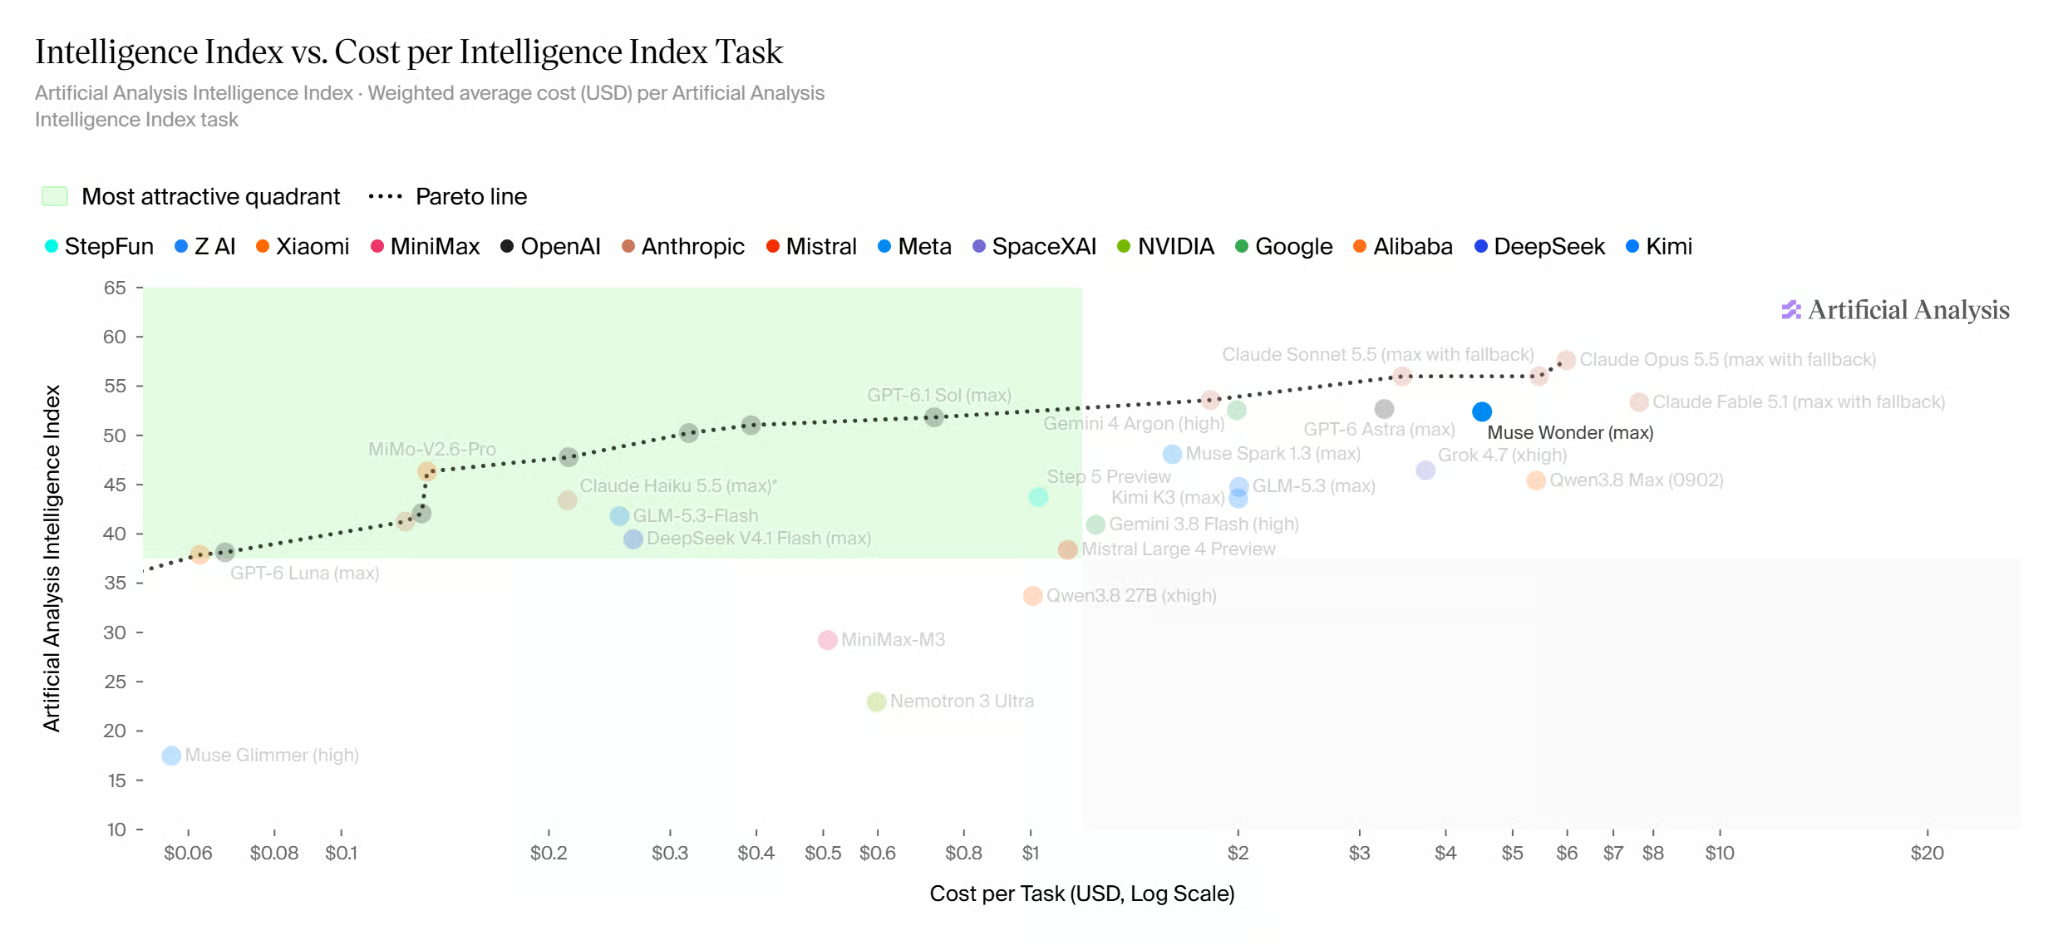
Muse Wonder балансирует между ценой и «интеллектом». Источник: Artificial Analysis.
Я почти исключил Gemini 4 Argon из этого раздела, потому что Meta его не тестировала, и, как отмечено в нашем обзоре Gemini 4 Argon, он сначала пошёл «доверенным» командам кибербезопасности. Без общих результатов честного лоб‑в‑лоб не получится, так что выбирайте по типу нагрузки и стоимости доведения задачи до конца.
Muse Wonder лучше всего подходит для двух типов работ: крупных изменений в ПО и многошаговых браузерных сценариев. Долгие планировочные задачи, вроде демо с рассадкой на свадьбе от Meta, больше зависят от приложения вокруг модели.
Этот сценарий подтверждён лучше всего — по крайней мере, для правок в уже существующем коде. В Muse Code Muse Wonder работает по файлам, запускает тесты, читает падения и пробует снова — ровно это измеряют DeepSWE и SWE‑Marathon. В реальном коде давайте только нужные разрешения, а изменения должен просматривать человек.
Демо «Saturday Run Planning» от Meta показывает, как Muse Wonder «работает прямо в браузере и между приложениями», ещё одно демо обрабатывает страховой случай. Поскольку Muse Wonder Full полностью завершает менее 4 из 10 десктопных задач, в реальном процессе перед отправкой или оплатой требуется ваше подтверждение.
Платить за Muse Wonder можно двумя способами: по токенам — за обычную Muse Wonder — или фиксированной ежемесячной платой Muse Code, что, как отмечалось, единственный путь к Muse Wonder Full.
На странице цен Meta обычная Muse Wonder указана по $4,00 за миллион входных токенов, $0,20 за кэшированные входы и $20,00 за выход. Это сильный скачок по сравнению с $1,25 и $4,25 у Muse Spark 1.3 и полное совпадение с ценами Claude Opus 5.5 — это намекает, на какой уровень Meta ставит Muse Wonder.
GPT‑6 Astra — $10, $1 (кэш) и $50, а GPT‑6.1 Sol — $2, $0,10 и $10. Гипотетика ниже применяет эти цены в день запуска к одной кодовой задаче с 3 млн входных токенов (2,4 млн кэш) и 200 000 выходных, допуская, что ни один запрос не превышает 272 000 токенов, после чего у GPT‑6 Astra растут цены.
|
Модель |
Некэш. вход (0,6M) |
Кэш. вход (2,4M) |
Выход (0,2M) |
Итого за задачу |
|
Muse Wonder |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
Claude Opus 5.5 |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
GPT-6 Astra |
$6,00 |
$2,40 |
$10,00 |
$18,40 |
|
GPT-6.1 Sol |
$1,20 |
$0,24 |
$2,00 |
$3,44 |
Равные цены за токен означают равные счета за попытку, поэтому для сравнения важна стоимость за завершённую задачу. Если Muse Wonder завершает одну из двух, это $13,76 — ровно как модель по ценам GPT‑6.1 Sol, которая завершает одну из четырёх (частоты вымышлены для примера).
Muse Wonder Full доступна только в ежемесячных планах Muse Code — там списывается фикс, а не токены. Можно пропустить этот раздел, если вы планируете только API. В документации по подпискам перечислены четыре плана:
На странице продукта Muse Code видны цены только для Power и Maximum — странный пробел, так что проверьте нижние планы на чекауте. Обычная Muse Wonder есть во всех планах.
У каждого плана есть лимит использования, который периодически сбрасывается. Неиспользованный остаток не переносится, а подписку нельзя использовать как кредит в API.
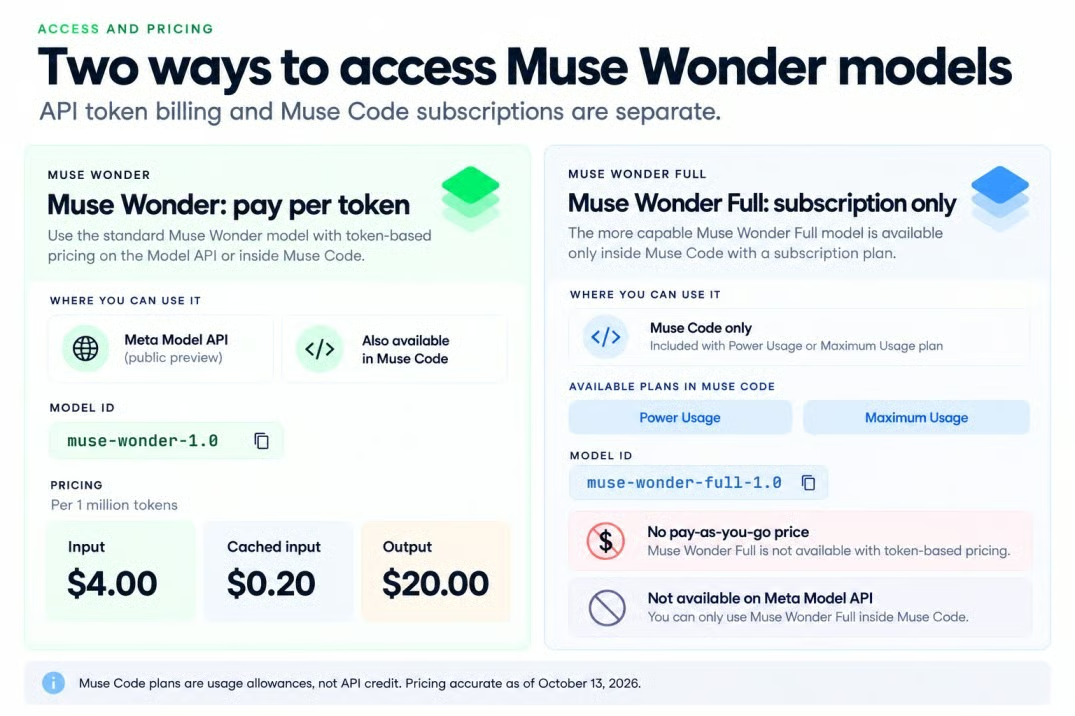
У Muse Wonder два ценовых маршрута. Источник: Meta; изображение автора.
План Power — самый дешёвый способ попробовать Muse Wonder Full, хотя Meta не уточняет, сколько крупных задач покрывает его лимит. На это я бы и смотрел: один ранний пользователь писал, что несколько мелких запросов «съели» около половины 5‑часового лимита стартового плана — об этом ниже в откликах разработчиков.
Напомним расклад: обычная Muse Wonder доступна через Meta Model API и Muse Code, а Muse Wonder Full — только через Muse Code.
Чтобы использовать API Muse Wonder, нужен аккаунт разработчика Meta, ключ API и биллинг; ID модели — muse-wonder-1.0. На продуктовой странице API по‑прежнему значится «публичный превью», код на SDK OpenAI можно «переключить» на него, а также в качестве маршрута указана OpenRouter.
Доступ не глобальный. Политика географического использования Meta блокирует ряд стран, включая Китай, Россию, Иран, Пакистан, Эритрею и Эфиопию.
Для доступа к Muse Wonder Full нужен тариф Power или Maximum в Muse Code, аккаунт Meta и возраст 18+ либо совершеннолетие в вашей стране. Как говорилось в разделе цен, в Model API её нет ни за какие деньги, а её ID, muse-wonder-full-1.0, работает только внутри Muse Code. В документации Muse Code указаны macOS, Linux и Windows, хотя на продуктовой странице — только macOS и Windows.
Риски здесь вытекают из тех же вещей, которые Meta подаёт как преимущества: длительные прогоны и доступ к вашим частным файлам.
Карточка модели называет три слабости, влияющие на агента. Каждая порождает свой тип проблем:
Это не изолированные проблемы с качеством ответов, когда модель умеет пользоваться инструментами. Неправильный клик или неверное допущение в начале двухчасовой задачи может испортить всё остальное.
Зависит от режима — прочтите это, прежде чем наводить Muse Code на приватный репозиторий. В Условиях использования Meta, обновлённых за три дня до запуска, сказано, что Meta не обучает на контенте, отправленном в Standard Services, тогда как контент в режиме Contributor может использоваться для «обучения, разработки, оценки и улучшения» моделей.
Подписки Muse Code по умолчанию стартуют в режиме Contributor в обмен на больший лимит, и переключение на Standard нужно сделать в настройках. Переключение действует только вперёд, так что всё ранее отправленное всё ещё может использоваться для обучения. Такой дефолт сложно одобрить.
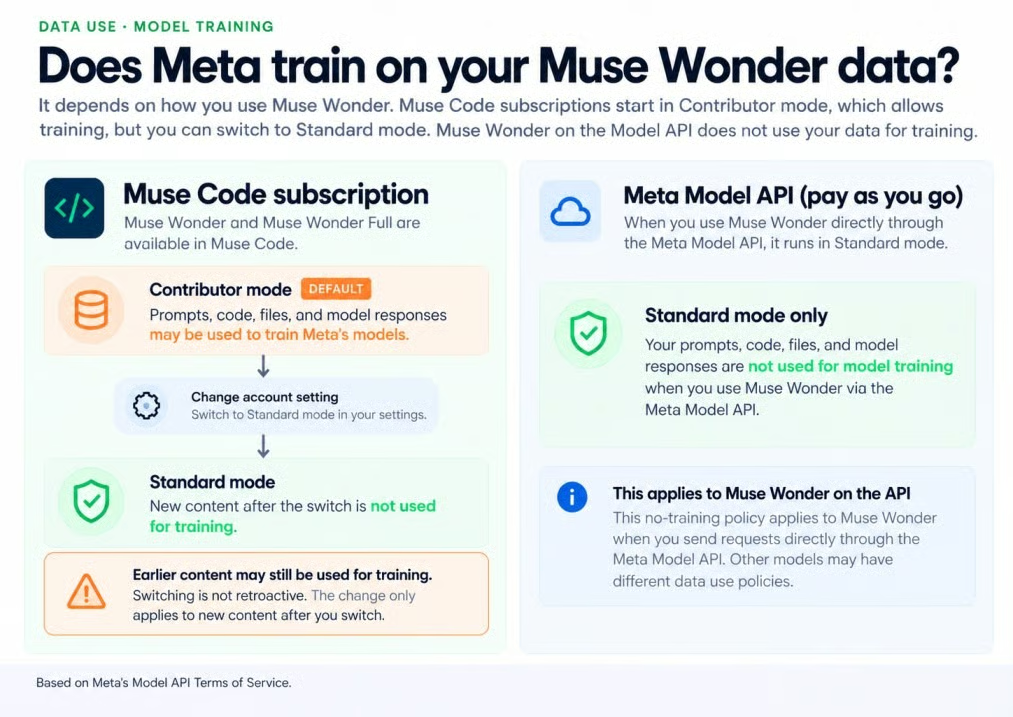
Контент в режиме Contributor может обучать модели Meta. Источник: Условия Meta; изображение автора.
Также в условиях указано, что вы «не должны отправлять чувствительную, конфиденциальную или персональную информацию» в режиме Contributor, включая приватный код. Обычная Muse Wonder в поминутном API работает только в режиме Standard.
Meta тестировала Muse Wonder Full по своему Superintelligence Scaling Framework. Без мер защиты Meta не исключает выхода на высокий риск по химическим и биологическим угрозам; с защитами все области риска оценены как «умеренные или ниже».
Оценка риска — не гарантия безопасности, а более полный отчёт обещан «скоро». Совет в карточке модели прост: требуйте подтверждения человеком для необратимых действий и держите агента в песочнице с ограничениями прав.
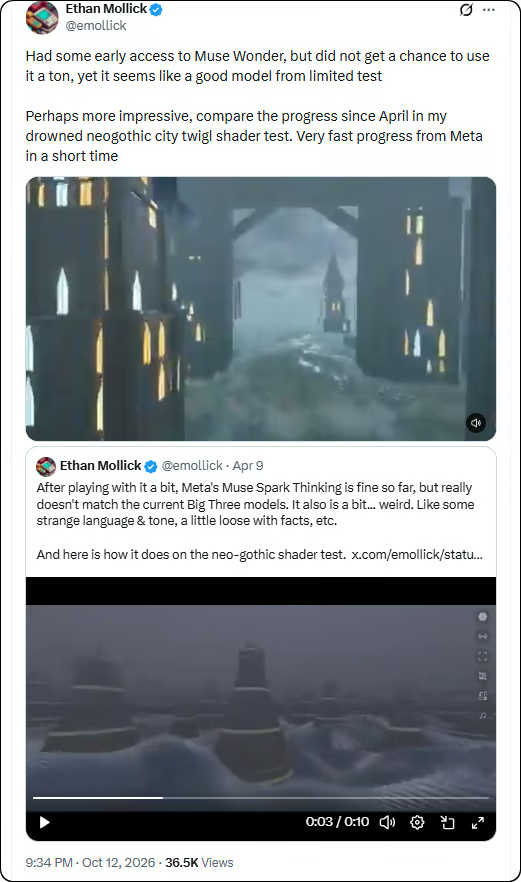
Реакции в день запуска в X колебались между «быстрым прогрессом», «неравномерной работой» и недовольством лимитами. Это короткие пробы и личные впечатления, а не контролируемые оценки.
Сдержанно‑позитивный взгляд высказал ранний тестировщик, у которого было мало времени с Muse Wonder, но впечатления хорошие. Более важный пункт — насколько продвинулись модели Meta со времён Muse Spark в апреле.
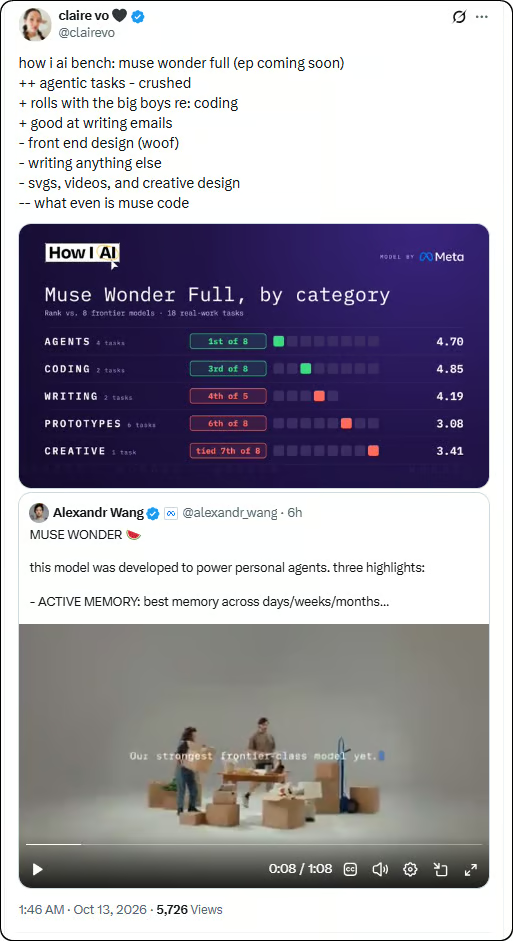
Более широкий «категорийный» тест показал менее стройную картину: Muse Wonder Full — вверху по агентам и коду, но слабее в письме, фронтенд‑дизайне и креативных задачах.
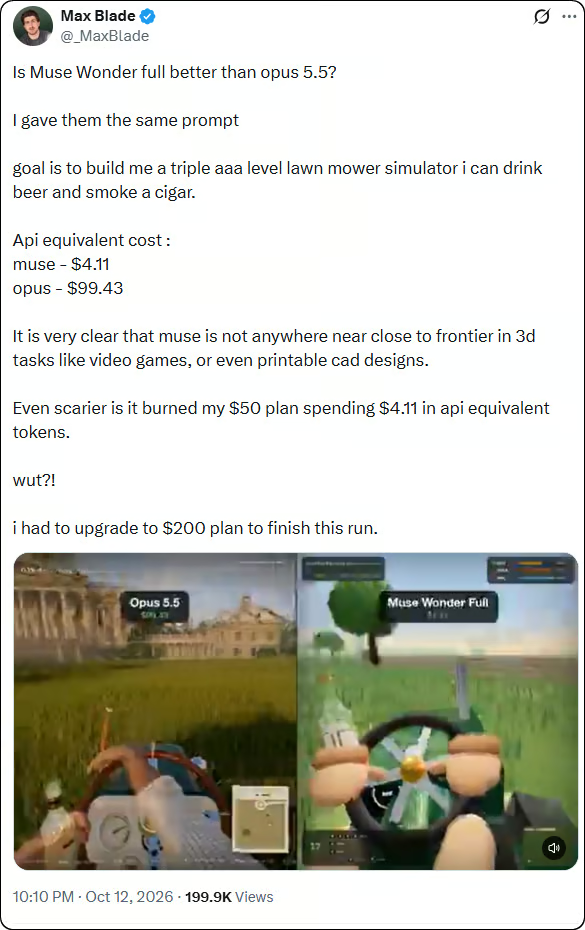
Самая резкая жалоба — на стоимость и лимиты планов. В одном тесте с одинаковым промптом про газонокосилку Muse Wonder Full «сожгла» примерно $4,11 в эквиваленте API‑токенов, но выдала более слабый 3D‑результат, чем Claude Opus 5.5; тестировщик добавил, что для завершения пришлось перейти с плана за $50 на $200.
В сумме посты намекают, что Muse Wonder конкурентоспособна, но неравномерна. Нужны повторяемые тесты, прежде чем считать любой единичный результат типичным.
Большинство доказательств в запуске исходит от самой Meta. У Muse Wonder Full нет поминутного API, а обычная Muse Wonder стоит как Claude Opus 5.5, уступая ей в ряде тестов.
Я бы тестировал обычную Muse Wonder для API‑агентов, а Muse Wonder Full — для длительной работы с репозиториями. Claude Opus 5.5 оставил бы для терминальных задач или сборки программ с нуля, а GPT‑6.1 Sol или Claude Sonnet 5.5 — когда решает стоимость.
Учитесь с DataCamp
{count, plural, one {Курс} few {Курса} many {Курсов} other {Курса}}
{count, plural, one {Курс} few {Курса} many {Курсов} other {Курса}}
{count, plural, one {Курс} few {Курса} many {Курсов} other {Курса}}