{count, plural, one {Kurs} other {Kurse}}
Konzepte großer Sprachmodelle (LLMs)
{hours} Std.
112.2K
Meta hat diese Woche Muse Wonder und Muse Wonder Full vorgestellt, die erste große Modellfamilie nach Muse Spark. Beide sind für KI-Agenten gebaut, die mehrstufige Aufgaben erledigen.
Metas Launch-Post bezeichnet Muse Wonder als Ergebnis eines 14-monatigen Neustarts der KI-Entwicklung. Zwei neue Kernbegriffe: Active Memory, das nützliche Details aus früheren Gesprächen wiederfindet, und Active Focus, das dranbleibt, wenn eine Aufgabe ins Stocken gerät.
Das reguläre Muse Wonder ist über die Meta Model API und Muse Code verfügbar, während Muse Wonder Full, das Modell hinter den meisten Top-Ergebnissen, nur in Muse Code auf den zwei teuersten Plänen läuft. Mehr dazu weiter unten.
Das nehme ich aus dem Launch mit:
Muse Wonder und Muse Wonder Full sind Reasoning-Modelle, laut Meta die bislang leistungsfähigsten, entwickelt für Agenten, die private und berufliche Aufgaben übernehmen. Die Model Card listet Text-, Bild-, Video- und Audioeingaben sowie reine Textausgabe, daher generiert keines der Modelle Bilder, Video oder Audio. Metas Developer-Dokumentation ergänzt PDF-Eingaben und nennt ein Kontextfenster von 1.048.576 Tokens.
Metas Research-Blog sagt, beide bauen auf der Trainingsarbeit von Muse Spark auf und wurden im Prometheus-Rechenzentrum trainiert. Parameterzahlen nennt Meta nicht.
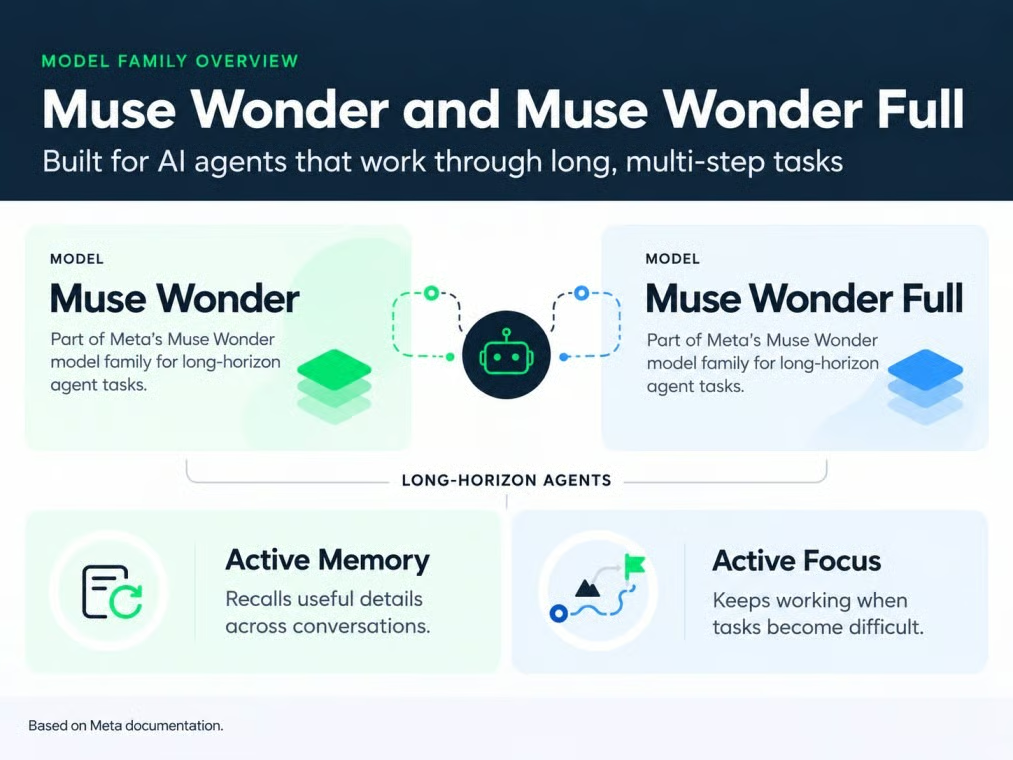
Muse Wonder gibt es in zwei Varianten. Bild: Autor.
Zwischen beiden ist Muse Wonder Full ein separates, leistungsfähigeres Modell. In den Developer-Dokumenten steht, dass das Hochdrehen des regulären Muse Wonder (muse-wonder-1.0) auf "max" Reasoning es nicht in Muse Wonder Full (muse-wonder-full-1.0) verwandelt.
Dir ist vielleicht aufgefallen, dass Meta den Namen Muse für mehrere Dinge verwendet. Kurz zusammengefasst:
Wenn Meta sagt, Muse Wonder „macht“ etwas, erledigt Muse Code oft die Hälfte der Arbeit. Das gilt für die meisten Coding-Ergebnisse unten.
Die zentralen Funktionen sind Active Memory und Active Focus, besonders sichtbar bei langen Coding-Jobs. Die Idee ist einfach: Ein Agent muss sich die richtigen Details merken und weitermachen, wenn ein Plan scheitert.
Active Memory ist Metas Begriff dafür, wichtige Details über Gespräche hinweg zu tragen und die aktuell benötigten abzurufen. Setzt du im März ein Homeoffice-Budget von 3.000 $, erhöhst es im April auf 4.000 $ und bittest im Mai um eine Möbelliste, nutzt ein gutes Gedächtnis die April-Zahl ohne Erinnerung.
Metas Beleg ist MemoryBench, ein eigener Test für lange Gespräche mit aktualisierten Fakten. Muse Wonder erzielt 85,6, was jedoch nichts über Erinnerungen über Monate aussagt, und eine auf der API aufgebaute App muss diese Fakten trotzdem selbst speichern. Das Feature interessiert mich am meisten, denn ein Agent mit altem Budget kann Geld kosten.
Active Focus ist Metas Bezeichnung für Durchhaltevermögen: eine andere Herangehensweise versuchen, Blocker abarbeiten und vor wichtigen Aktionen Rücksprache halten. Stell dir eine Code-Migration vor, bei der 30 Tests fehlschlagen. Ein fokussierter Agent korrigiert den Code und führt die Tests erneut aus, während ein schwächerer Agent nur die Tests so anpasst, dass sie bestehen.
Meta misst das mit FocusBench, einem weiteren eigenen Test, und mit SWE-Marathon, dazu gleich mehr im Benchmark-Teil. Keiner der beiden Tests garantiert ein fertiges Ergebnis, und Hintergrundarbeit hängt von der umgebenden Software ab – die Risiken für Always-on-Agenten beleuchten wir im OpenAI-Dots-Artikel.
Muse Wonder plant lange Coding-Jobs und teilt die Arbeit auf Helfer-Agenten auf, während Muse Code die Tools und Freigaben ausführt. Metas Developer-Seite positioniert es für Aufgaben, die „stundenlang laufen“ und bei denen viele Dateien parallel bearbeitet werden.
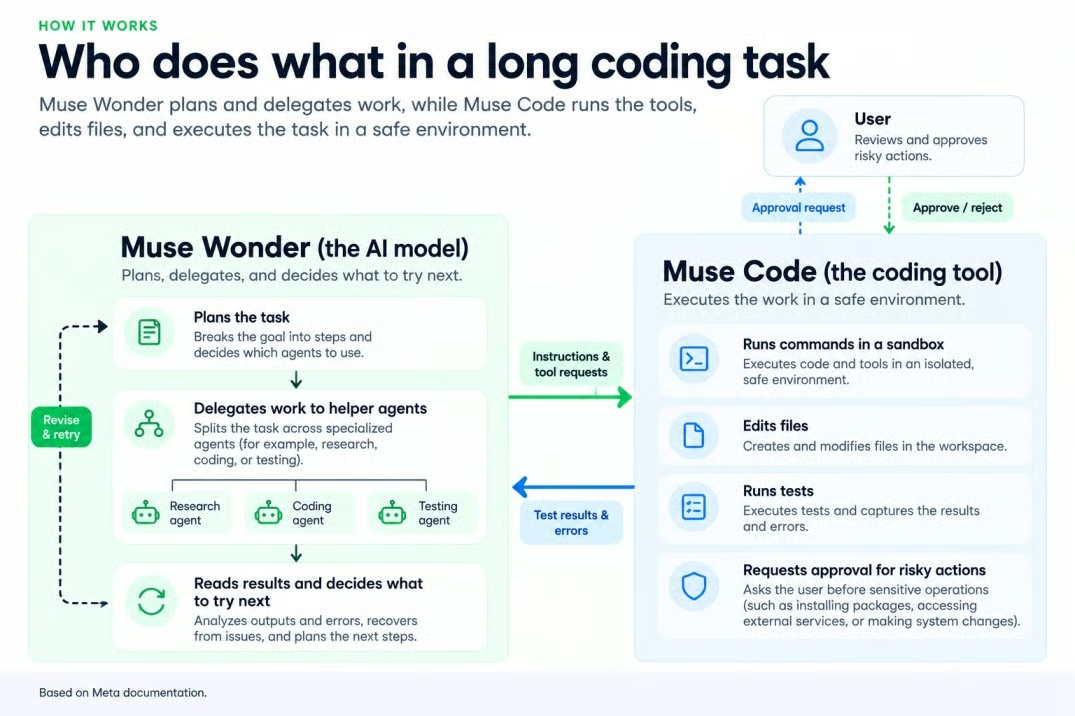
Muse Wonder plant, Muse Code führt aus. Bild: Autor.
Eines von Metas Demos ist ein spielbares 3D-Küchenspiel aus Bildern. Eine seltsame Wahl, da die Model Card 3D-Reasoning als bekannte Schwäche nennt (ich hätte ein anderes Demo gewählt).
Metas Tabelle begünstigt Muse Wonder Full bei langen Coding-Aufgaben und einigen Professional-Benchmarks, während Claude Opus 5.5 bei Terminal-Coding und dem Neuaufbau von Programmen führt. Die untenstehenden Zahlen stammen von Meta, sofern nicht anders angegeben, fast immer mit maximalem Reasoning (ich markiere die eine Ausnahme).
Muse Wonder Full führt in Metas Tabelle beide langen Coding-Tests an. Wie im Intro erwähnt, erreicht es 79,0 auf DeepSWE v1.1, das reguläre Muse Wonder liegt mit 78,8 knapp dahinter. Das sind vorerst Metas Zahlen, da Datacurves öffentliche DeepSWE-Bestenliste Muse Wonder noch nicht aufführt.
SWE-Marathon ist für mich der Watch-Index, weil seine 20 mehrstündigen Projekte mit null Punkten bewertet werden, wenn ein einziger Test scheitert. Meta meldet Muse Wonder Full mit 57,5 (eine Stufe unter dem höchsten Setting) und Muse Wonder mit 53,1, gegenüber 46,3 für Claude Opus 5.5 und 42,5 für GPT-6 Astra. Konkurrenzmodelle liefen in den jeweiligen hauseigenen Coding-Tools, daher sagt Meta selbst, dass der Vergleich nicht ganz fair ist. Und bei nur 20 Projekten kann ein Projekt den Score um mehrere Punkte verschieben.
Abundant AIs eigene SWE-Marathon-Bestenliste fällt moderater aus: Muse Wonder Full mit 53,1 % und das reguläre Muse Wonder mit 52,5 %, beide auf dem höchsten Setting in Muse Code, knapp vor Claude Sonnet 5.5 mit 51,3 %. Claude Haiku 5.5, fünf Tage früher erschienen, liegt bei 50,0 %. Die Listen stammen aus getrennten Tests, also nicht vermischen.
Metas Behauptung, Muse Wonder könne Arbeit über Apps hinweg ausführen, erhält gemischte Unterstützung. Auf AutomationBench-AA, das prüft, ob Business-Workflows im korrekten Endzustand landen, erzielt Muse Wonder Full 45,4 gegenüber 41,6 für GPT-6 Astra und 41,2 für Claude Opus 5.5, führt also, scheitert aber weiterhin an den meisten Workflows.
OSWorld V2.1, ein Set aus 108 Desktop-Aufgaben, ist aussagekräftiger. Muse Wonder Full erhält 78,4 mit Teilgutschrift, schließt aber nur 39,4 % der Aufgaben vollständig ab, und beide Claude-Modelle übertreffen seine Teilpunkte. Bei einem Versicherungsformular zählen „fast alle Schritte richtig“ noch als Fehlversuch, daher ist 39,4 % die Zahl, auf die man achten sollte.
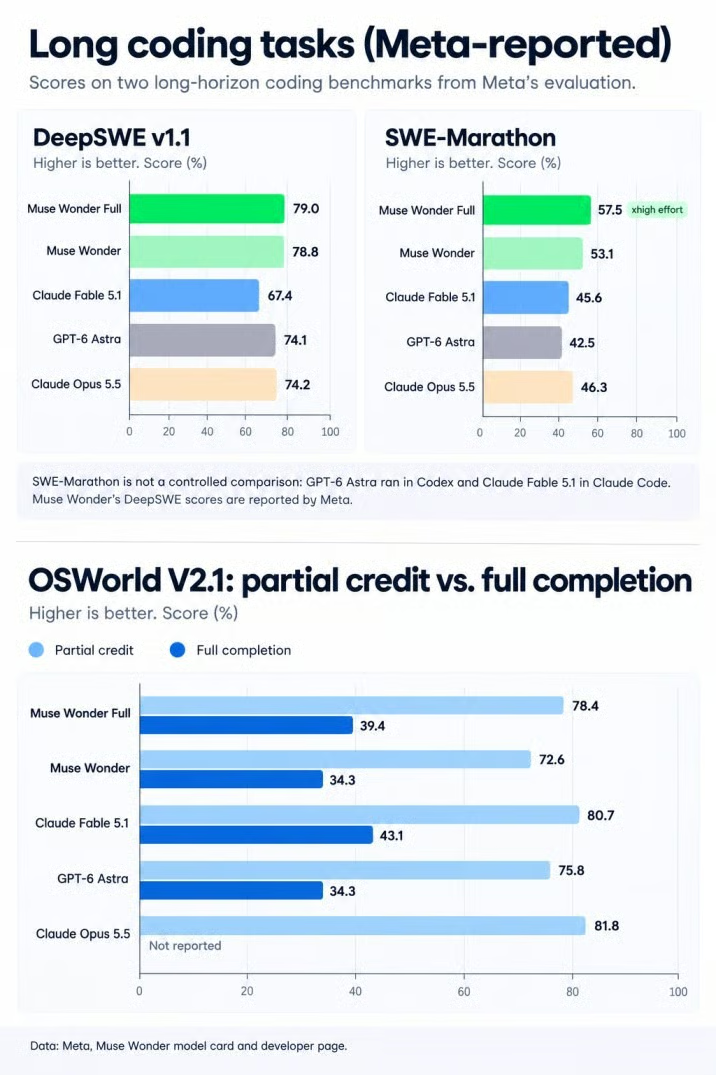
Starke Coding-Scores verdecken niedrige Abschlussraten. Quelle: Meta; Bild: Autor.
Muse Wonder Full führt beim Rechts-Benchmark und liegt bei Gesundheit zurück, Finanzen ist nahezu Gleichstand. Die Rechtswertung klingt klein, ist aber dreimal so hoch wie bei Claude Opus 5.5. In Artificial Analysis’ Version zählt ein juristisches Dokument nur, wenn es jede Anforderung ohne Erfundenes erfüllt. Muse Wonder Full erzielt 13,1 gegenüber 4,2 für Claude Opus 5.5, scheitert aber immer noch in rund 87 % der Aufgaben.
Finanzen ist nahezu pari: Muse Wonder Full mit 59,1 auf Vals Finance Agent V2 gegenüber 58,6 für Claude Opus 5.5. Gesundheit geht andersherum: Muse Wonder Full erzielt 62,3 auf HealthBench Pro, hinter Claude Opus 5.5 (65,6) und GPT-6 Astra (65,3).
Muse Wonder Full liegt in 6 von 14 Tests in Metas eigener Tabelle hinter Claude Opus 5.5, und GPT-6 Astra schlägt es in drei. Diese Tabelle sammelt die Niederlagen, die oben nicht abgedeckt sind.
|
Benchmark |
Was wird getestet |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Terminal-Coding |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Programme von Grund auf bauen |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Breiter Kompositindex |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Professionelle Tool-Nutzung |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Arbeiten mit PDFs |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Quelle: Metas Muse-Wonder-Developer-Seite zum Launch. Alle Modelle mit höchstem Reasoning-Setting.
ProgramBench ist die Niederlage, die Coder beachten sollten, und sie ist deutlich. Es fordert Modelle auf, ein Programm von Grund auf neu zu bauen – und ein Abstand von 11,5 Punkten zeigt, dass das Bearbeiten eines bestehenden Codebases und der Neuaufbau verschiedene Fähigkeiten sind.
Artificial Analysis listet Muse Wonder Full mit 55,8, was Meta auf 56 rundet, während Claude Sonnet 5.5 56,0 erzielt.
Kann man Muse Wonders Benchmarks trauen? Nicht vollständig. Die Model Card zeigt, dass die Tabelle drei Arten von Evidenz mischt:
Wie erwähnt, laufen fast alle Scores auf dem höchsten Reasoning-Setting – du siehst also jedes Modell in Bestform. Ergebnisse variieren auch je nach Tester: Anthropic meldet 66,4 % für Claude Opus 5.5 auf Terminal-Bench 4.0, gegenüber 59,6 in Metas Tabelle. Metas Behauptung, Muse Wonder Full meistere unbekannte Aufgaben besser als die Spark-Modelle, basiert auf eigener Analyse.
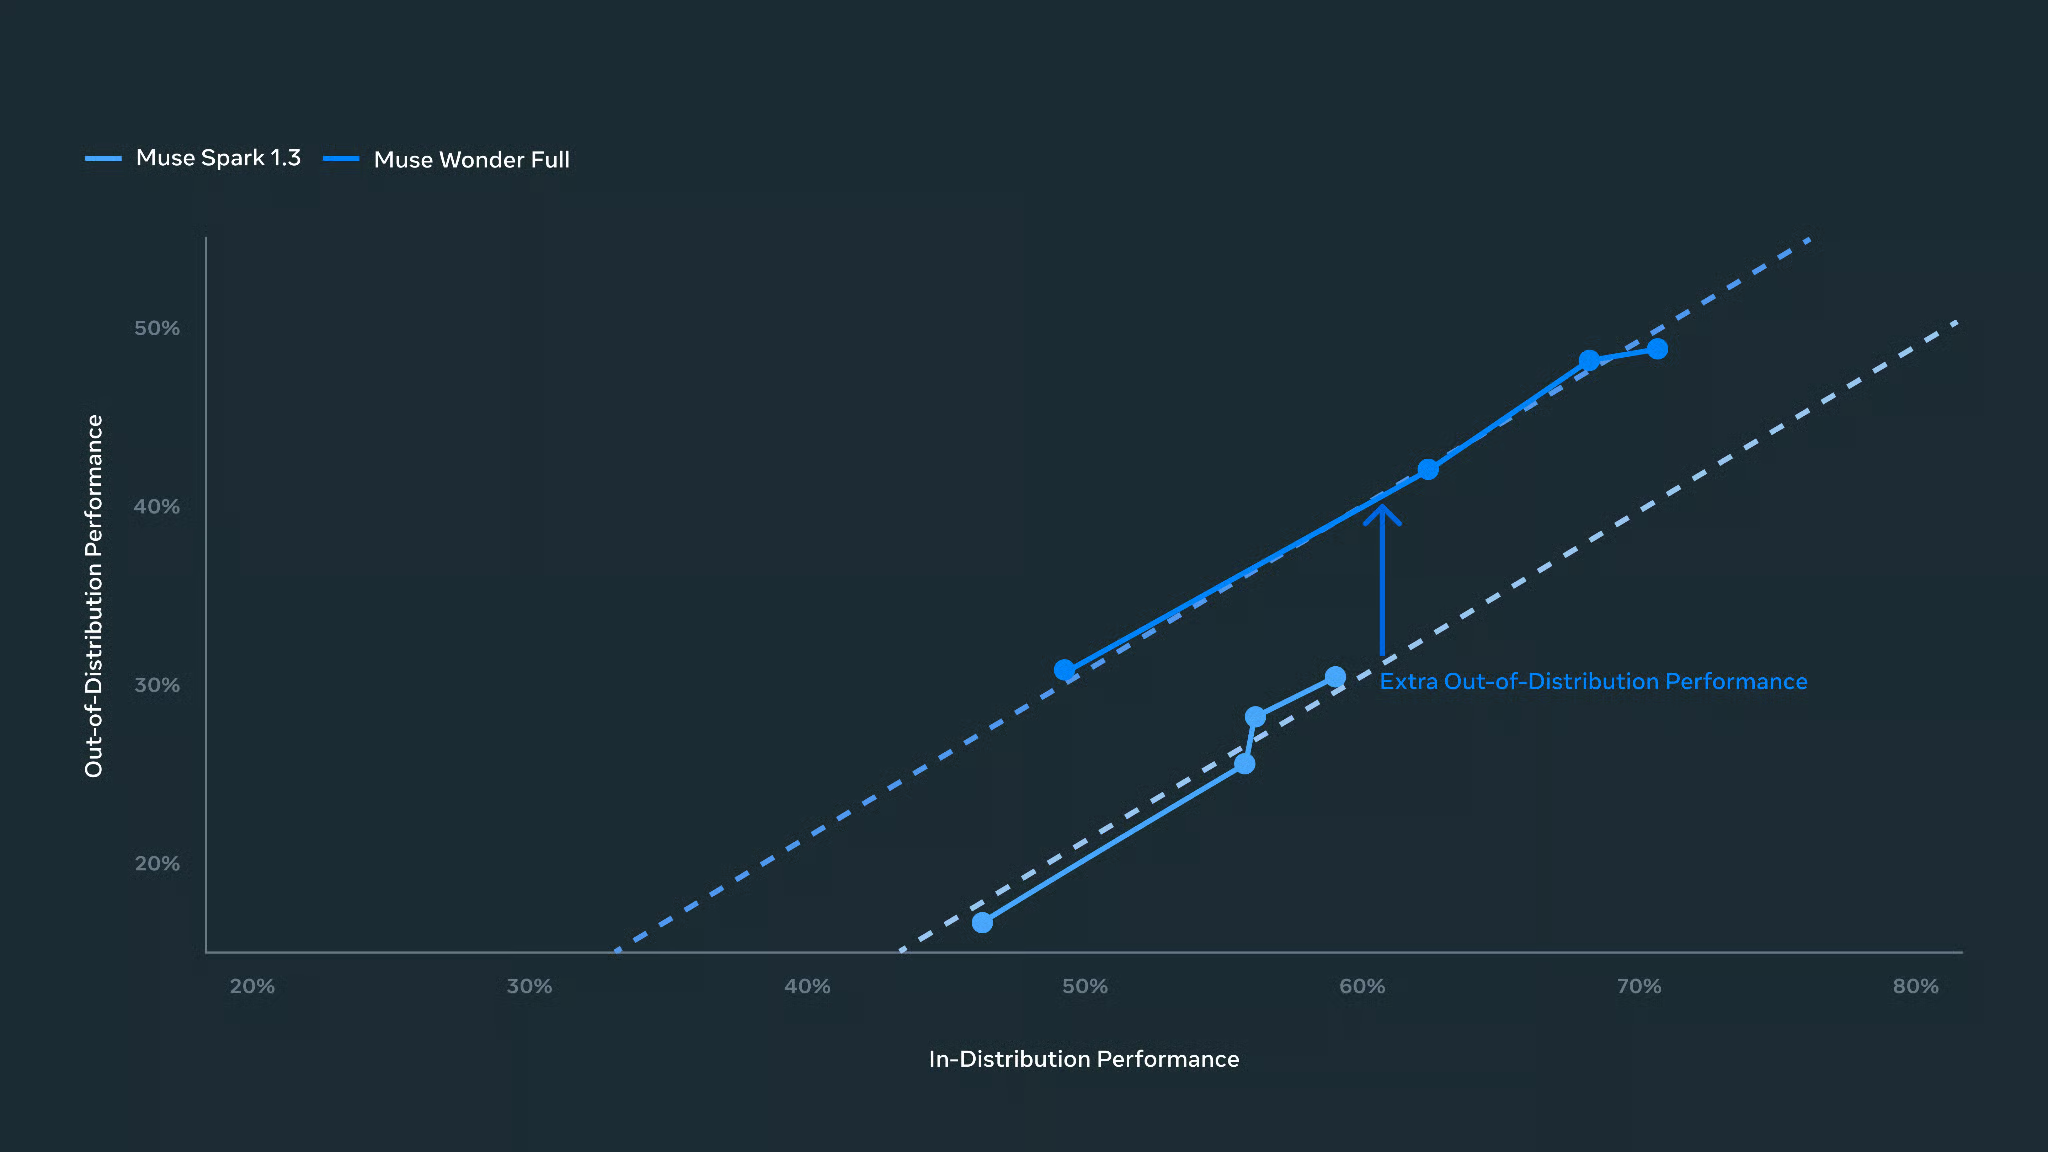
Meta vergleicht die Performance auf unbekannten Aufgaben. Quelle: Meta.
Nach Metas Zahlen gewinnt Muse Wonder Full lange Coding-Jobs (aber nur innerhalb von Muse Code), Claude Opus 5.5 gewinnt Terminal-Arbeit und Neuaufbau, und GPT-6 Astra führt nur eine Zeile in Metas Tabelle an. Dieser Teil fasst Benchmarks zusammen, vieles wird dir daher bekannt vorkommen.
Automation ist geteilt: Muse Wonder Full führt bei AutomationBench-AA, während die Claude-Modelle bei OSWorld-Teilgutschrift führen. Unter den Modellen mit gemeldetem Vollabschluss schafft keines die Mehrheit der Aufgaben. Beim breiten Reasoning führt Claude Opus 5.5 den Artificial-Analysis-Index an, auf dem das reguläre Muse Wonder 52,4 erreicht.
Beim Preis wirkt das reguläre Muse Wonder schwächer. GPT-6.1 Sol kostet pro Token halb so viel und erzielt 51,8 auf demselben Index, und Claude Sonnet 5.5 kostet so viel wie GPT-6.1 Sol.
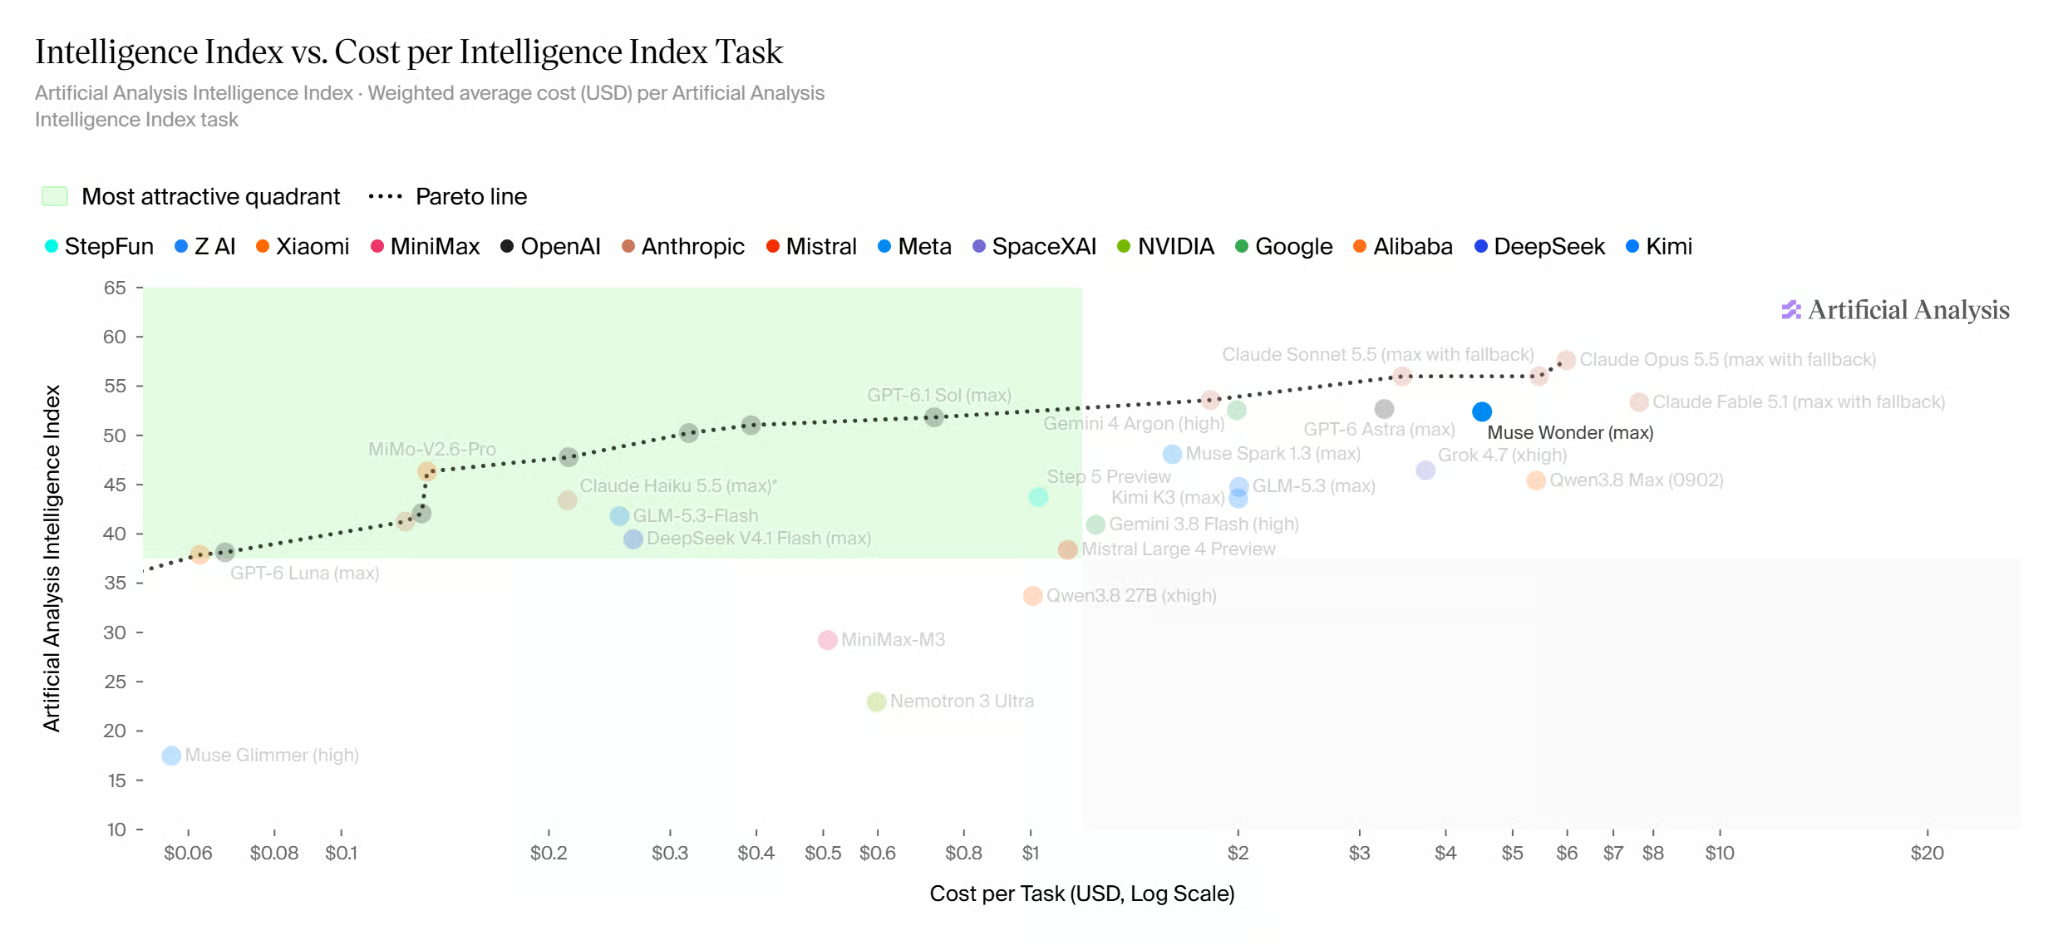
Muse Wonder balanciert Kosten und Intelligenz. Quelle: Artificial Analysis.
Ich hätte Gemini 4 Argon fast weggelassen, da Meta es nicht getestet hat und – wie unser Bericht zu Gemini 4 Argon festhält – es zuerst an vertrauenswürdige Cybersicherheitsteams ging. Ohne gemeinsame Ergebnisse ist ein fairer Direktvergleich nicht möglich; entscheide nach Workload und den Kosten pro abgeschlossenem Task.
Muse Wonder passt am besten zu zwei Arten von Arbeit: große Softwareänderungen und mehrstufige Browser-Workflows. Lange Planungsaufgaben – wie Metas Demo zur Sitzordnung einer Hochzeit – hängen stärker von der umgebenden App ab.
Hier ist die Evidenz am stärksten, zumindest für Änderungen an bestehendem Code. In Muse Code arbeitet Muse Wonder dateiübergreifend, führt Tests aus, liest Fehler und versucht es erneut – genau das messen DeepSWE und SWE-Marathon. In realen Repos: Nur nötige Berechtigungen geben und Änderungen menschlich reviewen lassen.
Metas „Saturday Run Planning“-Demo zeigt Muse Wonder „direkt im Browser und über Apps hinweg“, eine weitere Demo bearbeitet einen Versicherungsschaden. Da Muse Wonder Full weniger als 4 von 10 Desktop-Aufgaben vollständig abschließt, braucht ein echter Workflow deine Freigabe, bevor etwas eingereicht oder bezahlt wird.
Du zahlst Muse Wonder auf zwei Arten: pro Token für das reguläre Muse Wonder oder per monatlichem Muse-Code-Abo, das – wie im Intro erwähnt – der einzige Weg zu Muse Wonder Full ist.
Metas Preisseite listet das reguläre Muse Wonder mit 4,00 US-Dollar pro Million Eingabetokens, 0,20 US-Dollar für gecachte Eingaben und 20,00 US-Dollar für Ausgaben. Das ist ein großer Sprung von Muse Spark 1.3 (1,25 und 4,25 US-Dollar) und entspricht den Preisen von Claude Opus 5.5 – ein Hinweis, wo Meta Muse Wonder einordnet.
GPT-6 Astra liegt bei 10, 1 (gecached) und 50 US-Dollar, und GPT-6.1 Sol bei 2, 0,10 und 10 US-Dollar. Das folgende Beispiel wendet diese Startpreise auf eine Coding-Aufgabe mit 3 Millionen Eingabetokens (2,4 Millionen gecached) und 200.000 Ausgabetokens an, angenommen, keine einzelne Anfrage überschreitet 272.000 Tokens, ab der GPT-6 Astras Preise steigen.
|
Modell |
Ungecachte Eingabe (0,6 Mio.) |
Gecachte Eingabe (2,4 Mio.) |
Ausgabe (0,2 Mio.) |
Gesamt pro Aufgabe |
|
Muse Wonder |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
Claude Opus 5.5 |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
GPT-6 Astra |
$6,00 |
$2,40 |
$10,00 |
$18,40 |
|
GPT-6.1 Sol |
$1,20 |
$0,24 |
$2,00 |
$3,44 |
Gleiche Tokenpreise bedeuten gleiche Kosten pro Versuch, daher zählt der Preis pro abgeschlossenem Task. Schließt Muse Wonder jeden zweiten Versuch ab, sind das 13,76 $, genau wie ein Modell zum GPT-6.1-Sol-Preis, das jeden vierten Versuch abschließt (beide Raten sind fiktiv).
Muse Wonder Full gibt es nur mit den monatlichen Muse-Code-Plänen, die eine Pauschale statt pro Token berechnen. Du kannst diesen Teil überspringen, wenn du nur die API nutzen willst. Metas Abo-Dokumentation listet vier Pläne:
Metas Muse-Code-Produktseite zeigt Preise nur für Power und Maximum – eine seltsame Auslassung –, prüfe die niedrigeren Pläne daher beim Checkout. Das reguläre Muse Wonder ist in jedem Plan enthalten.
Jeder Plan hat ein Nutzungslimit, das sich periodisch zurücksetzt. Ungenutztes Kontingent verfällt, und das Abo kann nicht als API-Guthaben genutzt werden.
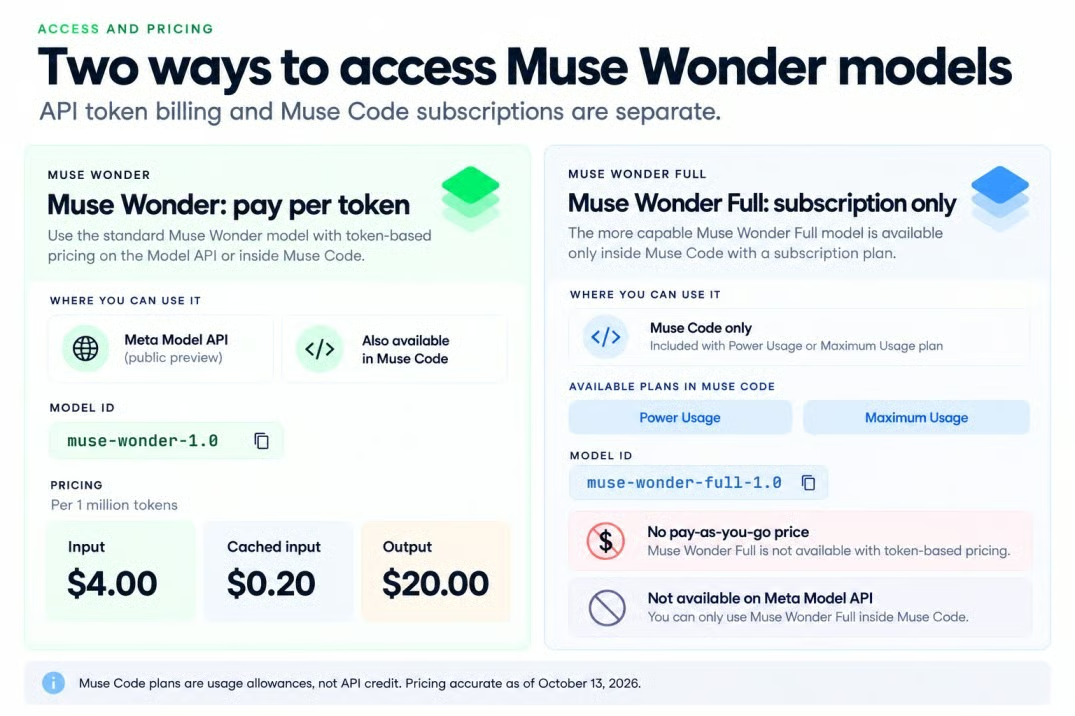
Zwei Wege zur Muse-Wonder-Nutzung und -Bepreisung. Quelle: Meta; Bild: Autor.
Power ist der günstigste Weg, Muse Wonder Full auszuprobieren, allerdings hat Meta nicht gesagt, wie viele große Tasks das Kontingent abdeckt. Darauf würde ich achten, da ein früher Nutzer berichtete, dass einige kleine Anfragen etwa die Hälfte des 5-Stunden-Limits eines Einstiegsplans verbrauchten – mehr dazu bei den Entwicklerreaktionen.
Zur Erinnerung an die Aufteilung aus dem Intro: Das reguläre Muse Wonder ist über die Meta Model API und Muse Code verfügbar, Muse Wonder Full nur über Muse Code.
Für die Muse-Wonder-API brauchst du ein Meta-Developer-Konto, einen API-Schlüssel und Abrechnung; die Modell-ID lautet muse-wonder-1.0. Meta nennt die API auf der Produktseite weiterhin „Public Preview“, Code auf Basis des OpenAI-SDK lässt sich darauf umbiegen, und Meta listet auch OpenRouter als Zugang.
Der Zugang ist nicht global. Metas Geographic Use Policy sperrt mehrere Länder, darunter China, Russland, Iran, Pakistan, Eritrea und Äthiopien.
Für Muse Wonder Full brauchst du einen Power- oder Maximum-Muse-Code-Plan, ein Meta-Konto und musst 18 Jahre oder volljährig sein. Wie im Preisabschnitt erwähnt, ist es in der Model API zu keinem Preis verfügbar, und seine ID muse-wonder-full-1.0 funktioniert nur innerhalb von Muse Code. In der Dokumentation sind macOS, Linux und Windows genannt, auf der Produktseite jedoch nur macOS und Windows.
Die Risiken rühren von denselben Punkten her, mit denen Meta wirbt: langen Läufen und Zugriff auf deine privaten Dateien.
Die Model Card nennt drei Schwächen, die Agenten beeinträchtigen können. Jede verursacht andere Probleme:
Das sind keine isolierten Antwortqualitätsprobleme, wenn das Modell Tools nutzen kann. Ein falscher Klick oder eine schlechte Annahme zu Beginn einer zweistündigen Aufgabe kann den Rest verderben.
Es hängt vom Modus ab – lies das, bevor du Muse Code auf ein privates Repository loslässt. Metas Nutzungsbedingungen, drei Tage vor dem Launch aktualisiert, sagen: Meta trainiert nicht auf Inhalten, die an die Standard Services gesendet werden, während Inhalte im Contributor Mode zum „Trainieren, Entwickeln, Evaluieren und Verbessern“ der Modelle genutzt werden können.
Muse-Code-Abos starten im Contributor Mode im Tausch gegen mehr Nutzung, und du musst in den Einstellungen auf Standard umstellen. Der Wechsel gilt nur für die Zukunft, bereits Gesendetes kann weiterhin fürs Training genutzt werden. Diese Voreinstellung gefällt mir gar nicht.
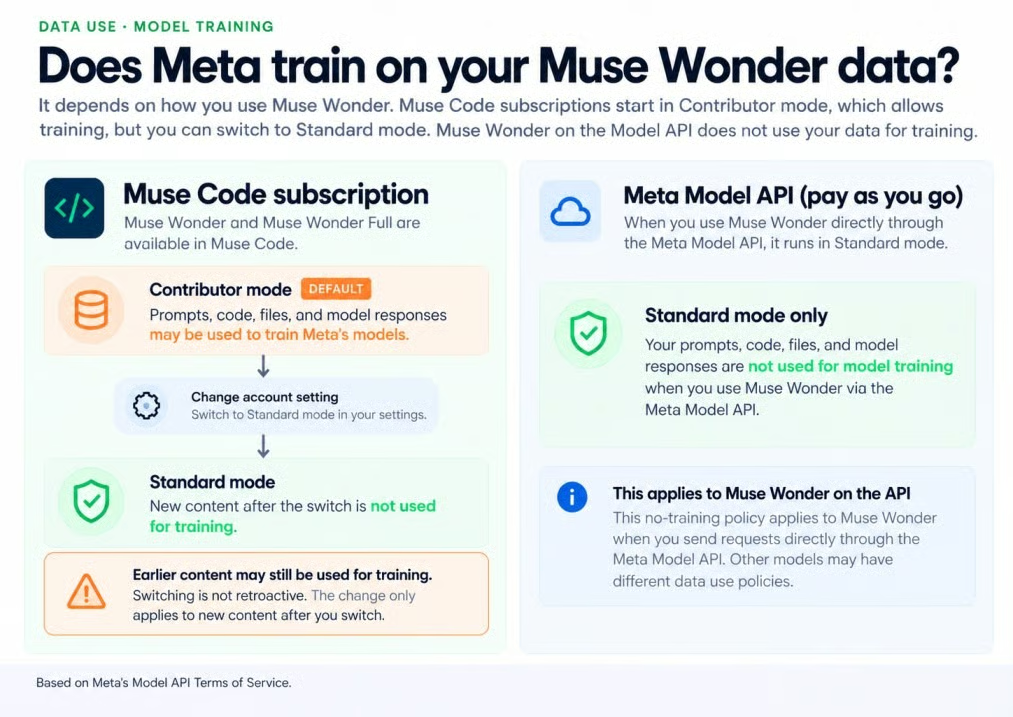
Contributor-Inhalte können Meta-Modelle trainieren. Quelle: Meta Terms; Bild: Autor.
Die Bedingungen sagen außerdem, dass du im Contributor Mode keine sensiblen, vertraulichen oder persönlichen Informationen einreichen darfst – inklusive privatem Code. Das reguläre Muse Wonder über die Pay-as-you-go-API läuft ausschließlich im Standard Mode.
Meta hat Muse Wonder Full nach seinem Superintelligence Scaling Framework geprüft. Ohne Safeguards schließt Meta nicht aus, dass es in Hochrisikobereiche für chemische und biologische Bedrohungen vordringt; mit Safeguards bewertet Meta alle Risiken als „moderat oder niedriger“.
Eine Risikobewertung ist keine Sicherheitsgarantie, und ein ausführlicherer Report soll „bald“ folgen. Der Rat der Model Card ist simpel: Fordere für nicht rückgängige Aktionen menschliche Bestätigung ein und halte den Agenten in einer Sandbox mit begrenzten Rechten.
Reaktionen zum Launch-Tag auf X schwankten zwischen raschem Fortschritt, uneinheitlicher Leistung und Frust über Nutzungslimits. Das sind Kurztests und persönliche Eindrücke, keine kontrollierten Evaluierungen.
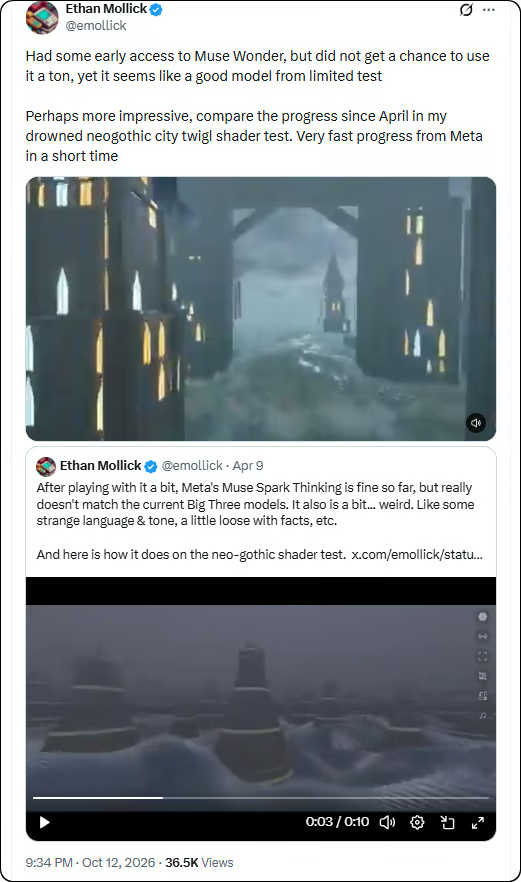
Eine vorsichtig positive Sicht kam von einem frühen Tester mit begrenzter Zeit, der Muse Wonder aber als gut einstufte. Der größere Punkt: wie weit Metas Modelle seit Muse Spark im April gekommen sind.
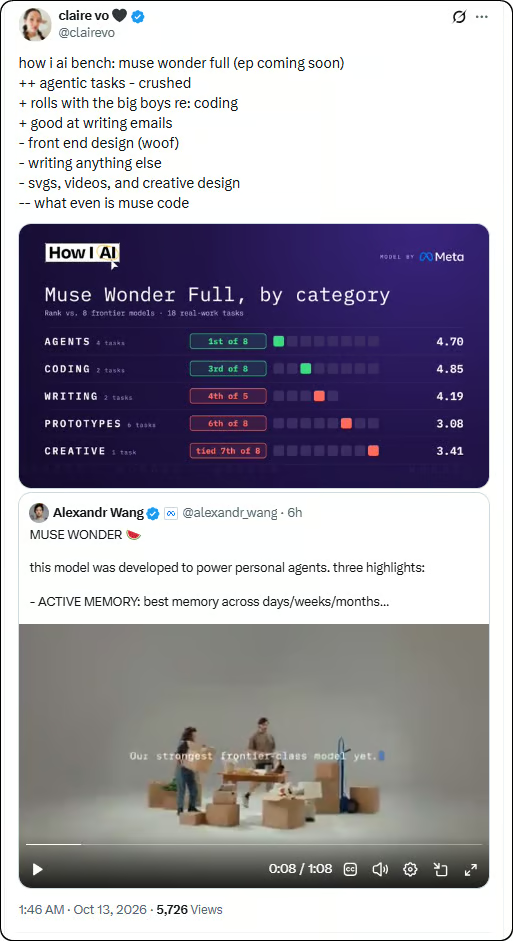
Ein breiterer Kategorietest zeichnete ein weniger rundes Bild. Muse Wonder Full lag bei Agenten und Coding vorn, fiel aber bei Writing, Frontend-Design und Kreativarbeit zurück.
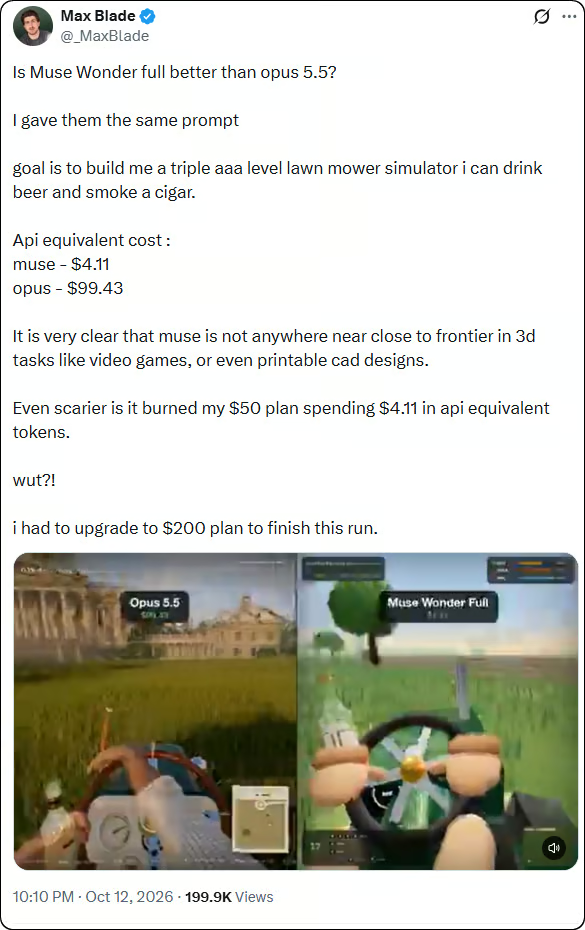
Die schärfste Kritik betraf Kosten und Planlimits. In einem identischen Prompt-Test zum Rasenmäher verbrauchte Muse Wonder Full umgerechnet etwa 4,11 $ an API-Tokens, lieferte aber ein schwächeres 3D-Ergebnis als Claude Opus 5.5, und der Tester sagte, der Abschluss habe ein Upgrade vom 50-$- auf den 200-$-Plan erfordert.
Zusammen legen die Posts nahe: Muse Wonder ist konkurrenzfähig, aber uneinheitlich. Mehr Wiederholungstests sind nötig, bevor man ein Ergebnis als typisch ansieht.
Ein Großteil der Evidenz stammt weiterhin von Meta. Für Muse Wonder Full gibt es keine Pay-as-you-go-API, und das reguläre Muse Wonder kostet so viel wie Claude Opus 5.5, liegt in mehreren Tests aber dahinter.
Ich würde das reguläre Muse Wonder für API-Agenten und Muse Wonder Full für lange Repo-Arbeiten testen. Für Terminal-Arbeit oder Programme von Grund auf würde ich Claude Opus 5.5 behalten und GPT-6.1 Sol oder Claude Sonnet 5.5 nutzen, wenn die Kosten entscheiden.
Lerne mit DataCamp
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Blog} other {Blogs}}
Hesam Sheikh Hassani
15 Min.
{count, plural, one {Blog} other {Blogs}}
{count, plural, one {Blog} other {Blogs}}
Zoumana Keita
15 Min.
{count, plural, one {Blog} other {Blogs}}
Nathaniel Taylor-Leach
{count, plural, one {Blog} other {Blogs}}
Nathaniel Taylor-Leach
4 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Matt Crabtree
5 Min.