{count, plural, one {Curs} few {Cursuri} other {Cursuri}}
Concepte privind Modelele de Limbaj de Mari Dimensiuni (LLM)
{hours} ore
112.2K
Săptămâna aceasta, Meta a lansat Muse Wonder și Muse Wonder Full, prima sa familie de modele majore după Muse Spark. Ambele sunt create pentru agenți AI care gestionează sarcini în mai mulți pași.
Postarea de lansare a Meta spune că Muse Wonder este rezultatul unei reconstrucții de 14 luni a muncii lor pe AI. Cei doi termeni noi de știut sunt Active Memory, care reține detalii utile din conversațiile trecute, și Active Focus, care continuă să lucreze când o sarcină se împotmolește.
Varianta standard Muse Wonder este disponibilă prin Meta Model API și Muse Code, în timp ce Muse Wonder Full, modelul din spatele majorității rezultatelor de top, rulează doar în Muse Code pe cele două abonamente cele mai scumpe. Vom intra în detalii mai târziu.
Iată ce am reținut din lansare:
Muse Wonder și Muse Wonder Full sunt modele de raționament pe care Meta le numește cele mai capabile de până acum, construite pentru agenți care gestionează sarcini personale și de lucru. Fișa modelului listează intrare text, imagine, video și audio și ieșire doar text, deci niciunul dintre modele nu generează imagini, video sau audio. Documentația pentru dezvoltatori adaugă intrare PDF și fixează fereastra de context la 1.048.576 de tokeni.
Blogul de cercetare al Meta spune că ambele se bazează pe munca de antrenare a Muse Spark și au fost antrenate în centrul de date Prometheus al Meta. Nu există valori pentru numărul de parametri.
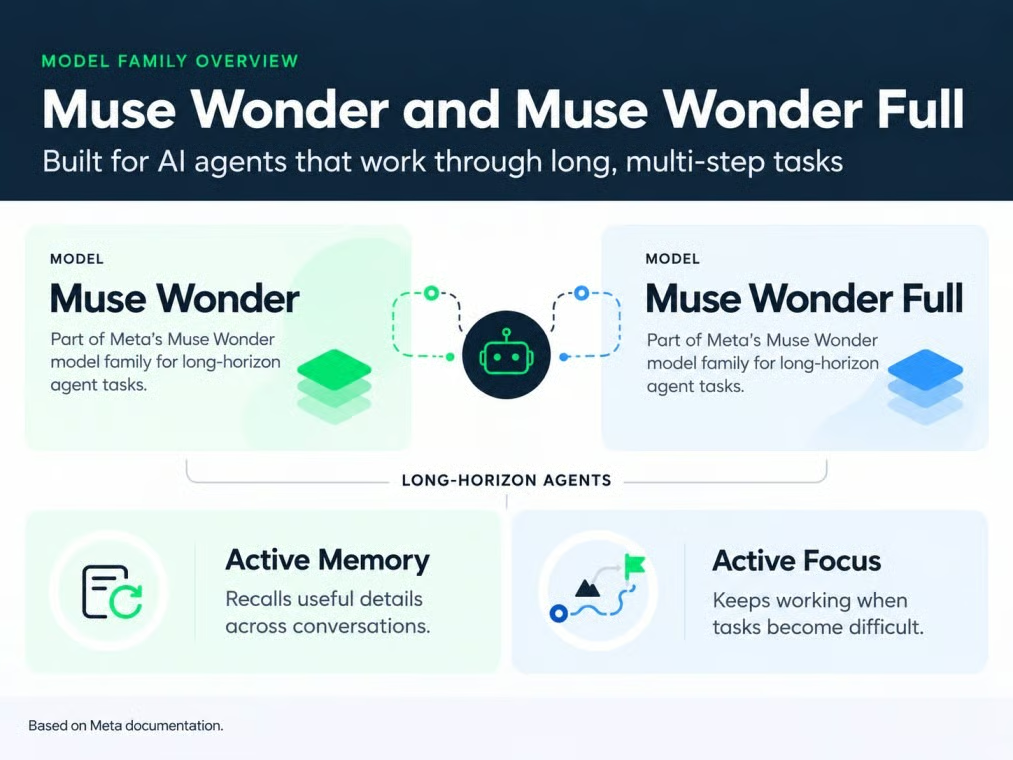
Muse Wonder are două variante. Imagine de autor.
Între cele două, Muse Wonder Full este un model separat, mai capabil. Documentația pentru dezvoltatori spune că ridicarea raționamentului pentru Muse Wonder standard (muse-wonder-1.0) la "max" nu îl comută la Muse Wonder Full (muse-wonder-full-1.0).
Probabil ai observat că Meta folosește numele Muse pentru mai multe lucruri. Recapitulare:
Când Meta spune că Muse Wonder „face” ceva, de multe ori Muse Code face jumătate din muncă. Asta se aplică pentru majoritatea rezultatelor de programare de mai jos.
Caracteristicile cheie ale Muse Wonder sunt Active Memory și Active Focus, iar sarcinile lungi de programare sunt locul unde Meta le evidențiază. Ideea din spatele ambelor e simplă: un agent trebuie să-și amintească detaliile potrivite și să continue când un plan eșuează.
Active Memory este termenul Meta pentru a transporta detalii importante între conversații și a le aduce în față pe cele de care are nevoie acum. Să zicem că în martie setezi un buget de 3.000 $ pentru biroul de acasă, îl ridici la 4.000 $ în aprilie și în mai ceri o listă scurtă de piese de mobilier. O memorie bună înseamnă că agentul folosește suma din aprilie fără să-i amintești.
Dovada Meta este MemoryBench, propriul test al conversațiilor lungi unde faptele sunt actualizate. Muse Wonder obține 85,6 la el, dar asta nu spune nimic despre rechemare pe luni de zile, iar o aplicație construită pe API tot trebuie să stocheze acele fapte ea însăși. Aceasta e funcția care mă interesează cel mai mult, pentru că un agent care lucrează după un buget vechi te poate costa bani.
Active Focus este denumirea Meta pentru perseverență: să încerce o altă abordare, să depășească blocajele și să ceară confirmare înainte de acțiuni importante. Imaginează-ți o migrare de cod în care 30 de teste eșuează. Un agent concentrat își repară codul și rulează din nou testele, pe când unul mai slab doar editează testele ca să treacă.
Meta măsoară asta cu FocusBench, un alt test propriu, și cu SWE-Marathon, la care voi ajunge în secțiunea de benchmarkuri. Niciuna nu garantează finalizarea unei sarcini, iar lucrul în fundal depinde de software-ul din jurul modelului, un risc acoperit în explicatorul nostru OpenAI Dots despre agenți mereu activi.
Muse Wonder planifică sarcini lungi de programare și împarte munca între agenți asistenți, în timp ce Muse Code rulează instrumentele și aprobările. Pagina pentru dezvoltatori a Meta o prezintă pentru sarcini care „rulează ore în șir”, cu multe fișiere editate simultan.
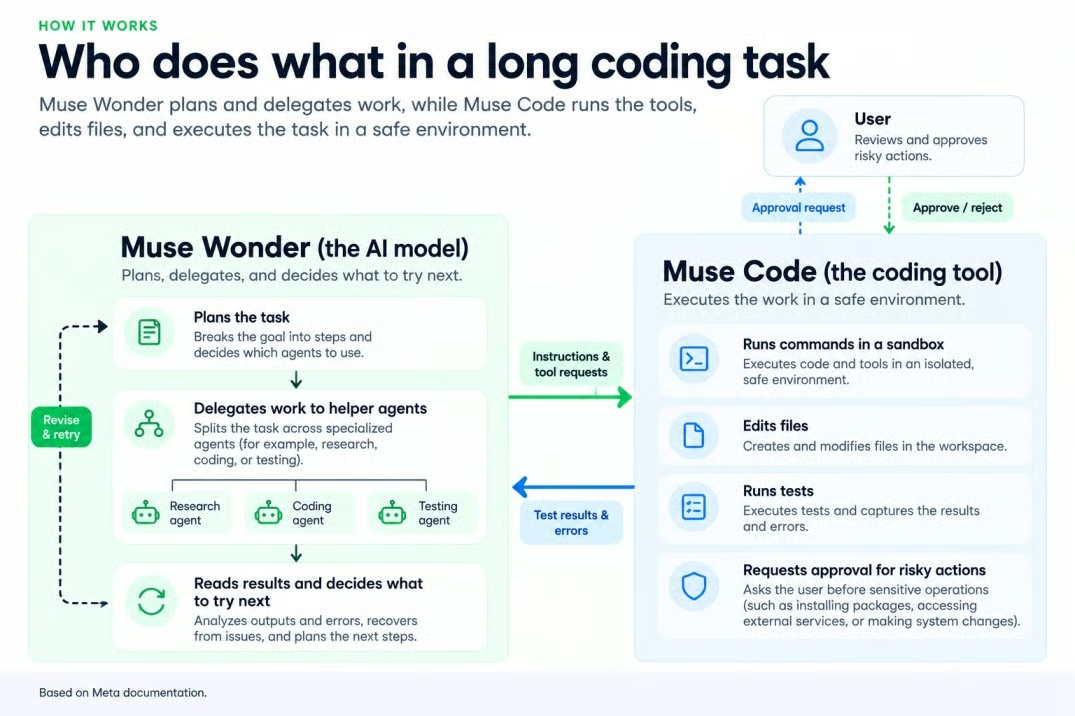
Muse Wonder planifică; Muse Code execută. Imagine de autor.
Unul dintre demo-urile Meta este un joc 3D jucabil cu bucătărie, construit din imagini. E o alegere ciudată, deoarece fișa modelului listează raționamentul 3D ca slăbiciune cunoscută (aș fi ales alt demo).
Tabelul Meta favorizează Muse Wonder Full la programare de durată și unele benchmarkuri profesionale, în timp ce Claude Opus 5.5 conduce la programare în terminal și construire de programe de la zero. Numerele de mai jos sunt ale Meta dacă nu e menționat altfel, cu aproape fiecare model la setarea maximă de raționament (voi semnala singura excepție).
Muse Wonder Full e pe primul loc în ambele teste lungi de programare din tabelul Meta. Cum am menționat în introducere, obține 79,0 pe DeepSWE v1.1, cu Muse Wonder standard aproape în spate la 78,8. Acestea sunt deocamdată numerele Meta, deoarece clasamentul public DeepSWE al Datacurve încă nu listează Muse Wonder.
SWE-Marathon este cel pe care l-aș urmări, deoarece cele 20 de proiecte de câteva ore punctează cu zero dacă un singur test eșuează. Meta raportează Muse Wonder Full la 57,5 (un pas sub setarea sa cea mai înaltă) și Muse Wonder la 53,1, față de 46,3 pentru Claude Opus 5.5 și 42,5 pentru GPT-6 Astra. Modelele rivale au rulat în propriile instrumente de programare ale companiilor lor, așa că Meta însăși spune că comparația nu e complet corectă, iar cu doar 20 de proiecte, un proiect poate schimba scorul cu câteva puncte.
Clasamentul propriu al Abundant AI pentru SWE-Marathon o pune mai modest: Muse Wonder Full la 53,1% și Muse Wonder standard la 52,5%, ambele la setarea maximă în Muse Code, puțin înaintea lui Claude Sonnet 5.5 la 51,3%. Claude Haiku 5.5, pe care Anthropic l-a lansat cu cinci zile mai devreme, stă la 50,0%. Cele două liste provin din teste separate, deci nu le amesteca.
Afirmația Meta că Muse Wonder poate duce munca la capăt prin aplicații primește susținere mixtă. Pe AutomationBench-AA, care verifică dacă fluxurile de lucru de business ajung în starea corectă, Muse Wonder Full obține 45,4 față de 41,6 pentru GPT-6 Astra și 41,2 pentru Claude Opus 5.5, deci conduce, dar tot eșuează în majoritatea fluxurilor.
OSWorld V2.1, un set de 108 sarcini pe desktop, îți spune mai mult. Muse Wonder Full câștigă 78,4 la credit parțial, dar finalizează complet doar 39,4% dintre sarcini, iar ambele modele Claude îi depășesc scorul parțial. Pentru un formular de asigurare, să faci majoritatea pașilor corect tot înseamnă sarcină eșuată, deci 39,4% e numărul de urmărit.
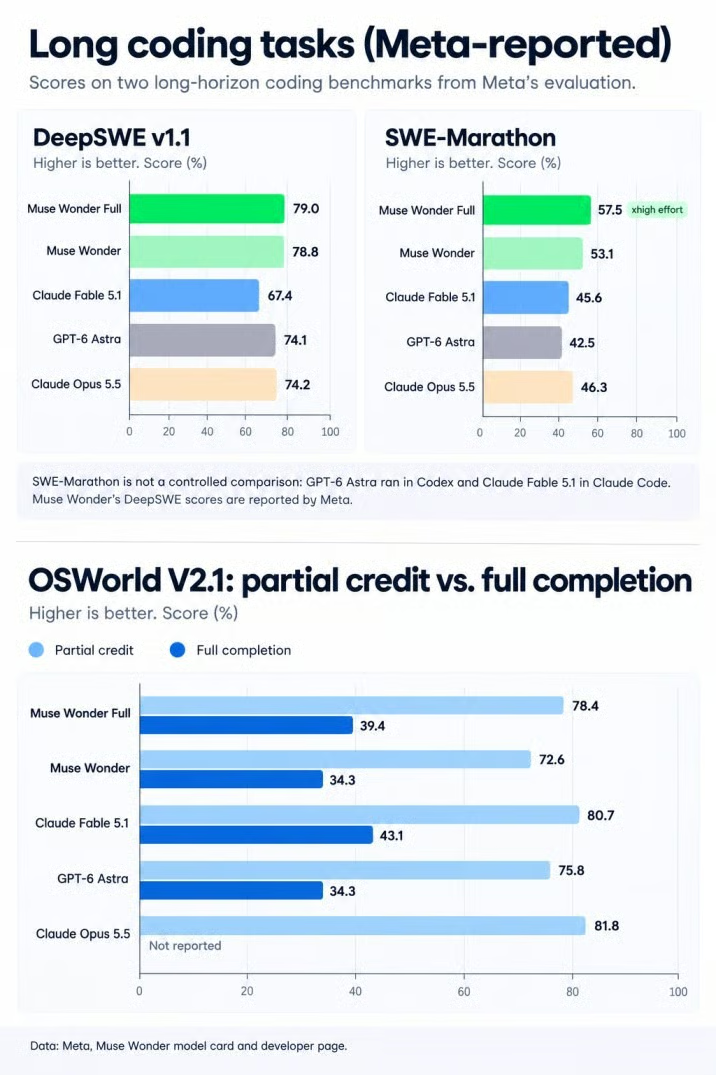
Avantajele la cod ascund rate mai scăzute de finalizare. Sursă: Meta; imagine de autor.
Muse Wonder Full conduce benchmarkul juridic și rămâne în urmă la sănătate, cu finanțele aproape la egalitate. Scorul juridic sună mic, și totuși e de trei ori mai mare decât al lui Claude Opus 5.5. În versiunea Artificial Analysis, un document juridic contează doar dacă îndeplinește fiecare cerință fără conținut inventat, iar Muse Wonder Full obține 13,1 față de 4,2 pentru Claude Opus 5.5, ceea ce tot înseamnă eșec la aproximativ 87% dintre sarcini.
La finanțe e aproape egalitate, cu Muse Wonder Full la 59,1 pe Vals Finance Agent V2 față de 58,6 pentru Claude Opus 5.5. La sănătate e invers: Muse Wonder Full obține 62,3 pe HealthBench Pro, în urma lui Claude Opus 5.5 (65,6) și GPT-6 Astra (65,3).
Muse Wonder Full rămâne în urma lui Claude Opus 5.5 la șase dintre cele 14 teste din chiar tabelul Meta, iar GPT-6 Astra îl depășește la trei. Acest tabel adună pierderile neacoperite mai sus.
|
Benchmark |
Ce testează |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Programare în terminal |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Construirea programelor de la zero |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Compus larg |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Utilizare de instrumente profesionale |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Lucru din PDF-uri |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Sursă: pagina pentru dezvoltatori a Muse Wonder la lansare. Toate modelele la setarea maximă de raționament.
ProgramBench este pierderea care ar trebui să-i intereseze pe programatori și nu e strânsă. Cere modelelor să reconstruiască un program de la zero, iar un decalaj de 11,5 puncte arată că a edita un cod existent și a construi din nimic sunt abilități diferite.
Artificial Analysis listează Muse Wonder Full la 55,8, pe care tabelul Meta îl rotunjește la 56, în timp ce Claude Sonnet 5.5 obține 56,0.
Poți avea încredere deplină în rezultatele benchmarkurilor pentru Muse Wonder? Nu pe deplin. Fișa modelului Meta arată că tabelul amestecă trei tipuri de dovezi:
După cum am notat mai devreme, aproape fiecare scor folosește setarea maximă de raționament, deci vezi fiecare model la cel mai bun nivel al său. Rezultatele se schimbă și în funcție de evaluator: Anthropic raportează 66,4% pentru Claude Opus 5.5 pe Terminal-Bench 4.0, față de 59,6 în tabelul Meta. Afirmația Meta că Muse Wonder Full gestionează mai bine sarcini nefamiliare decât modelele Spark se bazează pe propria sa analiză.
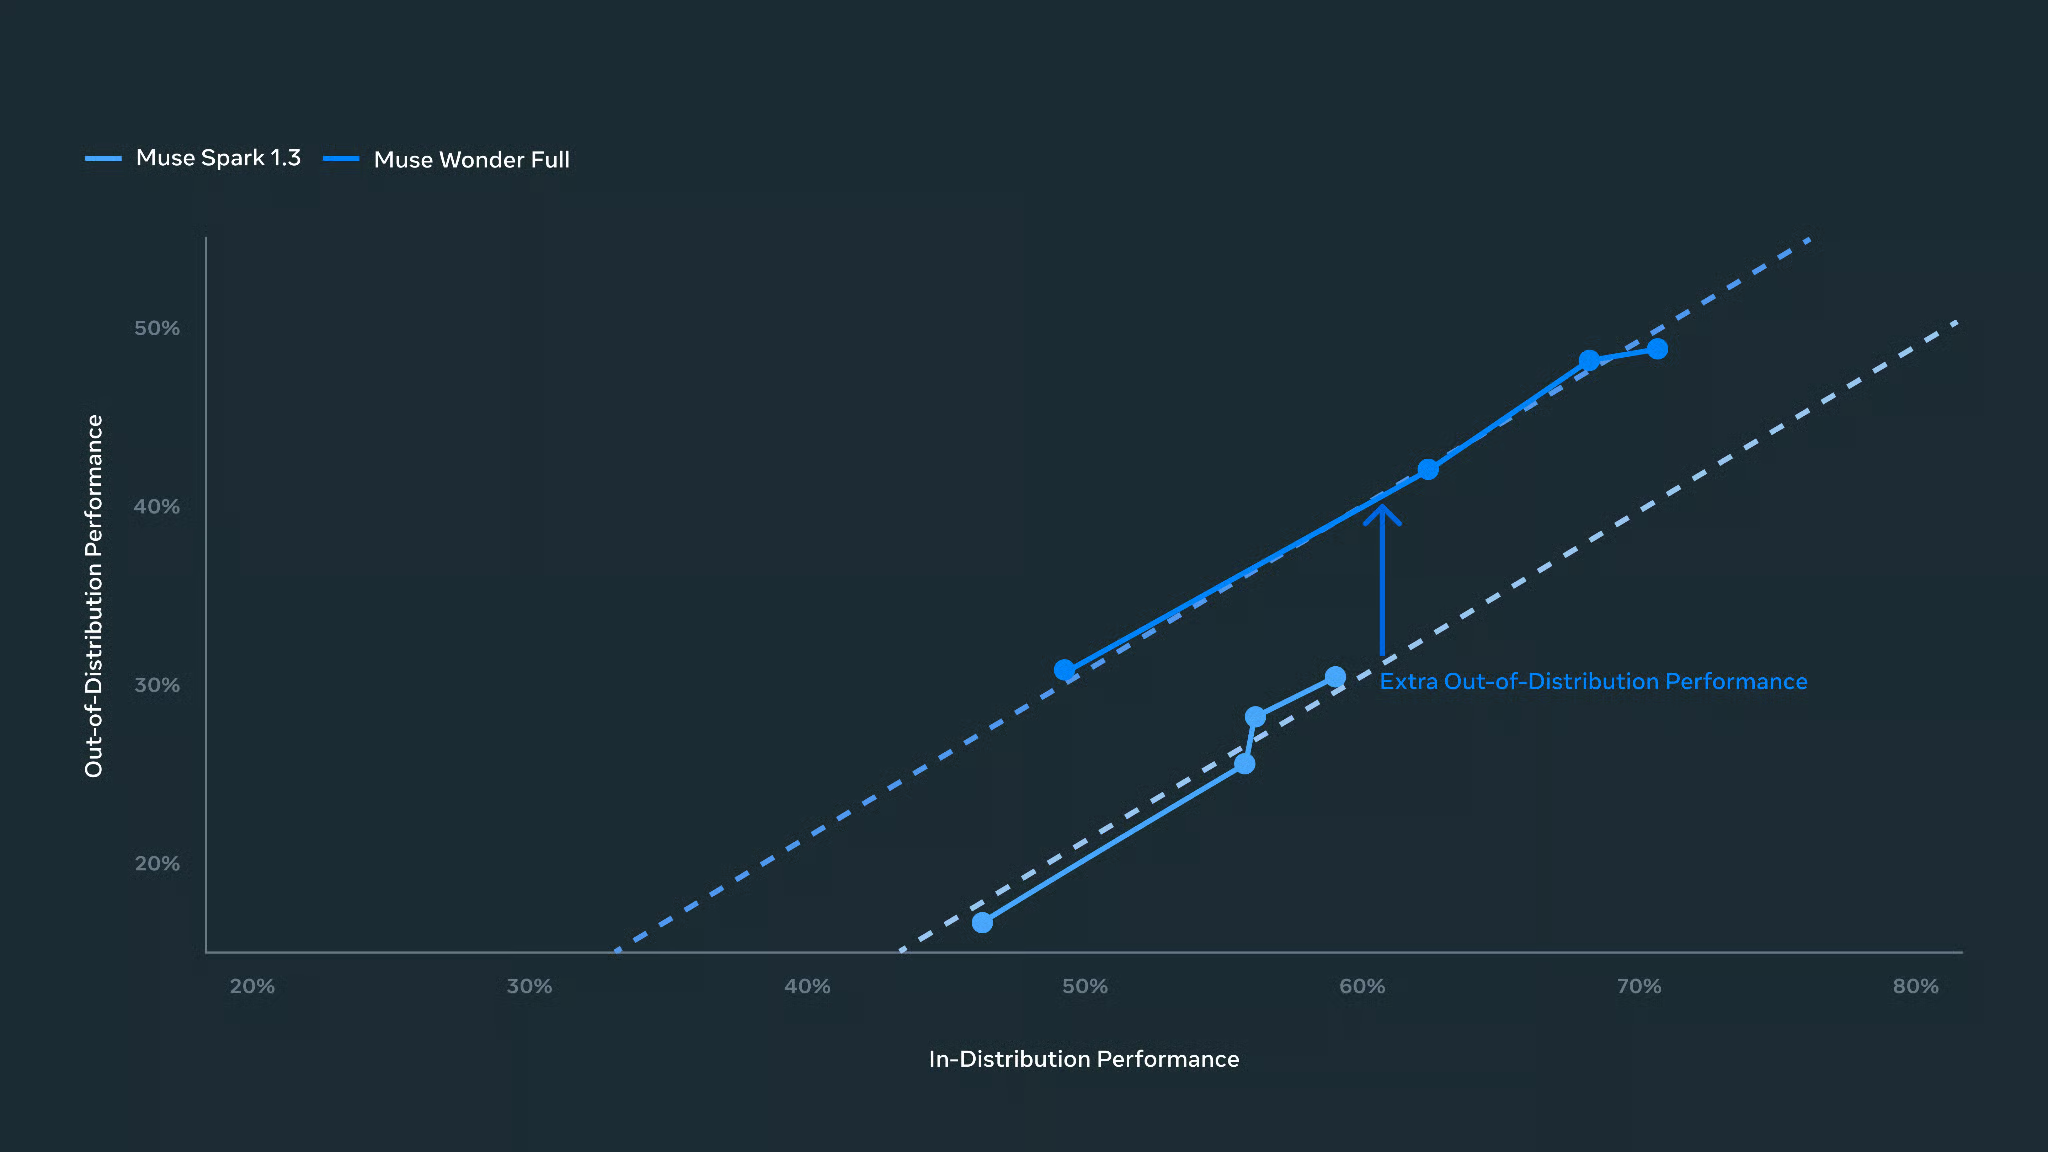
Meta compară performanța pe sarcini nefamiliare. Sursă: Meta.
Conform numerelor Meta, Muse Wonder Full câștigă sarcinile lungi de programare (dar doar în Muse Code), Claude Opus 5.5 câștigă munca în terminal și construirea de la zero, iar GPT-6 Astra domină doar un rând în tabelul Meta. Această parte adună benchmarkurile, deci îți va suna familiar.
Automatizarea e împărțită, deoarece Muse Wonder Full conduce la AutomationBench-AA, în timp ce modelele Claude conduc la creditul parțial OSWorld. Dintre modelele cu scor raportat de finalizare completă, niciunul nu termină majoritatea sarcinilor. La raționament larg, Claude Opus 5.5 conduce în indexul Artificial Analysis, unde Muse Wonder standard obține 52,4.
Prețul e locul unde Muse Wonder standard arată mai slab. GPT-6.1 Sol costă la jumătate per token și obține 51,8 pe același index, iar Claude Sonnet 5.5 are același preț ca GPT-6.1 Sol.
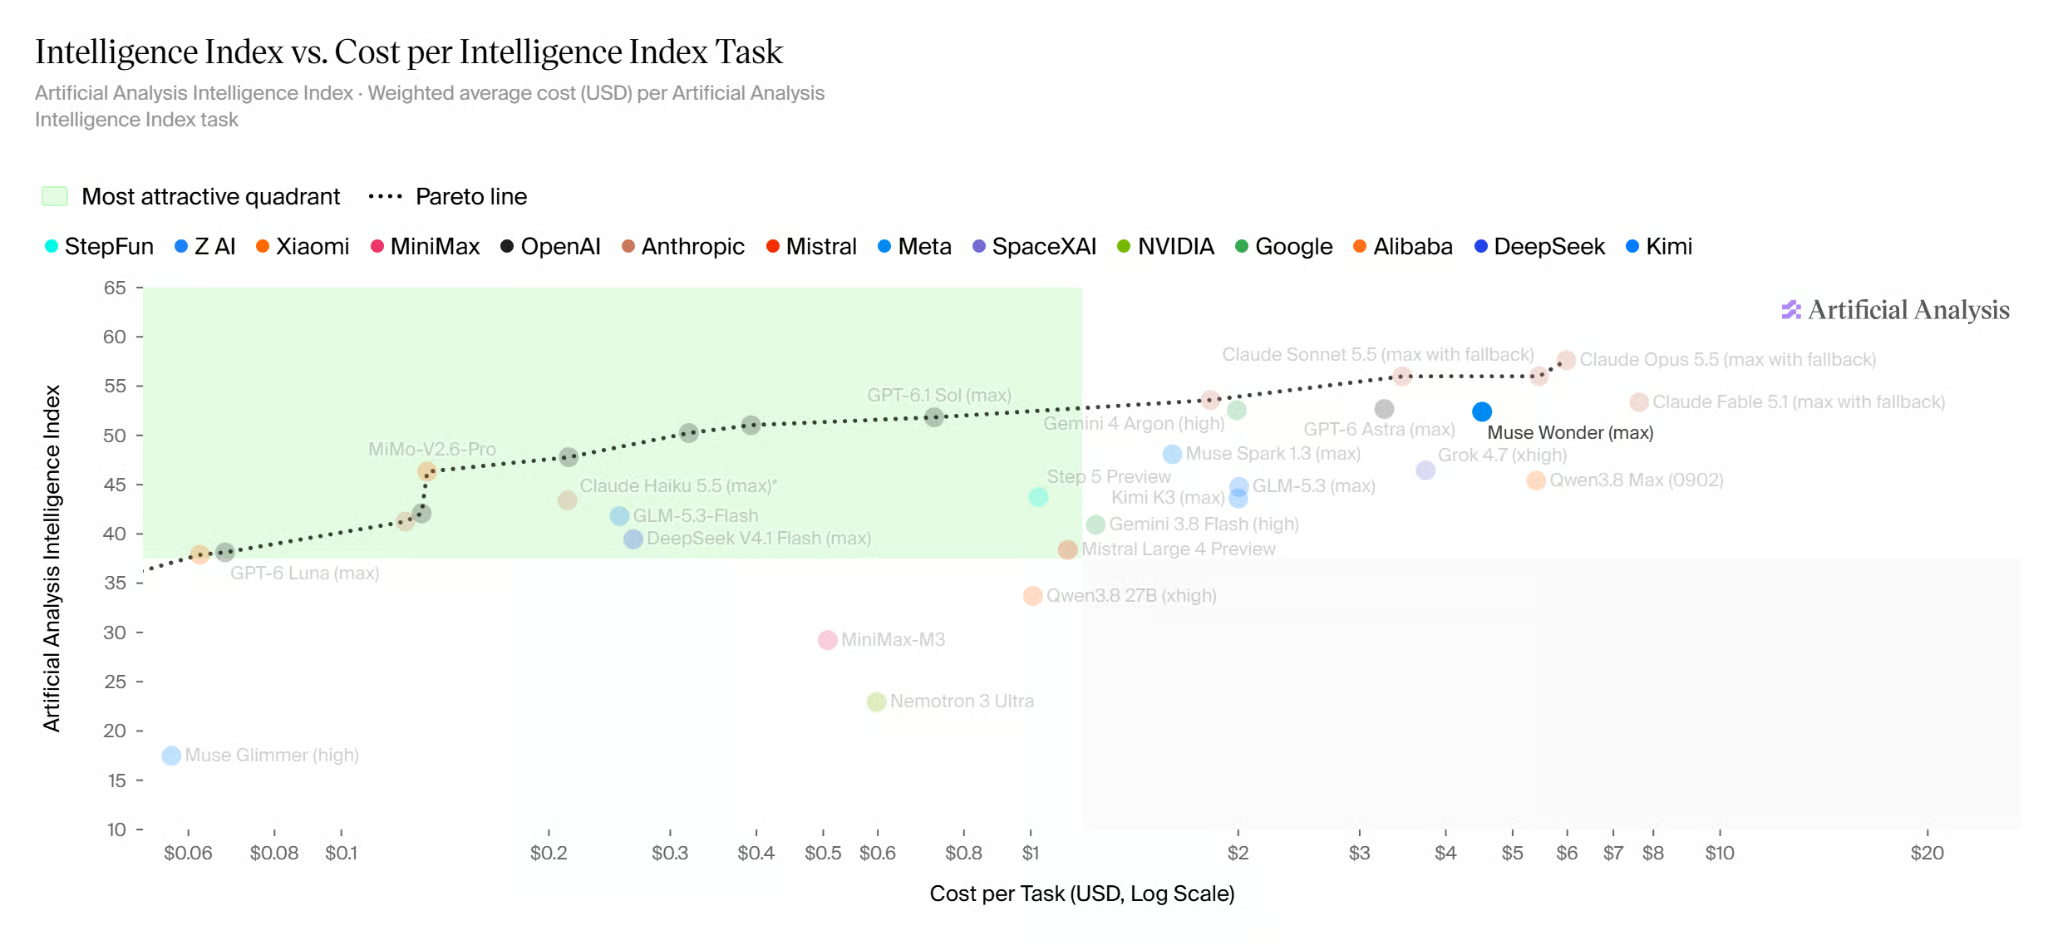
Muse Wonder schimbă costul pentru inteligență. Sursă: Artificial Analysis.
Aproape am scos Gemini 4 Argon din această secțiune, pentru că Meta nu l-a testat, iar așa cum acoperirea noastră pentru Gemini 4 Argon menționează, acesta a mers mai întâi la echipe de securitate cibernetică de încredere. Fără rezultate comune nu există o comparație corectă cap la cap, așa că alege după tipul de sarcină și costul de a o duce la capăt.
Muse Wonder se potrivește cel mai bine pentru două tipuri de muncă: schimbări mari de software și fluxuri de lucru în browser cu mai mulți pași. Sarcinile de planificare îndelungată, ca demo-ul Meta cu aranjarea meselor la o nuntă, depind mai mult de aplicația din jurul modelului.
Acest caz de utilizare are cele mai solide dovezi, cel puțin pentru modificarea codului care există deja. În Muse Code, Muse Wonder lucrează peste fișiere, rulează teste, citește eșecurile și încearcă din nou, ceea ce măsoară DeepSWE și SWE-Marathon. Pe cod real, dă-i doar permisiunile de care are nevoie sarcina și pune o persoană să revizuiască schimbările.
Demo-ul Meta Saturday Run Planning arată Muse Wonder „lucrând direct într-un browser și prin aplicații”, iar alt demo gestionează o cerere de despăgubire la asigurări. Din moment ce Muse Wonder Full finalizează complet mai puțin de 4 din 10 sarcini pe desktop, un flux real are nevoie de aprobarea ta înainte ca ceva să fie trimis sau plătit.
Plătești pentru Muse Wonder în două moduri: per token pentru Muse Wonder standard sau un abonament lunar Muse Code, care, cum am menționat în introducere, este singura cale de a obține Muse Wonder Full.
Pagina de prețuri a Meta listează Muse Wonder standard la 4,00 $ per milion de tokeni de intrare, 0,20 $ pentru intrare cache-uită și 20,00 $ pentru ieșire. E un salt mare față de 1,25 $ și 4,25 $ la Muse Spark 1.3 și se potrivește cu prețurile lui Claude Opus 5.5, ceea ce îți arată unde crede Meta că se poziționează Muse Wonder.
GPT-6 Astra este listat la 10 $, 1 $ cache și 50 $, iar GPT-6.1 Sol la 2 $, 0,10 $ și 10 $. Ipoteza de mai jos aplică acele prețuri din ziua lansării la o sarcină de programare cu 3 milioane de tokeni de intrare (2,4 milioane cache-uiți) și 200.000 tokeni de ieșire, presupunând că nicio cerere nu trece de 272.000 de tokeni, unde prețurile pentru GPT-6 Astra cresc.
|
Model |
Intrare necache-uită (0,6M) |
Intrare cache-uită (2,4M) |
Ieșire (0,2M) |
Total per sarcină |
|
Muse Wonder |
2,40 $ |
0,48 $ |
4,00 $ |
6,88 $ |
|
Claude Opus 5.5 |
2,40 $ |
0,48 $ |
4,00 $ |
6,88 $ |
|
GPT-6 Astra |
6,00 $ |
2,40 $ |
10,00 $ |
18,40 $ |
|
GPT-6.1 Sol |
1,20 $ |
0,24 $ |
2,00 $ |
3,44 $ |
Prețuri egale pe token înseamnă facturi egale pe încercare, deci numărul de comparat este costul per sarcină finalizată. Dacă Muse Wonder termină o dată din două, asta înseamnă 13,76 $, la fel ca un model cu prețurile lui GPT-6.1 Sol care termină o dată din patru (ambele rate inventate pentru exemplu).
Muse Wonder Full vine doar cu planurile lunare Muse Code, care taxează un tarif fix în loc de per token. Poți sări peste această parte dacă plănuiești doar să folosești API-ul. Documentația pentru abonamente a Meta listează patru planuri:
Pagina de produs Muse Code a Meta arată prețuri doar pentru Power și Maximum, ceea ce e o omisiune ciudată, așa că verifică planurile inferioare la checkout. Muse Wonder standard este pe fiecare plan.
Fiecare plan are o limită de utilizare care se resetează în timp. Alocația nefolosită nu se reportează, iar abonamentul nu poate fi folosit ca credit API.
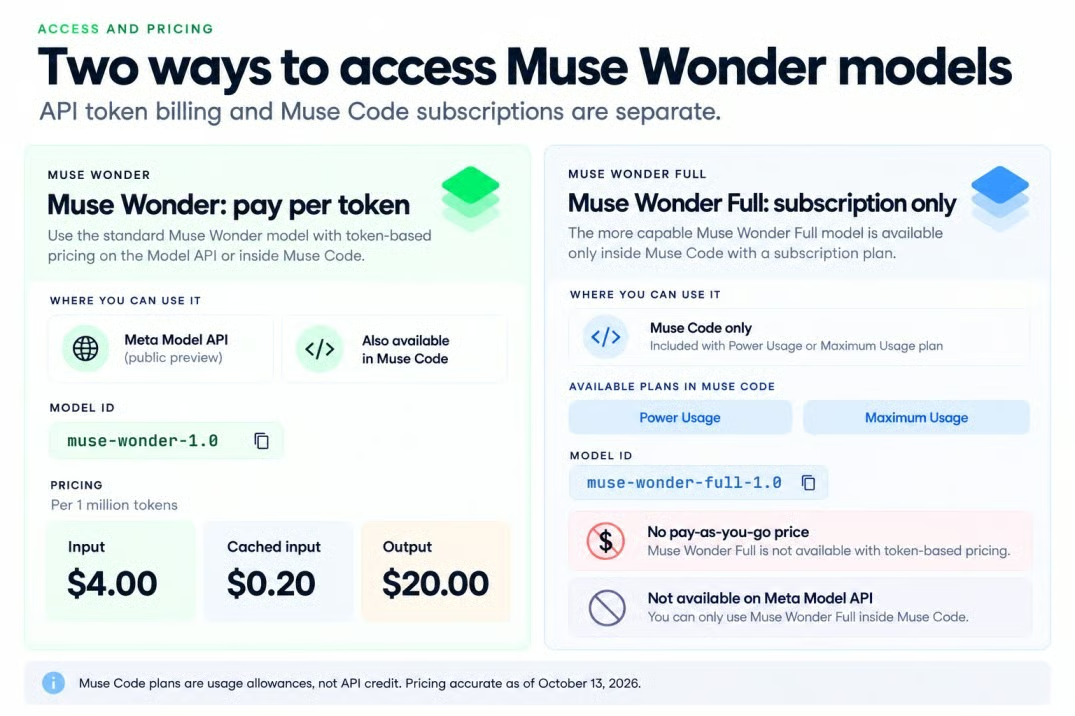
Prețurile Muse Wonder urmează două rute. Sursă: Meta; imagine de autor.
Power este cea mai ieftină cale de a încerca Muse Wonder Full, deși Meta nu a spus câte sarcini mari acoperă alocația. Asta aș urmări, din moment ce un utilizator timpuriu a spus că câteva cereri mici au consumat cam jumătate din limita pe 5 ore a unui plan de intrare, după cum voi acoperi în reacțiile dezvoltatorilor.
Recapitulând separarea din introducere: Muse Wonder standard este disponibil prin Meta Model API și Muse Code, iar Muse Wonder Full doar prin Muse Code.
Ca să folosești API-ul Muse Wonder, ai nevoie de un cont de dezvoltator Meta, o cheie API și facturare, iar ID-ul modelului este muse-wonder-1.0. Meta încă numește API-ul „public preview” pe pagina de produs, codul construit pe SDK-ul OpenAI poate fi direcționat către el, iar Meta listează și OpenRouter ca rută.
Accesul nu e global. Politica de utilizare geografică a Meta blochează mai multe locuri, inclusiv China, Rusia, Iran, Pakistan, Eritreea și Etiopia.
Ca să obții Muse Wonder Full, ai nevoie de un plan Muse Code Power sau Maximum, un cont Meta și să ai 18 ani sau vârsta majoratului unde locuiești. Așa cum am acoperit în secțiunea de prețuri, nu este pe Model API la niciun preț, iar ID-ul său, muse-wonder-full-1.0, funcționează doar în Muse Code. Documentația Muse Code listează macOS, Linux și Windows, deși pagina de produs menționează doar macOS și Windows.
Riscurile de aici vin din aceleași lucruri pe care Meta le promovează: rulări lungi și acces la fișierele tale private.
Fișa modelului numește trei slăbiciuni care pot afecta un agent. Fiecare cauzează o problemă diferită:
Acestea nu sunt probleme izolate de calitate a răspunsurilor când modelul poate folosi instrumente. Un clic greșit sau o presupunere proastă la începutul unei sarcini de două ore poate compromite restul.
Depinde de modul, așa că citește asta înainte de a îndrepta Muse Code către un depozit privat. Termenii de utilizare ai Meta, actualizați cu trei zile înainte de lansare, spun că Meta nu va antrena pe conținut trimis către Standard Services, în timp ce conținutul trimis în modul Contributor poate fi folosit pentru a „antrena, dezvolta, evalua și îmbunătăți” modelele sale.
Abonamentele Muse Code pornesc în modul Contributor, în schimbul unei utilizări mai mari, și trebuie să treci la Standard în setări. Comutarea se aplică doar de acum înainte, deci orice ai trimis deja poate fi încă folosit pentru antrenare. Găsesc acel implicit greu de plăcut.
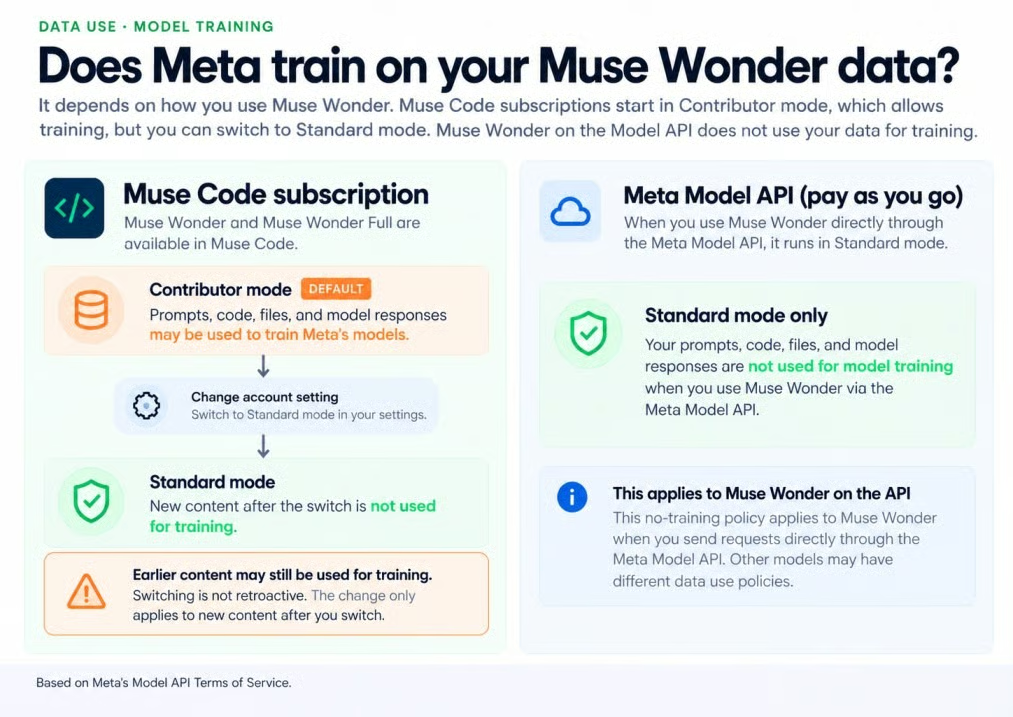
Conținutul Contributor poate antrena modelele Meta. Sursă: Termenii Meta; imagine de autor.
Termenii mai spun că „nu trebuie să trimiți informații sensibile, confidențiale sau personale” în modul Contributor, inclusiv cod privat. Muse Wonder standard pe API-ul pay-as-you-go rulează doar în modul Standard.
Meta a testat Muse Wonder Full în cadrul Superintelligence Scaling Framework. Fără măsuri de protecție, Meta nu exclude atingerea unui nivel de risc ridicat pentru amenințări chimice și biologice, iar cu măsuri de protecție evaluează fiecare domeniu de risc drept „moderat sau mai scăzut”.
Un rating de risc nu e o garanție de siguranță, iar un raport de siguranță mai complet urmează „în curând”. Sfaturile din fișa modelului sunt simple: cere confirmare umană pentru acțiuni pe care nu le poți anula și ține agentul într-un sandbox cu permisiuni limitate.
Reacțiile din ziua lansării pe X s-au împărțit între progres rapid, performanță inegală și frustrare legată de limitele de utilizare. Acestea sunt teste scurte și impresii personale, nu evaluări controlate.
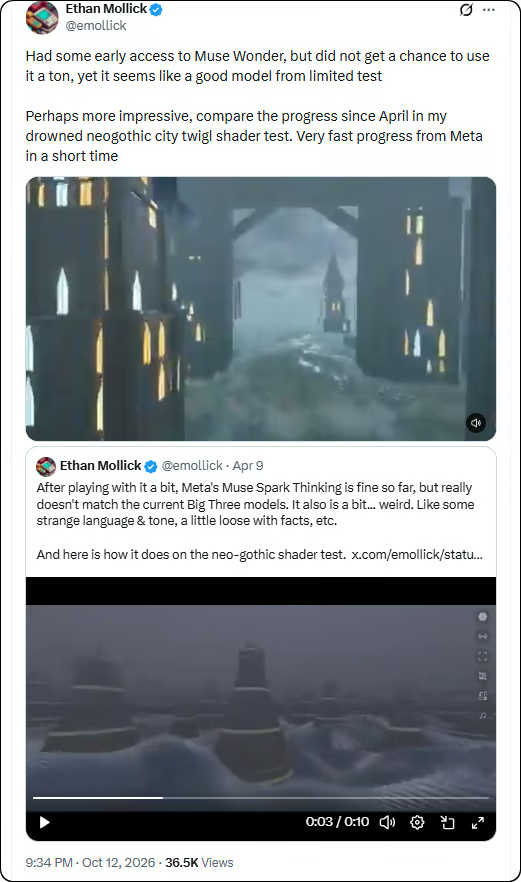
Punctul de vedere pozitiv, dar prudent, a venit de la un tester timpuriu care a avut timp limitat cu Muse Wonder, dar a considerat că arată bine. Ideea mai mare era cât de mult au progresat modelele Meta de la Muse Spark din aprilie.
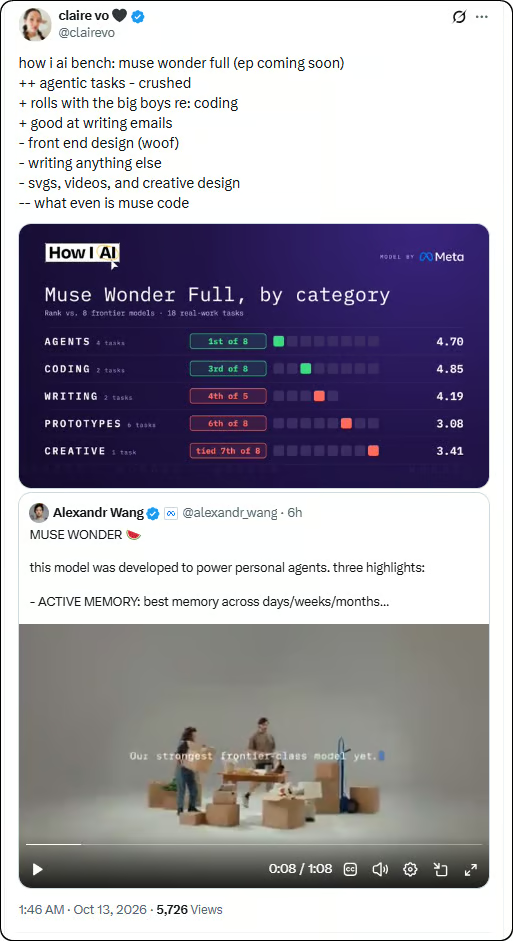
Un test mai larg pe categorii a spus o poveste mai puțin ordonată. Muse Wonder Full s-a clasat aproape de vârf pentru agenți și programare, dar a rămas în urmă la scriere, design front-end și lucru creativ.
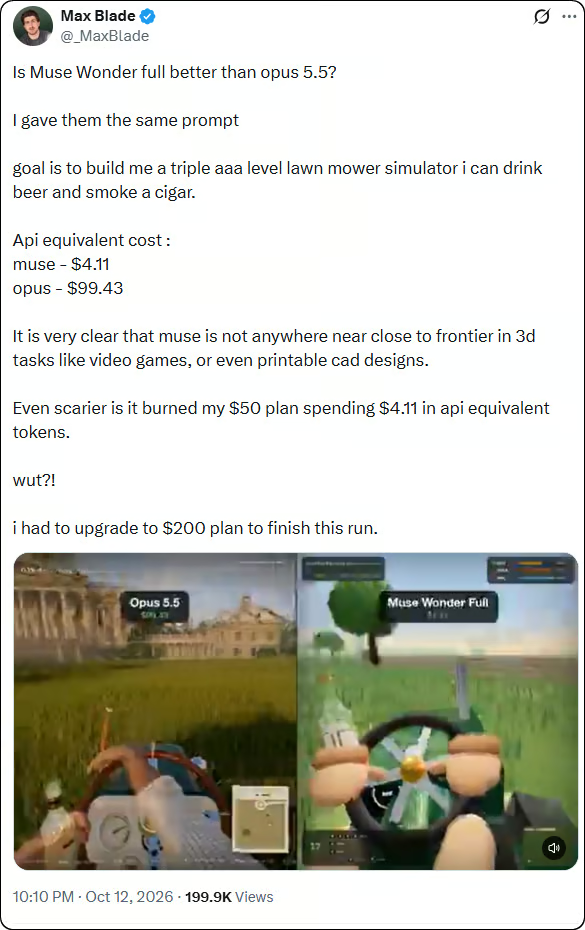
Cea mai ascuțită plângere a fost despre cost și limitele planurilor. Într-un test cu aceeași solicitare despre o mașină de tuns iarba, Muse Wonder Full a folosit tokeni echivalenți cu aproximativ 4,11 $ pe API, dar a produs un rezultat 3D mai slab decât Claude Opus 5.5, iar testerul a spus că finalizarea a necesitat un upgrade de la planul de 50 $ la planul de 200 $.
Împreună, postările sugerează că Muse Wonder este competitiv, dar inegal. E nevoie de mai multe teste repetate înainte de a trata orice rezultat drept tipic.
Majoritatea dovezilor de la lansare încă vin de la Meta. Muse Wonder Full nu are API pay-as-you-go, iar Muse Wonder standard costă la fel ca Claude Opus 5.5, deși rămâne în urmă la mai multe teste.
Aș testa Muse Wonder standard pentru agenți pe API și Muse Wonder Full pentru muncă lungă pe depozite de cod. Aș păstra Claude Opus 5.5 pentru munca în terminal sau construirea programelor de la zero și aș folosi GPT-6.1 Sol sau Claude Sonnet 5.5 când decide costul.
Învață cu DataCamp
{count, plural, one {Curs} few {Cursuri} other {Cursuri}}
{count, plural, one {Curs} few {Cursuri} other {Cursuri}}
{count, plural, one {Curs} few {Cursuri} other {Cursuri}}