
{count, plural, one {Khóa học} other {Khóa học}}
Các khái niệm về Large Language Models (LLMs)
{hours} giờ
112.2K
Tuần này, Meta ra mắt Muse Wonder và Muse Wonder Full, dòng mô hình lớn đầu tiên sau Muse Spark. Cả hai đều được xây dựng cho các tác nhân AI xử lý công việc nhiều bước.
Bài công bố ra mắt của Meta gọi Muse Wonder là kết quả của 14 tháng tái xây dựng công trình AI. Hai thuật ngữ mới cần biết là Active Memory, giúp gợi lại các chi tiết hữu ích từ cuộc trò chuyện trước, và Active Focus, giúp tiếp tục làm việc khi nhiệm vụ bị đình trệ.
Muse Wonder bản thường có sẵn qua Meta Model API và Muse Code, trong khi Muse Wonder Full, mô hình đứng sau hầu hết các kết quả nổi bật, chỉ chạy trong Muse Code ở hai gói đắt nhất. Ta sẽ nói kỹ hơn ở phần sau.
Tóm tắt những điểm chính từ đợt ra mắt:
Muse Wonder và Muse Wonder Full là các mô hình suy luận mà Meta gọi là mạnh nhất của họ đến nay, xây dựng cho các tác nhân xử lý công việc cá nhân và công việc. Thẻ mô hình liệt kê đầu vào văn bản, hình ảnh, video và âm thanh và đầu ra chỉ văn bản, nên cả hai đều không tạo hình ảnh, video hay âm thanh. Tài liệu nhà phát triển của Meta bổ sung đầu vào PDF và đặt cửa sổ ngữ cảnh ở 1.048.576 token.
Bài blog nghiên cứu của Meta cho biết cả hai kế thừa công việc huấn luyện của Muse Spark và được huấn luyện tại trung tâm dữ liệu Prometheus của Meta. Không có số tham số.
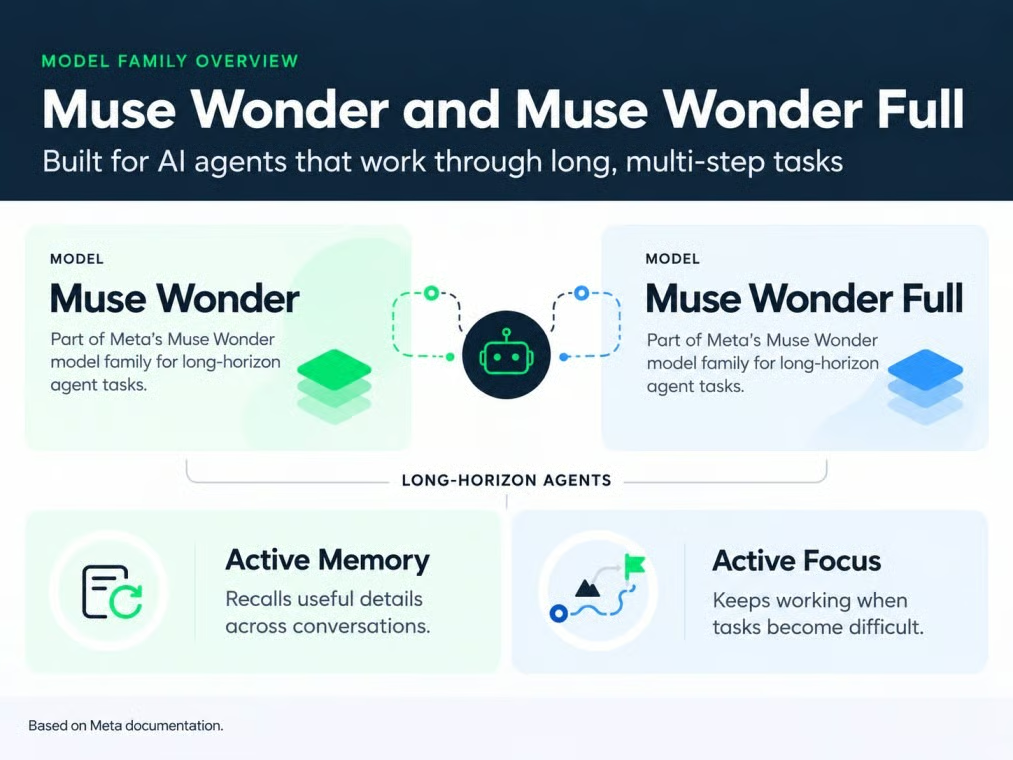
Muse Wonder có hai biến thể. Ảnh: Tác giả.
Giữa hai mô hình, Muse Wonder Full là một mô hình riêng biệt, mạnh hơn. Tài liệu nhà phát triển nói rằng tăng suy luận của Muse Wonder bản thường (muse-wonder-1.0) lên mức "max" không biến nó thành Muse Wonder Full (muse-wonder-full-1.0).
Bạn có thể nhận thấy Meta dùng tên Muse cho nhiều thứ. Tóm lại:
Khi Meta nói Muse Wonder “làm” điều gì đó, Muse Code thường đảm nhận nửa công việc. Điều này áp dụng cho hầu hết các kết quả lập trình bên dưới.
Hai tính năng chính của Muse Wonder là Active Memory và Active Focus, và các công việc lập trình dài là nơi Meta trình diễn chúng. Ý tưởng đằng sau cả hai rất đơn giản: một tác nhân phải nhớ đúng chi tiết và tiếp tục khi kế hoạch thất bại.
Active Memory là thuật ngữ Meta dùng cho việc mang theo các chi tiết quan trọng qua nhiều cuộc trò chuyện và gọi lại đúng thông tin khi cần. Giả sử bạn đặt ngân sách văn phòng tại nhà $3.000 vào tháng 3, tăng lên $4.000 vào tháng 4 và yêu cầu danh sách nội thất rút gọn vào tháng 5. Ghi nhớ tốt nghĩa là tác nhân dùng con số tháng 4 mà không cần nhắc.
Bằng chứng của Meta là MemoryBench, bài kiểm thử nội bộ về các cuộc hội thoại dài nơi các sự kiện được cập nhật. Muse Wonder đạt 85,6 trên đó, nhưng không nói gì về khả năng nhớ trong nhiều tháng, và một ứng dụng xây trên API vẫn phải tự lưu trữ các sự kiện đó. Đây là tính năng tôi tò mò nhất, vì một tác nhân làm việc với ngân sách cũ có thể khiến bạn tốn tiền.
Active Focus là tên Meta đặt cho tính kiên trì: thử cách tiếp cận khác, xử lý các trở ngại và hỏi ý kiến trước khi thực hiện hành động quan trọng. Hãy hình dung một lần di trú mã nơi 30 bài kiểm thử thất bại. Một tác nhân tập trung sẽ sửa mã và chạy lại kiểm thử, còn tác nhân yếu hơn chỉ chỉnh các bài kiểm thử để chúng đỗ.
Meta đo lường điều này bằng FocusBench, một bài kiểm thử nội bộ khác, và bằng SWE-Marathon, mà tôi sẽ nói ở phần điểm chuẩn. Không bài nào đảm bảo xong việc, và việc chạy nền phụ thuộc vào phần mềm xung quanh mô hình, một rủi ro mà bài giải thích OpenAI Dots của chúng tôi đã đề cập cho các tác nhân luôn bật.
Muse Wonder lên kế hoạch cho các công việc lập trình dài và chia nhỏ công việc cho các tác nhân phụ, trong khi Muse Code chạy công cụ và xin phê duyệt. Trang dành cho nhà phát triển của Meta giới thiệu cho các nhiệm vụ “chạy trong hàng giờ”, với nhiều tệp được chỉnh sửa cùng lúc.
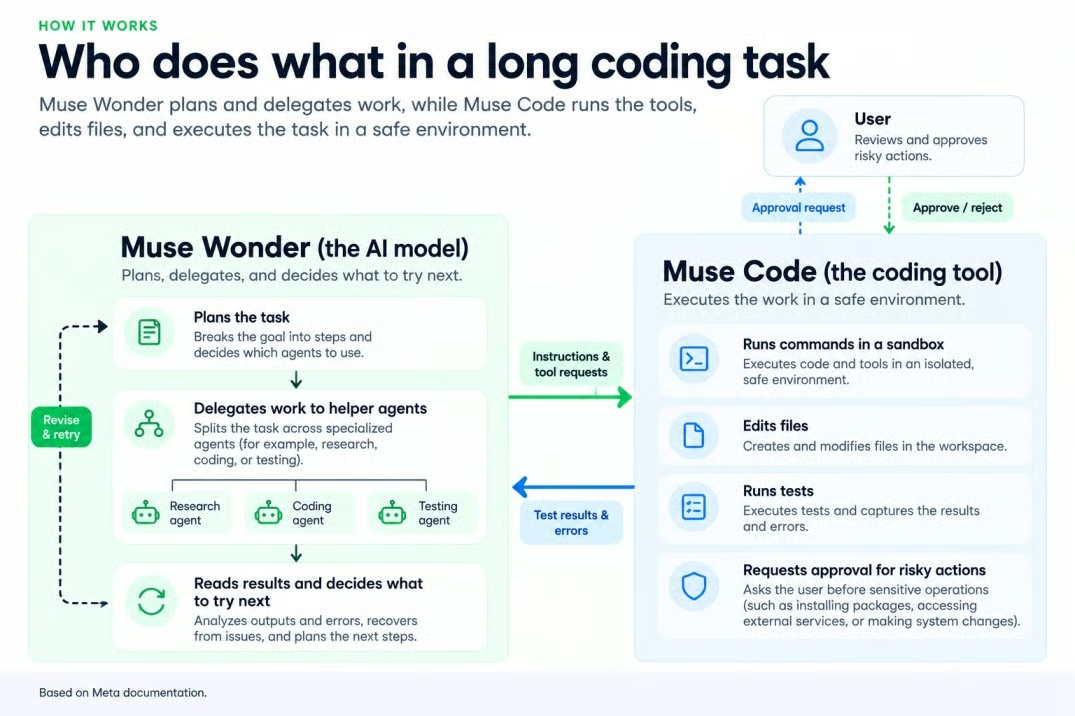
Muse Wonder lập kế hoạch; Muse Code thực thi. Ảnh: Tác giả.
Một bản demo của Meta là trò chơi nhà bếp 3D có thể chơi được, dựng từ ảnh. Đây là lựa chọn lạ, vì thẻ mô hình liệt kê suy luận 3D là điểm yếu đã biết (tôi sẽ chọn demo khác).
Bảng của Meta nghiêng về Muse Wonder Full ở lập trình dài và một số điểm chuẩn chuyên nghiệp, trong khi Claude Opus 5.5 dẫn đầu ở lập trình terminal và xây dựng chương trình từ đầu. Các con số dưới đây là của Meta trừ khi ghi chú, với gần như mọi mô hình ở mức suy luận cao nhất (tôi sẽ đánh dấu ngoại lệ duy nhất).
Muse Wonder Full đứng đầu cả hai bài kiểm thử lập trình dài trong bảng của Meta. Như tôi đã đề cập ở phần mở đầu, nó đạt 79,0 trên DeepSWE v1.1, với Muse Wonder bản thường sát ngay sau ở 78,8. Đó là số liệu của Meta lúc này, vì bảng xếp hạng DeepSWE công khai của Datacurve chưa liệt kê Muse Wonder.
SWE-Marathon là bài tôi sẽ theo dõi, vì 20 dự án nhiều giờ của nó sẽ chấm 0 nếu chỉ một bài kiểm thử thất bại. Meta báo cáo Muse Wonder Full ở mức 57,5 (thấp hơn một nấc so với thiết lập cao nhất) và Muse Wonder ở 53,1, so với 46,3 cho Claude Opus 5.5 và 42,5 cho GPT-6 Astra. Các mô hình đối thủ chạy trong công cụ lập trình của chính công ty họ, nên Meta cũng nói rằng so sánh không hoàn toàn công bằng, và với chỉ 20 dự án, một dự án có thể làm lệch điểm vài điểm.
Bảng xếp hạng SWE-Marathon của Abundant AI đưa ra mức độ khiêm tốn hơn: Muse Wonder Full ở 53,1% và Muse Wonder bản thường ở 52,5%, cả hai ở thiết lập cao nhất trong Muse Code, nhỉnh hơn Claude Sonnet 5.5 ở 51,3%. Claude Haiku 5.5, phát hành sớm hơn năm ngày bởi Anthropic, ở mức 50,0%. Hai danh sách đến từ các bài kiểm thử khác nhau, nên đừng trộn lẫn.
Tuyên bố của Meta rằng Muse Wonder có thể thực hiện công việc xuyên qua các ứng dụng nhận được sự ủng hộ pha trộn. Trên AutomationBench-AA, bài kiểm tra xem liệu quy trình nghiệp vụ có kết thúc ở trạng thái đúng hay không, Muse Wonder Full đạt 45,4 so với 41,6 cho GPT-6 Astra và 41,2 cho Claude Opus 5.5, nên nó dẫn đầu dù vẫn thất bại ở đa số quy trình.
OSWorld V2.1, một bộ 108 nhiệm vụ desktop, cho bạn cái nhìn rõ hơn. Muse Wonder Full đạt 78,4 điểm theo tín chỉ một phần nhưng chỉ hoàn tất trọn vẹn 39,4% nhiệm vụ, và cả hai mô hình Claude đều vượt điểm tín chỉ một phần của nó. Với một biểu mẫu bảo hiểm, làm đúng hầu hết bước vẫn là nhiệm vụ thất bại, nên 39,4% là con số cần theo dõi.
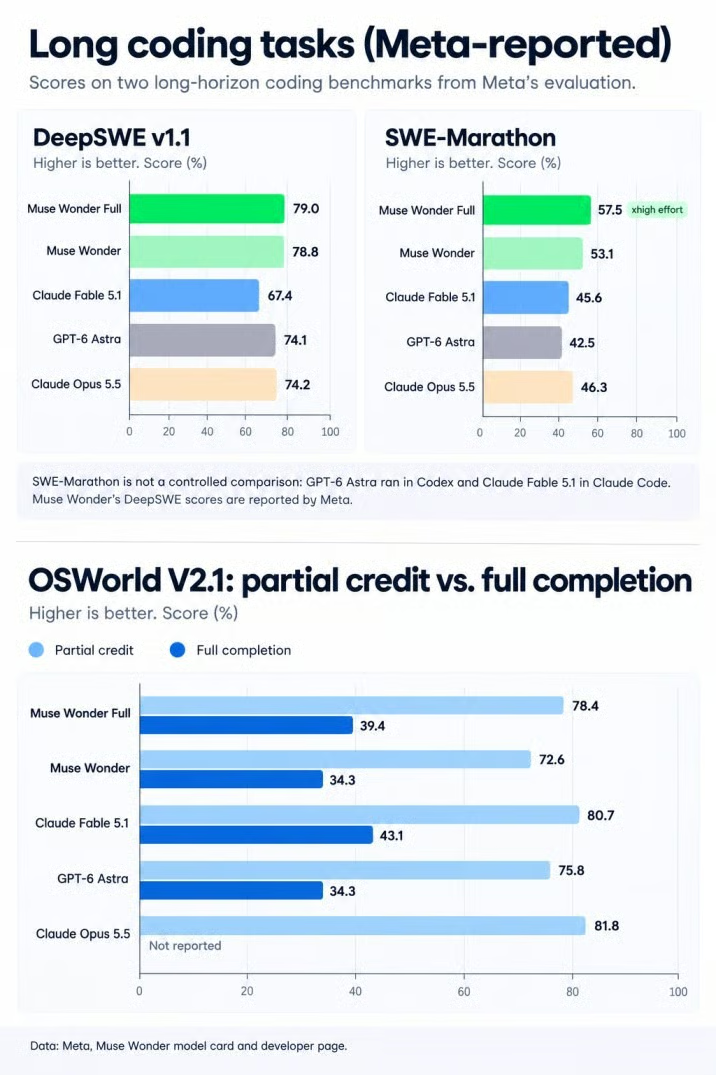
Dẫn đầu về lập trình che giấu tỷ lệ hoàn tất thấp. Nguồn: Meta; ảnh: Tác giả.
Muse Wonder Full dẫn đầu bài pháp lý và tụt sau ở sức khỏe, còn tài chính gần như hòa. Điểm pháp lý nghe rất nhỏ, nhưng vẫn gấp ba lần Claude Opus 5.5. Trong phiên bản của Artificial Analysis, một tài liệu pháp lý chỉ được tính nếu đáp ứng mọi yêu cầu và không bịa đặt nội dung, và Muse Wonder Full đạt 13,1 so với 4,2 cho Claude Opus 5.5, vẫn có nghĩa là thất bại khoảng 87% nhiệm vụ.
Tài chính gần như hòa, với Muse Wonder Full ở 59,1 trên Vals Finance Agent V2 so với 58,6 cho Claude Opus 5.5. Sức khỏe đi theo hướng ngược lại: Muse Wonder Full đạt 62,3 trên HealthBench Pro, sau Claude Opus 5.5 (65,6) và GPT-6 Astra (65,3).
Muse Wonder Full thua Claude Opus 5.5 ở 6 trong 14 bài kiểm thử trong chính bảng của Meta, và GPT-6 Astra vượt nó ở ba bài. Bảng sau tổng hợp các lần thua chưa đề cập ở trên.
|
Điểm chuẩn |
Kiểm tra điều gì |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Lập trình trong terminal |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Xây dựng chương trình từ đầu |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Tổng hợp rộng |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Sử dụng công cụ chuyên nghiệp |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Làm việc từ PDF |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Nguồn: Trang nhà phát triển Muse Wonder của Meta tại thời điểm ra mắt. Tất cả mô hình ở mức suy luận cao nhất.
ProgramBench là bài thua mà lập trình viên nên quan tâm, và khoảng cách không hề nhỏ. Nó yêu cầu mô hình dựng lại chương trình từ đầu, và khoảng cách 11,5 điểm cho thấy chỉnh sửa mã có sẵn và xây dựng từ con số không là hai kỹ năng khác nhau.
Artificial Analysis liệt kê Muse Wonder Full ở 55,8, mà bảng của Meta làm tròn thành 56, trong khi Claude Sonnet 5.5 đạt 56,0.
Bạn có thể tin các kết quả điểm chuẩn của Muse Wonder không? Không hoàn toàn. Thẻ mô hình của Meta cho thấy bảng trộn ba loại bằng chứng:
Như tôi đã lưu ý, gần như mọi điểm số dùng mức suy luận cao nhất, nên bạn đang thấy mỗi mô hình ở trạng thái tốt nhất. Kết quả cũng thay đổi theo bên thử nghiệm: Anthropic báo 66,4% cho Claude Opus 5.5 trên Terminal-Bench 4.0, so với 59,6 trong bảng của Meta. Tuyên bố của Meta rằng Muse Wonder Full xử lý nhiệm vụ lạ tốt hơn các mô hình Spark dựa trên phân tích nội bộ của họ.
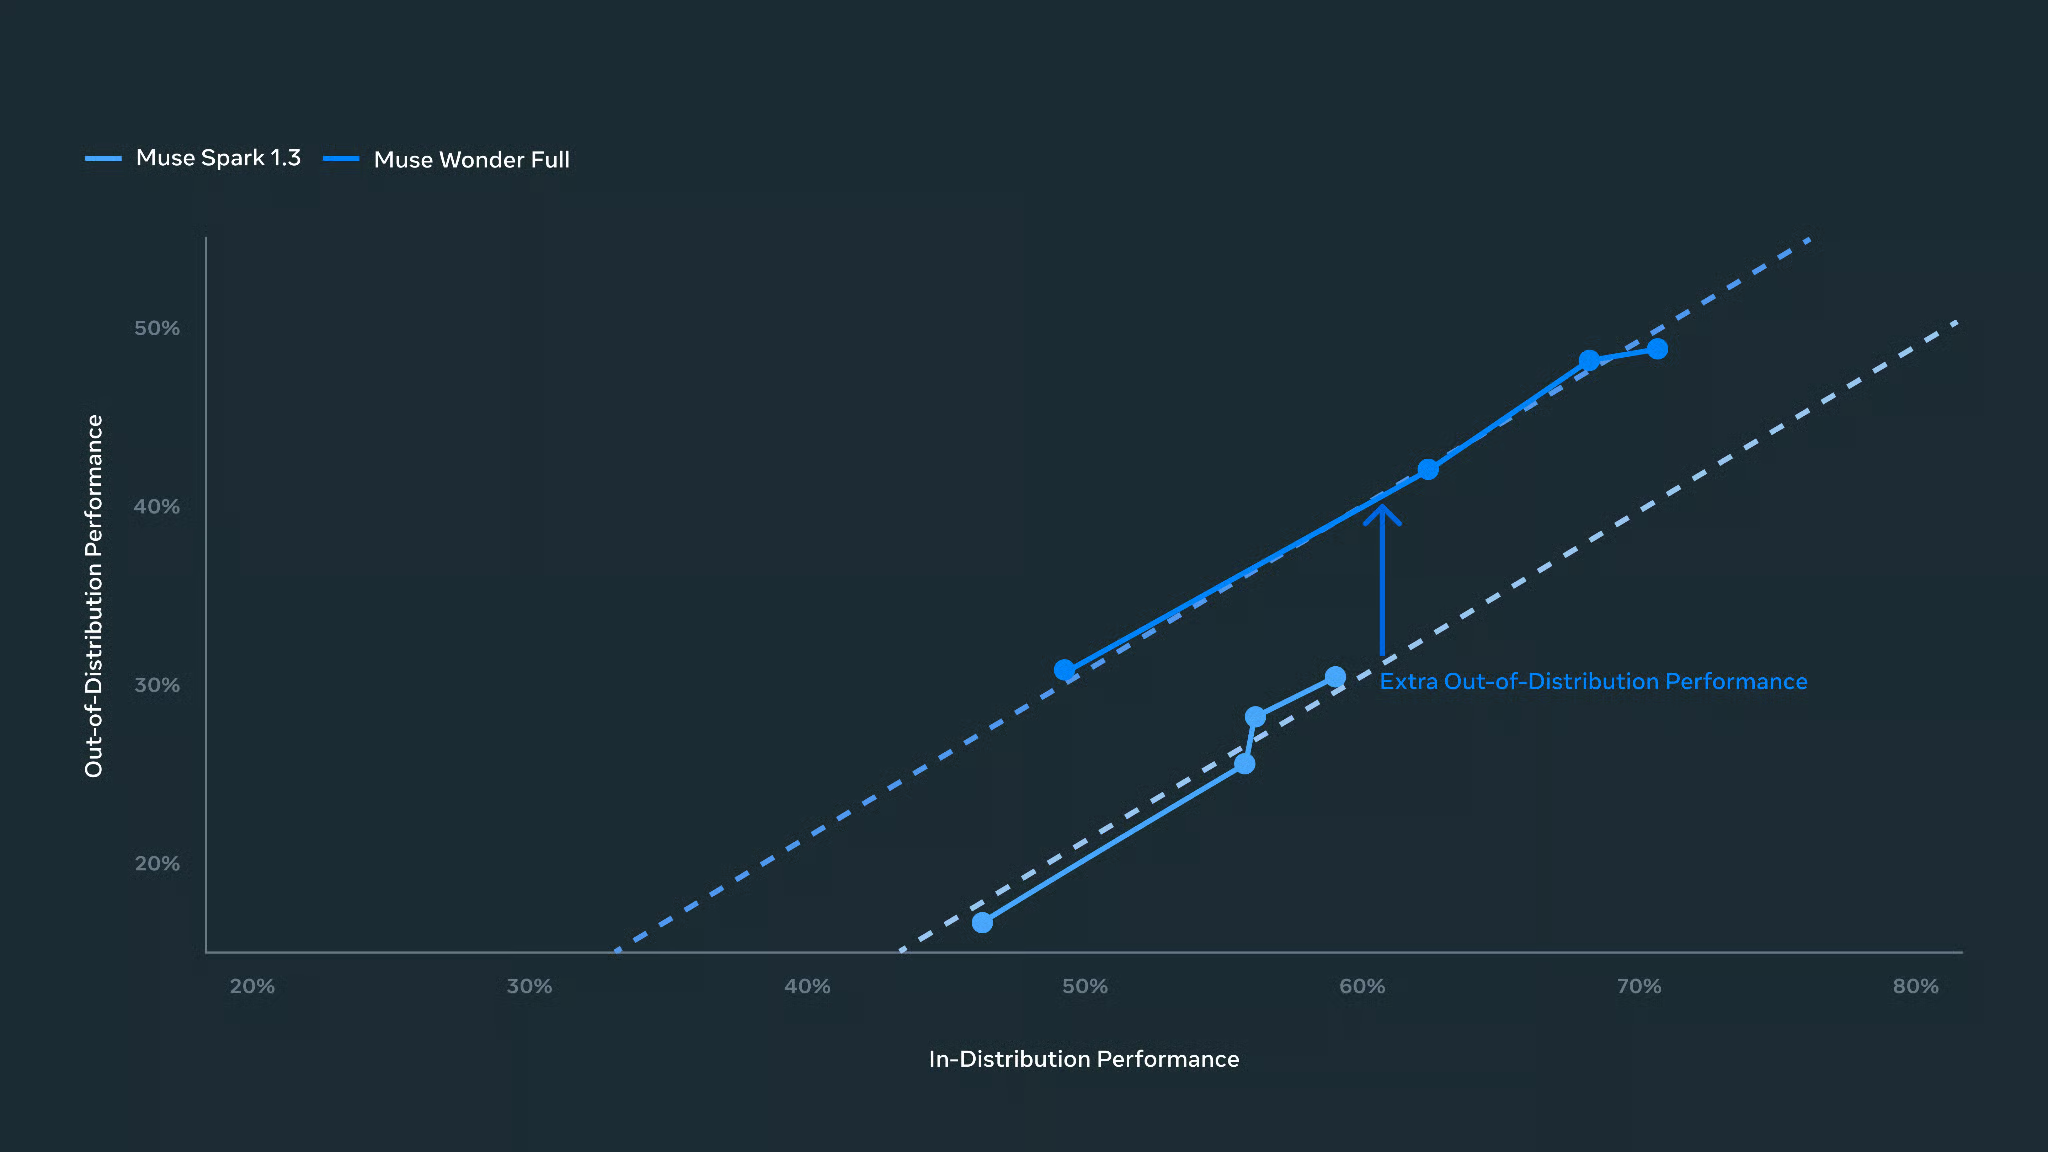
Meta so sánh hiệu năng trên nhiệm vụ lạ. Nguồn: Meta.
Theo số liệu của Meta, Muse Wonder Full thắng ở các công việc lập trình dài (nhưng chỉ trong Muse Code), Claude Opus 5.5 thắng ở công việc trong terminal và xây từ đầu, và GPT-6 Astra đứng đầu chỉ một hàng trong bảng của Meta. Phần này tổng hợp điểm chuẩn nên sẽ quen thuộc.
Tự động hóa thì chia đôi, vì Muse Wonder Full dẫn trên AutomationBench-AA trong khi các mô hình Claude dẫn ở điểm tín chỉ một phần của OSWorld. Trong số các mô hình có báo cáo tỷ lệ hoàn tất đầy đủ, không mô hình nào hoàn tất đa số nhiệm vụ. Về suy luận rộng, Claude Opus 5.5 dẫn đầu chỉ số của Artificial Analysis, nơi Muse Wonder bản thường đạt 52,4.
Giá là nơi Muse Wonder bản thường trông yếu hơn. GPT-6.1 Sol có giá mỗi token bằng một nửa và đạt 51,8 trên cùng chỉ số, và Claude Sonnet 5.5 có giá bằng GPT-6.1 Sol.
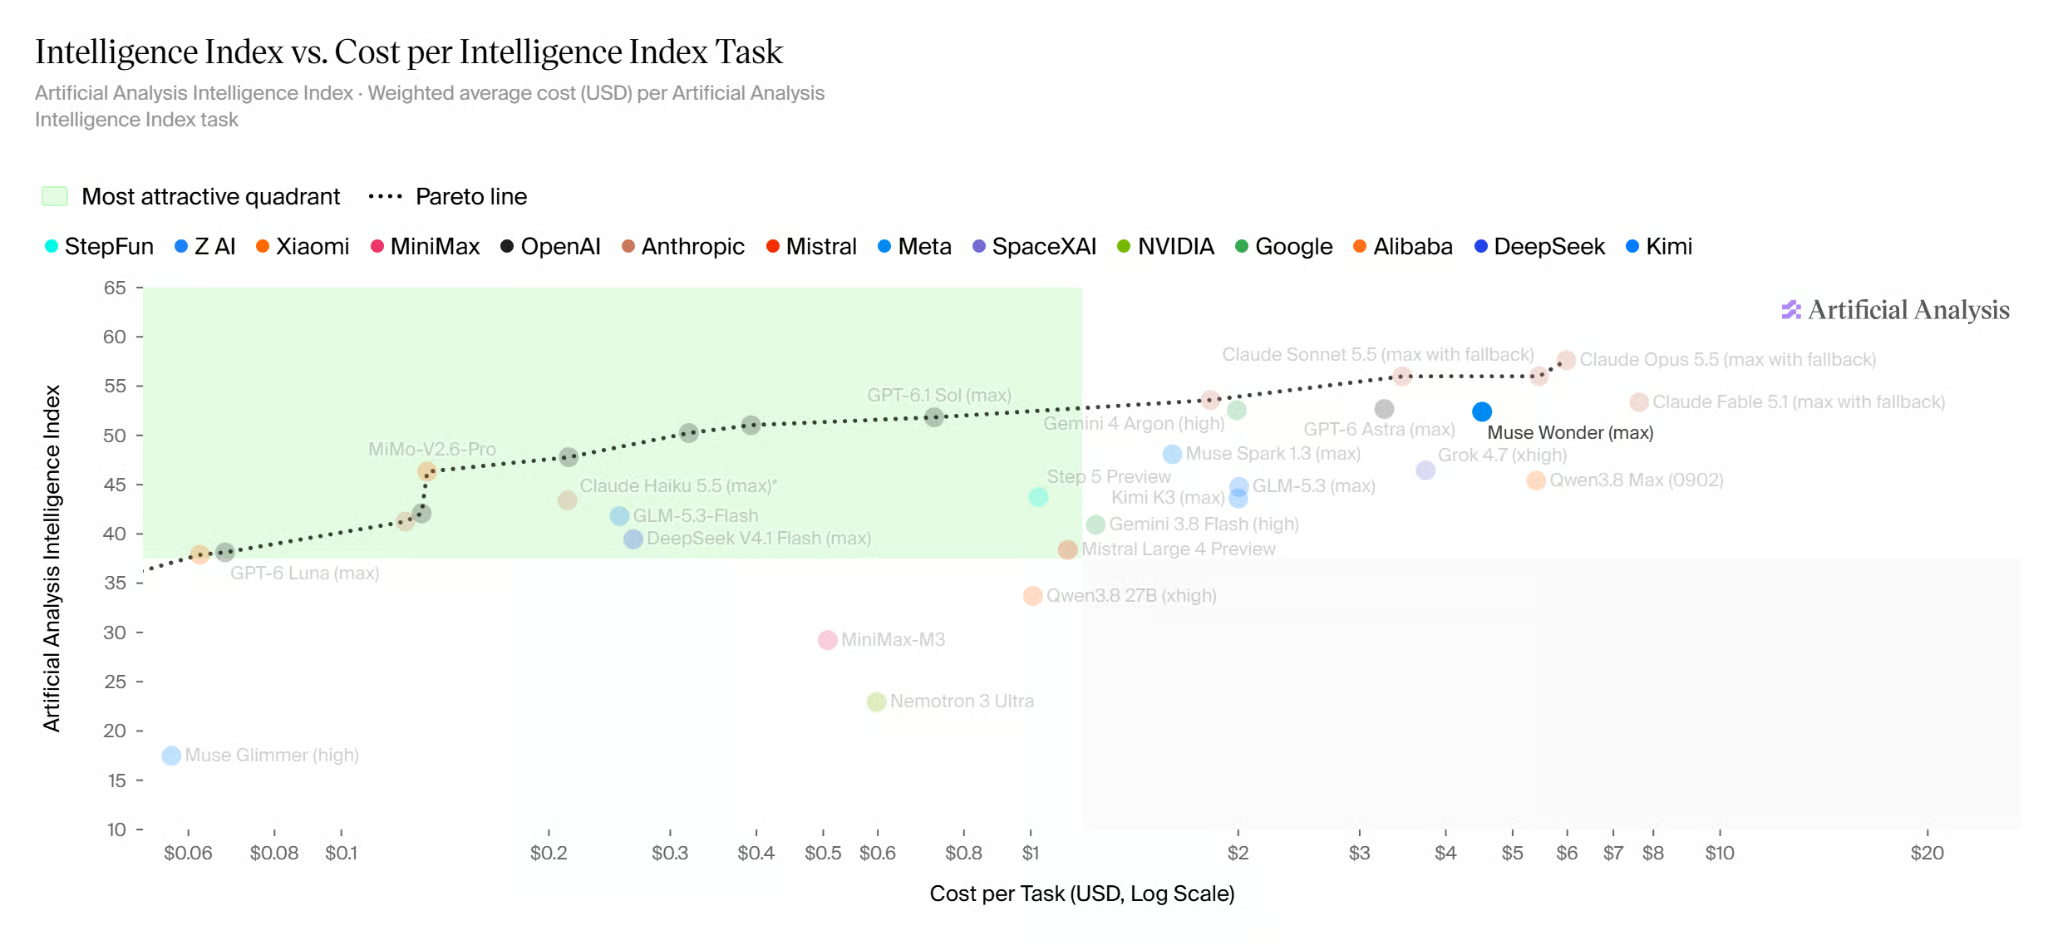
Muse Wonder đánh đổi chi phí với trí tuệ. Nguồn: Artificial Analysis.
Tôi suýt loại Gemini 4 Argon khỏi phần này, vì Meta không thử nó, và như bài viết về Gemini 4 Argon của chúng tôi nêu, nó được gửi đến các đội an ninh mạng tin cậy trước. Không có kết quả chung thì không thể so kè công bằng, nên hãy chọn theo khối lượng công việc và chi phí để hoàn tất nhiệm vụ.
Muse Wonder phù hợp nhất với hai kiểu công việc: thay đổi phần mềm lớn và quy trình duyệt web nhiều bước. Các công việc lập kế hoạch dài, như demo sơ đồ chỗ ngồi đám cưới của Meta, phụ thuộc nhiều hơn vào ứng dụng xung quanh mô hình.
Trường hợp này có bằng chứng mạnh nhất, ít nhất là cho việc thay đổi mã đã tồn tại. Trong Muse Code, Muse Wonder làm việc xuyên tệp, chạy kiểm thử, đọc lỗi và thử lại, đúng như DeepSWE và SWE-Marathon đo lường. Với mã thực, chỉ cấp quyền cần thiết cho nhiệm vụ và có người rà soát thay đổi.
Demo Lập kế hoạch Chạy cuối tuần của Meta cho thấy Muse Wonder “làm việc trực tiếp trong trình duyệt và xuyên qua ứng dụng”, và một demo khác xử lý yêu cầu bồi thường bảo hiểm. Vì Muse Wonder Full chỉ hoàn tất trọn vẹn dưới 4/10 nhiệm vụ desktop, một quy trình thực tế cần phê duyệt của bạn trước khi nộp hay thanh toán bất cứ thứ gì.
Bạn trả cho Muse Wonder theo hai cách: theo token cho Muse Wonder bản thường, hoặc gói Muse Code theo tháng cố định, và như tôi đã đề cập, đây là cách duy nhất để có Muse Wonder Full.
Trang giá của Meta niêm yết Muse Wonder bản thường ở $4,00 cho mỗi triệu token đầu vào, $0,20 cho đầu vào được lưu vào bộ nhớ đệm và $20,00 cho đầu ra. Đây là bước nhảy lớn từ $1,25 và $4,25 của Muse Spark 1.3, và trùng với giá của Claude Opus 5.5, cho thấy Meta định vị Muse Wonder ở đâu.
GPT-6 Astra niêm yết $10, $1 cho bộ nhớ đệm, và $50, còn GPT-6.1 Sol ở mức $2, $0,10 và $10. Ví dụ giả định dưới đây áp dụng các mức giá ngày ra mắt cho một nhiệm vụ lập trình với 3 triệu token đầu vào (2,4 triệu được lưu đệm) và 200.000 token đầu ra, giả định không yêu cầu nào vượt quá 272.000 token, nơi giá của GPT-6 Astra tăng lên.
|
Mô hình |
Đầu vào không lưu đệm (0,6M) |
Đầu vào lưu đệm (2,4M) |
Đầu ra (0,2M) |
Tổng mỗi nhiệm vụ |
|
Muse Wonder |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
Claude Opus 5.5 |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
GPT-6 Astra |
$6,00 |
$2,40 |
$10,00 |
$18,40 |
|
GPT-6.1 Sol |
$1,20 |
$0,24 |
$2,00 |
$3,44 |
Giá token bằng nhau nghĩa là hóa đơn mỗi lần thử bằng nhau, nên con số cần so là chi phí cho mỗi nhiệm vụ hoàn tất. Nếu Muse Wonder hoàn tất 1 trong 2 lần, đó là $13,76, tương đương một mô hình có giá như GPT-6.1 Sol hoàn tất 1 trong 4 lần (cả hai tỷ lệ đều giả định cho ví dụ).
Muse Wonder Full chỉ đi kèm với các gói hàng tháng của Muse Code, tính phí cố định thay vì theo token. Bạn có thể bỏ qua phần này nếu chỉ định dùng API. Tài liệu đăng ký của Meta liệt kê bốn gói:
Trang sản phẩm Muse Code của Meta chỉ hiển thị giá cho Power và Maximum, điều khá lạ, nên hãy kiểm tra các gói thấp hơn tại bước thanh toán. Muse Wonder bản thường có trong mọi gói.
Mỗi gói có giới hạn sử dụng đặt lại theo thời gian. Phần chưa dùng không được cộng dồn, và đăng ký không thể dùng như tín dụng API.
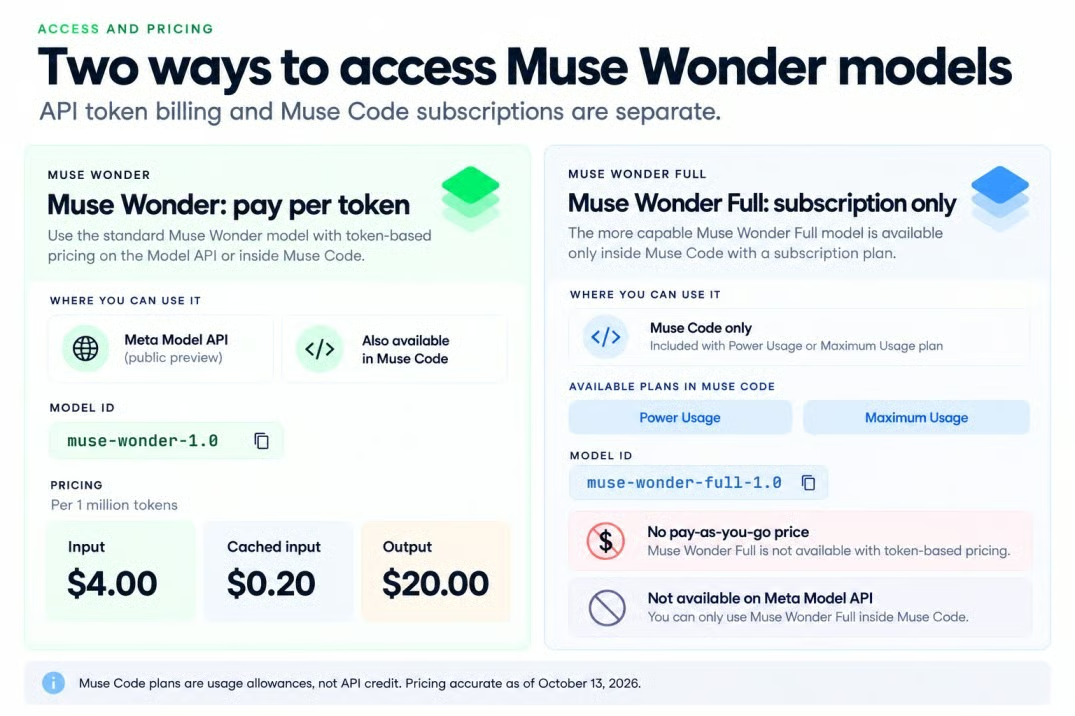
Giá Muse Wonder đi theo hai lộ trình. Nguồn: Meta; ảnh: Tác giả.
Power là cách rẻ nhất để thử Muse Wonder Full, dù Meta chưa nói suất sử dụng đó bao phủ bao nhiêu nhiệm vụ lớn. Đây là phần tôi sẽ theo dõi, vì một người dùng sớm nói vài yêu cầu nhỏ đã dùng khoảng nửa giới hạn 5 giờ của gói nhập môn, như tôi sẽ đề cập ở phần phản hồi của nhà phát triển.
Nhắc lại sự phân tách ở phần đầu: Muse Wonder bản thường có sẵn qua Meta Model API và Muse Code, còn Muse Wonder Full chỉ qua Muse Code.
Để dùng API Muse Wonder, bạn cần tài khoản nhà phát triển Meta, khóa API và thiết lập thanh toán, và ID mô hình là muse-wonder-1.0. Meta vẫn gọi API là “bản xem trước công khai” trên trang sản phẩm; mã xây trên SDK của OpenAI có thể trỏ sang API này, và Meta cũng liệt kê OpenRouter như một tuyến.
Quyền truy cập không phải toàn cầu. Chính sách sử dụng theo địa lý của Meta chặn một số nơi, bao gồm Trung Quốc, Nga, Iran, Pakistan, Eritrea và Ethiopia.
Để có Muse Wonder Full, bạn cần gói Power hoặc Maximum của Muse Code, tài khoản Meta và đủ 18 tuổi hoặc tuổi trưởng thành nơi bạn sống. Như tôi đã trình bày ở phần giá, nó không có trên Model API với bất kỳ giá nào, và ID của nó, muse-wonder-full-1.0, chỉ hoạt động trong Muse Code. Tài liệu của Muse Code liệt kê macOS, Linux và Windows, dù trang sản phẩm chỉ nhắc macOS và Windows.
Rủi ro xuất phát từ chính những điều Meta quảng bá: chạy dài và truy cập tệp riêng tư của bạn.
Thẻ mô hình nêu ba điểm yếu có thể ảnh hưởng đến tác nhân. Mỗi điểm gây một vấn đề khác nhau:
Đây không chỉ là các vấn đề chất lượng câu trả lời riêng lẻ khi mô hình có thể dùng công cụ. Một cú nhấp sai hay giả định sai ở đầu một nhiệm vụ hai giờ có thể làm hỏng phần còn lại.
Phụ thuộc vào chế độ, nên hãy đọc phần này trước khi trỏ Muse Code vào kho riêng. Điều khoản Dịch vụ, cập nhật ba ngày trước khi ra mắt, nói rằng Meta sẽ không huấn luyện trên nội dung gửi tới Dịch vụ Chuẩn (Standard), trong khi nội dung gửi ở chế độ Contributor có thể được dùng để “huấn luyện, phát triển, đánh giá và cải thiện” các mô hình của họ.
Đăng ký Muse Code khởi động ở chế độ Contributor, đổi lại mức sử dụng nhiều hơn, và bạn phải chuyển sang Standard trong phần cài đặt. Việc chuyển chỉ áp dụng cho tương lai, nên bất cứ thứ gì bạn đã gửi vẫn có thể được dùng để huấn luyện. Tôi không thích mặc định này.
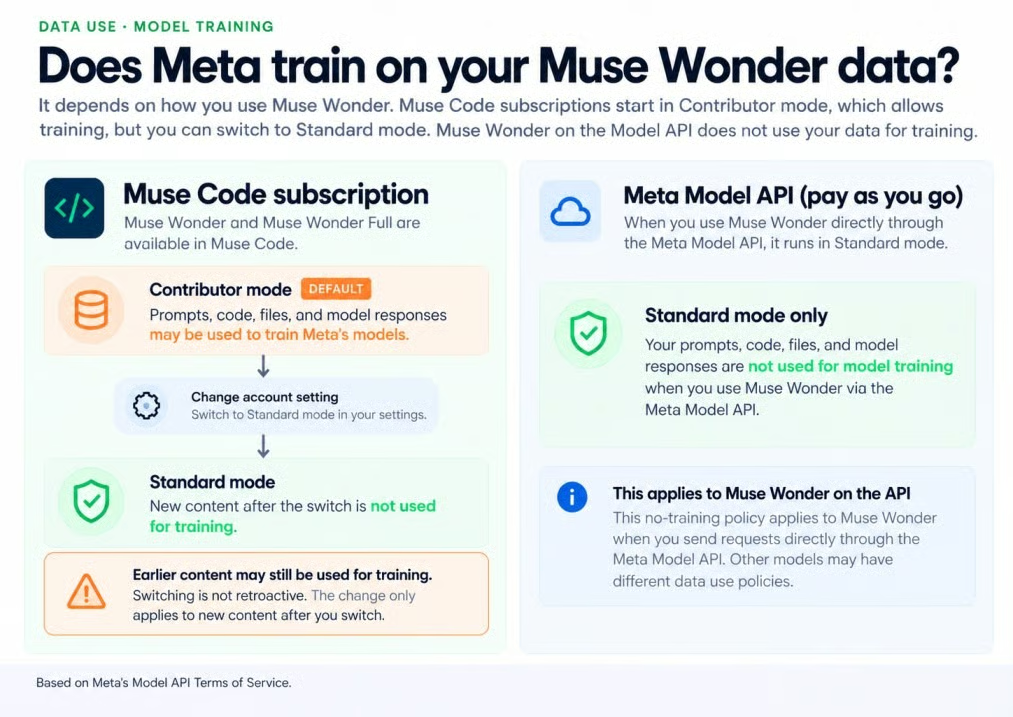
Nội dung Contributor có thể huấn luyện mô hình Meta. Nguồn: Điều khoản Meta; ảnh: Tác giả.
Điều khoản cũng nói bạn “không được gửi thông tin nhạy cảm, bí mật hoặc cá nhân” trong chế độ Contributor, bao gồm mã riêng tư. Muse Wonder bản thường trên API trả theo mức dùng chỉ chạy ở chế độ Standard.
Meta đã kiểm thử Muse Wonder Full theo Khung Mở rộng Siêu trí tuệ của mình. Nếu không có biện pháp bảo vệ, Meta không loại trừ khả năng nó đạt mức rủi ro cao cho các mối đe dọa hóa học và sinh học, và với biện pháp bảo vệ, họ xếp mọi lĩnh vực rủi ro ở “trung bình hoặc thấp hơn”.
Xếp hạng rủi ro không phải là đảm bảo an toàn, và một báo cáo an toàn đầy đủ hơn vẫn “sắp có”. Lời khuyên trong thẻ mô hình rất đơn giản: yêu cầu xác nhận của con người cho các hành động không thể hoàn tác, và giữ tác nhân trong sandbox với quyền hạn giới hạn.
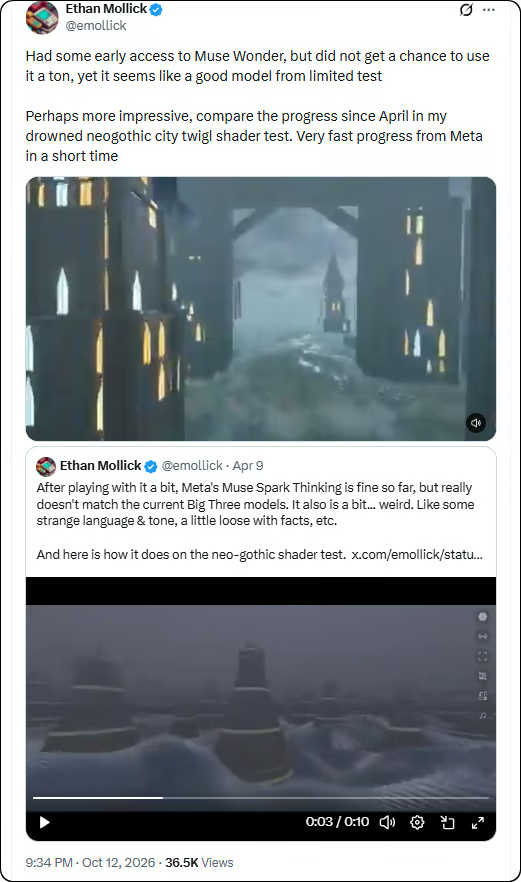
Phản ứng ngày ra mắt trên X chia thành tiến bộ nhanh, hiệu năng không đều và thất vọng với giới hạn sử dụng. Đây là các thử nghiệm ngắn và ấn tượng cá nhân, không phải đánh giá có kiểm soát.
Quan điểm tích cực thận trọng đến từ một người thử sớm, người chỉ có thời gian hạn chế với Muse Wonder nhưng cho rằng nó trông ổn. Điểm lớn hơn là mô hình của Meta đã tiến xa thế nào kể từ Muse Spark vào tháng 4.
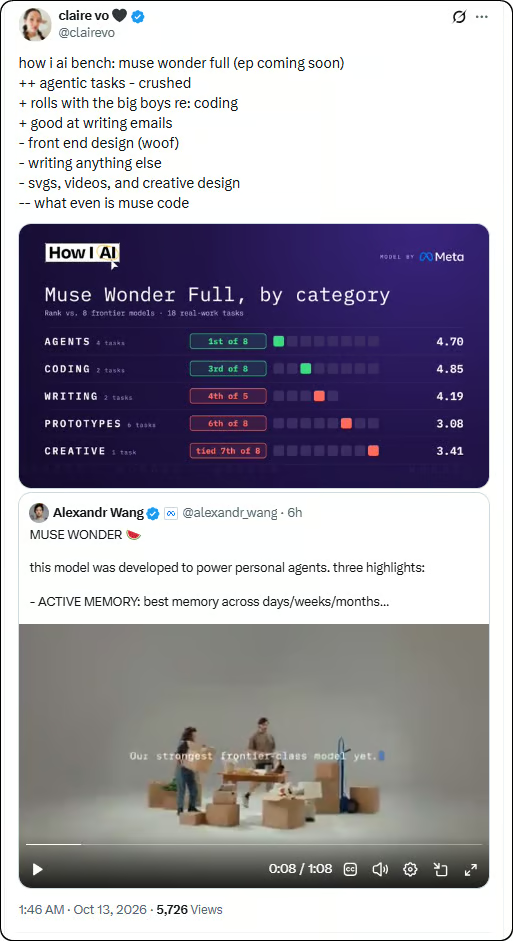
Một bài thử theo danh mục rộng cho thấy câu chuyện kém gọn gàng hơn. Muse Wonder Full xếp gần đầu ở tác nhân và lập trình, nhưng tụt hậu ở viết lách, thiết kế front-end và công việc sáng tạo.
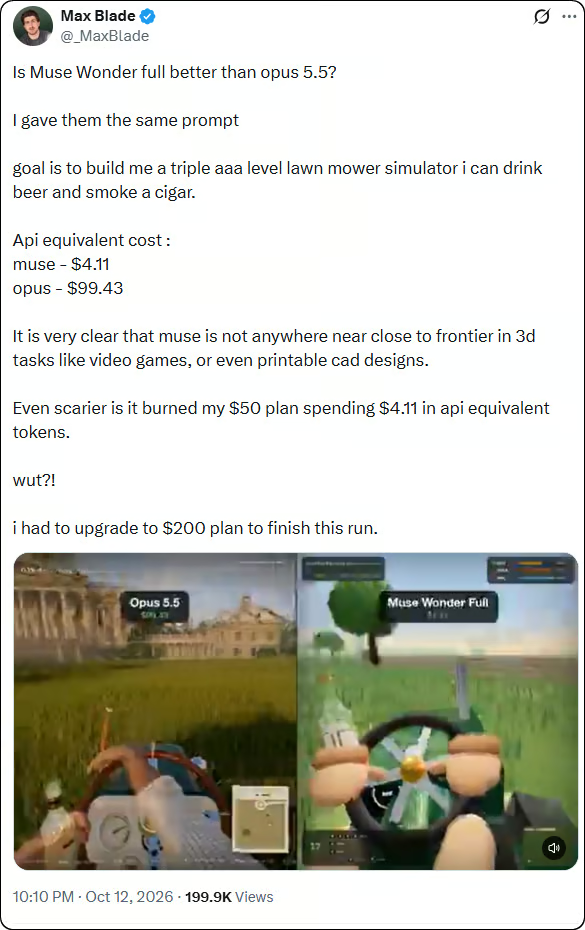
Phàn nàn gay gắt nhất là về chi phí và giới hạn gói. Trong một bài thử máy cắt cỏ với cùng prompt, Muse Wonder Full dùng khoảng $4,11 theo tương đương token API nhưng cho ra kết quả 3D yếu hơn Claude Opus 5.5, và người thử nói để hoàn tất phải nâng từ gói $50 lên gói $200.
Tổng hợp lại, các bài đăng gợi ý Muse Wonder có tính cạnh tranh nhưng không đều. Cần nhiều thử nghiệm lặp lại hơn trước khi coi một kết quả nào đó là điển hình.
Phần lớn bằng chứng khi ra mắt vẫn đến từ Meta. Muse Wonder Full không có API trả theo mức dùng, và Muse Wonder bản thường có giá ngang Claude Opus 5.5 trong khi thua ở một số bài kiểm thử.
Tôi sẽ thử Muse Wonder bản thường cho tác nhân API và Muse Wonder Full cho công việc với kho mã lớn. Tôi sẽ giữ Claude Opus 5.5 cho công việc trong terminal hoặc xây chương trình từ đầu, và dùng GPT-6.1 Sol hoặc Claude Sonnet 5.5 khi chi phí là yếu tố quyết định.
Học với DataCamp
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {blog} other {blog}}
Matt Crabtree
10 phút
