{count, plural, one {コース} other {コース}}
大規模言語モデル(LLM)の基本
{hours}時間
112.2K
今週、Meta は Muse Spark 以来となる主要なモデルファミリーとして、Muse Wonder と Muse Wonder Full を発表しました。Muse Sparkの後継となる初の大型モデルです。どちらもマルチステップの作業をこなす AI エージェント向けに設計されています。
Meta の発表記事では、Muse Wonder は AI 研究の14か月にわたる再構築の成果だとしています。覚えておきたい新用語は2つ。過去の会話から有用な詳細を呼び戻す Active Memory(アクティブメモリ)と、タスクが行き詰まっても作業を継続する Active Focus(アクティブフォーカス)です。
通常の Muse Wonder はMeta Model APIとMuse Codeから利用できます。一方で、見出しを飾る多くの結果の背後にある Muse Wonder Full は、Muse Code の最も高価な2つのプランでのみ動作します。詳細は後ほど解説します。
発表から読み取れたポイントは次のとおりです。
Muse Wonder と Muse Wonder Full は、Meta がこれまでで最も高性能とする推論モデルで、個人および業務タスクを扱うエージェント向けに構築されています。モデルカードには、入力としてテキスト・画像・動画・音声、出力はテキストのみと記載されており、いずれのモデルも画像・動画・音声の生成はしません。Meta の開発者ドキュメントには PDF 入力の追加と、コンテキストウィンドウが 1,048,576 トークンであることが示されています。
Meta のリサーチブログによると、両モデルは Muse Spark の学習成果を基盤にし、Meta の Prometheus データセンターで学習されました。パラメータ数は非公開です。
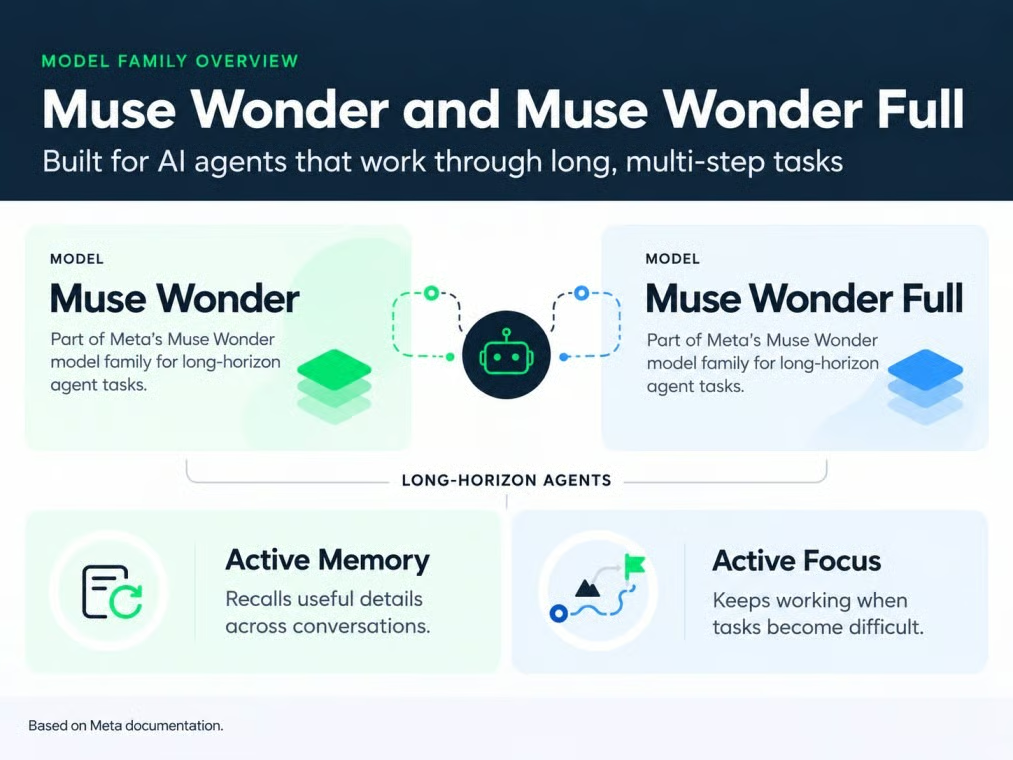
Muse Wonder には 2 つのバリアントがあります。画像:筆者作成。
2 つのうち、Muse Wonder Full は別物の、より高性能なモデルです。開発者ドキュメントによれば、通常の Muse Wonder(muse-wonder-1.0)の推論を"max"に上げても、Muse Wonder Full(muse-wonder-full-1.0)へ切り替わるわけではありません。
Meta は Muse という名称を複数のものに使っています。整理すると、次のとおりです。
Meta が Muse Wonder が「できる」と述べるとき、多くの場合その半分は Muse Code が担っています。以下のコーディング結果の大半にも当てはまります。
Muse Wonder の核となる機能は Active Memory と Active Focus で、長時間のコーディング作業で真価が示されています。どちらの発想もシンプルで、エージェントには適切な詳細の記憶と、計画が失敗しても継続する粘り強さが必要というものです。
Active Memory は、重要な詳細を会話をまたいで保持し、今必要なものを取り出す仕組みを指す Meta の用語です。例えば、3 月に在宅オフィスの予算を $3,000 に設定し、4 月に $4,000 に引き上げ、5 月に家具の候補リストを依頼したとします。良いメモリなら、エージェントはリマインドなしで 4 月の数字を使います。
Meta の根拠は、事実が更新される長い会話を想定した自社テストの MemoryBench です。Muse Wonder は 85.6 を記録していますが、これは数か月越しの想起力を示すものではなく、API 上に構築したアプリは依然として自前で事実を保存する必要があります。古い予算で動くエージェントはコストにつながるため、個人的に最も気になる機能です。
Active Focus は粘り強さを指す Meta の用語で、別のアプローチを試し、障害を乗り越え、重要な操作の前に確認を入れることを含みます。例えば 30 件のテストが落ちるコード移行では、集中したエージェントはコードを修正してテストを再実行しますが、弱いエージェントはテストを通るようテスト側を改変してしまいます。
Meta はこれを自社テストの FocusBench と、後述のSWE-Marathonで測定しています。どちらもタスク完了を保証するものではなく、バックグラウンド動作はモデルの周辺ソフト次第です。常時稼働エージェントのリスクについては、当社のOpenAI Dots 解説を参照してください。
Muse Wonder は長時間のコーディング作業を計画し、補助エージェントに分割して割り当てます。ツール実行や承認フローは Muse Code が担います。Meta の開発者ページは、同時に多数のファイルを編集しながら「数時間」走るタスクに適していると謳っています。
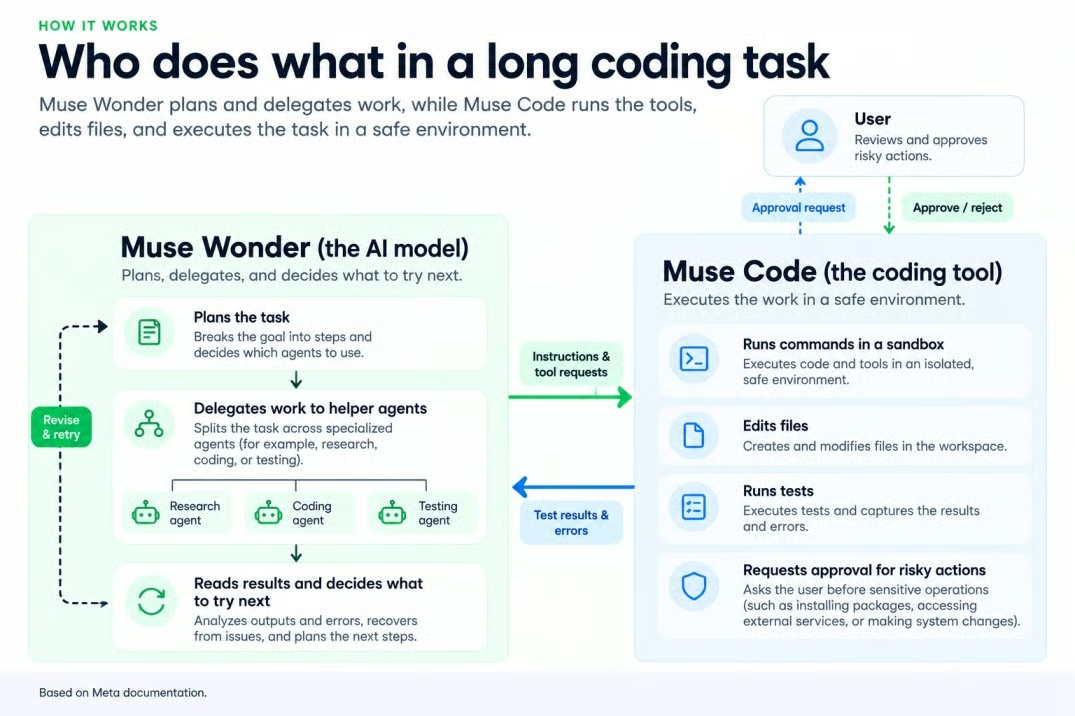
計画は Muse Wonder、実行は Muse Code。画像:筆者作成。
Meta のデモのひとつは、画像から構築したプレイ可能な 3D キッチンゲームです。モデルカードでは 3D 推論が既知の弱点とされているため、やや不思議な選択です(別のデモを選ぶべきだったでしょう)。
Meta の表では、長時間のコーディングや一部のプロ向けベンチで Muse Wonder Full に有利な一方、ターミナルコーディングやゼロからの構築では Claude Opus 5.5 が優勢です。以下の数値は断りがない限り Meta の公表値で、ほぼすべてのモデルが最高の推論設定です(例外は明記します)。
Meta の表では、Muse Wonder Full が長時間コーディングの 2 テストでトップです。冒頭でも触れたとおり、DeepSWE v1.1 では Muse Wonder Full が 79.0、通常の Muse Wonder が 78.8 と僅差です。Datacurve の公開 DeepSWE リーダーボードには現時点で Muse Wonder の掲載がないため、これらは当面 Meta 側の数値です。
SWE-Marathon は注目に値します。20 の数時間プロジェクトで、1 つでもテストが失敗するとスコアはゼロです。Meta は、Muse Wonder Full が 57.5(最高設定の一段下)、Muse Wonder が 53.1、対して Claude Opus 5.5 が 46.3、GPT-6 Astra が 42.5 と報告しています。競合モデルは各社の自社コーディングツール内で走らせたため、Meta 自身が比較が完全に公正ではないと注記しています。加えて 20 プロジェクトしかないため、ひとつで数ポイント動きます。
Abundant AI の SWE-Marathon リーダーボードではより控えめで、Muse Wonder Full が 53.1%、通常の Muse Wonder が 52.5%(いずれも Muse Code 内の最高設定)で、Claude Sonnet 5.5 の 51.3% をわずかに上回る程度です。Claude Haiku 5.5(Anthropic が 5 日前に公開)は 50.0% です。両リストは別テスト由来なので混同しないでください。
Muse Wonder がアプリをまたいで作業を遂行できるという Meta の主張は、評価が分かれます。AutomationBench-AA(業務ワークフローが正しい状態で終わるかを検証)では、Muse Wonder Full が 45.4、GPT-6 Astra が 41.6、Claude Opus 5.5 が 41.2 で、リードはするものの多くのワークフローに失敗しています。
108 のデスクトップ作業から成る OSWorld V2.1 は、より明確です。Muse Wonder Full は部分点で 78.4 を獲得する一方、完全達成は 39.4% にとどまり、部分点では両 Claude モデルが上回ります。保険の申請書のように、ほとんどの手順が正しくても未完了は失敗なので、注視すべきは 39.4% という完遂率です。
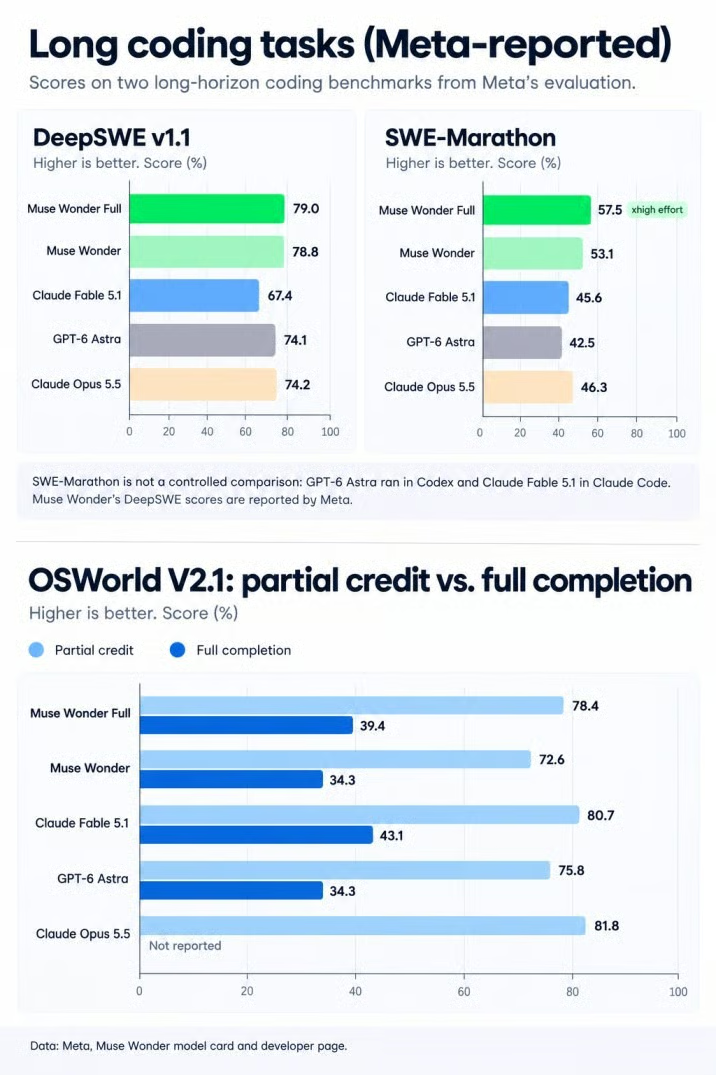
コーディングでの優位は、低い完遂率を覆い隠します。出典:Meta/画像:筆者作成。
Muse Wonder Full は法務系でリードし、医療では劣後、金融はほぼ互角です。法務のスコアは小さく聞こえますが、Claude Opus 5.5 の約 3 倍です。Artificial Analysis 版では、法的文書はすべての要件を満たし、捏造がない場合のみカウントされ、Muse Wonder Full は 13.1、Claude Opus 5.5 は 4.2。とはいえ、依然として約 87% のタスクに失敗します。
金融はほぼ引き分けで、Vals Finance Agent V2で Muse Wonder Full が 59.1、Claude Opus 5.5 が 58.6。医療は逆で、HealthBench Pro で Muse Wonder Full は 62.3、Claude Opus 5.5 は 65.6、GPT-6 Astra は 65.3 です。
Meta の表にある 14 テストのうち、Muse Wonder Full は 6 つで Claude Opus 5.5 に遅れ、GPT-6 Astra にも 3 つで負けています。以下は先に触れていない敗北項目の一覧です。
|
Benchmark |
What it tests |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Terminal coding |
57.1 |
52.0 |
59.1 |
59.6 |
52.0 |
|
ProgramBench |
Building programs from scratch |
59.0 |
50.0 |
52.5 |
70.5 |
55.5 |
|
AA Intelligence Index v4.3 |
Broad composite |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Professional tool use |
75.3 |
70.5 |
66.1 |
75.4 |
73.1 |
|
GDP.pdf |
Work from PDFs |
33.2 |
30.8 |
34.2 |
30.6 |
27.6 |
出典:公開時点の Meta の Muse Wonder 開発者ページ。すべてのモデルが最高の推論設定。
ProgramBenchの敗北は、コーダーにとって最も重要ですし、差も大きい。モデルにプログラムをゼロから再構築させるテストで、11.5 ポイントの開きは、既存コードベースの編集とゼロからの構築が別スキルであることを示します。
Artificial Analysis はMuse Wonder Full を 55.8とし、Meta の表では丸めて 56。Claude Sonnet 5.5 は 56.0 です。
Muse Wonder のベンチマークは信頼できるか? 全面的には難しいでしょう。モデルカードによれば、表は 3 種の根拠を混在させています。
前述のとおり、ほぼすべてのスコアは最高の推論設定で、各モデルの最良条件を示します。テスターによる差もあります。例えば Anthropic は、Terminal-Bench 4.0 で Claude Opus 5.5 を 66.4% と報告しており、Meta の表の 59.6 と乖離します。Muse Wonder Full が Spark 系列より未知タスクに強いという主張も、Meta 自身の分析に基づきます。
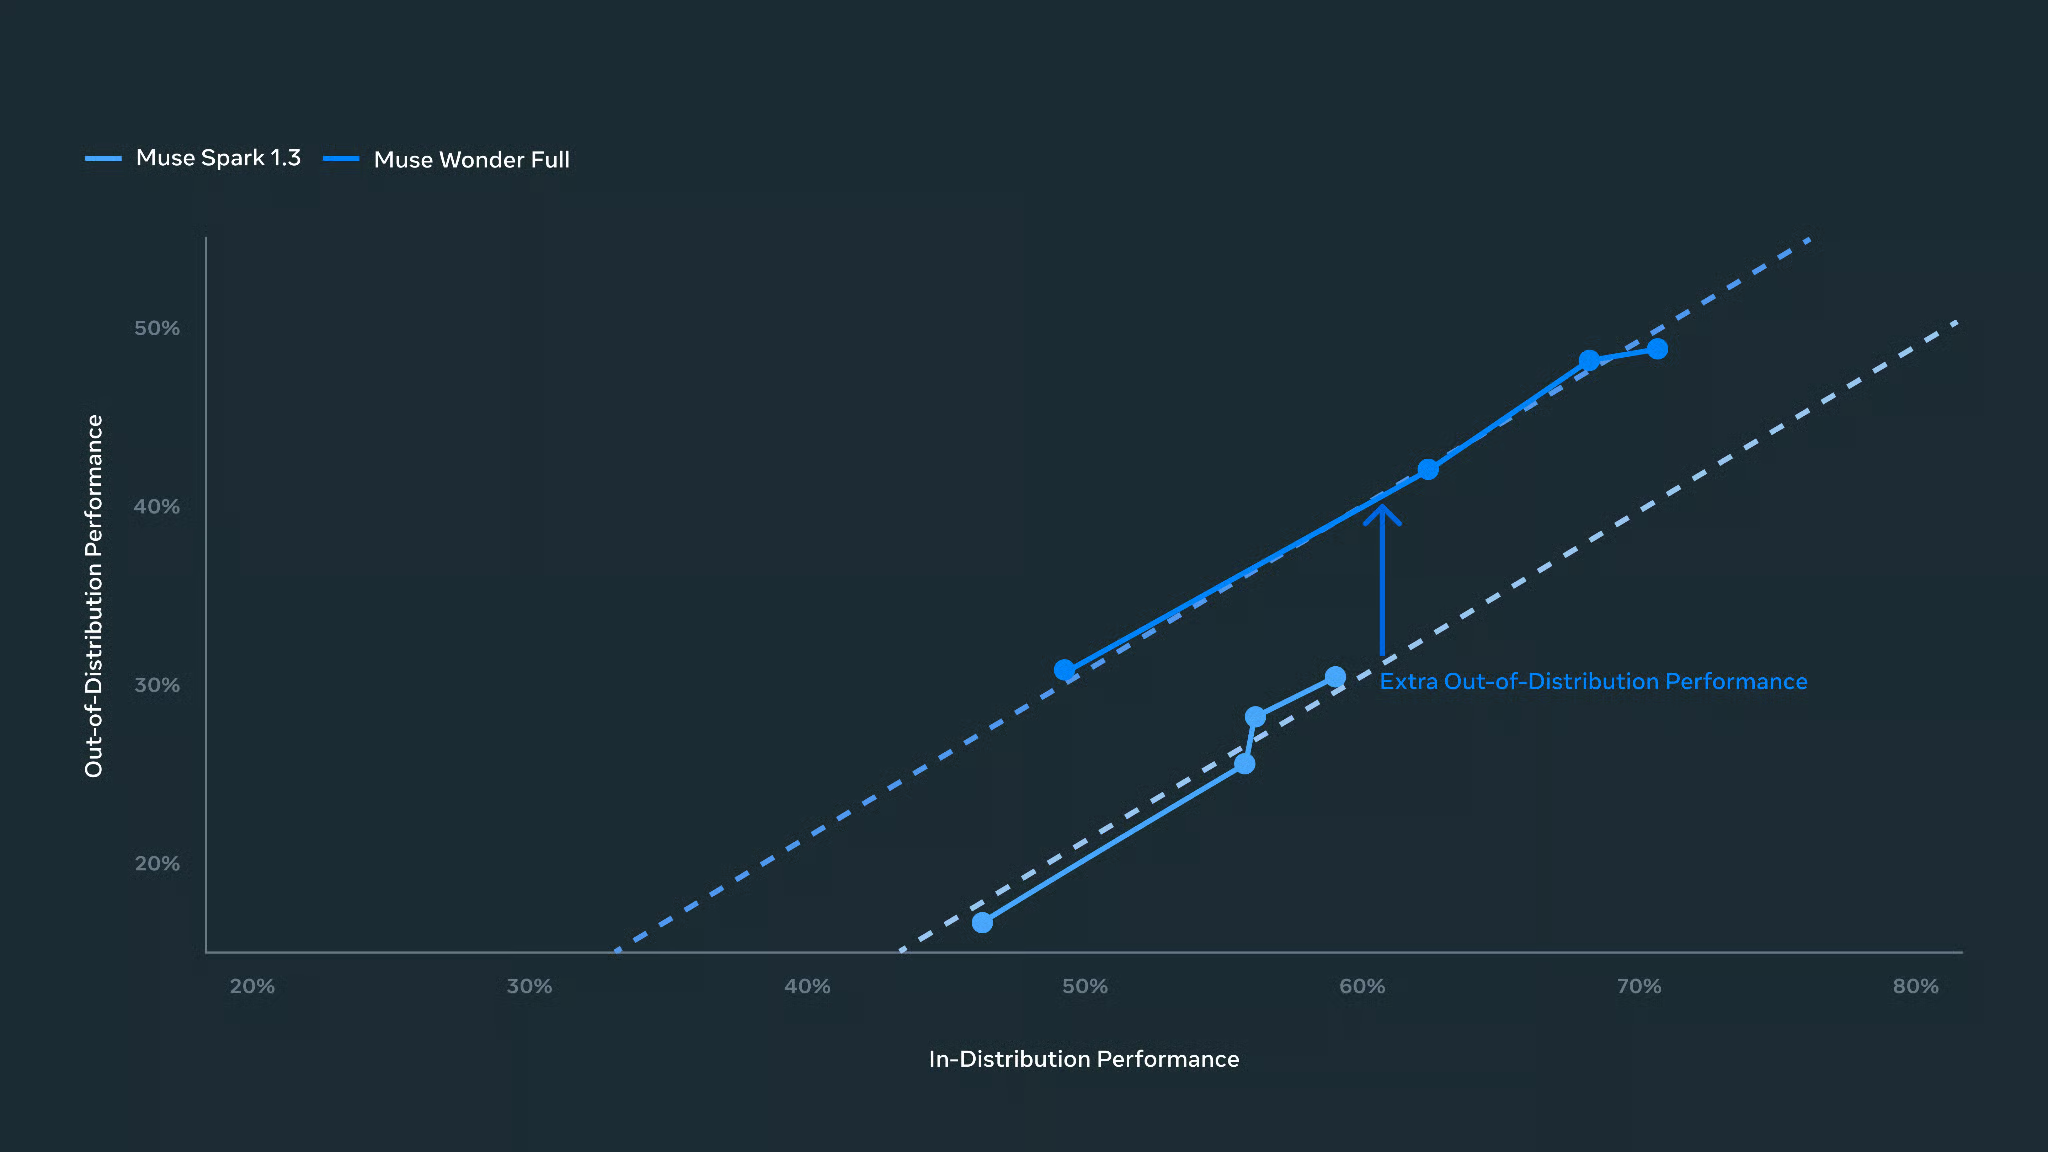
未知タスクでの性能比較(Meta 提供)。
Meta の数値では、長時間のコーディング(ただし Muse Code 内のみ)で Muse Wonder Full が勝り、ターミナル作業とゼロからの構築は Claude Opus 5.5 が優勢、GPT-6 Astra は表の 1 行だけをリードしています。ここではベンチマークを総合するので、内容は前段と重なります。
自動化は割れます。AutomationBench-AA は Muse Wonder Full がリードする一方、OSWorld の部分点は Claude 系が上です。完全達成率が報告されているモデルの中で、過半のタスクを完了したものはありません。広範な推論では、Artificial Analysis の指数で Claude Opus 5.5 がトップ、通常の Muse Wonder は 52.4 です。
価格では、通常の Muse Wonder は見劣りします。GPT-6.1 Solはトークン単価が半額で、同指数で 51.8。Claude Sonnet 5.5 も GPT-6.1 Sol と同価格です。
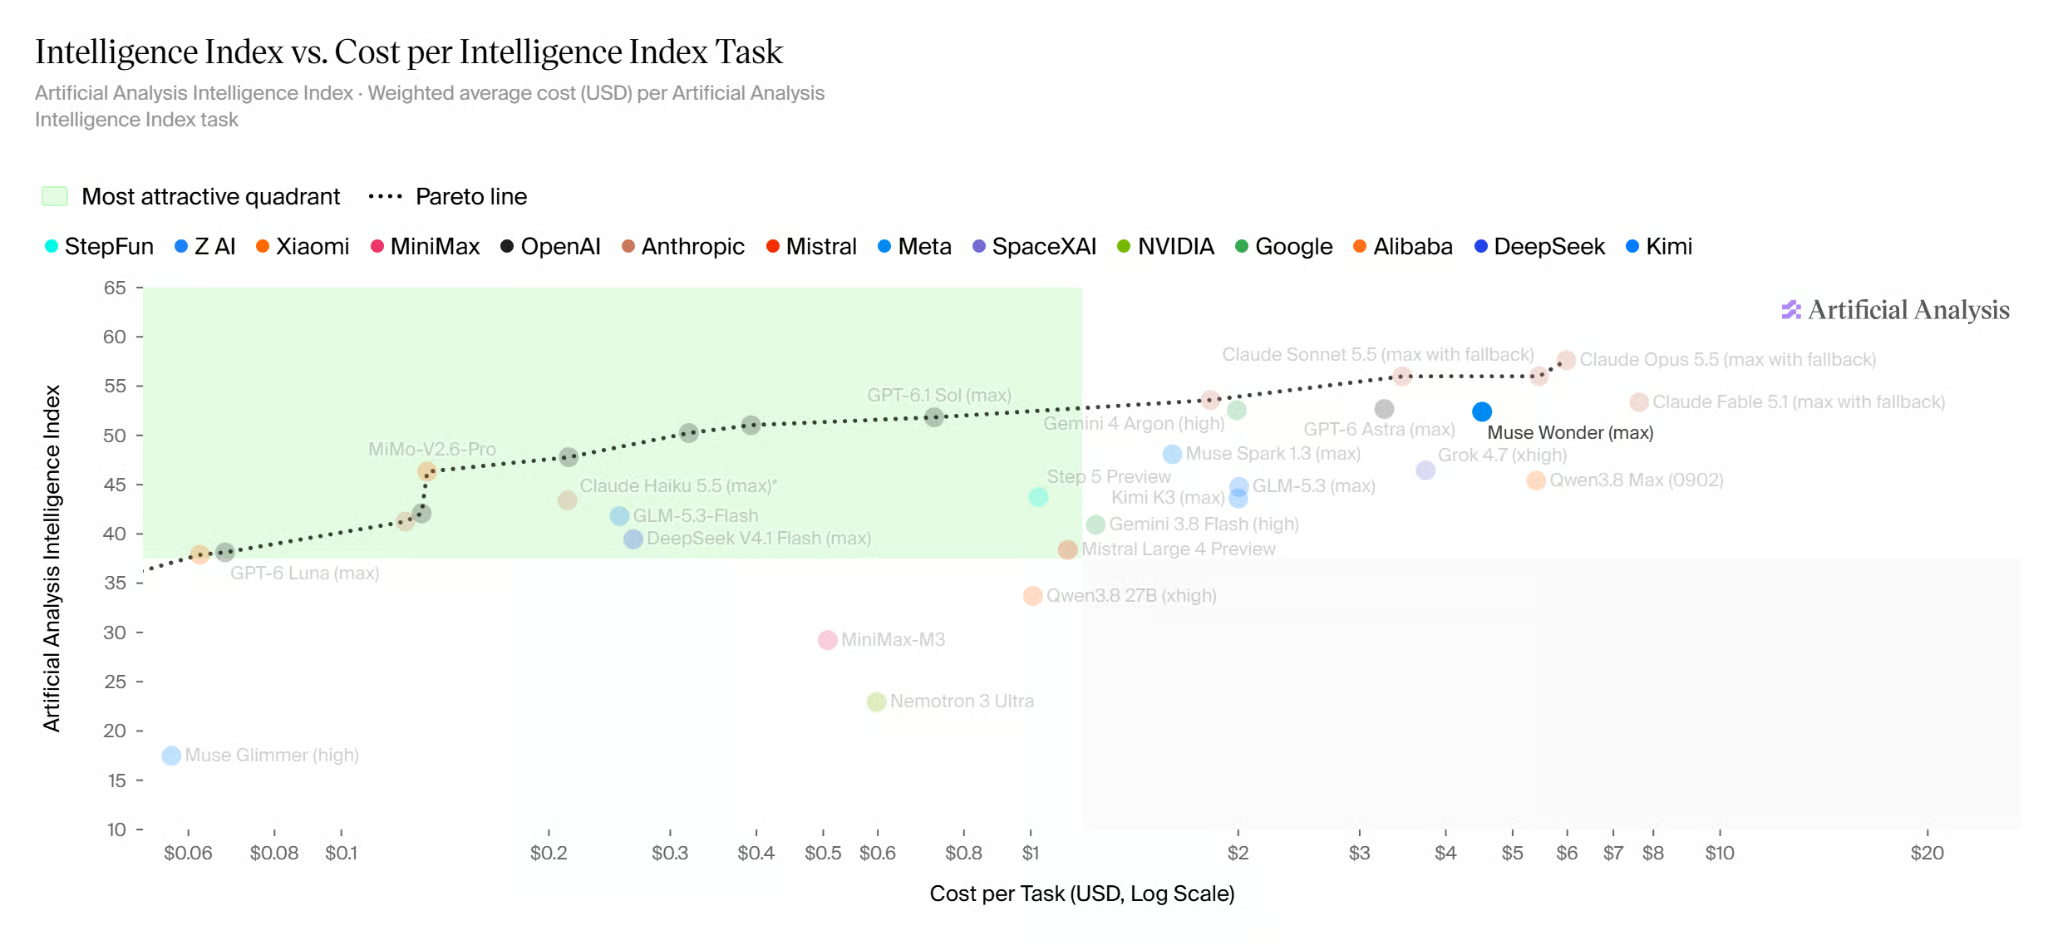
Muse Wonder はコストと知性のトレードオフ。出典:Artificial Analysis。
Gemini 4 Argon は Meta の比較対象に入っていないため、本節から外そうかと迷いました。当社のGemini 4 Argon の解説でも触れたとおり、まず信頼済みのサイバーセキュリティチーム向けに展開されたためです。共通の結果がない以上、公平な真っ向比較はできません。ワークロードとタスク完了までの総コストで選ぶべきでしょう。
Muse Wonder が最もはまるのは 2 種類の仕事です。大規模なソフトウェア変更と、マルチステップのブラウザ業務フローです。長期の計画系(Meta の結婚式の席配置デモなど)は、モデルの周辺アプリにより多く依存します。
このユースケースは、少なくとも既存コードの変更に関しては裏付けが最も強い分野です。Muse Code 内の Muse Wonder はファイルをまたいで作業し、テストを実行し、失敗を読み取り、再挑戦します。これは DeepSWE や SWE-Marathon が測っている挙動です。実コードへの適用では、必要最小限の権限のみを与え、人的レビューを入れてください。
Meta の Saturday Run Planning デモでは、Muse Wonder が「ブラウザ内で直接、アプリをまたいで」動作する様子が示され、別のデモでは保険金請求を扱います。Muse Wonder Full のデスクトップタスクの完全達成は 4 割未満なので、実運用のワークフローでは送信・支払い前に必ず承認を挟むべきです。
Muse Wonder の支払い方法は 2 通りです。通常の Muse Wonder はトークン単価課金、Muse Wonder Full は月額の Muse Code プラン(前述のとおり唯一の入手方法)です。
Meta の料金ページでは、通常の Muse Wonder は入力 100 万トークンあたり $4.00、キャッシュ済み入力 $0.20、出力 $20.00。これは Muse Spark 1.3($1.25/$4.25)からの大幅な値上げで、Claude Opus 5.5 の価格と同額です。Meta が Muse Wonder をどの位置づけと見なしているかがわかります。
GPT-6 Astra は $10、キャッシュ $1、出力 $50、GPT-6.1 Sol は$2、$0.10、$10です。以下の仮定は、ローンチ当日の価格を用い、1 件のコーディング作業に入力 300 万トークン(うち 240 万がキャッシュ)、出力 20 万トークンを想定しています。1 回のリクエストが 272,000 トークンを超えない(GPT-6 Astra の料金が上がる)前提です。
|
Model |
Uncached input (0.6M) |
Cached input (2.4M) |
Output (0.2M) |
Total per task |
|
Muse Wonder |
$2.40 |
$0.48 |
$4.00 |
$6.88 |
|
Claude Opus 5.5 |
$2.40 |
$0.48 |
$4.00 |
$6.88 |
|
GPT-6 Astra |
$6.00 |
$2.40 |
$10.00 |
$18.40 |
|
GPT-6.1 Sol |
$1.20 |
$0.24 |
$2.00 |
$3.44 |
トークン単価が同じなら試行 1 回あたりの請求も同額です。比較すべきは、完了タスク 1 件あたりのコストです。仮に Muse Wonder の完了率が 50% なら $13.76。これは、GPT-6.1 Sol の価格帯のモデルが完了率 25% の場合と同じ(どちらも例示の仮定)。
Muse Wonder Full は Muse Code の月額プラン専用で、トークン従量ではありません。API だけを使う予定なら読み飛ばして構いません。Meta のサブスクリプションのドキュメントでは、4 つのプランが示されています。
Meta のMuse Code 製品ページは Power と Maximum の価格しか掲載していません。下位プランの価格はチェックアウト時に確認してください。通常の Muse Wonder はすべてのプランで利用可能です。
各プランには時間でリセットされる使用上限があります。未使用分の繰り越しはできず、サブスクは API クレジットとしては使えません。
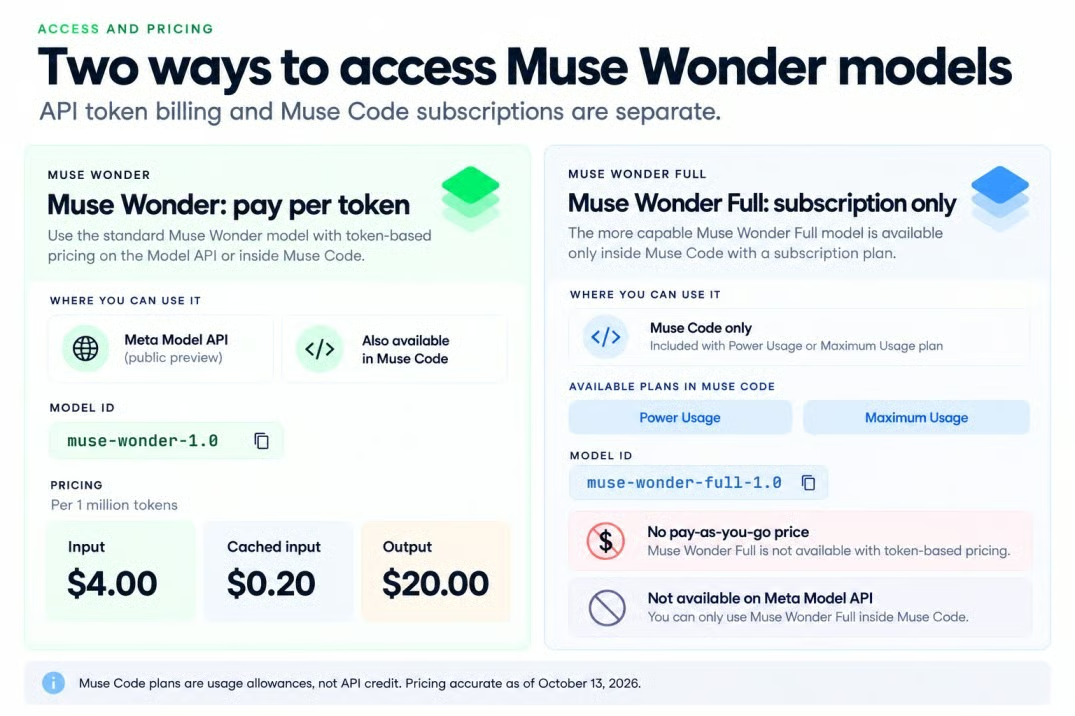
Muse Wonder の料金は 2 つの経路。出典:Meta/画像:筆者作成。
Muse Wonder Full を試す最安は Power ですが、どれだけ大型タスクをカバーできるか Meta は明らかにしていません。ここは注視したいところで、ある初期ユーザーは、いくつかの小さなリクエストでエントリープランの 5 時間制限の約半分を消費したと述べています。詳細は開発者の反応で触れます。
冒頭の整理のとおり、通常の Muse Wonder は Meta Model API と Muse Code から、Muse Wonder Full は Muse Code のみから利用できます。
Muse Wonder API を使うには、Meta の開発者アカウント、API キー、課金設定が必要で、モデル ID はmuse-wonder-1.0です。製品ページでは API をいまだ「パブリックプレビュー」と呼んでおり、OpenAI の SDK で書かれたコードを向け替えて使えます。Meta は OpenRouter からの経路も案内しています。
アクセスは全世界対応ではありません。Meta のGeographic Use Policyでは、中国、ロシア、イラン、パキスタン、エリトリア、エチオピアなど複数地域がブロックされています。
Muse Wonder Full を利用するには、Muse Code の Power または Maximum プラン、Meta アカウント、そして 18 歳(または居住地の成年)であることが必要です。料金の節で触れたとおり、Model API ではいかなる価格でも提供されておらず、ID はmuse-wonder-full-1.0で、Muse Code 内でのみ機能します。Muse Code のドキュメントには macOS、Linux、Windows の記載がありますが、製品ページには macOS と Windows のみの言及があります。
リスクは、Meta が推す強みと同じ要素、すなわち長時間の稼働とプライベートファイルへのアクセスから生じます。
モデルカードは、エージェントに影響しうる 3 つの弱点を挙げています。各弱点は異なる問題を引き起こします。
ツールを使えるモデルでは、これは単発の回答品質の問題に留まりません。2 時間タスクの序盤での誤クリックや誤った仮定が、以降を台無しにすることがあります。
モードに依存するため、プライベートリポジトリに Muse Code を向ける前に必ず確認してください。Meta の利用規約(ローンチ 3 日前に更新)では、Standard Services に送信されたコンテンツは学習に使用しない一方、Contributor モードで送信されたコンテンツはモデルの「学習、開発、評価、改善」に使用されうるとしています。
Muse Code のサブスクリプションは、使用量を増やす代わりに既定で Contributor モードから始まり、設定で Standard に切り替える必要があります。切り替えは今後の送信にのみ適用され、既に送ったものは学習に使われ得ます。この既定は好ましく感じません。
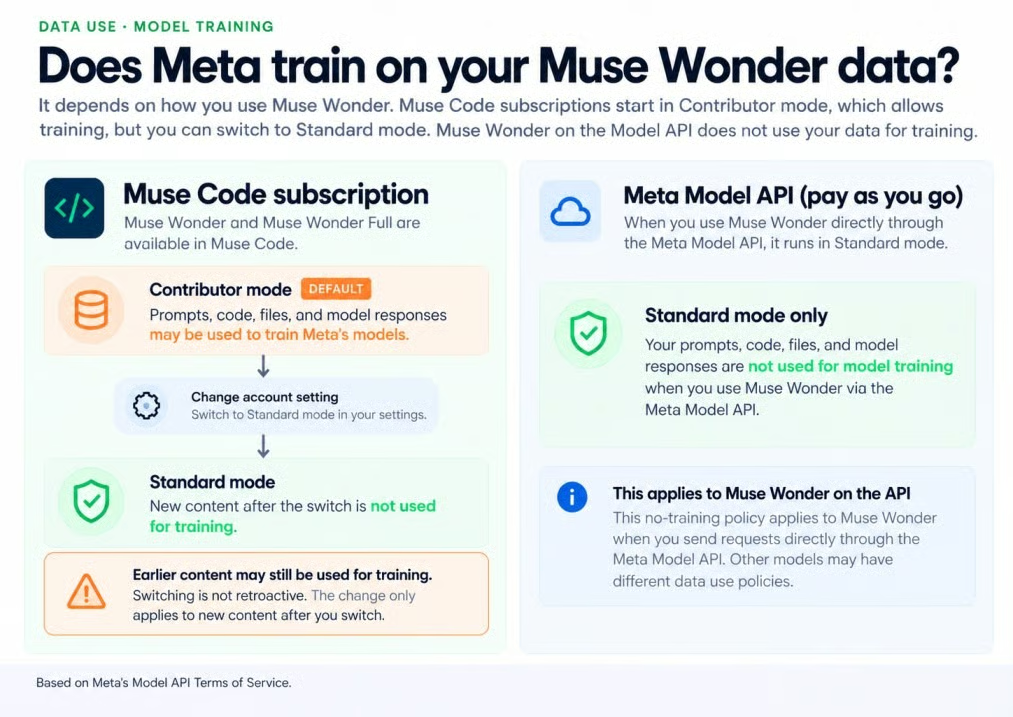
Contributor のコンテンツは Meta の学習に使われ得ます。出典:Meta 利用規約/画像:筆者作成。
また規約では、Contributor モードで「機微、機密、個人情報」を提出してはならないとし、私的コードも含まれます。従量課金の API で動く通常の Muse Wonder は、Standard モードのみです。
Meta は Muse Wonder Full をSuperintelligence Scaling Frameworkに基づいて評価しました。セーフガードなしでは、化学・生物学的脅威のハイリスク水準に到達しうることを排除せず、セーフガードありではすべてのリスク領域を「中程度以下」と評価しています。
リスク評価は安全の保証ではありません。より詳しい安全性レポートは「近日中」に公開予定です。モデルカードの助言はシンプルで、取り消せない操作には人の確認を必須とし、限定権限のサンドボックス内でエージェントを動かすことです。
X(旧 Twitter)でのローンチ当日の反応は、急速な進歩、ばらつく性能、使用制限への不満に分かれました。いずれも短時間の試用や個人的な印象で、制御された評価ではありません。
慎重なポジティブ評価として、短時間の試用ながら「良さそう」という声がありました。より大きなポイントは、4 月の Muse Spark 以降の Meta モデルの進歩の速さでした。
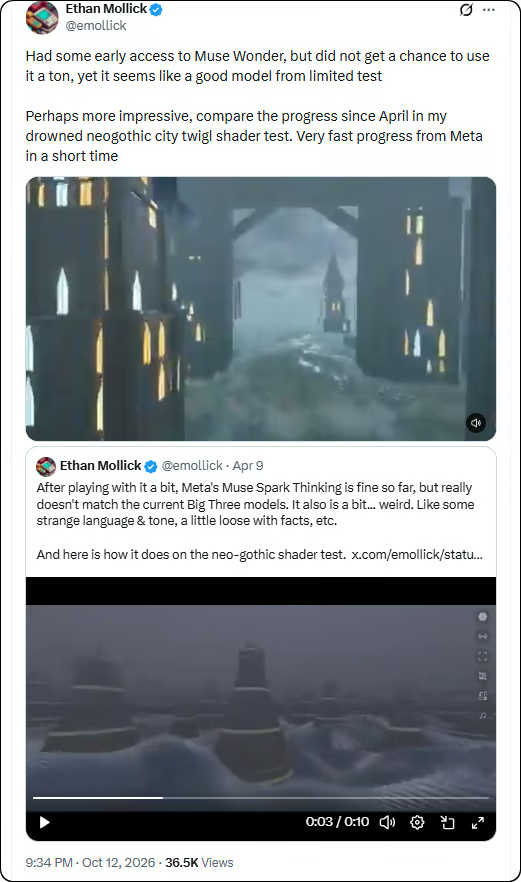
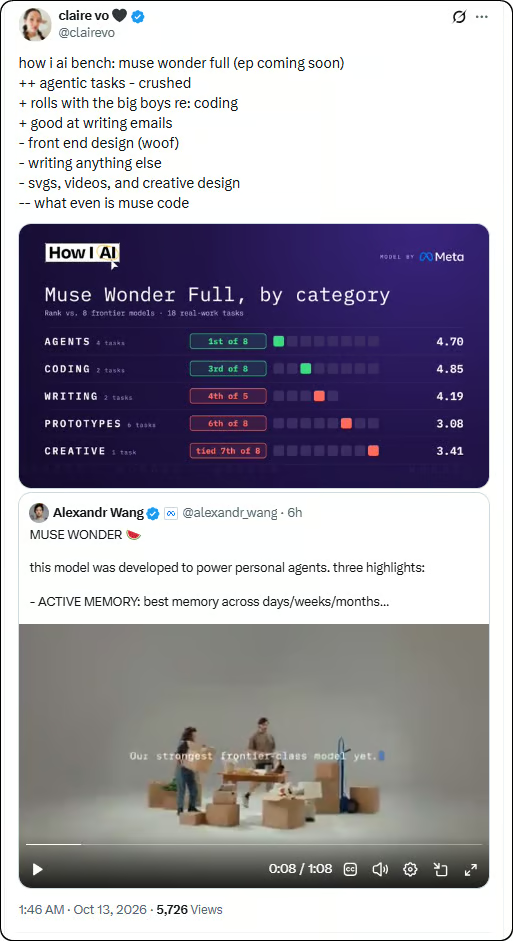
より広いカテゴリテストでは、結果は一枚岩ではありません。エージェントとコーディングでは上位に来るものの、ライティング、フロントエンド設計、クリエイティブ作業では後れを取りました。
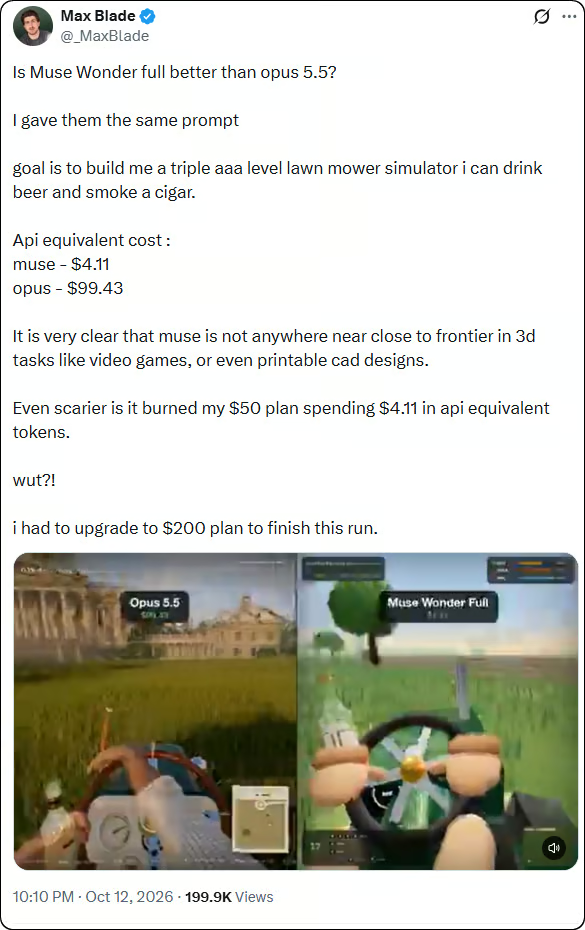
最も強い不満は、コストとプラン制限についてでした。同一プロンプトの芝刈り機テストでは、Muse Wonder Full は API 換算で約 $4.11 のトークンを使った一方で、3D の結果は Claude Opus 5.5 より弱く、完了には $50 プランから $200 プランへのアップグレードが必要になったといいます。
総じて、投稿群は Muse Wonder が競争力はあるが均一ではないことを示唆します。どの結果も、一般化するには繰り返し検証が必要です。
現時点の証拠の多くは Meta からのものです。Muse Wonder Full には従量課金 API がなく、通常の Muse Wonder はいくつかのテストで劣後しながらも Claude Opus 5.5 と同額です。
API エージェントには通常の Muse Wonder、長時間のリポジトリ作業には Muse Wonder Full を試すのがよいでしょう。ターミナル作業やゼロからの構築には Claude Opus 5.5 を、コスト重視なら GPT-6.1 Sol や Claude Sonnet 5.5 を使い分けます。
DataCamp で学ぶ
{count, plural, one {コース} other {コース}}
{count, plural, one {コース} other {コース}}
{count, plural, one {コース} other {コース}}