
{count, plural, one {कोर्स} other {कोर्स}}
Large Language Models (LLMs) कॉन्सेप्ट्स
{hours} घंटा
112.3K
इस सप्ताह, Meta ने Muse Wonder और Muse Wonder Full जारी किए, जो Muse Spark के बाद इसका पहला प्रमुख मॉडल परिवार है। दोनों को बहु-चरणीय काम संभालने वाले AI एजेंट्स के लिए बनाया गया है।
Meta की लॉन्च पोस्ट Muse Wonder को उसके AI कार्य के 14-महीने के पुनर्निर्माण का नतीजा बताती है। जानने लायक दो नए शब्द हैं Active Memory, जो पिछली बातचीतों से उपयोगी विवरण याद रखता है, और Active Focus, जो कार्य अटकने पर भी काम जारी रखता है।
सामान्य Muse Wonder Meta Model API और Muse Code के जरिए उपलब्ध है, जबकि Muse Wonder Full, जो ज़्यादातर सुर्खियों में आया, केवल Muse Code की दो सबसे महंगी योजनाओं में चलता है। इस पर आगे विस्तार से बात करेंगे।
लॉन्च से मेरी मुख्य सीखें:
Muse Wonder और Muse Wonder Full तर्क-आधारित मॉडल हैं जिन्हें Meta अब तक के अपने सबसे सक्षम मॉडल कहता है, जो निजी और कार्य-संबंधी कार्यों को संभालने वाले एजेंट्स के लिए बने हैं। मॉडल कार्ड में टेक्स्ट, इमेज, वीडियो और ऑडियो इनपुट तथा केवल टेक्स्ट आउटपुट सूचीबद्ध हैं, यानी कोई भी मॉडल इमेज, वीडियो या ऑडियो जनरेट नहीं करता। Meta के डेवलपर दस्तावेज़ PDF इनपुट जोड़ते हैं और संदर्भ-विंडो 1,048,576 टोकन बताते हैं।
Meta के रिसर्च ब्लॉग के अनुसार, दोनों Muse Spark के प्रशिक्षण कार्य पर आधारित हैं और Meta के Prometheus डेटा सेंटर में प्रशिक्षित किए गए। पैरामीटर काउंट्स साझा नहीं किए गए हैं।
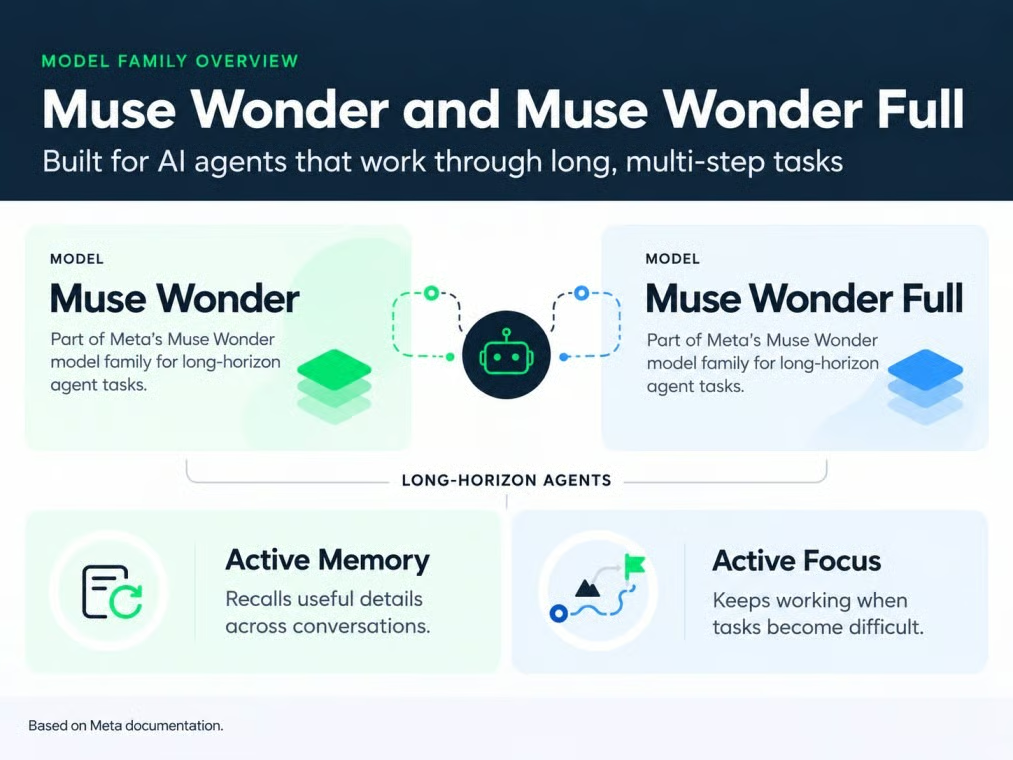
Muse Wonder दो रूपों में आता है। चित्र: लेखक।
दोनों में, Muse Wonder Full एक अलग, अधिक सक्षम मॉडल है। डेवलपर दस्तावेज़ बताते हैं कि सामान्य Muse Wonder (muse-wonder-1.0) को "max" रीजनिंग पर सेट करने से यह Muse Wonder Full (muse-wonder-full-1.0) नहीं बन जाता।
आपने गौर किया होगा कि Meta कई चीज़ों के लिए Muse नाम का उपयोग करता है। संक्षेप में:
जब Meta कहता है कि Muse Wonder कुछ "करता" है, तो अक्सर आधा काम Muse Code करता है। यह नीचे दिए गए अधिकांश कोडिंग परिणामों पर लागू होता है।
Muse Wonder की प्रमुख विशेषताएँ Active Memory और Active Focus हैं, और लंबे कोडिंग कार्यों में Meta इन्हें दिखाता है। दोनों के पीछे का विचार सरल है: एजेंट को सही विवरण याद रखने चाहिए और योजना विफल होने पर भी आगे बढ़ते रहना चाहिए।
Active Memory वह शब्द है जिसका उपयोग Meta महत्वपूर्ण विवरणों को वार्तालापों के पार ले जाने और अभी ज़रूरी विवरण निकालने के लिए करता है। मान लीजिए आपने मार्च में होम-ऑफिस बजट $3,000 तय किया, अप्रैल में उसे $4,000 कर दिया, और मई में फर्नीचर की शॉर्टलिस्ट मांगी। अच्छी मेमोरी का मतलब है कि एजेंट बिना याद दिलाए अप्रैल वाली राशि का उपयोग करे।
Meta का साक्ष्य MemoryBench है, जो इसकी अपनी लंबी बातचीतों की परीक्षा है जिसमें तथ्य अपडेट होते रहते हैं। Muse Wonder इस पर 85.6 स्कोर करता है, लेकिन इससे महीनों-पार रिकॉल के बारे में कुछ नहीं पता चलता, और API पर बनी कोई ऐप फिर भी खुद उन तथ्यों को स्टोर करेगी। यह वही फीचर है जिसके बारे में मैं सबसे अधिक जिज्ञासु हूँ, क्योंकि पुराना बजट मानकर काम करने वाला एजेंट आपको महँगा पड़ सकता है।
Active Focus का मतलब है दृढ़ता: दूसरा तरीका आज़माना, बाधाओं के पार काम करना, और महत्वपूर्ण कार्रवाइयों से पहले पुष्टि लेना। कल्पना कीजिए, कोड माइग्रेशन में 30 टेस्ट फेल हो रहे हैं। केंद्रित एजेंट अपना कोड ठीक करता है और टेस्ट फिर चलाता है, जबकि कमजोर एजेंट सिर्फ टेस्टों में बदलाव कर देता है ताकि वे पास हो जाएँ।
Meta इसे अपने एक और टेस्ट FocusBench से और SWE-Marathon से मापता है, जिस पर मैं बेंचमार्क खंड में आऊँगा। कोई भी यह गारंटी नहीं देता कि कार्य पूरा होगा, और बैकग्राउंड में काम करना मॉडल के आसपास के सॉफ्टवेयर पर निर्भर करता है, जिस जोखिम को हमारे OpenAI Dots समझाने में हमेशा-चालू एजेंट्स के लिए कवर किया गया है।
Muse Wonder लंबे कोडिंग कार्यों की योजना बनाता है और काम को सहायक एजेंट्स में बाँटता है, जबकि Muse Code टूल्स और अनुमोदन चलाता है। Meta का डेवलपर पेज इसे ऐसे कार्यों के लिए प्रस्तुत करता है जो "घंटों तक चलते हैं," और एक साथ कई फाइलें एडिट होती हैं।
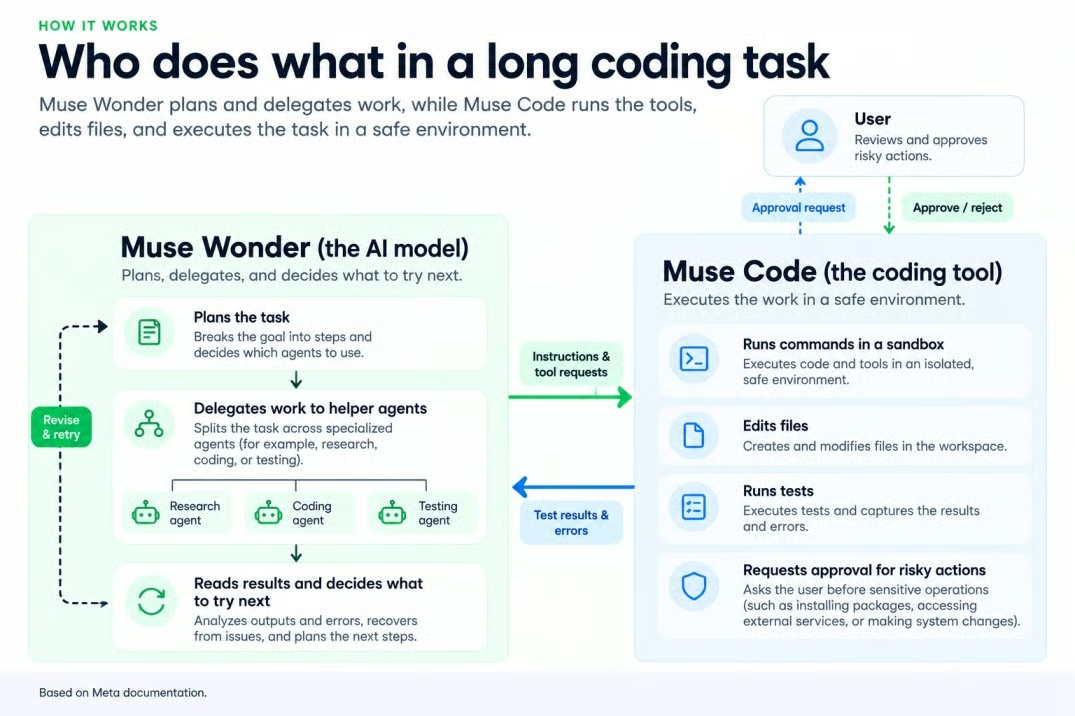
Muse Wonder योजना बनाता है; Muse Code निष्पादित करता है। चित्र: लेखक।
Meta के डेमोज़ में से एक इमेजेज़ से बना एक प्लेएबल 3D किचन गेम है। यह अटपटा चयन है, क्योंकि मॉडल कार्ड में 3D तर्क को ज्ञात कमजोरी बताया गया है (मैं कोई और डेमो चुनता)।
Meta की तालिका लंबे कोडिंग और कुछ प्रोफेशनल बेंचमार्क्स में Muse Wonder Full के पक्ष में है, जबकि Claude Opus 5.5 टर्मिनल कोडिंग और शून्य से प्रोग्राम बनाने में आगे है। नीचे दिए गए आँकड़े Meta के हैं जब तक विशेष रूप से न कहा जाए, और लगभग हर मॉडल अपने उच्चतम रीजनिंग सेटिंग पर है (मैं एकमात्र अपवाद को चिह्नित करूँगा)।
Meta की तालिका में Muse Wonder Full दोनों लंबे कोडिंग परीक्षणों में शीर्ष पर है। जैसा कि मैंने परिचय में बताया, यह DeepSWE v1.1 पर 79.0 स्कोर करता है, जबकि सामान्य Muse Wonder 78.8 पर उसके क़रीब है। ये फिलहाल Meta के ही आँकड़े हैं, क्योंकि Datacurve की सार्वजनिक DeepSWE लीडरबोर्ड पर अभी Muse Wonder सूचीबद्ध नहीं है।
SWE-Marathon वह है जिस पर मेरी नज़र रहेगी, क्योंकि इसकी 20 बहु-घंटे परियोजनाएँ एक भी टेस्ट फेल होने पर शून्य अंक देती हैं। Meta Muse Wonder Full को 57.5 (इसके उच्चतम सेटिंग से एक दर्जा नीचे) और Muse Wonder को 53.1 बताता है, जबकि Claude Opus 5.5 46.3 और GPT-6 Astra 42.5 पर हैं। प्रतिद्वंदी मॉडल अपनी-अपनी कंपनियों के कोडिंग टूल्स के अंदर चले, इसलिए Meta खुद कहता है कि तुलना पूरी तरह निष्पक्ष नहीं है, और केवल 20 परियोजनाओं के साथ, एक परियोजना कई अंकों से स्कोर बदल सकती है।
Abundant AI की अपनी SWE-Marathon लीडरबोर्ड इसे और संयत रखती है: Muse Wonder Full 53.1% और सामान्य Muse Wonder 52.5% पर, दोनों Muse Code में अपनी उच्चतम सेटिंग पर, और Claude Sonnet 5.5 के 51.3% से थोड़ा आगे। Claude Haiku 5.5, जिसे Anthropic ने पाँच दिन पहले जारी किया था, 50.0% पर है। ये दोनों सूचियाँ अलग परीक्षणों से आती हैं, इसलिए इन्हें मिलाएँ नहीं।
ऐप्स के पार काम पूरा करने की Muse Wonder की Meta की दलील को मिला-जुला समर्थन मिलता है। AutomationBench-AA पर, जो जाँचता है कि व्यावसायिक वर्कफ़्लो सही स्थिति में समाप्त होते हैं या नहीं, Muse Wonder Full 45.4 स्कोर करता है, GPT-6 Astra 41.6 और Claude Opus 5.5 41.2 पर, तो यह आगे है, पर फिर भी अधिकांश वर्कफ़्लो विफल होते हैं।
OSWorld V2.1, 108 डेस्कटॉप कार्यों का सेट, और अधिक बताता है। Muse Wonder Full आंशिक क्रेडिट में 78.4 कमाता है लेकिन पूरी तरह केवल 39.4% कार्य पूरे करता है, और दोनों Claude मॉडल इसके आंशिक स्कोर से आगे हैं। बीमा फॉर्म जैसे मामले में, अधिकांश चरण सही होना भी असफल कार्य ही है, इसलिए देखने लायक संख्या 39.4% है।
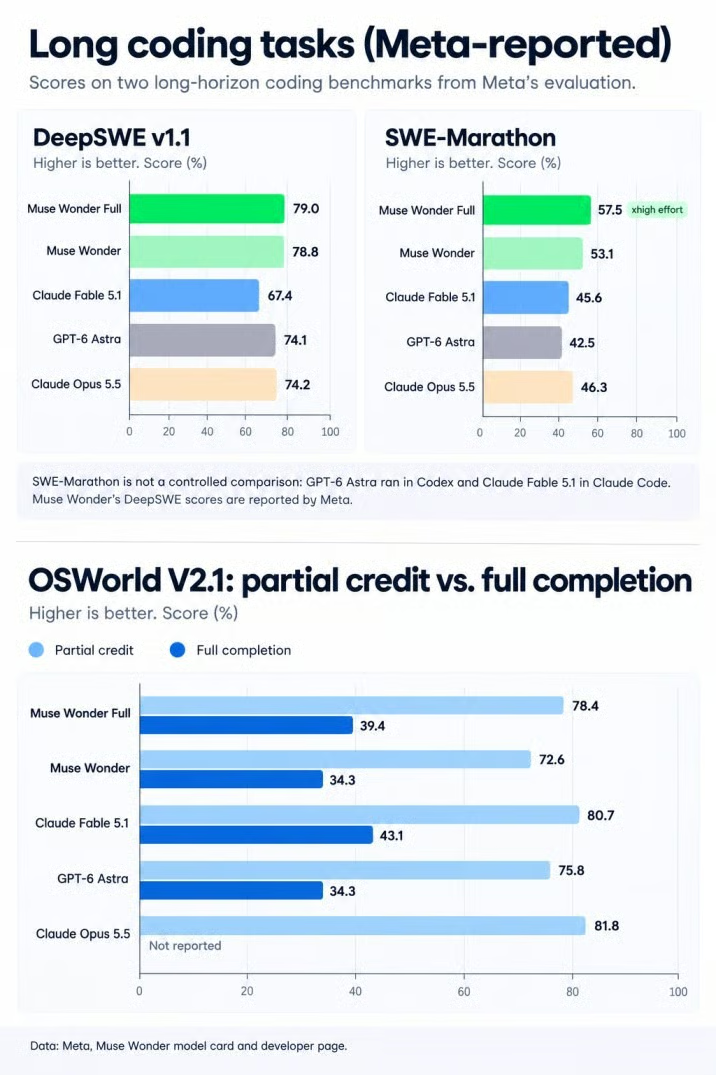
कोडिंग बढ़तें कम पूर्णता दरें छुपाती हैं। स्रोत: Meta; चित्र: लेखक।
कानूनी बेंचमार्क में Muse Wonder Full आगे है और स्वास्थ्य में पीछे, जबकि वित्त में लगभग बराबरी है। इसका कानूनी स्कोर छोटा लगता है, फिर भी Claude Opus 5.5 का तीन गुना है। Artificial Analysis के संस्करण में, कानूनी दस्तावेज़ तभी गिने जाते हैं जब वे हर आवश्यकता पूरी करें और कोई मनगढ़ंत सामग्री न हो, और Muse Wonder Full 13.1 स्कोर करता है जबकि Claude Opus 5.5 4.2 पर है, जो फिर भी लगभग 87% कार्यों के विफल होने का मतलब है।
वित्त में लगभग टाई है: Vals Finance Agent V2 पर Muse Wonder Full 59.1 और Claude Opus 5.5 58.6 पर हैं। स्वास्थ्य उलटा है: HealthBench Pro पर Muse Wonder Full 62.3 स्कोर करता है, जबकि Claude Opus 5.5 (65.6) और GPT-6 Astra (65.3) उससे आगे हैं।
Meta की अपनी तालिका के 14 परीक्षणों में से छह पर Muse Wonder Full, Claude Opus 5.5 से पीछे है, और GPT-6 Astra तीन पर इसे पछाड़ता है। यह तालिका वे हारें समेटती है जो ऊपर कवर नहीं हुईं।
|
Benchmark |
क्या जाँचता है |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
टर्मिनल कोडिंग |
57.1 |
52.0 |
59.1 |
59.6 |
52.0 |
|
ProgramBench |
शून्य से प्रोग्राम बनाना |
59.0 |
50.0 |
52.5 |
70.5 |
55.5 |
|
AA Intelligence Index v4.3 |
विस्तृत समग्र |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
व्यावसायिक टूल उपयोग |
75.3 |
70.5 |
66.1 |
75.4 |
73.1 |
|
GDP.pdf |
PDF से काम करना |
33.2 |
30.8 |
34.2 |
30.6 |
27.6 |
स्रोत: लॉन्च के समय Meta का Muse Wonder डेवलपर पेज। सभी मॉडल अपनी उच्चतम रीजनिंग सेटिंग पर।
ProgramBench वह हार है जिस पर कोडर्स को ध्यान देना चाहिए, और यह क़रीबी नहीं है। यह मॉडलों से शून्य से प्रोग्राम दोबारा बनाने को कहता है, और 11.5 अंकों का अंतर दिखाता है कि मौजूदा कोडबेस एडिट करना और शून्य से बनाना अलग कौशल हैं।
Artificial Analysis Muse Wonder Full को 55.8 पर सूचीबद्ध करता है, जिसे Meta की तालिका 56 तक राउंड करती है, जबकि Claude Sonnet 5.5 56.0 स्कोर करता है।
क्या आप Muse Wonder के बेंचमार्क परिणामों पर भरोसा कर सकते हैं? पूरी तरह नहीं। Meta के मॉडल कार्ड से पता चलता है कि तालिका तीन तरह के साक्ष्यों का मिश्रण है:
जैसा कि मैंने पहले उल्लेख किया, लगभग हर स्कोर उच्चतम रीजनिंग सेटिंग पर है, इसलिए आप प्रत्येक मॉडल को उसके सर्वश्रेष्ठ पर देख रहे हैं। परीक्षक के साथ परिणाम बदलते भी हैं: Anthropic Terminal-Bench 4.0 पर Claude Opus 5.5 के लिए 66.4% रिपोर्ट करता है, जबकि Meta की तालिका में 59.6 है। अनजाने कार्यों पर Muse Wonder Full के Spark मॉडलों से बेहतर होने का Meta का दावा उसके अपने विश्लेषण पर टिका है।
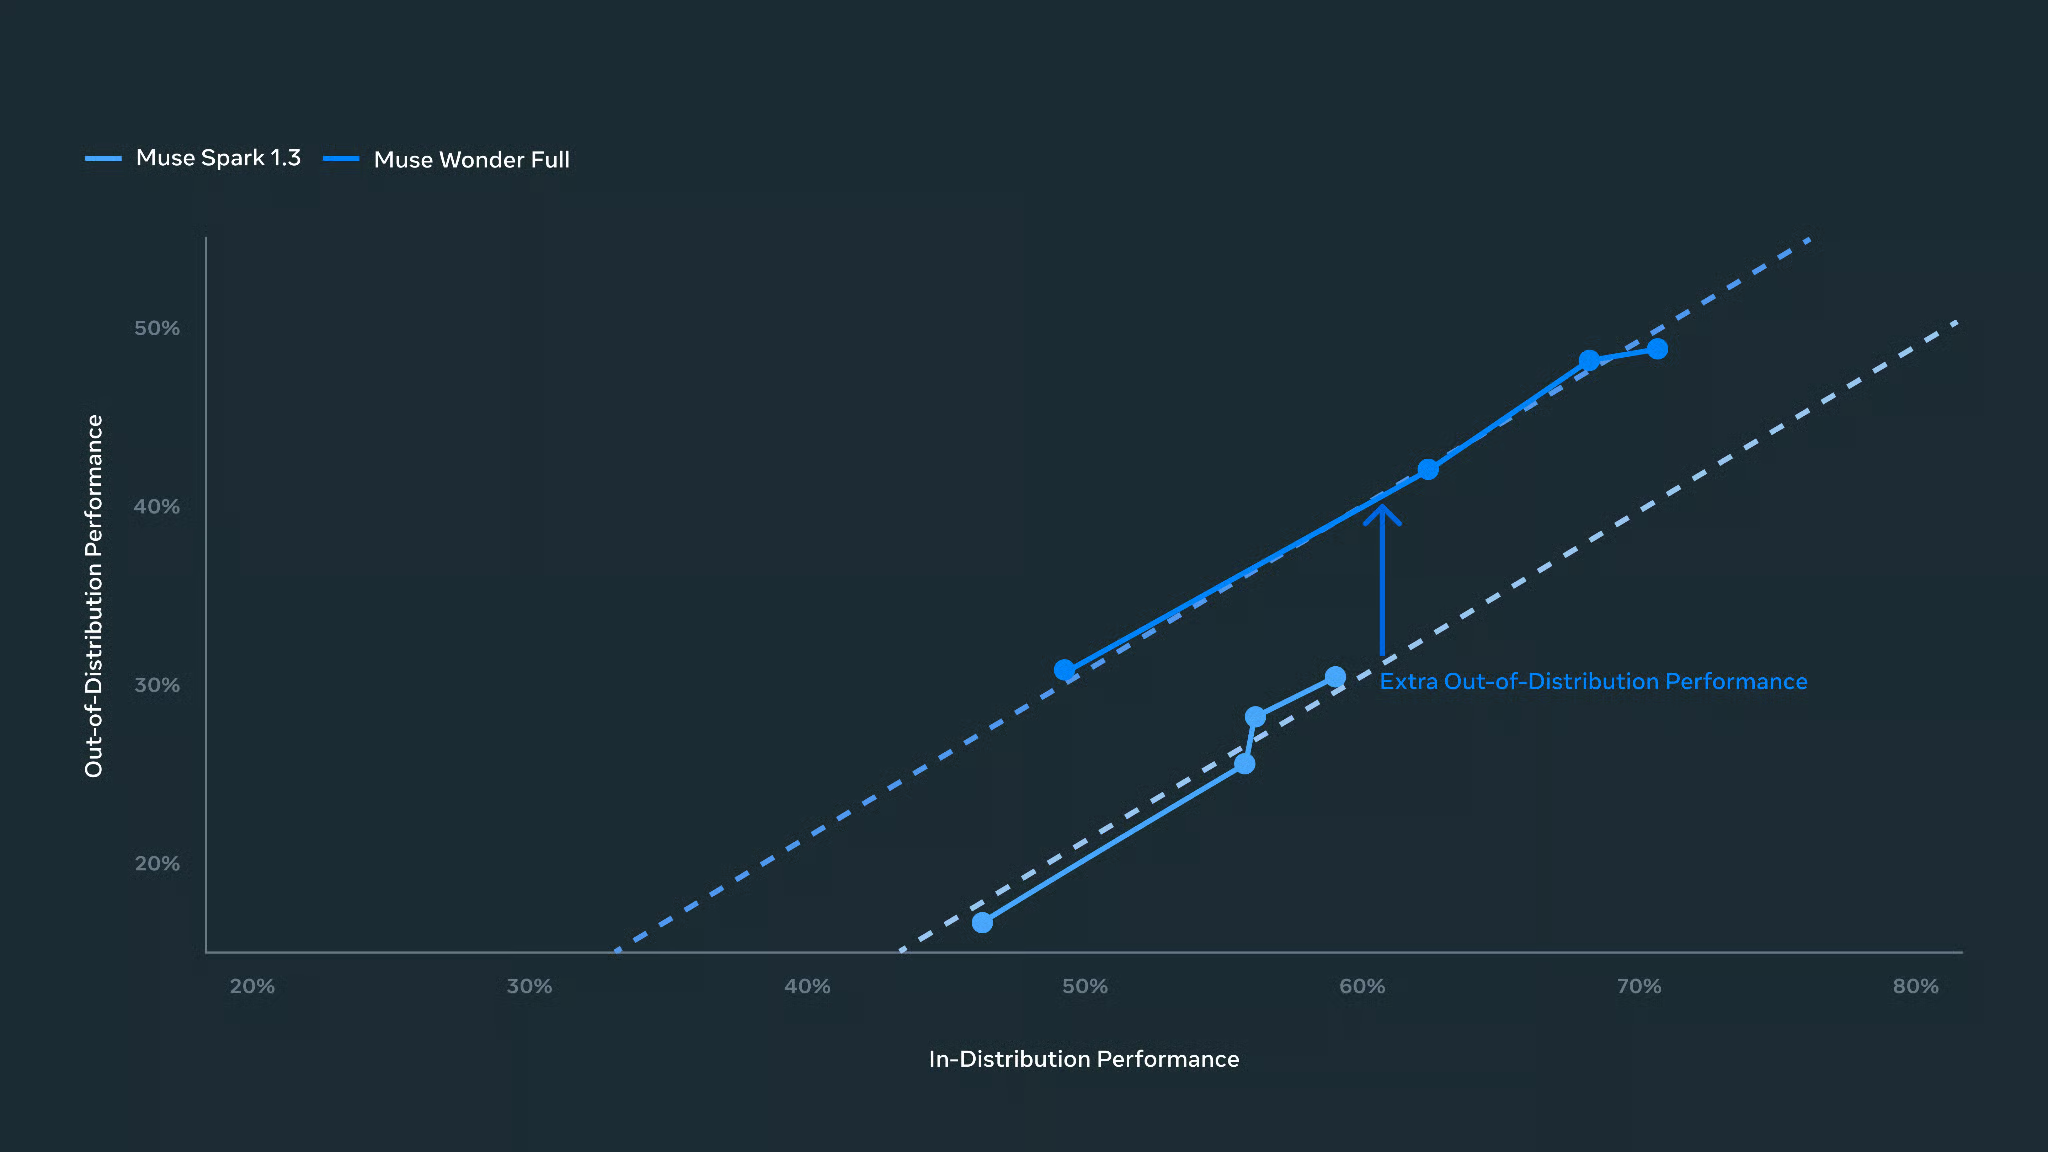
Meta अपरिचित कार्यों पर प्रदर्शन की तुलना करता है। स्रोत: Meta.
Meta के आँकड़ों के अनुसार, Muse Wonder Full लंबे कोडिंग कार्यों में जीतता है (पर केवल Muse Code के अंदर), Claude Opus 5.5 टर्मिनल कार्य और शून्य से बनावट में जीतता है, और GPT-6 Astra Meta की तालिका में केवल एक पंक्ति में शीर्ष पर है। यह हिस्सा बेंचमार्क्स को समेटता है, इसलिए यह परिचित लगेगा।
स्वचालन बँटा हुआ है, क्योंकि AutomationBench-AA पर Muse Wonder Full आगे है जबकि OSWorld आंशिक क्रेडिट पर Claude मॉडल आगे हैं। जिन मॉडलों के पास पूर्ण-समाप्ति स्कोर रिपोर्ट किया गया है, उनमें से कोई भी अधिकांश कार्य पूरे नहीं करता। व्यापक तर्क पर, Artificial Analysis इंडेक्स में Claude Opus 5.5 आगे है, जहाँ सामान्य Muse Wonder 52.4 स्कोर करता है।
कीमत वह जगह है जहाँ सामान्य Muse Wonder कमजोर दिखता है। GPT-6.1 Sol प्रति टोकन आधी कीमत पर आता है और उसी इंडेक्स पर 51.8 स्कोर करता है, और Claude Sonnet 5.5 की कीमत GPT-6.1 Sol के बराबर है।
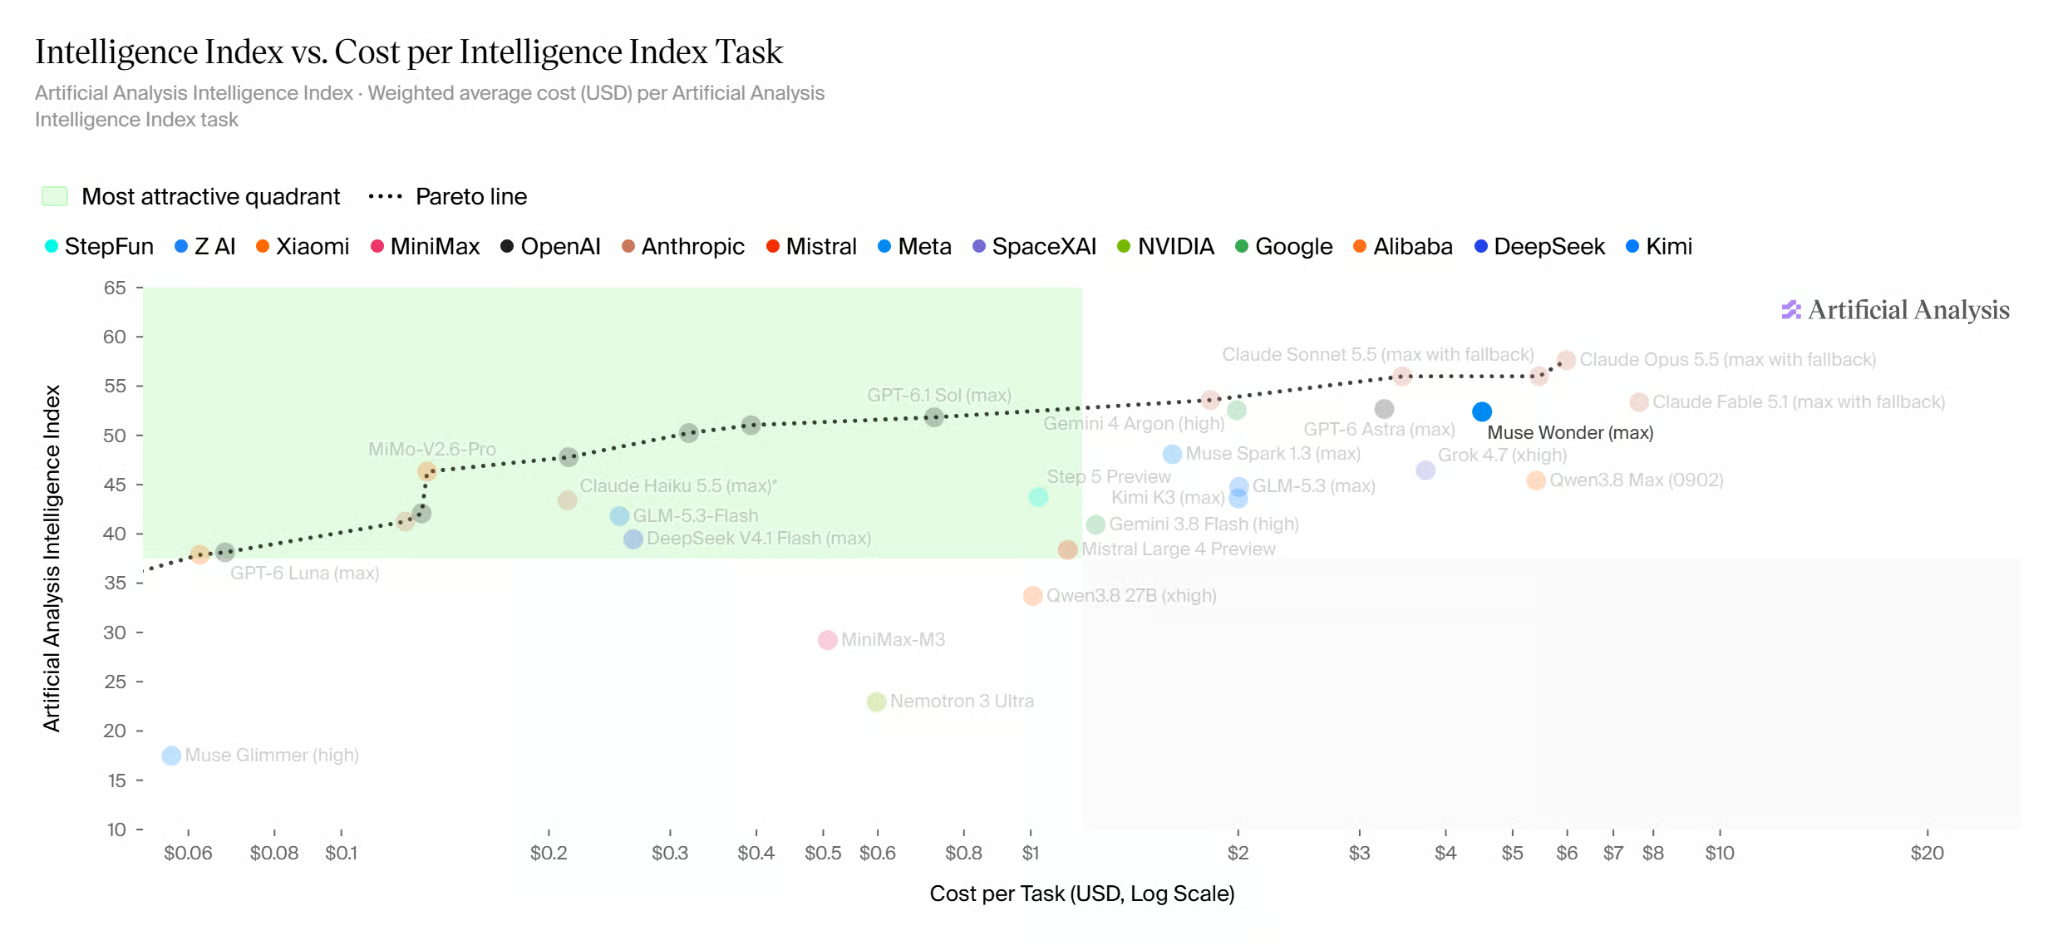
Muse Wonder लागत और इंटेलिजेंस के बीच संतुलन करता है। स्रोत: Artificial Analysis.
मैं लगभग Gemini 4 Argon को इस खंड से बाहर रखता, क्योंकि Meta ने इसका परीक्षण नहीं किया, और जैसा कि हमारी Gemini 4 Argon कवरेज नोट करती है, यह पहले भरोसेमंद साइबरसुरक्षा टीमों के पास गया। साझा परिणामों के बिना निष्पक्ष आमने-सामने तुलना संभव नहीं, इसलिए काम के बोझ और कार्य पूरा करने की लागत के आधार पर चुनें।
Muse Wonder दो तरह के कामों के लिए सबसे उपयुक्त है: बड़े सॉफ़्टवेयर परिवर्तन और बहु-चरणीय ब्राउज़र वर्कफ़्लो। लंबी योजना वाले कार्य, जैसे Meta का वेडिंग सीटिंग चार्ट डेमो, मॉडल के आसपास के ऐप पर अधिक निर्भर करते हैं।
यह उपयोग-कौशल सबसे अधिक सशक्त साक्ष्य वाला है, कम से कम मौजूदा कोड बदलने के लिए। Muse Code में, Muse Wonder फाइलों के पार काम करता है, टेस्ट चलाता है, विफलताएँ पढ़ता है और फिर से प्रयास करता है, जिसे DeepSWE और SWE-Marathon मापते हैं। असली कोड पर, उसे केवल उतनी ही अनुमतियाँ दें जितनी कार्य को चाहिए, और बदलाओं की मानव समीक्षा करवाएँ।
Meta का Saturday Run Planning डेमो दिखाता है कि Muse Wonder "सीधे ब्राउज़र में और ऐप्स के पार काम करता है," और एक अन्य डेमो बीमा दावा संभालता है। चूँकि Muse Wonder Full 10 में से 4 से कम डेस्कटॉप कार्य पूरी तरह पूरा करता है, किसी वास्तविक वर्कफ़्लो में कुछ भी सबमिट या भुगतान होने से पहले आपकी स्वीकृति आवश्यक है।
आप Muse Wonder के लिए दो तरीकों से भुगतान करते हैं: सामान्य Muse Wonder के लिए प्रति टोकन, या एक निश्चित मासिक Muse Code योजना, जो, जैसा कि मैंने परिचय में बताया, Muse Wonder Full पाने का एकमात्र तरीका है।
Meta का प्राइसिंग पेज सामान्य Muse Wonder को प्रति मिलियन इनपुट टोकन $4.00, कैश्ड इनपुट $0.20, और आउटपुट $20.00 पर सूचीबद्ध करता है। यह Muse Spark 1.3 के $1.25 और $4.25 से बड़ा उछाल है, और Claude Opus 5.5 की कीमतों से मेल खाती है, जो बताता है कि Meta Muse Wonder को कहाँ रखता है।
GPT-6 Astra $10, $1 कैश्ड, और $50 पर सूचीबद्ध है, और GPT-6.1 Sol $2, $0.10, और $10 पर। नीचे दिया काल्पनिक उदाहरण लॉन्च-दिवस कीमतों को एक कोडिंग कार्य पर लागू करता है जिसमें 3 मिलियन इनपुट टोकन (2.4 मिलियन कैश्ड) और 200,000 आउटपुट टोकन हैं, मानते हुए कि कोई भी एकल अनुरोध 272,000 टोकन से आगे नहीं जाता, जहाँ GPT-6 Astra की कीमतें बढ़ती हैं।
|
Model |
Uncached input (0.6M) |
Cached input (2.4M) |
Output (0.2M) |
Total per task |
|
Muse Wonder |
$2.40 |
$0.48 |
$4.00 |
$6.88 |
|
Claude Opus 5.5 |
$2.40 |
$0.48 |
$4.00 |
$6.88 |
|
GPT-6 Astra |
$6.00 |
$2.40 |
$10.00 |
$18.40 |
|
GPT-6.1 Sol |
$1.20 |
$0.24 |
$2.00 |
$3.44 |
बराबर टोकन कीमतें बराबर बिल प्रति प्रयास देती हैं, इसलिए तुलना करने लायक संख्या प्रति पूर्ण-कार्य लागत है। अगर Muse Wonder दो में एक बार कार्य पूरा करता है, तो वह $13.76 है, जो GPT-6.1 Sol की कीमतों वाले मॉडल के चार में एक बार कार्य पूरा करने के बराबर है (दोनों दरें उदाहरण के लिए गढ़ी गई हैं)।
Muse Wonder Full केवल Muse Code की मासिक योजनाओं के साथ आता है, जो प्रति टोकन की जगह एक निश्चित दर लेती हैं। यदि आप केवल API का उपयोग करने की योजना बना रहे हैं, तो आप इस हिस्से को छोड़ सकते हैं। Meta के सब्सक्रिप्शन दस्तावेज़ चार योजनाएँ सूचीबद्ध करते हैं:
Meta का Muse Code प्रोडक्ट पेज केवल Power और Maximum की कीमतें दिखाता है, जो छोड़ने के लिए अजीब है, इसलिए निचली योजनाएँ चेकआउट पर देखें। सामान्य Muse Wonder हर योजना में है।
हर योजना में उपयोग सीमा होती है जो समय के साथ रीसेट होती है। अप्रयुक्त भत्ता आगे नहीं बढ़ता, और सब्सक्रिप्शन को API क्रेडिट के रूप में उपयोग नहीं किया जा सकता।
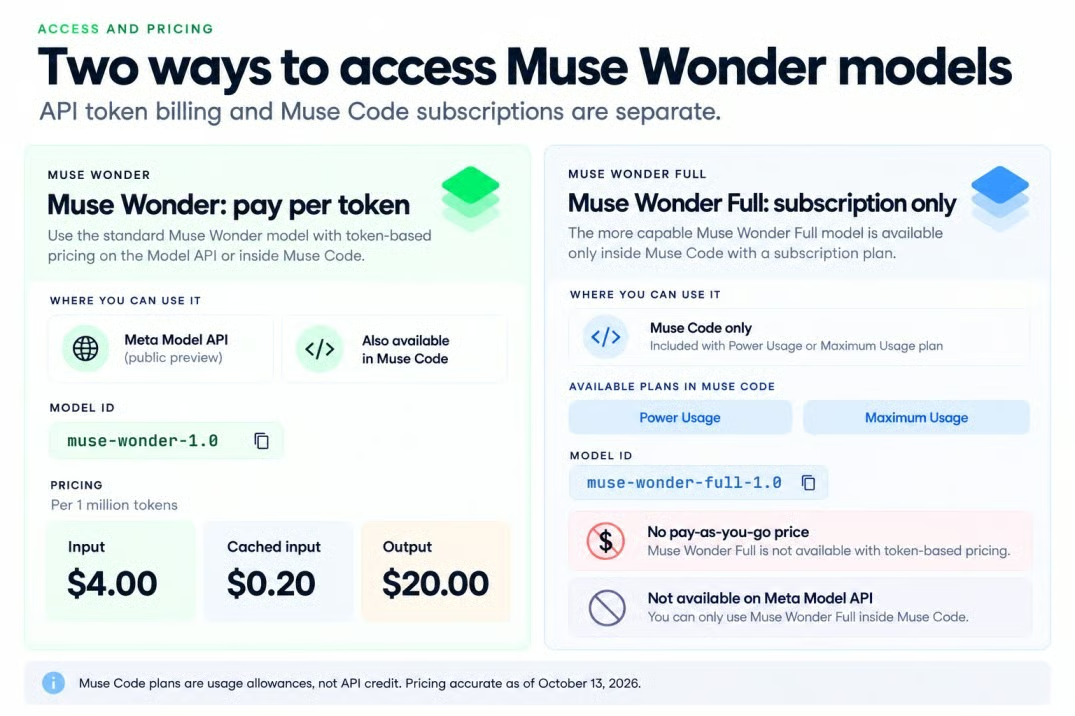
Muse Wonder की कीमत दो रास्तों का अनुसरण करती है। स्रोत: Meta; चित्र: लेखक।
Power, Muse Wonder Full आज़माने का सबसे सस्ता तरीका है, हालांकि Meta ने नहीं बताया कि इसका भत्ता कितने बड़े कार्यों को कवर करता है। इस पर नज़र रखूँगा, क्योंकि एक शुरुआती उपयोगकर्ता ने कहा कि कुछ छोटे अनुरोधों ने एंट्री प्लान की 5-घंटे सीमा का लगभग आधा उपयोग कर लिया, जिसका ज़िक्र मैं डेवलपर प्रतिक्रियाओं में करूँगा।
परिचय की विभाजन-रेखा दोहराते हुए: सामान्य Muse Wonder Meta Model API और Muse Code के जरिए उपलब्ध है, और Muse Wonder Full केवल Muse Code के जरिए।
Muse Wonder API उपयोग करने के लिए आपको Meta डेवलपर खाता, API कुंजी और बिलिंग चाहिए, और मॉडल ID है muse-wonder-1.0। Meta अपने प्रोडक्ट पेज पर अभी भी API को "public preview" कहता है, OpenAI के SDK पर बना कोड इसमें पॉइंट किया जा सकता है, और Meta OpenRouter को भी मार्ग के रूप में सूचीबद्ध करता है।
एक्सेस वैश्विक नहीं है। Meta की भौगोलिक उपयोग नीति कई स्थानों को अवरुद्ध करती है, जिनमें चीन, रूस, ईरान, पाकिस्तान, इरीट्रिया और इथियोपिया शामिल हैं।
Muse Wonder Full पाने के लिए आपको Power या Maximum Muse Code प्लान, एक Meta खाता, और 18 वर्ष या जहाँ आप रहते हैं वहाँ की वयस्कता की आयु की आवश्यकता है। जैसा कि मैंने प्राइसिंग खंड में कवर किया, यह Model API पर किसी भी कीमत पर उपलब्ध नहीं है, और इसका ID, muse-wonder-full-1.0, केवल Muse Code के अंदर काम करता है। Muse Code के दस्तावेज़ macOS, Linux, और Windows सूचीबद्ध करते हैं, हालांकि इसके प्रोडक्ट पेज पर केवल macOS और Windows का उल्लेख है।
यहाँ जोखिम उन्हीं बातों से आते हैं जिन्हें Meta प्रस्तुत कर रहा है: लंबे रन और आपकी निजी फाइलों तक पहुँच।
मॉडल कार्ड तीन कमजोरियाँ बताता है जो एजेंट को प्रभावित कर सकती हैं। प्रत्येक अलग समस्या पैदा करती है:
जब मॉडल टूल्स का उपयोग कर सकता है, तो ये पृथक उत्तर-गुणवत्ता समस्याएँ नहीं हैं। दो घंटे के कार्य में शुरू की गई गलत क्लिक या गलत मान्यता बाकी सब बिगाड़ सकती है।
यह मोड पर निर्भर करता है, इसलिए Muse Code को किसी निजी रिपॉज़िटरी की ओर इंगित करने से पहले इसे पढ़ें। Meta की सेवा की शर्तें, जो लॉन्च से तीन दिन पहले अपडेट हुईं, कहती हैं कि Meta अपनी Standard Services को भेजी गई सामग्री पर प्रशिक्षण नहीं करेगा, जबकि Contributor मोड में भेजी गई सामग्री का उपयोग उसके मॉडलों को "प्रशिक्षित, विकसित, मूल्यांकन और सुधार" करने के लिए किया जा सकता है।
Muse Code सब्सक्रिप्शन Contributor मोड में शुरू होते हैं, बदले में अधिक उपयोग के साथ, और आपको सेटिंग्स में Standard पर स्विच करना होता है। स्विच आगे लागू होता है, इसलिए जो कुछ आप पहले ही भेज चुके हैं, वह प्रशिक्षण में अभी भी उपयोग हो सकता है। मुझे यह डिफ़ॉल्ट पसंद नहीं आता।
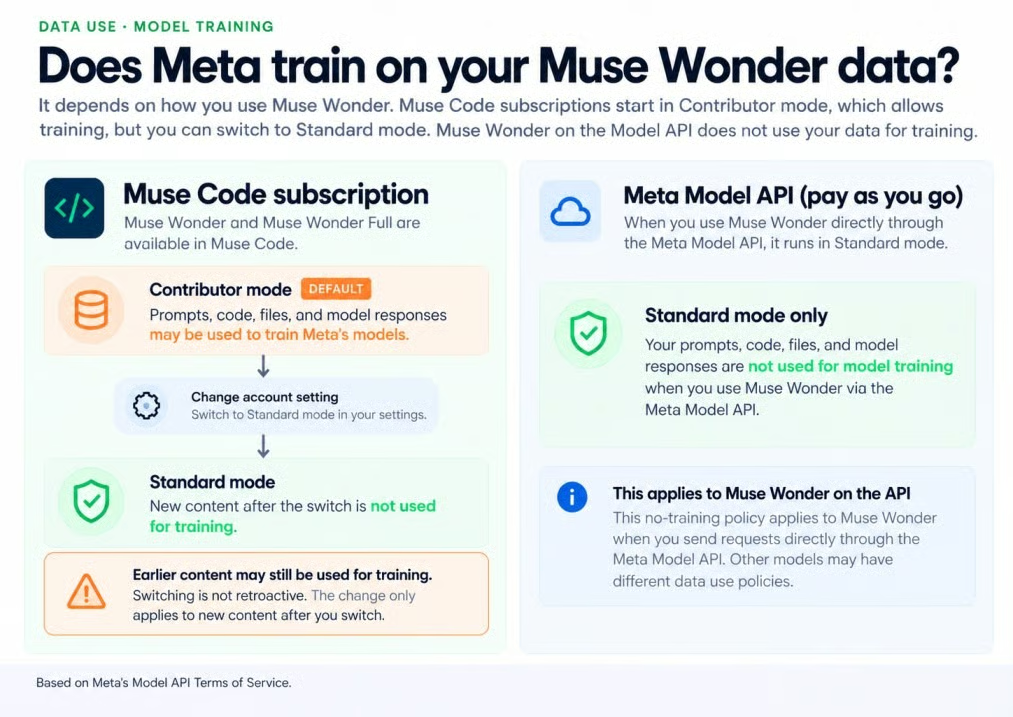
Contributor सामग्री Meta मॉडलों को प्रशिक्षित कर सकती है। स्रोत: Meta Terms; चित्र: लेखक।
शर्तें यह भी कहती हैं कि आप Contributor मोड में "संवेदनशील, गोपनीय, या व्यक्तिगत जानकारी" प्रस्तुत नहीं कर सकते, जिसमें निजी कोड शामिल है। पे-एज़-यू-गो API पर सामान्य Muse Wonder केवल Standard मोड में चलता है।
Meta ने Muse Wonder Full का परीक्षण अपने Superintelligence Scaling Framework के तहत किया। सुरक्षा उपायों के बिना, Meta इसे रासायनिक और जैविक खतरों के लिए उच्च-जोखिम स्तर तक पहुँचने से खारिज नहीं करता, और सुरक्षा उपायों के साथ यह हर जोखिम क्षेत्र को "मध्यम या कम" आंकेगा।
जोखिम रेटिंग सुरक्षा की गारंटी नहीं है, और एक विस्तृत सुरक्षा रिपोर्ट अभी भी "जल्द" आने वाली है। मॉडल कार्ड की सलाह सरल है: ऐसी कार्रवाइयों के लिए मानवीय पुष्टि आवश्यक करें जिन्हें आप पूर्ववत नहीं कर सकते, और एजेंट को सीमित अनुमतियों वाले सैंडबॉक्स में रखें।
लॉन्च-दिवस की X पर प्रतिक्रियाएँ तेज़ प्रगति, असमान प्रदर्शन, और उपयोग सीमा से हताशा के बीच बंटी रहीं। ये संक्षिप्त परीक्षण और निजी धारणाएँ हैं, नियंत्रित मूल्यांकन नहीं।
सावधान सकारात्मक दृष्टिकोण एक शुरुआती परीक्षक से आया जिसे Muse Wonder के साथ सीमित समय मिला, लेकिन उसे यह अच्छा लगा। बड़ा बिंदु यह था कि अप्रैल में Muse Spark के बाद Meta के मॉडल कितनी दूरी तय कर चुके थे।
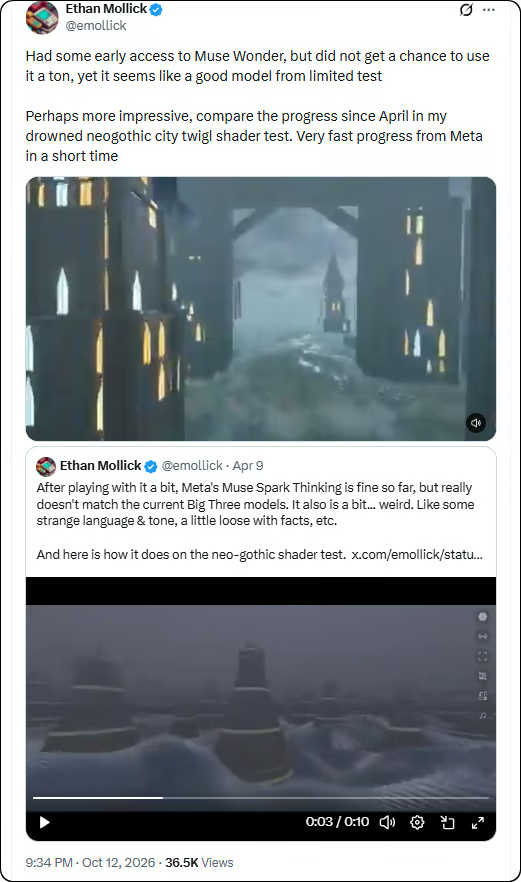
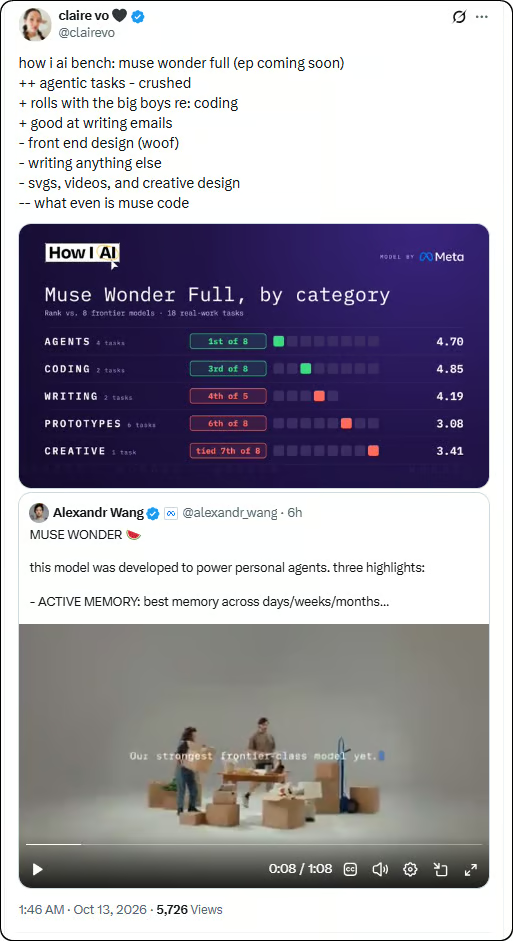
एक व्यापक श्रेणी परीक्षण ने कम सुथरी कहानी बताई। एजेंट्स और कोडिंग में Muse Wonder Full शीर्ष के क़रीब रहा, पर लेखन, फ्रंट-एंड डिज़ाइन और रचनात्मक कार्य में पीछे रह गया।
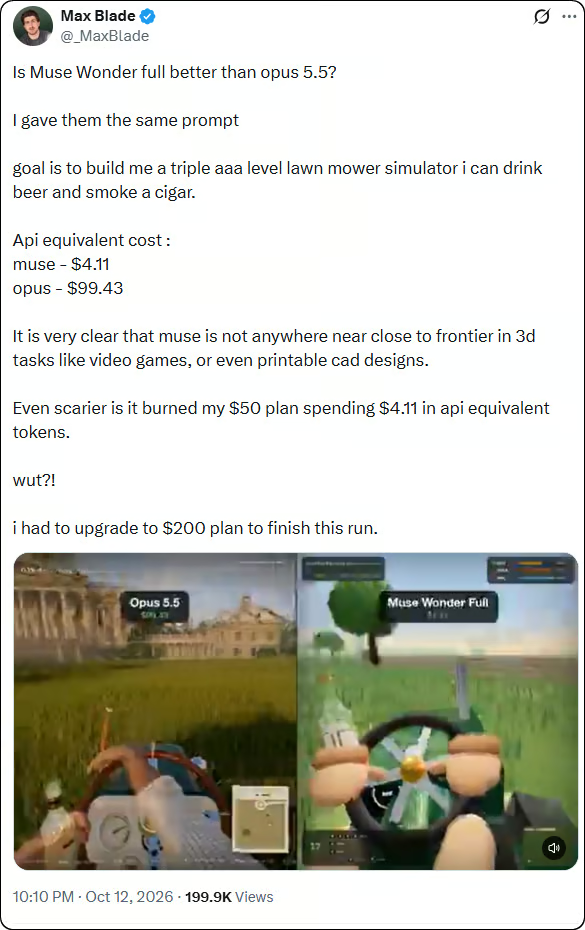
सबसे तीखी शिकायत लागत और प्लान सीमाओं पर थी। एक समान-प्रॉम्प्ट लॉन मॉवर परीक्षण में, Muse Wonder Full ने API-समकक्ष टोकन में लगभग $4.11 उपयोग किए पर Claude Opus 5.5 से कमजोर 3D परिणाम दिया, और परीक्षक ने कहा कि कार्य पूरा करने के लिए $50 प्लान से $200 प्लान में अपग्रेड करना पड़ा।
कुल मिलाकर, पोस्ट्स से संकेत मिलता है कि Muse Wonder प्रतिस्पर्धी है पर असमान। किसी एक परिणाम को सामान्य मानने से पहले और दोहराए गए परीक्षणों की ज़रूरत है।
लॉन्च के अधिकांश साक्ष्य अभी भी Meta से आते हैं। Muse Wonder Full के लिए पे-एज़-यू-गो API नहीं है, और सामान्य Muse Wonder, Claude Opus 5.5 जितना महँगा है, जबकि कई परीक्षणों में उससे पीछे है।
मैं API एजेंट्स के लिए सामान्य Muse Wonder और लंबे रिपॉज़िटरी कार्य के लिए Muse Wonder Full का परीक्षण करूँगा। टर्मिनल कार्य या शून्य से प्रोग्राम बनाने के लिए मैं Claude Opus 5.5 रखूँगा, और जब लागत निर्णायक हो तो GPT-6.1 Sol या Claude Sonnet 5.5 का उपयोग करूँगा।
DataCamp के साथ सीखें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}