{count, plural, one {Cursus} other {Cursussen}}
Concepten van Large Language Models (LLMs)
{hours} uur
112.2K
Deze week bracht Meta Muse Wonder en Muse Wonder Full uit, de eerste grote modelfamilie sinds Muse Spark. Beide zijn gebouwd voor AI-agents die meerstapsopdrachten afhandelen.
Meta's lanceringspost noemt Muse Wonder het resultaat van 14 maanden herbouw van zijn AI-inspanningen. De twee nieuwe termen om te kennen zijn Active Memory, dat nuttige details uit eerdere gesprekken ophaalt, en Active Focus, dat blijft doorwerken wanneer een taak vastloopt.
De reguliere Muse Wonder is beschikbaar via de Meta Model API en Muse Code, terwijl Muse Wonder Full, het model achter de meeste headline-resultaten, alleen draait in Muse Code op de twee duurste abonnementen. Daar komen we zo op terug.
Dit is wat ik meeneem uit de lancering:
Muse Wonder en Muse Wonder Full zijn redeneermodellen die Meta zijn meest capabele tot nu toe noemt, gebouwd voor agents die persoonlijke en werktaken afhandelen. De modelkaart noemt tekst-, beeld-, video- en audio-input en alleen tekstoutput, dus geen van beide modellen genereert afbeeldingen, video of audio. Meta's ontwikkelaarsdocs voegen PDF-input toe en zetten het contextvenster op 1.048.576 tokens.
Meta's researchblog zegt dat beide voortbouwen op het trainingswerk van Muse Spark en zijn getraind in Meta's Prometheus-datacenter. Er zijn geen parameteraantallen.
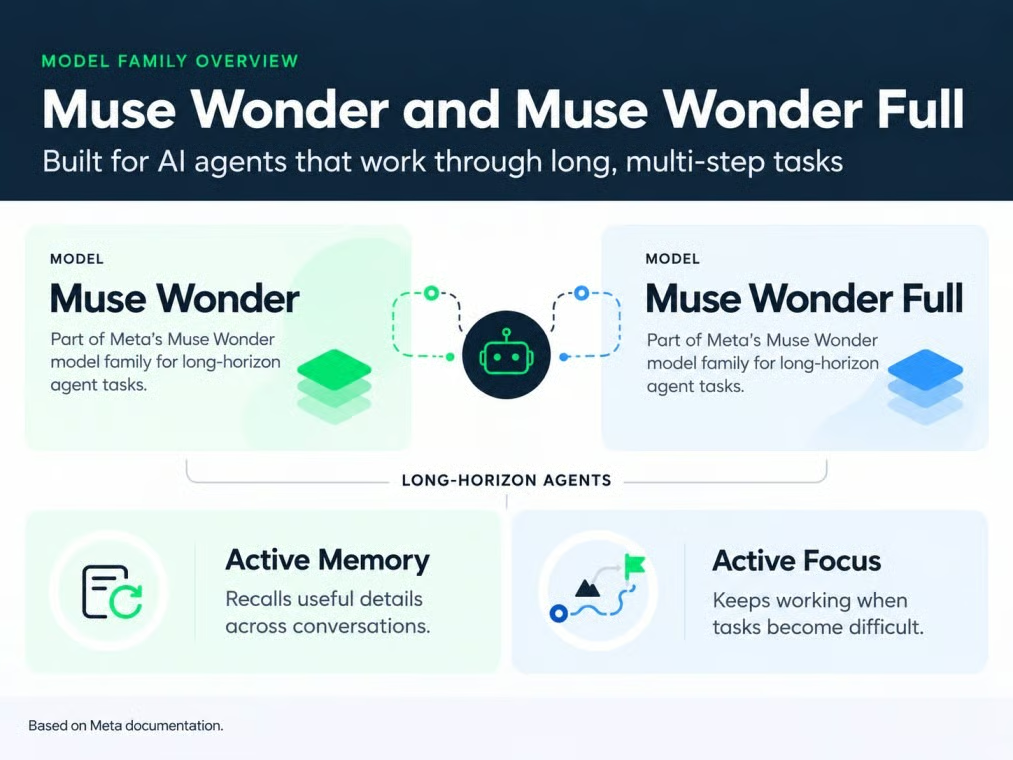
Muse Wonder komt in twee varianten. Afbeelding door auteur.
Van de twee is Muse Wonder Full een apart, krachtiger model. De ontwikkelaarsdocs zeggen dat het opschroeven van de reguliere Muse Wonder (muse-wonder-1.0) naar "max" redeneren hem niet omschakelt naar Muse Wonder Full (muse-wonder-full-1.0).
Je hebt misschien gemerkt dat Meta de naam Muse voor meerdere dingen gebruikt. Samengevat:
Als Meta zegt dat Muse Wonder iets "doet", neemt Muse Code vaak de helft van het werk op zich. Dat geldt voor de meeste coderesultaten hieronder.
De kernfeatures van Muse Wonder zijn Active Memory en Active Focus, en lange codeerklussen zijn waar Meta ze laat zien. Het idee achter beide is simpel: een agent moet de juiste details onthouden en doorgaan wanneer een plan faalt.
Active Memory is Meta's term voor het meenemen van belangrijke details tussen gesprekken en het naar boven halen van wat nu nodig is. Stel: je zet in maart een thuiskantoorbudget van $3.000, verhoogt dat in april naar $4.000 en vraagt in mei om een shortlist met meubels. Goede geheugenfunctie betekent dat de agent het aprilbedrag gebruikt zonder herinnering.
Meta's bewijs is MemoryBench, hun eigen test van lange gesprekken waarin feiten worden bijgewerkt. Muse Wonder scoort daarop 85,6, maar dat zegt niets over terughaal over maanden, en een app die op de API is gebouwd, moet die feiten nog steeds zelf opslaan. Dit is de feature waar ik het meest benieuwd naar ben, want een agent die met een oud budget werkt kan je geld kosten.
Active Focus is Meta's naam voor volharding: een andere aanpak proberen, blokkades wegwerken en even checken vóór belangrijke acties. Denk aan een codemigratie waarbij 30 tests falen. Een gefocuste agent past zijn code aan en draait de tests opnieuw, waar een zwakkere gewoon de tests wijzigt zodat ze slagen.
Meta meet dit met FocusBench, opnieuw een eigen test, en met SWE-Marathon, waar ik in de benchmarksectie op terugkom. Geen van beide garandeert een afgeronde taak, en op de achtergrond doorwerken hangt af van de software rondom het model, een risico dat onze OpenAI Dots-uitleg behandelt voor always-on agents.
Muse Wonder plant lange codeerklussen en splitst het werk over helperagents, terwijl Muse Code de tools en goedkeuringen uitvoert. Meta's ontwikkelaarspagina positioneert het voor taken die "urenlang draaien", met veel bestanden die tegelijk worden bewerkt.
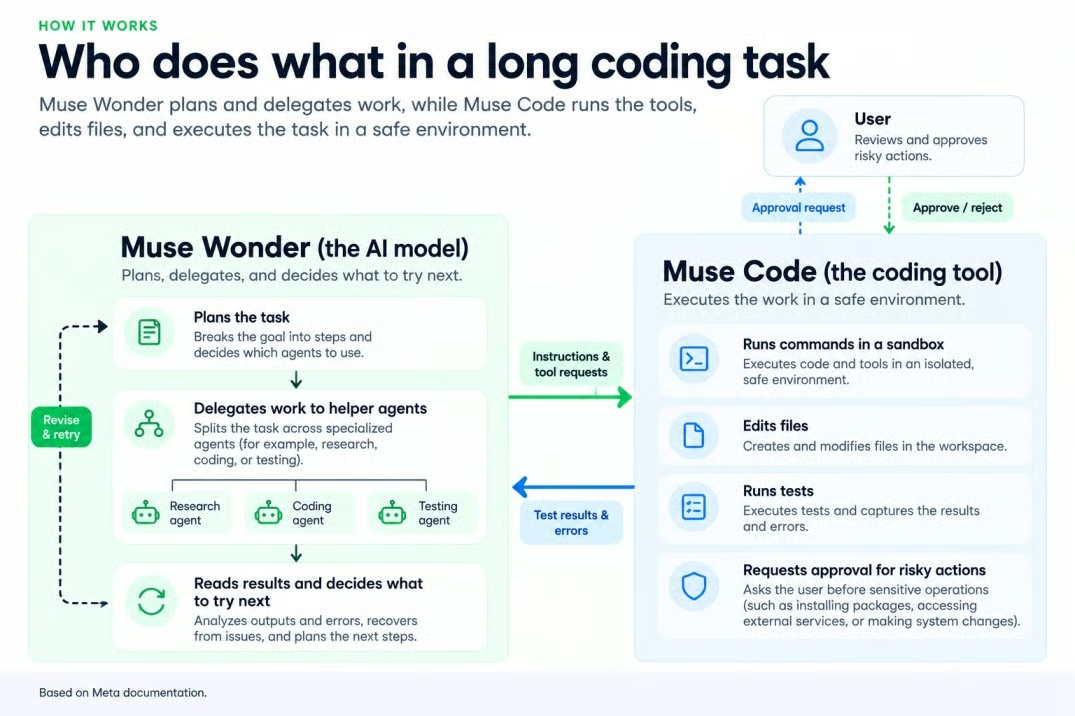
Muse Wonder plant; Muse Code voert uit. Afbeelding door auteur.
Een van Meta's demo's is een speelbare 3D-keukengame gebouwd uit afbeeldingen. Een vreemde keuze, aangezien de modelkaart 3D-redeneren als bekende zwakte vermeldt (ik had een andere demo gekozen).
Meta's tabel is gunstig voor Muse Wonder Full bij lange codeerklussen en enkele professionele benchmarks, terwijl Claude Opus 5.5 vooroploopt bij terminal-coding en het vanaf nul bouwen van programma's. De cijfers hieronder zijn van Meta tenzij anders vermeld, met bijna elk model op de hoogste redeneerstand (ik vlag de ene uitzondering).
Muse Wonder Full staat bovenaan beide lange codetests in Meta's tabel. Zoals ik in de intro noemde, scoort het 79,0 op DeepSWE v1.1, met de reguliere Muse Wonder kort daarachter op 78,8. Dat zijn voorlopig Meta's cijfers, want Datacurve's openbare DeepSWE-ranglijst vermeldt Muse Wonder nog niet.
SWE-Marathon is degene die ik in de gaten zou houden, omdat de 20 meeruurprojecten nul scoren als één enkele test faalt. Meta meldt Muse Wonder Full op 57,5 (één stand onder de hoogste) en Muse Wonder op 53,1, tegenover 46,3 voor Claude Opus 5.5 en 42,5 voor GPT-6 Astra. Rivaliserende modellen draaiden binnen hun eigen bedrijfs-codetools, dus Meta zelf zegt dat de vergelijking niet helemaal eerlijk is, en met slechts 20 projecten kan één project een score met meerdere punten doen verschuiven.
Abundant AI's eigen SWE-Marathon-ranglijst zet het bescheidener neer: Muse Wonder Full op 53,1% en de reguliere Muse Wonder op 52,5%, beide op de hoogste stand in Muse Code, net voor Claude Sonnet 5.5 op 51,3%. Claude Haiku 5.5, dat Anthropic vijf dagen eerder uitbracht, staat op 50,0%. De twee lijsten komen uit afzonderlijke tests, dus meng ze niet.
Meta's claim dat Muse Wonder werk over apps heen kan uitvoeren krijgt gemengde steun. Op AutomationBench-AA, dat checkt of zakelijke workflows in de juiste eindtoestand belanden, scoort Muse Wonder Full 45,4 tegenover 41,6 voor GPT-6 Astra en 41,2 voor Claude Opus 5.5, dus het leidt terwijl het nog steeds in de meeste workflows faalt.
OSWorld V2.1, een set van 108 bureaubladtaken, vertelt je meer. Muse Wonder Full haalt 78,4 in gedeeltelijke credits maar rondt slechts 39,4% van de taken volledig af, en beide Claude-modellen verslaan zijn partial-score. Voor een verzekeringsformulier is de meeste stappen goed nog steeds een mislukte taak, dus 39,4% is het getal om naar te kijken.
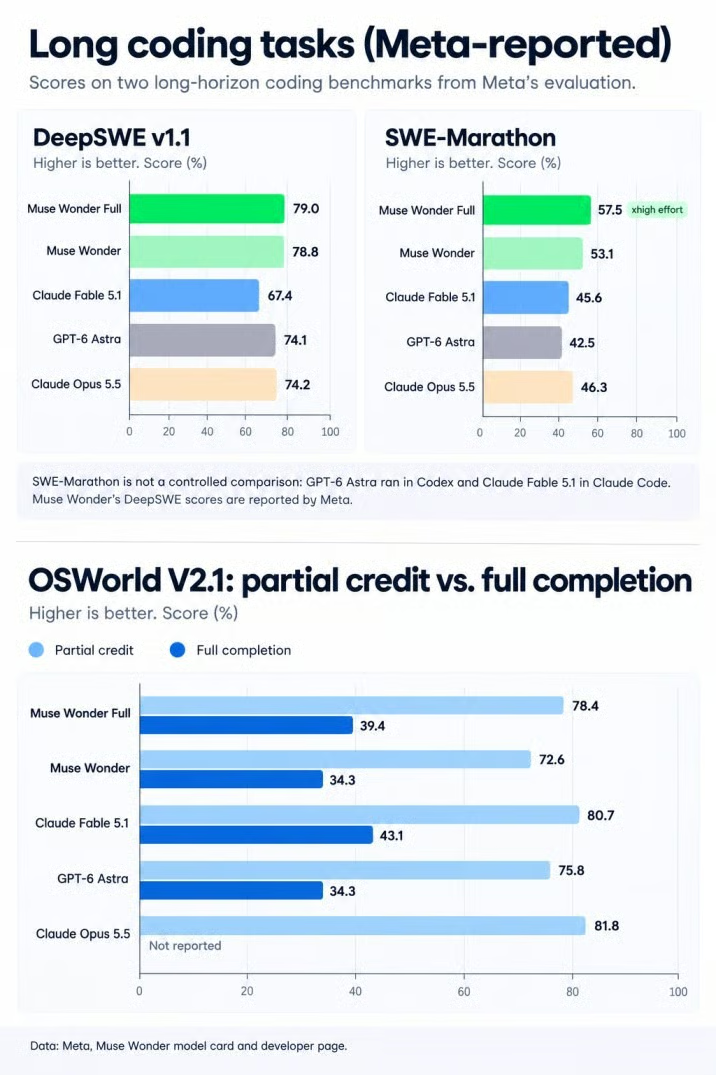
Voorsprongen in coderen verbergen lagere voltooiingspercentages. Bron: Meta; afbeelding door auteur.
Muse Wonder Full leidt de juridische benchmark en loopt achter bij gezondheid, met financiën bijna gelijk. De juridische score klinkt klein, en is nog steeds drie keer die van Claude Opus 5.5. In de versie van Artificial Analysis telt een juridisch document alleen als het aan alle eisen voldoet zonder verzonnen inhoud, en scoort Muse Wonder Full 13,1 tegenover 4,2 voor Claude Opus 5.5, wat nog steeds betekent dat ongeveer 87% van de taken faalt.
Financiën is een bijna gelijkspel, met Muse Wonder Full op 59,1 op Vals Finance Agent V2 tegenover 58,6 voor Claude Opus 5.5. Gezondheid gaat de andere kant op: Muse Wonder Full scoort 62,3 op HealthBench Pro, achter Claude Opus 5.5 (65,6) en GPT-6 Astra (65,3).
Muse Wonder Full loopt achter op Claude Opus 5.5 op zes van de 14 tests in Meta's eigen tabel, en GPT-6 Astra verslaat het op drie. Deze tabel bundelt de nederlagen die hierboven niet zijn behandeld.
|
Benchmark |
Wat wordt getest |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Terminal-coding |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Programma's vanaf nul bouwen |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Brede samengestelde score |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Professioneel gebruik van tools |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Werken met PDF's |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Bron: Meta's Muse Wonder-ontwikkelaarspagina bij lancering. Alle modellen op hun hoogste redeneerstand.
ProgramBench is het verlies waar codeerders zich zorgen over moeten maken, en het is niet nipt. Het vraagt modellen om een programma vanaf nul te herbouwen, en een kloof van 11,5 punten laat zien dat een bestaande codebase bewerken en iets vanuit niets opbouwen verschillende vaardigheden zijn.
Artificial Analysis noteert Muse Wonder Full op 55,8, wat Meta's tabel afrondt naar 56, terwijl Claude Sonnet 5.5 56,0 scoort.
Kun je de benchmarkresultaten van Muse Wonder vertrouwen? Niet volledig. Meta's modelkaart laat zien dat de tabel drie soorten bewijs mengt:
Zoals ik eerder opmerkte, gebruikt bijna elke score de hoogste redeneerstand, dus je ziet elk model op zijn best. Resultaten verschuiven ook per tester: Anthropic rapporteert 66,4% voor Claude Opus 5.5 op Terminal-Bench 4.0, tegenover 59,6 in Meta's tabel. Meta's bewering dat Muse Wonder Full onbekende taken beter aankan dan de Spark-modellen, rust op hun eigen analyse.
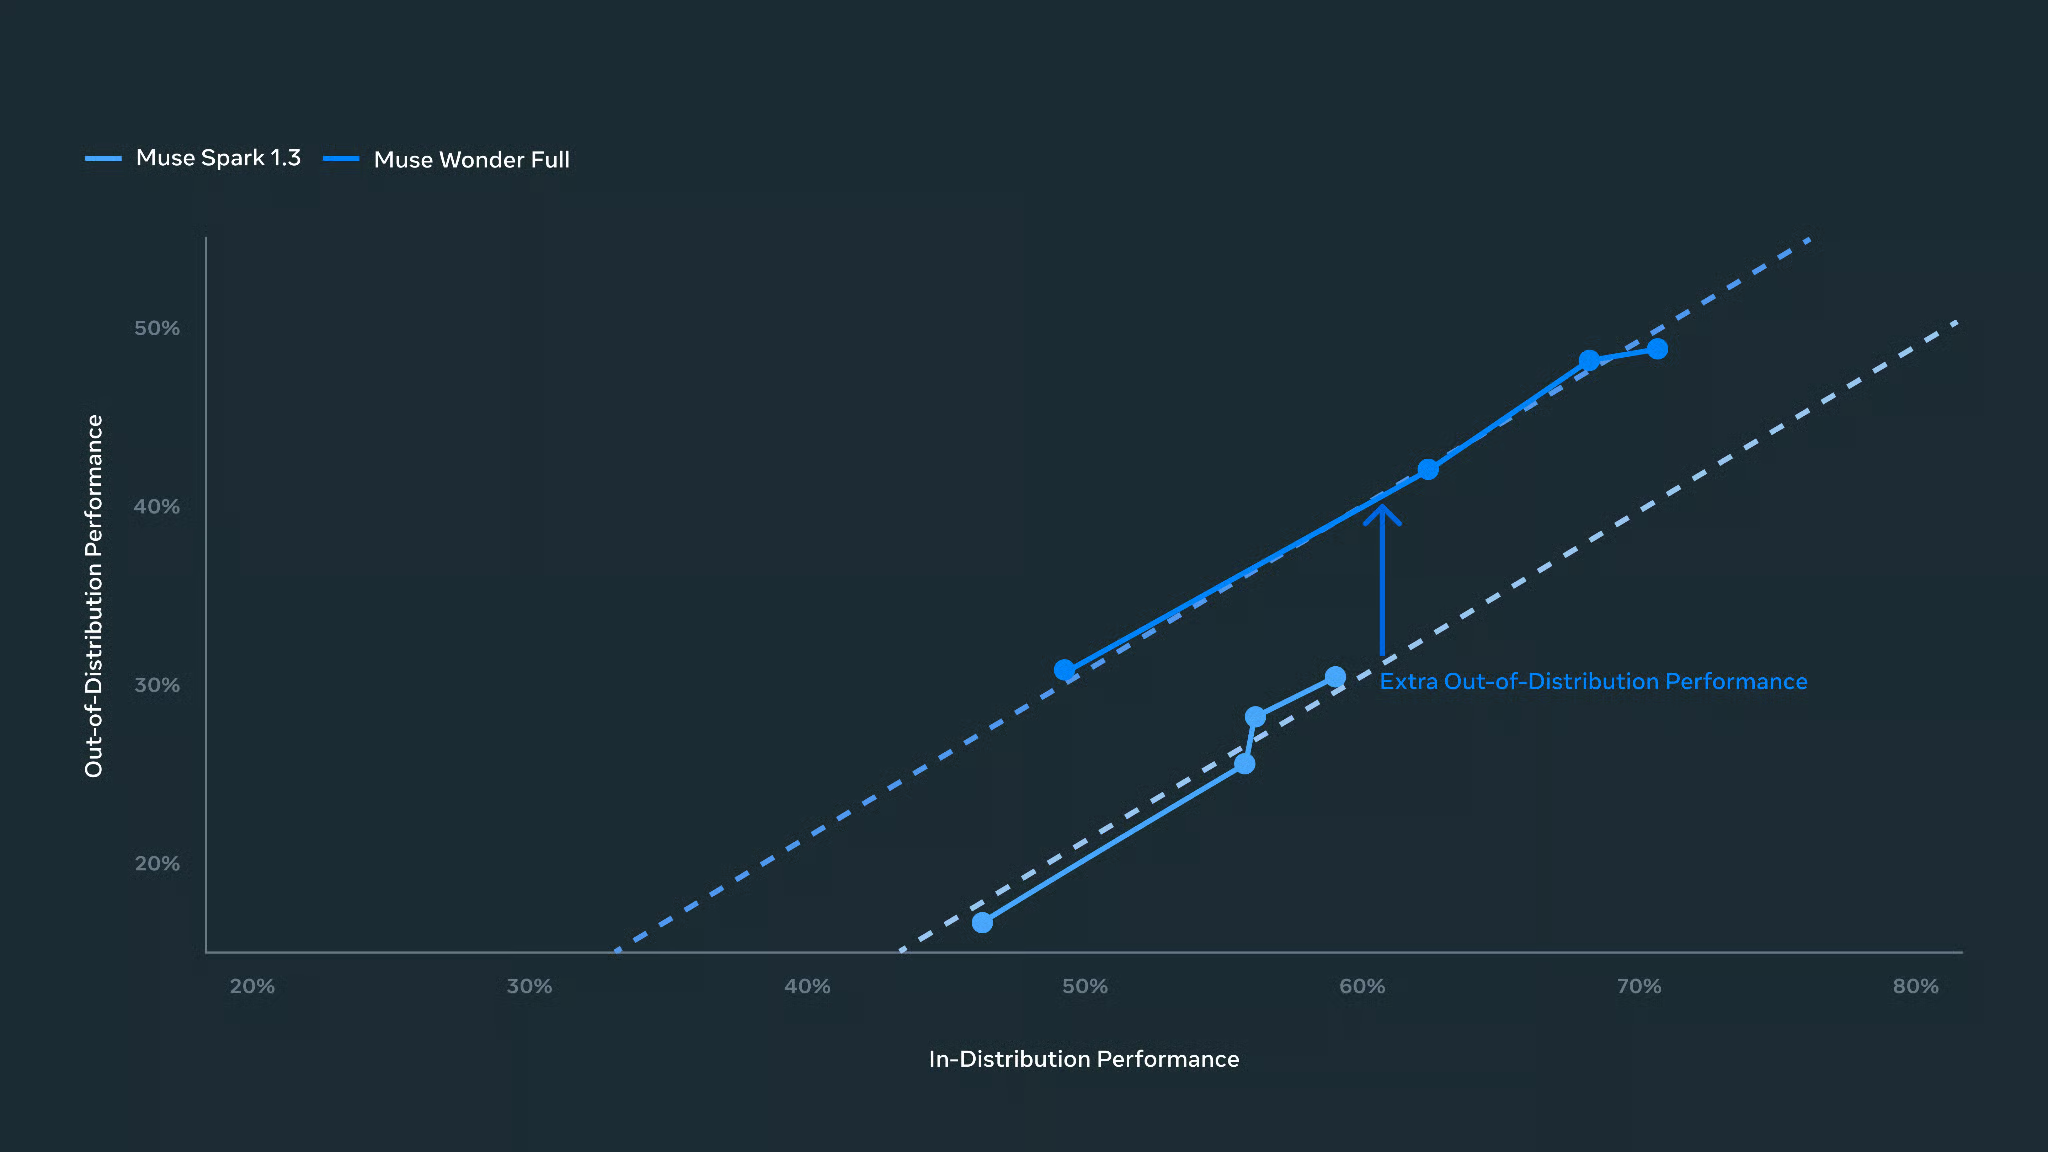
Meta vergelijkt prestaties op onbekende taken. Bron: Meta.
Op Meta's cijfers wint Muse Wonder Full lange codeerklussen (maar alleen binnen Muse Code), wint Claude Opus 5.5 terminalwerk en bouwen vanaf nul, en voert GPT-6 Astra slechts één rij aan in Meta's tabel. Dit deel brengt de benchmarks samen, dus het zal bekend klinken.
Automatisering is verdeeld, want Muse Wonder Full leidt op AutomationBench-AA terwijl de Claude-modellen leiden op OSWorld partial credit. Onder modellen met een gerapporteerde volledige voltooiingsscore rondt geen enkel de meeste taken af. Op brede redenering leidt Claude Opus 5.5 de Artificial Analysis-index, waar de reguliere Muse Wonder 52,4 scoort.
Prijs is waar de reguliere Muse Wonder zwakker oogt. GPT-6.1 Sol kost de helft per token en scoort 51,8 op dezelfde index, en Claude Sonnet 5.5 kost evenveel als GPT-6.1 Sol.
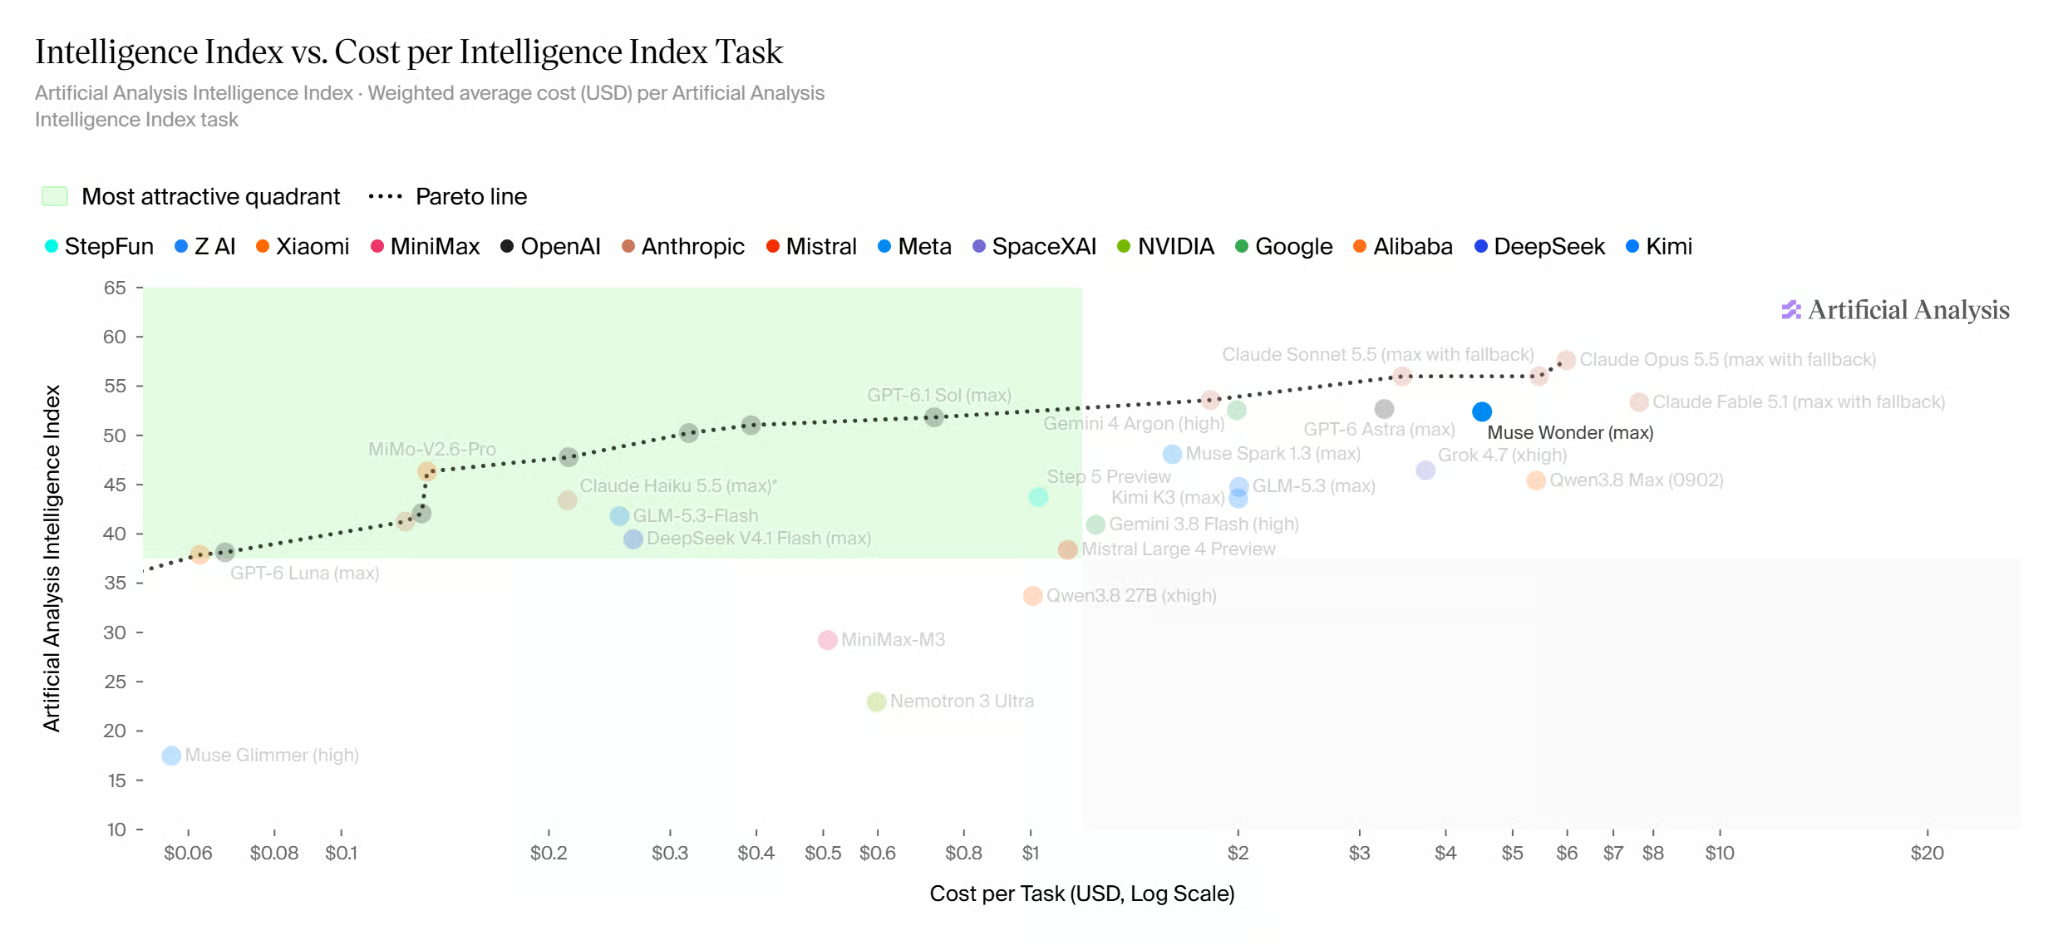
Muse Wonder ruilt kosten in tegen intelligentie. Bron: Artificial Analysis.
Ik stond op het punt Gemini 4 Argon uit dit deel te laten, omdat Meta het niet testte, en zoals onze Gemini 4 Argon-verslaggeving opmerkt, ging het eerst naar vertrouwde cybersecurityteams. Zonder gedeelde resultaten is er geen eerlijke head-to-head, dus kies op basis van workload en de kosten om een taak af te ronden.
Muse Wonder past het best bij twee soorten werk: grote softwarewijzigingen en meerstaps-browserworkflows. Lange planningsklussen, zoals Meta's demo met een tafelschikking voor een bruiloft, hangen meer af van de app rondom het model.
Voor deze use-case is het bewijs het sterkst, in elk geval bij het wijzigen van bestaande code. In Muse Code werkt Muse Wonder over bestanden heen, draait tests, leest fouten en probeert opnieuw, precies wat DeepSWE en SWE-Marathon meten. Geef op echte code alleen de permissies die de taak nodig heeft en laat een persoon de wijzigingen reviewen.
Meta's Saturday Run Planning-demo laat zien dat Muse Wonder "direct in een browser en over apps heen" werkt, en een andere demo handelt een verzekeringsclaim af. Omdat Muse Wonder Full minder dan 4 op de 10 bureaubladtaken volledig afrondt, heeft een echte workflow jouw goedkeuring nodig voordat er iets wordt ingediend of betaald.
Je betaalt voor Muse Wonder op twee manieren: per token voor de reguliere Muse Wonder, of een vast maandelijks Muse Code-abonnement, wat, zoals ik in de intro noemde, de enige manier is om Muse Wonder Full te krijgen.
Meta's prijspagina vermeldt de reguliere Muse Wonder op $4,00 per miljoen inputtokens, $0,20 voor gecachte input en $20,00 voor output. Dat is een grote sprong vanaf Muse Spark 1.3's $1,25 en $4,25, en het komt overeen met de prijzen van Claude Opus 5.5, wat aangeeft waar Meta vindt dat Muse Wonder staat.
GPT-6 Astra staat op $10, $1 gecacht, en $50, en GPT-6.1 Sol op $2, $0,10 en $10. De hypothese hieronder past die lanceringsprijzen toe op één codeertaak met 3 miljoen inputtokens (2,4 miljoen gecacht) en 200.000 outputtokens, ervan uitgaande dat geen enkele request over 272.000 tokens gaat, waar GPT-6 Astra's prijzen omhooggaan.
|
Model |
Niet-gecachte input (0,6M) |
Gecachte input (2,4M) |
Output (0,2M) |
Totaal per taak |
|
Muse Wonder |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
Claude Opus 5.5 |
$2,40 |
$0,48 |
$4,00 |
$6,88 |
|
GPT-6 Astra |
$6,00 |
$2,40 |
$10,00 |
$18,40 |
|
GPT-6.1 Sol |
$1,20 |
$0,24 |
$2,00 |
$3,44 |
Gelijke tokenprijzen betekenen gelijke kosten per poging, dus het getal om te vergelijken is de kosten per voltooide taak. Als Muse Wonder één keer in de twee klaar is, is dat $13,76, hetzelfde als een model met de prijzen van GPT-6.1 Sol dat één keer in de vier klaar is (beide percentages verzonnen voor het voorbeeld).
Muse Wonder Full is er alleen bij de maandplannen van Muse Code, die een vast tarief rekenen in plaats van per token. Je kunt dit deel overslaan als je alleen de API wilt gebruiken. Meta's abonnementsdocumentatie vermeldt vier plannen:
Meta's Muse Code-productpagina toont alleen prijzen voor Power en Maximum, wat een vreemde weglating is, dus check de lagere plannen bij het afrekenen. De reguliere Muse Wonder zit op elk plan.
Elk plan heeft een gebruikslimiet die periodiek reset. Ongebruikte tegoeden worden niet meegenomen en het abonnement kan niet worden gebruikt als API-krediet.
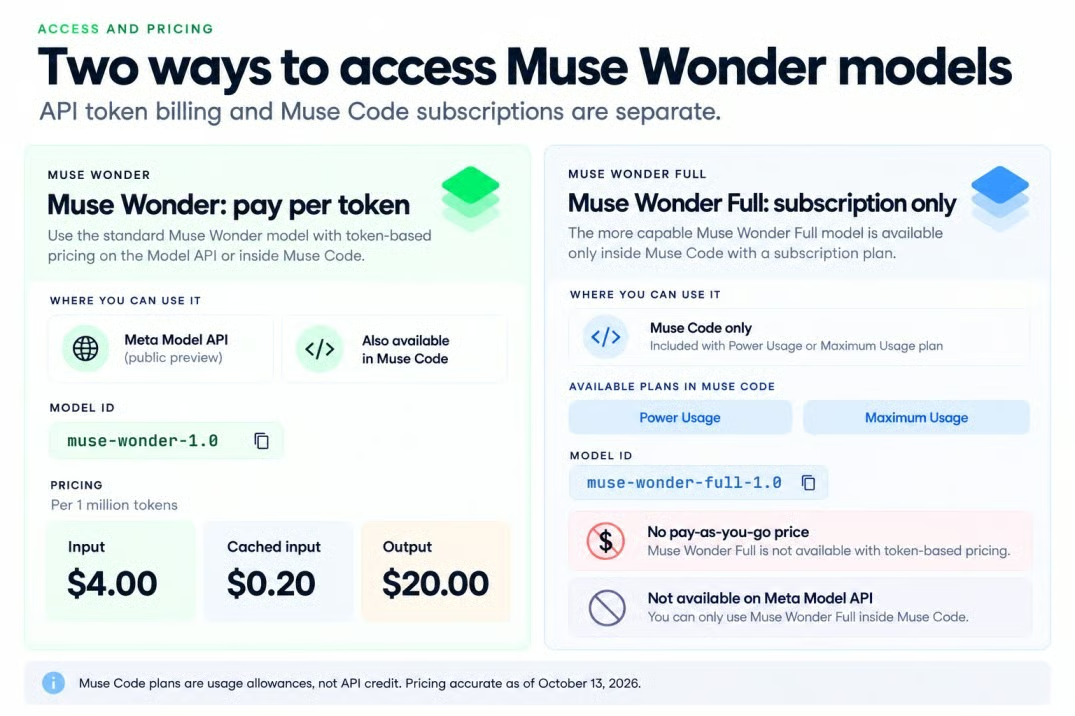
Prijzen van Muse Wonder volgen twee routes. Bron: Meta; afbeelding door auteur.
Power is de goedkoopste manier om Muse Wonder Full te proberen, al heeft Meta niet gezegd hoeveel grote taken de toelage dekt. Dat zou ik in de gaten houden, want een vroege gebruiker zei dat enkele kleine verzoeken ongeveer de helft van de 5-uurslimiet van een instapplan verbruikten, zoals ik in de reacties van ontwikkelaars behandel.
Terug naar de splitsing uit de intro: de reguliere Muse Wonder is beschikbaar via de Meta Model API en Muse Code, en Muse Wonder Full alleen via Muse Code.
Om de Muse Wonder API te gebruiken heb je een Meta-ontwikkelaarsaccount, een API-sleutel en facturering nodig, en de model-ID is muse-wonder-1.0. Meta noemt de API nog steeds een "public preview" op de productpagina, code gebouwd op de SDK van OpenAI kan erop worden gericht, en Meta vermeldt ook OpenRouter als route.
Toegang is niet wereldwijd. Meta's geografisch gebruiksbeleid blokkeert meerdere plaatsen, waaronder China, Rusland, Iran, Pakistan, Eritrea en Ethiopië.
Voor Muse Wonder Full heb je een Power- of Maximum-plan van Muse Code nodig, een Meta-account en moet je 18 zijn of de meerderjarigheidsleeftijd hebben waar je woont. Zoals ik in de prijzensectie besprak, staat het niet op de Model API voor welke prijs dan ook, en de ID, muse-wonder-full-1.0, werkt alleen binnen Muse Code. De documentatie van Muse Code noemt macOS, Linux en Windows, hoewel de productpagina alleen macOS en Windows vermeldt.
De risico's komen voort uit precies de dingen die Meta aanprijst: lange runs en toegang tot je privébestanden.
De modelkaart noemt drie zwaktes die een agent kunnen beïnvloeden. Elke veroorzaakt een ander probleem:
Dit zijn geen geïsoleerde kwaliteitsproblemen van antwoorden wanneer het model tools kan gebruiken. Een verkeerde klik of aanname vroeg in een twee uur durende taak kan de rest verpesten.
Het hangt af van de modus, dus lees dit voordat je Muse Code op een privérepository richt. Meta's Servicevoorwaarden, drie dagen voor de lancering bijgewerkt, zeggen dat Meta niet traint op content die naar zijn Standaarddiensten is gestuurd, terwijl content in Contributormodus kan worden gebruikt om modellen te "trainen, ontwikkelen, evalueren en verbeteren".
Muse Code-abonnementen starten in Contributormodus, in ruil voor meer gebruik, en je moet in je instellingen naar Standaard schakelen. De switch geldt alleen voor de toekomst, dus alles wat je al hebt verzonden kan nog steeds voor training worden gebruikt. Dat uitgangspunt vind ik lastig te waarderen.
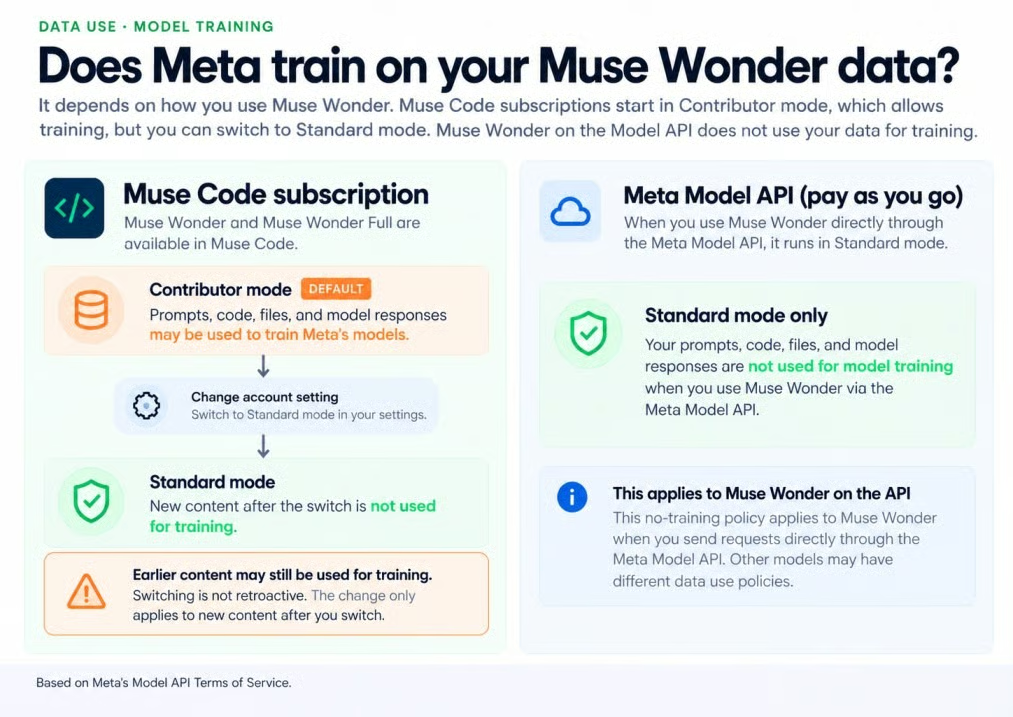
Contributorcontent kan Meta-modellen trainen. Bron: Meta-voorwaarden; afbeelding door auteur.
De voorwaarden zeggen ook dat je in Contributormodus geen gevoelige, vertrouwelijke of persoonlijke informatie mag inzenden, inclusief privécode. De reguliere Muse Wonder op de pay-as-you-go API draait alleen in Standaardmodus.
Meta testte Muse Wonder Full onder zijn Superintelligence Scaling Framework. Zonder waarborgen sluit Meta niet uit dat het het hoogrisiconiveau bereikt voor chemische en biologische dreigingen, en met waarborgen beoordeelt het elk risicogebied als "gematigd of lager".
Een risicobeoordeling is geen veiligheidswaarborg, en een vollediger veiligheidsrapport komt nog "binnenkort". Het advies van de modelkaart is eenvoudig: vereis menselijke bevestiging voor acties die je niet ongedaan kunt maken, en houd de agent in een sandbox met beperkte permissies.
Reacties op X op de lanceringsdag waren verdeeld tussen snelle vooruitgang, wisselende prestaties en frustratie over gebruikslimieten. Dit zijn korte tests en persoonlijke indrukken, geen gecontroleerde evaluaties.
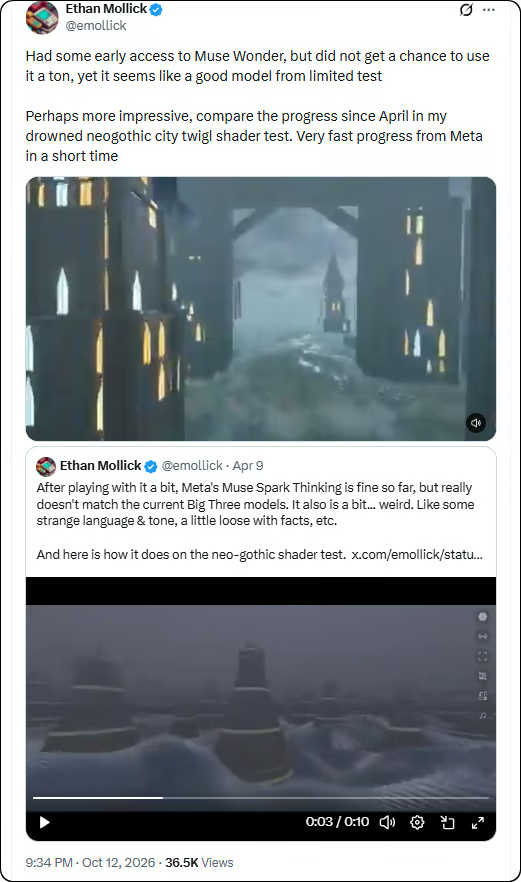
De voorzichtige positieve kijk kwam van een vroege tester die beperkte tijd met Muse Wonder had maar het goed vond ogen. Het grotere punt was hoe ver Meta's modellen sinds Muse Spark in april waren gekomen.
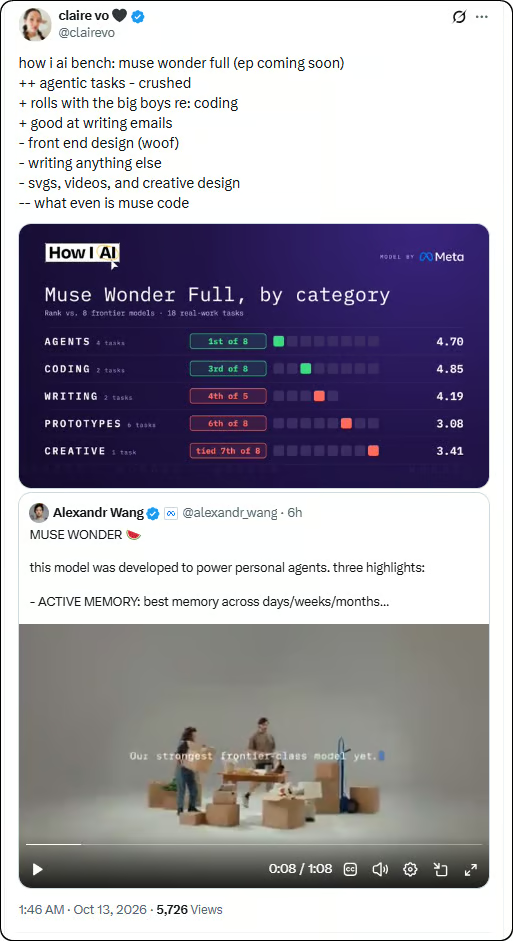
Een bredere categorietest vertelde een minder net verhaal. Muse Wonder Full stond dicht bij de top voor agents en coderen, maar zakte achterop bij schrijven, front-end design en creatief werk.
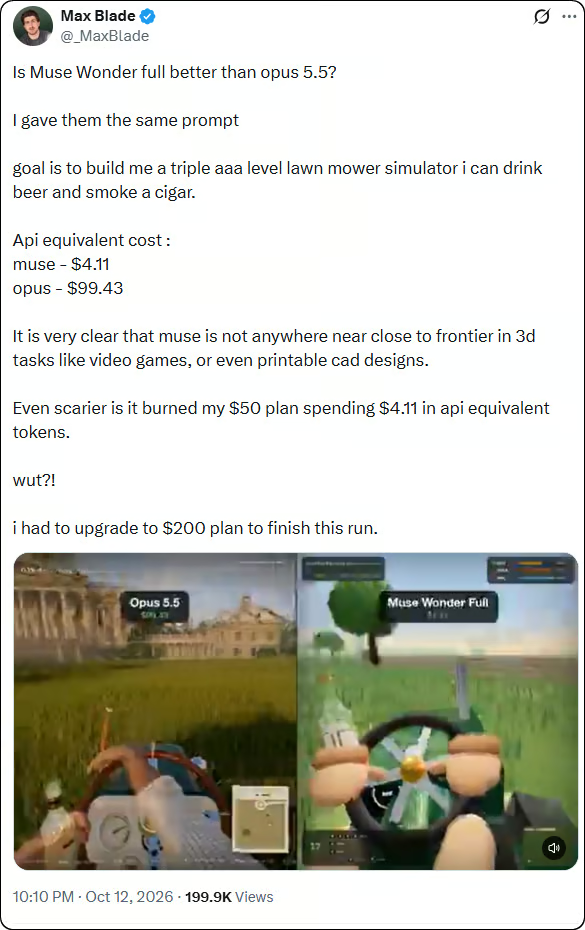
De scherpste klacht ging over kosten en planlimieten. In één same-prompt grasmaaier-test gebruikte Muse Wonder Full ongeveer $4,11 aan API-equivalente tokens maar leverde een zwakkere 3D-uitkomst op dan Claude Opus 5.5, en de tester zei dat afronden een upgrade vereiste van het $50-plan naar het $200-plan.
Gezamenlijk suggereren de posts dat Muse Wonder competitief maar oneffen is. Meer herhaalde tests zijn nodig voordat je één resultaat als typisch beschouwt.
Het meeste van het lanceringsbewijs komt nog steeds van Meta. Muse Wonder Full heeft geen pay-as-you-go API, en de reguliere Muse Wonder kost evenveel als Claude Opus 5.5 terwijl het op meerdere tests achterblijft.
Ik zou de reguliere Muse Wonder testen voor API-agents en Muse Wonder Full voor langdurig repositorywerk. Ik zou Claude Opus 5.5 aanhouden voor terminalwerk of het vanaf nul bouwen van programma's, en GPT-6.1 Sol of Claude Sonnet 5.5 gebruiken wanneer kosten doorslaggevend zijn.
Leer met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min