
{count, plural, one {Cours} other {Cours}}
Concepts des grands modèles de langage (LLM)
{hours} h
112.2K
Cette semaine, Meta a présenté Muse Wonder et Muse Wonder Full, sa première grande famille de modèles depuis Muse Spark. Les deux sont conçus pour des agents IA capables de gérer des enchaînements d’actions complexes.
Dans son article de lancement, Meta présente Muse Wonder comme l’aboutissement de 14 mois de refonte de ses travaux en IA. Deux notions sont à retenir : Active Memory, qui réactive des détails utiles issus d’échanges précédents, et Active Focus, qui permet de poursuivre le travail même en cas de blocage.
La version standard de Muse Wonder est disponible via la Meta Model API et Muse Code, tandis que Muse Wonder Full, le modèle derrière la plupart des résultats mis en avant, ne fonctionne que dans Muse Code sur ses deux offres les plus onéreuses. Nous y reviendrons plus loin.
Voici ce que je retiens du lancement :
Muse Wonder et Muse Wonder Full sont des modèles de raisonnement que Meta présente comme ses plus performants à ce jour, conçus pour des agents opérant sur des tâches personnelles et professionnelles. La model card indique des entrées texte, image, vidéo et audio, pour une sortie texte uniquement : aucun des deux modèles ne génère d’images, vidéos ou audio. La documentation développeurs ajoute le support PDF et fixe la fenêtre de contexte à 1 48 576 tokens.
Le blog de recherche de Meta explique que les deux modèles prolongent le travail d’entraînement de Muse Spark et ont été entraînés au data center Prometheus de Meta. Aucun décompte de paramètres n’est communiqué.
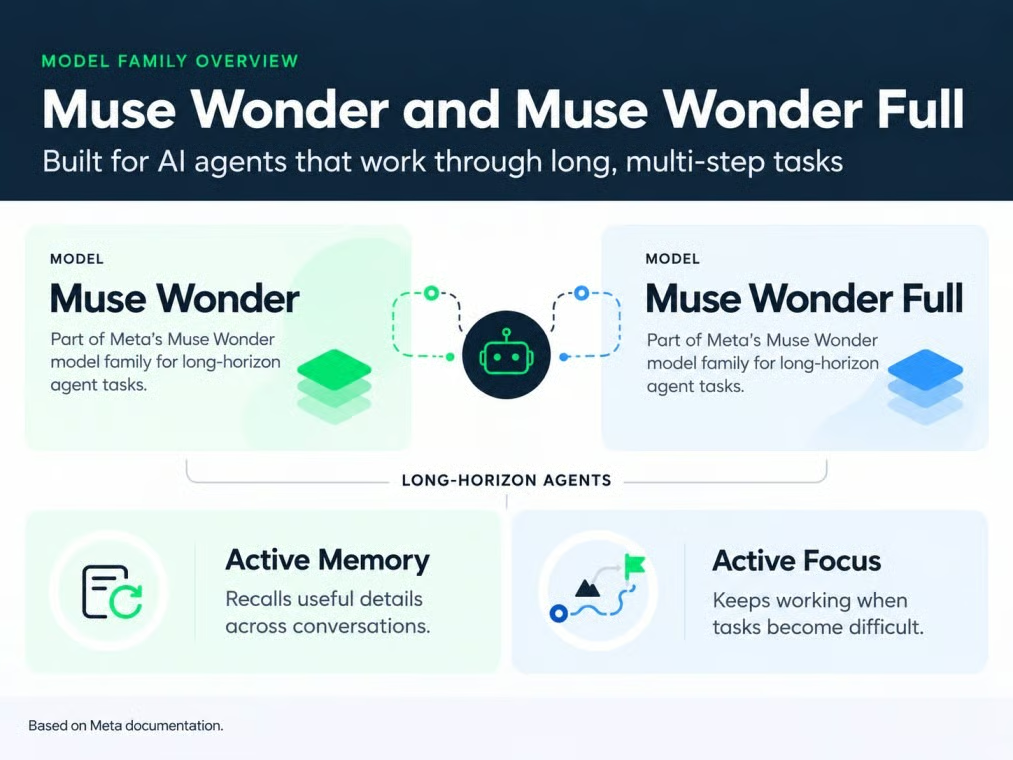
Muse Wonder existe en deux variantes. Image de l’auteur.
Entre les deux, Muse Wonder Full est un modèle distinct, plus performant. La documentation indique que pousser le raisonnement de Muse Wonder (muse-wonder-1.0) au niveau "max" ne le transforme pas en Muse Wonder Full (muse-wonder-full-1.0).
Vous aurez noté que Meta utilise la marque Muse pour plusieurs produits. Récapitulons :
Lorsque Meta indique que Muse Wonder « fait » quelque chose, Muse Code réalise souvent une bonne partie du travail. C’est le cas pour la plupart des résultats en codage ci-dessous.
Les points forts de Muse Wonder sont Active Memory et Active Focus, que Meta met en avant sur les longues tâches de code. Dans les deux cas, l’idée est simple : un agent doit retenir les bons détails et persévérer quand un plan capote.
Active Memory est le terme de Meta pour le rappel de détails importants au fil de conversations et la capacité à ressortir ceux qui comptent maintenant. Par exemple : vous fixez en mars un budget de 3 000 $ pour un bureau à domicile, vous le portez à 4 000 $ en avril et, en mai, vous demandez une short list de meubles. Une bonne mémoire signifie que l’agent utilise le montant d’avril sans rappel.
La preuve avancée par Meta est MemoryBench, son propre test de longues conversations où les faits évoluent. Muse Wonder y obtient 85,6, mais cela ne dit rien du rappel sur plusieurs mois, et une application bâtie sur l’API doit de toute façon stocker ces faits. C’est la fonctionnalité qui m’intrigue le plus, car un agent qui travaille avec un ancien budget peut vous coûter cher.
Active Focus est le nom donné par Meta à la persistance : tenter une autre approche, lever les blocages et demander validation avant les actions critiques. Imaginez une migration de code avec 30 tests en échec : un agent concentré corrige son code et relance les tests, là où un agent plus faible se contente d’éditer les tests pour les faire passer.
Meta mesure cela avec FocusBench, un autre de ses tests maison, ainsi qu’avec SWE-Marathon, sur lequel je reviens dans la section benchmarks. Aucun des deux ne garantit une tâche terminée, et le travail en arrière-plan dépend de l’environnement logiciel autour du modèle — un risque que notre explication d’OpenAI Dots couvre pour les agents toujours actifs.
Muse Wonder planifie de longues tâches de code et répartit le travail entre des agents auxiliaires, tandis que Muse Code exécute les outils et les validations. La page développeur la destine à des tâches qui « tournent pendant des heures », avec de nombreux fichiers modifiés en parallèle.
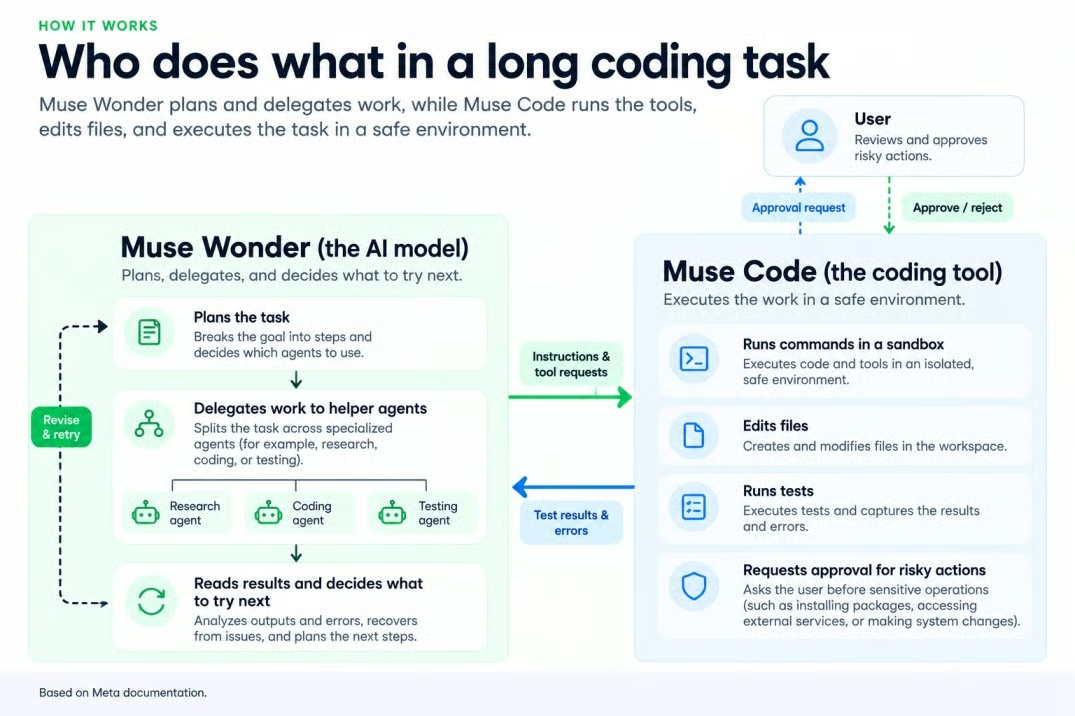
Muse Wonder planifie ; Muse Code exécute. Image de l’auteur.
L’une des démos de Meta est un jeu de cuisine 3D jouable généré à partir d’images. Un choix étonnant, puisque la model card signale le raisonnement 3D comme faiblesse connue (j’aurais choisi une autre démo).
Le tableau de Meta favorise Muse Wonder Full sur les longues tâches de code et certains benchmarks professionnels, tandis que Claude Opus 5.5 mène sur le code en terminal et la création de programmes à partir de zéro. Sauf mention contraire, les chiffres ci-dessous proviennent de Meta, avec presque tous les modèles au niveau de raisonnement maximal (je signalerai l’exception).
Muse Wonder Full arrive en tête des deux tests de code longue durée du tableau de Meta. Comme en intro, il obtient 79,0 sur DeepSWE v1.1, avec Muse Wonder standard juste derrière à 78,8. Ce sont, pour l’heure, les chiffres de Meta, car le classement public DeepSWE de Datacurve ne mentionne pas encore Muse Wonder.
SWE-Marathon est celui à surveiller : ses 20 projets de plusieurs heures valent zéro si un seul test échoue. Meta annonce Muse Wonder Full à 57,5 (un cran sous son réglage maximal) et Muse Wonder à 53,1, contre 46,3 pour Claude Opus 5.5 et 42,5 pour GPT-6 Astra. Les modèles concurrents tournaient dans les outils de codage de leurs éditeurs respectifs, si bien que Meta reconnaît une comparaison imparfaite ; et avec seulement 20 projets, un cas peut faire bouger le score de plusieurs points.
Le classement SWE-Marathon d’Abundant AI est plus mesuré : Muse Wonder Full à 53,1 % et Muse Wonder standard à 52,5 %, tous deux à leur réglage maximal dans Muse Code, légèrement devant Claude Sonnet 5.5 à 51,3 %. Claude Haiku 5.5, publié cinq jours plus tôt par Anthropic, est à 50,0 %. Les deux listes proviennent de tests différents : ne les mélangez pas.
L’affirmation de Meta selon laquelle Muse Wonder peut mener à bien des tâches multi-apps est partiellement confirmée. Sur AutomationBench-AA, qui vérifie l’état final des workflows métier, Muse Wonder Full marque 45,4 contre 41,6 pour GPT-6 Astra et 41,2 pour Claude Opus 5.5 : il mène la danse, tout en échouant encore sur la majorité des workflows.
OSWorld V2.1, un ensemble de 108 tâches desktop, est plus éloquent. Muse Wonder Full obtient 78,4 en crédit partiel mais ne termine intégralement que 39,4 % des tâches, et les deux modèles Claude dépassent son score partiel. Pour un formulaire d’assurance, réussir la plupart des étapes reste un échec : 39,4 % est donc l’indicateur à suivre.
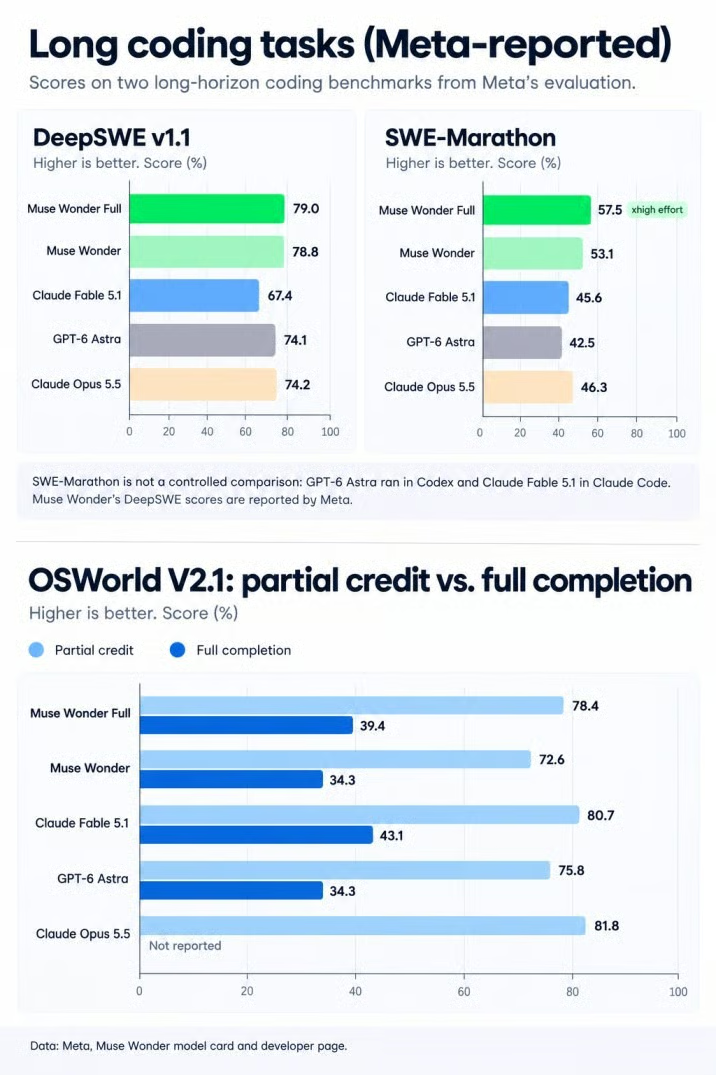
Les scores en codage masquent des taux d’achèvement plus faibles. Source : Meta ; image de l’auteur.
Muse Wonder Full mène sur le benchmark juridique et recule sur la santé, avec la finance au coude-à-coude. Son score juridique paraît faible, mais il est trois fois supérieur à celui de Claude Opus 5.5. Dans la version d’Artificial Analysis, un document juridique est comptabilisé uniquement s’il respecte toutes les exigences sans contenu inventé ; Muse Wonder Full atteint 13,1 contre 4,2 pour Claude Opus 5.5 — ce qui signifie tout de même échouer sur environ 87 % des tâches.
En finance, quasi-égalité : Muse Wonder Full à 59,1 sur Vals Finance Agent V2 contre 58,6 pour Claude Opus 5.5. En santé, c’est l’inverse : Muse Wonder Full obtient 62,3 sur HealthBench Pro, derrière Claude Opus 5.5 (65,6) et GPT-6 Astra (65,3).
Muse Wonder Full est derrière Claude Opus 5.5 sur six des 14 tests du tableau de Meta, et GPT-6 Astra le bat sur trois. Le tableau ci-dessous réunit les revers non encore abordés.
|
Benchmark |
Ce qu’il évalue |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Code en terminal |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Création de programmes à partir de zéro |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Indice composite général |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Usage d’outils professionnels |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Travail à partir de PDFs |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Source : page développeur de Muse Wonder au lancement. Tous les modèles au réglage de raisonnement maximal.
ProgramBench est le revers que les développeurs doivent garder en tête, et l’écart est net. Il demande de reconstruire un programme from scratch ; un écart de 11,5 points montre que modifier une base de code existante et bâtir à partir de rien mobilisent des compétences différentes.
Artificial Analysis donne Muse Wonder Full à 55,8, arrondi à 56 dans le tableau de Meta, tandis que Claude Sonnet 5.5 est à 56,0.
Peut-on se fier aux benchmarks de Muse Wonder ? Pas entièrement. La model card de Meta montre que le tableau mêle trois sources de preuves :
Comme indiqué, presque tous les scores utilisent le réglage de raisonnement maximal : vous voyez chaque modèle à son meilleur. Les résultats varient aussi selon l’évaluateur : Anthropic annonce 66,4 % pour Claude Opus 5.5 sur Terminal-Bench 4.0, contre 59,6 dans la table de Meta. L’affirmation de Meta selon laquelle Muse Wonder Full gère mieux les tâches inconnues que les modèles Spark repose sur sa propre analyse.
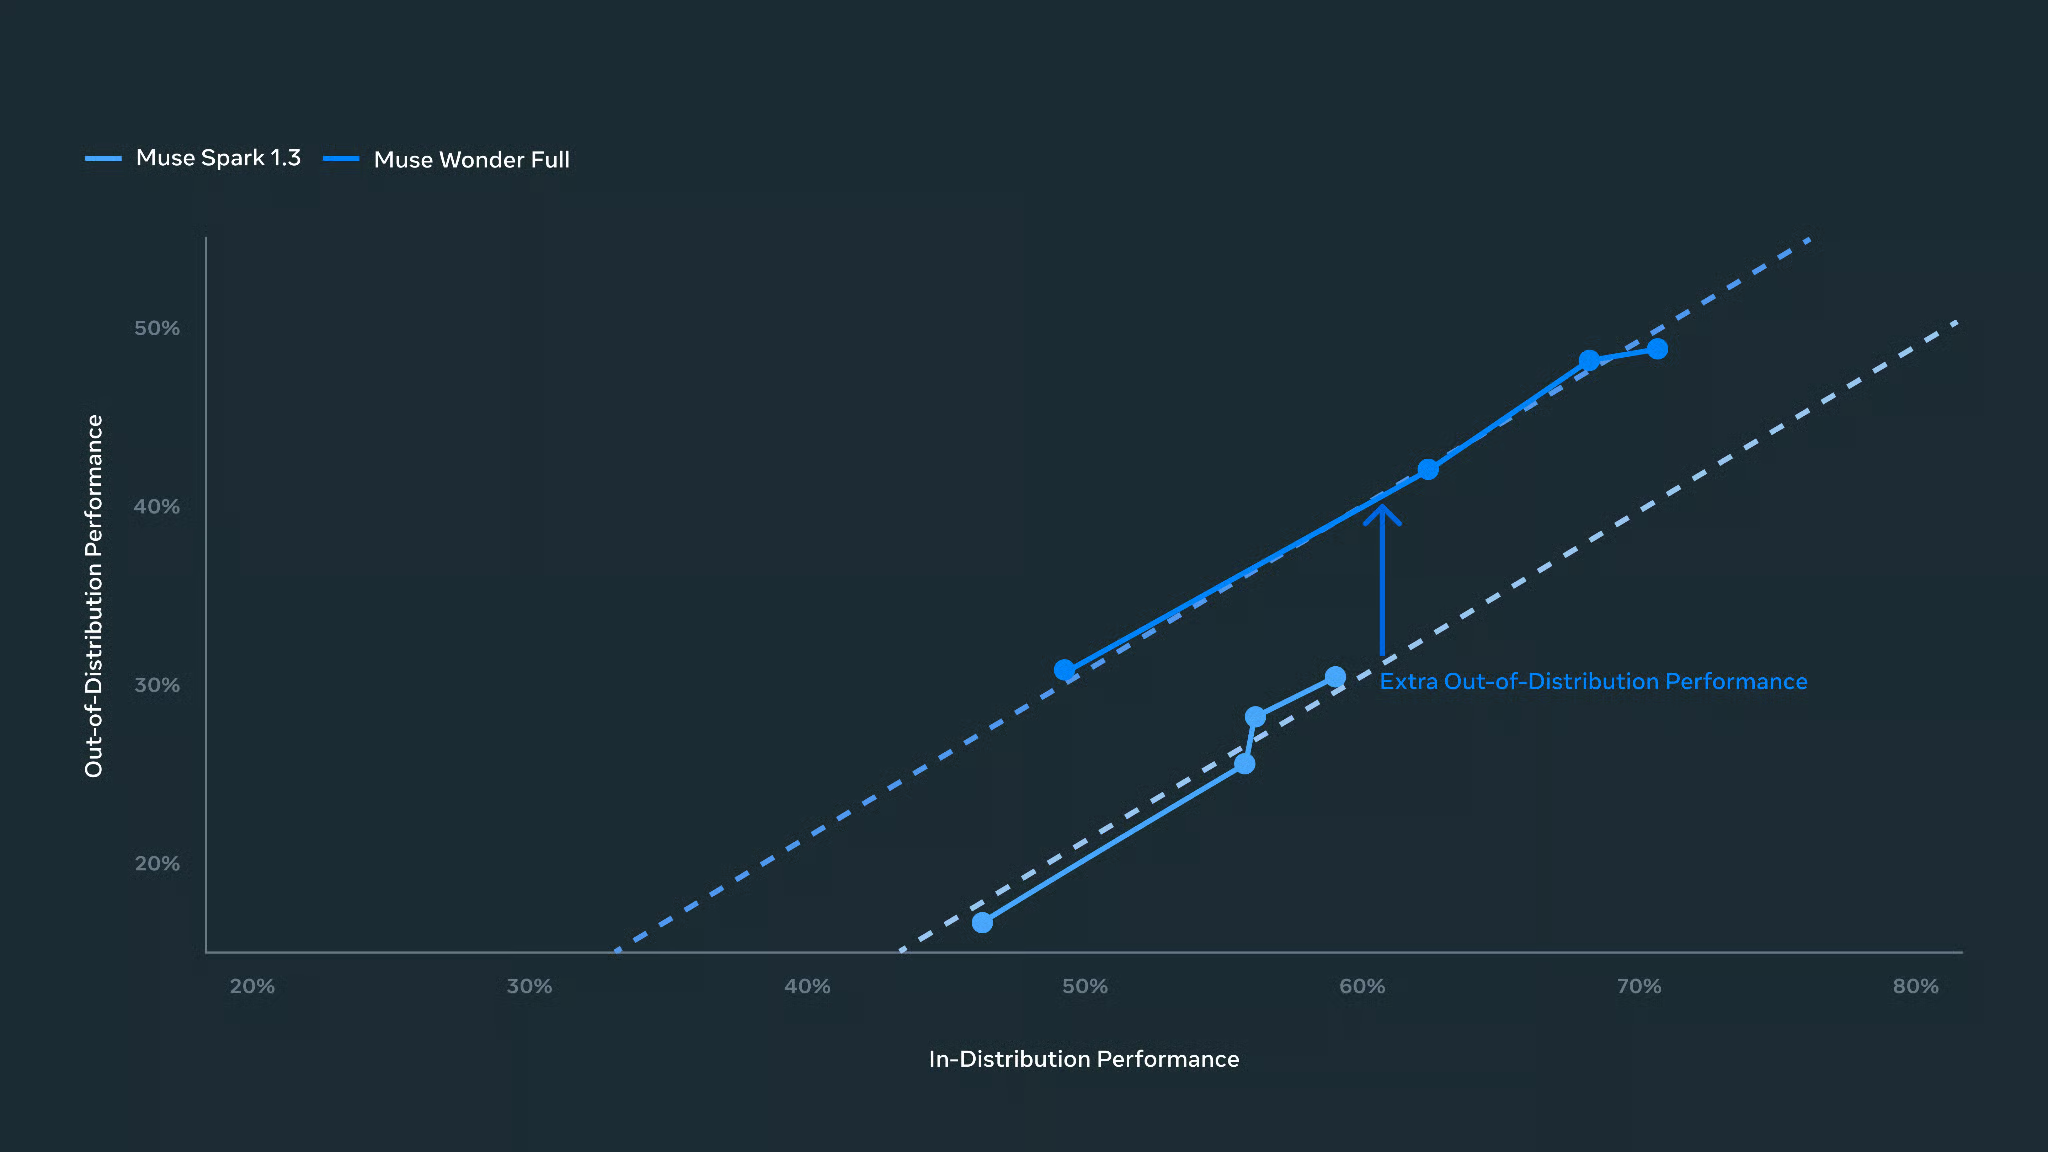
Meta compare la performance sur des tâches non familières. Source : Meta.
D’après les chiffres de Meta, Muse Wonder Full gagne sur les longues tâches de code (mais uniquement dans Muse Code), Claude Opus 5.5 s’impose sur le travail en terminal et la construction from scratch, et GPT-6 Astra ne mène qu’une seule ligne du tableau. Cette partie agrège les benchmarks, donc vous y verrez des répétitions.
Côté automatisation, les résultats sont partagés : Muse Wonder Full mène sur AutomationBench-AA, tandis que les modèles Claude dominent sur le crédit partiel OSWorld. Parmi les modèles avec un score de complétion totale, aucun ne termine la majorité des tâches. En raisonnement général, Claude Opus 5.5 mène l’indice d’Artificial Analysis, où Muse Wonder standard obtient 52,4.
Le prix est le point faible de Muse Wonder standard. GPT-6.1 Sol coûte deux fois moins cher par token et marque 51,8 sur le même indice, et Claude Sonnet 5.5 est au même tarif que GPT-6.1 Sol.
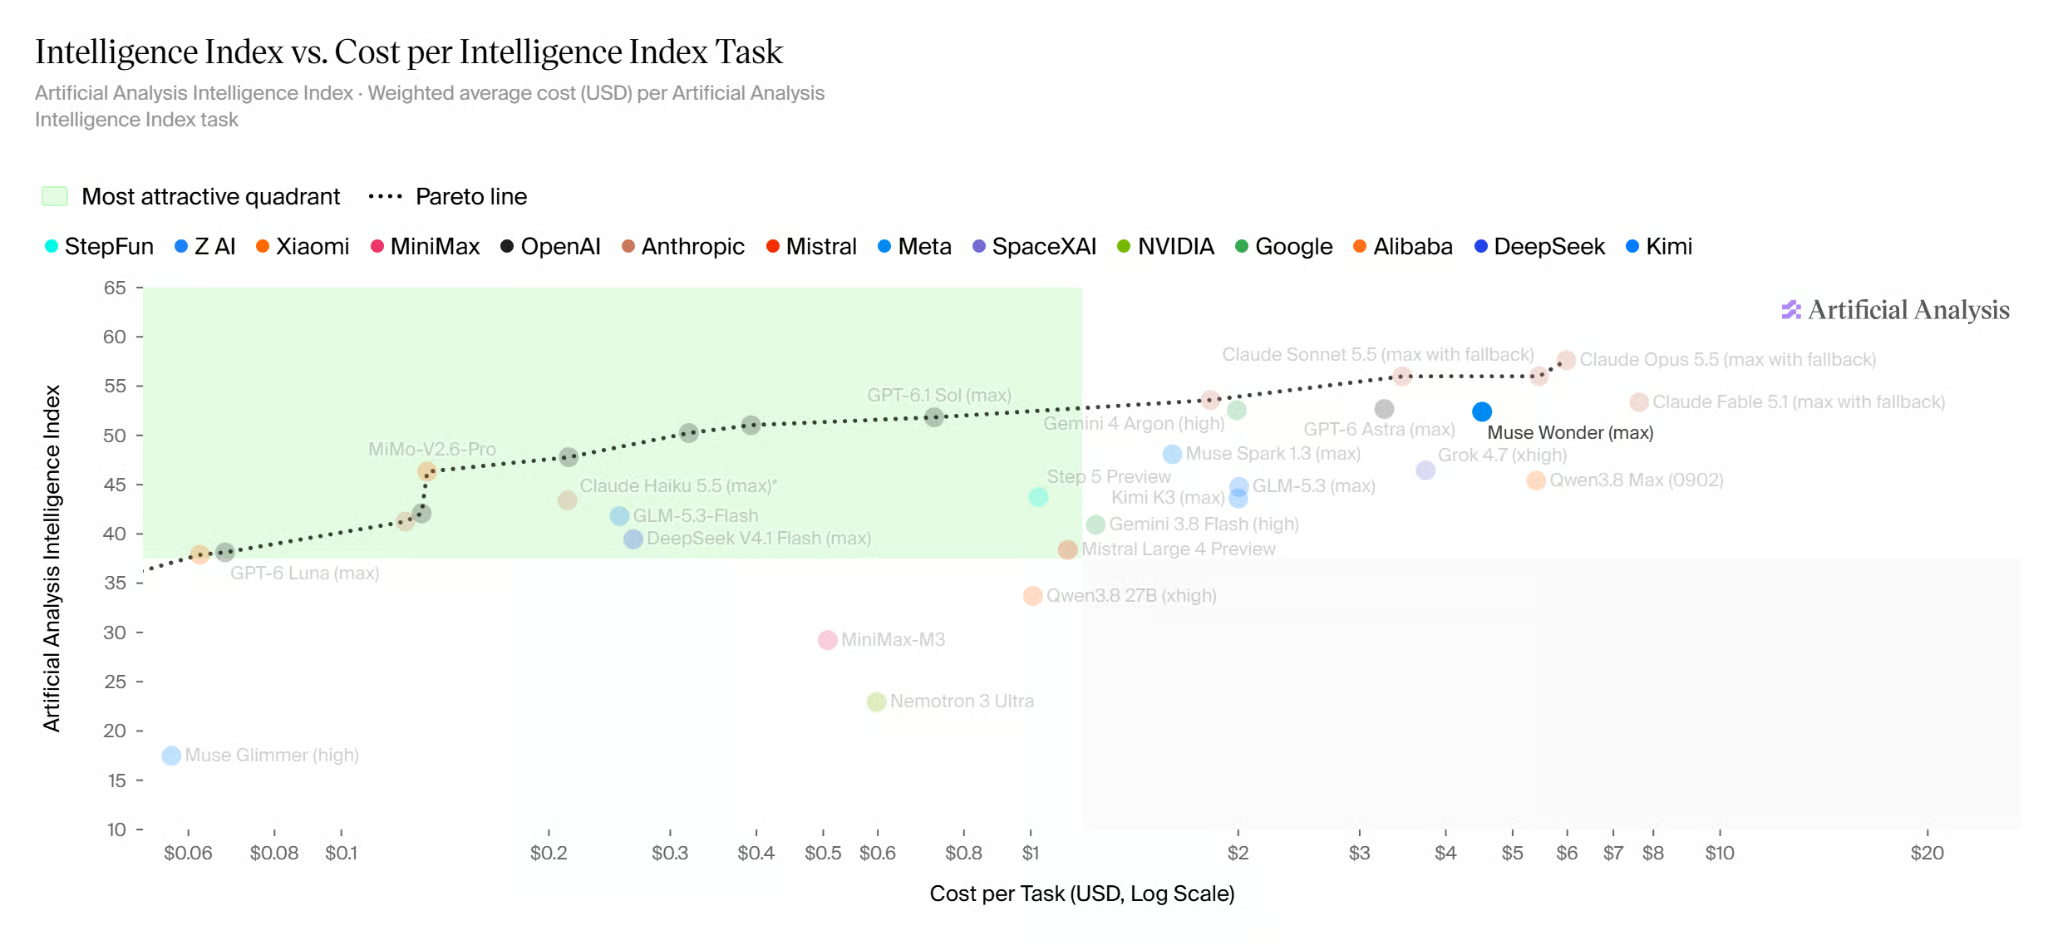
Muse Wonder arbitre entre coût et intelligence. Source : Artificial Analysis.
J’ai presque laissé Gemini 4 Argon de côté ici, car Meta ne l’a pas testé ; et comme notre couverture de Gemini 4 Argon le note, il a d’abord été déployé auprès d’équipes cybersécurité de confiance. Sans résultats communs, pas de duel équitable : choisissez selon la charge de travail et le coût pour terminer une tâche.
Muse Wonder excelle surtout sur deux terrains : les évolutions logicielles d’ampleur et les workflows web multi-étapes. Les longues tâches de planification (comme la démo du plan de table de mariage de Meta) dépendent davantage de l’application autour du modèle.
Ce cas d’usage est le mieux étayé, au moins pour modifier du code existant. Dans Muse Code, Muse Wonder opère sur plusieurs fichiers, lance les tests, lit les échecs et réitère : exactement ce que mesurent DeepSWE et SWE-Marathon. En situation réelle, limitez ses permissions au strict nécessaire et prévoyez une relecture humaine.
La démo Saturday Run Planning montre Muse Wonder « travaillant directement dans un navigateur et entre applications », et une autre gère un sinistre d’assurance. Étant donné que Muse Wonder Full termine moins de 4 tâches desktop sur 10, un workflow réel doit exiger votre validation avant tout envoi ou paiement.
Vous payez Muse Wonder de deux manières : au token pour la version standard via l’API, ou par abonnement mensuel Muse Code — la seule façon d’accéder à Muse Wonder Full, comme indiqué en introduction.
La page tarifs de Meta affiche Muse Wonder standard à 4,00 $ par million de tokens en entrée, 0,20 $ en cache, et 20,00 $ en sortie. C’est un bond depuis les 1,25 $/4,25 $ de Muse Spark 1.3, et cela aligne les prix de Claude Opus 5.5, ce qui situe l’ambition de Meta pour Muse Wonder.
GPT-6 Astra est listé à 10 $, 1 $ en cache et 50 $, et GPT-6.1 Sol à 2 $, 0,10 $ et 10 $. L’hypothèse ci-dessous applique ces prix de lancement à une tâche de codage avec 3 millions de tokens en entrée (2,4 millions en cache) et 200 000 en sortie, en supposant qu’aucune requête unique ne dépasse 272 000 tokens, seuil au-delà duquel les tarifs de GPT-6 Astra augmentent.
|
Modèle |
Entrée non cachée (0,6 M) |
Entrée cachée (2,4 M) |
Sortie (0,2 M) |
Total par tâche |
|
Muse Wonder |
2,40 $ |
0,48 $ |
4,00 $ |
6,88 $ |
|
Claude Opus 5.5 |
2,40 $ |
0,48 $ |
4,00 $ |
6,88 $ |
|
GPT-6 Astra |
6,00 $ |
2,40 $ |
10,00 $ |
18,40 $ |
|
GPT-6.1 Sol |
1,20 $ |
0,24 $ |
2,00 $ |
3,44 $ |
Des prix au token égaux donnent des factures égales par tentative ; la bonne comparaison est donc le coût par tâche terminée. Si Muse Wonder termine une fois sur deux, cela revient à 13,76 $, soit l’équivalent d’un modèle aux tarifs de GPT-6.1 Sol qui terminerait une fois sur quatre (taux purement illustratifs).
Muse Wonder Full est réservé aux abonnements mensuels Muse Code, facturés au forfait et non au token. Vous pouvez passer cette partie si vous n’utilisez que l’API. La documentation des abonnements liste quatre offres :
La page produit Muse Code n’affiche les prix que pour Power et Maximum, ce qui est étonnant ; vérifiez les offres inférieures au moment du paiement. Muse Wonder standard est inclus dans toutes les offres.
Chaque offre comporte une limite d’usage qui se réinitialise périodiquement. L’enveloppe non utilisée n’est pas reportée et l’abonnement ne peut pas servir de crédit API.
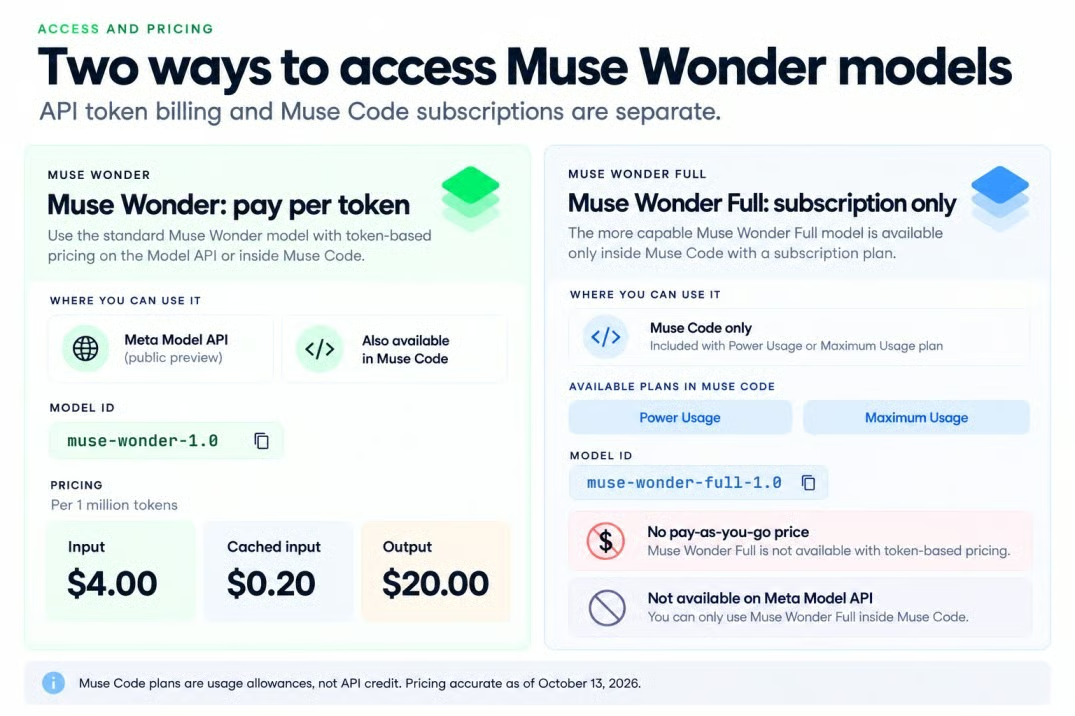
La tarification de Muse Wonder suit deux voies. Source : Meta ; image de l’auteur.
Power est la façon la plus économique d’essayer Muse Wonder Full, mais Meta n’a pas indiqué combien de grosses tâches couvre l’allocation. C’est le point à surveiller, car un utilisateur précoce indique que quelques petites requêtes ont consommé environ la moitié de la limite de 5 heures de l’offre d’entrée — nous y revenons dans les retours développeurs.
Pour résumer l’intro : Muse Wonder standard est accessible via la Meta Model API et Muse Code, et Muse Wonder Full uniquement via Muse Code.
Pour utiliser l’API Muse Wonder, vous avez besoin d’un compte développeur Meta, d’une clé API et d’un mode de facturation. L’ID du modèle est muse-wonder-1.0. Meta présente encore l’API comme une « public preview » sur sa page produit, le code basé sur le SDK d’OpenAI peut y être redirigé, et Meta liste également OpenRouter comme voie d’accès.
L’accès n’est pas mondial. La politique d’usage géographique de Meta bloque plusieurs pays, dont la Chine, la Russie, l’Iran, le Pakistan, l’Érythrée et l’Éthiopie.
Pour accéder à Muse Wonder Full, il vous faut une offre Muse Code Power ou Maximum, un compte Meta, et avoir 18 ans (ou l’âge légal dans votre pays). Comme vu dans la section tarifs, il n’est pas disponible via la Model API, quel que soit le prix, et son ID, muse-wonder-full-1.0, ne fonctionne qu’au sein de Muse Code. La documentation Muse Code mentionne macOS, Linux et Windows, bien que sa page produit n’indique que macOS et Windows.
Les risques tiennent aux mêmes points que Meta met en avant : des exécutions longues et l’accès à vos fichiers privés.
La model card cite trois faiblesses qui peuvent affecter un agent, chacune avec un impact différent :
Ces limites ne concernent pas seulement la qualité des réponses : lorsqu’un modèle a accès à des outils, un mauvais clic ou une hypothèse fausse au début d’une tâche de deux heures peut tout compromettre.
Cela dépend du mode : lisez ceci avant de pointer Muse Code vers un dépôt privé. Les Conditions générales de Meta, mises à jour trois jours avant le lancement, indiquent que Meta n’entraîne pas ses modèles sur le contenu envoyé via les Standard Services, tandis que le contenu envoyé en mode Contributor peut être utilisé pour « entraîner, développer, évaluer et améliorer » ses modèles.
Les abonnements Muse Code démarrent en mode Contributor, en échange d’une enveloppe d’usage plus généreuse ; il faut basculer manuellement en Standard dans les paramètres. Le changement n’est pas rétroactif : tout ce qui a déjà été envoyé peut être utilisé pour l’entraînement. Un choix par défaut difficile à apprécier.
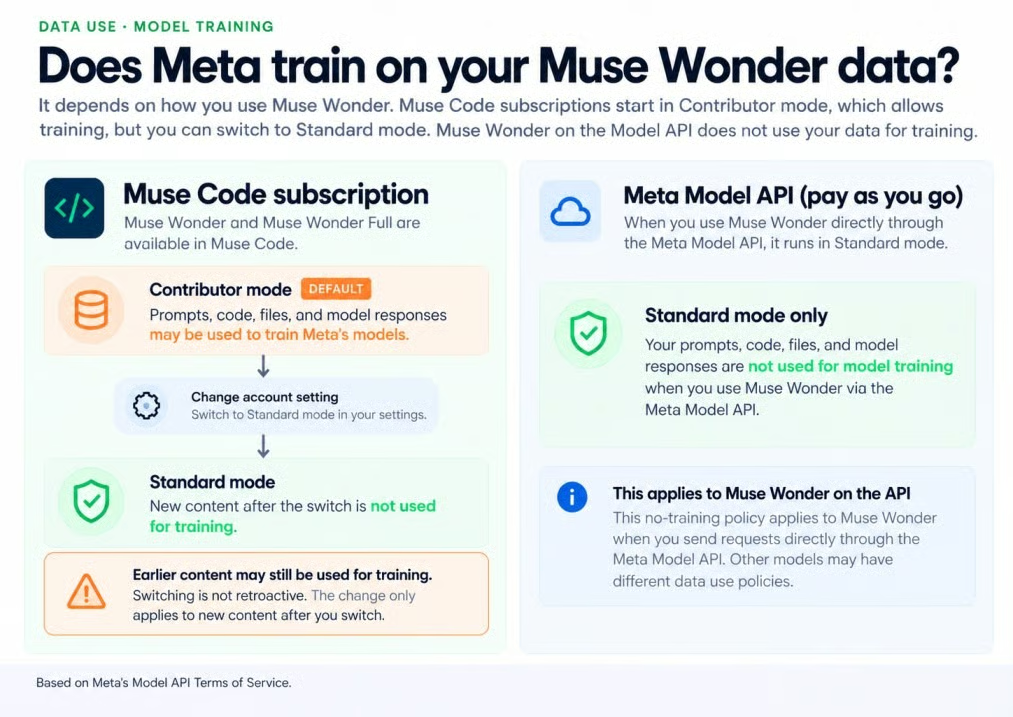
Le contenu Contributor peut entraîner les modèles Meta. Source : Conditions Meta ; image de l’auteur.
Les conditions stipulent aussi que vous ne devez « pas soumettre d’informations sensibles, confidentielles ou personnelles » en mode Contributor, y compris du code privé. Muse Wonder standard via l’API à la consommation fonctionne uniquement en mode Standard.
Meta a testé Muse Wonder Full au regard de son Superintelligence Scaling Framework. Sans garde-fous, Meta ne peut exclure l’atteinte du niveau de risque élevé pour les menaces chimiques et biologiques ; avec garde-fous, tous les risques sont évalués « modérés ou inférieurs ».
Un indice de risque n’est pas une garantie de sécurité, et un rapport plus complet est annoncé « bientôt ». Le conseil de la model card est limpide : exiger une confirmation humaine pour les actions irréversibles et maintenir l’agent dans un bac à sable avec des permissions limitées.
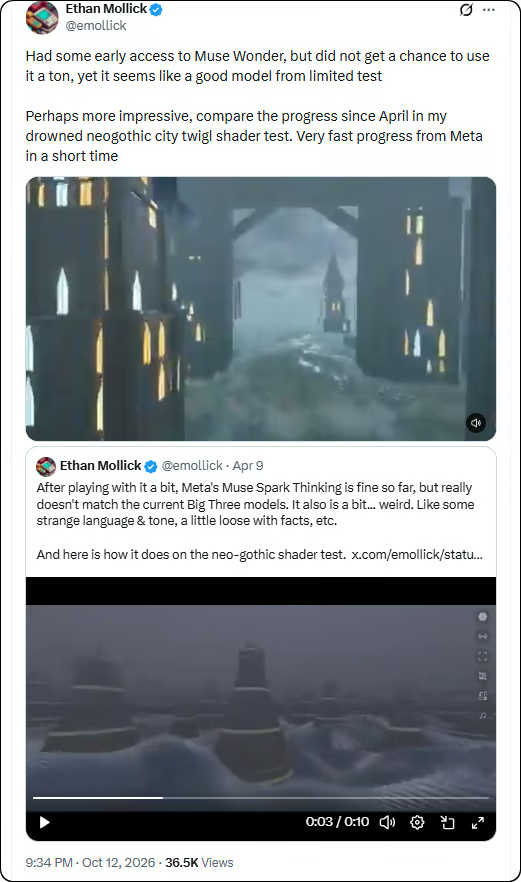
Les réactions le jour du lancement sur X oscillent entre progrès rapide, performances inégales et frustration face aux limites d’usage. Ce sont des tests éclair et des impressions personnelles, pas des évaluations contrôlées.
L’avis positif mais prudent vient d’un testeur précoce au temps d’accès limité, qui a jugé l’ensemble prometteur. Le point marquant : les progrès réalisés par Meta depuis Muse Spark en avril.
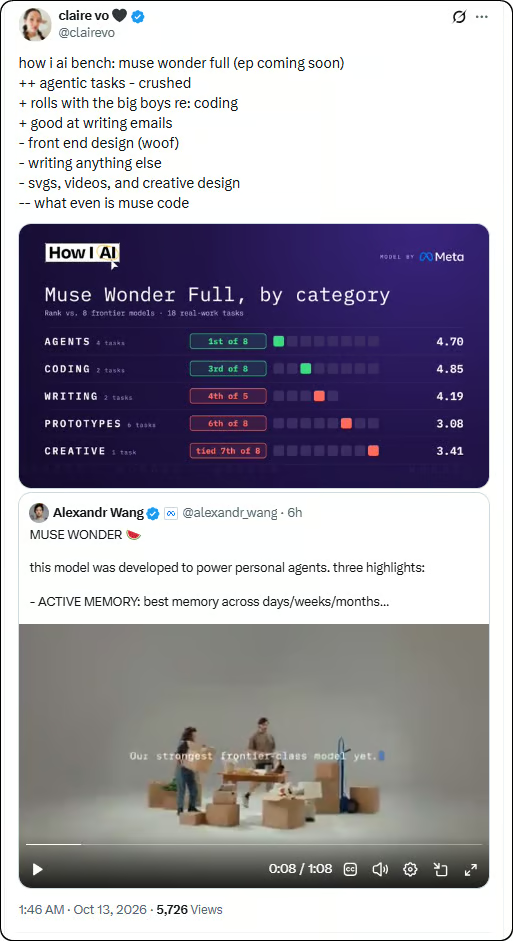
Un test multi-catégories dresse un tableau moins flatteur. Muse Wonder Full figure parmi les meilleurs pour les agents et le codage, mais recule sur la rédaction, le design front-end et la création.
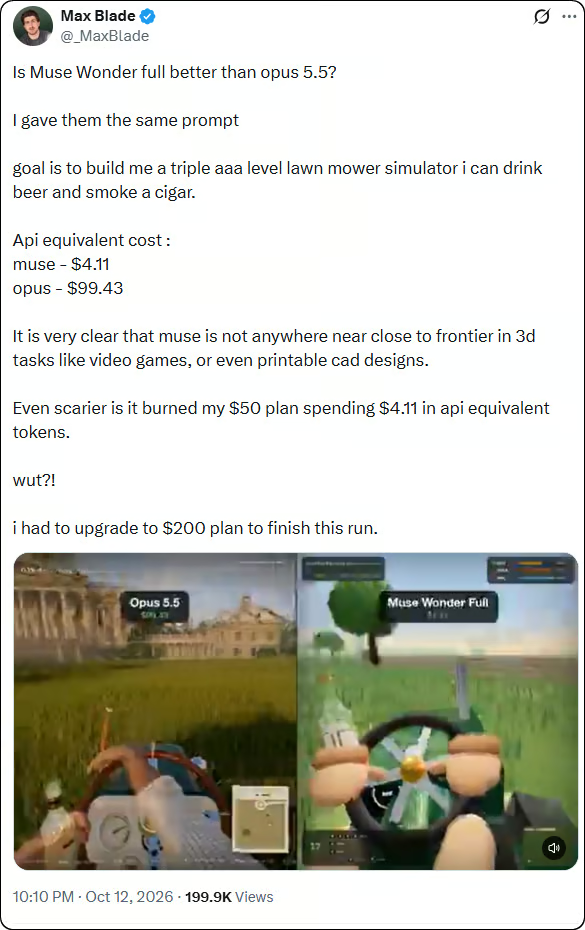
La critique la plus vive porte sur les coûts et les limites d’offre. Sur un test identique de tondeuse, Muse Wonder Full a consommé l’équivalent de 4,11 $ en tokens API mais a produit un résultat 3D plus faible que Claude Opus 5.5, et le testeur indique que finir a nécessité de passer de l’offre à 50 $ à celle à 200 $.
Pris ensemble, ces retours suggèrent un Muse Wonder compétitif mais inconstant. Il faudra des tests répétés avant de considérer un résultat comme typique.
L’essentiel des preuves de lancement provient encore de Meta. Muse Wonder Full n’a pas d’API à l’usage, et Muse Wonder standard coûte autant que Claude Opus 5.5 tout en restant derrière sur plusieurs tests.
Je testerais Muse Wonder standard pour les agents via API et Muse Wonder Full pour les longs travaux sur dépôts. Je garderais Claude Opus 5.5 pour le terminal ou la construction from scratch, et j’opterais pour GPT-6.1 Sol ou Claude Sonnet 5.5 quand le coût prime.
Formez-vous avec DataCamp
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}