{count, plural, other {คอร์ส}}
แนวคิดของ Large Language Models (LLMs)
{hours} ชม.
112.2K
สัปดาห์นี้ Meta ออก Muse Wonder และ Muse Wonder Full ซึ่งเป็นตระกูลโมเดลหลักชุดแรกหลังจาก Muse Spark โดยทั้งสองถูกออกแบบมาสำหรับเอเจนต์ AI ที่จัดการงานหลายขั้นตอน
โพสต์เปิดตัวของ Meta ระบุว่า Muse Wonder เป็นผลจากการสร้างงาน AI ใหม่ตลอด 14 เดือน คำใหม่สองคำที่ควรรู้คือ Active Memory ซึ่งจำรายละเอียดที่เป็นประโยชน์จากบทสนทนาที่ผ่านมา และ Active Focus ซึ่งทำงานต่อเมื่อภารกิจติดขัด
Muse Wonder รุ่นปกติใช้งานได้ผ่าน Meta Model API และ Muse Code ขณะที่ Muse Wonder Full ซึ่งเป็นโมเดลเบื้องหลังผลลัพธ์ส่วนใหญ่ในพาดหัวข่าว ทำงานได้เฉพาะใน Muse Code บนสองแพ็กเกจที่แพงที่สุด เดี๋ยวจะลงรายละเอียดต่อไป
ประเด็นสำคัญจากการเปิดตัว:
Muse Wonder และ Muse Wonder Full เป็นโมเดลด้านการให้เหตุผลที่ Meta เรียกว่าเก่งที่สุดของตนในปัจจุบัน สร้างมาเพื่อเอเจนต์ที่จัดการงานส่วนตัวและงานที่ทำงาน ที่ model card ระบุรับอินพุตแบบข้อความ ภาพ วิดีโอ และเสียง และเอาต์พุตเป็นข้อความเท่านั้น ดังนั้นทั้งสองโมเดลไม่สร้างภาพ วิดีโอ หรือเสียง เอกสารสำหรับนักพัฒนาของ Meta developer docs ยังระบุรองรับไฟล์ PDF และกำหนดหน้าต่างบริบทที่ 1,048,576 โทเค็น
บล็อกวิจัยของ Meta research blog ระบุว่าทั้งสองต่อยอดจากงานฝึกของ Muse Spark และผ่านการฝึกในศูนย์ข้อมูล Prometheus ของ Meta โดยไม่มีการเปิดเผยจำนวนพารามิเตอร์
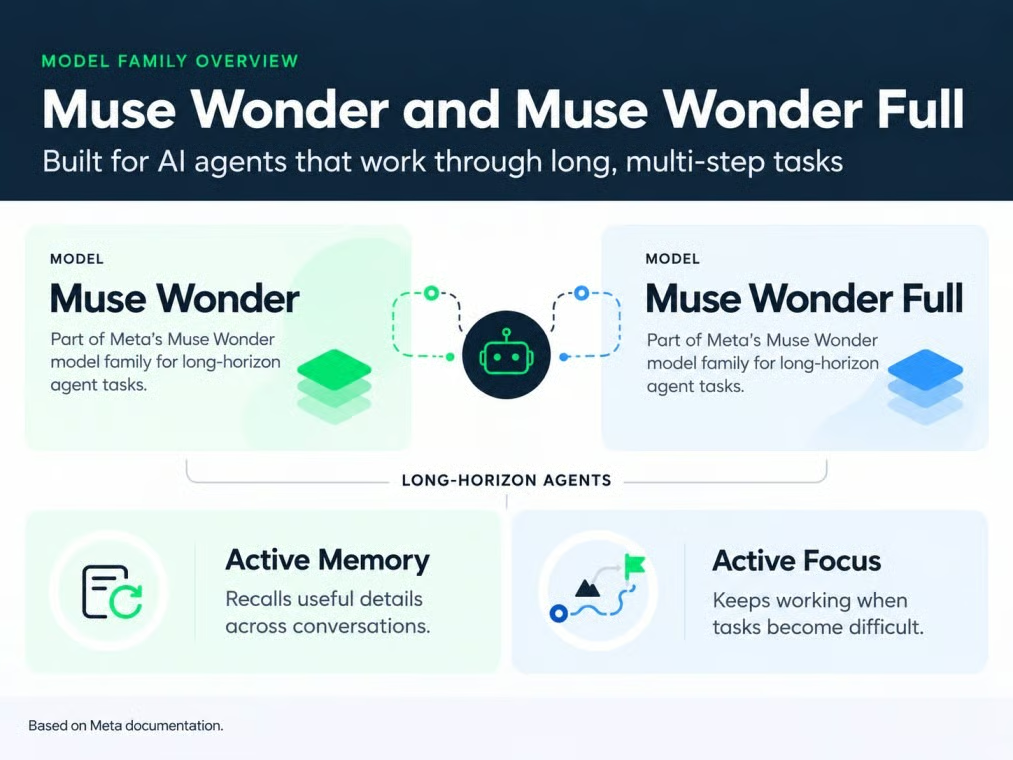
Muse Wonder มีสองรุ่น ภาพโดยผู้เขียน
ระหว่างสองรุ่น Muse Wonder Full เป็นโมเดลที่แยกต่างหากและมีความสามารถมากกว่า เอกสารนักพัฒนาระบุว่าการปรับ Muse Wonder รุ่นปกติ (muse-wonder-1.0) ไปที่เหตุผลระดับ "max" ไม่ได้ทำให้กลายเป็น Muse Wonder Full (muse-wonder-full-1.0)
อาจสังเกตได้ว่า Meta ใช้ชื่อ Muse กับหลายสิ่ง สรุปอีกครั้ง:
เมื่อ Meta บอกว่า Muse Wonder "ทำ" บางอย่าง มักเป็น Muse Code ที่ช่วยทำงานอยู่ครึ่งหนึ่ง ข้อนี้ใช้กับผลด้านโค้ดส่วนใหญ่ด้านล่าง
คุณสมบัติหลักของ Muse Wonder คือ Active Memory และ Active Focus และงานโค้ดระยะยาวคือเวทีที่ Meta นำมาโชว์ แนวคิดของทั้งสองตรงไปตรงมา: เอเจนต์ต้องจำรายละเอียดที่ถูกต้องและเดินหน้าต่อเมื่อแผนล้มเหลว
Active Memory เป็นคำที่ Meta ใช้เรียกความสามารถในการพารายละเอียดสำคัญข้ามบทสนทนาและดึงสิ่งที่ต้องใช้ตอนนี้ สมมติว่าตั้งงบทำโฮมออฟฟิศไว้ $3,000 ในเดือนมีนาคม เพิ่มเป็น $4,000 ในเดือนเมษายน และขอรายการเฟอร์นิเจอร์ในเดือนพฤษภาคม หน่วยความจำที่ดีหมายถึงเอเจนต์จะใช้งบเดือนเมษายนโดยไม่ต้องเตือน
หลักฐานของ Meta คือ MemoryBench การทดสอบบทสนทนายาวของตนเองที่มีการอัปเดตข้อเท็จจริง Muse Wonder ทำได้ 85.6 แต่ไม่ได้บอกอะไรเกี่ยวกับการจำเป็นเวลาหลายเดือน และแอปที่สร้างบน API ก็ยังต้องเก็บข้อเท็จจริงเหล่านั้นเอง นี่คือฟีเจอร์ที่อยากรู้ที่สุด เพราะเอเจนต์ที่ทำงานจากงบเก่าอาจทำให้เสียเงินได้
Active Focus เป็นชื่อที่ Meta ใช้เรียกความเพียรพยายาม: ลองแนวทางใหม่ ฝ่าด่านปัญหา และตรวจสอบก่อนทำการสำคัญๆ ลองนึกภาพการย้ายโค้ดที่มีเทสต์ล้ม 30 รายการ เอเจนต์ที่มีสมาธิจะปรับโค้ดและรันเทสต์ใหม่ ในขณะที่ตัวที่อ่อนกว่าจะแก้เทสต์ให้ผ่านแทน
Meta วัดด้วย FocusBench ซึ่งเป็นการทดสอบของตนเองอีกชุด และด้วย SWE-Marathon ซึ่งจะกล่าวถึงในส่วนเกณฑ์ทดสอบ ทั้งสองอย่างไม่ได้รับประกันว่างานจะเสร็จ และการทำงานเบื้องหลังขึ้นกับซอฟต์แวร์รอบโมเดล ซึ่งเป็นความเสี่ยงที่ บทอธิบาย OpenAI Dots ของเราครอบคลุมสำหรับเอเจนต์แบบทำงานตลอดเวลา
Muse Wonder วางแผนงานโค้ดระยะยาวและแบ่งงานให้เอเจนต์ผู้ช่วย ขณะที่ Muse Code รันเครื่องมือและการขออนุมัติ หน้าเว็บนักพัฒนา ของ Meta โปรโมตสำหรับงานที่ "รันเป็นชั่วโมง" โดยแก้ไขไฟล์จำนวนมากพร้อมกัน
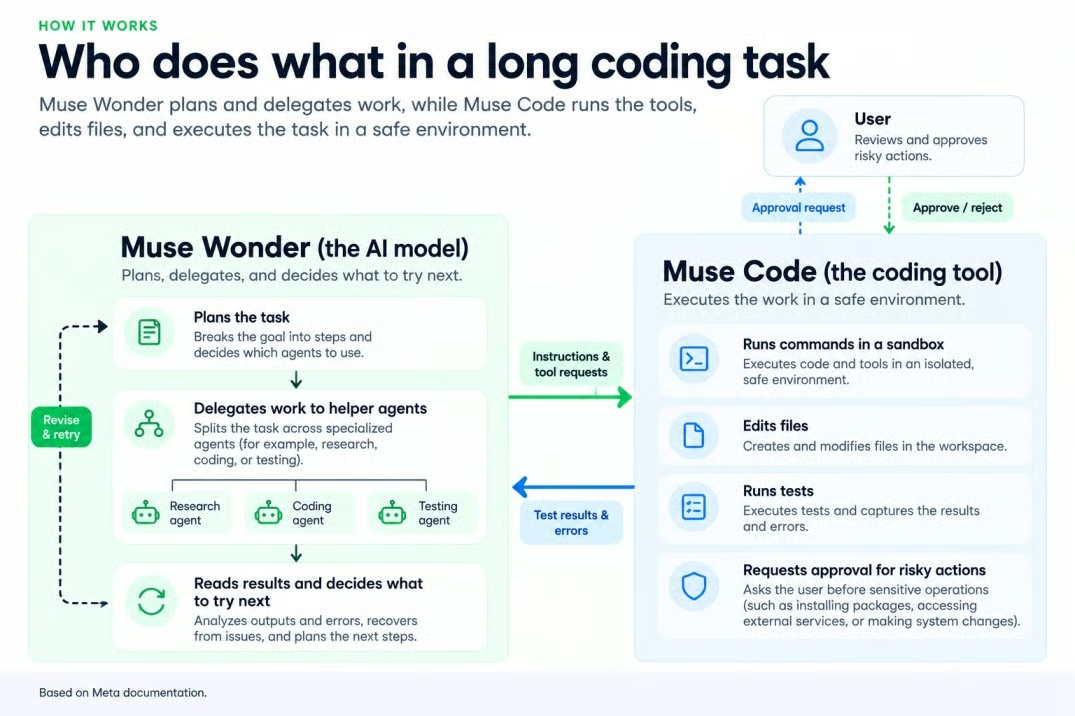
Muse Wonder วางแผน; Muse Code ดำเนินการ ภาพโดยผู้เขียน
เดโมหนึ่งของ Meta เป็นเกมครัว 3 มิติแบบเล่นได้ที่สร้างจากภาพ เป็นตัวอย่างที่แปลก เพราะใน model card ระบุว่าการให้เหตุผลเชิงพื้นที่ 3 มิติเป็นจุดอ่อนที่ทราบ (คงเลือกเดโมอื่น)
ตารางของ Meta เข้าข้าง Muse Wonder Full ในงานโค้ดระยะยาวและบางเกณฑ์ระดับมืออาชีพ ขณะที่ Claude Opus 5.5 นำหน้าในงานโค้ดผ่านเทอร์มินัลและการสร้างโปรแกรมจากศูนย์ ตัวเลขด้านล่างเป็นของ Meta เว้นแต่ระบุไว้ โดยเกือบทุกโมเดลตั้งที่เหตุผลระดับสูงสุด (จะระบุข้อยกเว้นไว้)
Muse Wonder Full นำสองการทดสอบงานโค้ดระยะยาวในตารางของ Meta ตามที่กล่าวในบทนำ มันได้ 79.0 บน DeepSWE v1.1 โดย Muse Wonder รุ่นปกติไล่มาที่ 78.8 นั่นเป็นตัวเลขของ Meta ณ ตอนนี้ เพราะบอร์ดจัดอันดับ DeepSWE สาธารณะของ Datacurve ยังไม่แสดง Muse Wonder
SWE-Marathon เป็นตัวที่น่าจับตา เพราะโปรเจกต์ 20 รายการที่ใช้เวลาหลายชั่วโมงจะได้ศูนย์ทันทีหากเทสต์ใดเทสต์หนึ่งล้มเหลว Meta รายงาน Muse Wonder Full ที่ 57.5 (ต่ำกว่าระดับสูงสุดหนึ่งขั้น) และ Muse Wonder ที่ 53.1 เทียบกับ Claude Opus 5.5 ที่ 46.3 และ GPT-6 Astra ที่ 42.5 โมเดลคู่แข่งรันภายในเครื่องมือโค้ดของบริษัทตนเอง ดังนั้น Meta เองก็บอกว่าเปรียบเทียบไม่ยุติธรรมเต็มที่ และด้วยโปรเจกต์เพียง 20 รายการ โปรเจกต์เดียวสามารถเหวี่ยงคะแนนได้หลายจุด
กระดานผู้นำ SWE-Marathon ของ Abundant AI เองให้ภาพที่เรียบลง: Muse Wonder Full อยู่ที่ 53.1% และ Muse Wonder ปกติที่ 52.5% ทั้งคู่อยู่ที่ระดับเหตุผลสูงสุดใน Muse Code นำหน้า Claude Sonnet 5.5 เล็กน้อยที่ 51.3% Claude Haiku 5.5 ที่ Anthropic ออกรุ่นก่อนหน้านั้นห้าวันอยู่ที่ 50.0% รายการทั้งสองมาจากการทดสอบคนละชุด อย่านำมาปนกัน
ข้ออ้างของ Meta ว่า Muse Wonder สามารถทำงานข้ามแอปได้รับการสนับสนุนแบบคละกัน บน AutomationBench-AA ซึ่งตรวจว่ากระบวนงานธุรกิจจบในสถานะที่ถูกต้องหรือไม่ Muse Wonder Full ได้ 45.4 เทียบกับ GPT-6 Astra ที่ 41.6 และ Claude Opus 5.5 ที่ 41.2 จึงนำหน้าแม้ยังล้มเหลวในกระบวนงานส่วนใหญ่
OSWorld V2.1 ชุดงานเดสก์ท็อป 108 รายการ บอกได้มากกว่า Muse Wonder Full ได้ 78.4 ในคะแนนบางส่วน แต่ทำงานสำเร็จเต็มรูปแบบเพียง 39.4% และโมเดล Claude ทั้งสองยังได้คะแนนบางส่วนสูงกว่า สำหรับฟอร์มประกันภัย การทำถูกส่วนใหญ่ยังถือว่าล้มเหลว ดังนั้น 39.4% คือเลขที่ควรจับตา
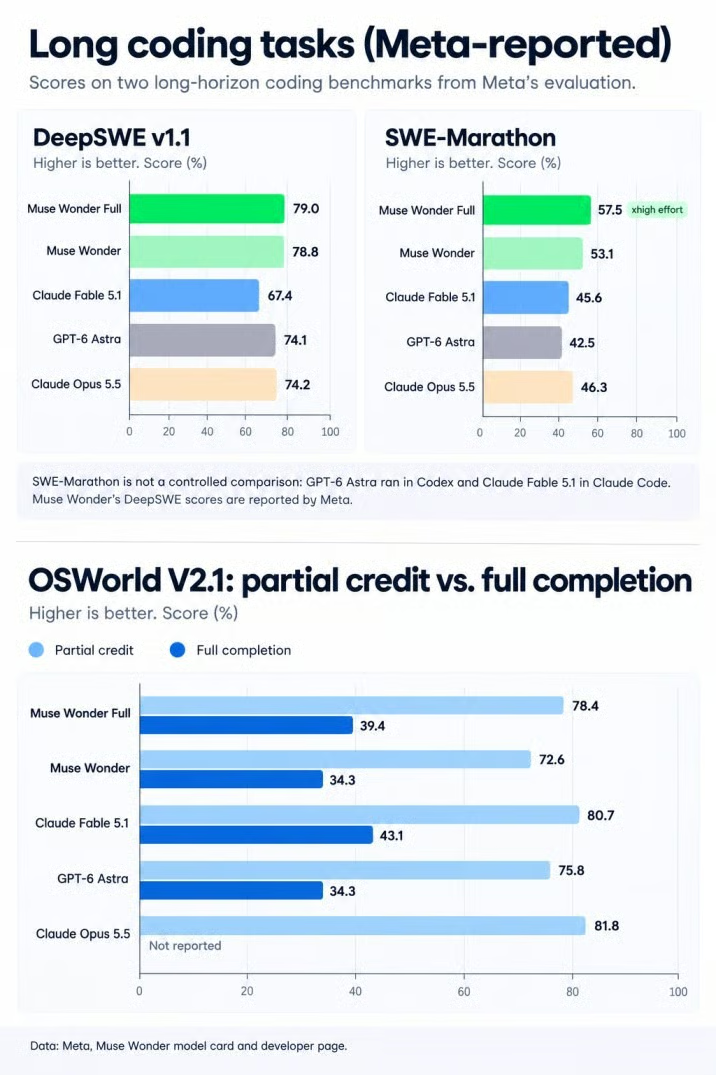
ความเป็นผู้นำด้านโค้ดซ่อนอัตราการทำงานเสร็จที่ต่ำกว่า ที่มา: Meta; ภาพโดยผู้เขียน
Muse Wonder Full นำหน้าในเกณฑ์กฎหมายและตามหลังในด้านสุขภาพ โดยการเงินใกล้เคียงเสมอไป คะแนนด้านกฎหมายฟังดูเล็ก แต่ยังมากกว่า Claude Opus 5.5 สามเท่า ใน เวอร์ชันของ Artificial Analysis เอกสารกฎหมายจะนับได้เฉพาะเมื่อครบทุกข้อกำหนดและไม่มีเนื้อหาที่แต่งขึ้น Muse Wonder Full ได้ 13.1 เทียบกับ Claude Opus 5.5 ที่ 4.2 ซึ่งยังหมายถึงล้มเหลวประมาณ 87% ของงาน
ด้านการเงินสูสี โดย Muse Wonder Full ได้ 59.1 บน Vals Finance Agent V2 เทียบกับ Claude Opus 5.5 ที่ 58.6 ด้านสุขภาพสวนทาง: Muse Wonder Full ได้ 62.3 บน HealthBench Pro ตามหลัง Claude Opus 5.5 (65.6) และ GPT-6 Astra (65.3)
Muse Wonder Full ตามหลัง Claude Opus 5.5 ใน 6 จาก 14 การทดสอบในตารางของ Meta เอง และ GPT-6 Astra ชนะมันใน 3 รายการ ตารางนี้รวบรวมการพ่ายแพ้ที่ยังไม่ได้กล่าวถึงด้านบน
|
เกณฑ์ |
ทดสอบอะไร |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
โค้ดผ่านเทอร์มินัล |
57.1 |
52.0 |
59.1 |
59.6 |
52.0 |
|
ProgramBench |
สร้างโปรแกรมจากศูนย์ |
59.0 |
50.0 |
52.5 |
70.5 |
55.5 |
|
AA Intelligence Index v4.3 |
ดัชนีผสมกว้าง |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
การใช้เครื่องมือระดับมืออาชีพ |
75.3 |
70.5 |
66.1 |
75.4 |
73.1 |
|
GDP.pdf |
ทำงานจากไฟล์ PDF |
33.2 |
30.8 |
34.2 |
30.6 |
27.6 |
ที่มา: หน้าเว็บนักพัฒนา Muse Wonder ตอนเปิดตัว โมเดลทั้งหมดตั้งที่เหตุผลระดับสูงสุด
ProgramBench คือการพ่ายแพ้ที่ผู้พัฒนาโค้ดควรใส่ใจ และช่องว่างก็ห่างมาก มันทดสอบให้โมเดลสร้างโปรแกรมใหม่จากศูนย์ และช่องว่าง 11.5 คะแนนแสดงว่าการแก้โค้ดในฐานที่มีอยู่กับการสร้างจากไม่มีอะไรเป็นทักษะที่ต่างกัน
Artificial Analysis ระบุ Muse Wonder Full ที่ 55.8 ซึ่งตารางของ Meta ปัดขึ้นเป็น 56 ขณะที่ Claude Sonnet 5.5 ทำได้ 56.0
จะเชื่อผลเกณฑ์ทดสอบของ Muse Wonder ได้แค่ไหน? ไม่เต็มที่ model card ของ Meta แสดงว่าตารางผสมหลักฐานสามแบบ:
อย่างที่กล่าวไว้ คะแนนแทบทั้งหมดใช้การตั้งค่าเหตุผลสูงสุด จึงเป็นการเห็นแต่ละโมเดลในสภาพที่ดีที่สุด ผลยังเปลี่ยนตามผู้ทดสอบด้วย: Anthropic รายงาน 66.4% สำหรับ Claude Opus 5.5 บน Terminal-Bench 4.0 เทียบกับ 59.6 ในตารางของ Meta ข้ออ้างของ Meta ว่า Muse Wonder Full จัดการงานที่ไม่คุ้นเคยได้ดีกว่าโมเดล Spark ตั้งอยู่บนการวิเคราะห์ของตนเอง
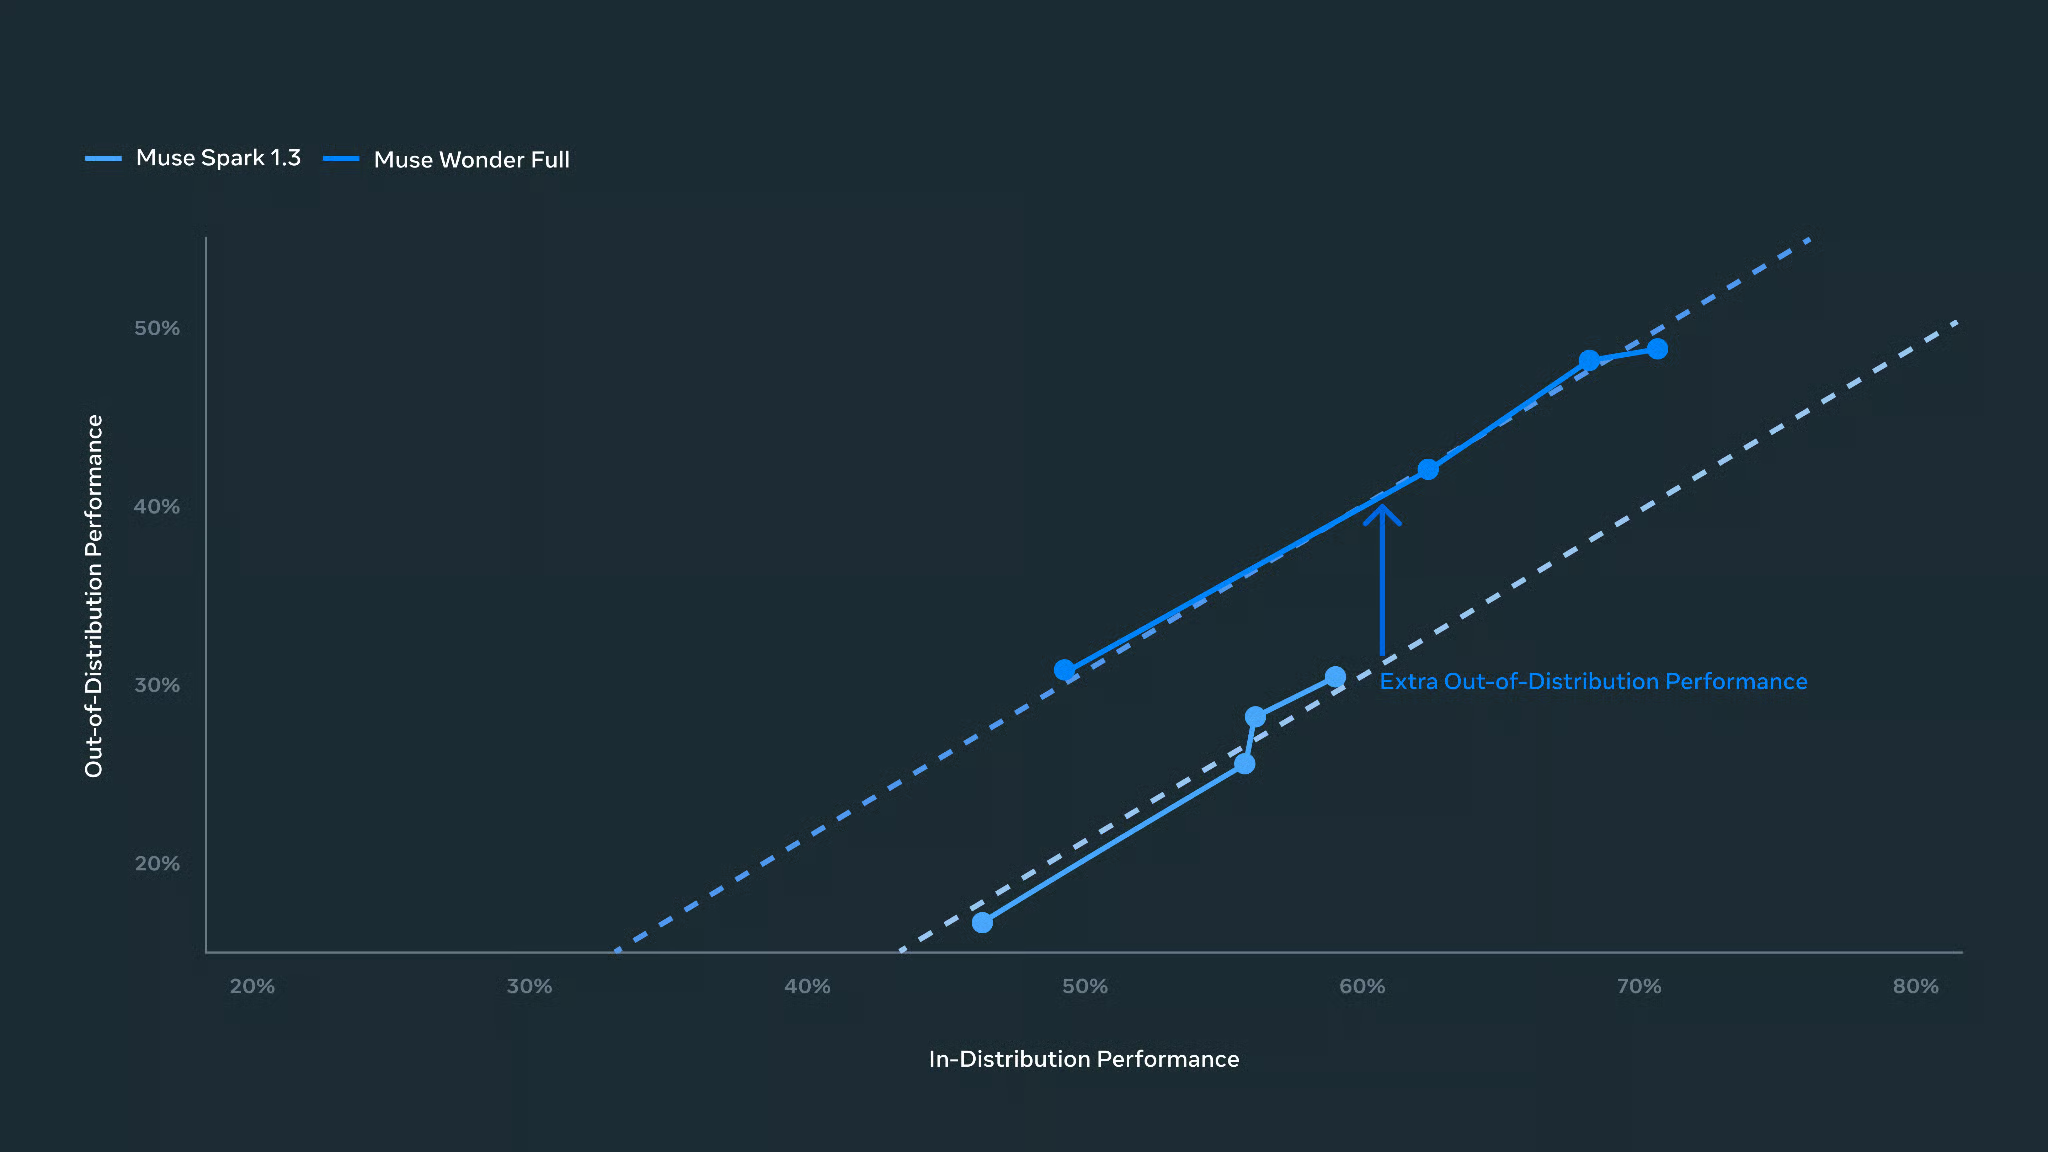
Meta เปรียบเทียบประสิทธิภาพบนงานที่ไม่คุ้นเคย ที่มา: Meta
ตามตัวเลขของ Meta Muse Wonder Full ชนะในงานโค้ดระยะยาว (แต่เฉพาะภายใน Muse Code) Claude Opus 5.5 ชนะงานเทอร์มินัลและการสร้างจากศูนย์ และ GPT-6 Astra นำเพียงแถวเดียวในตารางของ Meta ส่วนนี้รวบรวมเกณฑ์ทดสอบ จึงอาจคุ้นหู
ระบบอัตโนมัติผลออกมาปนกัน เพราะ Muse Wonder Full นำบน AutomationBench-AA ขณะที่โมเดล Claude นำบนคะแนนบางส่วนของ OSWorld ในบรรดาโมเดลที่มีคะแนนการทำงานเสร็จเต็มรูปแบบ รายใดๆ ก็ยังไม่ทำสำเร็จเกินครึ่ง ด้านการให้เหตุผลกว้าง Claude Opus 5.5 นำบนดัชนีของ Artificial Analysis ที่ Muse Wonder รุ่นปกติได้ 52.4
ราคาเป็นจุดที่ Muse Wonder รุ่นปกติดูด้อยกว่า GPT-6.1 Sol มีราคาโทเค็นครึ่งหนึ่งและได้ 51.8 บนดัชนีเดียวกัน และ Claude Sonnet 5.5 มีราคาเท่ากับ GPT-6.1 Sol
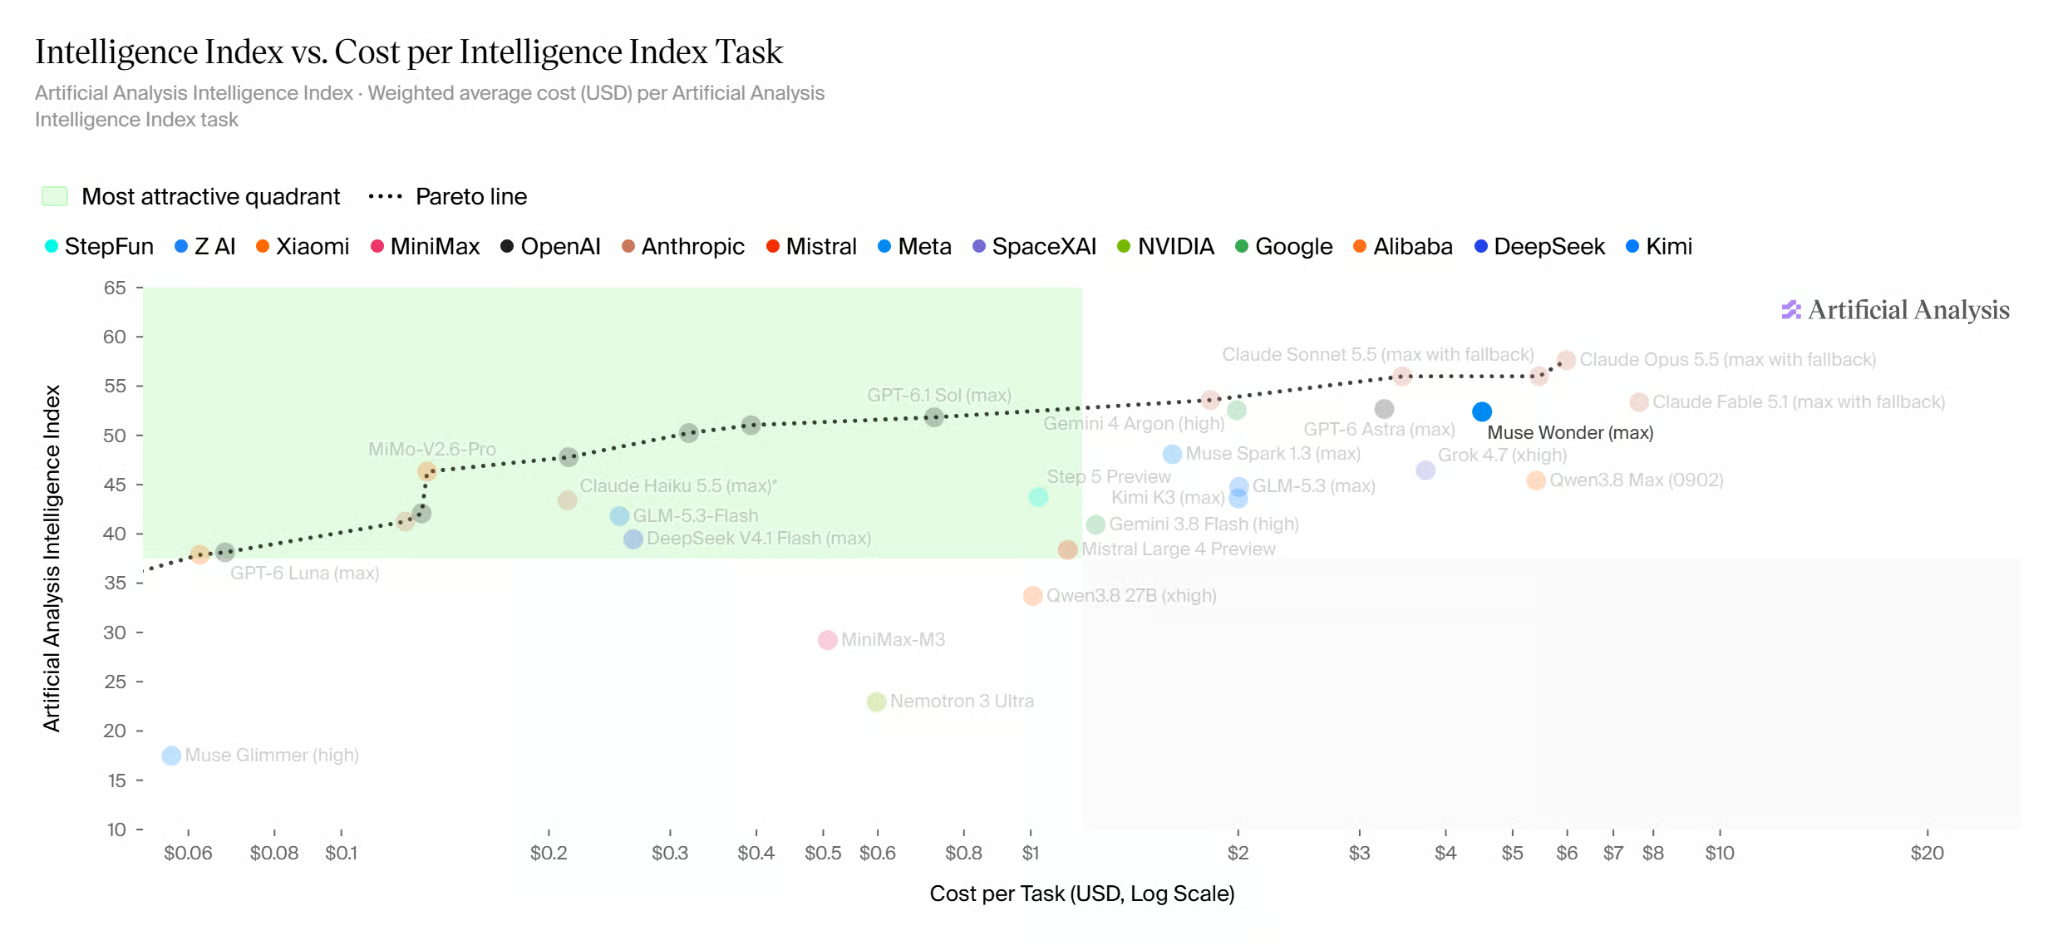
Muse Wonder แลกเปลี่ยนต้นทุนกับความฉลาด ที่มา: Artificial Analysis
แทบจะตัด Gemini 4 Argon ออกจากส่วนนี้ เพราะ Meta ไม่ได้ทดสอบ และตาม ความคุ้มครอง Gemini 4 Argon ของเรา มันถูกส่งให้ทีมความปลอดภัยไซเบอร์ที่เชื่อถือได้ก่อน ไม่มีผลร่วมกันก็ไม่มีการเทียบตัวต่อตัวที่ยุติธรรม ดังนั้นควรเลือกตามภาระงานและต้นทุนต่อภารกิจที่ทำเสร็จ
Muse Wonder เหมาะกับงานสองแบบ: การเปลี่ยนแปลงซอฟต์แวร์ขนาดใหญ่ และเวิร์กโฟลว์บนเบราว์เซอร์หลายขั้นตอน งานวางแผนระยะยาว เช่น เดโมผังที่นั่งงานแต่งของ Meta ขึ้นอยู่กับแอปรอบๆ โมเดลมากกว่า
กรณีนี้มีหลักฐานแข็งแรงที่สุด อย่างน้อยสำหรับการแก้โค้ดที่มีอยู่แล้ว ใน Muse Code Muse Wonder ทำงานข้ามไฟล์ รันเทสต์ อ่านข้อผิดพลาด และลองใหม่ ซึ่งเป็นสิ่งที่ DeepSWE และ SWE-Marathon วัด บนโค้ดจริง ควรให้สิทธิ์เท่าที่งานต้องใช้และให้คนตรวจทานการเปลี่ยนแปลง
เดโม Saturday Run Planning ของ Meta แสดง Muse Wonder ที่ "ทำงานโดยตรงในเบราว์เซอร์และข้ามแอป" และเดโมอีกตัวจัดการเคลมประกันภัย เนื่องจาก Muse Wonder Full ทำงานเดสก์ท็อปเสร็จสมบูรณ์น้อยกว่า 4 ใน 10 งาน เวิร์กโฟลว์จริงควรต้องได้รับอนุมัติก่อนยื่นหรือจ่ายอะไร
การจ่ายเงินมีสองทาง: คิดตามโทเค็นสำหรับ Muse Wonder รุ่นปกติ หรือเหมาจ่ายรายเดือนของ Muse Code ซึ่งอย่างที่กล่าวในบทนำ เป็นทางเดียวที่จะได้ใช้ Muse Wonder Full
หน้า ราคา ของ Meta ระบุ Muse Wonder รุ่นปกติที่ $4.00 ต่อหนึ่งล้านโทเค็นอินพุต $0.20 สำหรับอินพุตที่แคช และ $20.00 สำหรับเอาต์พุต ซึ่งเป็นการกระโดดจากราคา $1.25 และ $4.25 ของ Muse Spark 1.3 และเท่ากับ ราคา Claude Opus 5.5 ซึ่งบอกตำแหน่งที่ Meta มองว่า Muse Wonder ยืนอยู่
GPT-6 Astra ตั้งราคาไว้ที่ $10 $1 สำหรับแคช และ $50 และ GPT-6.1 Sol ที่ $2, $0.10 และ $10 สมมติฐานด้านล่างใช้ราคาวันเปิดตัวกับงานโค้ดหนึ่งงานที่มีอินพุต 3 ล้านโทเค็น (แคช 2.4 ล้าน) และเอาต์พุต 200,000 โทเค็น โดยสมมติว่าไม่มีคำขอใดเกิน 272,000 โทเค็น ซึ่งเป็นจุดที่ราคา GPT-6 Astra สูงขึ้น
|
โมเดล |
อินพุตไม่แคช (0.6M) |
อินพุตแคช (2.4M) |
เอาต์พุต (0.2M) |
รวมต่อภารกิจ |
|
Muse Wonder |
$2.40 |
$0.48 |
$4.00 |
$6.88 |
|
Claude Opus 5.5 |
$2.40 |
$0.48 |
$4.00 |
$6.88 |
|
GPT-6 Astra |
$6.00 |
$2.40 |
$10.00 |
$18.40 |
|
GPT-6.1 Sol |
$1.20 |
$0.24 |
$2.00 |
$3.44 |
ราคาโทเค็นเท่ากันหมายถึงบิลเท่ากันต่อครั้ง ดังนั้นตัวเลขที่ควรเปรียบเทียบคือค่าต่อภารกิจที่ทำเสร็จ หาก Muse Wonder ทำเสร็จหนึ่งในสองครั้ง เท่ากับ $13.76 ซึ่งเท่ากับโมเดลที่มีราคาแบบ GPT-6.1 Sol ทำเสร็จหนึ่งในสี่ครั้ง (ทั้งสองอัตราเป็นสมมติในตัวอย่าง)
Muse Wonder Full มีเฉพาะในแผนรายเดือนของ Muse Code ซึ่งคิดแบบเหมาจ่ายไม่ใช่ตามโทเค็น ข้ามส่วนนี้ได้หากตั้งใจใช้แค่ API เอกสารการสมัครของ Meta subscriptions documentation ระบุ 4 แผน:
หน้า ผลิตภัณฑ์ Muse Code ของ Meta แสดงราคาเฉพาะ Power และ Maximum ซึ่งเป็นเรื่องแปลกที่จะเว้นไว้ จึงควรตรวจราคาแผนล่างที่หน้าชำระเงิน Muse Wonder รุ่นปกติอยู่ในทุกแผน
แต่ละแผนมีขีดจำกัดการใช้งานที่รีเซ็ตตามเวลา โควตาที่ไม่ได้ใช้ไม่ทบยอด และการสมัครใช้ไม่ได้เป็นเครดิต API
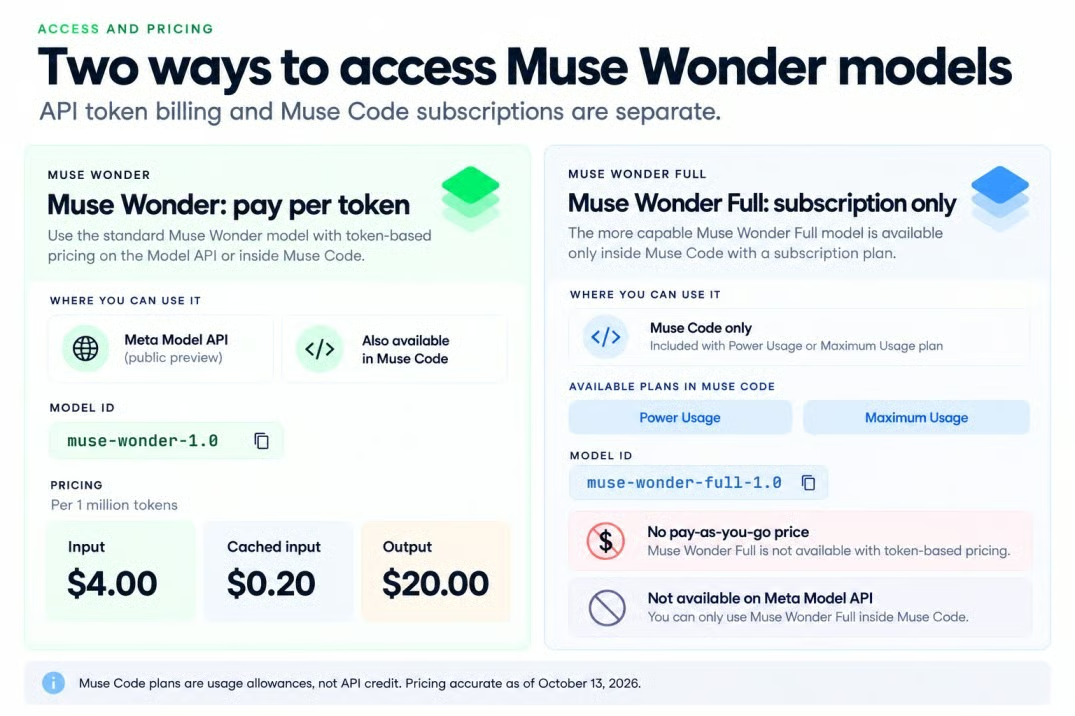
ราคา Muse Wonder มีสองเส้นทาง ที่มา: Meta; ภาพโดยผู้เขียน
Power เป็นวิธีที่ถูกที่สุดในการลอง Muse Wonder Full แม้ Meta ยังไม่บอกว่าโควตาครอบคลุมงานขนาดใหญ่กี่งาน นี่คือส่วนที่ควรจับตา เพราะผู้ใช้กลุ่มแรกคนหนึ่งกล่าวว่าคำขอเล็กๆ ไม่กี่ครั้งใช้โควตาครึ่งหนึ่งของแผนเริ่มต้นในกรอบเวลา 5 ชั่วโมง ซึ่งจะกล่าวถึงในเสียงสะท้อนจากนักพัฒนา
สรุปการแบ่งจากบทนำ: Muse Wonder รุ่นปกติใช้งานได้ผ่าน Meta Model API และ Muse Code ส่วน Muse Wonder Full มีเฉพาะผ่าน Muse Code
การใช้ API ของ Muse Wonder ต้องมีบัญชีนักพัฒนา Meta คีย์ API และการตั้งค่าการเรียกเก็บเงิน โดยรหัสโมเดลคือ muse-wonder-1.0 Meta ยังเรียก API ว่าเป็น "public preview" บนหน้าโปรดักต์ โค้ดที่พัฒนาบน SDK ของ OpenAI สามารถชี้มาที่นี่ได้ และ Meta ยังระบุ OpenRouter เป็นอีกเส้นทางหนึ่ง
การเข้าถึงไม่ได้เปิดทั่วโลก Geographic Use Policy ของ Meta บล็อกหลายพื้นที่ รวมถึงจีน รัสเซีย อิหร่าน ปากีสถาน เอริเทรีย และเอธิโอเปีย
การใช้ Muse Wonder Full ต้องมีแผน Muse Code แบบ Power หรือ Maximum มีบัญชี Meta และมีอายุ 18 ปีหรือบรรลุนิติภาวะตามที่อยู่อาศัย อย่างที่กล่าวในส่วนราคา มันไม่มีบน Model API ไม่ว่าราคาเท่าไร และรหัส muse-wonder-full-1.0 ใช้ได้ภายใน Muse Code เท่านั้น เอกสารของ Muse Code ระบุ macOS, Linux และ Windows แม้หน้าโปรดักต์จะกล่าวถึงเพียง macOS และ Windows
ความเสี่ยงมาจากสิ่งเดียวกับที่ Meta โปรโมต: การทำงานยาวนานและการเข้าถึงไฟล์ส่วนตัว
model card ระบุจุดอ่อนสามข้อที่มีผลต่อเอเจนต์ แต่ละข้อก่อปัญหาต่างกัน:
นี่ไม่ใช่ปัญหาคุณภาพคำตอบแบบโดดๆ เมื่อโมเดลใช้เครื่องมือได้ การคลิกผิดหรือสมมติฐานที่ผิดตั้งแต่ต้นในงานสองชั่วโมงอาจทำให้ส่วนที่เหลือเสียหาย
ขึ้นกับโหมด จึงควรอ่านก่อนชี้ Muse Code ไปยังรีโพส่วนตัว ข้อกำหนดการให้บริการ ของ Meta ที่อัปเดตสามวันก่อนเปิดตัว ระบุว่า Meta จะไม่ฝึกบนเนื้อหาที่ส่งให้บริการ Standard ในขณะที่เนื้อหาที่ส่งในโหมด Contributor อาจถูกใช้เพื่อ "ฝึก พัฒนา ประเมิน และปรับปรุง" โมเดลของตน
การสมัคร Muse Code เริ่มในโหมด Contributor แลกกับโควตาที่มากขึ้น และต้องสลับเป็น Standard ในการตั้งค่า การสลับมีผลเฉพาะในอนาคต ดังนั้นสิ่งที่เคยส่งไปแล้วยังคงถูกใช้เพื่อฝึกได้ ค่าเริ่มต้นแบบนี้ไม่น่าชอบเท่าไร
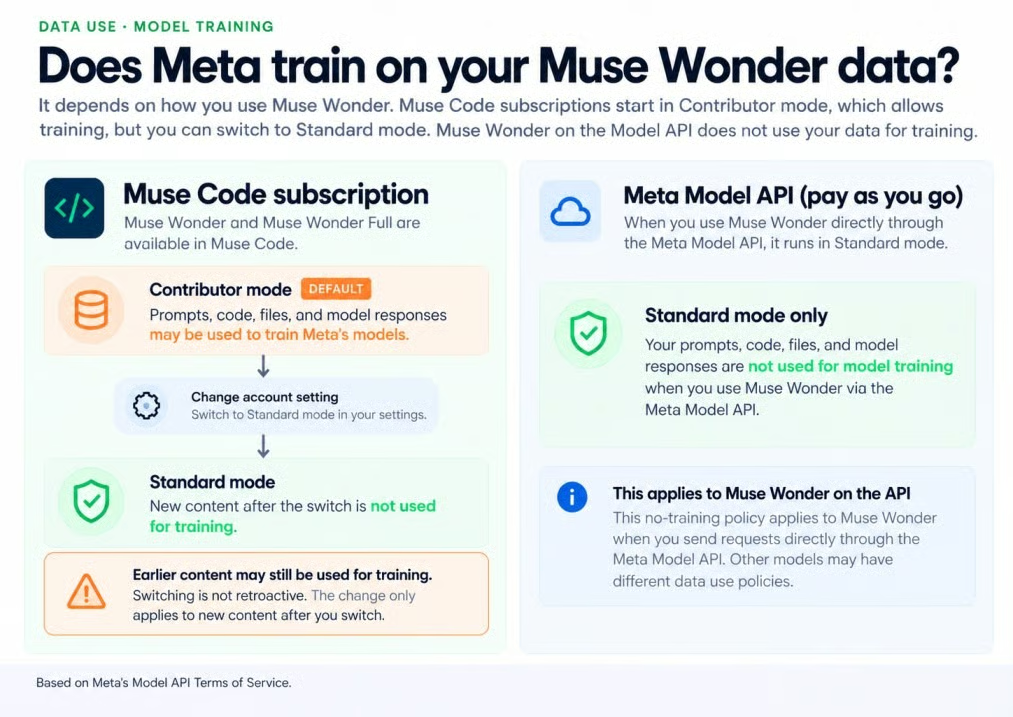
เนื้อหา Contributor อาจถูกใช้ฝึกโมเดลของ Meta ที่มา: ข้อกำหนดของ Meta; ภาพโดยผู้เขียน
ข้อกำหนดยังระบุว่า "ห้ามส่งข้อมูลที่อ่อนไหว ลับ หรือส่วนบุคคล" ในโหมด Contributor รวมถึงโค้ดส่วนตัว Muse Wonder รุ่นปกติบน API แบบจ่ายตามใช้ทำงานในโหมด Standard เท่านั้น
Meta ทดสอบ Muse Wonder Full ภายใต้ Superintelligence Scaling Framework ของตน หากไม่มีมาตรการคุ้มครอง Meta ไม่ตัดความเป็นไปได้ว่าจะถึงระดับความเสี่ยงสูงสำหรับภัยคุกคามทางเคมีและชีวภาพ และเมื่อมีมาตรการคุ้มครองจะประเมินทุกด้านความเสี่ยงว่า "ปานกลางหรือต่ำกว่า"
การให้ระดับความเสี่ยงไม่ใช่การรับประกันความปลอดภัย และรายงานความปลอดภัยฉบับเต็มจะตามมา "เร็วๆ นี้" คำแนะนำใน model card เรียบง่าย: ต้องให้มนุษย์ยืนยันสำหรับการกระทำที่ย้อนกลับไม่ได้ และเก็บเอเจนต์ไว้ใน sandbox ที่มีสิทธิ์จำกัด
ปฏิกิริยาวันเปิดตัวบน X แบ่งระหว่างความก้าวหน้าอย่างรวดเร็ว ประสิทธิภาพที่ไม่สม่ำเสมอ และความหงุดหงิดกับขีดจำกัดการใช้งาน เหล่านี้เป็นการทดสอบสั้นๆ และความเห็นส่วนตัว ไม่ใช่การประเมินแบบควบคุม
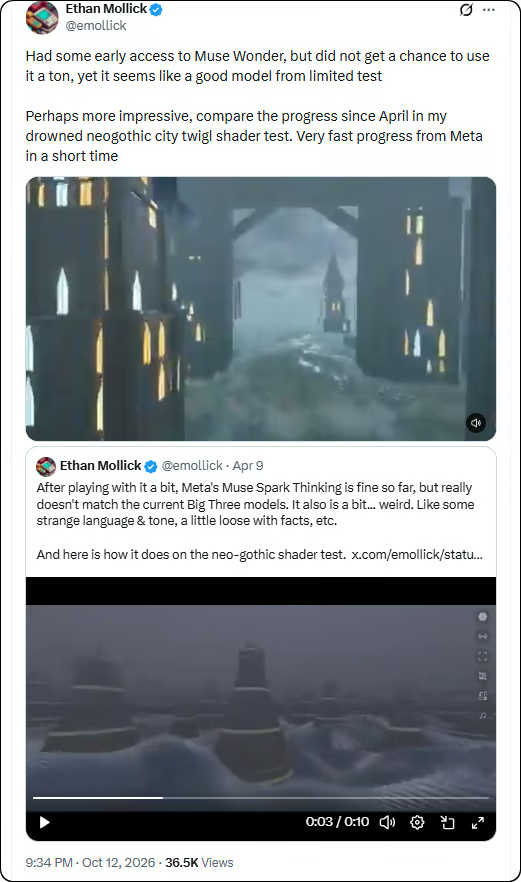
มุมมองเชิงบวกอย่างระมัดระวังมาจากผู้ทดสอบช่วงแรกซึ่งมีเวลาจำกัดกับ Muse Wonder แต่คิดว่าดูดี ประเด็นใหญ่คือโมเดลของ Meta ก้าวไกลจาก Muse Spark ในเดือนเมษายนมากเพียงใด
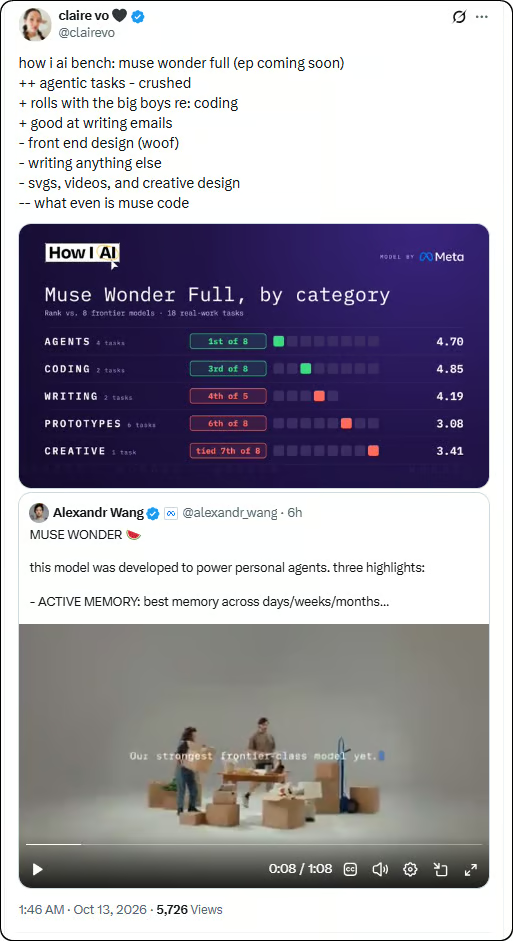
การทดสอบหมวดหมู่กว้างให้ภาพที่ไม่เนี้ยบเท่า Muse Wonder Full อยู่ใกล้หัวแถวสำหรับเอเจนต์และงานโค้ด แต่ตามหลังด้านการเขียน ออกแบบส่วนหน้า และงานสร้างสรรค์
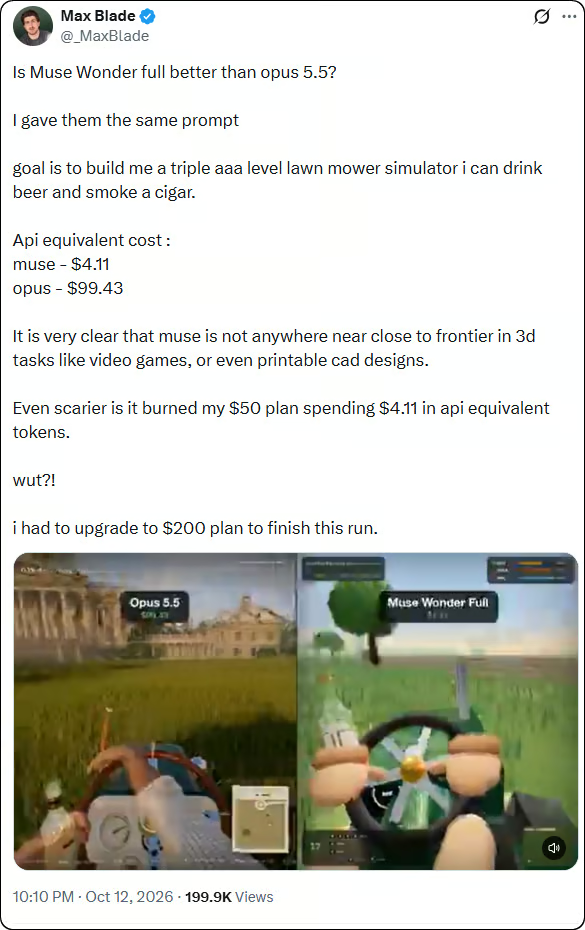
ข้อร้องเรียนที่หนักสุดคือเรื่องค่าใช้จ่ายและข้อจำกัดแผน ในการทดสอบเครื่องตัดหญ้าด้วยพรอมต์เดียวกัน Muse Wonder Full ใช้โทเค็นเทียบเท่า API ประมาณ $4.11 แต่ให้ผล 3 มิติที่อ่อนกว่า Claude Opus 5.5 และผู้ทดสอบกล่าวว่าการทำให้เสร็จต้องอัปเกรดจากแผน $50 เป็น $200
โดยรวม โพสต์ต่างๆ ชี้ว่า Muse Wonder แข่งขันได้แต่ยังไม่สม่ำเสมอ ควรมีการทดสอบซ้ำมากกว่านี้ก่อนจะมองว่าผลใดผลหนึ่งเป็นตัวแทนปกติ
หลักฐานการเปิดตัวยังมาจาก Meta เป็นส่วนใหญ่ Muse Wonder Full ไม่มี API แบบจ่ายตามใช้ และ Muse Wonder รุ่นปกติมีราคาเท่ากับ Claude Opus 5.5 ขณะที่ตามหลังในหลายการทดสอบ
แนะนำให้ทดสอบ Muse Wonder รุ่นปกติสำหรับเอเจนต์บน API และ Muse Wonder Full สำหรับงานรีโพขนาดใหญ่ระยะยาว คงใช้ Claude Opus 5.5 สำหรับงานเทอร์มินัลหรือการสร้างโปรแกรมจากศูนย์ และใช้ GPT-6.1 Sol หรือ Claude Sonnet 5.5 เมื่อต้นทุนเป็นตัวชี้ขาด
เรียนรู้กับ DataCamp
{count, plural, other {คอร์ส}}
{count, plural, other {คอร์ส}}
{count, plural, other {คอร์ส}}