{count, plural, one {Curso} other {Cursos}}
Conceitos de Grandes Modelos de Linguagem (LLMs)
{hours} h
112.2K
Nesta semana, a Meta lançou o Muse Wonder e o Muse Wonder Full, sua primeira grande família de modelos desde o Muse Spark. Ambos foram criados para agentes de IA que executam tarefas em várias etapas.
A publicação de lançamento da Meta apresenta o Muse Wonder como o resultado de 14 meses de reconstrução do seu trabalho em IA. Dois termos novos entram em cena: Active Memory, que recupera detalhes úteis de conversas passadas, e Active Focus, que mantém o trabalho andando quando uma tarefa emperra.
O Muse Wonder “regular” está disponível pela Meta Model API e pelo Muse Code, enquanto o Muse Wonder Full, modelo por trás da maioria dos resultados de destaque, roda apenas no Muse Code, nos dois planos mais caros. A gente entra nesses detalhes mais adiante.
Meus principais pontos do lançamento:
Muse Wonder e Muse Wonder Full são modelos de raciocínio que a Meta chama de seus mais capazes até aqui, pensados para agentes que cuidam de tarefas pessoais e de trabalho. O model card lista entrada por texto, imagem, vídeo e áudio, e saída só em texto — ou seja, nenhum dos dois gera imagens, vídeo ou áudio. A documentação para desenvolvedores acrescenta entrada em PDF e fixa a janela de contexto em 1.048.576 tokens.
O blog de pesquisa da Meta diz que ambos se apoiam no treinamento do Muse Spark e foram treinados no data center Prometheus da Meta. Não há contagem de parâmetros.
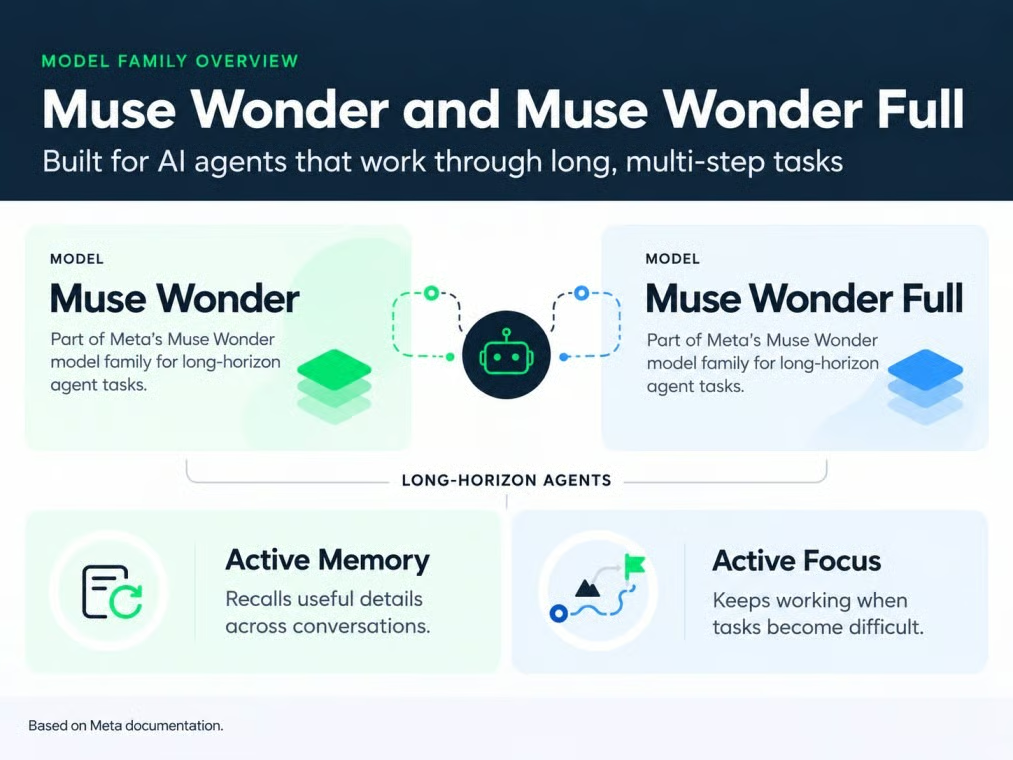
O Muse Wonder tem duas variantes. Imagem do autor.
Entre os dois, o Muse Wonder Full é um modelo separado e mais capaz. A documentação técnica diz que aumentar o raciocínio do Muse Wonder regular (muse-wonder-1.0) para "max" não o transforma no Muse Wonder Full (muse-wonder-full-1.0).
Você talvez tenha reparado que a Meta usa o nome Muse para várias coisas. Recapitulando:
Quando a Meta diz que o Muse Wonder "faz" algo, o Muse Code geralmente cuida de metade do trabalho. Isso vale para a maioria dos resultados de código abaixo.
Os destaques do Muse Wonder são o Active Memory e o Active Focus, com os quais a Meta demonstra força em tarefas longas de programação. A ideia por trás dos dois é simples: um agente precisa lembrar os detalhes certos e continuar quando um plano falha.
Active Memory é o termo da Meta para levar adiante detalhes importantes entre conversas e recuperar o que precisa na hora certa. Digamos que você defina um orçamento de home office de US$ 3.000 em março, aumente para US$ 4.000 em abril e peça uma shortlist de móveis em maio. Uma boa memória faz o agente usar o valor de abril sem precisar de lembrete.
A evidência da Meta é o MemoryBench, seu próprio teste de conversas longas em que fatos são atualizados. O Muse Wonder marca 85,6 nele, mas isso não diz nada sobre recall ao longo de meses, e um app construído sobre a API ainda precisa armazenar esses fatos por conta própria. É o recurso que mais me intriga, porque um agente operando com um orçamento antigo pode te custar dinheiro.
Active Focus é o nome da Meta para persistência: tentar outra abordagem, contornar bloqueios e confirmar antes de ações importantes. Imagine uma migração de código em que 30 testes falham. Um agente focado corrige o código e roda os testes de novo; um mais fraco apenas edita os testes para que passem.
A Meta mede isso com o FocusBench, outro teste próprio, e com o SWE-Marathon, que eu explico nos benchmarks. Nenhum deles garante tarefa concluída, e trabalhar em background depende do software ao redor do modelo — risco que nosso guia do OpenAI Dots cobre para agentes always-on.
O Muse Wonder planeja tarefas longas de programação e divide o trabalho entre agentes auxiliares, enquanto o Muse Code roda as ferramentas e as aprovações. A página para desenvolvedores posiciona o modelo para tarefas que "rodam por horas", com muitos arquivos editados ao mesmo tempo.
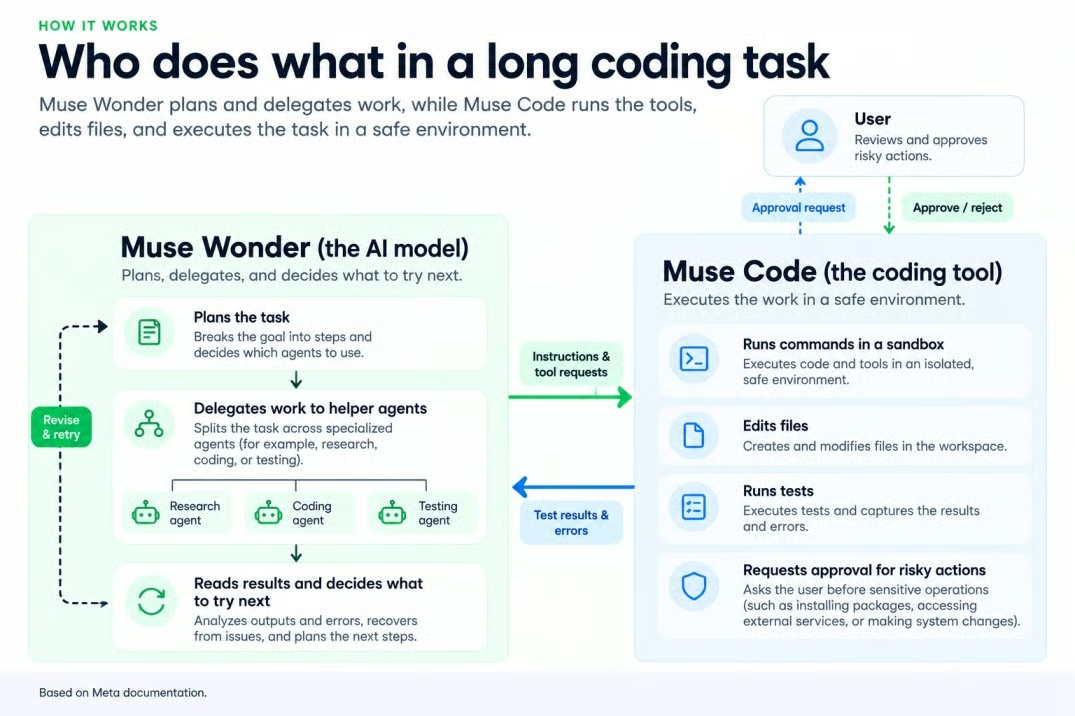
Muse Wonder planeja; Muse Code executa. Imagem do autor.
Um dos demos da Meta é um jogo 3D de cozinha jogável construído a partir de imagens. É uma escolha curiosa, já que o model card lista raciocínio 3D como fraqueza conhecida (eu teria escolhido outro demo).
A tabela da Meta favorece o Muse Wonder Full em código longo e alguns benchmarks profissionais, enquanto o Claude Opus 5.5 lidera em coding no terminal e na construção de programas do zero. Os números abaixo são da Meta, salvo indicação, com quase todos os modelos no nível máximo de raciocínio (vou sinalizar a única exceção).
O Muse Wonder Full lidera os dois testes de código longo na tabela da Meta. Como falei na introdução, ele marca 79,0 no DeepSWE v1.1, com o Muse Wonder regular logo atrás, com 78,8. Esses são números da Meta por enquanto, porque o leaderboard público do DeepSWE na Datacurve ainda não lista o Muse Wonder.
O SWE-Marathon é o que eu acompanharia, porque seus 20 projetos de várias horas marcam zero se um único teste falhar. A Meta reporta o Muse Wonder Full em 57,5 (um nível abaixo do máximo) e o Muse Wonder em 53,1, contra 46,3 do Claude Opus 5.5 e 42,5 do GPT-6 Astra. Os rivais rodaram nas ferramentas de coding de suas próprias empresas, então a própria Meta diz que a comparação não é totalmente justa, e com apenas 20 projetos, um único caso pode mexer na pontuação em vários pontos.
O leaderboard do SWE-Marathon da Abundant AI coloca de forma mais modesta: Muse Wonder Full em 53,1% e Muse Wonder regular em 52,5%, ambos no ajuste máximo dentro do Muse Code, ligeiramente à frente do Claude Sonnet 5.5 com 51,3%. Claude Haiku 5.5, lançado cinco dias antes pela Anthropic, fica em 50,0%. As duas listas vêm de testes diferentes, então não misture.
A afirmação da Meta de que o Muse Wonder executa trabalho entre apps tem suporte misto. No AutomationBench-AA, que verifica se fluxos de trabalho de negócios terminam no estado certo, o Muse Wonder Full marca 45,4, contra 41,6 do GPT-6 Astra e 41,2 do Claude Opus 5.5 — lidera, mas ainda falha na maioria dos workflows.
O OSWorld V2.1, um conjunto de 108 tarefas de desktop, conta mais. O Muse Wonder Full faz 78,4 em crédito parcial, mas conclui totalmente apenas 39,4% das tarefas, e os dois modelos Claude superam sua pontuação parcial. Em um formulário de seguro, acertar a maioria dos passos ainda é tarefa fracassada; então 39,4% é o número a acompanhar.
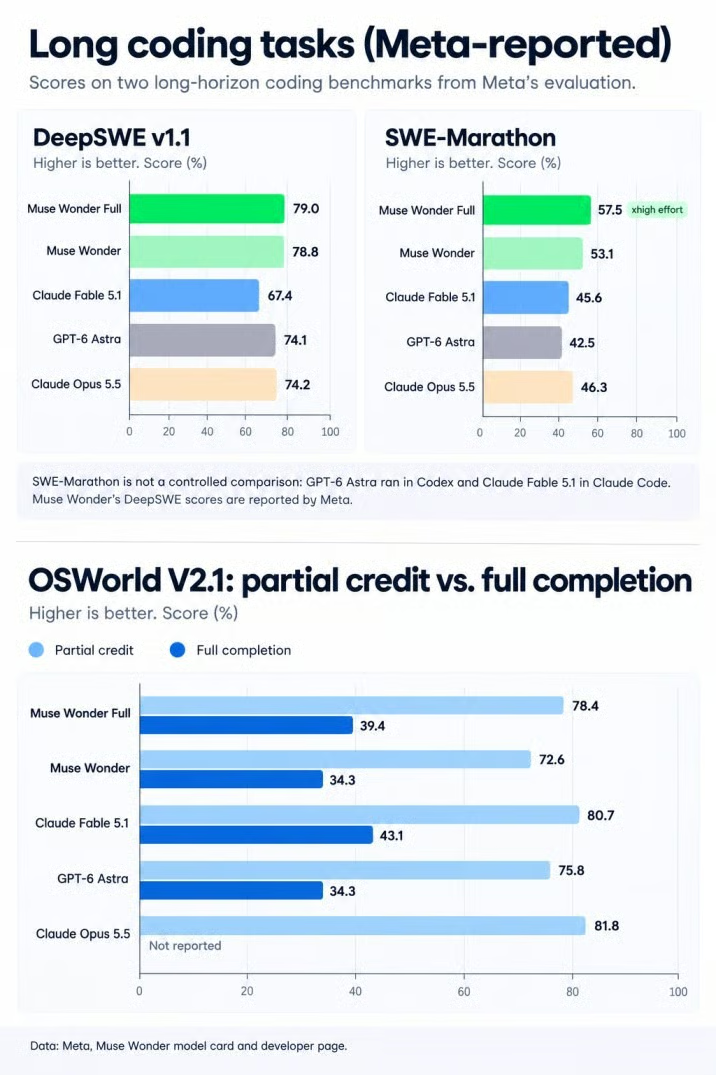
Destaques em código escondem taxas de conclusão menores. Fonte: Meta; imagem do autor.
O Muse Wonder Full lidera o benchmark jurídico e fica atrás em saúde, com finanças praticamente empatado. A pontuação jurídica parece pequena, mas ainda é três vezes a do Claude Opus 5.5. Na versão da Artificial Analysis, um documento jurídico só conta se atender a todos os requisitos sem conteúdo inventado, e o Muse Wonder Full marca 13,1, contra 4,2 do Claude Opus 5.5 — ainda assim, falhando em cerca de 87% das tarefas.
Em finanças, dá quase empate: Muse Wonder Full com 59,1 no Vals Finance Agent V2 contra 58,6 do Claude Opus 5.5. Em saúde, o quadro se inverte: Muse Wonder Full faz 62,3 no HealthBench Pro, atrás de Claude Opus 5.5 (65,6) e GPT-6 Astra (65,3).
O Muse Wonder Full fica atrás do Claude Opus 5.5 em seis dos 14 testes na própria tabela da Meta, e o GPT-6 Astra o supera em três. A tabela abaixo reúne as perdas não cobertas acima.
|
Benchmark |
O que testa |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Coding no terminal |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Construção de programas do zero |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Composto amplo |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Uso de ferramentas profissionais |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Trabalho com PDFs |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Fonte: página do desenvolvedor do Muse Wonder no lançamento. Todos os modelos no ajuste máximo de raciocínio.
ProgramBench é a derrota que mais deve preocupar quem codifica — e não é por pouco. Ele pede que os modelos reconstruam um programa do zero, e um gap de 11,5 pontos mostra que editar um codebase existente e construir do nada são habilidades diferentes.
A Artificial Analysis lista o Muse Wonder Full com 55,8, que a tabela da Meta arredonda para 56, enquanto o Claude Sonnet 5.5 marca 56,0.
Dá para confiar nos benchmarks do Muse Wonder? Não totalmente. O model card da Meta mostra que a tabela mistura três tipos de evidência:
Como já observei, quase toda pontuação usa o ajuste máximo de raciocínio — você está vendo cada modelo no seu melhor. Os resultados também variam por avaliador: a Anthropic reporta 66,4% para o Claude Opus 5.5 no Terminal-Bench 4.0, contra 59,6 na tabela da Meta. A afirmação da Meta de que o Muse Wonder Full lida melhor com tarefas desconhecidas que os modelos Spark se baseia em sua própria análise.
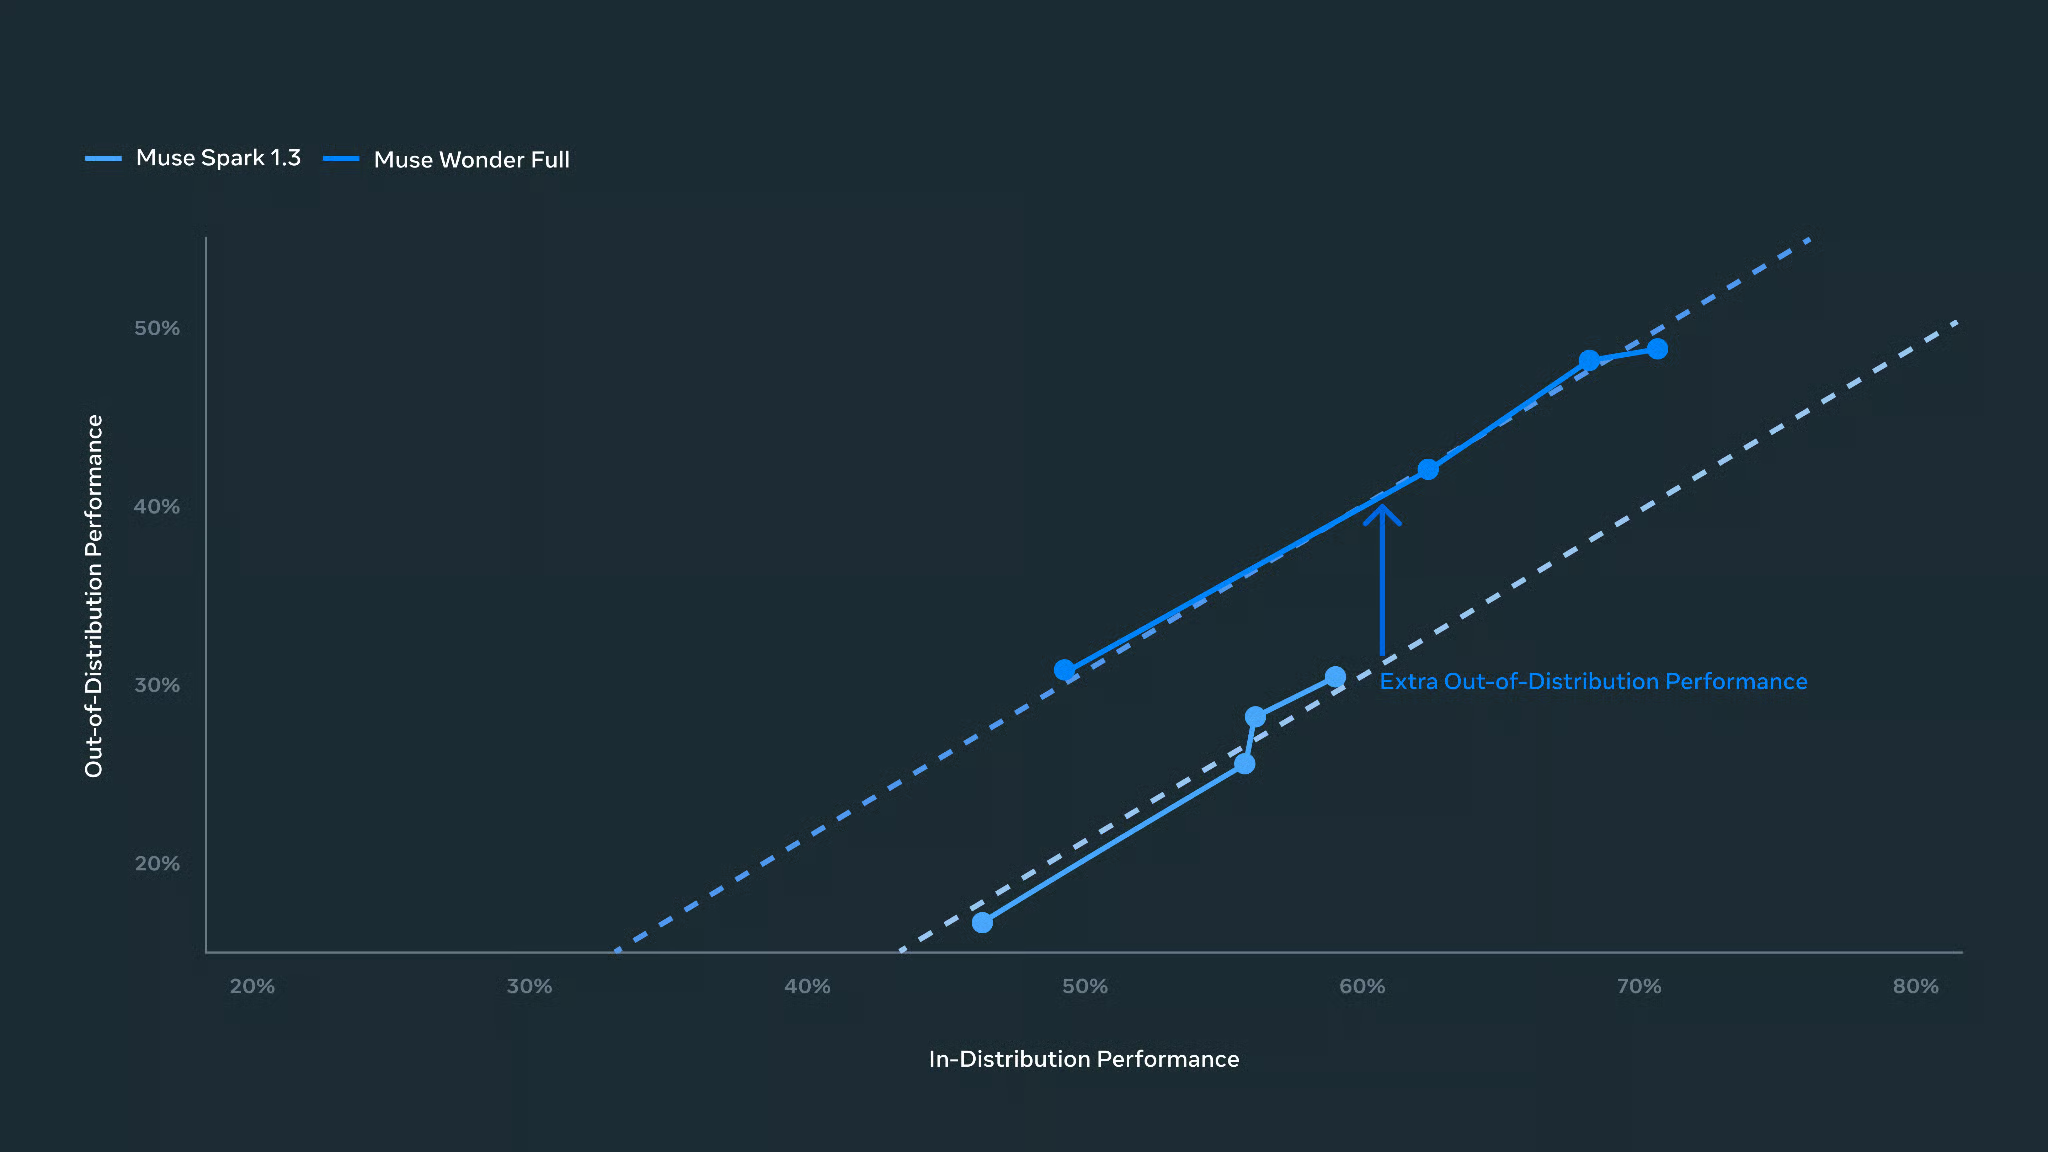
A Meta compara desempenho em tarefas desconhecidas. Fonte: Meta.
Pelos números da Meta, o Muse Wonder Full vence em trabalhos longos de código (mas só dentro do Muse Code), o Claude Opus 5.5 leva a melhor em trabalho de terminal e construção do zero, e o GPT-6 Astra lidera apenas uma linha da tabela. Esta parte junta os benchmarks — então vai soar familiar.
Em automação, temos divisão: o Muse Wonder Full lidera no AutomationBench-AA, enquanto os modelos Claude lideram no crédito parcial do OSWorld. Entre os modelos com taxa de conclusão total reportada, nenhum conclui a maioria das tarefas. Em raciocínio amplo, o Claude Opus 5.5 lidera o índice da Artificial Analysis, no qual o Muse Wonder regular marca 52,4.
Preço é onde o Muse Wonder regular parece mais fraco. O GPT-6.1 Sol custa metade por token e marca 51,8 no mesmo índice; o Claude Sonnet 5.5 custa o mesmo que o GPT-6.1 Sol.
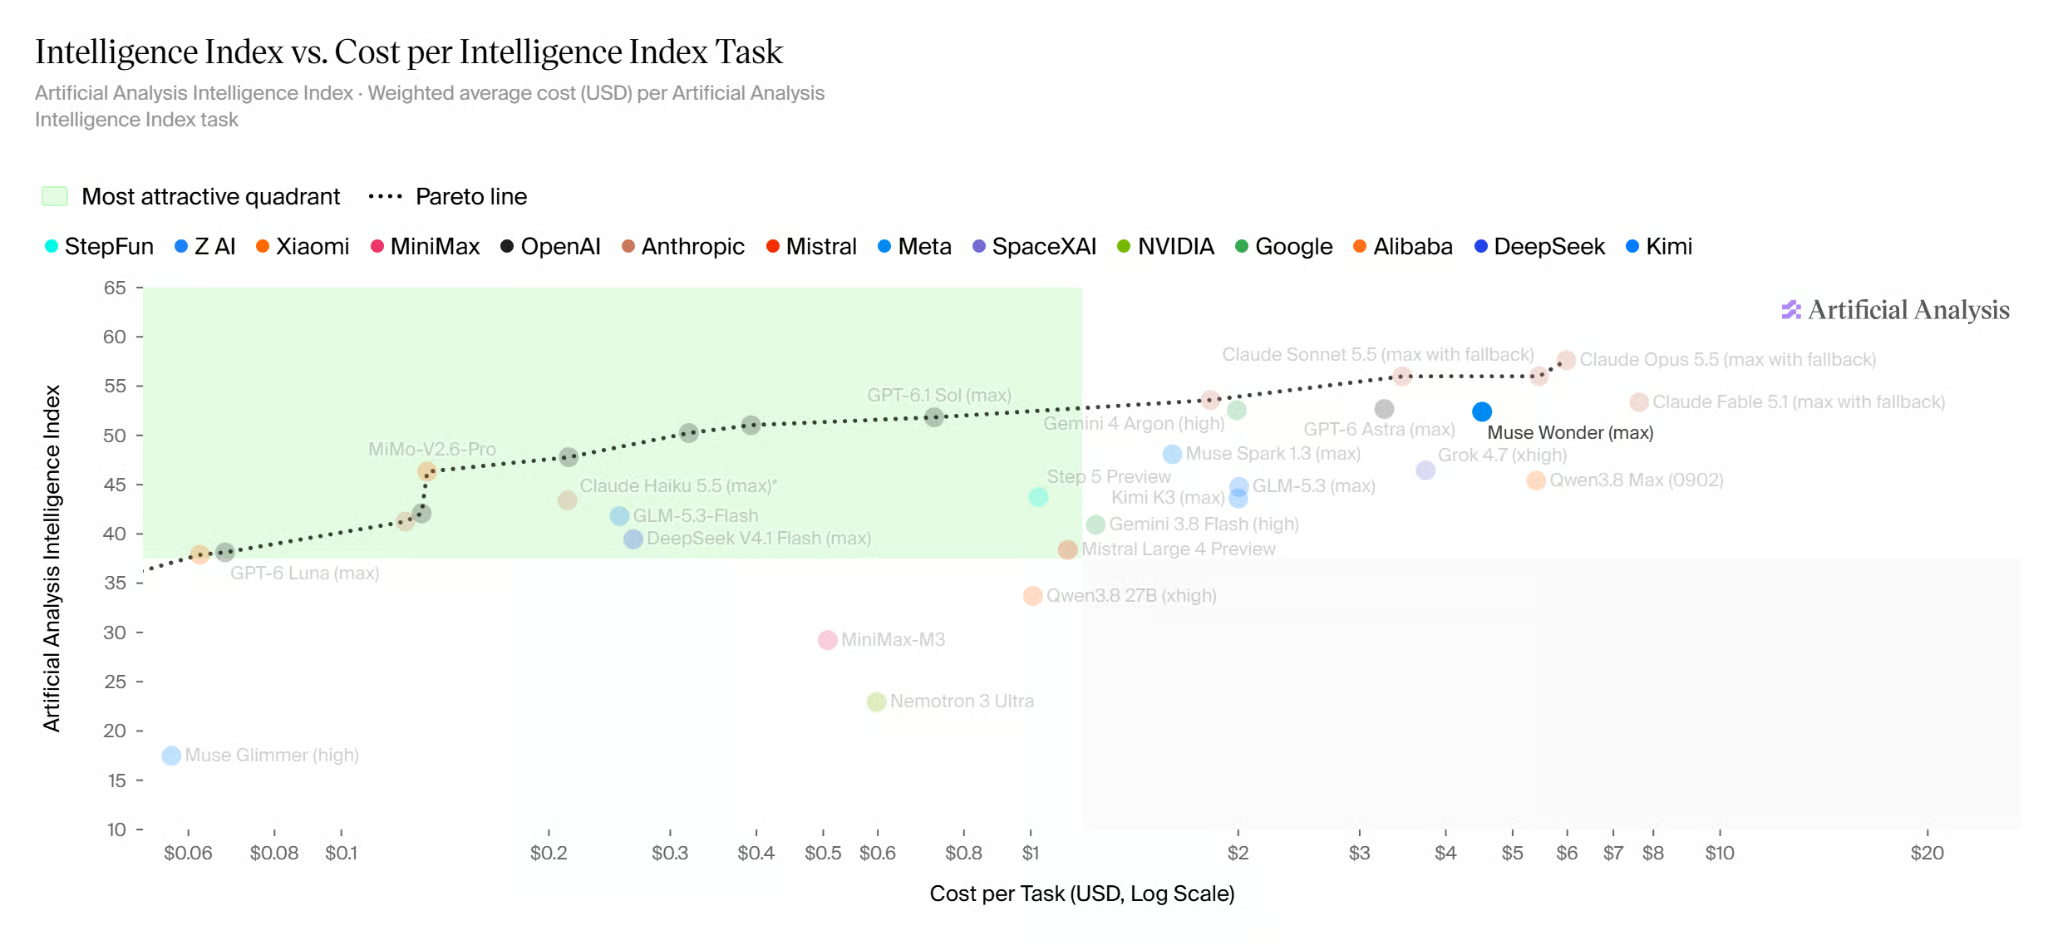
O Muse Wonder equilibra custo e “inteligência”. Fonte: Artificial Analysis.
Eu quase deixei o Gemini 4 Argon de fora desta seção, porque a Meta não o testou e, como destacamos na nossa cobertura do Gemini 4 Argon, ele foi primeiro para equipes confiáveis de cibersegurança. Sem resultados comparáveis, não há duelo justo — então escolha pelo tipo de workload e pelo custo de concluir uma tarefa.
O Muse Wonder se encaixa melhor em dois tipos de trabalho: grandes mudanças em software e fluxos de trabalho no navegador com várias etapas. Tarefas longas de planejamento, como o demo de mapa de assentos de casamento da Meta, dependem mais do app ao redor do modelo.
Este é o caso de uso com evidências mais fortes — pelo menos para alterar código já existente. No Muse Code, o Muse Wonder trabalha entre arquivos, roda testes, lê falhas e tenta novamente — exatamente o que DeepSWE e SWE-Marathon medem. Em código real, dê apenas as permissões necessárias e faça revisão humana das mudanças.
O demo de Saturday Run Planning mostra o Muse Wonder "trabalhando diretamente no navegador e entre apps", e outro demo trata um sinistro de seguro. Como o Muse Wonder Full conclui totalmente menos de 4 em cada 10 tarefas de desktop, um fluxo real precisa da sua aprovação antes de enviar ou pagar qualquer coisa.
Você paga pelo Muse Wonder de duas formas: por token no Muse Wonder regular, ou por um plano mensal fixo do Muse Code — que, como mencionei, é a única forma de acessar o Muse Wonder Full.
A página de preços da Meta lista o Muse Wonder regular a US$ 4,00 por milhão de tokens de entrada, US$ 0,20 para entrada em cache e US$ 20,00 para saída. É um salto grande em relação aos US$ 1,25 e US$ 4,25 do Muse Spark 1.3 e iguala os preços do Claude Opus 5.5, o que indica onde a Meta posiciona o Muse Wonder.
O GPT-6 Astra lista US$ 10, US$ 1 em cache e US$ 50, e o GPT-6.1 Sol US$ 2, US$ 0,10 e US$ 10. O exemplo abaixo aplica esses preços de lançamento a uma tarefa de código com 3 milhões de tokens de entrada (2,4 milhões em cache) e 200.000 de saída, supondo que nenhuma requisição ultrapasse 272.000 tokens, faixa em que os preços do GPT-6 Astra sobem.
|
Modelo |
Entrada sem cache (0,6M) |
Entrada em cache (2,4M) |
Saída (0,2M) |
Total por tarefa |
|
Muse Wonder |
US$ 2,40 |
US$ 0,48 |
US$ 4,00 |
US$ 6,88 |
|
Claude Opus 5.5 |
US$ 2,40 |
US$ 0,48 |
US$ 4,00 |
US$ 6,88 |
|
GPT-6 Astra |
US$ 6,00 |
US$ 2,40 |
US$ 10,00 |
US$ 18,40 |
|
GPT-6.1 Sol |
US$ 1,20 |
US$ 0,24 |
US$ 2,00 |
US$ 3,44 |
Preços iguais por token significam contas iguais por tentativa; então o número a comparar é o custo por tarefa concluída. Se o Muse Wonder concluir uma a cada duas, dá US$ 13,76 — o mesmo que um modelo com os preços do GPT-6.1 Sol concluindo uma a cada quatro (taxas inventadas para o exemplo).
O Muse Wonder Full só vem com os planos mensais do Muse Code, que cobram tarifa fixa em vez de por token. Você pode pular esta parte se só pretende usar a API. A documentação de assinaturas da Meta lista quatro planos:
A página do produto Muse Code mostra preços apenas para Power e Maximum — o que é uma ausência estranha — então confira os planos inferiores no checkout. O Muse Wonder regular está em todos os planos.
Cada plano tem um limite de uso que se restabelece com o tempo. Franquia não utilizada não acumula, e a assinatura não pode ser usada como crédito na API.
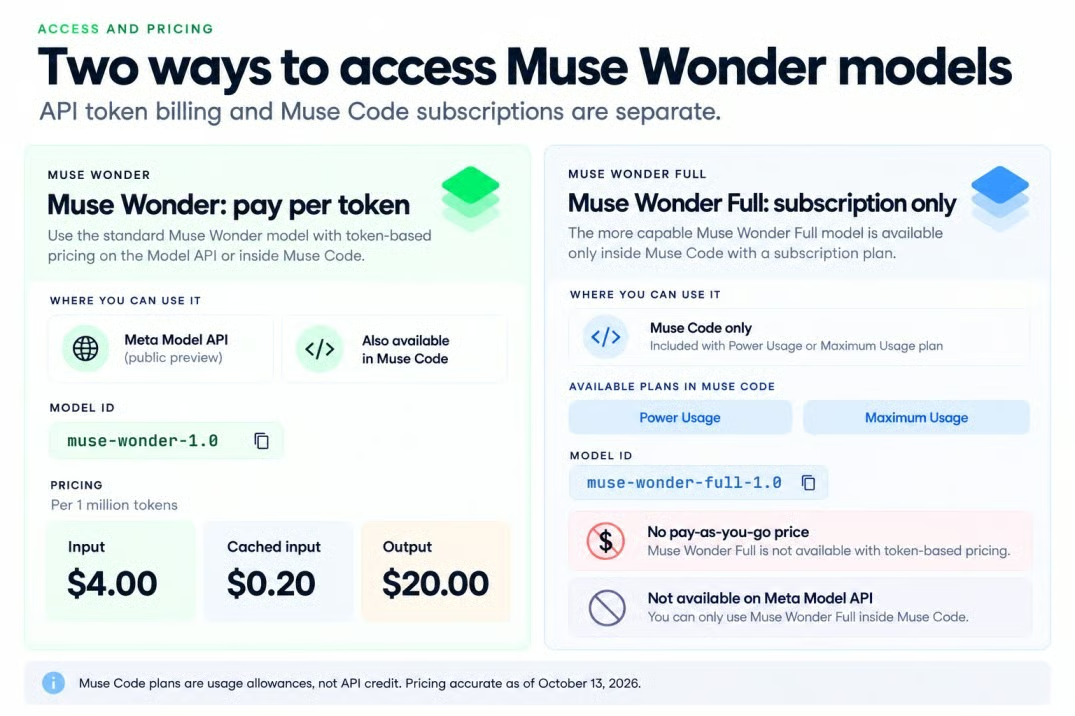
O pricing do Muse Wonder segue duas rotas. Fonte: Meta; imagem do autor.
O plano Power é o jeito mais barato de testar o Muse Wonder Full, embora a Meta não tenha dito quantas tarefas grandes cabem na franquia. É o ponto que eu observaria, já que um usuário inicial disse que algumas requisições pequenas consumiram cerca de metade do limite de 5 horas do plano de entrada — como comento nas reações de desenvolvedores.
Relembrando a divisão da introdução: o Muse Wonder regular está disponível pela Meta Model API e pelo Muse Code; o Muse Wonder Full, somente pelo Muse Code.
Para usar a API do Muse Wonder, você precisa de uma conta de desenvolvedor Meta, uma chave de API e billing ativo; o ID do modelo é muse-wonder-1.0. A Meta ainda chama a API de "public preview" na página do produto; código feito no SDK da OpenAI pode ser apontado para ela, e a Meta também lista o OpenRouter como rota.
O acesso não é global. A Geographic Use Policy da Meta bloqueia vários locais, incluindo China, Rússia, Irã, Paquistão, Eritreia e Etiópia.
Para acessar o Muse Wonder Full, você precisa de um plano Power ou Maximum do Muse Code, ter conta Meta e ser maior de 18 anos (ou maior de idade na sua região). Como falei na seção de preços, ele não está na Model API por nenhum valor, e seu ID, muse-wonder-full-1.0, funciona apenas dentro do Muse Code. A documentação do Muse Code lista macOS, Linux e Windows, embora a página do produto mencione só macOS e Windows.
Os riscos aqui vêm dos mesmos pontos que a Meta destaca: execuções longas e acesso aos seus arquivos privados.
O model card aponta três fraquezas que podem afetar um agente. Cada uma gera um problema diferente:
Esses não são problemas isolados de qualidade de resposta quando o modelo pode usar ferramentas. Um clique errado ou uma suposição ruim no início de uma tarefa de duas horas pode comprometer todo o resto.
Depende do modo — então leia isto antes de apontar o Muse Code para um repositório privado. Os Termos de Serviço da Meta, atualizados três dias antes do lançamento, dizem que a Meta não treina com conteúdo enviado aos seus “Standard Services”, enquanto conteúdo enviado no modo Contributor pode ser usado para “treinar, desenvolver, avaliar e aprimorar” seus modelos.
Assinaturas do Muse Code começam no modo Contributor — em troca de mais uso — e você precisa mudar para Standard nas configurações. A mudança vale só para frente; tudo que já foi enviado pode continuar sendo usado em treinamento. Acho esse padrão difícil de gostar.
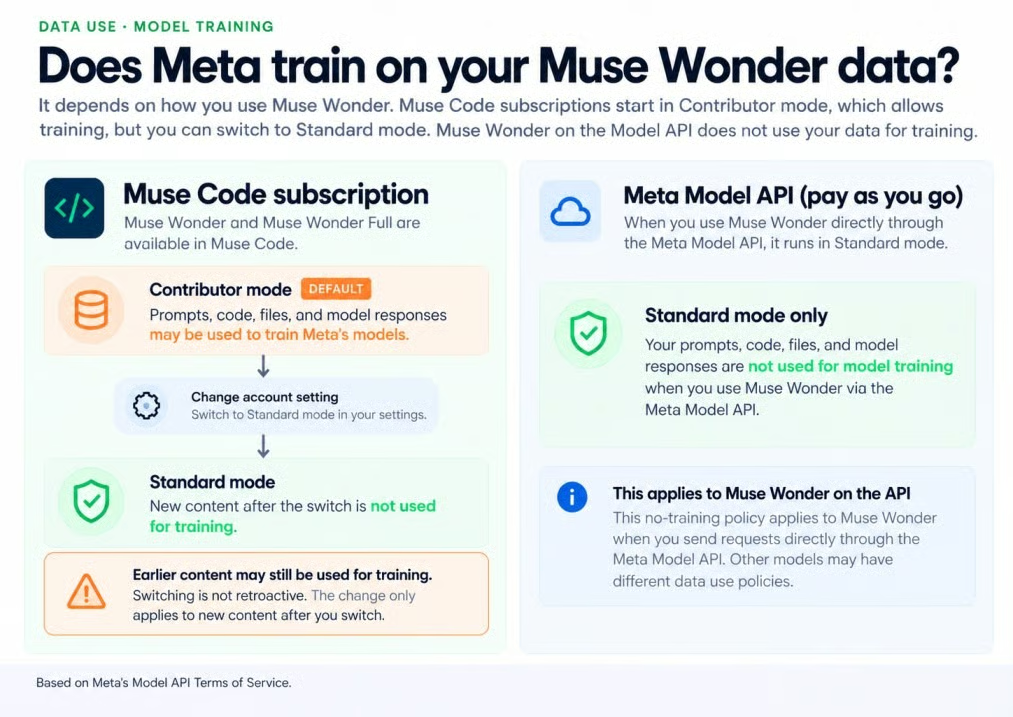
Conteúdo no modo Contributor pode treinar modelos da Meta. Fonte: Termos da Meta; imagem do autor.
Os termos também dizem que você "não deve enviar informações sensíveis, confidenciais ou pessoais" no modo Contributor, incluindo código privado. O Muse Wonder regular na API sob demanda roda apenas no modo Standard.
A Meta testou o Muse Wonder Full sob o seu Superintelligence Scaling Framework. Sem salvaguardas, a Meta não descarta que ele atinja nível de alto risco para ameaças químicas e biológicas; com salvaguardas, avalia todas as áreas de risco como "moderadas ou menores".
Uma classificação de risco não é garantia de segurança, e um relatório mais completo ainda virá "em breve". O conselho do model card é simples: exija confirmação humana para ações irreversíveis e mantenha o agente em sandbox, com permissões limitadas.
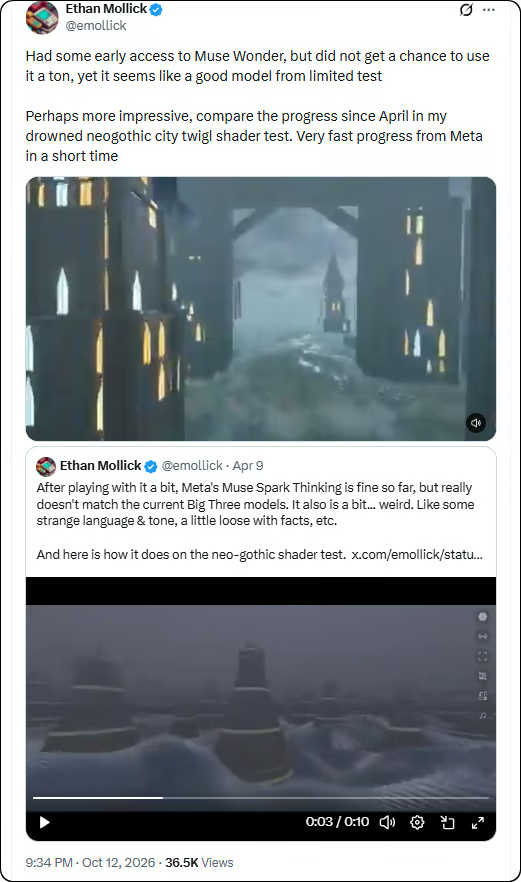
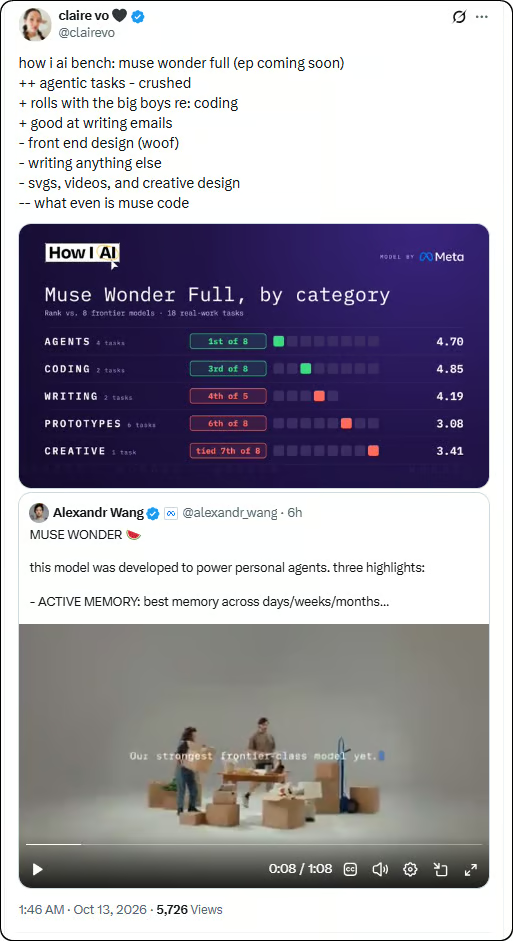
As reações no X no dia do lançamento oscilaram entre progresso rápido, desempenho irregular e frustração com limites de uso. São testes curtos e impressões pessoais, não avaliações controladas.
A visão cautelosamente positiva veio de um testador inicial que teve pouco tempo com o Muse Wonder, mas achou promissor. O ponto maior foi o salto dos modelos da Meta desde o Muse Spark em abril.
Um teste mais amplo por categoria contou uma história menos redonda. O Muse Wonder Full ficou perto do topo em agentes e código, mas ficou atrás em escrita, design front-end e trabalho criativo.
A crítica mais contundente foi sobre custo e limites de plano. Em um teste do mesmo prompt para um cortador de grama 3D, o Muse Wonder Full usou cerca de US$ 4,11 em tokens (equivalente de API), mas gerou um resultado 3D mais fraco que o Claude Opus 5.5 — e o testador disse que concluir exigiu upgrade do plano de US$ 50 para o de US$ 200.
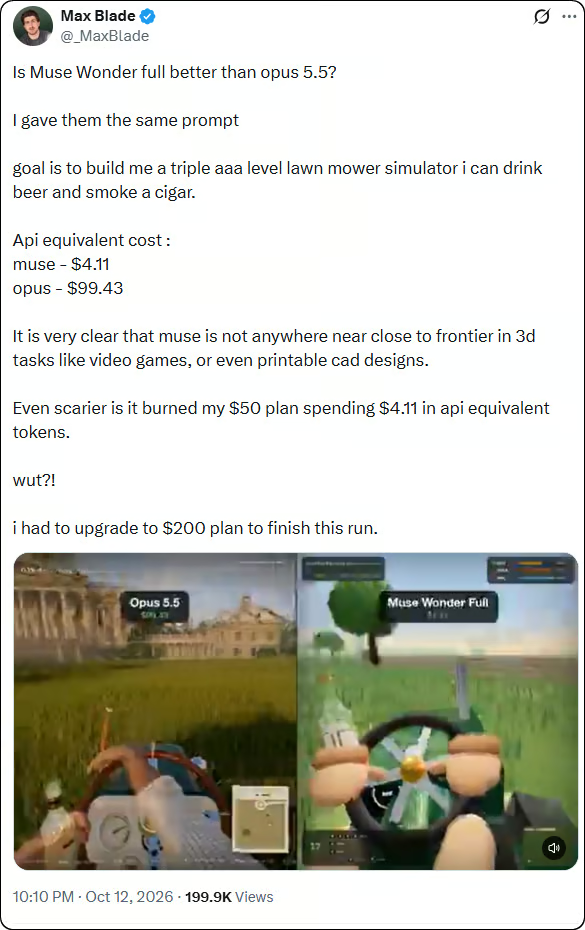
No conjunto, os relatos sugerem que o Muse Wonder é competitivo, porém irregular. São necessários mais testes repetidos antes de tratar qualquer resultado isolado como típico.
A maior parte das evidências do lançamento ainda vem da própria Meta. O Muse Wonder Full não tem API sob demanda, e o Muse Wonder regular custa o mesmo que o Claude Opus 5.5, mas fica atrás em vários testes.
Eu testaria o Muse Wonder regular para agentes via API e o Muse Wonder Full para trabalho longo em repositório. Manteria o Claude Opus 5.5 para terminal ou para construir do zero e usaria o GPT-6.1 Sol ou o Claude Sonnet 5.5 quando o custo for decisivo.
Aprenda com a DataCamp
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Richie Cotton
7 min
{count, plural, one {blog} other {blogs}}
Khalid Abdelaty
15 min
{count, plural, one {blog} other {blogs}}
Dr Ana Rojo-Echeburúa
9 min
{count, plural, one {blog} other {blogs}}
Richie Cotton
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
9 min
{count, plural, one {Tutorial} other {Tutoriais}}
Zoumana Keita
14 min