{count, plural, one {Curso} other {Cursos}}
Conceptos de grandes modelos lingüísticos (LLM)
{hours} h
112.2K
Esta semana, Meta presentó Muse Wonder y Muse Wonder Full, su primera gran familia de modelos desde Muse Spark. Ambos están pensados para agentes de IA que resuelven tareas de varios pasos.
La nota de lanzamiento de Meta presenta Muse Wonder como el resultado de 14 meses de reconstrucción de su trabajo en IA. Los dos conceptos clave son Active Memory, que recupera detalles útiles de conversaciones pasadas, y Active Focus, que mantiene el trabajo cuando una tarea se atasca.
El Muse Wonder "normal" está disponible a través de la Meta Model API y Muse Code, mientras que Muse Wonder Full, el modelo detrás de la mayoría de los resultados destacados, solo se ejecuta en Muse Code con sus dos planes más caros. Más abajo entro en detalles.
Esto es lo más relevante del anuncio:
Muse Wonder y Muse Wonder Full son modelos de razonamiento que Meta presenta como los más capaces hasta la fecha, diseñados para agentes que resuelven tareas personales y de trabajo. La model card indica entrada de texto, imagen, vídeo y audio, y salida solo de texto, así que ninguno de los dos genera imágenes, vídeo ni audio. La documentación para desarrolladores añade entrada de PDF y sitúa la ventana de contexto en 1.048.576 tokens.
El blog de investigación de Meta afirma que ambos se basan en el trabajo de entrenamiento de Muse Spark y se entrenaron en el centro de datos Prometheus de Meta. No hay recuentos de parámetros.
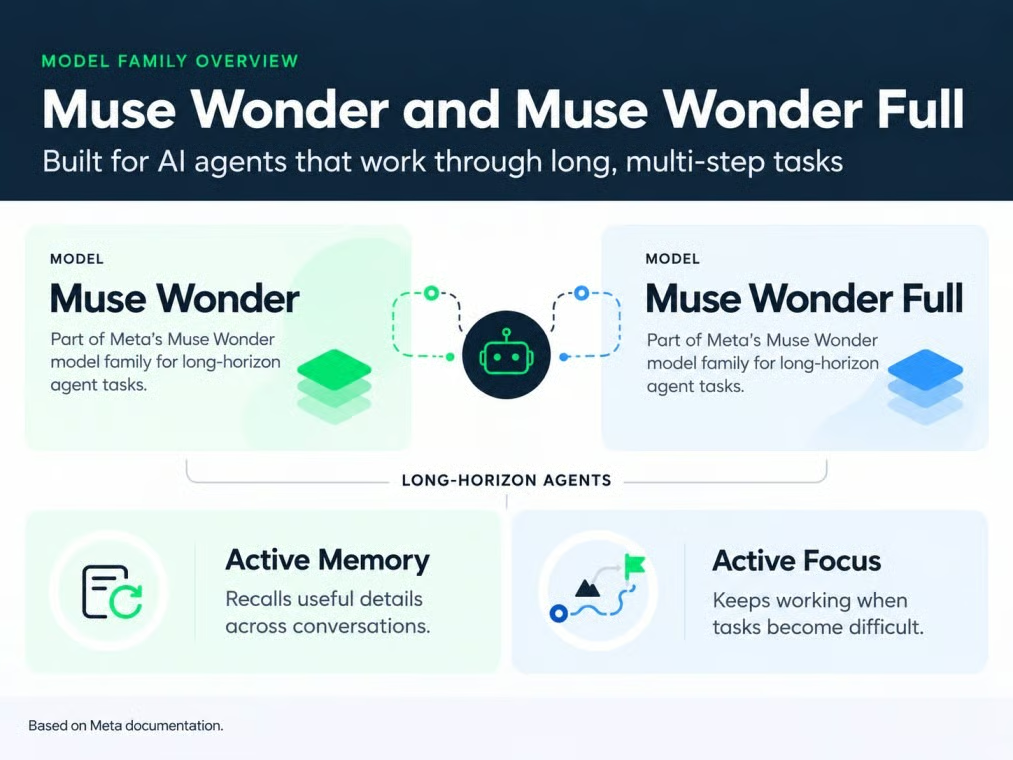
Muse Wonder llega en dos variantes. Imagen del autor.
Entre ambas, Muse Wonder Full es un modelo aparte y más capaz. La documentación para desarrolladores indica que poner el Muse Wonder normal (muse-wonder-1.0) al nivel de razonamiento "max" no lo convierte en Muse Wonder Full (muse-wonder-full-1.0).
Quizá hayas notado que Meta usa el nombre Muse para varias cosas. Resumiendo:
Cuando Meta dice que Muse Wonder "hace" algo, a menudo Muse Code hace la otra mitad del trabajo. Eso aplica a la mayoría de los resultados de programación que verás abajo.
Las funciones clave de Muse Wonder son Active Memory y Active Focus, y Meta las muestra especialmente en trabajos largos de programación. La idea detrás de ambas es simple: un agente debe recordar los detalles adecuados y seguir adelante cuando un plan falla.
Active Memory es el término de Meta para trasladar detalles importantes entre conversaciones y recuperar los que necesita en el momento. Imagina que fijas un presupuesto de 3.000 $ para tu despacho en casa en marzo, lo subes a 4.000 $ en abril y pides una lista corta de muebles en mayo. Una buena memoria implica que el agente use la cifra de abril sin recordárselo.
La evidencia de Meta es MemoryBench, su propia prueba de conversaciones largas donde los hechos se actualizan. Muse Wonder logra 85,6, pero eso no dice nada sobre el recuerdo a lo largo de meses, y una app construida sobre la API igualmente tendrá que almacenar esos datos por su cuenta. Es la función que más curiosidad me despierta, porque un agente que use un presupuesto antiguo puede costarte dinero.
Active Focus es el nombre de Meta para la perseverancia: probar otro enfoque, sortear bloqueos y pedir confirmación antes de acciones importantes. Piensa en una migración de código donde fallan 30 tests. Un agente con foco corrige su código y vuelve a ejecutar las pruebas; uno más débil simplemente edita los tests para que pasen.
Meta lo mide con FocusBench, otra prueba propia, y con SWE-Marathon, que detallo en la sección de benchmarks. Ninguna garantiza terminar la tarea, y el trabajo en segundo plano depende del software alrededor del modelo, un riesgo que explicamos en nuestro análisis de OpenAI Dots sobre agentes siempre activos.
Muse Wonder planifica trabajos largos de programación y reparte el trabajo entre agentes auxiliares, mientras Muse Code ejecuta herramientas y gestiona aprobaciones. La página para desarrolladores de Meta lo propone para tareas que "duran horas", con muchos archivos editados a la vez.
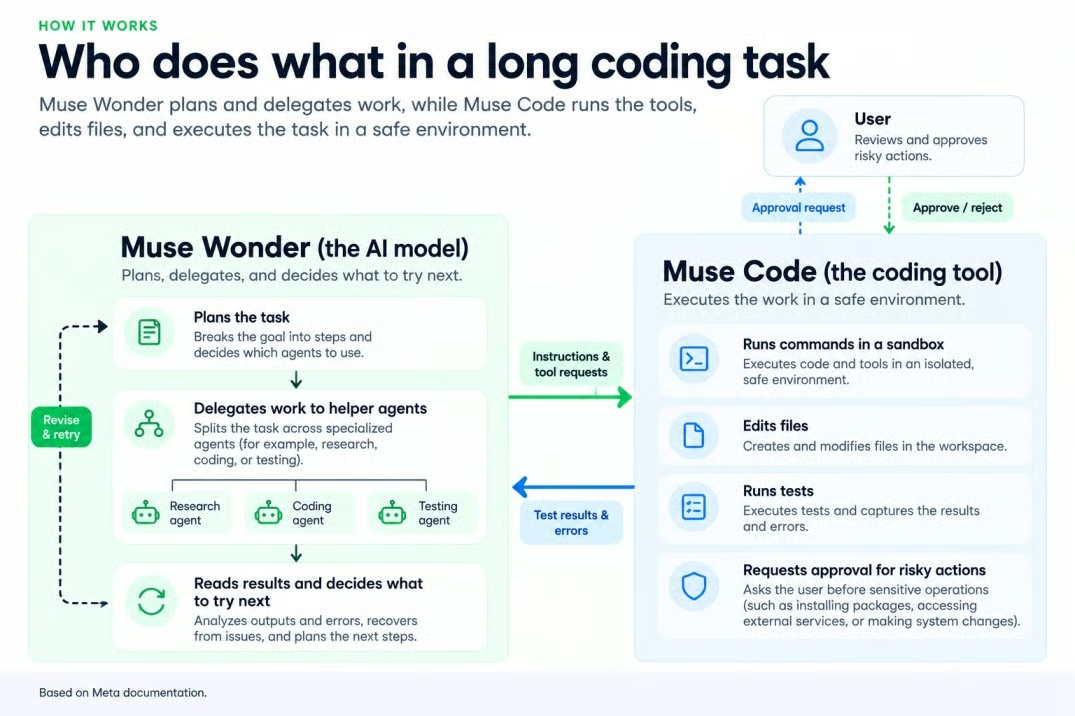
Muse Wonder planifica; Muse Code ejecuta. Imagen del autor.
Una de las demos de Meta es un juego 3D de cocina jugable construido a partir de imágenes. Es una elección extraña, ya que la model card lista el razonamiento 3D como una debilidad conocida (yo habría elegido otra demo).
La tabla de Meta favorece a Muse Wonder Full en programación larga y algunos benchmarks profesionales, mientras que Claude Opus 5.5 lidera en trabajo de terminal y creación de programas desde cero. Las cifras siguientes son de Meta salvo que se indique lo contrario, con casi todos los modelos en su ajuste máximo de razonamiento (señalaré la excepción).
Muse Wonder Full encabeza ambas pruebas largas de programación en la tabla de Meta. Como mencioné en la introducción, logra 79,0 en DeepSWE v1.1, con el Muse Wonder normal muy cerca en 78,8. Por ahora son cifras de Meta, ya que el ranking público de DeepSWE de Datacurve aún no lista a Muse Wonder.
SWE-Marathon es la que vigilaría, porque sus 20 proyectos de varias horas puntúan cero si falla una sola prueba. Meta reporta Muse Wonder Full en 57,5 (un punto por debajo de su ajuste máximo) y Muse Wonder en 53,1, frente a 46,3 de Claude Opus 5.5 y 42,5 de GPT-6 Astra. Los modelos rivales se ejecutaron dentro de las herramientas de programación de sus propias compañías, así que la propia Meta admite que la comparación no es del todo justa, y con solo 20 proyectos, uno puede mover varios puntos la puntuación.
El ranking de SWE-Marathon de Abundant AI lo coloca de forma más modesta: Muse Wonder Full en 53,1% y Muse Wonder normal en 52,5%, ambos en su ajuste máximo dentro de Muse Code, ligeramente por delante de Claude Sonnet 5.5 en 51,3%. Claude Haiku 5.5, que Anthropic lanzó cinco días antes, se sitúa en 50,0%. Son listas de pruebas distintas, así que no las mezcles.
La afirmación de Meta de que Muse Wonder puede realizar trabajo entre apps obtiene un apoyo mixto. En AutomationBench-AA, que comprueba si los flujos de trabajo empresariales acaban en el estado correcto, Muse Wonder Full obtiene 45,4 frente a 41,6 de GPT-6 Astra y 41,2 de Claude Opus 5.5; lidera, aunque falla en la mayoría de flujos.
OSWorld V2.1, un conjunto de 108 tareas de escritorio, dice más. Muse Wonder Full logra 78,4 en crédito parcial pero completa totalmente solo el 39,4% de las tareas, y ambos modelos Claude superan su puntuación parcial. Para un formulario de seguros, acertar la mayoría de pasos sigue siendo un fallo, así que el 39,4% es el dato a vigilar.
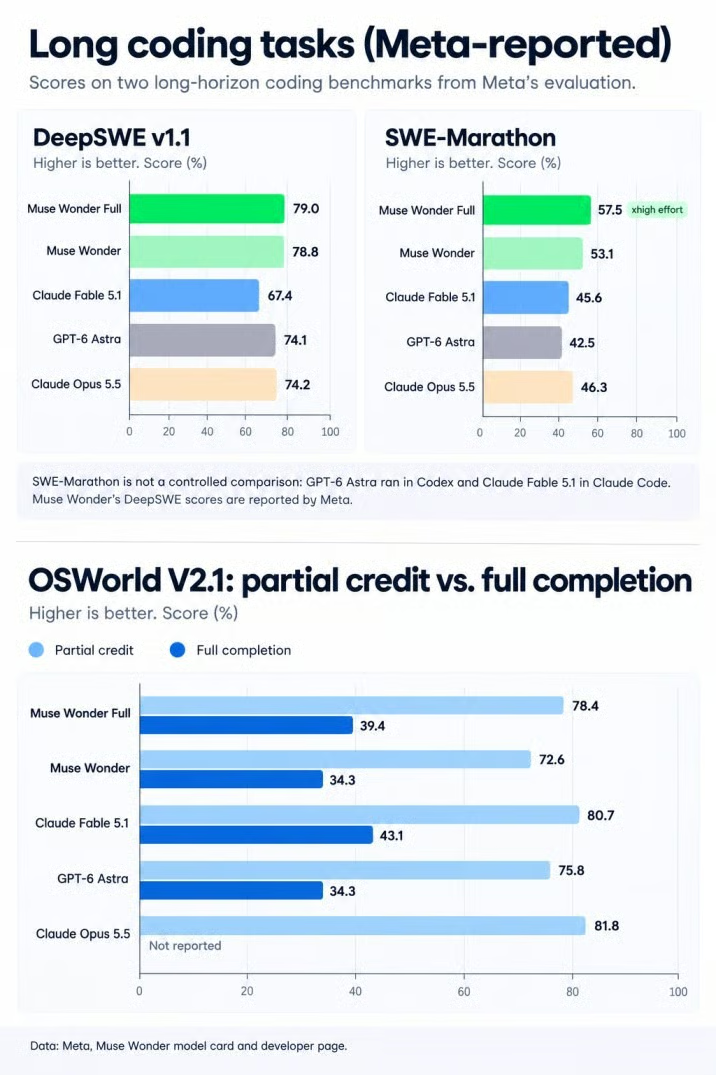
Los liderazgos en código ocultan bajas tasas de finalización. Fuente: Meta; imagen del autor.
Muse Wonder Full lidera el benchmark legal y queda por detrás en salud, con finanzas prácticamente en empate. Su puntuación legal suena pequeña, pero triplica la de Claude Opus 5.5. En la versión de Artificial Analysis, un documento legal solo cuenta si cumple todos los requisitos sin contenido inventado, y Muse Wonder Full obtiene 13,1 frente a 4,2 de Claude Opus 5.5, lo que aun así implica fallar en torno al 87% de las tareas.
En finanzas hay casi empate, con Muse Wonder Full en 59,1 en Vals Finance Agent V2 frente a 58,6 de Claude Opus 5.5. En salud ocurre lo contrario: Muse Wonder Full logra 62,3 en HealthBench Pro, por detrás de Claude Opus 5.5 (65,6) y GPT-6 Astra (65,3).
Muse Wonder Full queda por detrás de Claude Opus 5.5 en seis de las 14 pruebas de la propia tabla de Meta, y GPT-6 Astra le gana en tres. Esta tabla recoge las derrotas no cubiertas arriba.
|
Benchmark |
Qué evalúa |
Muse Wonder Full |
Muse Wonder |
GPT-6 Astra |
Claude Opus 5.5 |
Claude Fable 5.1 |
|
Terminal-Bench 4.0-AA |
Código en terminal |
57,1 |
52,0 |
59,1 |
59,6 |
52,0 |
|
ProgramBench |
Crear programas desde cero |
59,0 |
50,0 |
52,5 |
70,5 |
55,5 |
|
AA Intelligence Index v4.3 |
Índice compuesto amplio |
56 |
52 |
53 |
58 |
53 |
|
JobBench |
Uso de herramientas profesionales |
75,3 |
70,5 |
66,1 |
75,4 |
73,1 |
|
GDP.pdf |
Trabajo con PDFs |
33,2 |
30,8 |
34,2 |
30,6 |
27,6 |
Fuente: página para desarrolladores de Muse Wonder de Meta en el lanzamiento. Todos los modelos en su ajuste máximo de razonamiento.
ProgramBench es la derrota que debería importar a quienes programan, y no es ajustada. Pide a los modelos reconstruir un programa desde cero, y una brecha de 11,5 puntos muestra que editar una base de código existente y construir desde nada son habilidades distintas.
Artificial Analysis sitúa Muse Wonder Full en 55,8, que Meta redondea a 56, mientras Claude Sonnet 5.5 logra 56,0.
¿Puedes fiarte de los resultados de los benchmarks de Muse Wonder? No del todo. La model card de Meta muestra que la tabla mezcla tres tipos de evidencias:
Como señalé antes, casi todas las puntuaciones usan el ajuste de razonamiento más alto, así que ves cada modelo en su mejor versión. Los resultados también cambian según quién evalúe: Anthropic reporta 66,4% para Claude Opus 5.5 en Terminal-Bench 4.0, frente a 59,6 en la tabla de Meta. La afirmación de Meta de que Muse Wonder Full maneja mejor tareas no familiares que los modelos Spark se basa en su propio análisis.
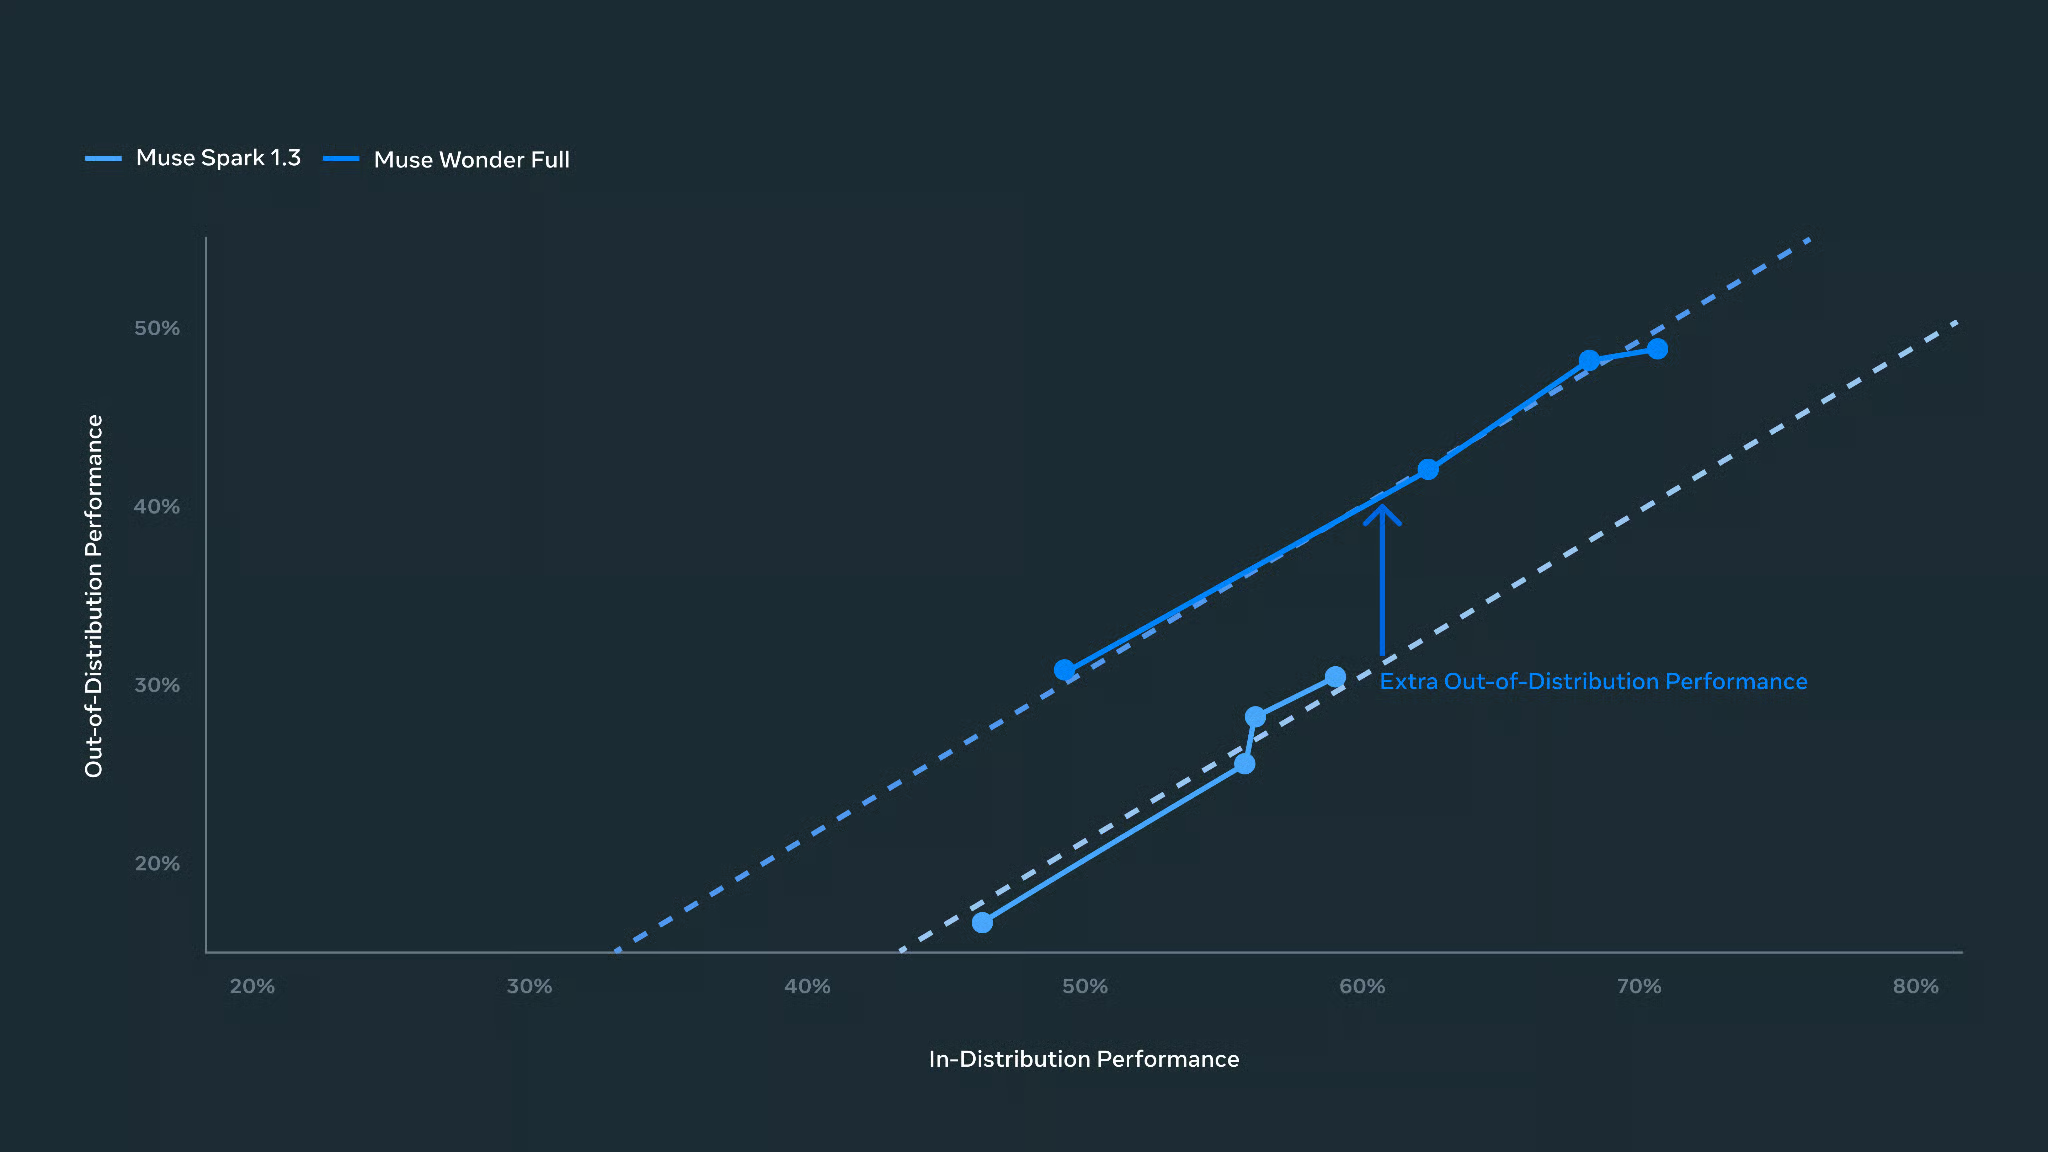
Meta compara el rendimiento en tareas no familiares. Fuente: Meta.
Con los datos de Meta, Muse Wonder Full gana en trabajos largos de programación (pero solo dentro de Muse Code), Claude Opus 5.5 gana en trabajo de terminal y construcción desde cero, y GPT-6 Astra solo encabeza una fila de la tabla de Meta. Esta parte recopila los benchmarks, así que te sonará.
En automatización hay división: Muse Wonder Full lidera en AutomationBench-AA mientras que los modelos Claude lideran en crédito parcial de OSWorld. Entre los modelos con tasa de finalización total reportada, ninguno completa la mayoría de las tareas. En razonamiento general, Claude Opus 5.5 lidera el índice de Artificial Analysis, donde el Muse Wonder normal marca 52,4.
El precio es donde el Muse Wonder normal queda menos favorecido. GPT-6.1 Sol cuesta la mitad por token y logra 51,8 en el mismo índice, y Claude Sonnet 5.5 cuesta lo mismo que GPT-6.1 Sol.
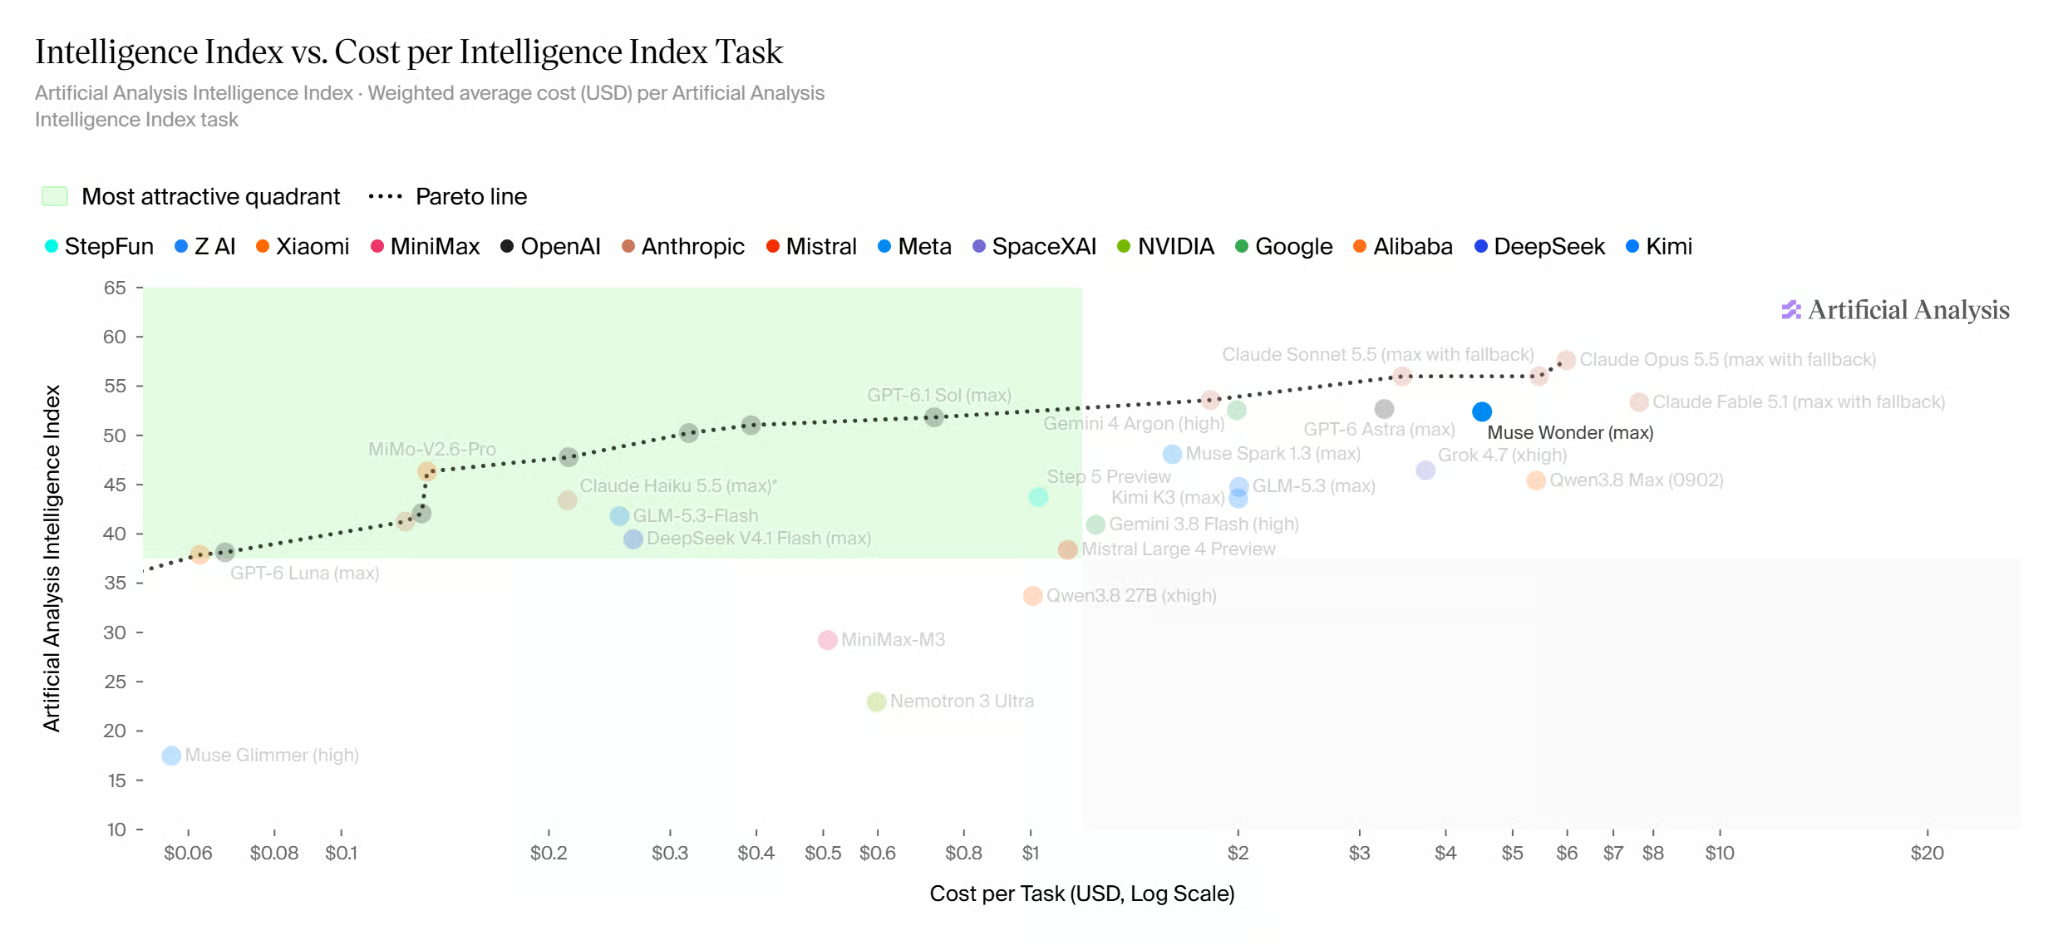
Muse Wonder equilibra coste e inteligencia. Fuente: Artificial Analysis.
Casi dejo fuera a Gemini 4 Argon en esta sección, porque Meta no lo probó y, como contamos en nuestra cobertura de Gemini 4 Argon, fue primero a equipos de ciberseguridad de confianza. Sin resultados compartidos no hay una comparativa justa, así que elige según la carga de trabajo y el coste de terminar una tarea.
Muse Wonder encaja mejor en dos tipos de trabajo: cambios grandes en software y flujos de trabajo en navegador con múltiples pasos. Los trabajos de planificación larga, como la demo del plano de mesas de boda de Meta, dependen más de la app que rodea al modelo.
Este caso es el que tiene evidencia más sólida, al menos para modificar código existente. En Muse Code, Muse Wonder trabaja entre archivos, ejecuta pruebas, lee fallos e itera, justo lo que miden DeepSWE y SWE-Marathon. En código real, dale solo los permisos necesarios y que una persona revise los cambios.
La demo de Saturday Run Planning muestra a Muse Wonder "trabajando directamente en un navegador y entre apps", y otra demo gestiona un parte de seguro. Como Muse Wonder Full completa totalmente menos de 4 de cada 10 tareas de escritorio, un flujo real debe pedir tu aprobación antes de enviar o pagar nada.
Pagas Muse Wonder de dos formas: por token en el caso del Muse Wonder normal, o con una suscripción mensual fija de Muse Code, que, como dije en la introducción, es la única vía para acceder a Muse Wonder Full.
La página de precios de Meta lista el Muse Wonder normal a 4,00 $ por millón de tokens de entrada, 0,20 $ si están en caché, y 20,00 $ de salida. Es una subida importante respecto a los 1,25 $ y 4,25 $ de Muse Spark 1.3, y coincide con los precios de Claude Opus 5.5, lo que indica dónde sitúa Meta a Muse Wonder.
GPT-6 Astra se lista a 10 $, 1 $ en caché y 50 $, y GPT-6.1 Sol a 2 $, 0,10 $ y 10 $. El supuesto siguiente aplica esos precios de lanzamiento a una tarea de código con 3 millones de tokens de entrada (2,4 millones en caché) y 200.000 de salida, suponiendo que ninguna solicitud supera los 272.000 tokens, a partir de donde los precios de GPT-6 Astra suben.
|
Modelo |
Entrada sin caché (0,6M) |
Entrada en caché (2,4M) |
Salida (0,2M) |
Total por tarea |
|
Muse Wonder |
2,40 $ |
0,48 $ |
4,00 $ |
6,88 $ |
|
Claude Opus 5.5 |
2,40 $ |
0,48 $ |
4,00 $ |
6,88 $ |
|
GPT-6 Astra |
6,00 $ |
2,40 $ |
10,00 $ |
18,40 $ |
|
GPT-6.1 Sol |
1,20 $ |
0,24 $ |
2,00 $ |
3,44 $ |
Precios por token iguales implican facturas iguales por intento, así que la métrica a comparar es el coste por tarea terminada. Si Muse Wonder termina una de cada dos, eso son 13,76 $, lo mismo que un modelo con los precios de GPT-6.1 Sol terminando una de cada cuatro (ambas tasas inventadas para el ejemplo).
Muse Wonder Full solo está disponible con los planes mensuales de Muse Code, que cobran una tarifa plana en lugar de por token. Puedes saltarte esta parte si solo piensas usar la API. La documentación de suscripciones de Meta lista cuatro planes:
La página de producto de Muse Code solo muestra precios para Power y Maximum, algo extraño de dejar fuera; comprueba los planes inferiores en el checkout. El Muse Wonder normal está en todos los planes.
Cada plan tiene un límite de uso que se restablece con el tiempo. La asignación no utilizada no se acumula y la suscripción no sirve como crédito para la API.
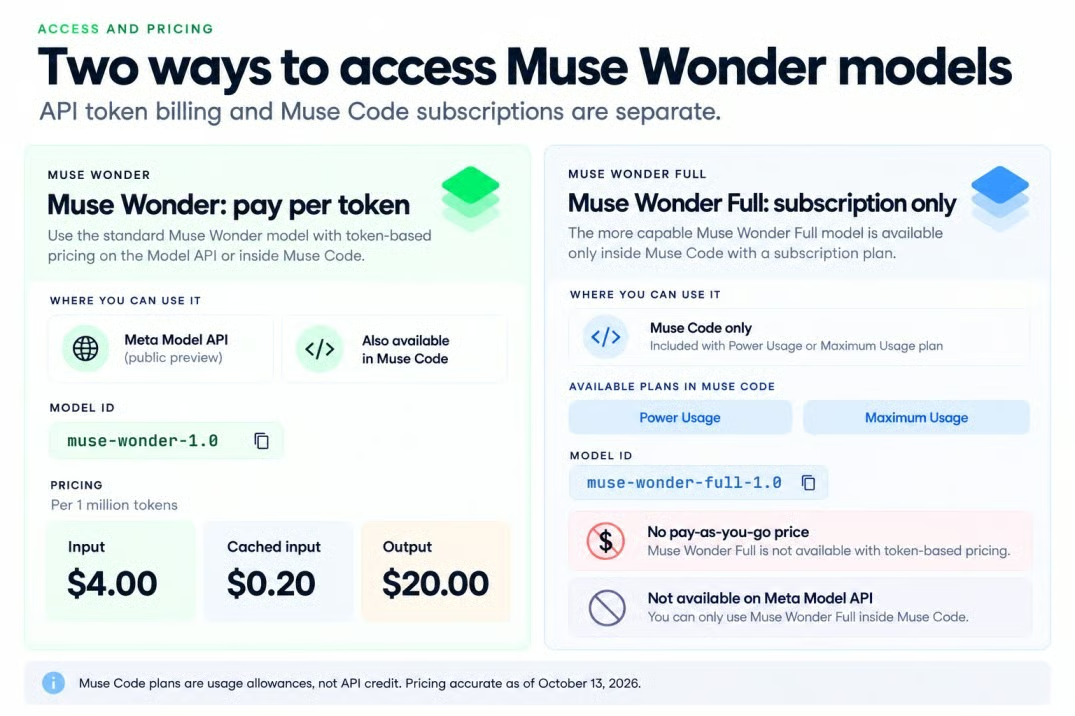
Muse Wonder tiene dos vías de precio y acceso. Fuente: Meta; imagen del autor.
Power es la forma más barata de probar Muse Wonder Full, aunque Meta no ha dicho cuántas tareas grandes cubre su asignación. Es lo que vigilaría, ya que un usuario temprano comentó que unas pocas peticiones pequeñas consumieron cerca de la mitad del límite de 5 horas de un plan de entrada, como detallo en las reacciones de desarrolladores.
Recapitulando lo de la introducción: el Muse Wonder normal está disponible a través de la Meta Model API y de Muse Code, y Muse Wonder Full solo a través de Muse Code.
Para usar la API de Muse Wonder necesitas una cuenta de desarrollador de Meta, una clave de API y facturación; el ID del modelo es muse-wonder-1.0. Meta aún llama a la API "public preview" en su página de producto, el código construido sobre el SDK de OpenAI puede apuntar a ella, y Meta también lista OpenRouter como vía de acceso.
El acceso no es global. La política de uso geográfico de Meta bloquea varios lugares, incluidos China, Rusia, Irán, Pakistán, Eritrea y Etiopía.
Para acceder a Muse Wonder Full necesitas un plan Power o Maximum de Muse Code, una cuenta de Meta y ser mayor de 18 años o de la mayoría de edad en tu país. Como expliqué en la sección de precios, no está en la Model API a ningún precio, y su ID, muse-wonder-full-1.0, solo funciona dentro de Muse Code. La documentación de Muse Code lista macOS, Linux y Windows, aunque su página de producto menciona solo macOS y Windows.
Los riesgos vienen de lo mismo que Meta destaca: ejecuciones largas y acceso a tus archivos privados.
La model card menciona tres debilidades que pueden afectar a un agente. Cada una provoca un problema distinto:
No son problemas aislados de calidad de respuesta cuando el modelo puede usar herramientas. Un clic erróneo o una mala suposición al inicio de una tarea de dos horas puede estropear el resto.
Depende del modo, así que léelo antes de apuntar Muse Code a un repositorio privado. Los Términos de servicio de Meta, actualizados tres días antes del lanzamiento, dicen que Meta no entrenará con contenido enviado a sus Standard Services, mientras que el contenido enviado en modo Contributor puede usarse para "entrenar, desarrollar, evaluar y mejorar" sus modelos.
Las suscripciones de Muse Code empiezan en modo Contributor, a cambio de más uso, y tienes que cambiar a Standard en la configuración. El cambio solo aplica en adelante, así que lo que ya enviaste puede seguir usándose para entrenamiento. Ese valor por defecto no me entusiasma.
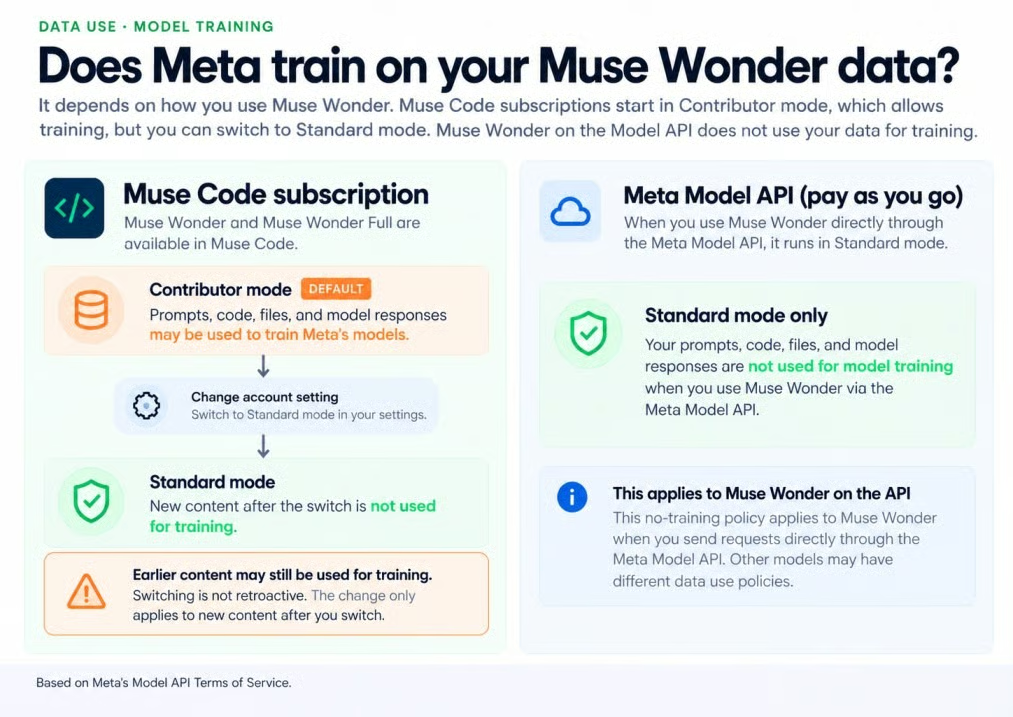
El contenido en modo Contributor puede entrenar modelos de Meta. Fuente: Términos de Meta; imagen del autor.
Los términos también indican que "no debes enviar información sensible, confidencial o personal" en modo Contributor, incluido código privado. El Muse Wonder normal en la API de pago por uso funciona solo en modo Standard.
Meta probó Muse Wonder Full bajo su Superintelligence Scaling Framework. Sin salvaguardas, Meta no descarta que alcance el nivel de alto riesgo para amenazas químicas y biológicas; con salvaguardas, califica todas las áreas de riesgo como "moderadas o menores".
Una calificación de riesgo no es una garantía de seguridad, y aún queda un informe más completo "próximamente". El consejo de la model card es sencillo: exige confirmación humana para acciones que no puedas deshacer y mantén al agente en un sandbox con permisos limitados.
Las reacciones del día de lanzamiento en X se repartieron entre progreso rápido, rendimiento irregular y frustración por los límites de uso. Son pruebas breves e impresiones personales, no evaluaciones controladas.
La visión positiva y prudente vino de una persona que probó Muse Wonder poco tiempo pero lo vio prometedor. Lo más destacado fue cuánto han mejorado los modelos de Meta desde Muse Spark en abril.
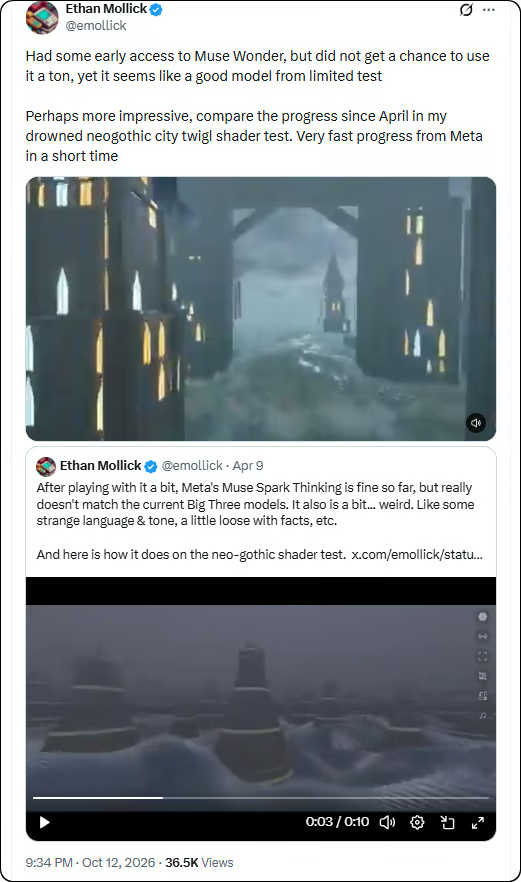
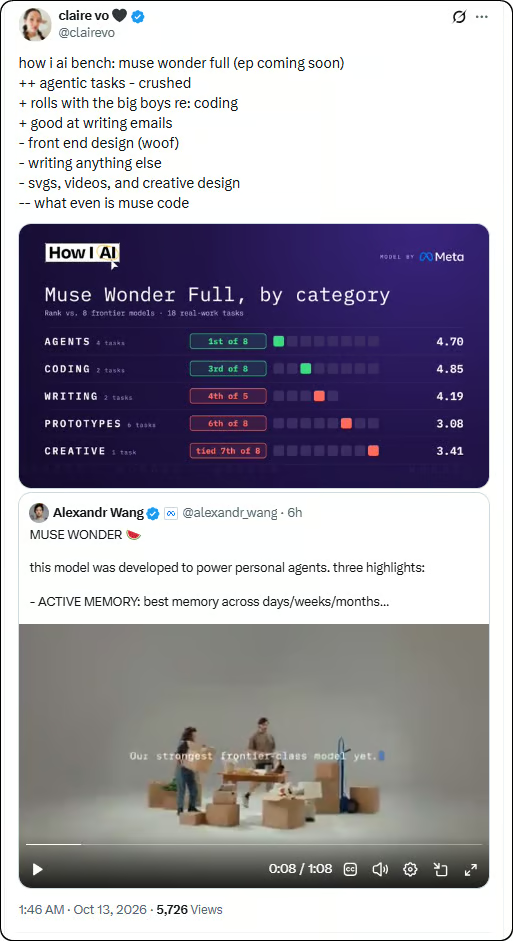
Una prueba más amplia por categorías dejó una imagen menos pulida. Muse Wonder Full quedó cerca de la cima en agentes y programación, pero por detrás en escritura, diseño front-end y trabajos creativos.
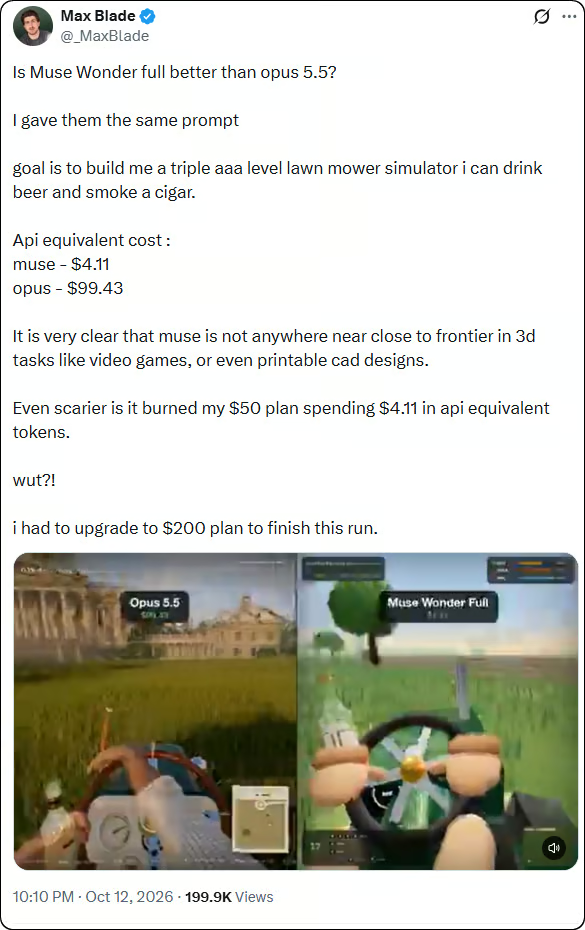
La queja más contundente fue sobre el coste y los límites de plan. En una prueba del mismo prompt sobre un cortacésped, Muse Wonder Full consumió unos 4,11 $ en tokens equivalentes de API pero produjo un resultado 3D más flojo que Claude Opus 5.5, y la persona probadora comentó que para terminar tuvo que pasar del plan de 50 $ al de 200 $.
En conjunto, las publicaciones sugieren que Muse Wonder es competitivo pero irregular. Harán falta más pruebas repetidas antes de tomar un resultado concreto como representativo.
La mayor parte de la evidencia del lanzamiento sigue viniendo de Meta. Muse Wonder Full no tiene API de pago por uso, y el Muse Wonder normal cuesta lo mismo que Claude Opus 5.5 mientras queda por detrás en varias pruebas.
Yo probaría el Muse Wonder normal para agentes vía API y Muse Wonder Full para trabajo largo sobre repositorios. Mantendría Claude Opus 5.5 para trabajo en terminal o construcción desde cero, y usaría GPT-6.1 Sol o Claude Sonnet 5.5 cuando el coste sea decisivo.
Aprende con DataCamp
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Dr Ana Rojo-Echeburúa
9 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
8 min
{count, plural, one {blog} other {blogs}}
Bhavishya Pandit
7 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {Tutorial} other {Tutoriales}}
Zoumana Keita
14 min
{count, plural, one {Tutorial} other {Tutoriales}}
Abid Ali Awan
9 min