
Last chance! 50% off DataCamp Premium
Sale ends in
De Cauchy-verdeling vormt een intrigerende statistische puzzel. Hoewel ze de bekende klokvorm deelt met veel andere continue kansverdelingen, tart ze de conventionele analyse doordat ze geen gedefinieerd gemiddelde en variantie heeft. Genoemd naar wiskundige Augustin-Louis Cauchy, duikt deze verdeling van nature op in vakgebieden variërend van financiële modellering tot Bayesiaanse statistiek.
Als leermiddel illustreert de Cauchy-verdeling fundamentele statistische concepten met opvallende helderheid. Ze laat de niet-convergentie van steekproefgemiddelden zien, benadrukt het belang van aannames over de verdeling en toont hoe schatters presteren onder verschillende omstandigheden.
Wil je deze statistische concepten en hun toepassingen in data science onder de knie krijgen? Bekijk onze Machine Learning Scientist in R-carrièreroute, waarin je leert deze ideeën te implementeren met R-programmering.
De Cauchy-verdeling is een continue kansverdeling die bekendstaat om haar unieke eigenschappen en zware staarten. Ze wordt gekarakteriseerd door twee sleutelparameters:
De verdeling wordt wiskundig gedefinieerd door haar kansdichtheidsfunctie (PDF):
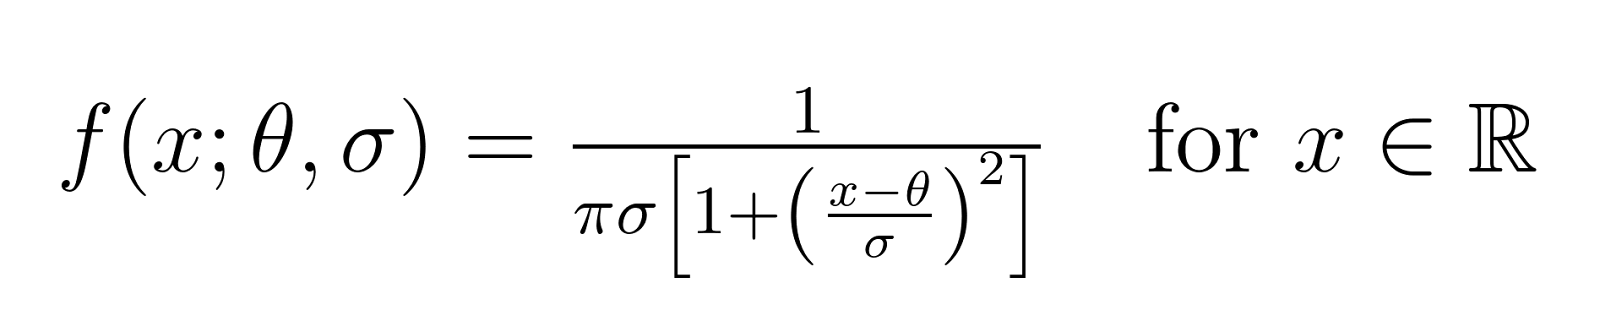
Als we θ = 0 en σ = 1 nemen, krijgen we de zogenoemde standaard Cauchy-verdeling. Dit is de eenvoudigste vorm van de verdeling en dient als referentiepunt voor het begrijpen van complexere gevallen.
Zie de Cauchy-verdeling als de verdeling van "extreme gebeurtenissen". Terwijl een normale verdeling suggereert dat waarden ver van het centrum zeer zeldzaam zijn (zoals iemand van 2,13 meter lang), laat de Cauchy-verdeling zien dat extreme waarden vaker voorkomen dan je zou verwachten.
Bijvoorbeeld, bij rendementen op de aandelenmarkt komen enorme koersschommelingen op één dag (zoals tijdens crashes of rally’s) vaker voor dan een normale verdeling zou voorspellen. De zware staarten van de Cauchy-verdeling kunnen deze "zwarte zwaan"-gebeurtenissen beter vastleggen.
Dit is misschien wel de meest fascinerende eigenschap van de Cauchy-verdeling. In tegenstelling tot de meeste verdelingen die je kent, heeft de Cauchy-verdeling geen betekenisvol gemiddelde of spreiding (variantie).
Om te begrijpen waarom dit belangrijk is: als je herhaaldelijk steekproeven uit een Cauchy-verdeling trekt en hun gemiddelde probeert te berekenen, convergeert dat niet naar een specifieke waarde, zelfs niet met miljoenen steekproeven. Dit heeft gevolgen voor statistische analyses, want traditionele methoden die op gemiddelden en varianties leunen (zoals t-toetsen of ANOVA) werken niet met Cauchy-verdeelde data.
De Cauchy-verdeling is perfect symmetrisch rond haar locatieparameter (θ), als een spiegelbeeld aan beide kanten. Deze symmetrie betekent echter niet dat ze zich gedraagt zoals de vertrouwde normale verdeling. Hoewel beide verdelingen symmetrisch zijn, spreidt de Cauchy-verdeling haar kans veel breder. Dat betekent dat, ook al is er een duidelijk centrum, waarden met aanzienlijke waarschijnlijkheid ver van dat centrum kunnen afwijken.
De Cauchy-verdeling heeft een opmerkelijke eigenschap: als je twee onafhankelijke Cauchy-verdeelde variabelen optelt, krijg je opnieuw een Cauchy-verdeling! Deze eigenschap, bekend als stabiliteit, wordt slechts door enkele andere verdelingen gedeeld (zoals de normale verdeling). Ze is bijzonder nuttig in de natuurkunde en financiële modellering, waar we vaak willen begrijpen hoe gecombineerde willekeurige processen zich in de tijd gedragen.
De Cauchy-verdeling blinkt uit in het omgaan met uitschieters, omdat ze verwacht dat die voorkomen. Dat maakt haar vooral nuttig in situaties waar extreme waarden natuurlijke onderdelen van de data zijn, niet fouten die je moet verwijderen. In zulke gevallen kunnen traditionele methoden voor het detecteren van uitschieters te agressief zijn en ten onrechte legitieme datapunten markeren om te verwijderen. De Cauchy-verdeling biedt een kader voor het bouwen van robuuste modellen die niet onevenredig worden beïnvloed door extreme observaties, en is dus waardevol bij datasets waar uitschieters een inherent kenmerk zijn in plaats van een anomalie die je moet elimineren.
Of je een Cauchy-verdeling moet gebruiken, hangt af van je data en doelen. De Cauchy-verdeling is vooral waardevol wanneer je data vaak extreme waarden vertoont, wanneer je werkt met verhoudingen van normaal verdeelde variabelen, of wanneer je een robuust model nodig hebt dat zwaarstaartige data aankan. Wees echter voorzichtig met het gebruik van de Cauchy-verdeling in bepaalde situaties: wanneer je moet vertrouwen op gemiddelden en varianties, wanneer je data eigenlijk een lichter staartige verdeling volgt, of wanneer rekenefficiëntie primair is. Inzicht in deze afwegingen helpt om weloverwogen te beslissen of de Cauchy-verdeling geschikt is voor jouw specifieke analysetaak.
Hoewel de wiskundige formule van de Cauchy-verdeling eenvoudig is, kan ze computationeel uitdagend zijn. Parameterschatting vereist vaak gespecialiseerde technieken zoals Markov Chain Monte Carlo (MCMC), en standaard maximum likelihood-methoden kunnen moeite hebben met de zware staarten. Gelukkig bevatten moderne statistische softwarepakketten vaak specifieke tools voor het omgaan met Cauchy-verdelingen, waardoor het in de praktijk haalbaarder wordt om met deze verdeling te werken ondanks de rekenkundige complexiteit.
De Cauchy-verdeling heeft verschillende belangrijke wiskundige eigenschappen die haar uniek en nuttig maken:
Het gedrag van de Cauchy-verdeling begrijp je het best via visualisatie. Laten we R gebruiken om grafieken van verschillende Cauchy-verdelingen te maken en te laten zien hoe de locatie- (θ) en schaalparameters (σ) de vorm en positie beïnvloeden.
R biedt functies voor het werken met Cauchy-verdelingen via het stats-pakket. We gebruiken ook ggplot2 om duidelijke, publiceerbare visuals te maken:
# Load required libraries
library(ggplot2)  # for plotting
# Note: dcauchy is from the stats package which is loaded by default in R

# Create a sequence of x values
x <- seq(-10, 10, length.out = 1000)

# Generate different Cauchy distributions using stats::dcauchy
# Standard Cauchy (θ = 0, σ = 1)
standard_cauchy <- dcauchy(x, location = 0, scale = 1)

# Location and Scale Adjusted (θ = 2, σ = 3)
adjusted_cauchy <- dcauchy(x, location = 2, scale = 3)

# Highly Scaled (θ = -1, σ = 5)
scaled_cauchy <- dcauchy(x, location = -1, scale = 5)

# Create a data frame for plotting
plot_data <- data.frame(
  x = rep(x, 3),
  density = c(standard_cauchy, adjusted_cauchy, scaled_cauchy),
  distribution = rep(c("Standard (θ=0, σ=1)",
                      "Adjusted (θ=2, σ=3)",
                      "Scaled (θ=-1, σ=5)"),
                    each = length(x))
)

# Create the plot
ggplot(plot_data, aes(x = x, y = density, color = distribution)) +
  geom_line(size = 1) +
  theme_minimal() +
  labs(title = "Comparison of Cauchy Distributions",
       x = "x",
       y = "Density",
       color = "Parameters") +
  theme(legend.position = "bottom",
        plot.title = element_text(hjust = 0.5)) +
  scale_color_brewer(palette = "Set1")
Deze code genereert een vergelijkingsgrafiek van drie verschillende Cauchy-verdelingen:
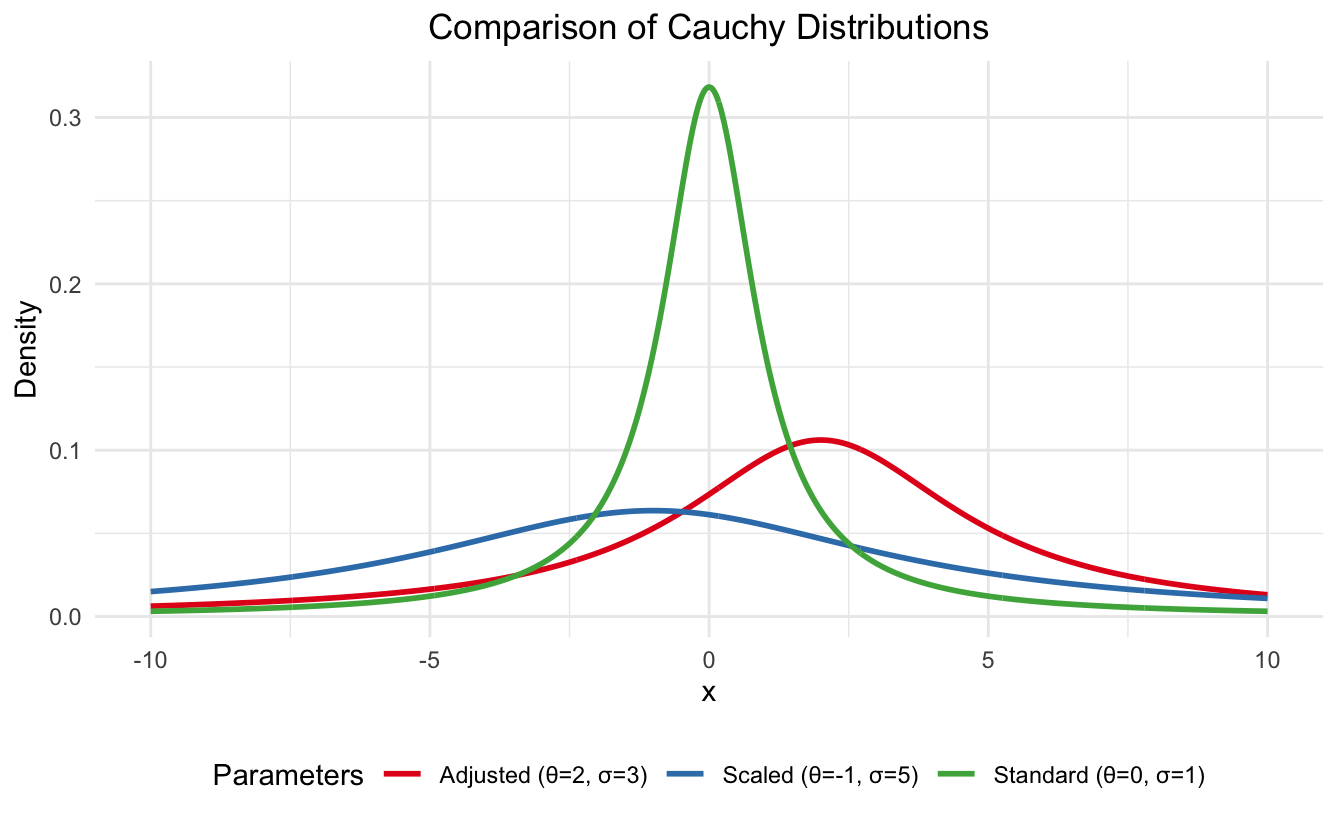
Cauchy-verdeling in R. Afbeelding door de auteur
De visualisatie laat duidelijk zien hoe een grotere schaalparameter (σ) leidt tot een vlakkere, meer uitgespreide verdeling, terwijl de locatieparameter (θ) de gehele verdeling simpelweg naar links of rechts verschuift.
Na het verkennen van de parameters van de Cauchy-verdeling in R, gebruiken we Python om de Cauchy-verdeling te vergelijken met haar bekendere neef, de normale verdeling. De wetenschappelijke stack van Python, met name scipy.stats, biedt uitstekende tools voor het werken met kansverdelingen.
Terwijl het stats-pakket van R directe toegang gaf tot functies voor de Cauchy-verdeling, biedt Python’s scipy.stats-module vergelijkbare functionaliteit met een iets andere interface. We gebruiken matplotlib, de belangrijkste plotbibliotheek van Python, om een duidelijke visualisatie te maken:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Set style parameters for better visualization
plt.style.use('seaborn')
plt.rcParams.update({
    'font.size': 16,
    'axes.labelsize': 18,
    'axes.titlesize': 24,
    'xtick.labelsize': 16,
    'ytick.labelsize': 16,
    'legend.fontsize': 16,
})

# Create data
x = np.linspace(-10, 10, 1000)
cauchy = stats.cauchy.pdf(x, loc=0, scale=1)
normal = stats.norm.pdf(x, loc=0, scale=1)

# Create the plot
plt.figure(figsize=(12, 8))

# Plot distributions
plt.plot(x, cauchy, 'b-', linewidth=2.5, label='Cauchy(0,1)')
plt.plot(x, normal, 'r--', linewidth=2.5, label='Normal(0,1)')

# Customize the plot
plt.title('Cauchy vs Normal Distribution', pad=20)
plt.xlabel('x', labelpad=10)
plt.ylabel('Density', labelpad=10)

# Customize legend
plt.legend(fontsize=16, bbox_to_anchor=(0.99, 0.99),
          loc='upper right', borderaxespad=0.)

# Add grid and adjust layout
plt.grid(True, alpha=0.3)
plt.tight_layout()

plt.show()
De bovenstaande code maakt een vergelijking tussen de standaard Cauchy-verdeling (blauwe doorgetrokken lijn) en de standaard normale verdeling (rode stippellijn), beide gecentreerd op 0 met een schaalparameter van 1.
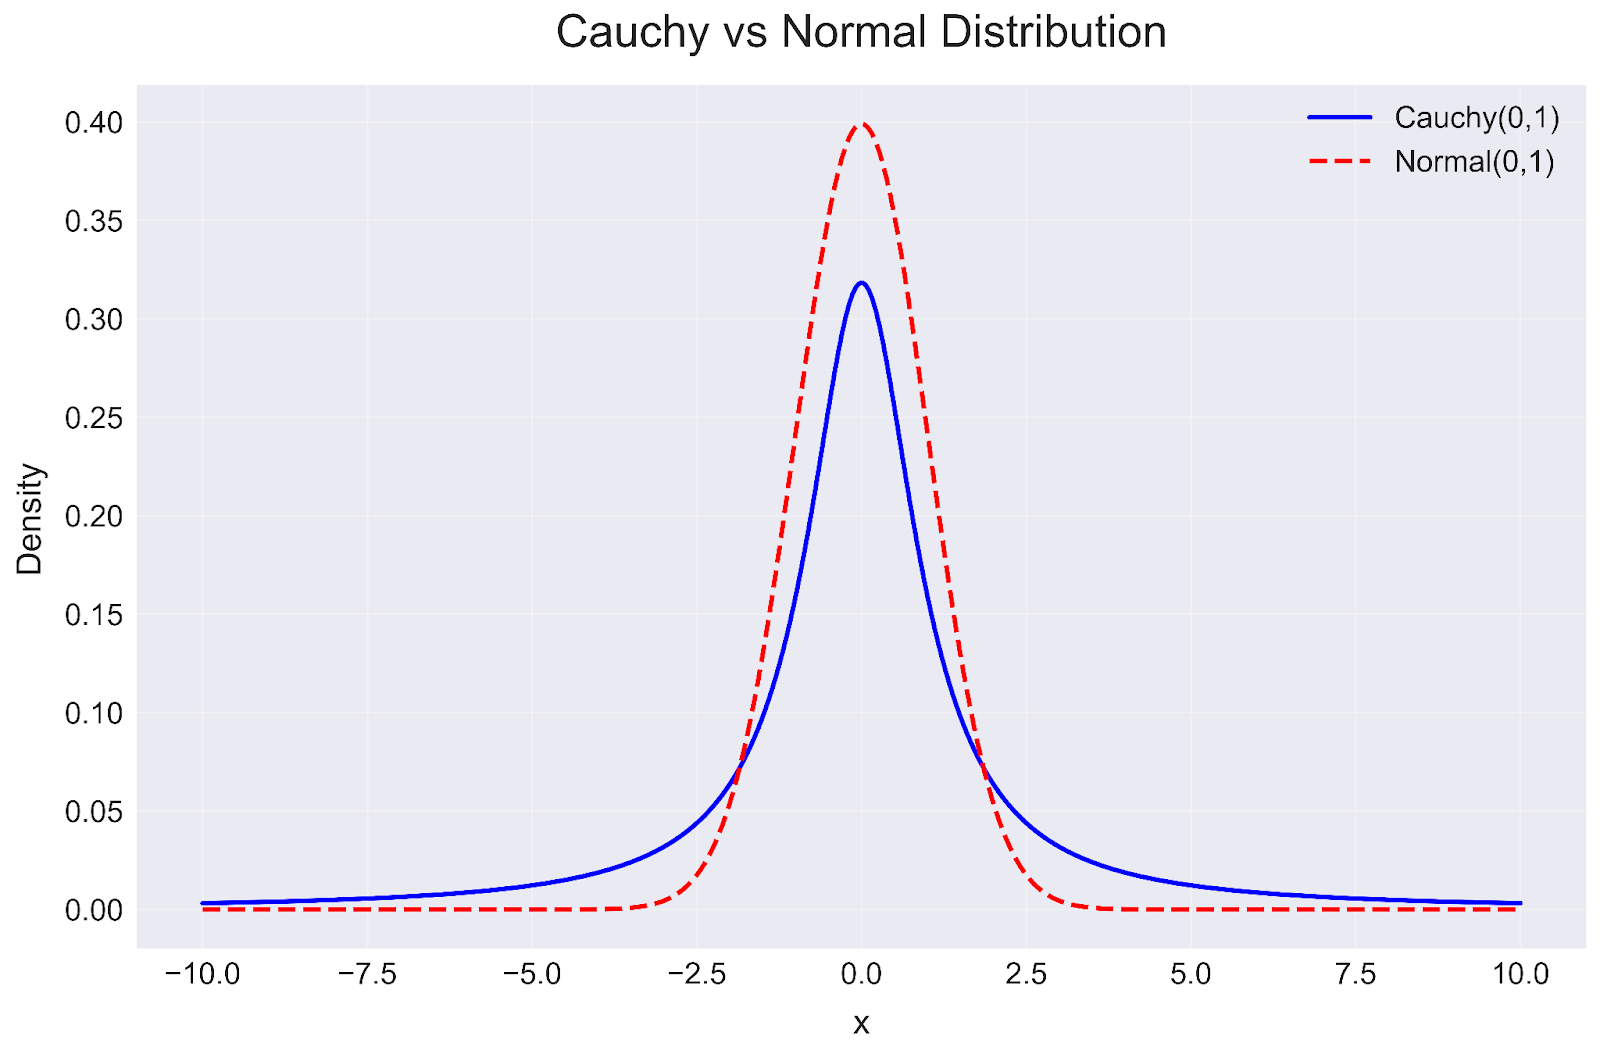
Cauchy-verdeling in Python. Afbeelding door de auteur
Deze visualisatie onthult enkele belangrijke inzichten:
Deze vergelijking helpt verklaren waarom de Cauchy-verdeling vaak wordt gebruikt in situaties waarin de normale verdeling de kans op extreme gebeurtenissen onderschat. Hoewel beide verdelingen symmetrisch zijn rond hun centrum, maken de zware staarten van de Cauchy-verdeling haar geschikter voor systemen waarin uitschieters eerder regel dan uitzondering zijn.
De Cauchy-verdeling dient specifieke doelen in data-analyse en modellering. Laten we bekijken hoe ze effectief wordt toegepast in verschillende domeinen.
Financiële markten staan bekend om hun onvoorspelbare karakter, met vaak dramatische prijsbewegingen die onder aannames van een normale verdeling "onmogelijk" zouden zijn. De Cauchy-verdeling blinkt hier uit omdat:
Tijdens de financiële crisis van 2008 faalden veel traditionele modellen bijvoorbeeld omdat ze uitgingen van normale verdelingen. Een op Cauchy gebaseerde benadering had de mogelijkheid van zulke extreme marktbewegingen beter kunnen voorzien.
Bij het evalueren van beleggingsrisico’s biedt de Cauchy-verdeling een voorzichtiger en realistischer beeld. Ze helpt risicomanagers passend kapitaal aan te houden door met extreme scenario’s rekening te houden, schat de kans op aanzienlijke verliezen of winsten beter in en biedt een realistischer model voor stresstesten van portefeuilles. Deze aanpak helpt financiële instellingen zich voor te bereiden op onwaarschijnlijke maar impactvolle marktevents.
In Bayesiaanse analyses is het kiezen van de juiste prior cruciaal. De Cauchy-verdeling is hier bijzonder waardevol omdat:
Wanneer je bijvoorbeeld de effectiviteit van een nieuwe medische behandeling analyseert, helpt een Cauchy-prior voor de effectgrootte te voorkomen dat we de mogelijkheid van grote behandeleffecten onderschatten.
Traditionele regressie kan sterk worden beïnvloed door uitschieters. Het gebruik van Cauchy-verdeelde fouttermen helpt robuustere modellen te bouwen door het model minder gevoelig te maken voor extreme observaties. De resultaten blijven betrouwbaar, zelfs als de data uitschieters bevat, en voorspellingen zijn stabieler in de aanwezigheid van ongewone punten. Deze robuustheid maakt Cauchy-verdeelde fouttermen bijzonder waardevol bij echte datasets die vaak onverwachte of extreme waarden bevatten.
Moderne machine learning werkt vaak met rommelige, real-world data. De Cauchy-verdeling helpt veerkrachtigere algoritmen te bouwen door:
In computer vision kan het gebruik van Cauchy-verdeelde ruismodellen algoritmen bijvoorbeeld helpen om artefacten of sensorstoringen beter te verwerken.
In geavanceerde machinelearningtoepassingen helpt de Cauchy-verdeling om flexibelere modellen te creëren. Ze is nuttig in variational autoencoders wanneer data zwaarstaartige kenmerken heeft, helpt realistischer synthetische data te genereren die af en toe extreme waarden bevat, en is waardevol bij het modelleren van latente ruimtes waar normale verdelingen te beperkend kunnen zijn. Deze flexibiliteit maakt de Cauchy-verdeling bijzonder bruikbaar in generatieve taken waarbij het belangrijk is het volledige scala aan mogelijke datavariaties vast te leggen.
Het is gebruikelijk om de Cauchy-verdeling te verwarren met andere, soortgelijke verdelingen. Laten we de belangrijkste verschillen verkennen zodat je de juiste keuze maakt voor je analyse.
De normale verdeling is vaak de standaardkeuze voor veel analyses, maar er zijn belangrijke verschillen met de Cauchy-verdeling:
Hoewel beide verdelingen symmetrisch zijn, vertellen hun staarten een heel ander verhaal: De normale verdeling suggereert dat waarden voorbij drie standaarddeviaties uiterst zeldzaam zijn. De Cauchy-verdeling laat zien dat extreme waarden veel vaker voorkomen dan je zou verwachten.
Deze verdelingen verschillen fundamenteel in hoe we ze kunnen analyseren: De normale verdeling heeft goed gedefinieerde momenten (gemiddelde = μ, variantie = σ²). De Cauchy-verdeling heeft geen gedefinieerd gemiddelde of variantie, waardoor traditionele statistische methoden onbruikbaar zijn.
Dit verschil is belangrijk in echte toepassingen: Gebruik de normale verdeling wanneer je data clustert rond een centrale waarde met voorspelbare spreiding. Gebruik de Cauchy-verdeling wanneer je data vaak extreme waarden vertoont die onder normale aannames "onmogelijk" zouden zijn.
De Laplace-verdeling lijkt op het eerste gezicht op de Cauchy, maar er zijn belangrijke verschillen die ze onderscheiden:
Beide verdelingen hebben zwaardere staarten dan de normale verdeling, maar ze verschillen in hoe zwaar: De staarten van de Laplace-verdeling nemen exponentieel af. De staarten van de Cauchy-verdeling nemen langzamer af (polynomiaal), waardoor extreme waarden nog waarschijnlijker zijn.
Beide verdelingen zijn symmetrisch rond hun centrum, maar verschillen in het gedrag van de staarten: De Laplace-verdeling vertoont exponentiële afname in de staarten. De Cauchy-verdeling vertoont polynomiale afname, waardoor haar staarten zwaarder zijn dan die van Laplace.
Inzicht in deze verschillen helpt je het juiste gereedschap te kiezen: Gebruik de Laplace-verdeling wanneer je af en toe uitschieters verwacht maar wel gedefinieerde momenten nodig hebt. Gebruik de Cauchy-verdeling wanneer je vaak extreme waarden verwacht en geen gemiddelden hoeft te berekenen.
De Cauchy-verdeling wordt misschien niet zo universeel toegepast als de normale verdeling, maar ze is van groot belang in contexten waar data zwaarstaartig gedrag vertoont, robuustheid tegen uitschieters vereist is, of de theoretische eigenschappen van stabiele verdelingen centraal staan. Of het nu in de natuurkunde, finance of Bayesiaanse statistiek is: inzicht in de Cauchy-verdeling vergroot je vermogen om data met grote variabiliteit en uitschieters te modelleren en te interpreteren.
Voor een dieper begrip van verwante kansverdelingen is de volgende reeks de moeite waard: Onze gids over de Gaussische verdeling verkent de meest gebruikte kansverdeling en vormt een uitstekend contrast met het zwaarstaartige gedrag van de Cauchy-verdeling. Onze gids over de Poisson-verdeling duikt in het modelleren van discrete gebeurtenissen in tijd of ruimte, terwijl onze gids over de binomiale verdeling de wiskunde achter reeksen onafhankelijke proeven uitlegt. Voor wie geïnteresseerd is in de fundamenten van de kansrekening biedt onze gids over de Bernoulli-verdeling inzicht in de bouwstenen van complexere verdelingen.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


