
Last chance! 50% off DataCamp Premium
Sale ends in
La distribuzione di Cauchy pone un intrigante rompicapo statistico. Pur condividendo la familiare forma a campana con molte altre distribuzioni di probabilità continue, sfugge all’analisi convenzionale perché non ha né media né varianza definite. Prende il nome dal matematico Augustin-Louis Cauchy e compare naturalmente in campi che vanno dalla modellazione finanziaria alla statistica bayesiana.
Come strumento didattico, la distribuzione di Cauchy illustra concetti statistici fondamentali con notevole chiarezza. Mostra la non convergenza delle medie campionarie, evidenzia l’importanza delle assunzioni sulle distribuzioni e fa vedere come si comportano gli stimatori in condizioni diverse.
Vuoi padroneggiare questi concetti statistici e le loro applicazioni nella data science? Esplora il nostro percorso di carriera Machine Learning Scientist in R, dove imparerai a implementare queste idee con la programmazione in R.
La distribuzione di Cauchy è una distribuzione di probabilità continua famosa per le sue proprietà uniche e le code pesanti. È caratterizzata da due parametri chiave:
La distribuzione è definita matematicamente dalla sua funzione di densità di probabilità (PDF):
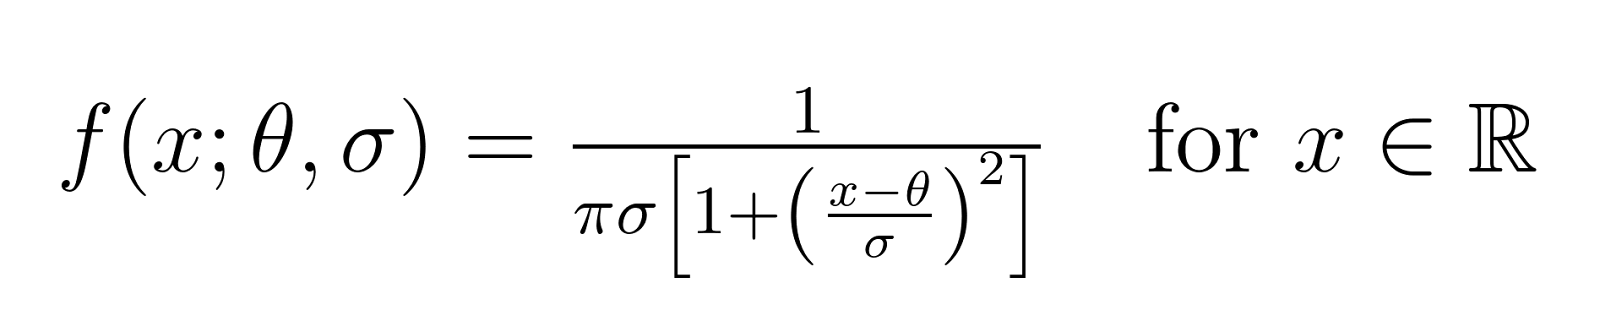
Impostando θ = 0 e σ = 1, otteniamo la cosiddetta distribuzione di Cauchy standard. Questa è la forma più semplice della distribuzione e funge da riferimento per capire casi più complessi.
Pensa alla distribuzione di Cauchy come alla distribuzione degli "eventi estremi". Mentre una distribuzione normale suggerisce che i valori lontani dal centro siano molto rari (come trovare una persona alta 7 piedi), la distribuzione di Cauchy ci dice che i valori estremi si verificano più spesso di quanto potresti aspettarti.
Per esempio, nei rendimenti azionari, enormi variazioni di prezzo in un solo giorno (come durante crolli o rally di mercato) accadono più spesso di quanto predirebbe una normale. Le code pesanti della distribuzione di Cauchy catturano meglio questi eventi "cigno nero".
Questa è forse la proprietà più affascinante della distribuzione di Cauchy. A differenza della maggior parte delle distribuzioni che conosci, la distribuzione di Cauchy non ha una media o una dispersione (varianza) significative.
Per capire perché conta: se prendi campioni ripetuti da una distribuzione di Cauchy e provi a calcolarne la media, non convergerai a nessun valore specifico, anche con milioni di campioni. Questo ha implicazioni per l’analisi statistica, poiché i metodi tradizionali che si basano su medie e varianze (come i t-test o ANOVA) non funzionano con dati distribuiti secondo Cauchy.
La distribuzione di Cauchy è perfettamente bilanciata attorno al suo parametro di posizione (θ), come un’immagine speculare su entrambi i lati. Tuttavia, questa simmetria non significa che si comporti come la familiare distribuzione normale. Sebbene entrambe siano simmetriche, la distribuzione di Cauchy distribuisce la probabilità in modo molto più ampio. Ciò significa che, pur avendo un centro chiaro, i valori possono allontanarsi molto da questo centro con probabilità significativa.
La distribuzione di Cauchy ha una proprietà notevole: se sommi due variabili indipendenti distribuite secondo Cauchy, ottieni ancora una distribuzione di Cauchy! Questa proprietà, nota come stabilità, è condivisa solo con poche altre distribuzioni (come la normale). È particolarmente utile in fisica e nella modellazione finanziaria, dove spesso dobbiamo capire come si comportano nel tempo processi casuali combinati.
La distribuzione di Cauchy è eccellente nel gestire gli outlier perché si aspetta che si verifichino. Questo la rende particolarmente utile in scenari in cui i valori estremi sono parti naturali dei dati, non errori da rimuovere. In questi casi, i metodi tradizionali di rilevamento degli outlier possono essere troppo aggressivi, segnalando in modo inappropriato punti dati legittimi da eliminare. La distribuzione di Cauchy fornisce un quadro per costruire modelli robusti che non saranno eccessivamente influenzati da osservazioni estreme, rendendola uno strumento prezioso quando lavori con dataset in cui gli outlier sono una caratteristica intrinseca più che un’anomalia da eliminare.
La scelta di usare o meno una distribuzione di Cauchy dipende dai tuoi dati e dai tuoi obiettivi. La distribuzione di Cauchy è particolarmente utile quando i tuoi dati mostrano spesso valori estremi, quando lavori con rapporti di variabili normalmente distribuite o quando ti serve un modello robusto capace di gestire dati con code pesanti. Tuttavia, dovresti essere cauto nell’usare la distribuzione di Cauchy in alcune situazioni: quando devi fare affidamento su medie e varianze, quando i tuoi dati seguono effettivamente una distribuzione a code più leggere o quando l’efficienza computazionale è una priorità. Capire questi compromessi è utile per decidere se la distribuzione di Cauchy è appropriata per le tue esigenze di analisi specifiche.
Sebbene la formula matematica della distribuzione di Cauchy sia semplice, lavorarci dal punto di vista computazionale può essere impegnativo. La stima dei parametri richiede spesso tecniche specializzate come le catene di Markov Monte Carlo (MCMC), e i metodi standard di massima verosimiglianza possono faticare a causa delle code pesanti. Fortunatamente, i moderni software statistici includono spesso strumenti specifici per gestire le distribuzioni di Cauchy, rendendo più praticabile lavorare con questa distribuzione nonostante le sue complessità computazionali.
La distribuzione di Cauchy possiede diverse proprietà matematiche importanti che la rendono unica e utile:
Il comportamento della distribuzione di Cauchy si capisce al meglio tramite la visualizzazione. Usiamo R per creare grafici di diverse distribuzioni di Cauchy, mostrando come i parametri di posizione (θ) e scala (σ) influenzino la forma e la posizione della distribuzione.
R offre funzioni per lavorare con le distribuzioni di Cauchy tramite il pacchetto stats. Useremo anche ggplot2 per creare visualizzazioni chiare, di qualità editoriale:
# Load required libraries
library(ggplot2)  # for plotting
# Note: dcauchy is from the stats package which is loaded by default in R

# Create a sequence of x values
x <- seq(-10, 10, length.out = 1000)

# Generate different Cauchy distributions using stats::dcauchy
# Standard Cauchy (θ = 0, σ = 1)
standard_cauchy <- dcauchy(x, location = 0, scale = 1)

# Location and Scale Adjusted (θ = 2, σ = 3)
adjusted_cauchy <- dcauchy(x, location = 2, scale = 3)

# Highly Scaled (θ = -1, σ = 5)
scaled_cauchy <- dcauchy(x, location = -1, scale = 5)

# Create a data frame for plotting
plot_data <- data.frame(
  x = rep(x, 3),
  density = c(standard_cauchy, adjusted_cauchy, scaled_cauchy),
  distribution = rep(c("Standard (θ=0, σ=1)",
                      "Adjusted (θ=2, σ=3)",
                      "Scaled (θ=-1, σ=5)"),
                    each = length(x))
)

# Create the plot
ggplot(plot_data, aes(x = x, y = density, color = distribution)) +
  geom_line(size = 1) +
  theme_minimal() +
  labs(title = "Comparison of Cauchy Distributions",
       x = "x",
       y = "Density",
       color = "Parameters") +
  theme(legend.position = "bottom",
        plot.title = element_text(hjust = 0.5)) +
  scale_color_brewer(palette = "Set1")
Questo codice genera un grafico comparativo di tre diverse distribuzioni di Cauchy:
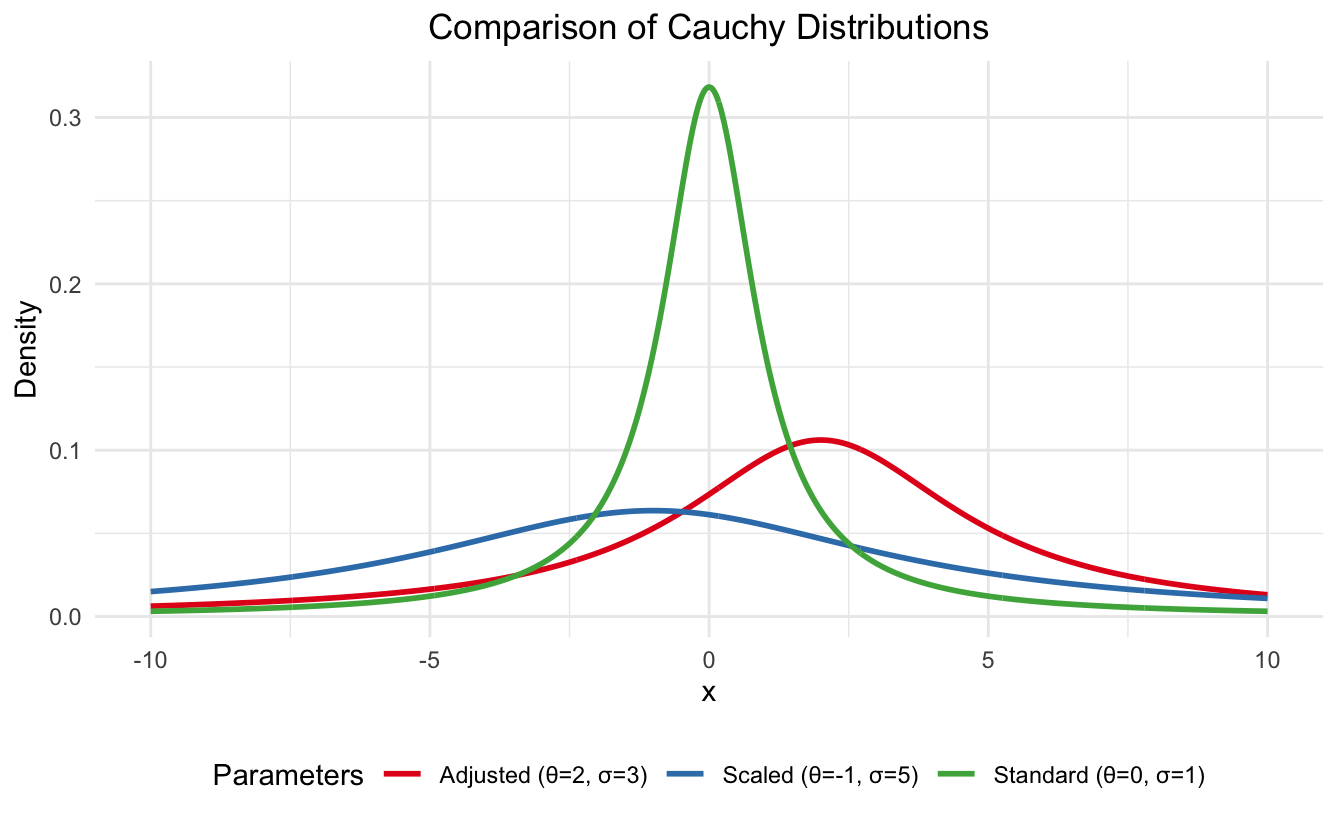
Distribuzione di Cauchy in R. Immagine dell’autore
La visualizzazione mostra chiaramente come l’aumento del parametro di scala (σ) porti a una distribuzione più piatta e dispersa, mentre il parametro di posizione (θ) sposta semplicemente l’intera distribuzione a sinistra o a destra.
Dopo aver esplorato i parametri della distribuzione di Cauchy in R, usiamo Python per confrontare la distribuzione di Cauchy con la sua cugina più nota, la Normale. Lo stack scientifico di Python, in particolare scipy.stats, offre ottimi strumenti per lavorare con le distribuzioni di probabilità.
Mentre il pacchetto stats di R fornisce accesso diretto alle funzioni per la distribuzione di Cauchy, il modulo scipy.stats di Python offre funzionalità simili con un’interfaccia leggermente diversa. Useremo matplotlib, la principale libreria di grafici in Python, per creare una visualizzazione chiara:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Set style parameters for better visualization
plt.style.use('seaborn')
plt.rcParams.update({
    'font.size': 16,
    'axes.labelsize': 18,
    'axes.titlesize': 24,
    'xtick.labelsize': 16,
    'ytick.labelsize': 16,
    'legend.fontsize': 16,
})

# Create data
x = np.linspace(-10, 10, 1000)
cauchy = stats.cauchy.pdf(x, loc=0, scale=1)
normal = stats.norm.pdf(x, loc=0, scale=1)

# Create the plot
plt.figure(figsize=(12, 8))

# Plot distributions
plt.plot(x, cauchy, 'b-', linewidth=2.5, label='Cauchy(0,1)')
plt.plot(x, normal, 'r--', linewidth=2.5, label='Normal(0,1)')

# Customize the plot
plt.title('Cauchy vs Normal Distribution', pad=20)
plt.xlabel('x', labelpad=10)
plt.ylabel('Density', labelpad=10)

# Customize legend
plt.legend(fontsize=16, bbox_to_anchor=(0.99, 0.99),
          loc='upper right', borderaxespad=0.)

# Add grid and adjust layout
plt.grid(True, alpha=0.3)
plt.tight_layout()

plt.show()
Il codice sopra crea un confronto tra la distribuzione di Cauchy standard (linea blu continua) e la distribuzione Normale standard (linea rossa tratteggiata), entrambe centrate in 0 con parametro di scala 1.
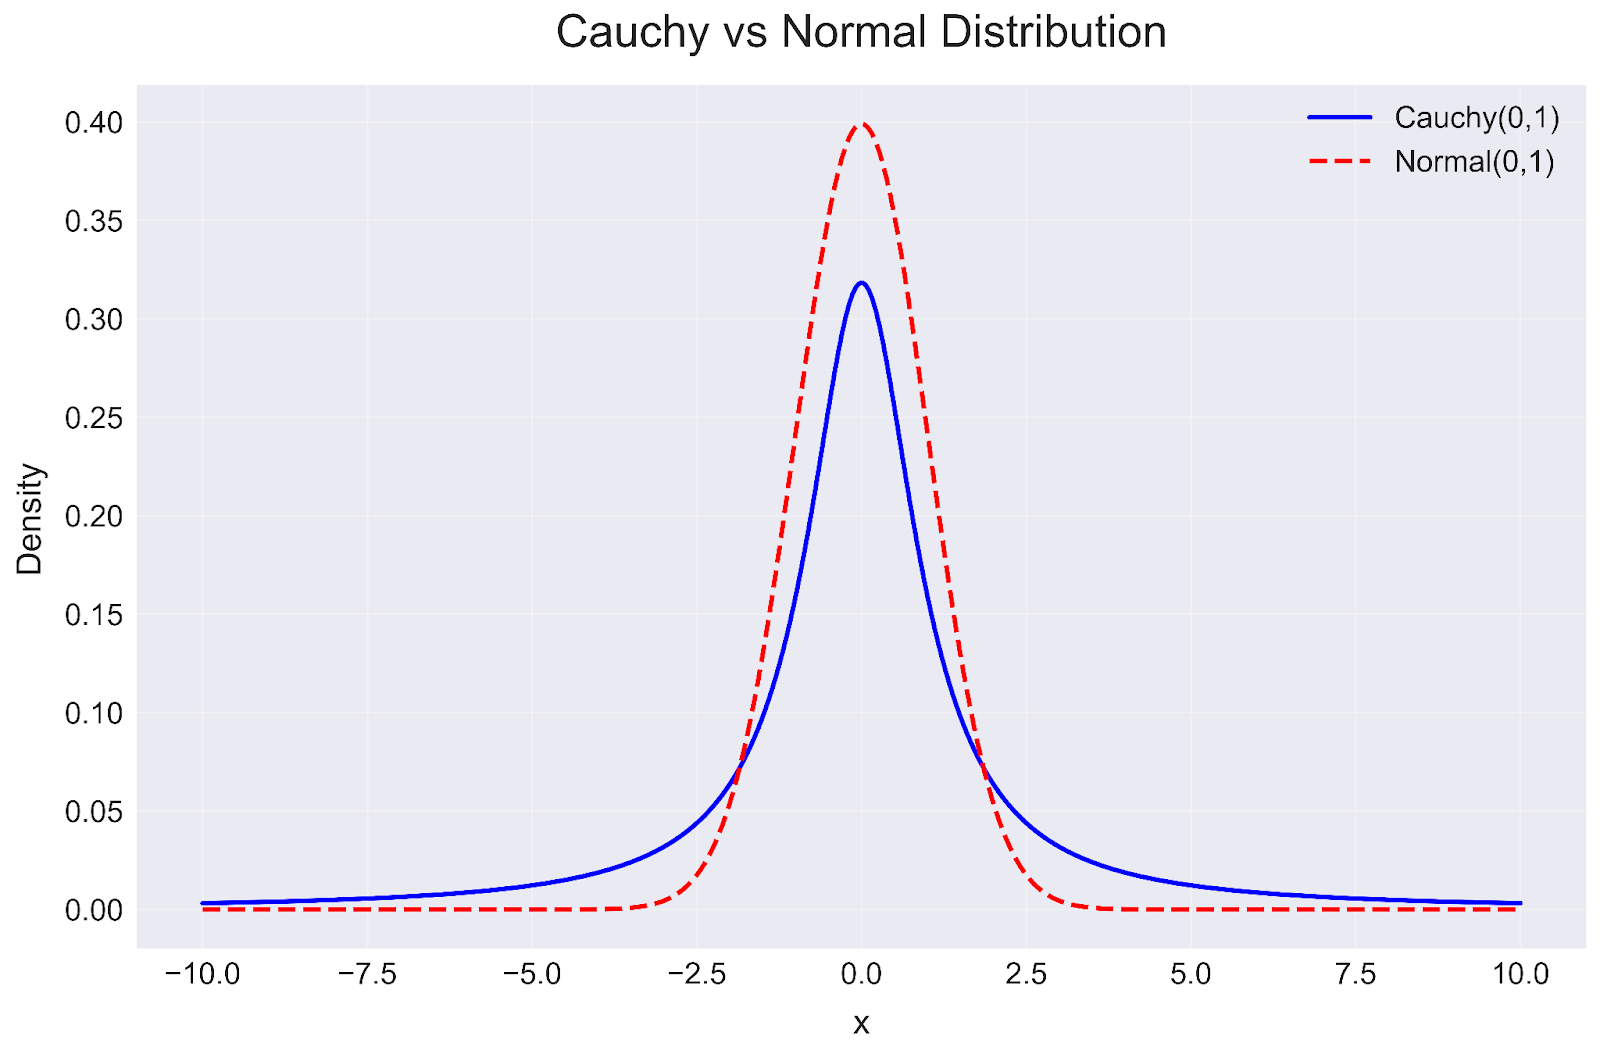
Distribuzione di Cauchy in Python. Immagine dell’autore
Questa visualizzazione rivela diversi spunti chiave:
Questo confronto aiuta a spiegare perché la distribuzione di Cauchy è spesso usata in scenari in cui la Normale sottostima la probabilità di eventi estremi. Sebbene entrambe le distribuzioni siano simmetriche attorno al loro centro, le code pesanti della Cauchy la rendono più adatta a modellare sistemi in cui gli outlier sono comuni piuttosto che rare eccezioni.
La distribuzione di Cauchy ha scopi specifici nell’analisi e nella modellazione dei dati. Vediamo come viene usata efficacemente in diversi ambiti.
I mercati finanziari sono noti per la loro natura imprevedibile, con oscillazioni di prezzo drammatiche che, sotto le assunzioni di normalità, sarebbero considerate "impossibili". La distribuzione di Cauchy qui brilla perché:
Per esempio, durante la crisi finanziaria del 2008, molti modelli tradizionali fallirono perché assumevano distribuzioni normali. Un modello basato su Cauchy avrebbe anticipato meglio la possibilità di movimenti di mercato così estremi.
Nella valutazione dei rischi d’investimento, la distribuzione di Cauchy offre una visione più conservativa e realistica. Aiuta i risk manager a definire riserve di capitale più appropriate considerando scenari estremi, stima meglio la probabilità di perdite o guadagni significativi e fornisce un modello più realistico per gli stress test dei portafogli. Questo approccio alla valutazione del rischio aiuta le istituzioni finanziarie a prepararsi a eventi di mercato improbabili ma di grande impatto.
Nell’analisi bayesiana, scegliere la giusta distribuzione a priori è fondamentale. La distribuzione di Cauchy è particolarmente preziosa perché:
Per esempio, quando si analizza l’efficacia di un nuovo trattamento medico, usare una priori di Cauchy per l’ampiezza dell’effetto aiuta a non sottostimare la possibilità di effetti molto grandi.
La regressione tradizionale può essere fortemente influenzata dagli outlier. Usare termini di errore distribuiti secondo Cauchy aiuta a costruire modelli più robusti rendendo il modello meno sensibile alle osservazioni estreme. I risultati restano affidabili anche quando i dati contengono outlier e le previsioni sono più stabili in presenza di punti dati insoliti. Questa robustezza rende i termini di errore di tipo Cauchy particolarmente utili quando si lavora con dataset reali che spesso contengono valori inattesi o estremi.
Il machine learning moderno spesso affronta dati rumorosi e reali. La distribuzione di Cauchy aiuta a costruire algoritmi più resilienti:
Per esempio, in computer vision, usare modelli di rumore distribuiti secondo Cauchy può aiutare gli algoritmi a gestire meglio artefatti delle immagini o malfunzionamenti dei sensori.
Nelle applicazioni avanzate di machine learning, la distribuzione di Cauchy aiuta a creare modelli più flessibili. È utile nei variational autoencoder quando i dati possono avere caratteristiche a code pesanti, aiuta a generare dati sintetici più realistici che includono occasionali valori estremi ed è preziosa nel modellare spazi latenti in cui le distribuzioni normali potrebbero essere troppo restrittive. Questa flessibilità rende la distribuzione di Cauchy particolarmente utile nei compiti di modellazione generativa in cui è importante catturare l’intera gamma delle possibili variazioni dei dati.
È comune confondere la distribuzione di Cauchy con altre distribuzioni simili. Esploriamo le differenze chiave per aiutarti a scegliere quella giusta per la tua analisi.
La distribuzione normale è spesso la scelta predefinita in molte analisi, ma tra questa e la distribuzione di Cauchy ci sono differenze importanti:
Sebbene entrambe le distribuzioni siano simmetriche, le loro code raccontano storie molto diverse: La distribuzione normale suggerisce che i valori oltre le tre deviazioni standard siano estremamente rari. La distribuzione di Cauchy ci dice che i valori estremi sono molto più comuni di quanto potresti aspettarti.
Queste distribuzioni differiscono in modo fondamentale nelle modalità di analisi: La distribuzione normale ha momenti ben definiti (media = μ, varianza = σ²). La distribuzione di Cauchy non ha media né varianza definite, rendendo inutilizzabili i metodi statistici tradizionali.
Questa differenza conta nelle applicazioni reali: Usa la distribuzione normale quando i tuoi dati si raggruppano attorno a un valore centrale con una dispersione prevedibile. Usa la distribuzione di Cauchy quando i tuoi dati mostrano spesso valori estremi che sarebbero "impossibili" sotto le assunzioni di normalità.
La distribuzione di Laplace può sembrare simile alla Cauchy a prima vista, ma ci sono differenze chiave che le distinguono:
Entrambe hanno code più pesanti della normale, ma differiscono nella "pesantezza": Le code della Laplace decadono esponenzialmente. Le code della Cauchy decadono più lentamente (polinomialmente), rendendo i valori estremi ancora più probabili.
Entrambe sono simmetriche attorno al loro centro, ma differiscono nel comportamento delle code: La Laplace mostra decadimento esponenziale nelle code. La Cauchy mostra decadimento polinomiale, con code più pesanti della Laplace.
Capire queste differenze aiuta a scegliere lo strumento giusto: Usa la distribuzione di Laplace quando ti aspetti outlier occasionali ma hai ancora bisogno di momenti definiti. Usa la distribuzione di Cauchy quando ti aspetti valori estremi frequenti e non hai bisogno di calcolare le medie.
La distribuzione di Cauchy, pur non essendo applicata in modo onnipresente come la distribuzione normale, riveste grande importanza nelle aree in cui i dati mostrano comportamenti a code pesanti, è richiesta robustezza agli outlier o interessano le proprietà teoriche delle distribuzioni stabili. Che si tratti di fisica, finanza o statistica bayesiana, comprendere la distribuzione di Cauchy migliora la capacità di modellare e interpretare dati con forte variabilità e outlier.
Per approfondire le distribuzioni di probabilità correlate, potresti trovare utile la seguente serie: La nostra guida sulla Distribuzione Gaussiana esplora la distribuzione di probabilità più usata, che offre un ottimo contrasto con il comportamento a code pesanti della Cauchy. La nostra guida sulla Distribuzione di Poisson approfondisce la modellazione di eventi discreti nel tempo o nello spazio, mentre la guida sulla Distribuzione Binomiale spiega la matematica alla base di sequenze di prove indipendenti. Per chi è interessato ai fondamenti della teoria della probabilità, la guida sulla Distribuzione di Bernoulli offre spunti sui mattoni di base delle distribuzioni più complesse.
Impara con DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min




